Spring
1.Spring을 이해하기 위한 객체지향 기초와 웹 개발 핵심 개념 정리
Spring은 새로운 프로그래밍 언어가 아니다.Java로 개발할 때 반복적으로 발생하는 객체 생성, 객체 관리, 객체 간 연결 문제를 해결하기 위해 만들어진 프레임워크이다.따라서 Spring을 이해하려면 먼저 객체가 무엇인지, 객체들이 어떤 방식으로 협력하는지 이해해야
2.Spring 입문 전 이해해야 할 HTTP, API, RESTful 설계

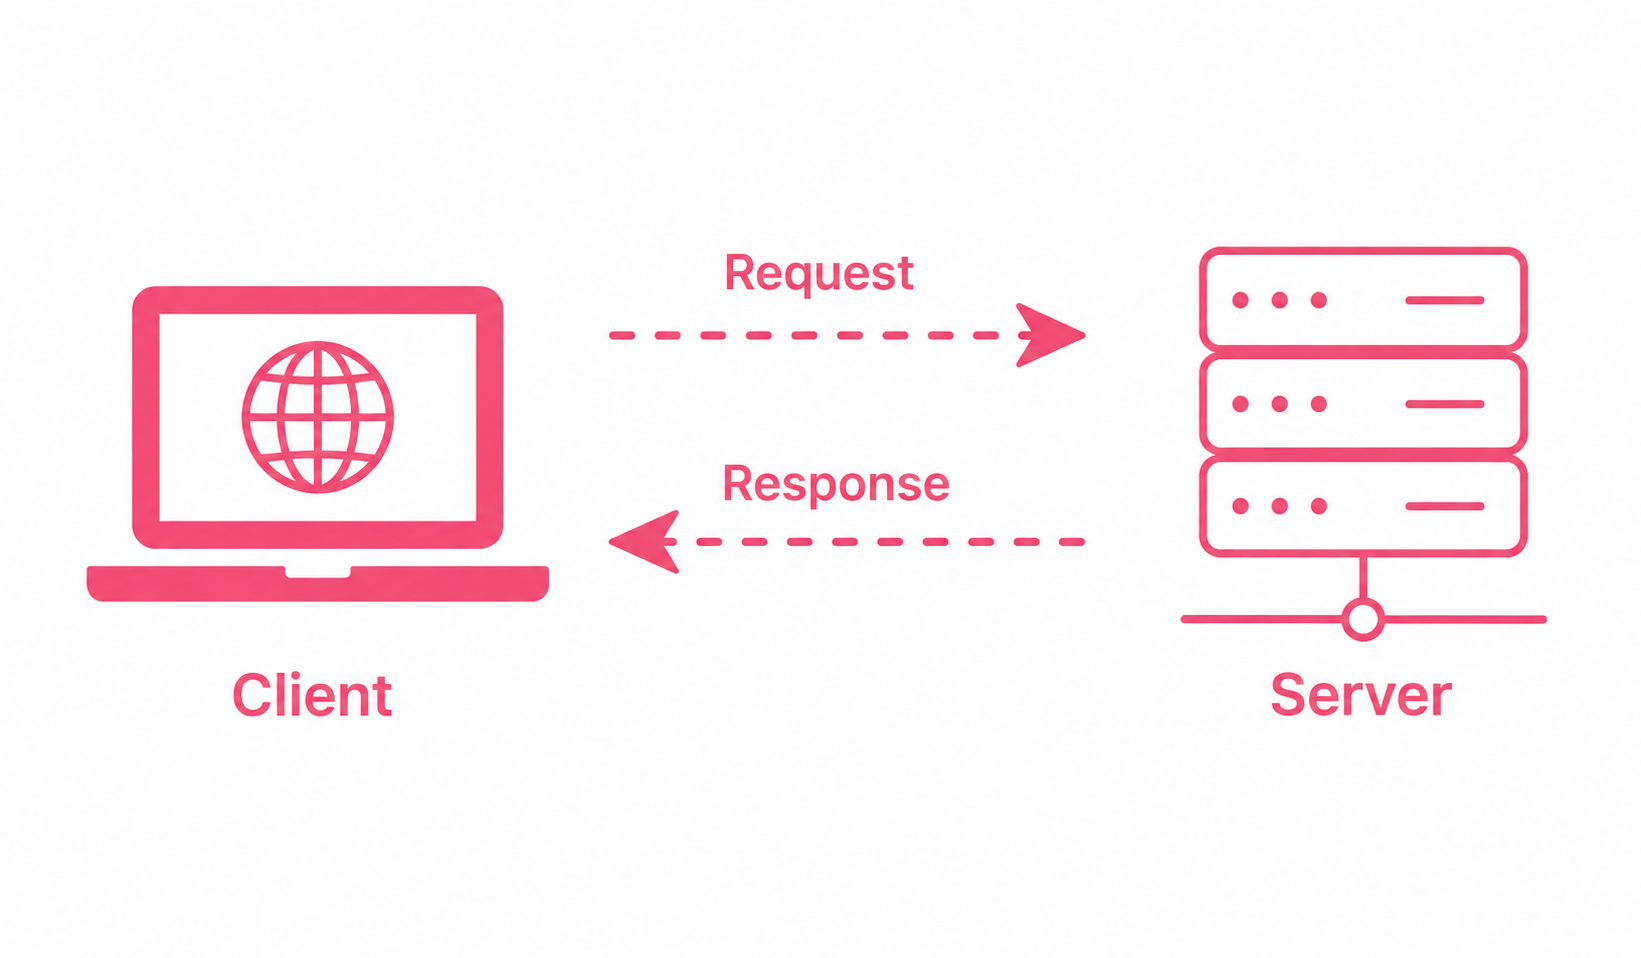
Spring으로 백엔드 서버를 만들기 전에 먼저 이해해야 하는 것은 HTTP의 요청과 응답 흐름이다. Spring Controller에서 사용하는 @GetMapping, @PostMapping, @RequestBody, @PathVariable, ResponseEnti
3.Spring Boot의 자동화 도구: Annotation, Lombok, Gradle 의존성 관리
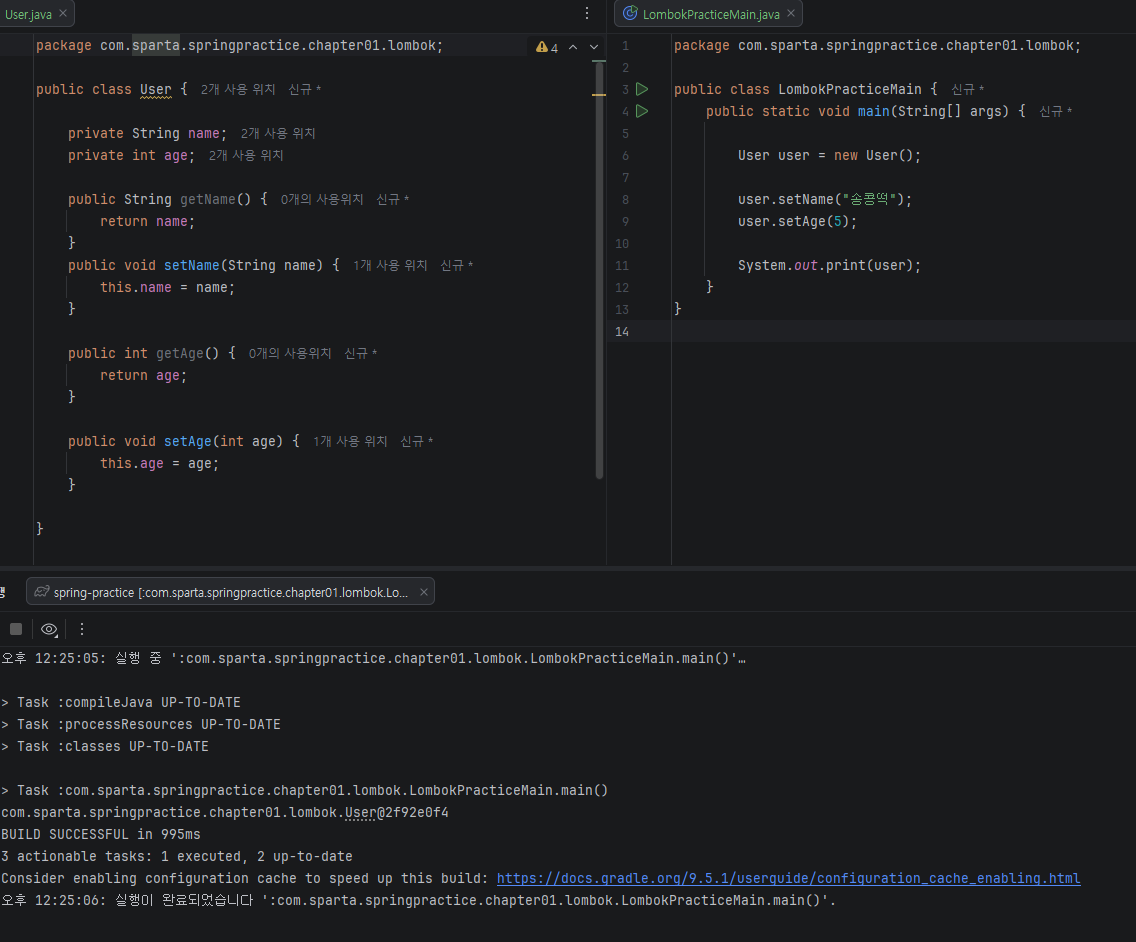
Java 문법을 배울 때는 클래스를 만들고, 필드를 선언하고, getter, setter, toString() 같은 메서드를 직접 작성했다. 작은 예제에서는 직접 작성해도 큰 문제가 없었지만, 클래스 수가 늘어나면 같은 형태의 코드가 반복된다.Spring Boot 프로
4.Servlet 기반 API 구현과 JSON 응답 흐름 이해
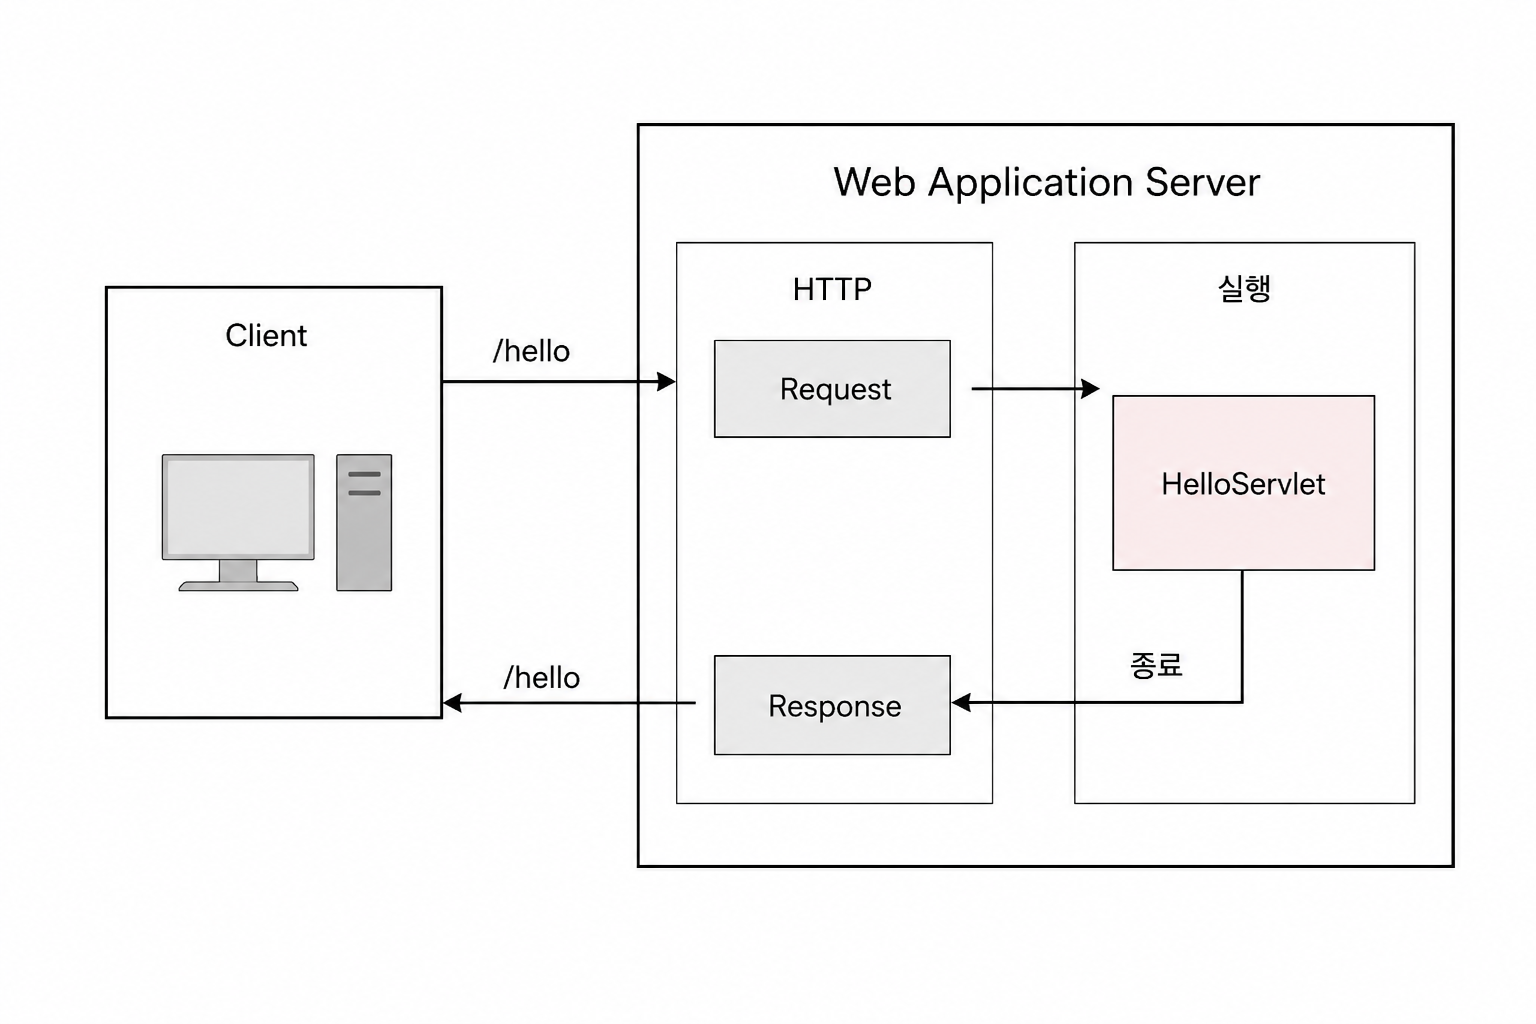
초기의 웹 페이지는 이미 만들어진 HTML 파일을 그대로 내려주는 방식이었다. 이런 방식은 모든 사용자에게 같은 화면을 보여주기에는 충분하지만, 요청마다 다른 결과를 만들어야 하는 기능에는 한계가 있다.예를 들어 영화 추천 기능을 만든다고 하면, 서버는 단순히 고정된
5.Servlet의 한계에서 DispatcherServlet까지
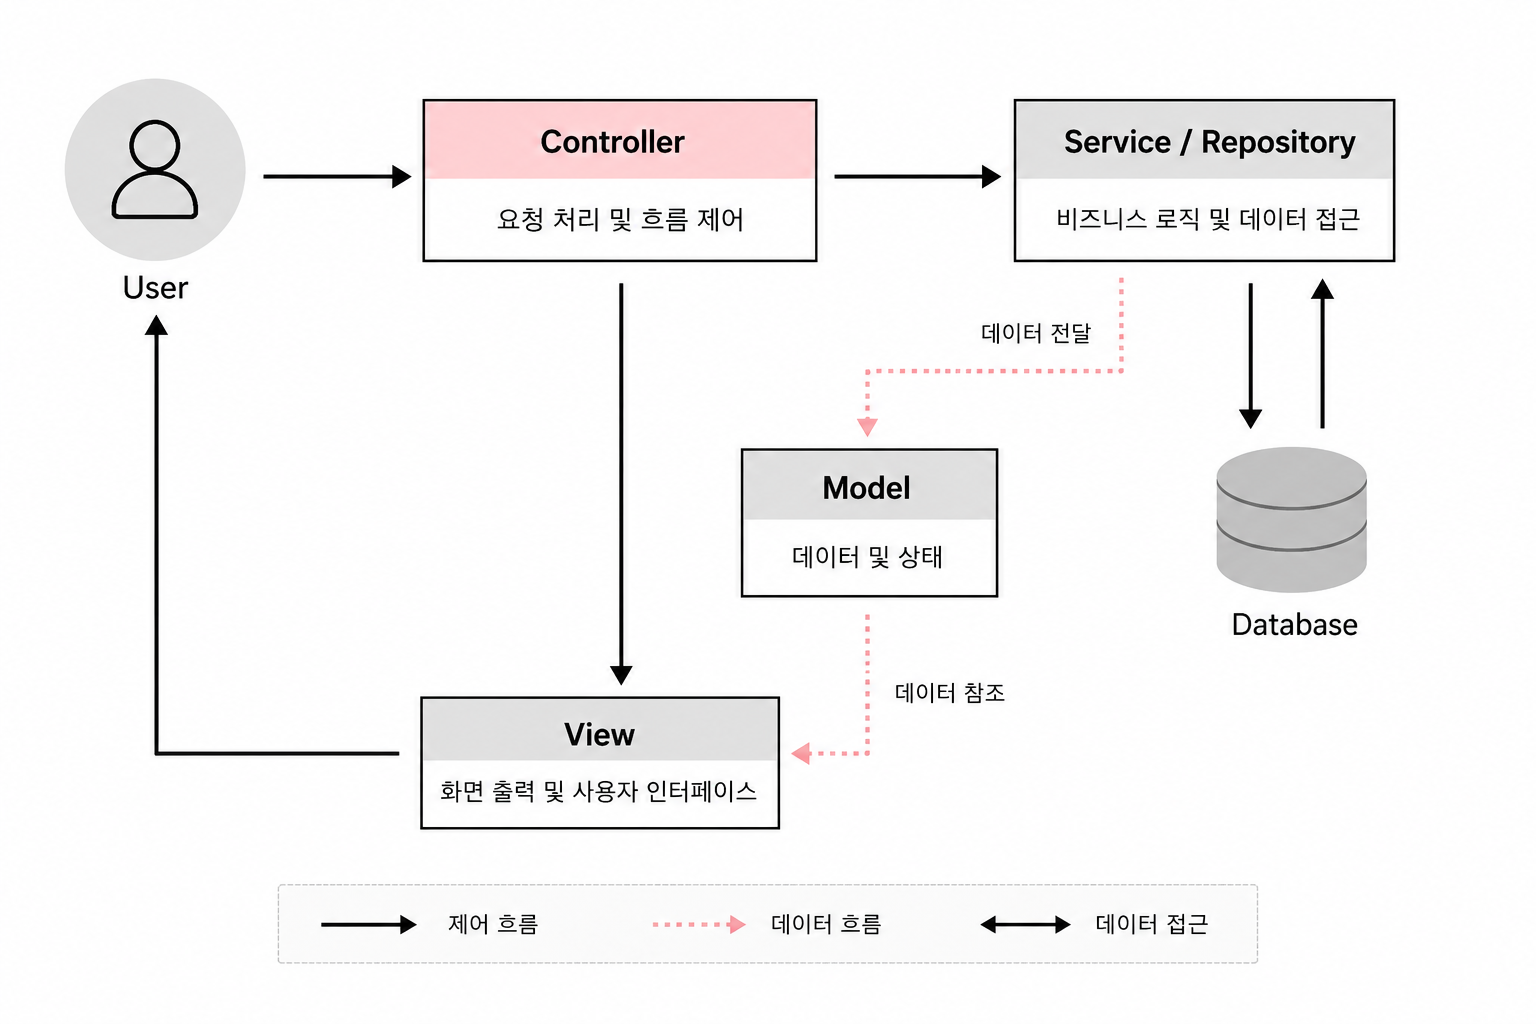
Servlet으로도 간단한 API는 만들 수 있다. 예를 들어 영화 추천 API처럼 요청을 받고, 영화 목록에서 하나를 고르고, JSON으로 변환한 뒤 응답을 보내는 코드는 정상적으로 동작한다. 문제는 기능이 많아질 때 시작된다. Servlet 하나 안에 HTTP 요청
6.Controller에서 Thymeleaf 화면까지: Spring MVC View 처리 이해
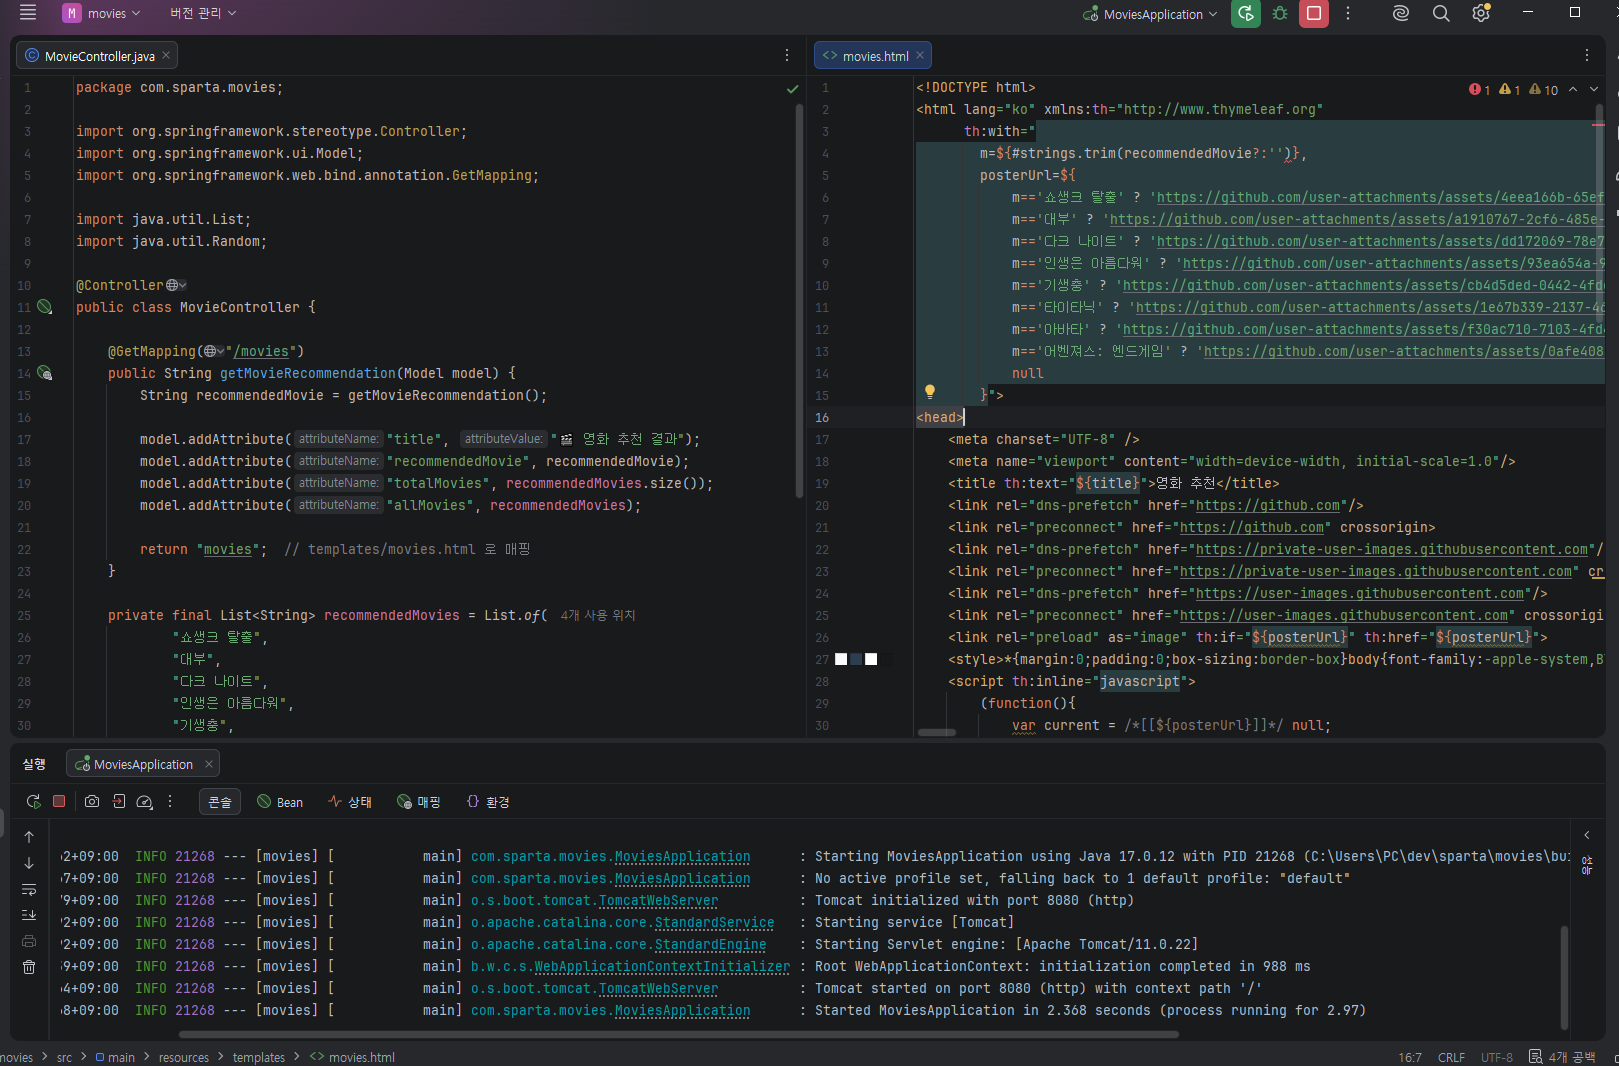
웹 어플리케이션은 사용자의 요청을 받은 뒤, 그 결과를 다시 사용자가 이해할 수 있는 형태로 응답해야 한다. 이때 응답 형태는 크게 두 가지로 나눌 수 있다.하나는 서버가 HTML 화면까지 완성해서 브라우저에 보내는 방식이고, 다른 하나는 서버가 JSON 데이터만 보내
7.Spring REST API 요청 처리 흐름과 JSON 응답 구조 이해
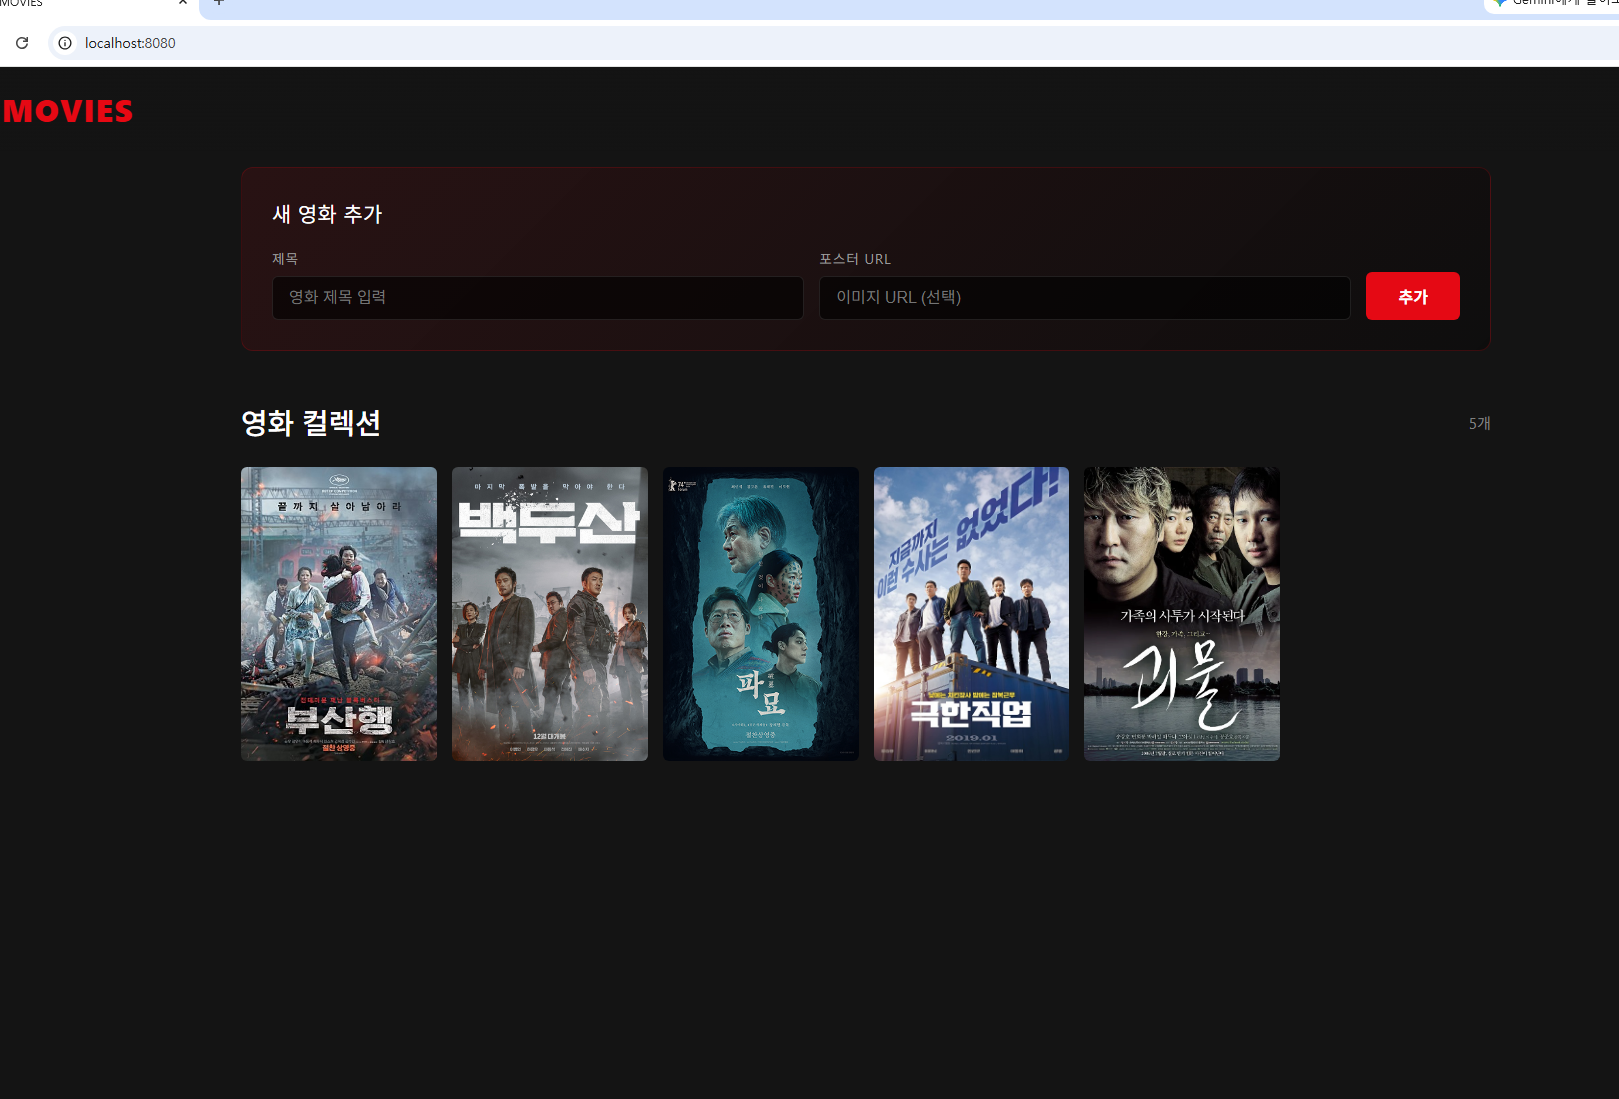
웹 어플리케이션에서 백엔드는 두 가지 방식으로 응답할 수 있다.첫번째는 서버가 HTML 화면을 직접 만들어 브라우저에 전달하는 방식이다.이 경우 Controller는 View 이름을 반환하고, ViewResolver가 해당 HTML 파일을 찾아 화면을 완성한다.두번째는
8.백엔드 데이터 저장의 시작: MySQL 실습과 ERD 설계 흐름
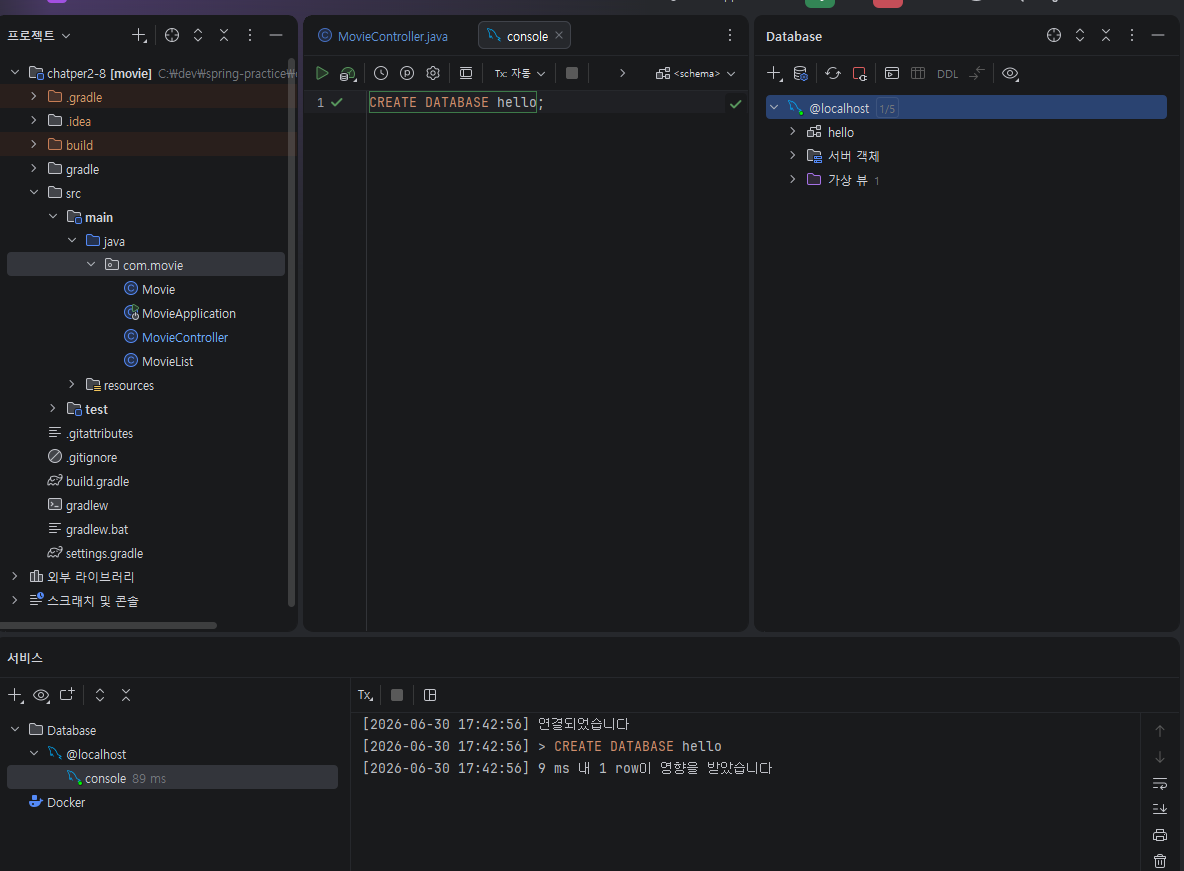
자바 프로그램 안에서 List나 배열에 데이터를 저장하면 프로그램이 실행되는 동안에는 데이터를 사용할 수 있다. 하지만 서버를 종료하면 메모리에 있던 데이터는 사라진다. 게시글, 회원 정보, 일정, 주문 내역처럼 계속 남아 있어야 하는 데이터는 별도의 저장소가 필요하다
9.ORM에서 Entity 매핑까지: Java 객체와 데이터베이스를 연결하는 흐름
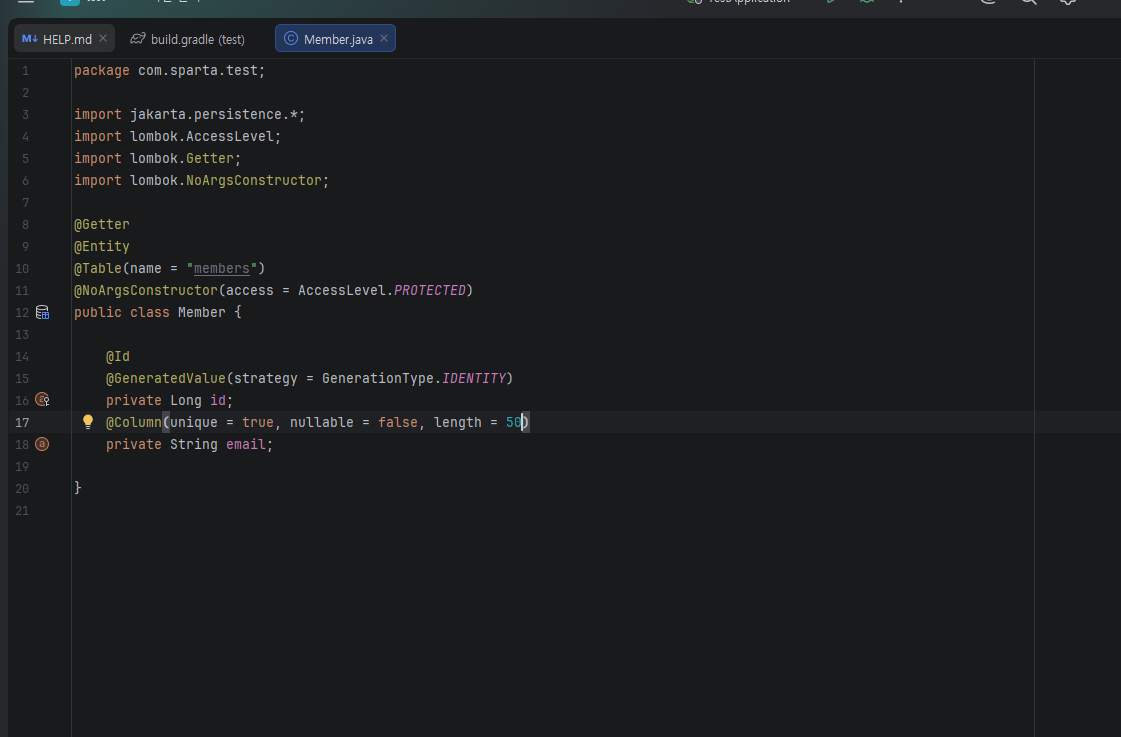
백엔드 어플리케이션은 Java 코드만으로 완성되지 않는다. 사용자가 입력한 데이터는 결국 데이터베이스에 저장되어야 하고, 저장된 데이터는 다시 Java 객체로 꺼내져 사용된다. 문제는 Java의 객체 구조와 관계형 데이터베이스의 테이블 구조가 서로 다르다는 점이다.OR
10.3 Layer Architecture와 JPA 영속성 컨텍스트를 활용한 CRUD 구조 이해
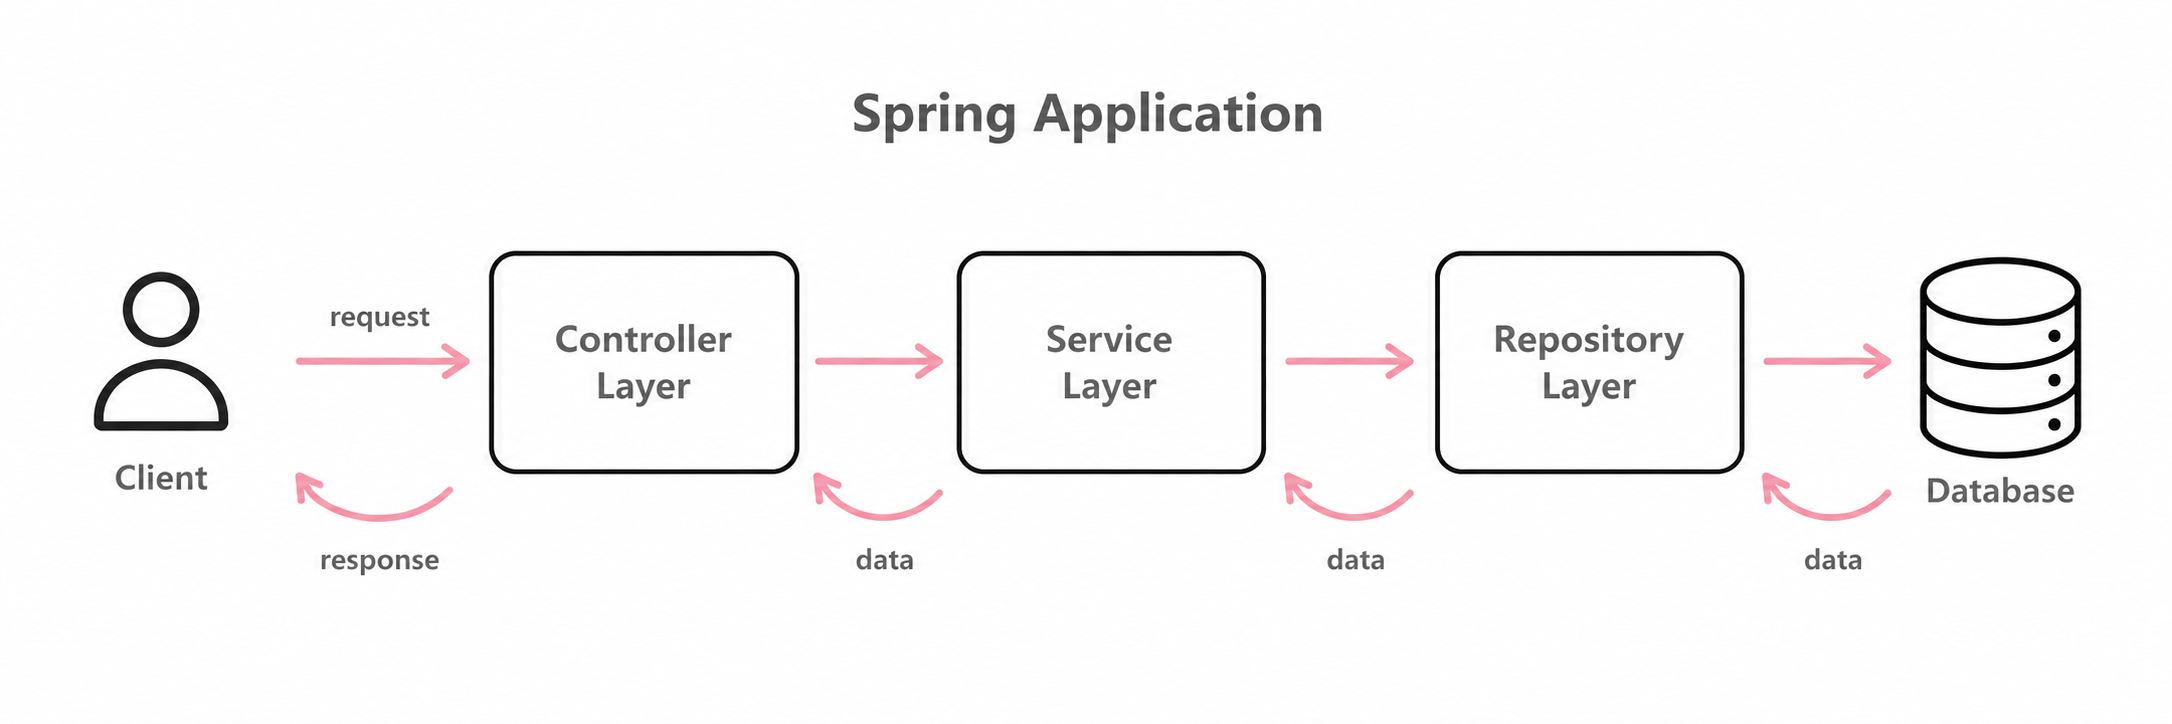
백엔드 어플리케이션은 단순히 "코드가 실행되는 것"만으로는 충분하지 않다. 요청을 받는 코드, 비즈니스 규칙을 처리하는 코드, 데이터베이스와 통신하는 코드가 한곳에 섞이면 처음에는 빠르게 만들 수 있지만, 기능이 늘어날수록 수정하기 어려운 구조가 된다.그래서 Sprin
11.미니 방명록으로 이해한 Spring CRUD와 계층 구조
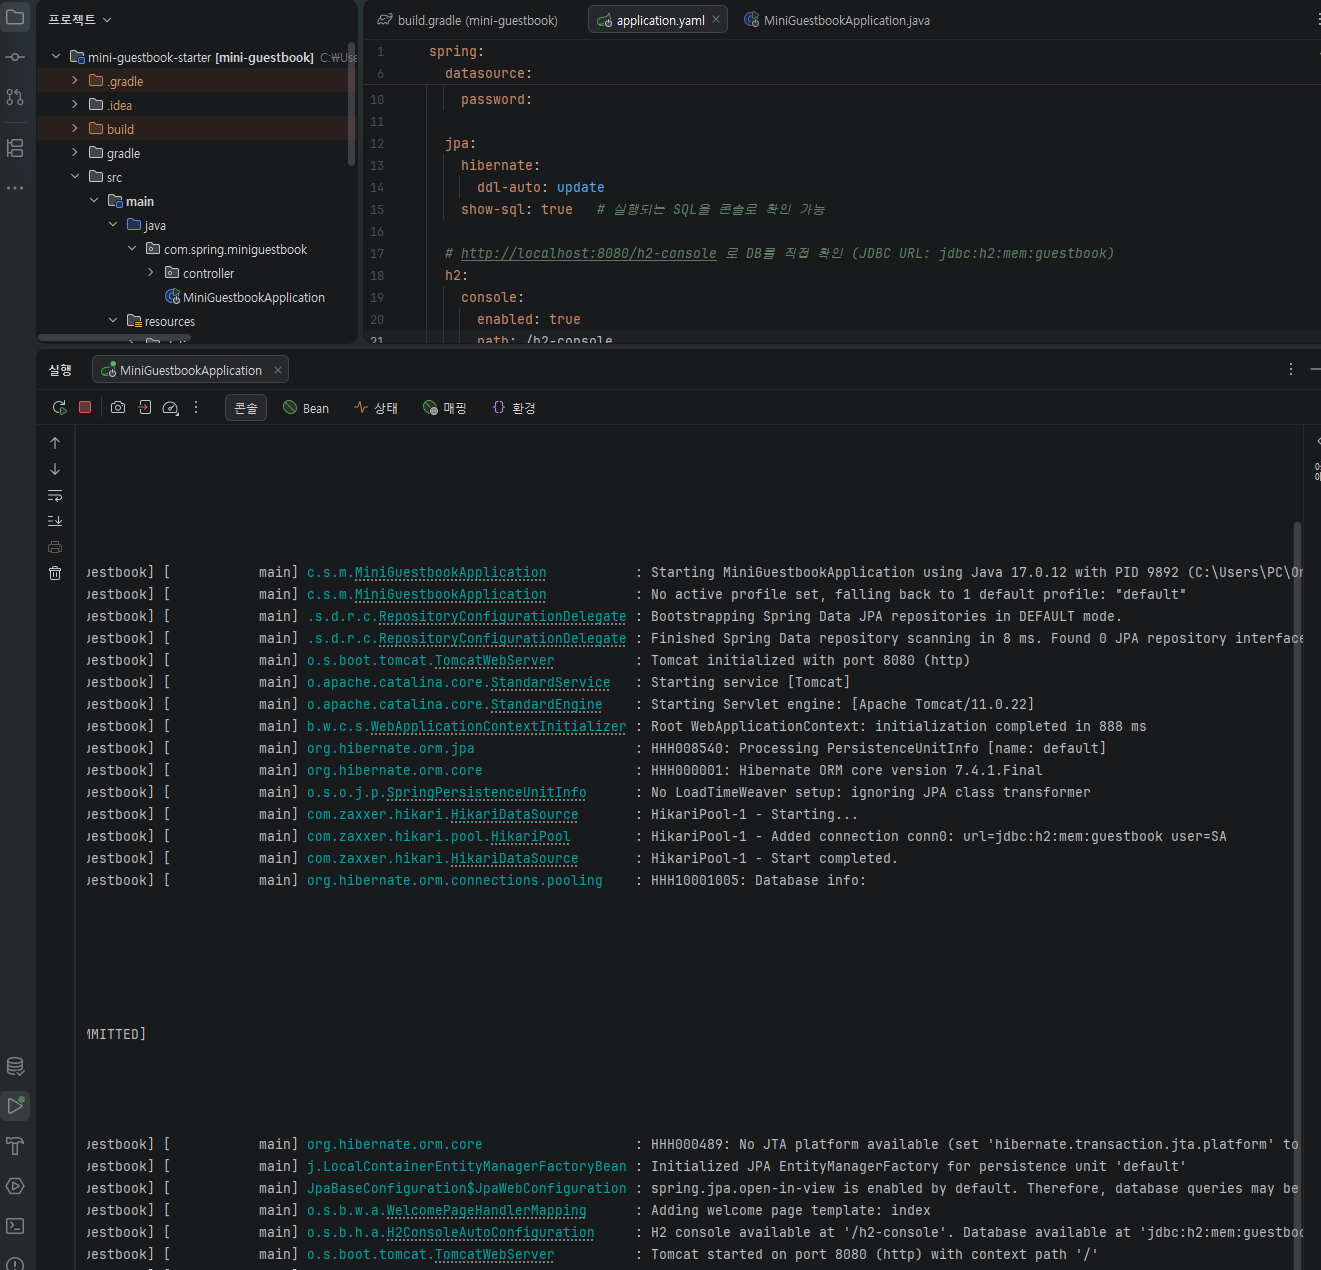
미니 방명록 프로젝트는 이름과 메세지를 등록하고, 조회하고, 수정하고, 삭제하는 작은 기능으로 구성되어 있다. 겉으로는 단순한 CRUD 기능이지만, 내부에서는 Controller → Service → Repository → JPA/Hibernate → DB 흐름이 모두
12.다형성과 IoC/DI로 개선한 환율 결제 서비스 구조
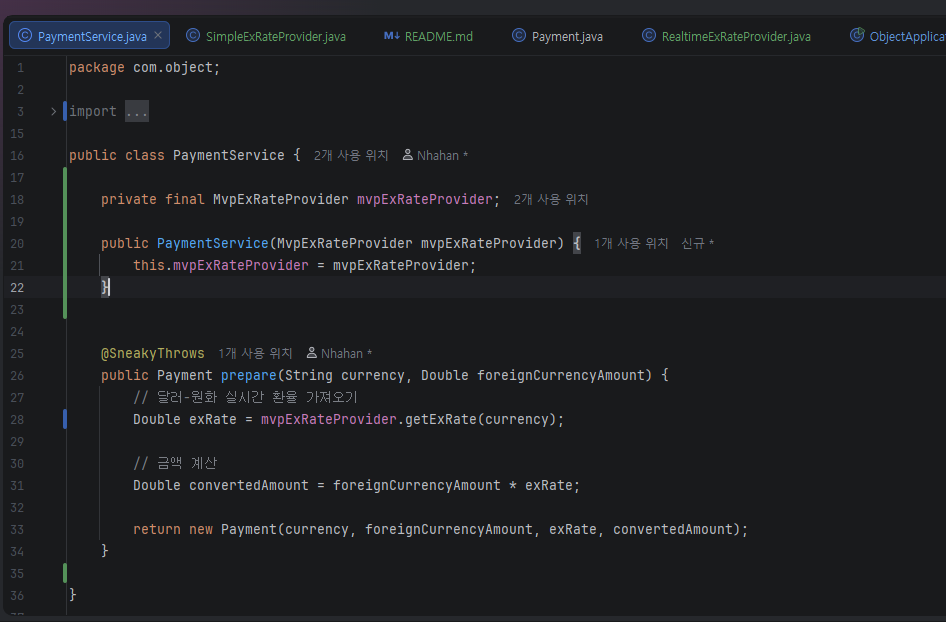
가장 먼저 작성한 환율 결제 코드는 기능적으로는 정상 동작했다. PaymentService가 외부 환율 API를 호출하고, 응답에서 KRW 환율을 꺼낸 뒤, 외화 금액에 환율을 곱해 Payment 객체를 생성했다.하지만 코드가 정상 실행된다고 해서 항상 좋은 구조라고
13.Spring Bean과 IoC Container로 이해하는 객체 관리 구조
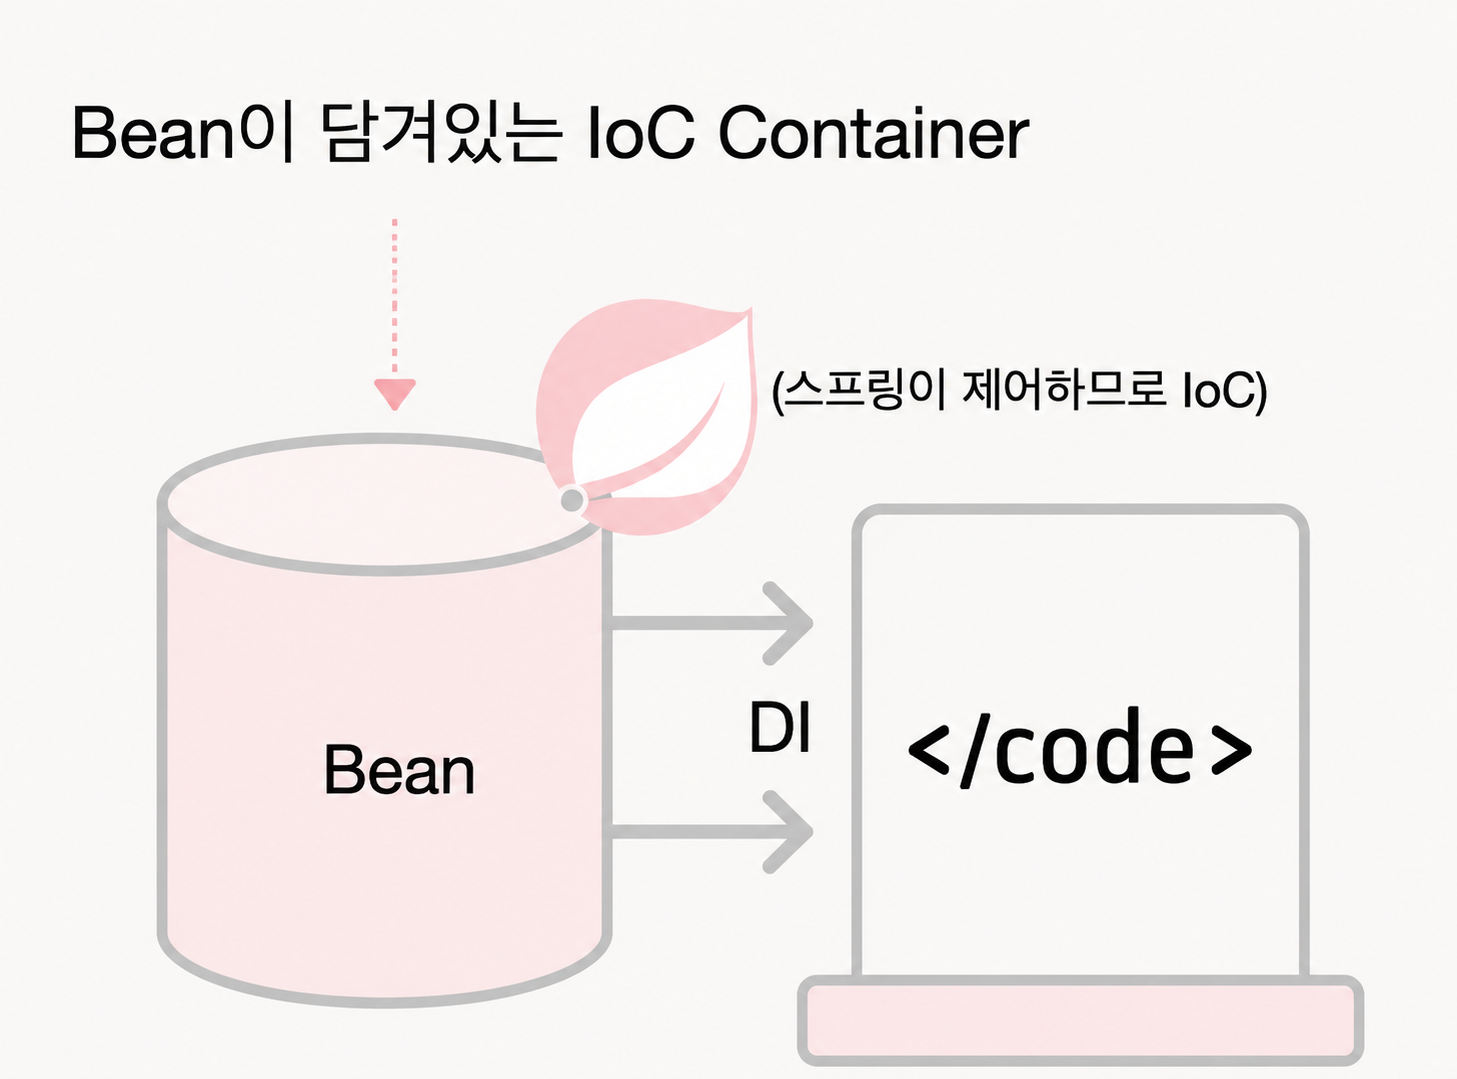
Java만 사용할 때는 필요한 객체를 개발자가 직접 new로 생성했다.이 방식은 초반엔 단순해 보이지만, 클래스가 많아질수록 복잡해지는 등 문제가 커진다.스케줄 CRUD 구조로 보면 ScheduleController → ScheduleService → ScheduleR
14.Spring Validation으로 잘못된 요청 데이터 차단하기
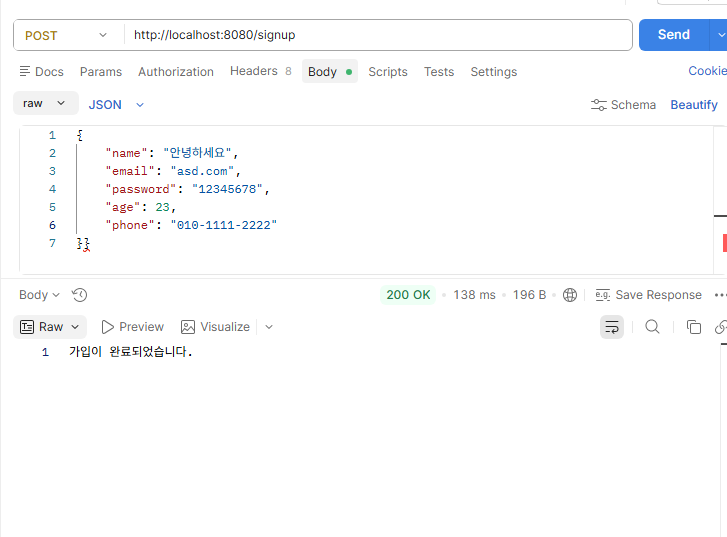
회원가입 API를 만든다고 가정하면 사용자는 이름, 이메일, 비밀번호, 나이, 전화번호를 입력한다.문제는 사용자가 항상 올바른 값을 보내지는 않는다는 점이다.예를 들어 이메일 칸에 다래와 같은 값을 보낼 수 있다.asd.com은 이메일처럼 보이지만 실제 이메일 형식은
15.Session 기반 로그인 상태 관리와 닉네임 수정 API 구현
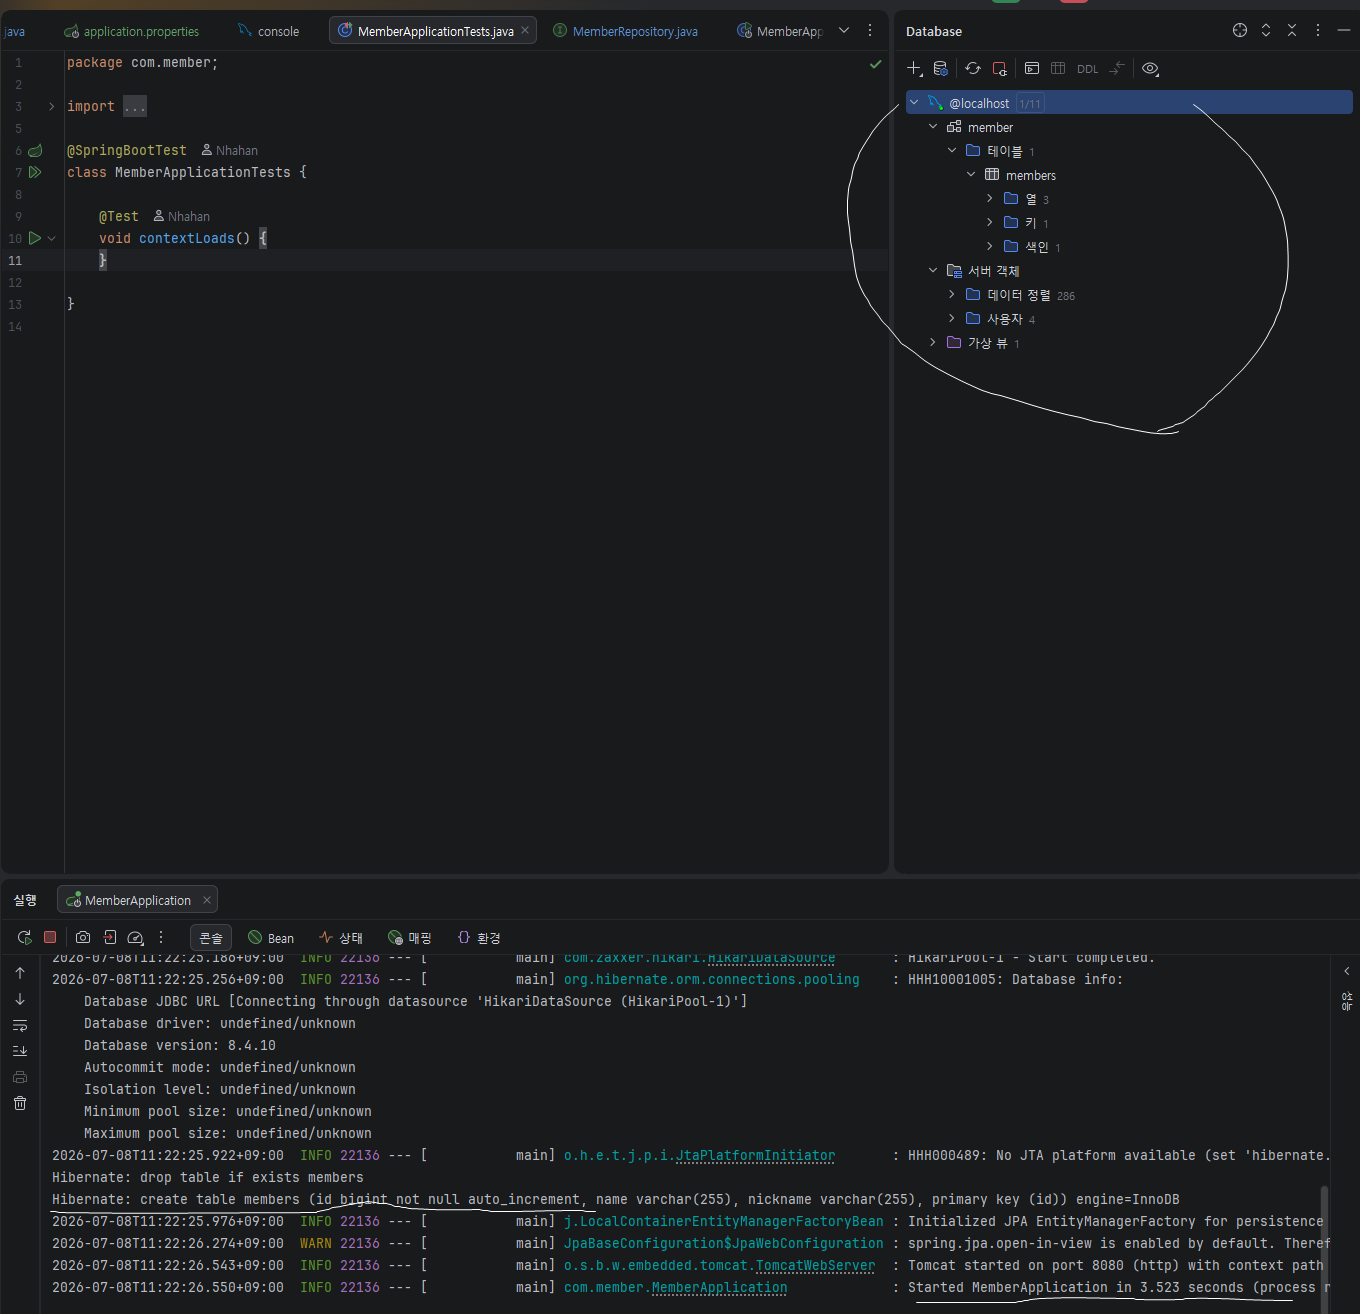
HTTP 요청은 기본적으로 무상태(Stateless)구조다.즉, 서버는 요청 하나가 끝나면 이전 요청의 사용자가 누구였는지 자동으로 기억하지 않는다.예를 들어 사용자가 방금 로그인을 했더라도, 다음 요청에서 서버는 그대로 두면 이렇게 판단한다.그래서 로그인 이후에도 사
16.세션 인증과 연관관계를 적용한 일정 관리 API 구현
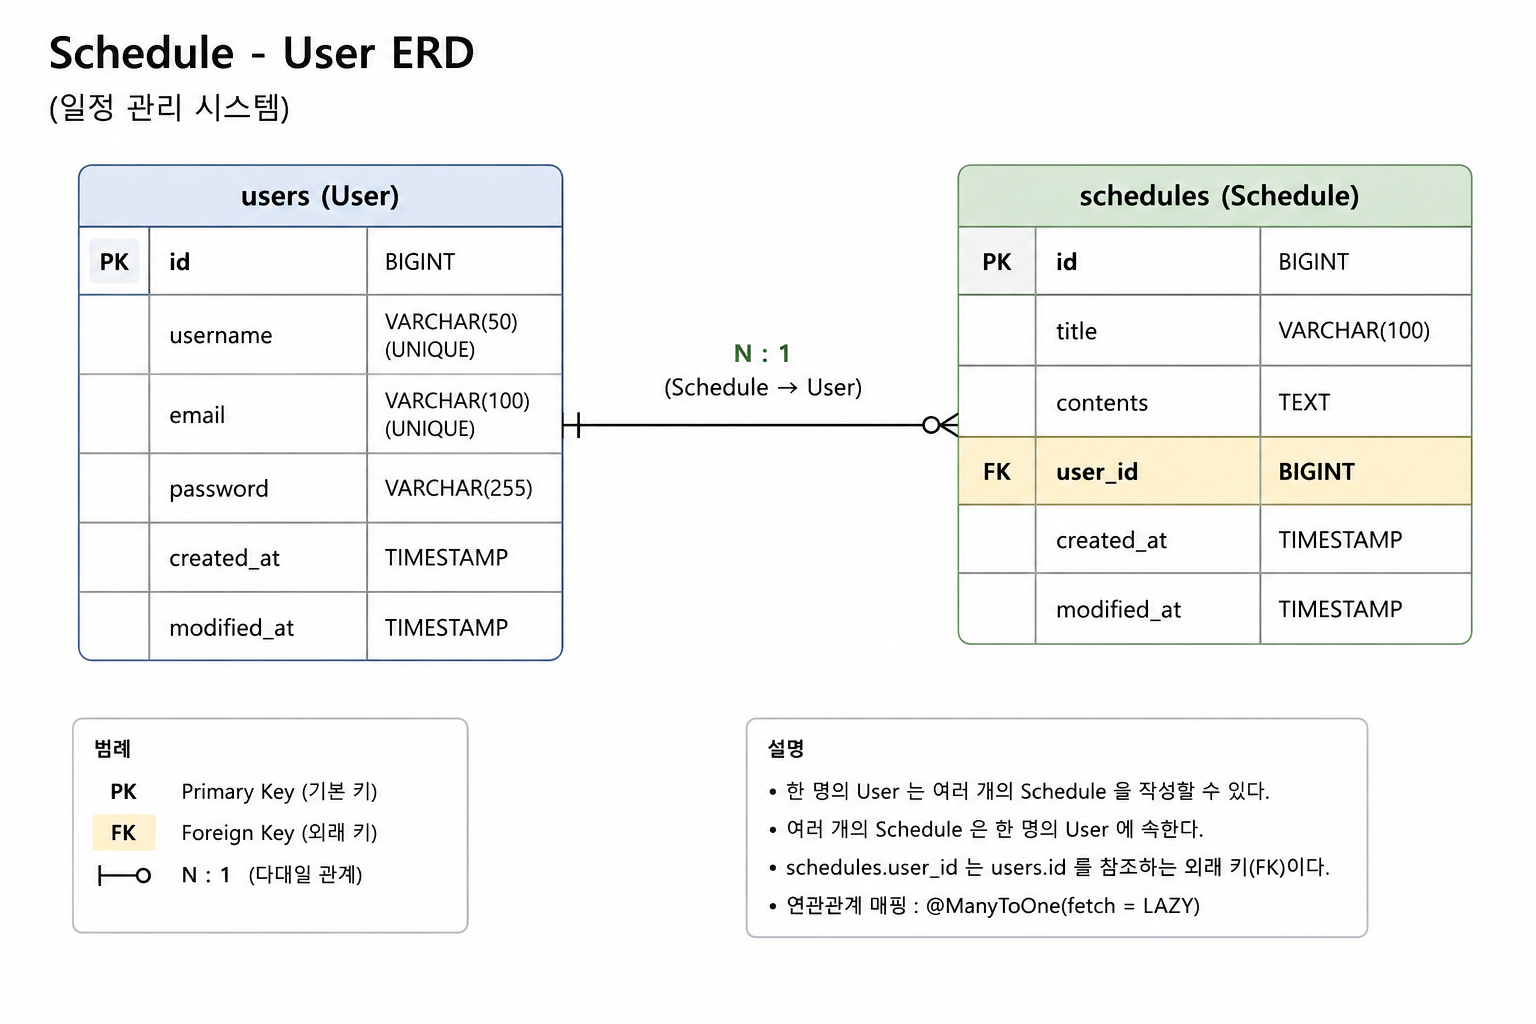
...
17.Spring 관리자 회원가입 구현: 입력 검증부터 BCrypt 비밀번호 저장까지
일반 사용자 서비스와 달리 백오피스 관리자는 상품, 고객, 주문 등 중요한 운영 데이터에 접근한다. 누구나 회원가입 직후 관리자 기능을 사용할 수 있다면 무분별한 계정 생성과 데이터 오남용으로 이어질 수 있다.따라서 관리자 회원가입은 단순히 계정을 생성하는 기능이 아니
18.Spring 고객 정보 관리 API 구현: 조회·수정·상태 변경과 JPA 변경 감지
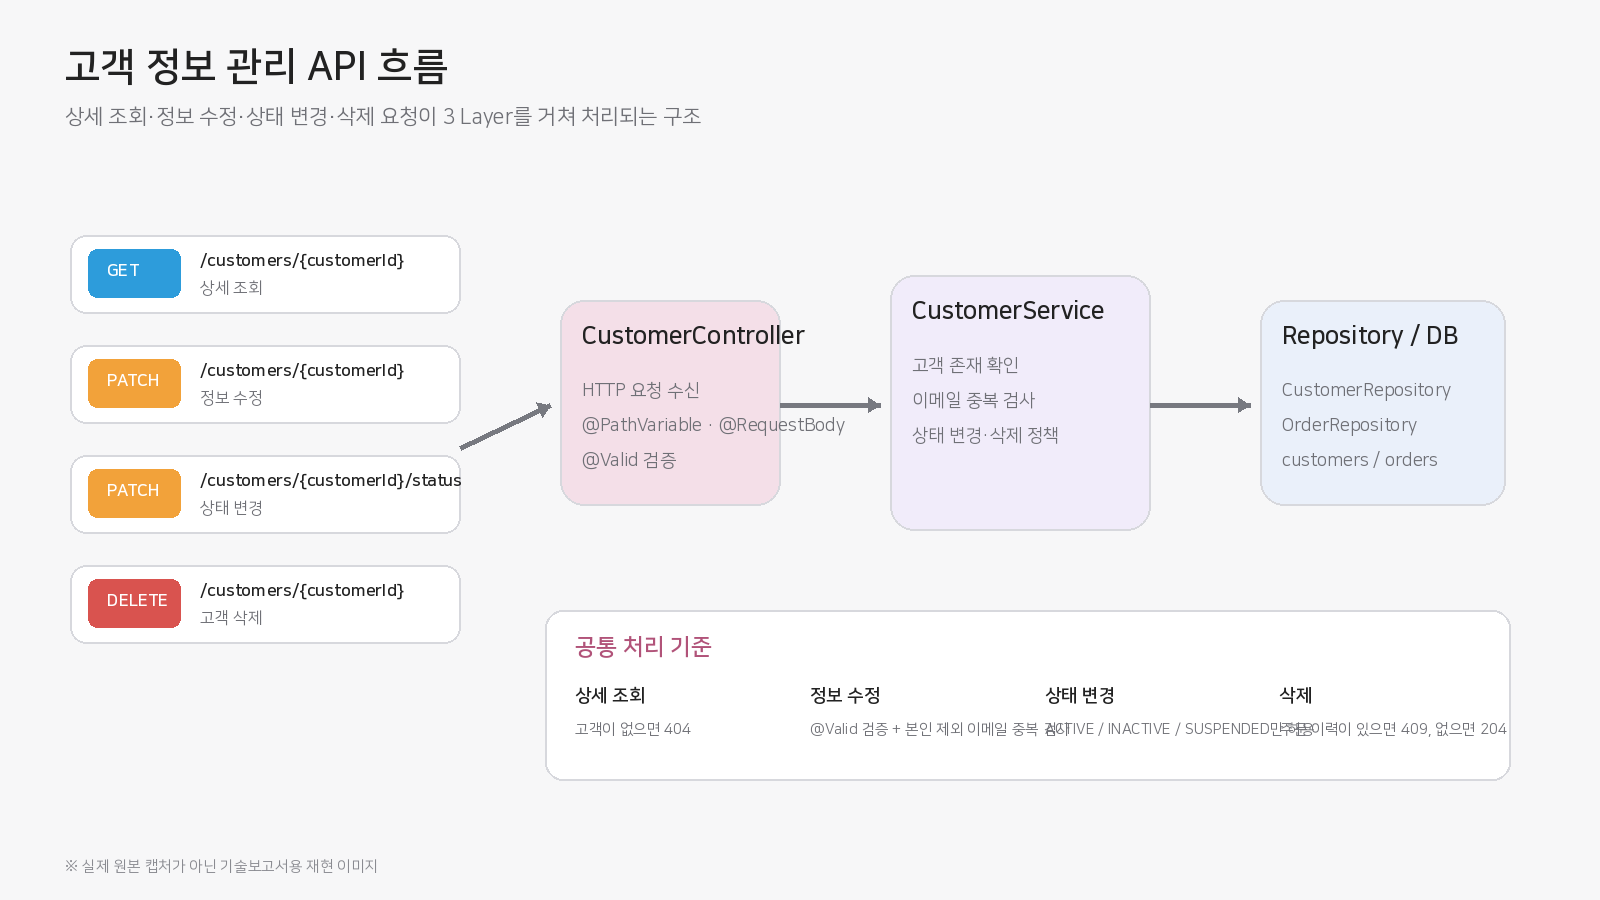
고객 정보 관리는 단순 CRUD가 아닌 이유 백오피스에서 고객 정보는 주문 조회, 고객 응대, 계정 상태 관리에 사용된다. 고객 데이터를 단순히 조회하고 삭제하는 것만으로는 충분하지 않다. 다음과 같은 규칙이 함께 필요하다. 이번 고객 정보 관리 기능에서는 다음
19.200 OK인데 검색은 되지 않았다 ㅡ JPA Specification 적용 과정
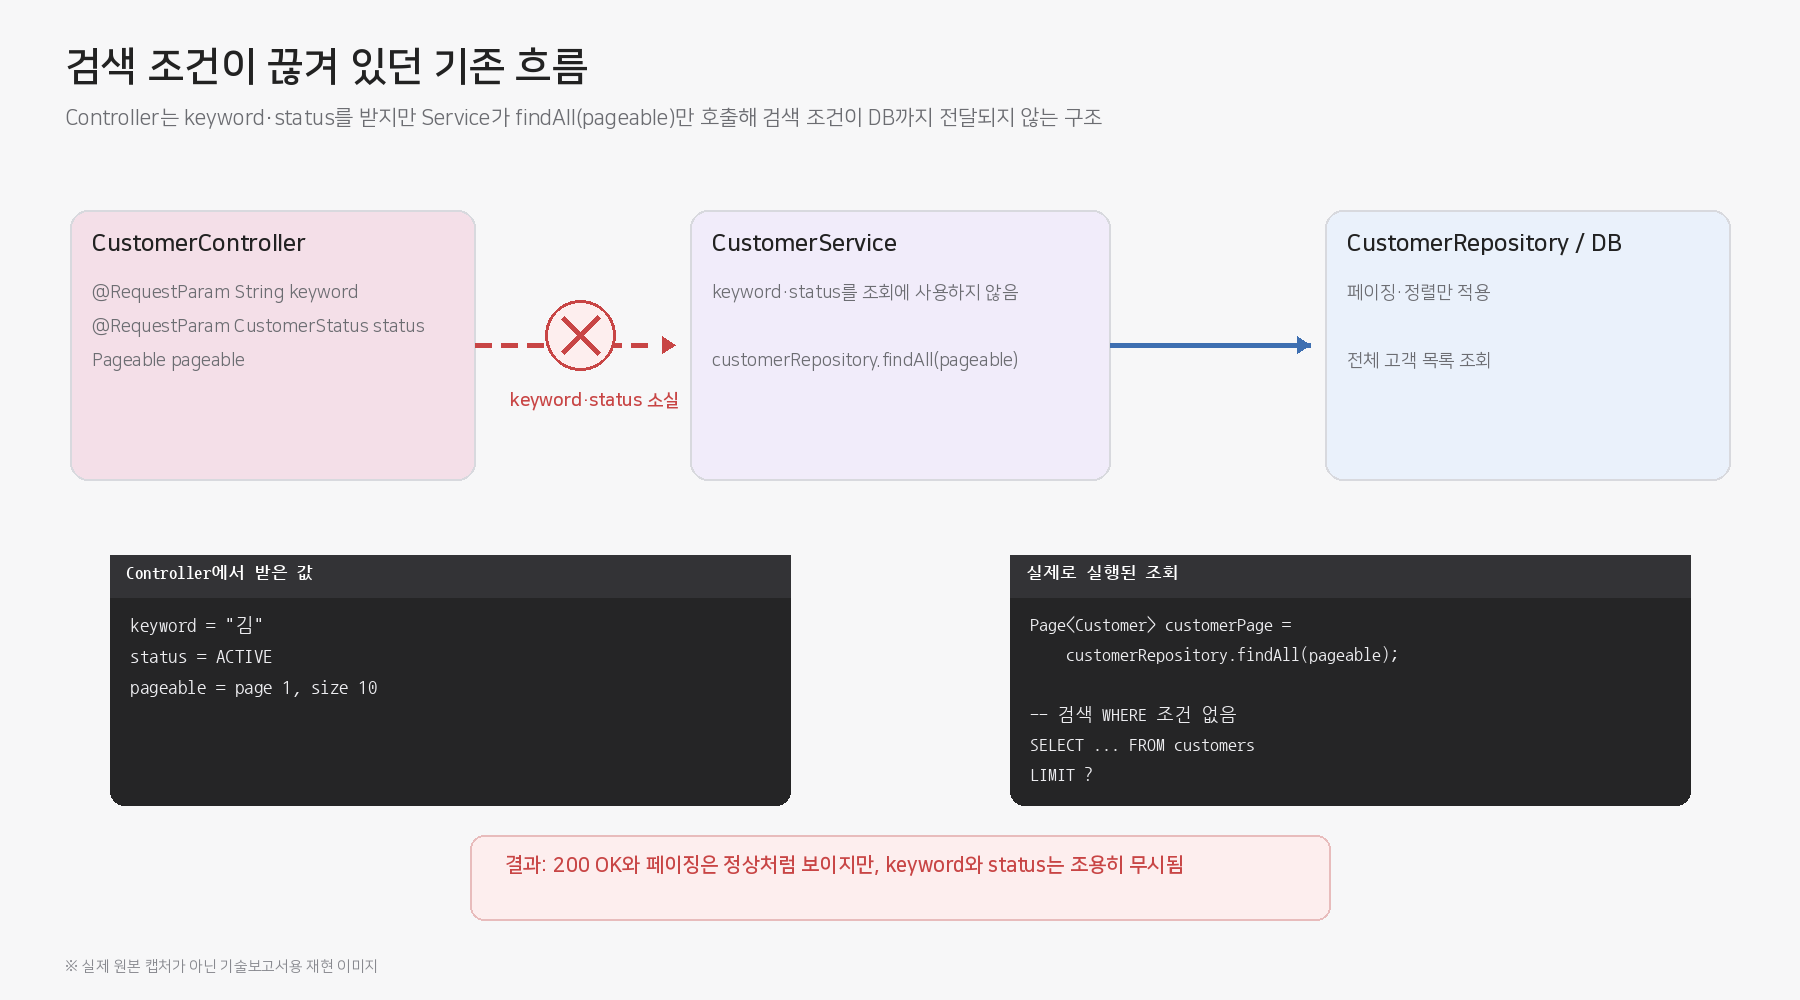
고객 정보 관리 파트를 인수받은 뒤 기존 코드의 요청 흐름을 다시 확인했다.고객 목록 Controller는 이미 keyword와 status를 요청 파라미터로 받고 있었다.그러나 Service에서는 검색 조건을 사용하지 않고 다음 코드만 실행하고 있었다.findAll(
20.Spring Data JPA 동적 쿼리 비교: @Query, Specification, Querydsl
검색 조건은 왜 동적으로 처리해야 하는가 관리자 페이지의 검색 조건은 항상 모두 입력되는 것이 아니다. 상품 목록을 예로 들면 사용자는 상품명만 검색할 수도 있고, 카테고리와 상태를 함께 선택할 수도 있으며, 아무 조건 없이 전체 목록을 조회할 수도 있다. 조건 조
21.JPA 영속성 컨텍스트의 핵심 원리와 엔티티 변경 흐름
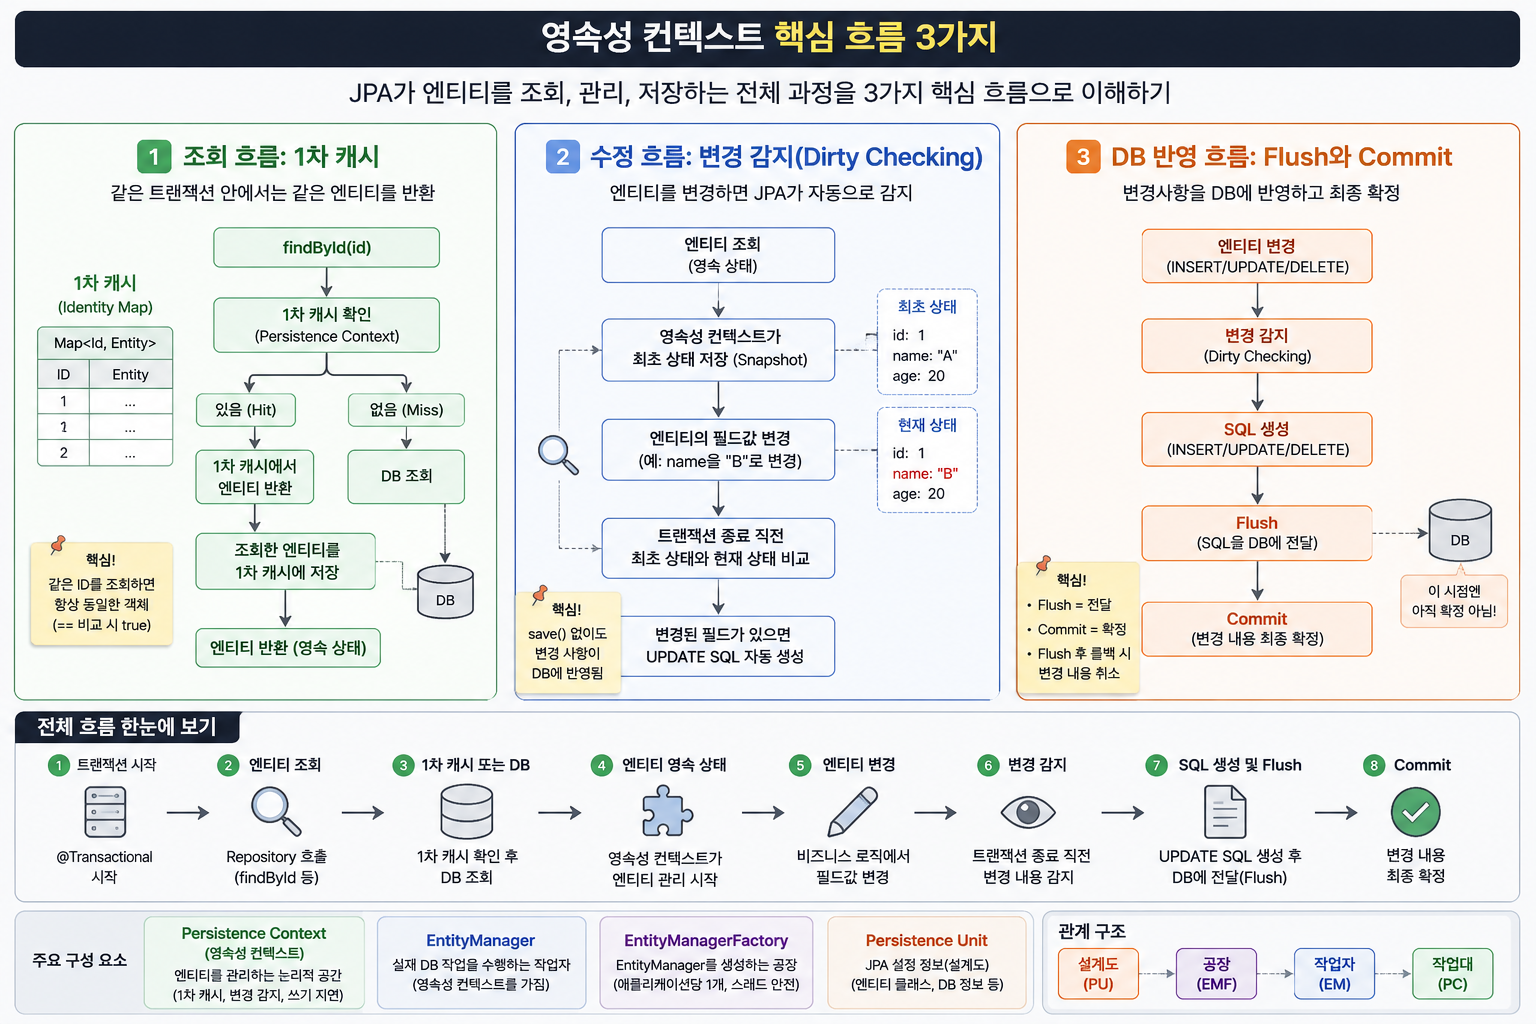
JPA는 엔티티를 조회하거나 변경할 때마다 곧바로 데이터베이스와 통신하지 않는다. 어플리케이션과 데이터베이스 사이에 영속성 컨텍스트라는 관리 공간을 두고, 트랜잭션 동안 엔티티의 상태를 추적한다.영속성 컨텍스트는 단순한 캐시가 아니라 다음 역할을 수행하는 논리적 공간이
22.Spring 트랜잭션 전파와 격리 수준
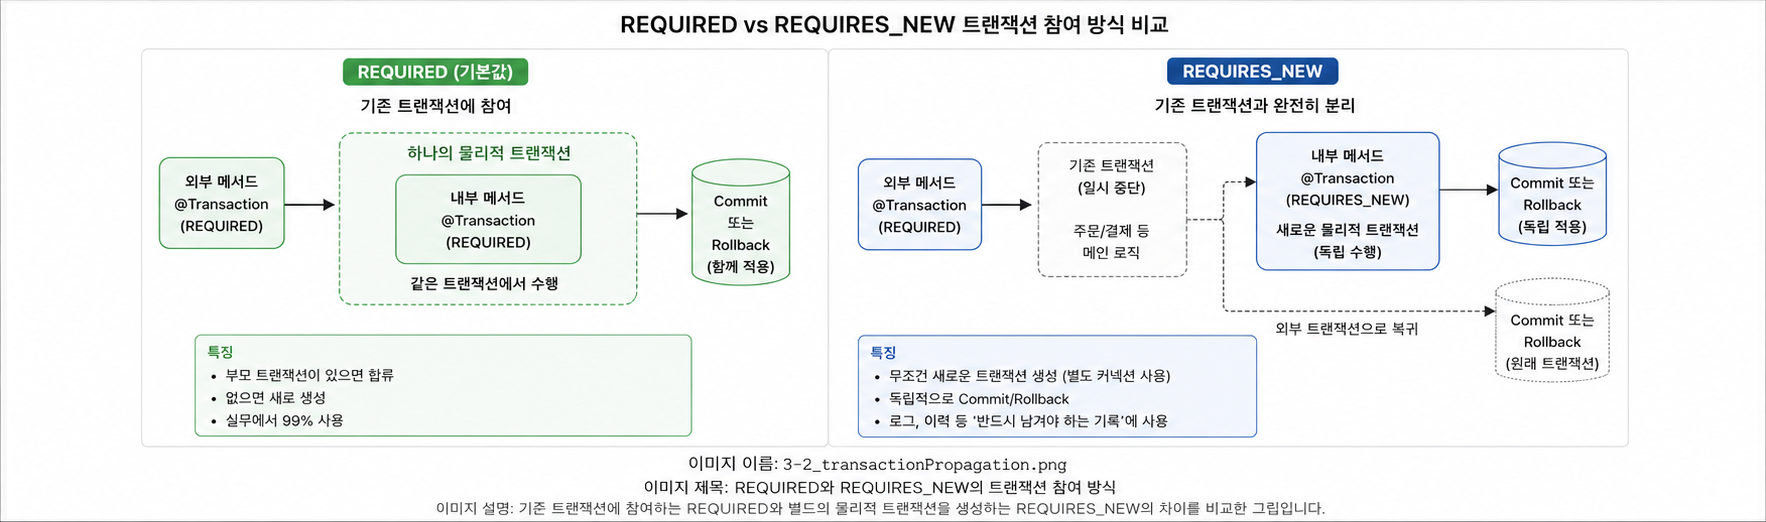
트랜잭션 전파는 내부 작업을 기존 트랜잭션과 함께 처리할지 분리할지 결정하고, 격리 수준은 동시에 실행되는 트랙잭션끼리 데이터를 어디까지 볼 수 있는지 결정한다.@Transactional 메서드 안에서 다른 @Transactional 메서드를 호출하면, 두 작업을 같은
23.JPA 연관관계 매핑과 지연 로딩 : 관계 설계에서 프록시까지
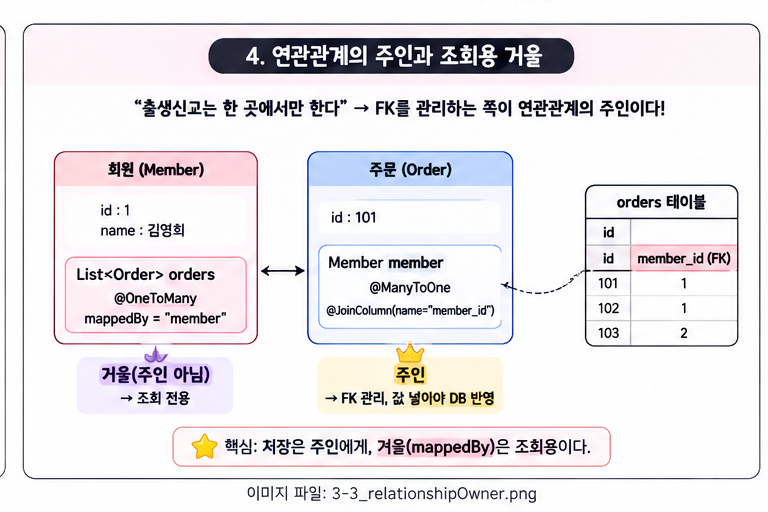
Java 객체는 참조를 따라 연관 객체에 접근한다.반면 DB는 외래 키(FK)를 기준으로 테이블을 JOIN한다.연관관계 어노테이션은 서로 다른 객체 세계와 테이블 세계를 연결하는 번역기 역할을 한다.1 : N 관계의 FK는 N쪽 테이블에 존재한다. 따라서 FK를 가진
24.JPA Cascade와 orphanRemoval : 부모와 자식의 생명주기 관리
반복되는 자식 저장을 줄이는 방법 부모와 자식을 함께 생성할 때 Cascade가 없다면 각각의 Repository를 직접 호출해야 한다. 부모가 자식의 생명주기를 완전히 관리하는 관계라면 이러한 코드는 반복적이다. 영속성 전이(Cascade)는 부모의 저장·삭제와 같은 영속성 상태 변화를 자식에게 자동으로 전달하여 이 문제를 줄인다. 단, 옵션을 지정하지...
25.Filter와 JWT를 활용한 인증 흐름 실습
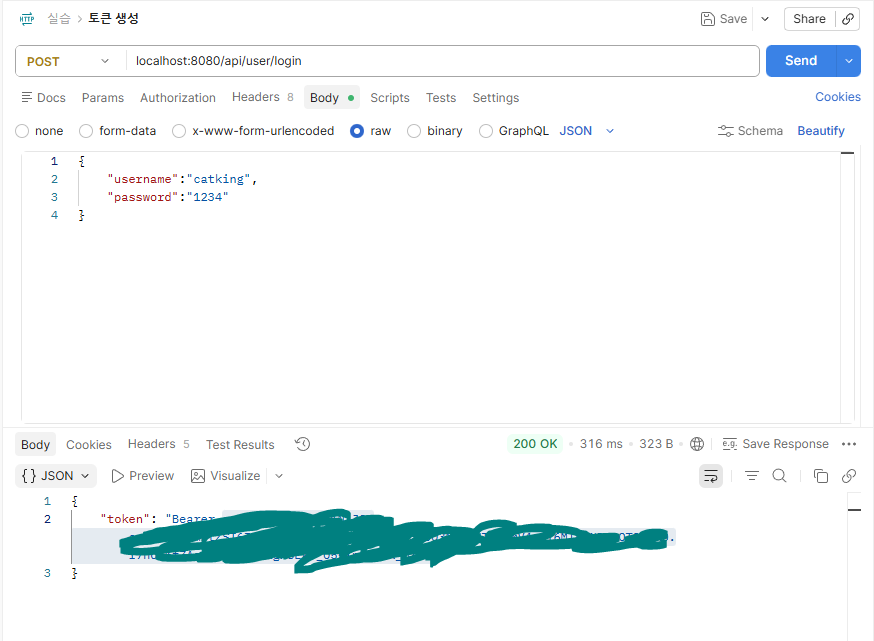
OncePerRequestFilter를 이용해 요청이 Controller에 도달하기 전에 실행되는 Filter를 구현했다.이후 JWT를 생성하고 검증하는 기능을 작성했으며, JwtFilter에서 다음 작업을 공통으로 처리하도록 구성하였다.로그인 API는 아직 JWT가
26.adv spring assn soon
27.Spring Security JWT 인증·인가 구현과 401·403 디버깅
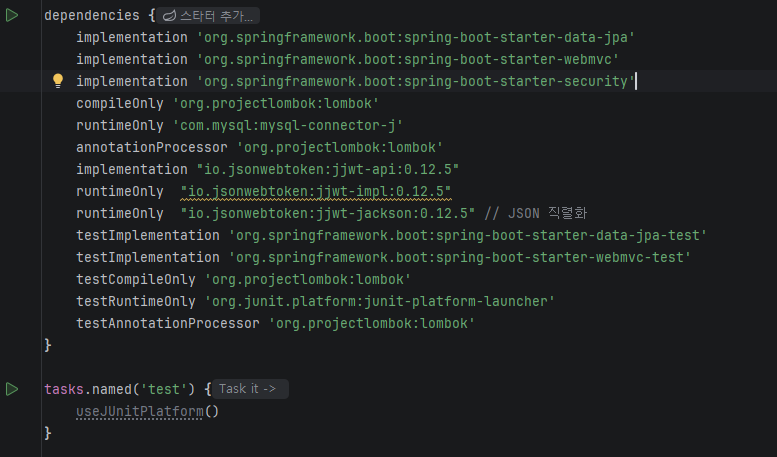
JWT를 사용하는 API에서는 보호된 요청이 들어올 때마다 토큰을 검사해야 한다. 이를 각 Controller에 직접 작성하면 같은 코드가 반복되고, 일부 API에서 인증 검사가 누락될 가능성도 생긴다.Spring Security는 Controller에 도착하기 전 단
28.AWS 네트워크 구축과 EC2를 이용한 Spring Boot 배포
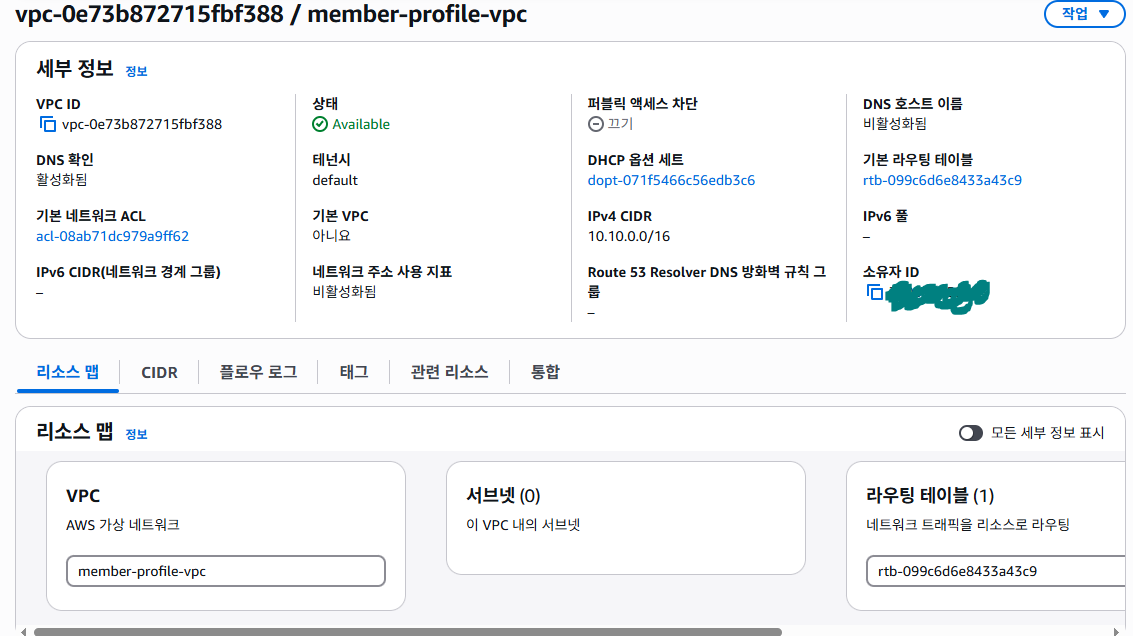
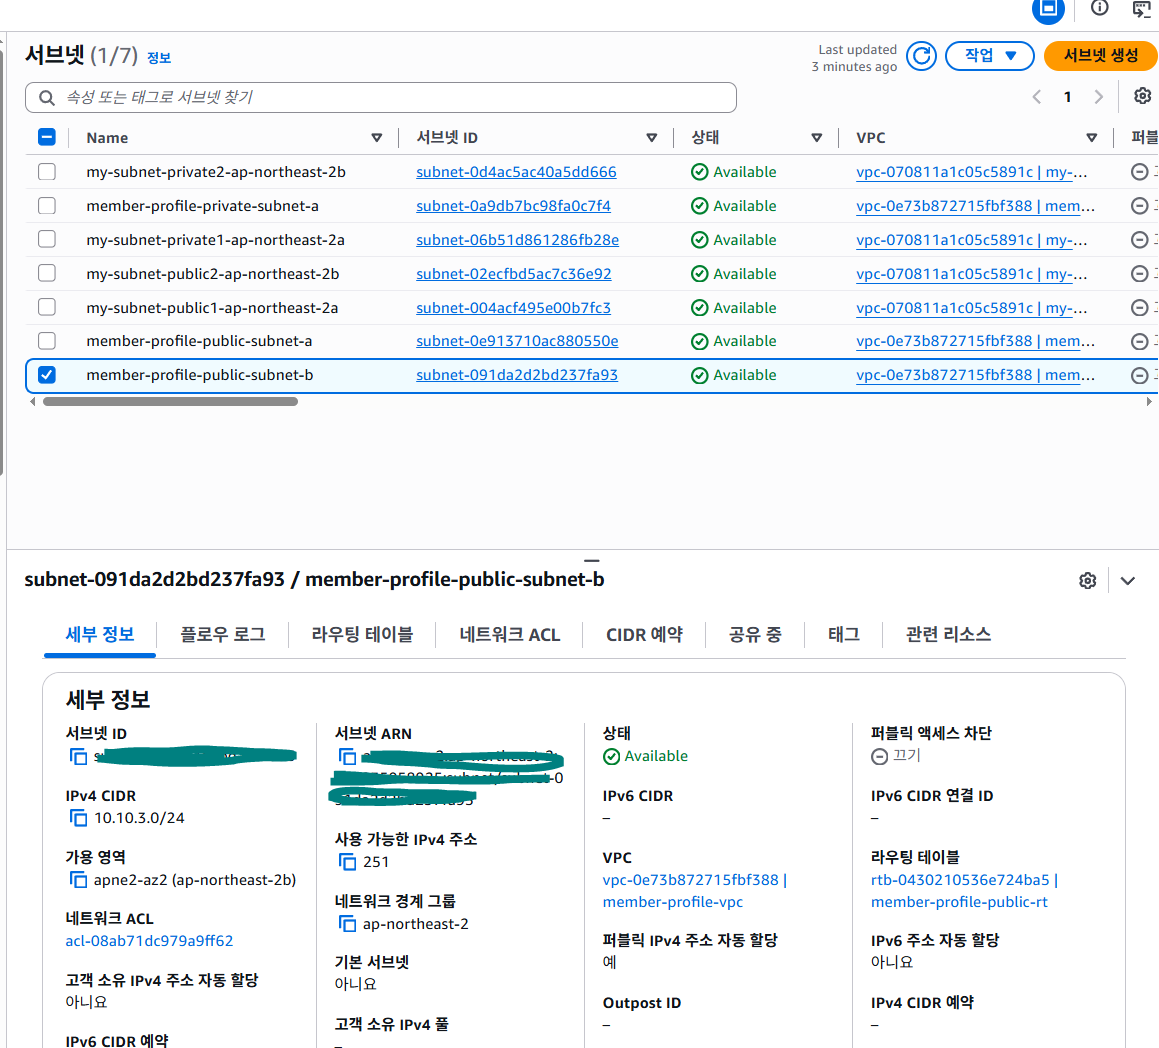
Spring Boot 어플리케이션을 외부에서도 사용할 수 있도록 AWS 네트워크를 직접 구성하고 EC2에 배포하였다.이번 과정의 핵심은 어플리케이션을 실행하는 것보다, 서비스가 인터넷과 통신하기 위한 네트워크를 이해하는 것AWS에서는 EC2만 생성한다고 인터넷과 연결되
29.AWS RDS 연동과 Parameter Store를 이용한 안전한 DB 구성
로컬 H2 데이터베이스는 개발과 테스트에는 편리하지만, 서버가 종료되면 운영 데이터를 안정적으로 보존하기 어렵다. 또한 DB 주소와 비밀번호를 코드에 직접 작성하면 저장소를 통해 민감 정보가 노출될 수 있다.이를 해결하기 위해 MySQL RDS를 어플리케이션 서버와 분
30.S3를 이용한 프로필 이미지 저장과 Presigned URL 기반 접근 제어
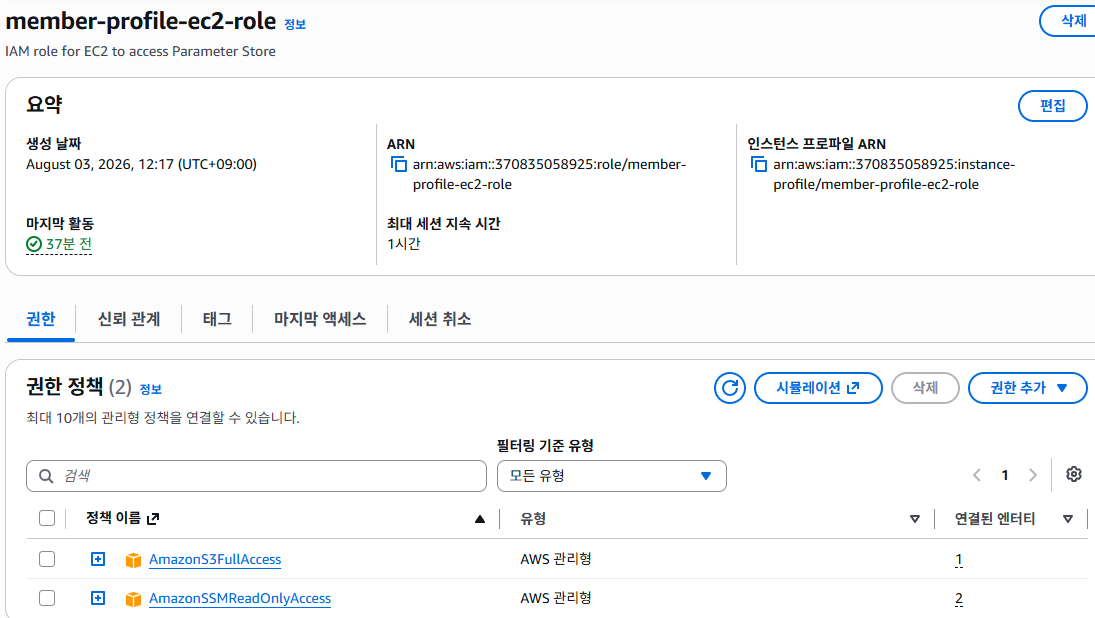
프로필 이미지를 EC2 내부 디스크에 저장하면 인스턴스가 교체되거나 삭제될 때 파일도 함께 사라질 수 있다. 어플리케이션 서버가 파일 저장까지 담당하면 서버 확장과 운영 관리도 복잡해진다.이를 해결하기 위해 이미지는 Amazon S3에 저장하고, Spring Boot와
31.Docker로 Spring Boot 와 MySQL 실행 환경 표준화하기
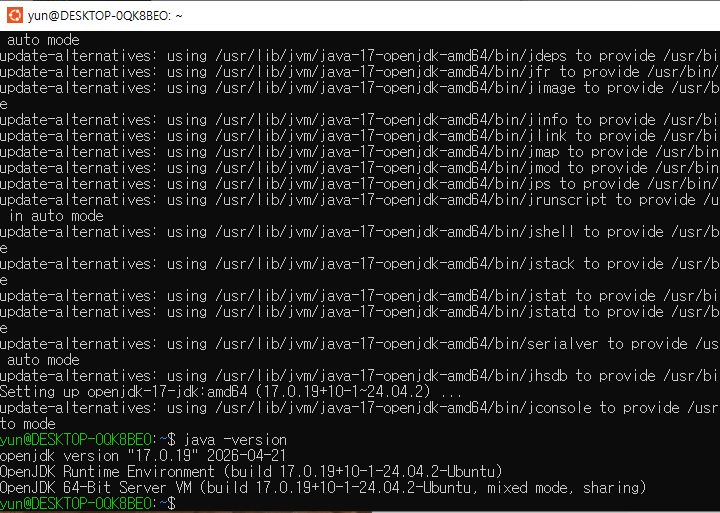
기존에는 서버에 SSH로 접속한 뒤 Java를 설치하고, JAR 파일을 복사한 다음 java -jar 명령으로 어플리케이션을 실행했다.이 방식은 서버마다 다음 조건을 직접 맞춰야 한다.올바른 Java 버전이 설치되어 있는가??필요한 파일이 정확한 위치에 있는가?실행 명
32.record vs 일반 class(Spring Security CustomUserPrincipal)
JWT 인증에서 로그인 사용자 정보를 담는 CustomUserPrincipal을record로 만들지 class로 만들지 고민했다.이번 과정의 핵심은 "record가 더 짧다"가 아니라,"record의 접근자 규칙이 기존 팀 코드와 맞는가"를 이해하는 것이었다.Custo
33.인증(Authentication) vs 인가(Authorization)
Spring Security로 JWT 로그인을 붙이면서 "인증"과 "인가"를 자꾸 뭉뚱그려 생각했다.이번 과정의 핵심은 "로그인 기능을 만드는 것"이 아니라,"너 누구야(인증)"와 "너 이거 해도 돼?(인가)"가 서로 다른 단계라는 걸 이해하는 것이었다.두 개념은 이름
34.JWT 인증 필터의 동작 흐름 (OncePerRequestFilter)
JWT 로그인은 만들었지만, "토큰이 실제로 어느 순간에 검증되고컨트롤러는 어떻게 로그인 사용자를 아는지"가 흐릿했다.이번 과정의 핵심은 "필터를 등록하는 것"이 아니라,요청 한 번이 필터를 거쳐 인증되는 흐름 전체를 이해하는 것이었다.JWT 인증은 컨트롤러가 아니라
35.401은 왜 @RestControllerAdvice가 아니라 EntryPoint가 처리하나
예외는 다 @RestControllerAdvice(GlobalExceptionHandler)가 잡는 줄 알았는데,인증 실패(401)만은 그게 안 잡고 다른 곳에서 응답이 만들어졌다.이번 과정의 핵심은 "예외 처리기를 하나 만드는 것"이 아니라,요청이 컨트롤러에 도달하기
36.엔티티 설계: DB 제약 vs 애플리케이션 검증, 그리고 불변식을 엔티티에 담기
상품(Product) 엔티티를 만들면서 @Column(columnDefinition = "TEXT")를 처음 써봤고,재고 차감/복구 같은 규칙을 어디에 둘지 고민했다.이번 과정의 핵심은 "애노테이션을 붙이는 법"이 아니라,잘못된 값을 어느 층(DB / 애플리케이션)에서
37.N+1 문제: CartItem → Product 지연 로딩과 Fetch Join
장바구니 조회가 쿼리 한 방이면 될 줄 알았는데, 로그를 보니 상품 수만큼 SELECT가 더 나갔다.이번 과정의 핵심은 "Fetch Join을 쓰는 법"이 아니라,지연 로딩이 언제 추가 쿼리를 쏘는지 이해하고, 연관 데이터가 반드시 필요한 조회에서는그걸 한 번에 가져오
38.JUnit·Mockito로 결제 서비스 테스트를 고치며 이해한 단위 테스트의 핵심
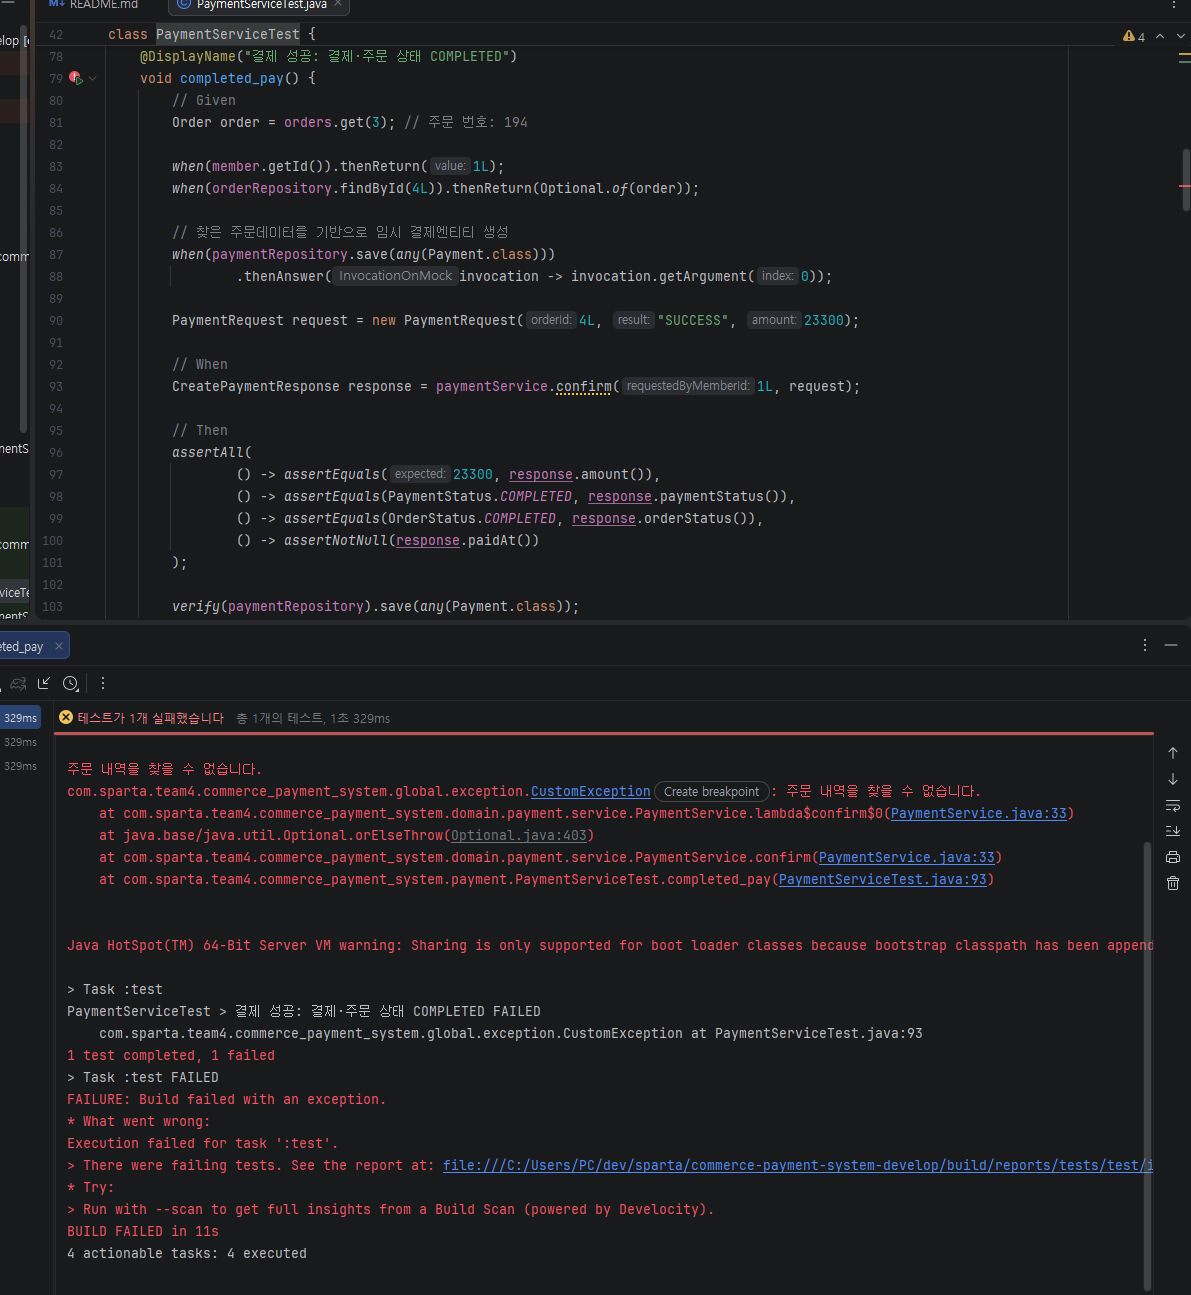
기능을 한 번 정상 동작시켰다고 해서 이후에도 계속 정상이라는 보장은 없다. 새로운 기능을 추가하거나 기존 코드를 리팩토링하면, 직접 수정하지 않은 기능까지 영향을 받을 수 있다.테스트 코드의 역할은 이때 "기존 동작이 여전히 유지되고 있는가??"를 자동으로 확인하는