Day 61
Iterm)
빅데이터의 정의
빅데이터의 정의1
서버 한대로 처리할 수 없는 규모의 데이터
판다스로 처리해야할 데이터가 너무 커서 처리가 불가능하다면 어떻게 해야할까?
빅데이터의 정의2
기존의 소프트웨어로는 처리할 수 없는 규모의 데이터
대표적인 기존 소프트웨어 오라클이나 mysql과 같은 관계형 데이터베이스
- 분산환경을 염두에 두지 않음
scale-up 접근 방식
메모리 추가 cpu 추가 디스크 추가
빅데이터의 정의3
4v
volume, velocity, variety,veracity(품질)
빅데이터 처리의 특징은?
먼저 큰 데이터를 손실없이 보관할 방법이 필요: 스토리지
처리 시간이 오래 걸림: 병렬처리
이런 데이터들을 비구조화된 데이터일 가능성이 높음: sql 만으로는 부족
예를 들면 웹 로그 파일
- 구조는 있지만 쉽게 parsing할 수 있는 데이터는 아니다. 단순히 sql문으로만 할 수 는 없음
해결 방안은?
큰 데이터를 손실없이 보관할 방법이 필요
- 큰 데이터 저장이 가능한 분산 파일 시스템이 필요
시간이 오래 걸림
- 병렬 처리가 가능한 분산 컴퓨팅 시스템이 필요
이런 데이터들은 비구조화된 데이터일 가능성이 높음
비구조화 데이터를 처리할 방법이 필요
대용량 분산 시스템이란?
분산 환경 기반
- 분산 파일 시스템과 분산 컴퓨팅 시스템이 필요
fault tolerance
소수의 서버가 고장나도 동작해야함
확장이 용이해야함
scale out이 되어야함
하둡의 등장과 소개
다수의 노드로 구성된 클러스터 시스템
마치 하나의 거대한 컴퓨터처럼 동작
사실은 다수의 컴퓨터들이 복잡한 소프트웨어로 통제됨
하둡 1세대
mapreduce 라는 분산 컴퓨팅 시스템이 도는 구조
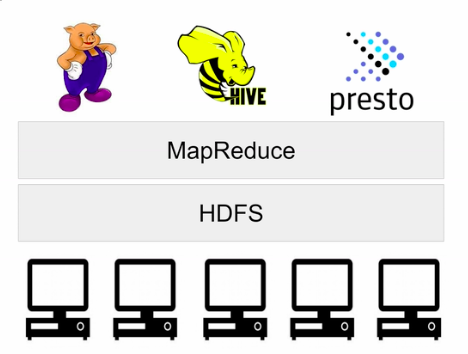
하둡 2세대는 아키테거가 크게 변경되었다
하둡은 yarn이란 이름의 분산처리 시스템위에서 동작하는 애플리케이션이 됨
spark은 yarn위에서 어플리케이션 레이어로 실행됨
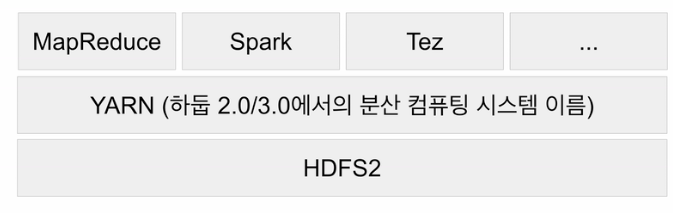
yarn은 분산 컴퓨팅 시스템 (resource management layer)
HDFS - 분산 파일 시스템
데이터를 블록단위로 나눠 저장
블록의 크기는 128MB
블록 복제 방식
각 블록은 3군데에 중복 저장됨
fault tolerance를 보장할 수 있는 방식으로 이블록들을 저장됨
하둡 2세대 네임노드 이중화 지원
acitive & standby
둘 사이에 share edit log가 존재
secondary 네임 노드는 여전히 존재
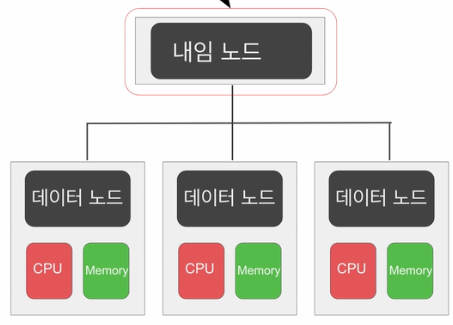
Mapreduce 분산 컴퓨팅 시스템
하둡 1.0
하나의 잡 트래커와 다수의 태스크 트래커로 구성됨
잡 트래커가 일을 나눠서 다수의 태스크 트래커에게 분배
태스크 트래커에서 병렬 처리
mapreduce만 지원 제너럴한 시스템이 아님.
분산 컴퓨팅 시스템 : 하둡 2.0(yarn 1.0)
세부 리소스 관리가 가능한 범용 컴퓨팅 프레임 웍
리소스 매니저
- job scheduler, application manager
노드 매니저
컨테이너
- 앱 마스터
- 태스크
spark이 이 위에서 구현된다.
slave 마다 노드 매니저가 설치 되어있음
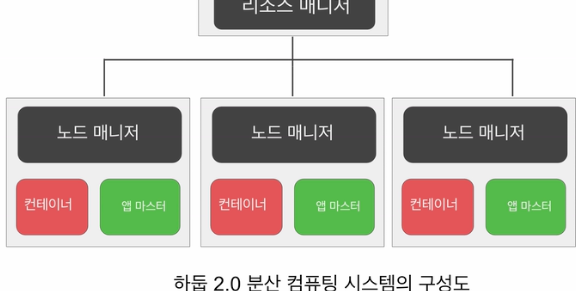
슬레이브 마다 노드 매니저가 설치되어있음. 서버에 해당하는 리소스를 관리하는데 여기서 리소스는 컨테이너를 의미한다. java에서 얘기하는 jvm임. 다수의 컨테이너가 있을 수 있음.
하나의 태스크가 보고가 없거나, 오류 보고가 올라왔다면 앱마스터는 해당 태스크를 대신할 컨테이너를 리소스 매니저로부터 받아서 대신할 컨테이너를 찾아서 태스크 실행 -> fault tolerance를 보장
yarn의 동작
- 실행하려는 코드와 환경 정보를 RM에게 넘김 (리소스 매니저)
실행에 필요한 파일들은 application id에 해당하는 hdfs 폴더에 복사가 미리 복사됨 - 리소스 매니저는 노드 매니저로부터 컨테이너를 받아 applicaiton master 실행
어플리케이션 마스터는 프로그램마다 하나씩 할당되는 프로그램 마스터에 해당 - 앱마스터는 입력 데이터 처리에 필요한 리소스를 rm에게 요구, rm은 data locality를 고려해서 리소스 즉 컨테이너를 할당
- 앱마스터는 할당받은 리소스를 노드매니저를 통해 컨테이너로 론치하고 그 안에서 코드를 실행
이 때 실행에 필요한 파일들이 hdfs에서 컨테이너가 있는 서버로 먼저 복사 - 각 태스크는 상황을 주기적으로 am에게 보고
태스크가 실패하거나 보고가 오랜 시간 없으면 태스크를 다른 컨테이너로 재실행
클라이언트 -> resource mananger
-> 노드매니저 (컨테이너/ 앱마스터) -> 리소스 매니저 리소스 할당
-> 노드 매니저에게 컨테이너들을 받아 태스크 실행
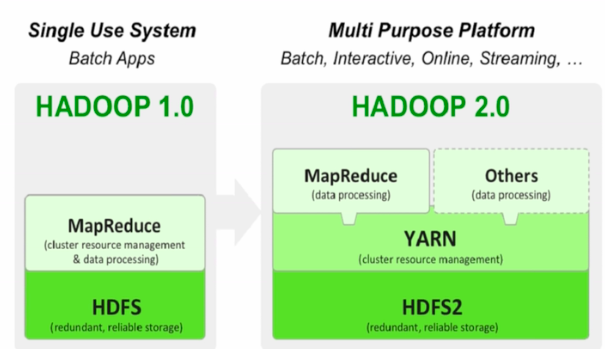
하둡 3.0 세대가 나왔음
yarn 2.0을 사용
yarn 프로그램들이 논리적인 그룹으로 나눠서 자원 관리가 가능.
이를 통해 데이터 수집 프로세스와 데이터 서빙 프로세스를 나눠서 관리 가능
타임라인 서버에서 hbase를 기본 스토리지로 사용
파일 시스템
네임노드의 경우 다수의 스탠바이 내임노드를 지원
HDFS, S3, Azure Storage 이외에도 Azure Data Lake Storage
맵리듀스 프로그래밍
맵리듀스 프로그래밍은 기존 프로그램이과 어떻게 다를까?
맵리듀스 프로그래밍의 특징
데이터 셋은 key, value의 집합이며 변경 불가
데이터 조작은 map과 reduce 두 개의 오퍼레이션으로만 가능
이 두 오퍼레이션은 항상 하나의 쌍으로 연속으로 실행됨
이 두 오퍼레이션의 코드를 개발자가 채워야함
맵리듀스 시스템이 map의 결과를 reduce 단으로 모아줌
이 단계를 보통 셔플링이라 부르며 네트웍단을 통한 데이터 이동이 생김.
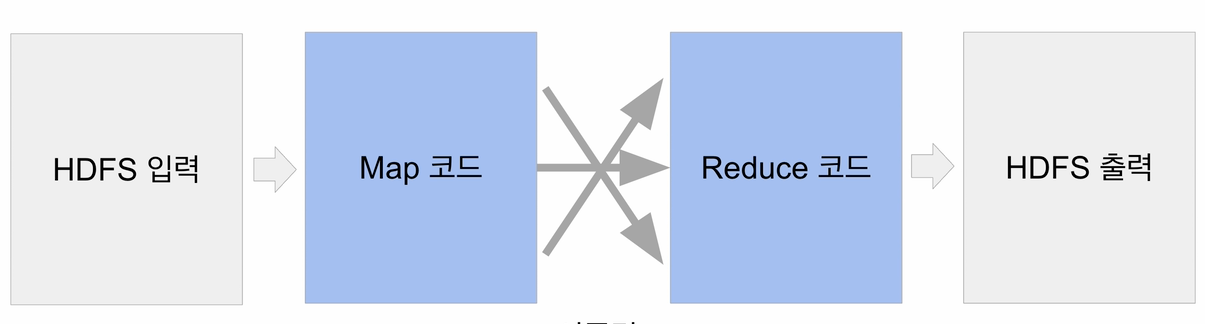
셔플링이됨
map, reduce 코드만 우리가 작성하면된다.
입출력은 알아서 시스템이 해준다.
맵의 아웃풋을 받아서 같은 key를 갖는 value들을 list로 만들어서 reduce로 입력해주는 것이 셔플링이라고함.
yarn이라면 jvm 내의 돌아가는 코드임. 즉 map과 reduce가 돌아가는 서버가 다름. map의 출력이 시스템에 의해서 같은 key를 갖는 경우 묶여서 reduce서버로 전송이되어야함. 데이터의 크기에 따라 다르겠지만, 네트웍을 따라 전송이 활발하게 벌어짐. 이 과정이 셔플링이라고함. 셔플링으로 이동하는 데이터가 커진다고 하면, 전체적으로 시간이 오래걸림.
Map: (k, v) -> [(k', v')*]
▪ 입력은 시스템에 의해 주어지며 입력으로 지정된 HDFS 파일에서 넘어옴
▪ 키,밸류 페어를 새로운 키,밸류 페어 리스트로 변환 (transformation)
▪ 출력:입력과동일한키,밸류페어를그대로출력해도되고출력이없어도
됨
여기서 중요한 점은 맵의 입력은 우리가 정하는 것이 아님. hdfs 입력 file에서 자동으로 들어가는 것
Reduce: (k’, [v1’, v2’, v3’, v4’, ...]) -> (k’’, v'') ▪ 입력은 시스템에 의해 주어짐
• 맵의 출력 중 같은 키를 갖는 키/밸류 페어를 시스템이 묶어서 입력으로 넣어줌
▪ 키와 밸류 리스트를 새로운 키,밸류 페어로 변환 -> SQL의 GROUP BY와 흡사
▪ 출력이 HDFS에 저장됨
shuffling
hdfs의 인풋이 3개의 file로 구성되어 있다면, mapper가 3개가 형성될 것임, 일반적으로(한 블록의 최대 사이즈 128mb) 이것 보다 작으면 하나의 mapper로 처리될 수 있음.
입력은 시스템 코드는 개발자
mapper의 출력을 reducer로 보내주는 프로세스를 말함
전송되는 데이터의 크기가 크면 네트웍 병목을 초래하고 시간이 오래 걸림
sorting
모든 mapper의 출력을 reducer가 받으면 이를 키별로 소팅
map reduce : Data skew
각 태스크가 처리하는 데이터 크기에 불균형이 존재한다면?
병렬 처리의 큰 의미가 없음. 가장 느린 태스크가 전체 처리 속도를 결정
특히 reducer로 오는 나눠지는 데이터의 크기는 큰 차이가 있을 수 있음
groupby 나 join등이 이에 해당함
처리 방식에 따라 reducer의 수에 다라 메모리 에러등이 날 수 있음
데이터 엔지니어가 고생하는 이유중의 하나
빅데이터 시스템에는 이 문제가 모두 존재
MapReduce 프로그래밍의 문제점
- 낮은 생산성
프로그래밍 모델이 가진 융통성 부족
튜닝/최적화가 쉽지 않음
데이터 분포가 균등하지 않은 경우
배치 작업 중심
기본적으로 Low Latency가 아니라 Throughput에 초점이 맞춰짐
그래서 대안들의 등장
yarn, spark
sql의 컴백 hive와 presto
hive - mapreduce위에서 구현됨. Throughput에 초점. 대용량 ETL에 적합
presto - low latency에서 초점. 메모리를 주로 사용. adhoc 쿼리에 적합
aws athena가 presto 기반.
apache spark
하둡은 1세대 빅데이터 처리 기술이라면 saprk은 2세대 빅데이터 기술이다.
yarn등을 분산환경으로 사용
scala로 작성됨
빅데이터 처리 관련 다양한 기능 제공
spark 구성
❖ Spark Core
❖ Spark SQL
❖ Spark ML - RDD 기반
- Spark MLlib - 데이터프레임 기반/ 없어지는 추세
❖ Spark Streaming
❖ Spark GraphX
spark vs mapreduce
Spark은 기본적으로 메모리 기반
맵리듀스는 속도가 느림 - low latency를 지원 x
● 메모리가 부족해지면 디스크 사용
● MapReduce는 디스크 기반
❖ MapReduce는 하둡(YARN)위에서만 동작
● Spark은 하둡(YARN)이외에도 다른 분산 컴퓨팅 환경 지원 (K8s, Mesos) ❖ MapReduce는 키와 밸류 기반 데이터 구조만 지원
● Spark은 판다스 데이터프레임과 개념적으로 동일한 데이터 구조 지원
❖ Spark은 다양한 방식의 컴퓨팅을 지원
● 배치 데이터 처리, 스트림 데이터 처리, SQL, 머신 러닝, 그래프 분석
spark 프로그래밍 api
RDD (resilient Distributed Dataset)
로우 레벨 프로그래밍 api로 세밀한 제어가 가능
하지만 코딩 복잡도 증가
DataFrame & Dataset
● 하이레벨 프로그래밍 API로 점점 많이 사용되는 추세
● 구조화 데이터 조작이라면 보통 Spark SQL을 사용
● DataFrame/Dataset이 꼭 필요한 경우는?
▪ ML 피쳐 엔지니어링을 하거나 Spark ML을 쓰는 경우
▪ SQL만으로 할 수 없는 일의 경우
- dataset 단의 문제 일때
spark sql
spark sql은 구조화된 데이터 처리를 sql로 처리
데이터 프레임을 sql로 처리 가능
데이터 프레임은 테이블처럼 sql로 처리 가능
판다스도 동일 기능 제공
hive 쿼리 보다 최대 100배 빠른 성능을 보장
사실은 그렇지 않음 hive도 그 사이에 메모리를 쓰는 걸로 발전
hive 디스크 -> 메모리
spark 메모리 -> 디스크
presto 메모리 -> 디스크
Spark 데이터 시스템 사용 예들
❖ 기본적으로 대용량 데이터 배치 처리, 스트림 처리, 모델 빌딩
● 예 1) 대용량 비구조화된 데이터 처리하기 (ETL 혹은 ELT)
- 배치 프로세싱
로그데이터 -> storage data lake -> spark -> 데이터 웨어하우스
ml 모델에 사용되는 대용량 피쳐 처리
amazon s3, redshift, kinesis -> spark -> nosql (cassandra, hbase) -> mlapi
스트리밍 일때는 kafka, spark streaming
● 예 2) ML 모델에 사용되는 대용량 피쳐 처리 (배치/스트림)
● 예 3) Spark ML을 이용한 대용량 훈련 데이터 모델 학습
spark 프로그램 실행 환경
❖ 개발/테스트/학습 환경 (Interactive Clients)
● 노트북 (주피터, 제플린) 제플린은 spark 전용 notebook
● Spark Shell
❖ 프로덕션 환경 (Submit Job)
● spark-submit (command-line utility): 가장 많이 사용됨
● 데이터브릭스 노트북:
▪ 노트북 코드를 주기적으로 실행해주는 것이 가능
● REST API:
▪ Spark Standalone 모드에서만 가능
▪ API를 통해 Spark 잡을 실행
▪ 실행코드는 미리 HDFS등의 파일 시스템에 적재되어 있어야함
spark 프로그램의 구조
driver
실행되는 코드의 마스터 역할 수행 - yarn의 application master
executor
실제 태스크를 실행해주는 역할 수행 - yarn의 컨테이너
spark cluster)
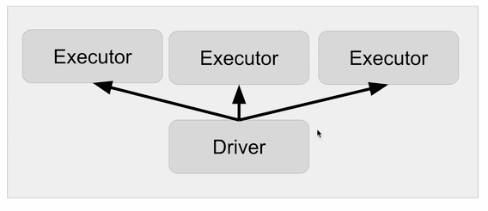
driver는 앱마스터이다. 내가 실행하려는 스파크 코드를 지휘하는 역할
client 모드, cluster 모드에 따라 실행되는 곳이 달라짐
--num-executors, --executor-cores, --executor-memory
spark job의 몇개의 executer, 몇개의 cpu, 메모리 양
spark submit이라는 커맨드라인을 쓸 때 지정
yarn의 resource manager는 spark 애플리케이션의 driver역할을 수행한다.
cluster 모드로 돌 때는 , driver가 yarn cluster안에서 컨테이너를 하나 잡아서 움직이는데 이게 앱마스터가 된다.
코드를 실행하는데 필요한 리소스를 지정함.
sparkcontext를 만들어 spark 클러스터와 통신 수행
cluster manager (yarn의 경우 resource manager)
executor yarn의 경우 container
사용자의 코드를 실제 spark 태스크로 변환해 spark 클러스터에서 실행
executor:
실제 태스크를 실행해주는 역할 수행 (JVM) : transformations, actions
yarn에서는 container가 됨.
spark 클러스터 매니저 옵션
❖ local[n] - 실습 / n은 몇개의 스레드를 띄울꺼냐
❖ YARN - yarn위에서 동작
❖ Kubernetes - 대용량 컨테이너가 이미 준비되어 있을 때
❖ Mesos
❖ Standalone- spark 자체의 cluster를 이용하고 싶다면 / 잘 사용 x
yarn
두 개의 실행 모드가 존재 : client vs cluster
client 모드 : driver가 spark 클러스터 밖에서 동작
yarn 기반 spark 클러스터를 바탕으로 개발 / 테스트 등을 할 때 사용
cluster 모드: driver가 spark 클러스터 안에서 동작
- 하나의 executor 슬롯을 차지
- 실제 프로덕션 운영에 사용되는 모드!!
client 모델
driver가 application manager해당하는 것이 안에 있지 않고 밖에 있는 것임. 밖에 있기 때문에 driver가 notebook 혹은 spark shell
클러스터 매니저
실행 모드 (deployed mode)
프로그램 실행 방식
local[n]
Client
Spark Shell, IDE, 노트북
YARN
Client
Spark Shell, 노트북
YARN
Cluster
spark-submit
GPT
YARN 위에서 Spark가 동작하는 경우, Spark 애플리케이션은 YARN 클러스터 매니저인 ResourceManager와 통신하여 클러스터의 자원을 관리하고 실행됩니다. 아래는 YARN과 Spark의 동작과정을 간단히 설명한 것입니다.
YARN 동작과정:
Application Submission:
사용자는 YARN 클러스터에 Spark 애플리케이션을 제출합니다.
제출된 애플리케이션은 ResourceManager에 등록됩니다.
Resource Allocation:
ResourceManager는 클러스터 내의 노드에 자원을 할당합니다.
할당된 자원은 Spark 애플리케이션의 드라이버와 익스큐터에 할당됩니다.
Container Launch:
ResourceManager는 클러스터 노드에 컨테이너를 시작하도록 지시합니다.
각 컨테이너는 Spark의 드라이버 또는 익스큐터를 실행하는 환경을 제공합니다.
Application Execution:
Spark 애플리케이션의 드라이버 프로그램이 컨테이너에서 실행됩니다.
드라이버는 클러스터의 자원을 효과적으로 활용하고 익스큐터에 작업을 할당합니다.
Task Execution:
드라이버는 익스큐터에 작업(task)을 할당하고 익스큐터는 해당 작업을 실행합니다.
작업은 데이터 처리, 변환, 액션 등 Spark의 연산을 수행합니다.
Result Retrieval:
작업이 완료되면 결과가 드라이버에 반환되고, 필요에 따라 결과가 저장 또는 다른 작업에 활용됩니다.
Spark 동작과정 (YARN 위에서):
Spark Application Initialization:
사용자는 Spark 애플리케이션을 작성하고 제출합니다.
Spark 애플리케이션은 YARN 클러스터에 등록되어 ResourceManager로부터 할당된 리소스를 받습니다.
Driver Execution:
Spark 애플리케이션의 드라이버 프로그램이 클러스터 내의 컨테이너에서 실행됩니다.
드라이버는 익스큐터의 구성 및 작업 스케줄링을 담당합니다.
Executor Launch:
드라이버는 익스큐터를 클러스터의 다른 노드에 분산하여 실행합니다.
각 익스큐터는 YARN 컨테이너 내에서 실행됩니다.
Task Distribution:
드라이버는 작업을 익스큐터에 분배하고 각 익스큐터에서 작업이 실행됩니다.
Result Collection:
작업이 완료되면 결과가 드라이버로 반환되고, 필요에 따라 결과가 저장되거나 다른 작업에 활용됩니다.
Completion and Cleanup:
애플리케이션이 모든 작업을 완료하면 ResourceManager에 애플리케이션 완료를 알립니다.
ResourceManager는 할당된 자원을 해제하고 클러스터를 정리합니다.
이렇게 YARN과 Spark가 협력하여 클러스터에서 Spark 애플리케이션이 실행되고 자원을 효율적으로 활용할 수 있게 됩니다.