TIL - Day62
Spark 데이터 처리
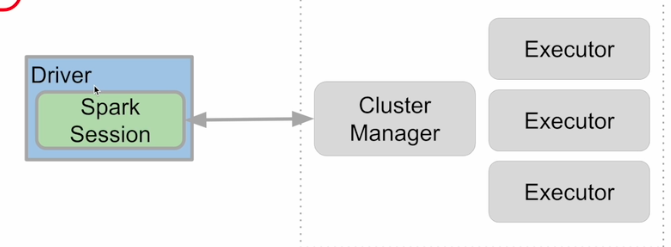
spark 데이터 시스템 아키텍처
spark sql, spark streaming, spark graphx, spark ml
spark core engine
yarn, kubernetis -> resource manager
hdfs, s3, blob, cloud storage
batch 형태로 adhoc 분석만 한다면 hive나 presto만 해도 됌
내부데이터는 hdfs나, s3에서 빼면 되겠지만
외부 데이터 같은 경우는 nosql, rdbms
-> 1. 주기적으로 etl을 통해서 내부데이터로 가져오고 processing하면 됌.
-> 2. 필요할 때 바로처리 spark로 -> 외부데이터에 writing 혹은 내부데이터 hdfs에 쓰는 경우
데이터 병렬처리가 가능하려면
데이터가 먼저 분산되어야함
◆데이터 병렬처리가 가능하려면?
❖ 데이터가 먼저 분산되어야함
● 하둡 맵의 데이터 처리 단위는 디스크에 있는 데이터 블록 (128MB)
▪ hdfs-site.xml에 있는 dfs.block.size 프로퍼티가 결정
● Spark에서는 이를 파티션 (Partition)이라 부름. 파티션의 기본크기도 128MB
▪ spark.sql.files.maxPartitionBytes: !! 모든 파일이 아님 hdfs 블락 사이즈와 동일시해줌. HDFS등에 있는 파일을 읽어올 때만 적용됨
❖ 다음으로 나눠진 데이터를 각각 따로 동시 처리
● 맵리듀스에서 N개의 데이터 블록으로 구성된 파일 처리시 N개의 Map 태스크가 실행
● Spark에서는 파티션 단위로 메모리로 로드되어 Executor가 배정됨
로딩이 될때 파티션이라고 부르고 메모리에 로드되어 excutor가 배정됨. 한 executor에서 여러 파티션을 처리할 수 있다.
처리데이터 나누기 -> 파티션 -> 병렬처리
처리하려는 데이터 파일
처리하려는 데이터 파일이 4개의 block으로 되어있다. 파티셔닝도 4개의 파티션이 생김. 이건 hdfs 전용
만약 mysql 같은 디비에서 가져온다면 jdbc 소스에서는 기본으로 하나의 파티션만 만든다.
여기서 만약 spark cluster 내의 executor 는 2개가 있다. executor 내의 cpu 하나만 있다. 그러면 2 * 1로 두개의 task가 최댓값이다. 그럼 병렬로 2개의 파티션만 처리할 수 있다.
파티션은 pysical 적으로 나뉜 것이고, 포맷은 rdd, dataframe/dataset이다.
적절한 파티션의 수 = executor의 수 x executor당 cpu 수
-> 병렬 처리를 최대화할 수 있다.
spark 데이터 처리흐름
❖ 데이터프레임은 작은 파티션들로 구성됨
● 데이터프레임은 한번 만들어지면 수정 불가 (Immutable)
❖ 입력 데이터프레임을 원하는 결과 도출까지 다른 데이터 프레임으로 계속 변환
● sort, group by, filter, map, join, ...
파티션간에 데이터 이동없이 계속 변환이 가능할까?
새로 파티션을 만들어야함 : group by나 sort 같은 경우 네트워크를 통해 데
이터 전송이 이루어짐. 새로만든 파티션간에 데이터양이 동일하지 않을 수 있음.
파티션간에 데이터 이동이 필요한 경우 발생 - 셔플링
셔플링이 발생하는 경우?
- 명시적으로 파티션을 새롭게 하는 경우
- 시스템에 의해 이뤄지는 셔플링
- grouping 등의 aggregation sorting
셔플링이 발생할 때 네트웍을 타고 데이터가 이동하게 됨
● 몇 개의 파티션이 결과로 만들어질까?
▪ spark.sql.shuffle.partitions이 결정
• 기본값은 200이며 이는 최대 파티션 수
▪ 오퍼레이션에 따라 파티션 수가 결정됨
• random, hashing partition, range partition 등등
• sorting의 경우 range partition을 사용함.
파티션을 통해서 데이터가 분산되어 있기 때문에 하나의 파티션가지고는 안됌.
데이터 프레임의 키값 분포를 보는 것임. sampling을 함. 모든 데이터프레임의 크기가 크다면 시간이 오래걸릴 수도 있을 것이기 때문에. range에 따라서 예를 들어 3개라면 3개의 파티션이 생기고 레코드들이 이동하는 것임
sampling이 잘못된다면 data skew가 생길 수 있음.
● 또한 이때 Data Skew 발생 가능!
Data skewness
data partitioning은 데이터 처리에 병렬성을 주지만 단점도 존재
이는 데이터가 균등하게 분포하지 않는 경우
주로 데이터 셔플링 후에 발생
셔플링을 최소화하는 것이 중요하고 파티션의 최소화를 하는 것이 중요
spark 데이터 구조
RDD, DataFrame,Dataset
3개다 immutable임 바꾸지 못함.
Spark 데이터 구조
❖ RDD (Resilient Distributed Dataset)
● 로우레벨 데이터로 클러스터내의 서버에 분산된 데이터를 지칭
● 레코드별로 존재하지만 스키마가 존재하지 않음
▪ 구조화된 데이터나 비구조화된 데이터 모두 지원
❖ DataFrame과 Dataset
● RDD위에 만들어지는 RDD와는 달리 필드 정보를 갖고 있음 (테이블)
● Dataset은 타입 정보가 존재하며 컴파일 언어에서 사용가능 ▪ 컴파일 언어: Scala/Java에서 사용가능
● PySpark에서는 DataFrame을 사용 -> 이것밖에 사용못함
아래의 구조이다.
Spark SQL, DataFrame, Dataset
Spark SQL Engine
RDD API
- Code Analysis
- Logical Optimization (Catalyst Optimizer)
- Physical Planning -> RDD operation code로 바뀜
- Code Generation (Project Tungsten) -> java by 코드로 바뀜
spark 데이터 구조 - 데이터 프레임
변경이 불가한 분산 저장된 데이터
rdd와는 다르게 관계형 데이터베이스 테이블처럼 컬럼으로 나눠 저장
판다스의 데이터 프레임 혹은 관계형 데이터베이스의 테이블과 거의 흡사
다양한 데이터 소스 지원 : hdfs, hive, rdd
스칼라 자바 파이썬과 같은 언어에서 지원.
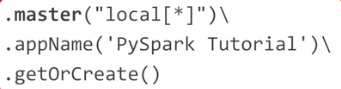
◆ Spark Session 생성
❖ Spark 프로그램의 시작은 SparkSession을 만드는 것
● 프로그램마다 하나를 만들어 Spark Cluster와 통신: Singleton 객체
● Spark 2.0에서 처음 소개됨
❖ Spark Session을 통해 Spark이 제공해주는 다양한 기능을 사용
● DataFrame, SQL, Streaming, ML API 모두 이 객체로 통신
● config 메소드를 이용해 다양한 환경설정 가능
● 단 RDD와 관련된 작업을 할때는 SparkSession 밑의 sparkContext 객체를 사용
pyspark
from pyspark.sql import SparkSession
-> spark sql engine이 중심으로 동작함
sparkseesion 은 싱글턴
-> 한 프로그램당 하나만 있으면 됌
pyspark Session 환경 변수
❖ Spark Session을 만들 때 다양한 환경 설정이 가능 ❖ 몇 가지 예
● executor별 메모리: spark.executor.memory (기본값: 1g)
● executor별 CPU수: spark.executor.cores (YARN에서는 기본값 1)
● driver 메모리: spark.driver.memory (기본값: 1g)
● Shuffle후 Partition의 수: spark.sql.shuffle.partitions (기본값: 최대 200)
❖ 가능한 모든 환경변수 옵션은 여기에서 찾을 수 있음
● 사용하는 Resource Manager에 따라 환경변수가 많이 달라짐
pyspark seesion 환경 설정 방법
◆ Spark Session 환경 설정 방법 4가지
❖ 환경변수
❖ $SPARK_HOME/conf/spark_defaults.conf
❖ spark-submit 명령의 커맨드라인 파라미터
● 나중에 따로 설명
❖ SparkSession 만들때 지정
● SparkConf