참고
LLM을 사용하다보면, 코드에서 파라미터로 temperature, top-k 등을 지정하는 경우가 발생한다.
이에 대해서 알아보자.
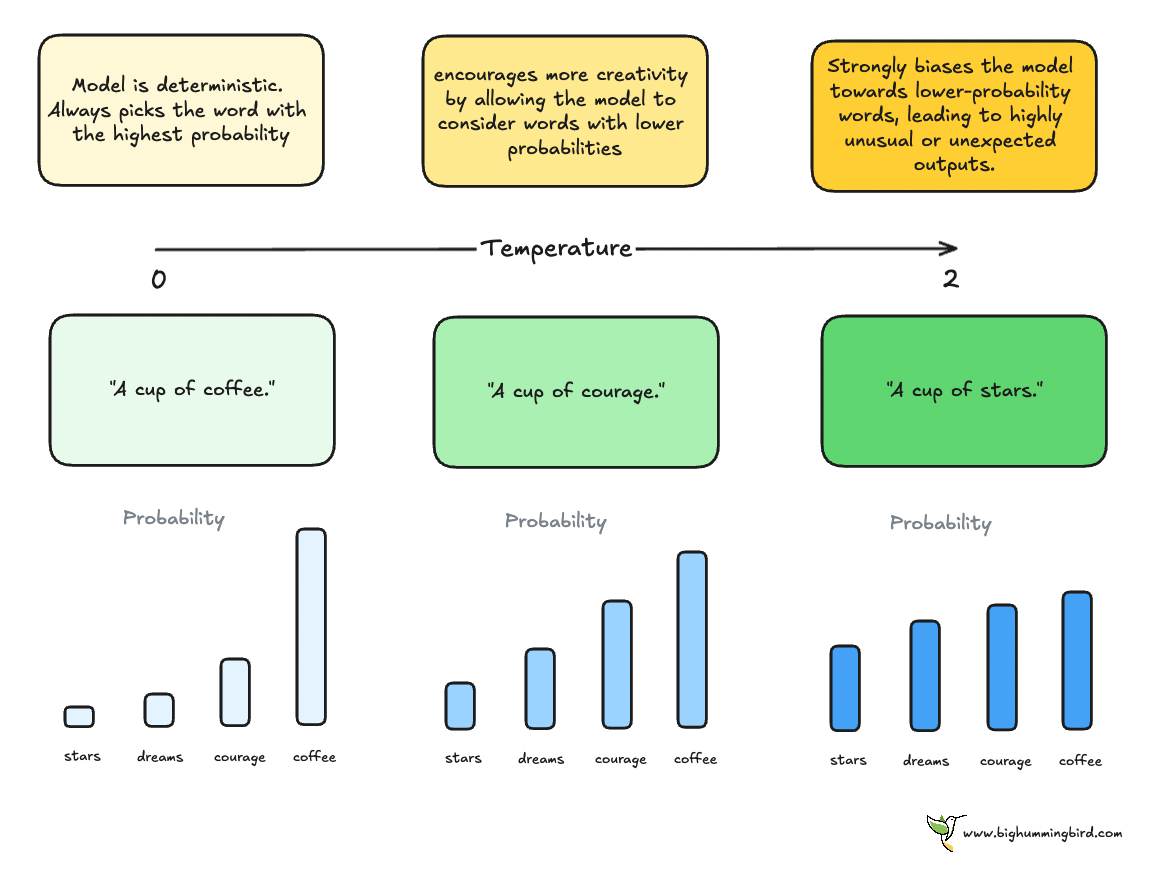
✅ 온도 (Temperature)
- 모델 출력의 무작위성 제어
- 온도가 낮을수록 결정적인 출력 - 더 가능성이 높은 단어 선호
- 온도를 0으로 설정하더라도 모델이 완전히 결정론적이 되는 것 X but 매우 가까워짐
- 기술 문서/공식 문서 작성 등 정확하고 예측 가능한 결과가 필요한 작업에 이상적
- 온도가 높을수록 가능성이 낮은 단어 고려 - 더 많은 창의성 발휘
- 온도가 증가함에 따라 서로 다른 단어 간의 샘플링 확률이 균일해지기 시작 → 모델이 매우 특이하거나 예상치 못한 출력 생성
✅ 최대 토큰 (Max Tokens)
- 모델이 응답에서 생성할 수 있는 토큰(단어 or 단어의 일부)의 최대 개수를 정의
- 토큰 = 모델이 처리하는 텍스트의 최소 단위
- 토큰을 1.5로 나누면(대략적인 평균) 단어 수를 대략적으로 추정 가능
- 낮은 최대 토큰 수 (예: 50): 헤드라인, 짧은 요약, 간결한 답변 등 짧은 응답이 필요한 작업에 적합
- 높은 최대 토큰 수 (예: 500): 기사, 스토리 또는 자세한 설명과 같은 긴 콘텐츠를 생성하는 데 유용
✅ 탑케이 (Top-k)
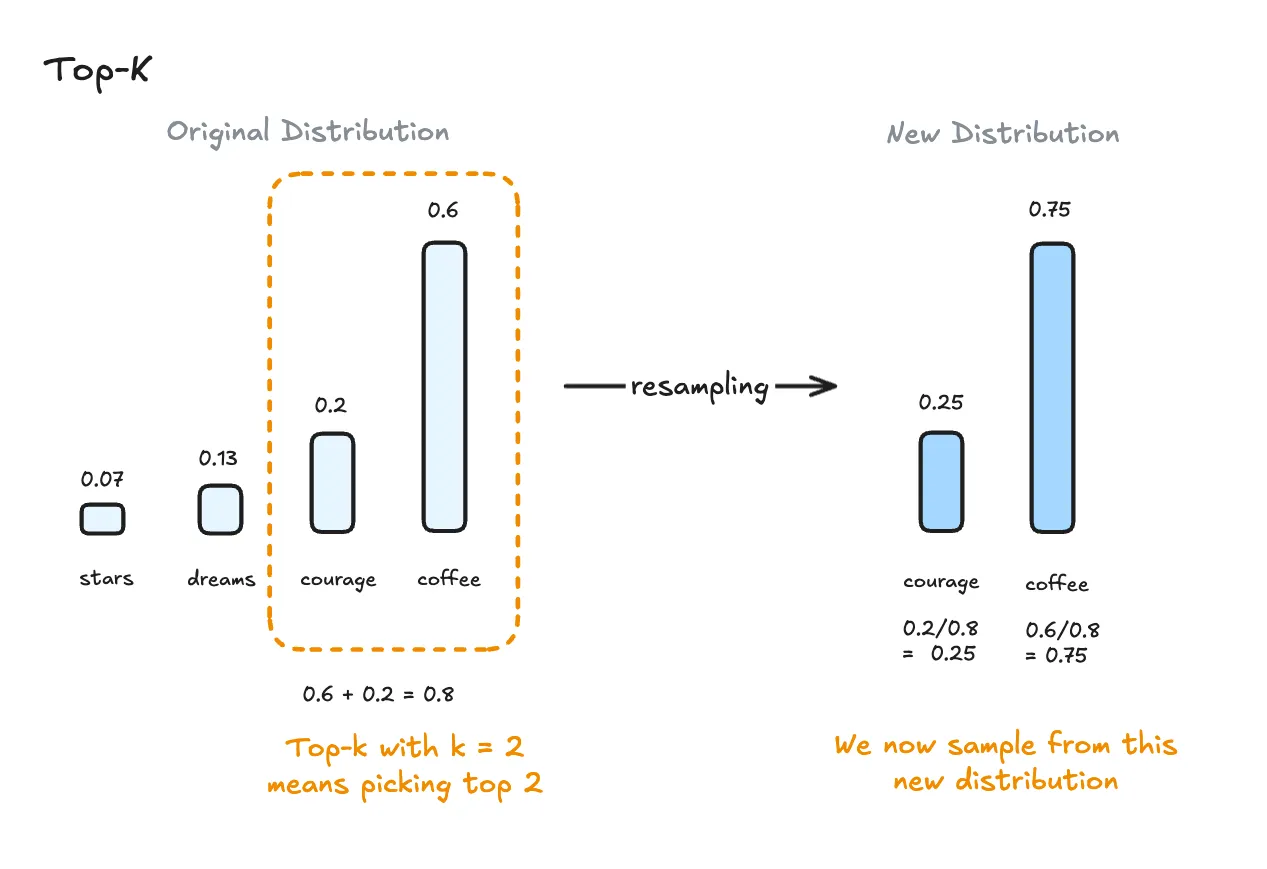
- Top-k 샘플링: 모델이 다음 단어로 가장 가능성이 높은 상위 k개의 단어 선택하도록 제한
- 선택 범위를 좁힘 → 관련성이 없거나 무의미한 결과가 생성될 가능성을 줄이는 데 이바지
- k개 선택 → 확률의 합이 1이 되도록 조정 (리샘플링) → k개 중 하나가 선택되도록 함
- 낮은 k (예: k=10): 요약이나 코딩과 같이 집중력과 일관성을 유지해야 하는 구조화된 작업에 적합
- 높은 k (예: k=50): 일관성을 잃지 않으면서 더 많은 가변성을 도입하려는 창의적/탐색적 작업에 적합
✅ 탑피 (Top-p)
- Top-p 샘플링은 결합 확률이 임계값 p를 초과하는 가장 작은 단어 집합을 선택하여 상황에 맞는 단어 선택 용이
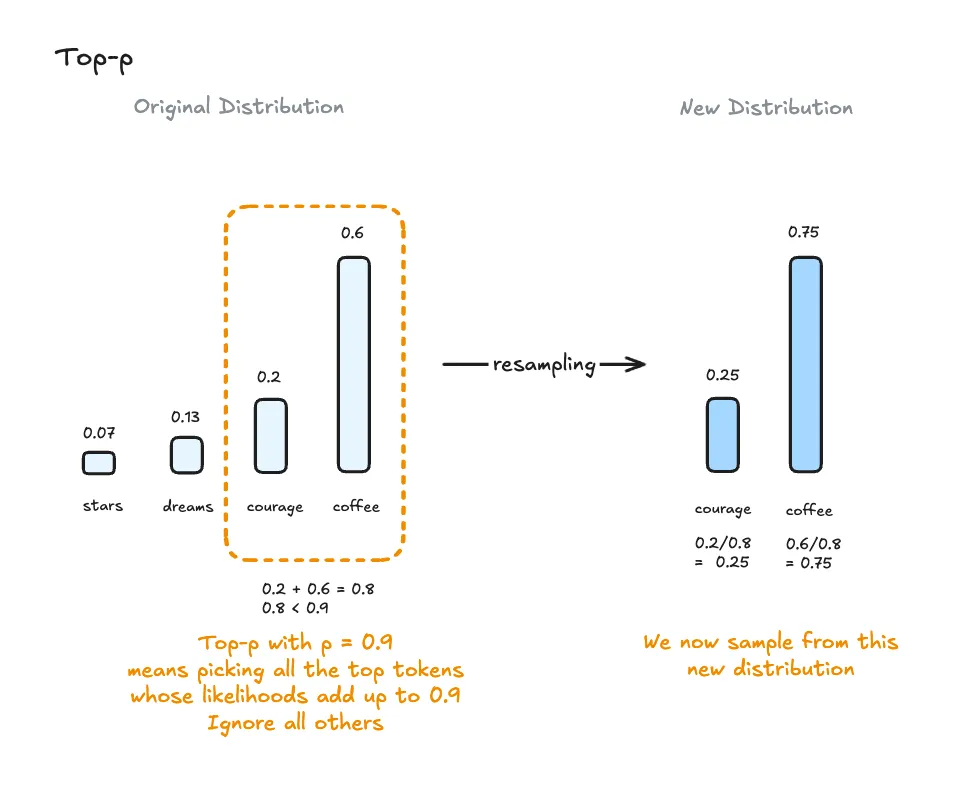
- 낮은 p (예: p=0.5): 뉴스 헤드라인이나 교육 텍스트와 같이 간결하고 요점을 잡은 출력이 필요한 작업
- 높은 p (예: p=0.95): 대화 생성이나 창의적인 콘텐츠와 같이 더 다양한 응답이 바람직한 개방형 작업에 유용
✅ 빈도 페널티 (Frequency Penalty)
- 모델이 텍스트 내에서 동일한 단어를 반복할 가능성을 줄여 다양성을 높이고 출력의 중복 최소화
- 이 패널티를 적용하면 모델은 이미 등장한 단어를 재사용하는 대신, 새로운 단어를 도입하도록 유도됨
- 조정된 확률 = 초기 확률 / (1 + 빈도 페널티 * 출현 횟수)
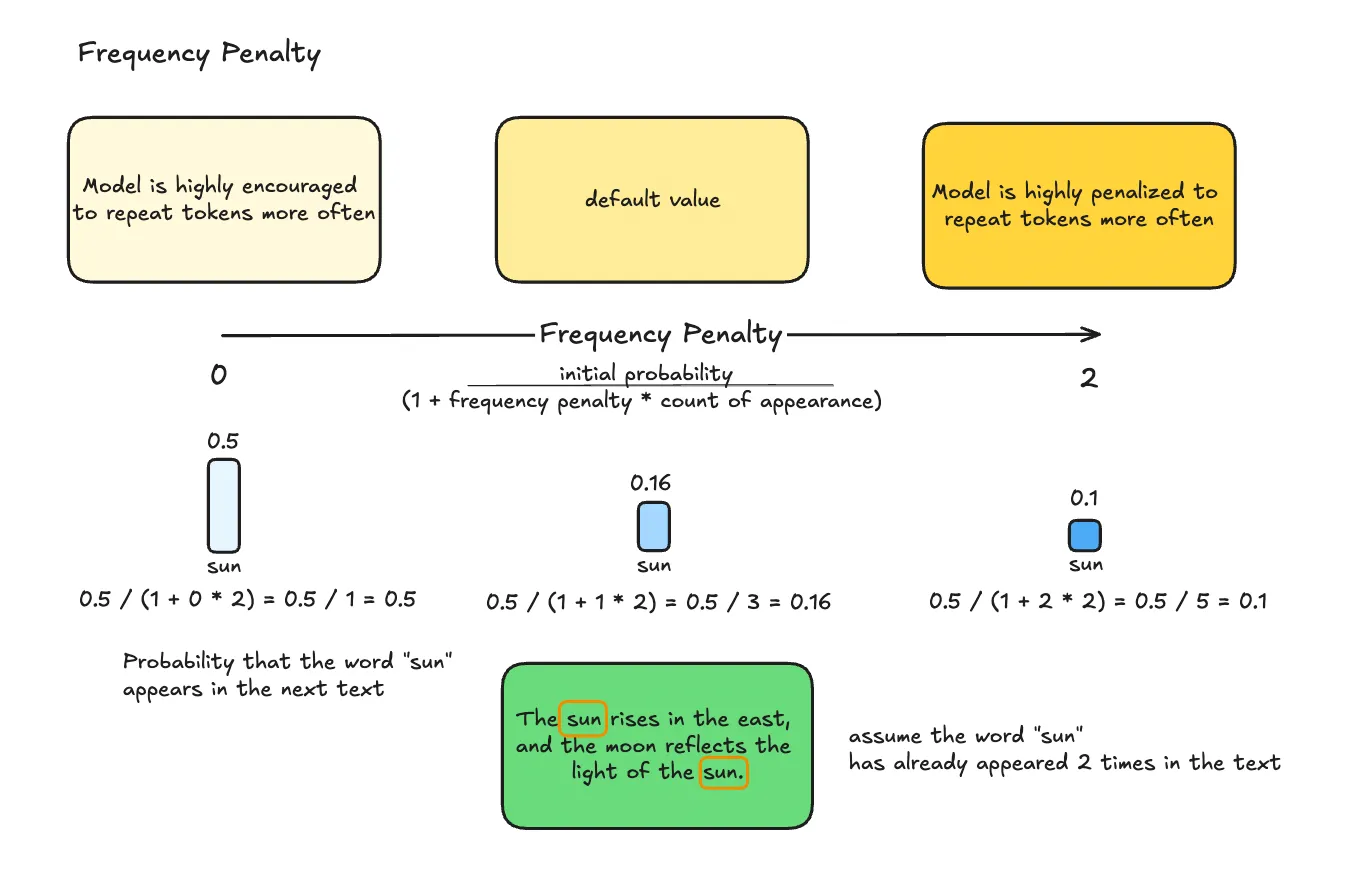
- 높은 페널티 (예: 1.0): 반복이 방해되거나 바람직하지 않은 에세이/연구논문 생성에 이상적
- 낮은 페널티 (예: 0.0): 시/마케팅 슬로건 같이 반복이 필요하거나 유익할 때 유용
✅ 출석 페널티 (Presence Penalty)
- 빈도 페널티와 유사하나, 한 가지 주요 차이점이 있다
- 이미 언급된 단어나 문구를 재사용할 경우 모델에 페널티를 부여하나, 그 빈도는 해당 단어나 문구가 얼마나 자주 등장하는지에 관계 X
- 조정된 확률 = 초기 확률 / (1 + 존재 페널티 * 존재)
- “sun”이 등장한 빈도에 페널티를 곱하는 대신, 단순히 “sun”이 등장했는지 여부만 확인
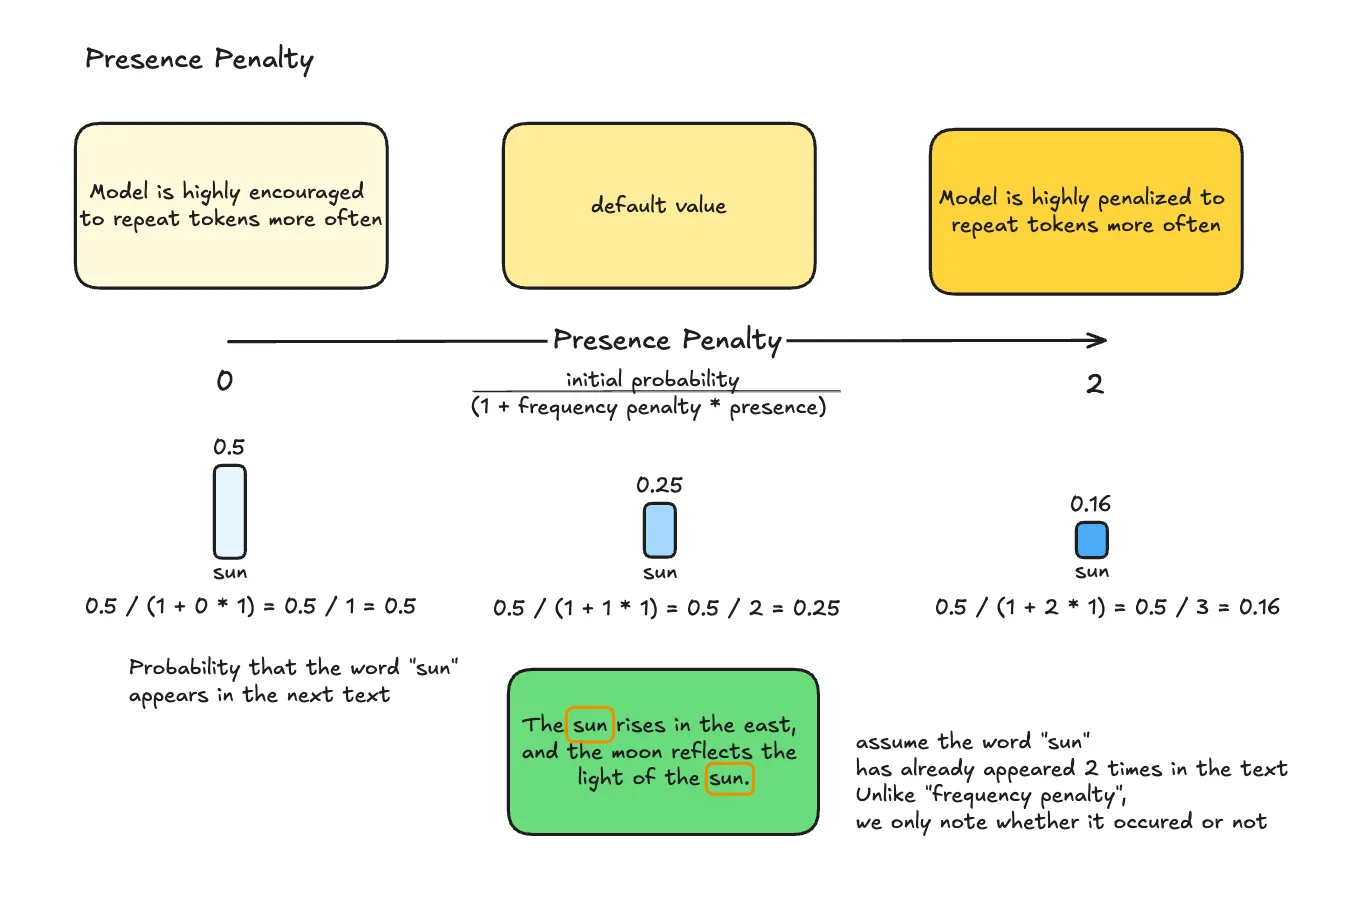
- 높은 페널티 (예: 1.0): 모델이 새로운 아이디어나 주제를 계속 소개하길 원하는 탐색/브레인스토밍 세션에 적합
- 낮은 페널티 (예: 0.0): 기술 문서/교육 자료와 같이 핵심 용어나 아이디어의 강화가 중요한 작업에 적합
🧑💻 빈도와 존재 페널티는 종종 함께 발생한다.
- 언제 사용해야 하나? → 콘텐츠 생성, 중복 방지
- 사용하지 말아야 할 때? → 기술 문서 작성(일관된 용어 중요한 기술 문서/지침), 브랜드 메시징(특정 브랜드 톤이나 핵심 문구에 크게 의존하는 콘텐츠 생성 시 반복 줄이면 브랜드 약화)
공부 기록용 & 프로젝트 회고용 24.08.05~ #AI/LLM #RAG # Data Science