LLM을 활용하여 사용자의 문서를 요약할 때가 발생한다.
이런 경우에 활용되는 방법론을 알아보자.
- stuff: 전체 문서 한 번에 요약
- map-reduce: 분할 요약 후 일괄 병합
- map-refine: 분할 요약 후 점진적인 병합
- chain of density: N번 반복 실행하며, 누락된 entity를 보완하며 요약 개선
- clustering-map-refine: 문서의 Chunk를 N개의 클러스터로 나누고, 각 클러스터에서 중심점에 가까운 문서에 대한 요약을 refine 요약
이 중 핵심 방법론은 상위 3개이다.
요약기를 구축할 때 중심적인 질문은 → “문서를 LLM의 컨텍스트 창에 어떻게 전달한 것인가”이다.
- stuff: 단순히 모든 문서를 단일 프롬프트로 넣는다
- map-reduce: 각 문서를 “map” 단계에서 개별적으로 요약한 다음, “reduce” 단계에서 요약본들을 최종 요약본으로 합친다
- refine: 입력 문서를 순회하며 반복적으로 답변을 업데이트하여 응답을 구성한다 → 각 문서에 대해, 모든 비문서 입력, 현재 문서, 그리고 최신 중간 답변을 chain에 전달하여 새로운 답변을 얻는다.
💌 개념
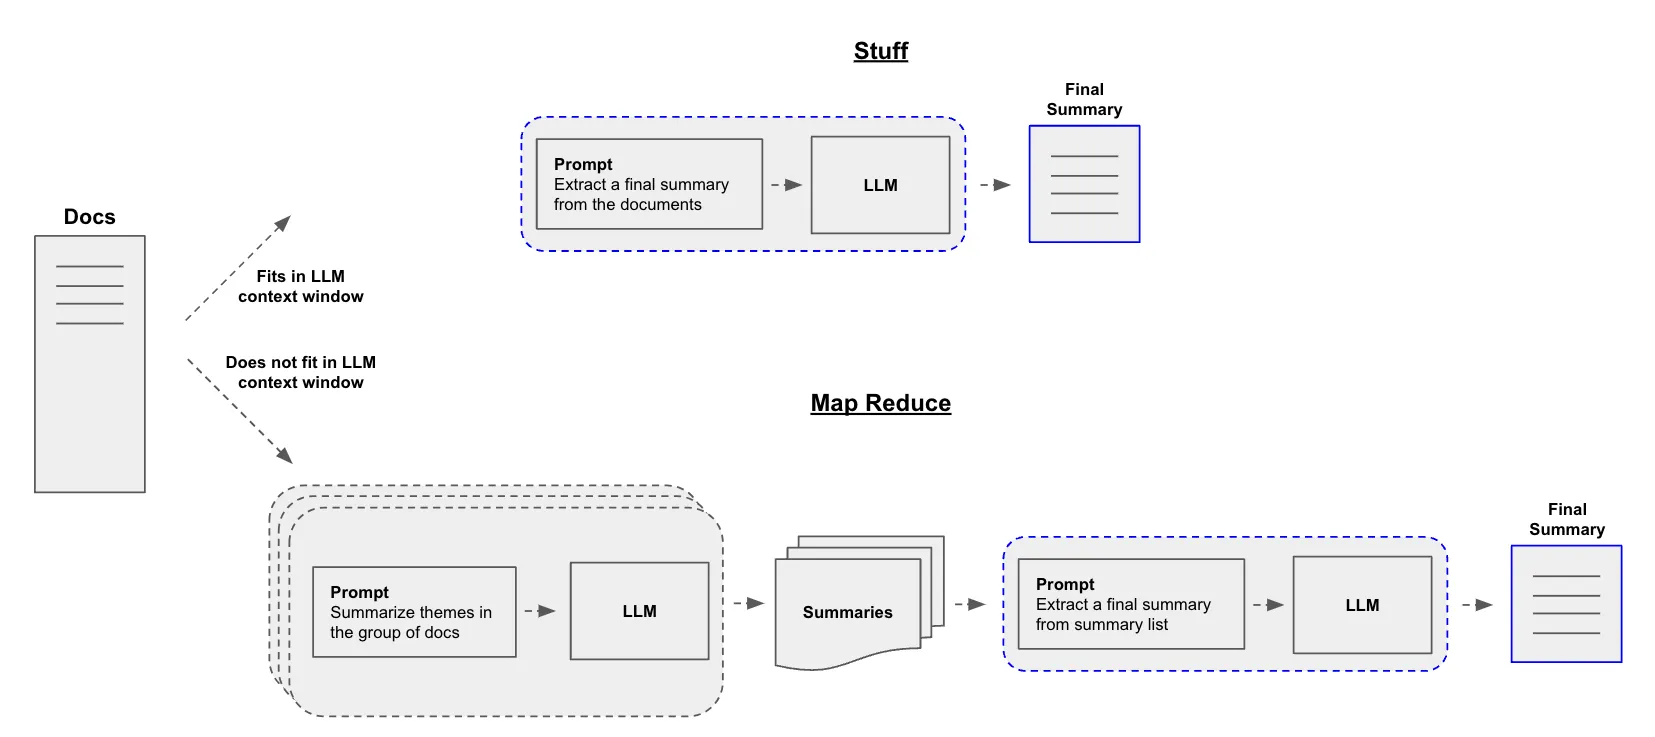
🎁 Stuff
: 문서 목록을 가져와서 모두 프롬프트에 삽입한 다음, 그 프롬프트를 LLM에 전달한다
⇒ 문서가 작고 대부분의 호출에 몇 개만 전달되는 애플리케이션에 적합
🎁 Map-Reduce
: 먼저 문서를 작은 chunk로 나누는 “map” 단계와, 각 chunk의 요약을 결합하는 “reduce” 단계로 구성된다
- map 단계에서는 각 chunk를 병렬로 요약
- reduce 단계에서는 이 요약들을 하나의 최종 요약으로 통합
⇒ 대규모 문서를 처리할 때 유용, 언어 모델의 토큰 제한을 우회할 수 있게 함
🎁 Map-Refine
: Map-Reduce와 유사하나 약간의 차이가 존재한다
- map 단계: 문서를 여러 개의 작은 chunk로 나누고, 각 chunk에 대해 개별적으로 요약 생성
- refine 단계: 생성된 요약들을 순차적으로 처리하며 최종 요약을 점진적으로 개선 → 각 단계에서 이전 요약과 새로운 chunk의 정보를 결합하여 요약 갱신
- 반복 과정: 모든 chunk가 처리될 때까지 reifne 단계 반복
- 최종 요약: 마지막 chunk까지 처리한 후 얻은 요약이 최종 결과가 된다
⇒ 문서의 순서를 유지하면서 점진적으로 요약 개선 가능 ← 문서의 맥락이 중요한 경우 유용
↔ BUT map-reduce에 비해 순차적으로 처리되기 때문에 → 병렬화가 어려워 대규모 문서 처리 시 시간 더 오래 소요
🎃 Chain of Density
From Sparse to Dense: GPT-4 Summarization with Chain of Density Prompting
: CoD 프롬프트는 GPT-4를 사용한 요약 생성을 개선하기 위해 개발된 기법
- 초기에 개체가 적은 요약을 생성한 후, 길이를 늘리지 않으면서 누락된 중요 개체들을 반복적으로 통합하는 과정을 거친다
- 연구 결과, CoD로 생성된 요약은 일반 프롬프트보다 더 추상적이고 정보 융합이 뛰어나며, 인간이 작성한 요약과 비슷한 밀도를 가진 것으로 나타난다
- 점진적 개선: CoD는 초기에 개체가 적은 간단한 요약을 생성한 후, 단계적으로 중요한 개체들을 추가하며 요약을 개선한다. → 이 과정에서 요약의 길이는 유지되며, 정보 밀도가 증가하여 읽기 쉬우면서도 정보량이 풍부한 요약이 만들어진다
- 정보 밀도와 가독성의 균형: CoD 방식은 요약의 정보 밀도를 조절하여 정보성과 가독성 사이의 최적 균형점을 찾는다. ← 연구 결과에 따르면, 사람들은 일반적인 GPT-4 요약보다, 더 밀도 있지만 사람이 작성한 요약만큼 밀도가 높지 않은 CoD 요약을 선호하는 것으로 나타났다
- 추상화와 정보 융합 개선: CoD로 생성된 요약은 더 추상적이고 정보 융합이 뛰어나며, 원문의 앞부분에 치우치는 경향이 덜하다. → 이는 요약의 전반적인 품질과 가독성을 향상시키는 데 기여한다.
초기 요약은 의도적으로 정보가 적고, 반복 과정을 통해 중요한 엔티티(개체)를 하나씩 추가해가면서 요약의 "밀도"를 높여가는 구조
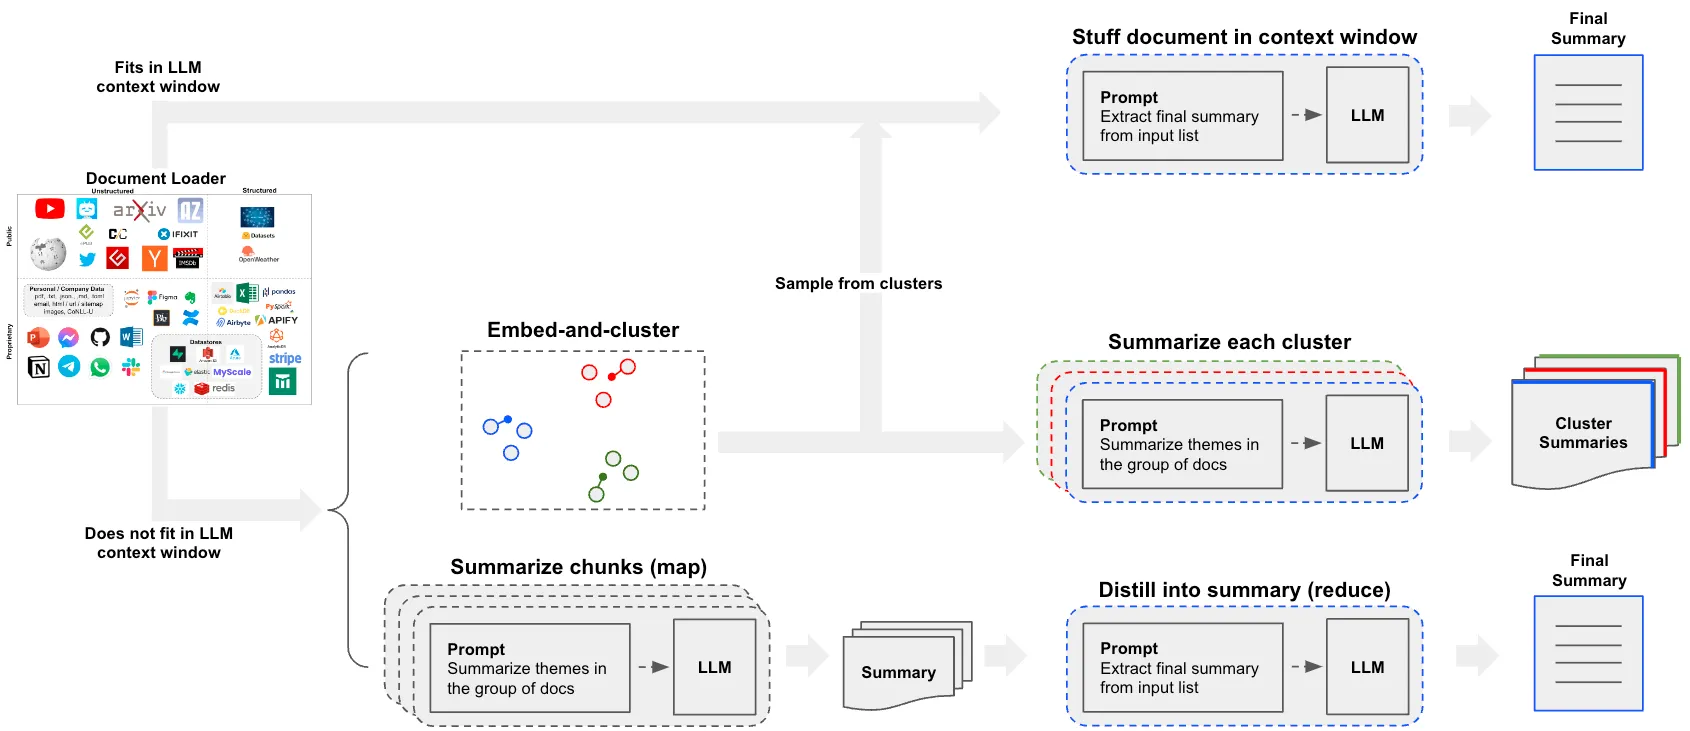
🎃 Clustering-Map-Refine
배경
- map-reduce나 map-refine 방식은 시간이 오래 걸리고, 비용이 많이 든다
- 따라서, 문서를 몇 개(N개)의 클러스터로 나눈 뒤, 가장 중심축에서 가까운 문서를 클러스터의 대표 문서로 인지하고, 이를 map-reduce(혹은 map-refine) 방식으로 요약하는 방식을 제안
- 과정: 하나의 문서로 텍스트 합치기 → 하나의 텍스트를 여러 문서로 나누기 → 문서 임베딩 → 클러스터로 나누기(
KMeans) →t-SNE사용해 고차원 데이터를 저차원 공간(2차원)으로 시각화 → 각 클러스터의 중심점에 가장 가까운 임베딩 찾아 저장 → 문서 요약 순서대로 진행 위해 오름차순 정렬 → 문서 생성 및 map_refine 사용해 요약 생성
💌 주요 방법론 정리
1️⃣ stuff (단순 통합 요약)
🔍 개념
- 모든 문서를 한 번에 LLM에 넣고 요약함
- 가장 단순하고 빠르지만, context limit에 취약
📦 동작 방식
LLM("다음 문서를 요약해줘:\n 문서1 + 문서2 + 문서3 ...")✅ 장점
- 간단하고 응답 속도가 빠름
- 문서가 짧을 때 효율적
❌ 단점
- 문서가 길면 토큰 초과 발생
- 부분 문맥을 놓칠 수 있음
2️⃣ map-reduce (분할 요약 → 결합 요약)
🔍 개념
- Map 단계: 문서를 chunk로 쪼개고 각각 요약
- Reduce 단계: 개별 요약들을 다시 결합해 LLM에 넣고 최종 요약 생성
📦 동작 방식
# Map 단계
Chunk1 → 요약1
Chunk2 → 요약2
Chunk3 → 요약3

# Reduce 단계
LLM("요약1 + 요약2 + 요약3 을 종합해서 최종 요약을 만들어줘")
✅ 장점
- 길이가 긴 문서에 강함
- 병렬 처리 가능
❌ 단점
- 중복 정보 발생 가능
- Reduce 단계가 부정확하면 정보 손실 위험 있음
3️⃣ map-refine (분할 요약 → 누적 개선 요약)
🔍 개념
- Map 단계: 첫 chunk 요약 시작
- Refine 단계: 다음 chunk를 요약 + 이전 요약을 반영해 점점 보완/개선된 요약 생성
📦 동작 방식
# 초기 요약
Chunk1 → 요약1

# Refine 반복
요약1 + Chunk2 → 요약2
요약2 + Chunk3 → 요약3
...

→ 요약N = 최종 요약
✅ 장점
- 이전 내용 반영해 일관성 있고 누적된 요약 가능
- refine 과정에서 정보 강화
❌ 단점
- 직렬 처리 → 속도가 느림
- 초반 요약에 편향될 위험
📊 요약 비교표 1
| 전략 | 요약 방식 | 토큰 효율성 | 성능 | 병렬 처리 | 적합한 문서 |
|---|---|---|---|---|---|
stuff | 전체 문서 한 번에 | 낮음 | 빠름 | ❌ | 짧은 문서 |
map-reduce | 부분 요약 후 결합 | 높음 | 좋음 | ✅ | 긴 문서 |
map-refine | 누적 개선형 요약 | 중간 | 좋음 | ❌ | 구조 있는 문서 |
📊 요약 비교표 2
🧱 공통 구조: 문서 요약 체인(Document Summarization Chain)
| 이름 | 특징 | 문서 분할 | 요약 방식 |
|---|---|---|---|
stuff | 문서를 모두 한 번에 LLM에 넣음 | ❌ 없음 | 한 번에 요약 |
map-reduce | 쪼갠 뒤 개별 요약 → 합쳐 다시 요약 | ✅ 있음 | 두 단계 요약 |
map-refine | 쪼갠 뒤 요약 → 누적 보완하며 요약 | ✅ 있음 | 누적 개선형 요약 |
📌 언제 어떤 걸 쓰면 좋을까?
| 상황 | 추천 전략 |
|---|---|
| 문서가 짧다 | stuff |
| 문서가 길고 병렬 처리 가능 | map-reduce |
| 문서 내용이 논리적으로 누적되며 흐름이 중요 | map-refine |
💌 Chain of Density
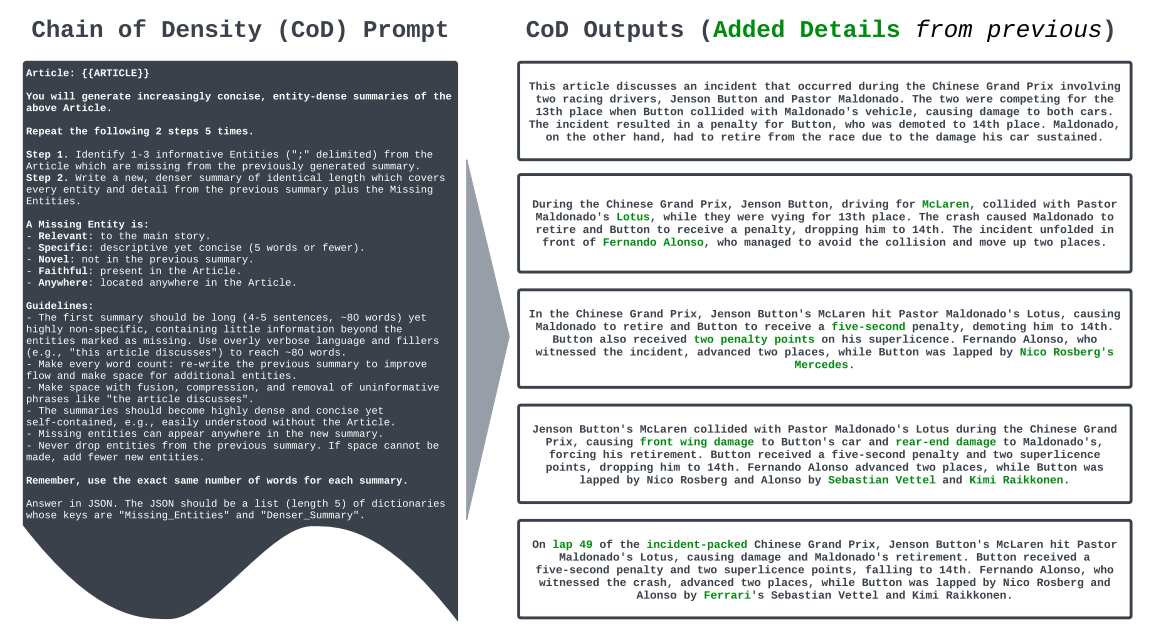
CoD는 LLM 기반 요약 시, 정해진 길이 안에서 정보의 밀도(entity density)를 점진적으로 높여가는 반복적 정제(prompt chaining) 방식의 기법이다.
주요 특징은 다음과 같다:
- 반복적 정제 (Iterative Refinement)
- 초기 요약은 엔티티가 적은 간결한 형태로 생성
- 각 반복 단계마다 이전 요약에 빠진 핵심 엔티티 1–3개를 식별해서 요약에 추가
- 누락 엔티티 식별 CoD에서는 보통 LLM이 스스로 이전 요약에서 빠진 핵심 엔티티를 찾아내도록 프롬프트로 지시. 필요하면 규칙/도구로 보강.
- 길이 유지, 밀도 향상
- 요약의 단어 수는 동일하게 유지하면서, 압축하거나 중복된 표현을 제거해 공간을 확보하고 엔티티를 "융합(fuse)"해 넣음
- 개체 중심 요약
- “Missing Entity”는 다음 기준을 충족해야 해:
- 관련성 있음, 구체적(5단어 이하), 새롭고 요약에 포함되지 않음, 원문에 실제 존재함, 문서 어디에나 있을 수 있음
- “Missing Entity”는 다음 기준을 충족해야 해:
🧠 중요한 점
- CoD는 "청크 1 → 청크 2 → 청크 3" 식의 순차 이동이 아니라, 같은 원문을 기준으로 요약문을 계속 업그레이드하는 구조
- 만약 문서가 너무 길어서 한 번에 LLM에 못 넣는다면,
- 각 청크마다 CoD 적용 → 부분 요약 생성 → 최종 통합 요약
- 이런 하이브리드 구조를 만들 수 있음 → 이 경우가 map-reduce + CoD 결합형.
📌 예시 (단일 문서 CoD)
원문: 긴 뉴스 기사

[1회차] → 요약(간단)
[2회차] → 빠진 엔티티 2개 추가, 길이 동일
[3회차] → 빠진 엔티티 1개 추가, 길이 동일
...
[최종] → 엔티티 밀도 최댓값 요약
📌 실제 동작 흐름
CoD의 전형적인 반복 구조는 이렇게 구성된다:
Article: [원문 텍스트]

You will generate increasingly concise, entity-dense summaries of the above Article.
Repeat the following 2 steps 5 times:

1. Identify 1–3 informative Entities (semicolon-delimited) from the Article which are missing from the previously generated summary.
2. Write a new, denser summary of identical length that covers every entity and detail from the previous summary plus the Missing Entities.
🎃 CoD vs map-reduce
Chain of Density(CoD)는 map-reduce랑 비슷하게 "여러 번 요약"을 하지만, 구조적으로는 "청크 순회 방식"이 아니라 요약문 자체를 반복 정제하는 방식
📌 차이 정리
| 항목 | Map-Reduce 요약 | Chain of Density |
|---|---|---|
| 단위 | 청크별(Map) → 합치기(Reduce) | 전체 문서(또는 한 덩어리) 요약을 반복 정제 |
| 흐름 | 각 청크를 개별 요약 후 합침 | 초기 요약 → 빠진 엔티티 찾아 추가 → 길이 유지하며 조밀화 반복 |
| 중점 | 긴 문서를 토큰 한도 안에 넣기 | 동일 길이 내에서 정보 밀도 최대화 |
| 누락 정보 보강 | 합치는 단계에서 처리 | 각 반복 단계에서 1–3개 핵심 엔티티 추가 |
💌 Clustering-map-refine
- Clustering (의미 기반 분할 및 대표 청크 선별)
- 문서를 청크로 나눈 뒤 각 청크를 벡터화하고, K‑means 등으로 클러스터링하여 주제별 대표 청크를 선별
Reddit 사용자 설명: “문서를 쪼개고 벡터화한 뒤 유사한 주제끼리 모은 다음, 각 클러스터의 중심 표현값(centroid)을 대표로 삼아 요약에 사용하는 방식이 가장 효과적이고 비용 효율적이었다.” (Reddit)
- Map 단계 (대표 청크 요약)
- 클러스터링 후 추출한 대표 청크들을 stuff 또는 map 방식으로 LLM에 넣고 요약을 생성
- 이때 extractive 또는 abstractive 요약 방식을 사용할 수 있다
- Refine 또는 Density 정제
- Map 단계에서 생성된 요약을 기반으로 Chain of Density(CoD) 또는 refine 방식으로 요약을 반복 정제
- 예를 들어 Chain of Density를 적용해 "누락된 엔티티를 추가하여 동일 길이 내 요약 밀도 향상"하는 과정을 수행할 수 있다
🎃 부가 정리
📌 요약 전략 비교
| 단계 | 설명 |
|---|---|
| Clustering | 문서 청크들을 의미 단위로 묶고 대표 청크 선정 (병렬 처리 및 집중 요약 가능) |
| Map | 각 대표 청크에 대해 요약 생성 (extractive 또는 abstractive) |
| Refine / CoD | 초기 요약을 반복 정제하여 정보 밀도 및 일관성 향상 |
🖼️ 그림으로 표현
[문서 전체]
 → (청크 분할) → [청크1, 청크2, ...]
 → (임베딩) → (K-means 클러스터링)
 → [클러스터1, 클러스터2, ...]
 → (중심점 근처 청크 선택) → [대표청크1, 대표청크2, ...]
 → (Map 단계 요약) → [요약1, 요약2, ...]
 → (Refine 단계 통합·보완) → [최종 요약]
💌 파이널 정리
stuff:
  문서 → LLM → 요약

map-reduce:
  문서 → 청크 → [청크 요약들] → 합쳐서 최종 요약

map-refine:
  문서 → 청크 → 청크1 요약 → +청크2 보완 → +청크3 보완 → 최종 요약

Chain of Density:
  문서/청크 → 초기 요약 → 엔티티 추가(반복) → 밀도 높은 최종 요약

clustering-map-refine:
  문서 → 청크 → 임베딩 → 클러스터링 → 중심점 청크 선택 → map-refine → 최종 요약
📊 요약 전략 비교표
| 방법 | 문서 처리 방식 | 요약 진행 방식 | 장점 | 단점 | 적합한 상황 |
|---|---|---|---|---|---|
| Stuff | 문서 전체를 한 번에 LLM에 넣음 | 한 번에 요약 | 빠르고 단순, 문맥 완전 보존 | 토큰 제한 초과 시 불가 | 짧은 기사, 메모, 이메일 |
| Map-Reduce | 문서를 청크로 나눔 | 각 청크 요약(Map) → 최종 요약(Reduce) | 긴 문서 처리 가능, 병렬화 가능 | Reduce 단계에서 정보 손실 가능 | 긴 보고서, 책, 회의록 |
| Map-Refine | 문서를 청크로 나눔 | 첫 청크 요약 → 다음 청크에서 기존 요약 보완 반복 | 문맥 일관성↑, 정보 누락 방지 | 순차 처리로 속도 느림 | 논리 흐름이 중요한 문서, 스토리성 자료 |
| Chain of Density | 문서 전체 또는 청크 단위 | 초기 요약 → 빠진 엔티티 1~3개씩 추가, 길이 유지 반복 | 동일 길이 내 정보 밀도↑ | 반복 비용 증가, LLM 품질 의존 | 제한된 길이의 정보집약형 요약 |
| Clustering-Map-Refine | 문서 청크 → 임베딩 → 클러스터링 | 각 클러스터 대표 청크 선택 → Map-Refine | 중복 최소화, 비용 절감 | 대표 청크 선택 정확도에 성능 영향 | 대규모 문서 집합 요약, 토픽별 요약 |
📜 예시 시나리오
| 상황 | 추천 방식 | 이유 |
|---|---|---|
| 2~3페이지 보고서 | Stuff | 토큰 한도 내에서 문맥 보존 가능, 속도 빠름 |
| 200페이지 회의록 | Map-Reduce | 청크별 병렬 처리로 빠르게 전체 요약 |
| 50페이지 논문 | Map-Refine | 앞뒤 내용의 흐름과 용어 일관성 유지 필요 |
| 5페이지 제한 보고서에 정보 최대한 담기 | Chain of Density | 길이 고정 + 엔티티 추가로 밀도↑ |
| 500건의 뉴스 기사 모음 | Clustering-Map-Refine | 토픽별 대표 기사 선택, 중복 줄이고 요약 |