참고
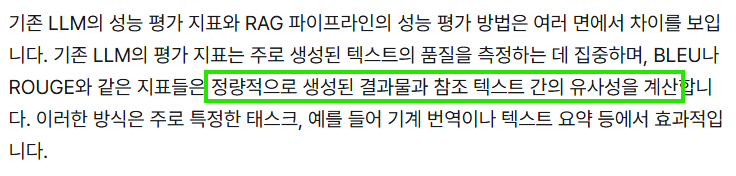
RAG의 성능을 측정할 때 사용하는 지표로 BLEU와 ROUGE가 있다고 한다.
이에 대해서 이론을 정리하고, 예시를 살펴보자.
📚 요약
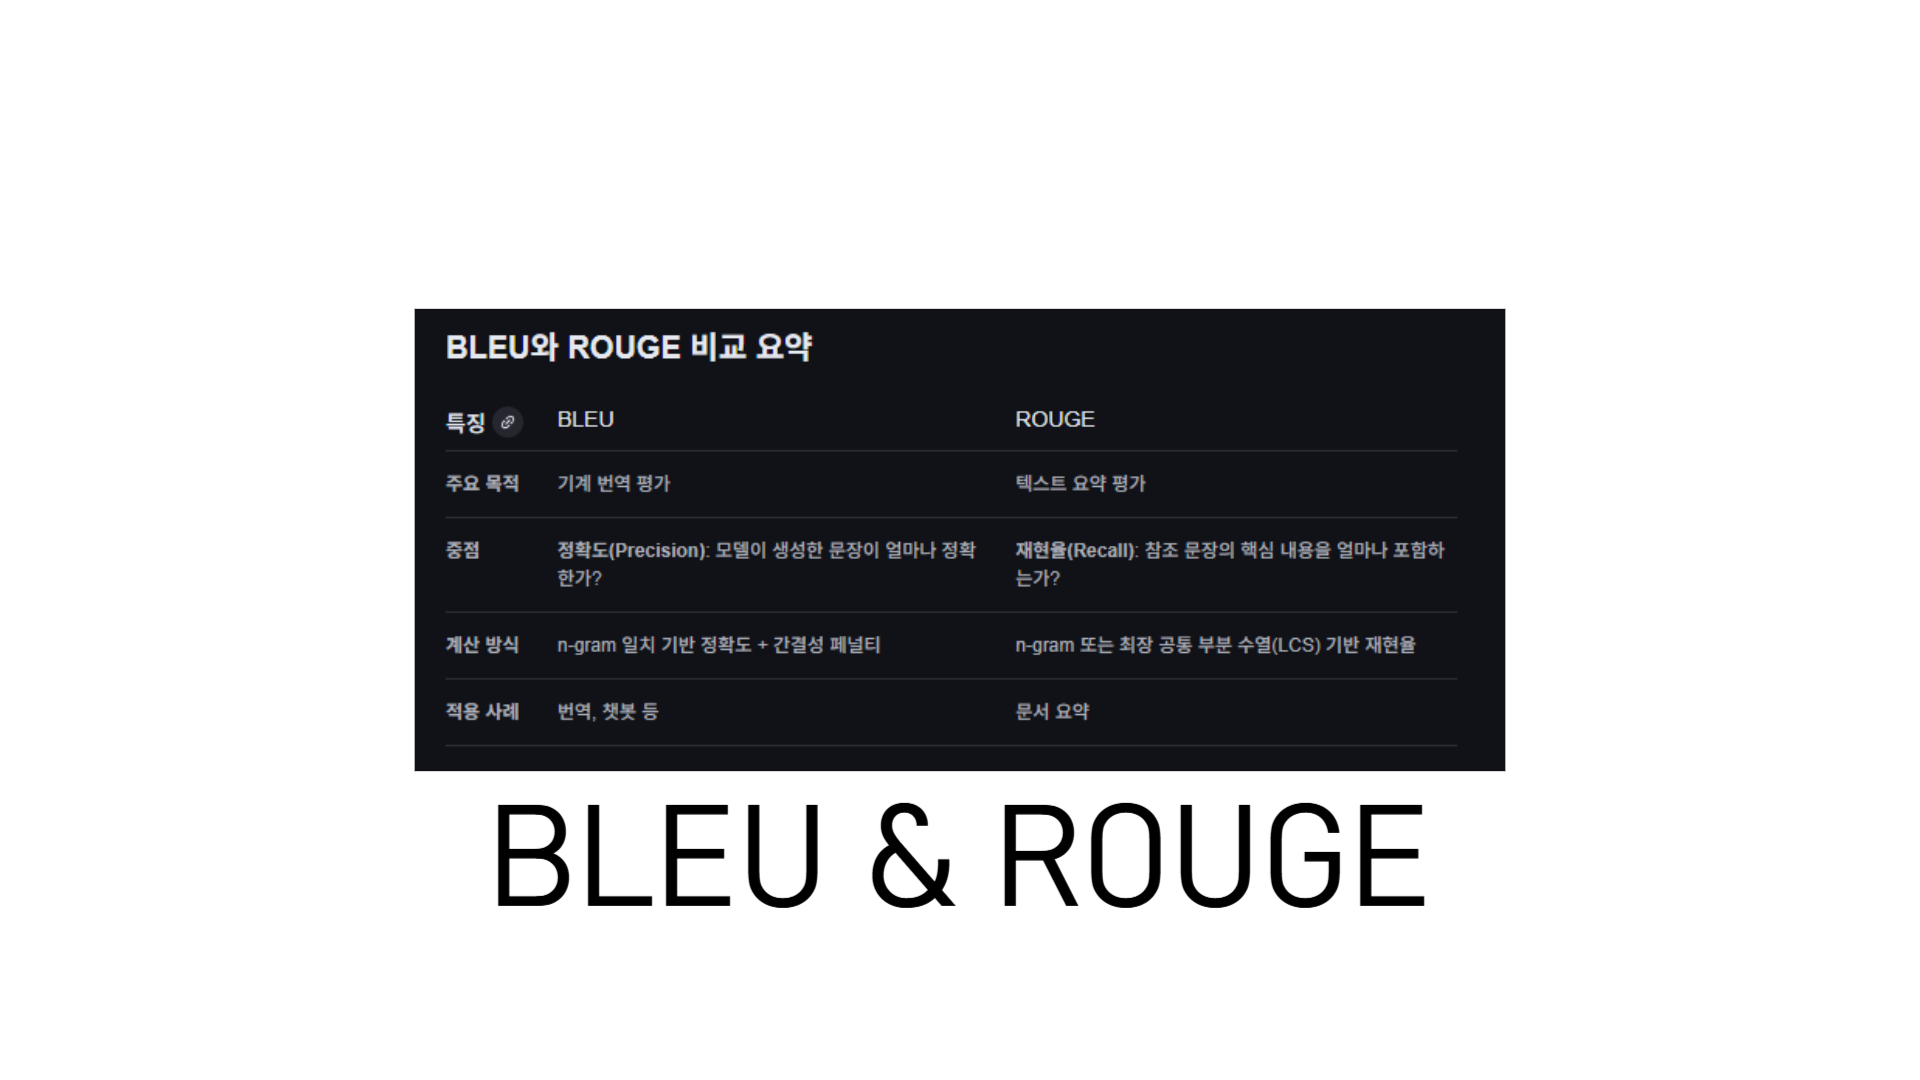
BLEU: 예측이 정답과 얼마나 “정확히 같은 n-그램”을 많이 포함했나(정밀도) + 짧으면 패널티.
ROUGE: 정답의 정보가 예측에 얼마나 “회수되었나”(재현율). 구현에 따라 F1도 흔함.
요약하면 BLEU는 ‘정밀도(precision) 중심’, ROUGE는 ‘재현율(recall) 중심’ 지표이다.
- 주의: 둘 다 동의어/패러프레이즈에는 약해서, 의미 동등성·사실성 평가는 별도 지표(g-Eval, faithfulness 등)로 보완하는 게 좋다.
- 다만 ROUGE는 실무에서 F1(정밀도·재현율 조화 평균)로도 자주 보고한다는 점만 덧붙이자
📚 개념: BLEU와 ROUGE
🧮 BLEU (Bilingual Evaluation Understudy)
-
목적: 예측 문장이 정답과 얼마나 동일한 n-그램을 많이 포함했는지 평가. 정밀도 중심.
-
기본 원리:
- 수정 정밀도(modified n-gram precision): 예측 n-그램 빈도를 정답 빈도로 클리핑해 과대계산 방지.
- 기하평균: 1~N그램 정밀도를 가중(보통 균등) 기하평균.
- 길이 패널티(BP): 예측 길이 c, 정답 길이 r일 때
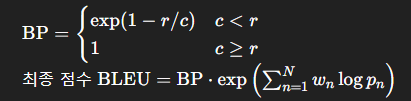
-
실무 팁:
- 코퍼스 단위로 해석할 때 안정적. 문장 단위는 스무딩 필요.
- 보통 BLEU-4, 소규모·짧은 문장에는 BLEU-2 + 스무딩.
- 토크나이저, 대소문자/구두점 처리에 민감.
🧮 ROUGE (Recall-Oriented Understudy for Gisting Evaluation)
-
목적: 정답의 n-그램이 예측에서 얼마나 회수되었는지 평가. 재현율 중심. 구현에 따라 정밀도·F1도 보고.
-
대표 변형:
- ROUGE-N: n-그램 재현율(필요 시 Precision/F1 포함).
- ROUGE-L: 최장 공통 부분수열(LCS) 기반. 순서를 존중. 보통 F1 보고.
- ROUGE-S/SU: 스킵-바이그램(중간 단어 건너뛰기 허용). SU는 유니그램 보정 포함.
- ROUGE-Lsum: 요약 다문장 버전(LCS를 문장 경계에 맞춰 계산).
-
실무 팁:
- 길이를 늘리면 재현율이 인위적으로 상승할 수 있어 F1 병행 권장.
- 다중 레퍼런스가 있으면 점수 신뢰도↑.
🎯 공통 한계와 보완
-
둘 다 표면 중복에 의존. 동의어·패러프레이즈·사실성 판단에 약함.
-
한국어는 공백 기반 토큰화가 불안정. 형태소/서브워드 토큰화 일관화 필요.
-
RAG 평가에는 정확한 근거 회수와 사실성이 중요하므로, BLEU/ROUGE는 참고용으로 두고
- 근거 매칭(hit@k, nDCG),
- 의미 중복(BERTScore, MoverScore, BLEURT),
- 사실성(QAFactEval, LLM-as-Judge/g-eval류)
를 병행하는 구성이 안전.
🎯사용 권장 시나리오
- 생성 번역/표면 충실성: BLEU 유리.
- 요약/핵심 내용 회수: ROUGE-N/ROUGE-L, 가능하면 F1.
- 짧은 문장·데이터 적음: 낮은 N, 스무딩 필수.
- 한국어: 일관된 토크나이징 규칙 문서화 후 적용.
📚 예시
아래 예시로 감 잡아보자. (영문 예시를 쓰면 토큰 경계가 명확해서 계산이 쉽다.)
🧑💻 예시 세팅
- 정답(Reference):
the cat is on the mat← 6토큰- 예측 A(Candidate A):
the cat is on mat← 5토큰- 예측 B(Candidate B):
a cat sits on the mat← 6토큰
🎯 BLEU-2 (정밀도 중심 + 길이 패널티)
BLEU는 예측 문장에 들어있는 n-그램이 정답에도 얼마나 많이 포함되었는지(정밀도)를 보고,
예측이 지나치게 짧으면 패널티(Brevity Penalty)를 준다.
🧑💻 1. A에 대한 BLEU-2
- 1-그램 정밀도(precision):
- 예측 5토큰 모두 정답에 존재 → 5/5 = 1.00
- 2-그램 정밀도:
- 예측 2-그램:
the cat,cat is,is on,on mat(4개) - 정답 2-그램:
the cat,cat is,is on,on the,the mat(5개) - 일치 3개(
the cat,cat is,is on) → 3/4 = 0.75
- 예측 2-그램:
- 기하평균: √(1.00×0.75) ≈ 0.8660
- 길이 패널티 BP: 참조 r=6, 예측 c=5 → BP = exp(1 − r/c) = exp(1 − 6/5) ≈ 0.8187
- BLEU-2 ≈ 0.8187 × 0.8660 ≈ 0.709
🧑💻 2. B에 대한 BLEU-2
- 1-그램 정밀도: 정답과 겹치는 토큰 4개(
cat,on,the,mat) → 4/6 ≈ 0.667 - 2-그램 정밀도: 겹침 2개(
on the,the mat) → 예측 2-그램 5개 중 2/5 = 0.4 - 기하평균: √(0.667×0.4) ≈ 0.516
- 길이 패널티: c=r=6 → 1.0
- BLEU-2 ≈ 0.516
⭐ 해석: A가 B보다 정밀도가 높고(특히 2-그램), A는 다소 짧지만 BP까지 고려해도 BLEU는 A가 더 높음.
🎯 ROUGE (재현율 중심)
ROUGE-N은 정답의 n-그램이 예측에 얼마나 회수되었는지(재현율)를 본다.
관례적으로 recall을 보고, 구현에 따라 Precision/F1도 함께 계산한다.
🧑💻 1. A에 대한 ROUGE
- ROUGE-1 (unigram)
- 정답 6토큰 중 예측이 회수한 토큰 5개 → Recall = 5/6 ≈ 0.833
- Precision = 5/5 = 1.00 → F1 ≈ 0.909
- ROUGE-2 (bigram)
- 정답 2-그램 5개 중 회수 3개 → Recall = 3/5 = 0.60
- Precision = 3/4 = 0.75 → F1 ≈ 0.667
🧑💻 2. B에 대한 ROUGE
- ROUGE-1
- 회수 4개 → Recall = 4/6 ≈ 0.667, Precision = 4/6 ≈ 0.667, F1 ≈ 0.667
- ROUGE-2
- 회수 2개 → Recall = 2/5 = 0.40, Precision = 2/5 = 0.40, F1 = 0.40
⭐ 해석: A가 정답의 토큰/구문을 더 많이 회수해서 ROUGE도 A가 높음.
ROUGE는 길게 쓰면 recall이 쉬워서 올라갈 수 있지만, 불필요한 군더더기도 함께 들어올 위험이 있어 F1을 같이 보는 경우가 많다 (정밀도 균형).