04. 추정과 가설 검정⭐⭐⭐
1) 추정
-
추정이란?
통계적 방법론을 통해서 알고자 하는 대상 = 모집단의 확률 분포
확률분포의 특징을 표현하는 값을 모수(parameter)
대부분 표본조사를 실시하여 모수를 추정한다 -
점추정 (Point Estimation)
-
구간추정 (Interval Estimation)
신뢰도(신뢰수준)로는 90%, 95% 등의 확률을 이용한다
- 모분산 이 알려져 있는 경우에는 수식에 바로 분산을 대입 가능
- 모분산 이 알려져 있지 않은 경우 모분산 대신 표본분산 사용
2) 가설검정
-
가설검정 개념
모집단에 대한 가설을 설정한 후 표본관찰을 통해 가설의 채택 여부를 결정하는 분석법 -
귀무가설 (null hypothesis, )
비교하는 값과 차이가 없다, 동일하다를 기본 개념으로하는 가설
실험, 연구로 기각하고자 하는 특정 가설로, 대립가설과는 상반되는 개념
ex) 기각하고 싶은 가설이라고 할 수 있음 -
대립가설 (alternative hypothesis, )
뚜렷한 증거가 있을 때 주장하는 가설
귀무가설이 틀렸다고 판단될 경우 채택되는 가설
ex) 내가 증명하고자 하는 가설 -
제1종 오류와 제2종 오류
- 제1종 오류 (Type I Error) : 귀무가설()이 사실인데 귀무가설()을 기각하는 오류 (정말 조심해야 하는 오류)
- 제2종 오류 (Type II Error) : 귀무가설()이 사실이 아닌데도 귀무가설()을 채택하는 오류 (계속 의심할 수 있는, 그럴 수 있는 오류)
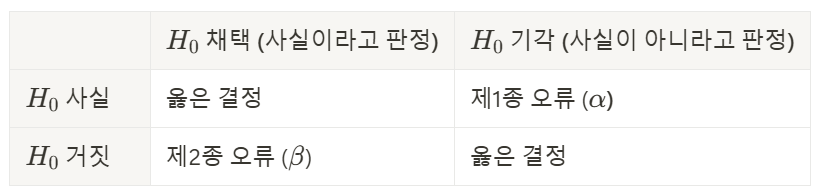
-
검정통계량 (test statistic)
귀무가설의 채택 여부를 판단하기 위해 얻은 값으로, 귀무가설의 옳고 그름을 판단할 수 있는 값이다 -
기각역 (Critical Region, C)
표본 데이터가 특정 범위에 속할 때 귀무가설을 기각할 수 있는 영역
검정 통계량이 기각역 이내에 속하면 귀무가설을 기각한다.
기각역의 반대 개념은 채택역 (Acceptance Region)으로, 채택역에 속하면 귀무가설을 기각할 수 없다.
기각역의 경곗값을 임곗값 (ciritical value)이라고 한다. -
유의수준
귀무가설을 기각할 확률의 크기 '귀무가설이 옳은데도 이를 기각하는 확률의 크기(최대 허용 한계)'
제1종 오류와 제2종 오류는 반비례 관계로, 하나를 낮추면 다른 하나가 커지기 때문에 제1종 오류를 허용할 수 있는 최대 확률 유의수준을 설정하여 가설검정을 수행한다. -
유의확률(significance probability, p-value)
주어진 통계량이 귀무가설을 지지하는 정도를 나타내는 값
이 값이 유의수준보다 작은 경우, 귀무가설이 참이라고 가정했을 때 귀무가설과 같은 결과가 나올 확률이 매우 적다
p-value란 귀무가설이 참일 때 t값을 얻을 확률이기 때문에 이 값이 적어야 대립가설(내가 지지하는 가설)이 유의미함 > 0.05, 0.01보다 작아야 함
3) 비모수검정
-
모수적 방법
모수라고 하는 것은 결국에는 분포를 의미함
이 모수라는 값이 큰 지 작은 지 구별하는 것이 매우 중요하다.
큰 지 작은 지를 안다는 것은 그 분포를 아는 것이다.
표본평균, 표본분산 등을 이용해 검정하는 방법 -
비모수적 방법
분포를 구하지 못할 때, 모를 때 사용하는 검정 방법
(분포를 수식으로 만들 수 없기 때문에 모수가 큰 지 작은 지 알 수가 없다)
N수(샘플 사이즈)가 적을 때, 자료가 개체 간의 서열관계를 나타내는 경우에 사용
관측값들의 순위나 차이의 부호 등을 이용하여 검정한다
ADsP 강의 10주차 강의 - 8주차 강의 자료
01. 기술통계
1) 기술통계란?
관측을 통해 자료의 특성을 표, 그림, 통계량 등을 사용하여 쉽게 파악할 수 있도록 정리, 요약하는 것
데이터의 대략적인 통계적 수치를 계산해 보며 분석한다
통계란 과거의 자료
확률이란 미래의 자료
-
히스토그램
주어진 데이터를 구간으로 나누고, 각 구간에 속하는 데이터의 빈도를 막대로 표현한 그래프
데이터의 분포를 살펴보고, 데이터의 모양이나 특성을 파악하는 데에 사용
연속형(Continuous)으로 표시된 데이터를 표현하며 임의로 순서를 변경할 수 없고, 막대 사이의 간격이 없다 -
막대그래프
범주형으로 구분된 데이터를 표현하며 범주의 순서를 의도에 따라 바꿀 수 있다 -
줄기-잎그림 (Stem-and Leaf Plot)
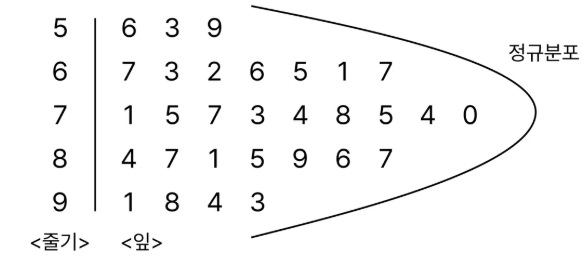
-
상자그림 ⭐ (사분위수)
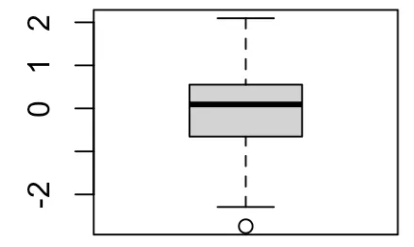
다섯 숫자 요약을 통해 그림으로 표현 (최솟값, Q1, Q2, Q3, 최댓값)
보통이상점 (Mild Outlier) : 안쪽 울타리와 바깥 울타리 사이에 있는 자료
극단이상점 (Extreme Outlier) : 바깥 울타리 밖의 자료
2) 인과관계의 이해
-
종속변수 (반응변수, y)
다른 변수(독립변수)에 의해 영향을 받는 변수 -
독립변수 (설명변수, x)
다른 변수(종속변수)에 영향을 주는 변수
독립변수는 종속변수의 값을 설명, 예측할 때 사용하며 종속변수의 원인이 되는 변수 -
산점도 ⭐
두 변수 간의 관계를 시각적으로 나타내는 그래픽 표현 방법
각 점은 두 변수의 값을 나타내며, 점들의 분포를 통해 두 변수 간의 관계를 시각적으로 확인 가능
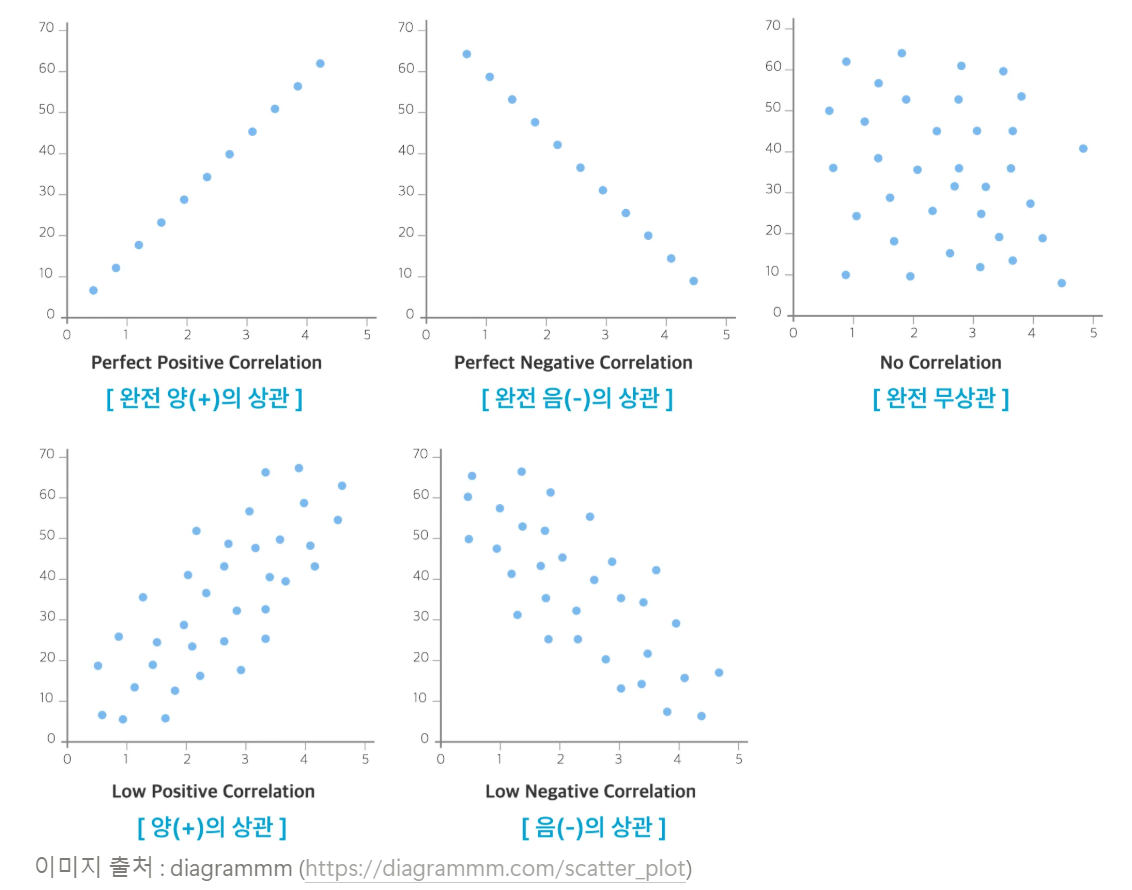
두 변수 사이의 선형관계(직선관계)
두 변수 사이의 함수관계 (직선 또는 곡선관계)
이상값의 존재 여부
몇 개의 집단으로 구분되는지
02. t-검정
t-value : 그룹간 평균 차이를 보는 값
표본평균의 차이를 불확실성(표준 오차)으로 나눈 것으로 볼 수 있다
1) 일 표본 t-검정
- 일 표본 t-검정 (one sample t-test) 이란?
한(one) 집단의 평균이 어떤 특정한 값과 차이가 있는지를 검정하는 통계적 방법
주로 특정 가설을 확인하거나 평균이 기대값과 일치하는지 여부 평가
2) 이(독립) 표본 t-검정
독립된 그룹 간의 평균 차이가 있는지를 검정하는 통계적 방법
두 그룹의 분산이 같음을 의미하는 등분산성을 만족해야 하므로 등분산 검정(F 검정)이 우선되어야 한다.
3) 대응 표본 t-검정 (Paired t-Test)
동일한 대상에 대해서 두 가지 관측치(전, 후 등)가 있는 경우 이를 비교하여 차이가 있는지 검정하는 방법
두 변수간의 변화가 우연에 의한 것인지, 특정한 조건에 의해 유발된 것인지 알 수 있다
