과제 목표
- python pandas library로 데이터 기초 핸들링 및 응용 실습
- 과제 데이터셋 : flight_data_homework
- 과제 문제마다 하기 기본 library import
import pandas as pd
import numpy as np
from datetime import datetime, timedelta
참고 자료 : datetime, timedelta란?
- datetime 라이브러리
현재 시간을 받아오는 라이브러리로, timedelta 라이브러리로 datetime의 객체간 연산 수행 가능
- 기본 사용법
    from datetime import datetime, timedelta

    # 현재 시간
    print('현재시간 : ', datetime.now())

    # 하루 전 시간
    delta = datetime.now() - timedelta(1) # 원하는 day 입력하면 됨
    print('하루 전 시간 : ', delta)

    # 1년 전 시간
    delta = datetime.now() - timedelta(1)*365
    # 혹은
    delta = datetime.now() - timedelta(365)
    print('1년 전 시간 : ', delta)
    # timedelta() 라는 객체 자체에는 곱하기, 나누기는 적용 가능하나 덧셈, 뺄셈은 불가
필수 문제 1번. 데이터 불러오기
- Python 라이브러리를 활용하여 구글 드라이브의 CSV 파일을 DataFrame으로 읽어오는 코드를 작성해주세요.
- 테이블의 행과 열 개수를 확인해주세요.
➡️.shape메소드 사용- 테이블의 처음 5줄을 확인해주세요.
➡️.head()사용, 처음 n줄까지 출력 가능, 디폴트값은 5
.tail(): 마지막 n줄까지 출력 가능, 디폴트값은 5
참고 자료 : pandas head, tail, print 함수의 활용- 결과 제출형태: Library import 부분을 포함한 정답코드
- 제출 코드
from google.colab import drive
drive.mount('/content/drive')
df = pd.read_csv('/content/drive/MyDrive/Colab/Python_Live_Session/flight_data_homework.csv') # flight_data_homework.csv

# 기본 라이브러리 import
import pandas as pd
import numpy as np
from datetime import datetime, timedelta


df.shape # dataframe의 행과 열 개수 확인
# 출력 : (10683, 11)
df.head() # dataframe의 첫 5줄 출력
필수 2번 문제. 결측치 처리
- 각 컬럼별 결측치 개수를 구해주세요.
➡️.isna().sum(),.isnull().sum()으로 컬럼별 결측치 확인 가능- 결측치가 있는 행을 모두 제거해주세요.
참고 자료 : pandas 결측치 제거- 결과 제출형태: Library import 부분을 포함한 정답코드
# 기본 라이브러리 import
import pandas as pd
import numpy as np
from datetime import datetime, timedelta

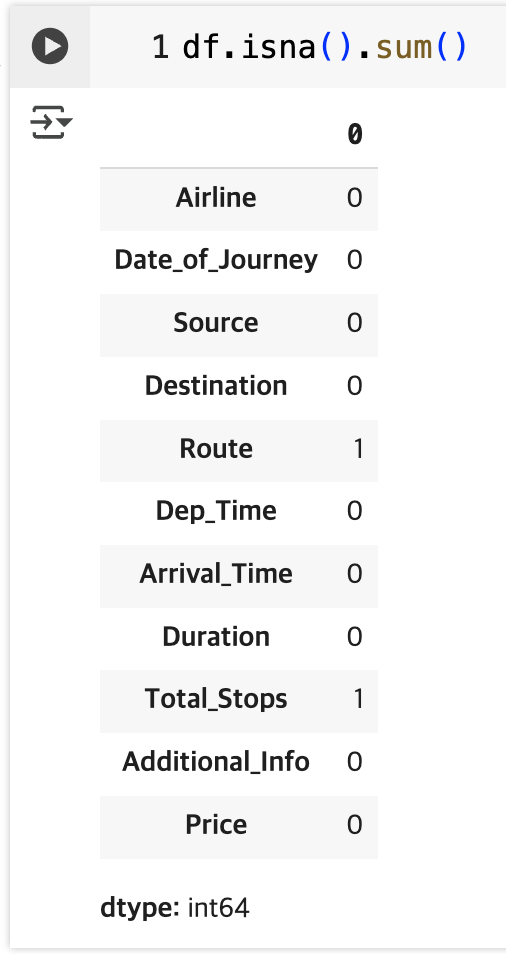
df.isna().sum()- 출력 결과
# 결측치가 있는 행 모두 제거 - 결측치가 한 개라도 있으면 그 행이 있는 컬럼이 모두 삭제됨
df.dropna()

# 결측치 제거 후 결과를 바로 저장하고 싶을 때, inplace=True
df.dropna(inplace=True)
필수 3. 조건에 맞는 데이터 추출하기
- 데이터프레임의 Destination 컬럼 기준 price의 평균값과 중앙값을 동시에 구해주세요.
단, 값은 모두 소수점 첫번째 자리까지 표현해주세요.
참고 자료 : pandas groupby를 이용한 집계,
pandas 그룹별 합계와 평균 구하기
➡️ 평균값 :.mean(), 중앙값 :.median()- 데이터프레임의 Airline, Total_Stops 기준 Route 컬럼을 중복값 없이 추출해주시고,
인덱스를 재정렬해주세요. 이를 df2 라는 dataframe 으로 받아주세요.- 결과 제출형태: Library import 부분을 포함한 정답코드
# 기본 라이브러리 import
import pandas as pd
import numpy as np
from datetime import datetime, timedelta

# Destination 기준 Price의 평균값과 중앙값 동시에 구하기
df.groupby('Destination')['Price'].agg(['mean', 'median']).round(1)

# Airline, Total_Stops 기준 Route 중복값 없이 추출 후 인덱스 재정렬하여 df2
df.groupby(['Airline', 'Total_Stops'])['Route'].unique()
df2 = df.groupby(['Airline', 'Total_Stops'])['Route'].unique().reset_index()
필수 4. 조건에 맞는 데이터 추출하기2
- 피벗테이블을 구현하여 출발지와 도착지를 기준으로 한 Airline을 카운트해주세요.
그리고, 카운트 값을 기준으로 내림차순 정렬해주세요.- Airline 컬럼이 Air India 이고, Price 컬럼이 7000 이상인 데이터를 필터링 해주세요.
- 결과 제출형태: Library import 부분을 포함한 정답코드
# 기본 라이브러리 import
import pandas as pd
import numpy as np
from datetime import datetime, timedelta

# 출발지(Source)와 도착지(Destination)을 기준으로 한 Airline 카운트후 내림차순 정렬
pd.pivot_table(df, index = ['Source', 'Destination'], values = 'Airline', aggfunc = 'count').sort_values(by = 'Airline', ascending = False)

# Airline컬럼이 Air India, Price 컬럼이 7000이상인 데이터 필터링
mask = ((df['Airline'] == 'Air India') & (df['Price'] >= 7000))
df[mask]
도전 1번. 조건에 맞는 데이터 추출하기3
- Date_of_Journey 기준 수요일에 예약된 경우의 평균 가격을 구해주세요.
- 힌트1: pandas의 to_datetime 함수의 infer_datetime_format(여러 datetime 유명한 포맷 중에서 datetime이 어떤 형식으로 이루어졌는지 확인 후 자동으로 변환)
- 힌트2: 아래 두가지 방식 중 하나를 선택하여 문제를 풀어주세요.
1️⃣ dt.day_name() 의 사용
2️⃣ rrule 함수의 byweekday property사용
- 함수 사용을 위해, dtstart는 Date_of_Journey 컬럼의 최소값으로 설정해주세요.
- rrule byweekday property는 아래와 같이 사용할 수 있습니다.
참고 자료 :
pandas to_datetime
pandas dt 연산자 활용
-
infer_datetime_format 이란?
format 지정 없이, datetime이 어떤 형식으로 이루어져있는지 확인 후 자동으로 변환한다. -
dt.day_name() 이란?
dt.day_name()는 '요일'을 문자열로 추출하는 함수 -
rrule 함수의 byweekday property
#문자열 형식을 활용하지 않을 경우, 라이브러리 import 예시
from dateutil.rrule import rrule, WEEKLY

#문자열 형식을 활용할 경우, 라이브러리 import 예시(월요일, 화요일, 일요일 사용)
from dateutil.rrule import rrule, WEEKLY, MO, TU, SU

월: MO 또는 0
화: TU 또는 1
수: WE 또는 2
목: TH 또는 3
금: FR 또는 4
토: SA 또는 5
일: SU 또는 6

사용법
rrule(~~, byweekday=❓❓❓)
df는 현재 Date_of_Journey가 object타입이기 때문에 pd.to_datetime 을 이용하여 datetime 자료형으로 변환해주어야 한다.
# 기본 라이브러리 import
import pandas as pd
import numpy as np
from datetime import datetime, timedelta

#
df['Date_of_Journey'] = pd.to_datetime(df['Date_of_Journey'], infer_datetime_format = True)
df['Date_of_Journey']- 출력 결과
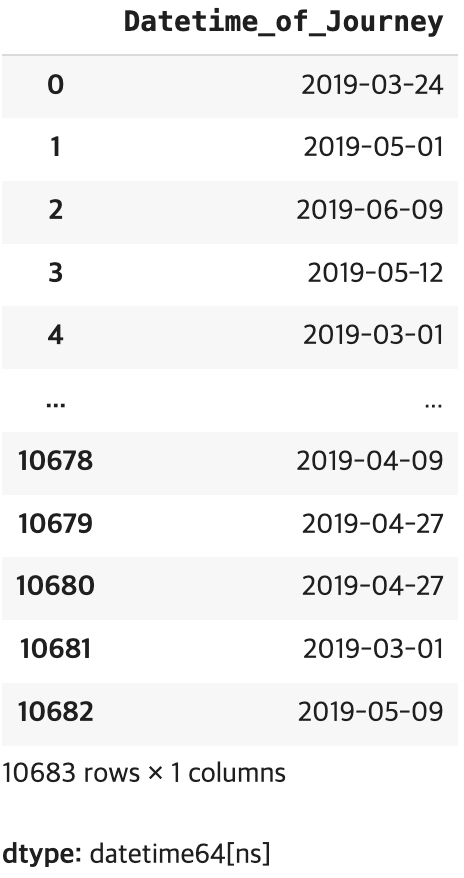
object type이 datetime으로 변경된 것을 확인할 수 있다.
# datetime형태로 변경된 Date_of_Journey를 요일로 변환
df['Date_of_Journey'] = pd.to_datetime(df['Date_of_Journey'], infer_datetime_format = True)
df['Date_of_Journey'] = df['Date_of_Journey'].dt.day_name()
df['Date_of_Journey']- 출력 결과
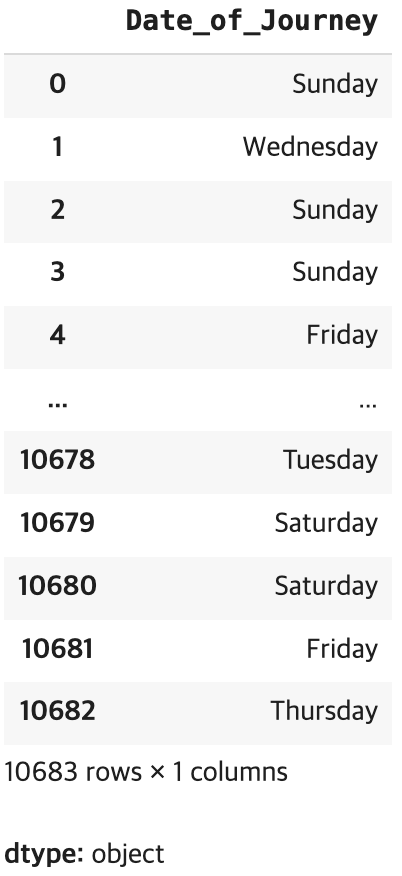
이렇게 변환된 Date_of_Journey에서 수요일('Wednesday')라는 날짜만 필터링해서 평균 가격(mean)을 구하는 방법을 찾다가
mask + groupby or pivot_table을 사용하는 방법 대신 .loc[]라는 함수를 찾게 되었다.
- mask + groupby 사용한 경우
df_wed = df[(df['Date_of_Journey'] == 'Wednesday')]
df_wed.groupby('Date_of_Journey')['Price'].mean()

# 한 줄로 정리해서 작성하면,
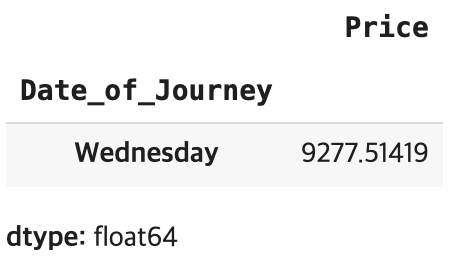
df[(df['Date_of_Journey'] == 'Wednesday')].groupby('Date_of_Journey')['Price'].mean()
-
출력 결과
-
.loc[] 란?
참고 자료 : pandas loc[]로 행, 열 조회하기
.loc[]는 'location'의 약자로, 내가 원하는 행 또는 열의 데이터를 조회할 수 있는 attribute 중의 하나다. 즉, 이름 그대로 원하는 데이터의 '위치'를 찾아서 가져오는 것.
# 기본 구조
df.loc['행 조건', '열 조건']
위의 .loc[]를 사용하여 조건에 맞는 코드를 작성하면 다음과 같다.
df_wed = df.loc[df['Date_of_Journey'] == 'Wednesday', 'Price'].mean()
df_wed- 출력 결과
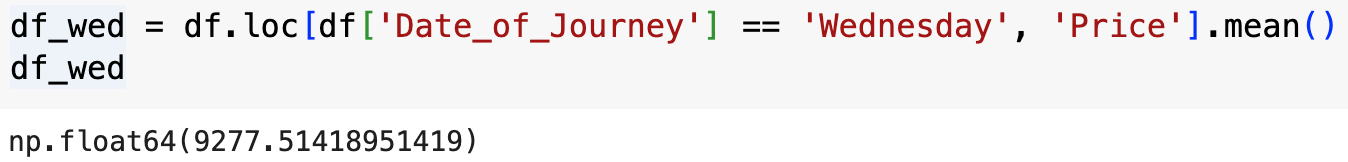
보다시피, mask + groupby의 결과와 .loc[] 결과가 다르다.
.loc[]는 최종적으로 집계 결과의 '값'만을 보여주고 있어 데이터 프레임이 아닌 수치로 결과물이 나타난다.
어떤 방법이 정답인지는 내일 튜터님께 문의해봐야 정확히 알 수 있을 것 같아서,
오늘은 여기까지 풀어보았다. (왠지 mask + groupby가 맞을 것 같다..😂)
내일은 rrule도 한번 사용해서 다시 풀어보고 결과를 비교해볼 예정이다.
