[논문 리뷰] Machine node-enhanced graph contrastive learning with long-range prompt model for quality propagation in multistage manufacturing systems (2025.08 Manufacturing Systems Journal)
0. Abstract
현대의 제조 공정은 더욱 복잡한 다단계 제조 시스템(MMSs, Multistage Manufacturing Systems)이 주류를 이루고 있다. 이에 따라 공정이 복잡해짐에 따라 품질 전파(Quality Propagation)를 예측하는 것이 매우 중요해졌다. 딥러닝이 해결책으로 떠올랐지만, 기존 모델들은 1. 개별 공정만 보거나, 2. 실제 공정 흐름을 무시하거나, 3. 라벨링 된 데이터에만 의존하여 노이즈에 취약하다는 한계가 있었다.
본 논문은 이러한 문제를 해결하기 위해 MNGCLP (Machine Node-enhanced Graph Contrastive Learning with Long-range Prompt) 모델을 제안한다. 이 모델의 핵심은 다음과 같다.
Solution
MNGCLP (Machine Node-enhanced Graph Contrastive Learning with Long-range Prompt) 모델을 제안
-
1단계: 기계 간의 생산 관계를 모델링하여 생산 공정 그래프(Production process graph)를 형성한다.
-
2단계: 대조 학습 기반의 사전 훈련 과정에서 기계 강화 그래프(Machine-enhanced graph)를 설계한다. 이는 생산 공정의 논리를 위반하지 않으면서 생산 정보를 추가하고, 라벨 의존도를 낮추는 역할을 한다.
- 3단계: 사전 훈련된 모델을 미세 조정(Fine-tuning)하기 위해 원본 그래프에서 포착된 기계 노드 간의 장거리 관계(Long-distance relationship)를 Prompt로 사용한다.
지도 학습 기반 그래프 신경망(Supervised GNN) 대비 RMSE는 2.4%, MSE는 4.8%, MAE는 9.8% 향상되었으며,
대조 학습 기반 그래프 신경망(Contrastive GNN) 대비 RMSE는 2.5%, MSE는 5.0%, MAE는 6.3% 향상되었다.
이에 따라 MNGCLP 모델은 전통적인 모델보다 우수한 성능을 보였으며 예측 결과에 대한 합리적인 설명을 제공하였다.
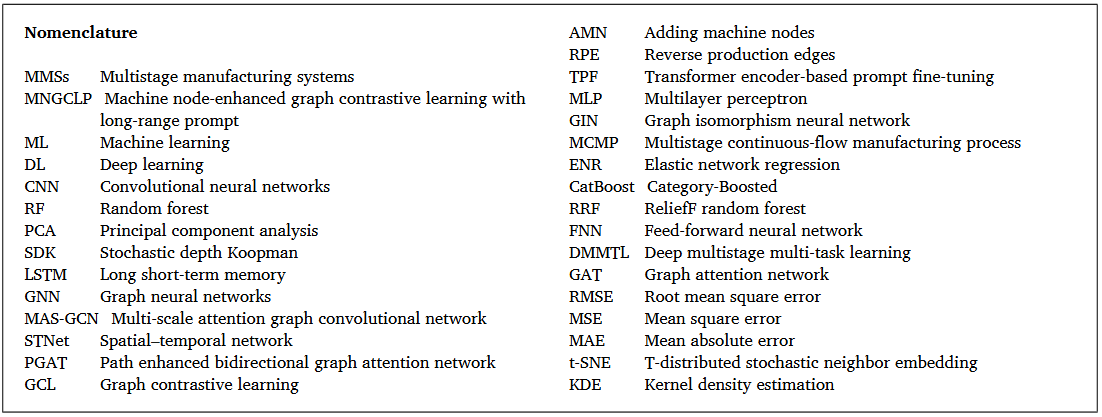
친절하게 용어 설명 부분도 따로 제공해준다.
1. Introduction
1.1 Motivation
과거의 공장은 단순한 직렬구조였지만, 현대의 다단계 제조 시스템(MMSs)은 기계들이 직렬과 병렬로 복잡하게 얽힌 '직렬-병렬 하이브리드(Serial-Parallel Hybrid)' 형태를 띤다. 이런 환경에서는 앞단 기계의 미세한 오차가 뒷단으로 넘어가며 증폭되거나 변형되는 품질 전파(Quality Propagation) 현상이 발생한다. 마치 나비 효과처럼, 초기 단계의 작은 변수가 최종 제품의 품질을 결정짓는 핵심 요인이 되는 것이다.
1.2 Problem Definition - 기존 연구
-
단일 단계 모델의 한계: 기존의 단일 단계 모델은 개별 기계나 단일 단계의 품질만을 예측할 뿐, 공정 간의 품질 전파(Quality Propagation) 효과를 무시한다.
-
기존 다단계 모델의 한계: 일부 모델이 품질 전파를 고려하긴 하나, 단순히 단계 내의 기계 특성(Feature)을 집계하는 수준에 그치거나 실제 생산 공정과 일치하지 않는 기계 간 공간 관계를 사용한다.
-
데이터 의존성 문제: 전통적인 모델은 라벨 데이터(정답 데이터)에 대한 의존도가 매우 높다. 따라서 노이즈가 섞인 데이터를 충분히 활용하기 어렵고, 이는 예측 정확도 저하와 해석 가능성 부족으로 이어진다.
1.3 Contribution
- "라벨이 부족하고 노이즈가 많은 현실 공장 데이터"를 제대로 활용하기 위해 그래프 대조 학습(Graph Contrastive Learning) 제안
- 정답(Label)이 없어도 데이터 자체의 구조를 학습할 수 있는 자기 지도 학습(Self-supervised Learning)을 사용
- 기존 대조 학습은 그래프를 무작위로 자르거나 변형했지만, 공장 프로세스를 함부로 끊으면 문제 발생 따라서, 실제 생산 공정의 흐름을 해치지 않으면서 기계 노드를 강화(Enhancement)하는 새로운 기법 적용
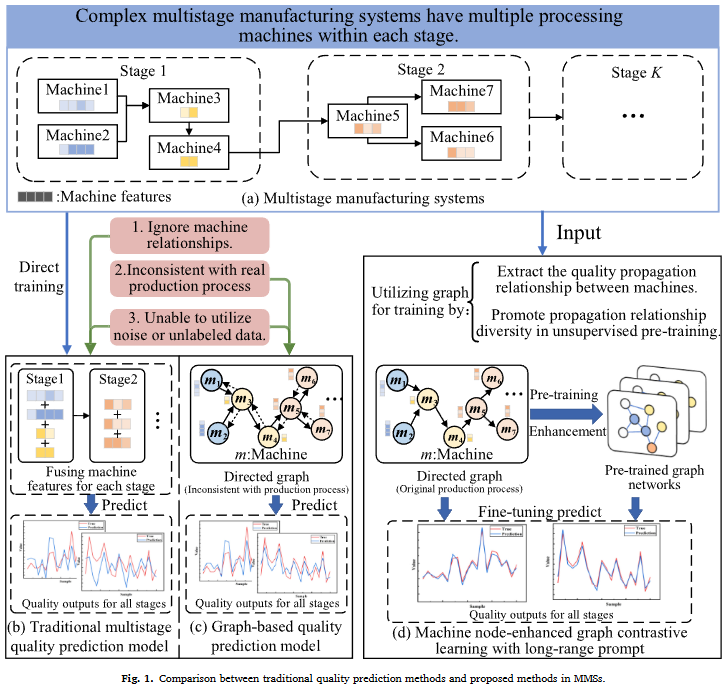
기존 모델들의 한계와 MNGCLP의 접근 방식을 위 그림으로 명확히 비교
(a) Multistage manufacturing systems: 현대의 공정은 그림처럼 Stage 1의 여러 기계(병렬)가 Stage 2(직렬)로 합쳐지는 복잡한 구조
(b) Traditional Model (기존 모델): 단순히 각 단계의 기계 특징(Feature)을 더하기(Fusing)만 한다. 기계끼리 어떻게 영향을 주고받는지(화살표)는 무시된다.
(c) Graph-based Model (그래프 모델): 기계들을 연결했지만, 실제 공정 흐름과 맞지 않거나(Inconsistent), 노이즈/라벨 없는 데이터를 활용하지 못하는 한계 존재
(d) MNGCLP (제안 모델):
- 그래프 구축: 실제 공정 흐름 그대로 그래프를 그린다.
- Pre-training (사전 훈련): 기계 노드 강화(Enhancement)를 통해 정답 라벨이 없어도 다양한 전파 경로를 미리 학습한다 .
- Fine-tuning (미세 조정): 마지막으로 장거리 프롬프트(Prompt)를 사용해 멀리 떨어진 기계 간의 영향력까지 고려하여 최종 품질을 예측한다.
2. Literature review
크게 단일 단계 예측, 다단계 예측, 그리고 그래프 대조 학습의 흐름으로 기존 연구를 분석
1. 단일 단계 품질 예측 (Single-stage Quality Prediction)
초기 연구들은 복잡한 공정 전체를 보기보다는, 개별 기계나 특정 단계의 품질을 맞추는 데 집중했다.
- 머신러닝(ML) 기반: 데이터 불균형 문제를 해결하기 위해 향상된 트리 모델을 사용하거나, 작은 데이터셋에서 부스팅(Boosting) 기법을 활용했다.
- 딥러닝(DL) 기반: CNN을 활용해 고품질 라벨에 대한 의존도를 낮추거나 , 동적 특징 추출 네트워크를 도입해 성능을 높였다.
하지만 한계로, 이 방법들은 단일 단계 공정에만 초점을 맞추고 있어, MMSs(다단계 제조 시스템)에서 단계와 단계 사이로 품질 영향이 퍼져나가는 전파 효과(Propagation effects)를 무시한다.
2. 다단계 품질 예측 (Multistage Quality Prediction)
공정이 복잡해지면서, 여러 단계를 아우르는 모델들이 등장했다.
-
통계 및 ML 접근: PCA와 연관 규칙을 결합하거나, 엔트로피 정보를 이용해 중요한 특징을 선택한 후 랜덤 포레스트(RF)를 쌓아 올리는 방식이 제안되었다 .
-
딥러닝 접근
- DMMTL (Deep Multistage Multi-Task Learning): 비선형 은닉 상태 표현을 사용하여 다단계 제품의 다중 출력 예측을 수행했다 .
- SDK (Stochastic Depth Koopman): 품질 정보의 전파를 선형화하여 모델의 해석 가능성을 높였다.
- LSTM: 양방향 직렬-병렬 LSTM 모델을 도입해 데이터 이상치를 처리하기도 했다.
하지만 이 또한 한계가 존재하는데, 1. 구조적 한계: 대부분 직렬(Serial) 생산 공정에만 적용 가능하며, 단계 내의 복잡한 병렬 흐름 관계를 무시하고, 2. 라벨이 없거나 노이즈가 섞인 데이터는 활용하지 못한다.
3. 그래프 신경망과 대조 학습의 등장 (GNN & GCL)
여기서 그래프(Graph) 데이터 구조가 구원투수로 등장한다. 그래프는 기계(노드)와 공정(엣지)의 관계를 표현하는 데 탁월하기 때문이다.
- 그래프 신경망 (GNN): PGAT(Path Enhanced Bidirectional Graph Attention Network) 같은 모델은 기계 간의 장거리 의존성을 학습하는 데 성공했다. 하지만 여전히 고품질 라벨 데이터에 크게 의존한다는 한계
이 문제를 해결하기 위해 그래프 대조 학습(Graph Contrastive Learning, GCL)이 도입되었다. GCL은 라벨이 없어도 데이터 자체의 구조를 학습(Self-supervised)하여 라벨 의존도를 낮춘다.
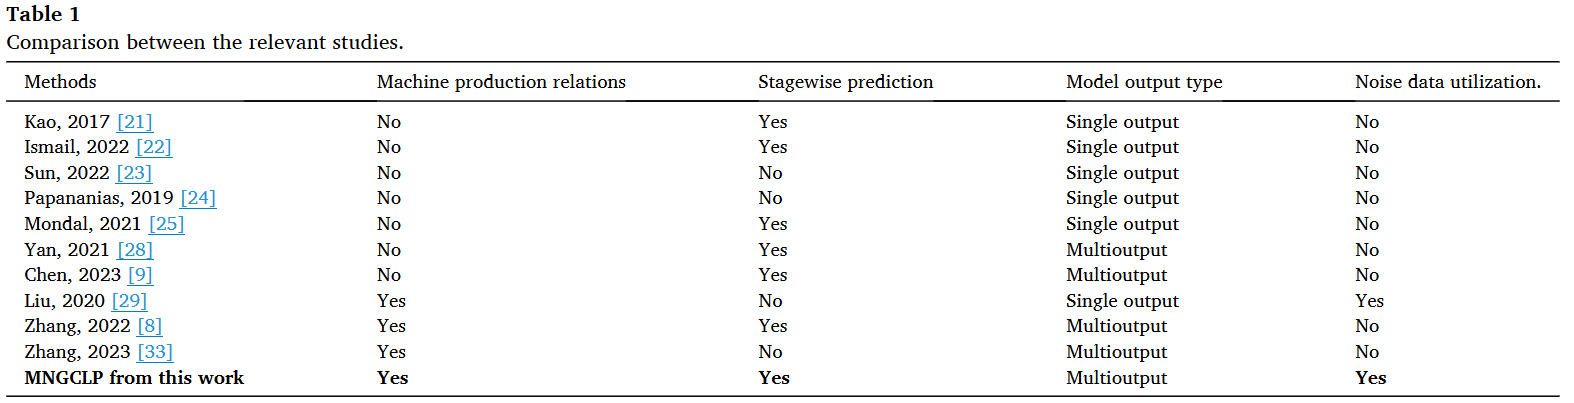
위 Table 1처럼,
-
생산 단계 내 기계들의 복잡한 상호 의존성을 모델링한다.
-
각 단계의 다중 품질 지표를 동시에 예측한다.
-
노이즈가 있는 라벨 데이터도 효과적으로 활용한다.
3. Proposed Framework
해당 section에서는 제안한 모델에 대해서 더 깊게 설명한다
앞서서도 언급한 것처럼, MNGCLP 모델은 크게 데이터 전처리 및 그래프 구축, 사전 훈련(Pre-training), 그리고 미세 조정(Fine-tuning)의 3단계로 나뉜다.
3.1 Problem Definition - 공장의 문제
MNGCLP 모델을 이해하기 위해서는 먼저 해결하려는 문제가 무엇인지, 그리고 공장의 요소들이 수식으로 어떻게 정의되는지 명확히 해야 한다.
핵심은 "복잡한 관계를 가진 기계들의 특징을 입력받아, 노이즈가 섞인 환경에서도 최종 품질을 정확히 예측하는 것"이다.
1. 기계와 특징 (Machines & Features)
공장은 수많은 기계()의 집합이다. 각 기계는 저마다의 상태 값을 가진다.
- 기계 (): 전체 기계 집합 에 속한 개별 기계.
- 특징 (): 각 기계의 설정값(모터 속도, 압력 등)이나 원자재 속성. 이를 차원의 벡터 으로 정의한다.
2. 예측 목표: 품질 지표 (Quality Indicators)
각 생산 단계()마다 우리가 맞춰야 할 정답(Target)이다.
- 품질 (): 단계의 품질 측정값 집합 이다.
- 문제: 실제 데이터는 노이즈(Noise)가 많고, 기계 간의 상호작용으로 인해 품질이 비선형(Nonlinear)적으로 변해 예측이 매우 까다롭다.
3. 핵심 내용: 생산 공정 그래프 (Production Process Graph)
기계들을 독립적으로 보지 않고, '연결된 관계'로 파악하기 위해 그래프를 그린다.
- 그래프 ():
- 노드 (): 기계 그 자체.
- 엣지 (): 제품이 이동하는 생산 흐름.
- 인접 행렬 (): 기계 간의 연결도. 기계 에서 로 제품이 넘어가면 로 표시한다.
4. MNGCLP의 최종 목표 (Goal)결국 이 모델이 하고자 하는 것은 다음 한 문장으로 요약된다.
"기계 특징()과 연결 관계()를 입력으로 받아, 노이즈를 이겨내고 각 단계의 품질()을 정확히 맞추는 것."
- 이를 위해 MNGCLP는 두 단계로 문제를 푼다.
-
사전 훈련 (): 정답 없이 기계 간의 전파 효과(Propagation effects)를 먼저 공부한다.
-
다중 작업 예측 (): 공부한 내용을 바탕으로 여러 품질 지표를 동시에 예측한다.
-
3.2 Machine node-enhanced graph contrastive learning with long-range prompt framework
원 논문에서는 수식 관련한 내용들이 많지만, 수식에 대한 설명은 최소한으로 정리하고자 한다.. (내용이 방대하다.)
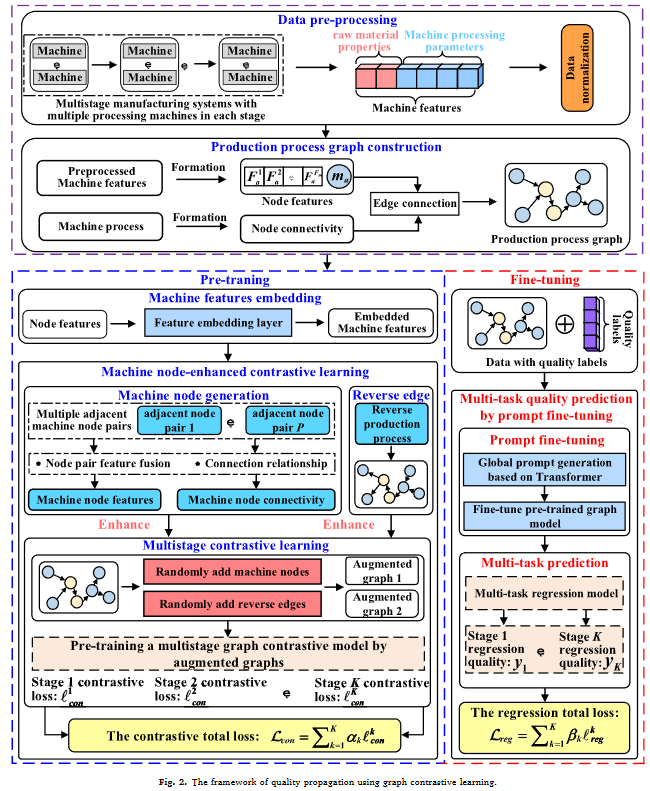
전체 Framework
1) 데이터 전처리 및 생산 공정 그래프 구축 (Data Pre-processing & Graph Construction)
-
Figure 2의 상단(Purple Box)에 해당하는 부분이다.
-
데이터 수집: 초기 단계 기계의 원자재 속성과 가공 매개변수, 후속 기계들의 가공 매개변수를 수집한다.
-
정규화(Normalization): 데이터 품질을 높이기 위해 수집된 데이터를 정규화한다.
-
그래프 변환: 각 기계를 노드(Node)로, 기계 간의 생산 흐름을 엣지(Edge)로 설정하여 생산 공정 그래프(Production Process Graph)를 생성한다. 이를 통해 직렬 및 병렬 기계 간의 제품 전파 영향을 모델링한다 .
2) 기계 노드 기반 그래프 대조 사전 훈련 (Pre-training)
-
Figure 2의 좌측 하단(Blue Box)에 해당하는 부분이다.
-
이 단계의 목표는 품질 라벨 없이 기계 간의 인접한 전파 효과(Adjacent Propagation Effects)를 학습하는 것이다.
-
배경: 라벨 데이터에 노이즈가 많거나 라벨링이 어려운 경우, 이를 모두 제거하면 학습할 데이터가 부족해진다. 따라서 라벨이 없는 데이터까지 모두 활용하기 위해 자기 지도 학습(Self-supervised Learning) 방식인 대조 학습을 도입한다 .
-
기계 노드 강화(Machine Node Enhancement): 기존 대조 학습처럼 노드를 무작위로 삭제하면 공정이 끊긴다. 대신, 인접한 기계 노드 쌍을 융합하여 새로운 노드를 추가하거나 역방향 엣지(Reverse Edge)를 추가하는 증강 기법을 사용한다.
- 효과: 이를 통해 모델은 생산 공정의 흐름을 위반하지 않으면서도 다양한 관계 패턴을 학습하게 되며, 라벨 노이즈에 강건한 특징 표현을 익힌다 .
3) 장거리 프롬프트 미세 조정을 통한 다중 작업 예측 (Fine-tuning)
- Figure 2의 우측 하단(Red Box)에 해당하는 부분이다.
- 사전 훈련된 모델은 인접한 관계는 잘 알지만, 멀리 떨어진 기계 간의 관계(Global Interaction)를 파악하는 데는 한계가 있다. 이를 장거리 프롬프트로 보완한다.
-
Transformer 기반 프롬프트: Transformer를 사용하여 기계 노드 간의 장거리(Long-distance) 관계 정보를 포착하고, 이를 '프롬프트(Prompt)' 형태로 그래프에 추가한다 .
-
다중 작업 예측(Multi-task Prediction): 사전 훈련된 그래프 인코더에 프롬프트를 적용하여 각 단계의 특징을 추출하고, 이를 통해 여러 품질 지표를 동시에 예측한다.
- 최종 학습: 소량의 고품질 라벨 데이터를 사용하여 전체 모델을 미세 조정(Fine-tuning)함으로써, 사전 훈련과 실제 예측 작업 사이의 격차(Gap)를 줄이고 예측 성능을 극대화한다 .
3.3 The model construction of proposed MNGCLP
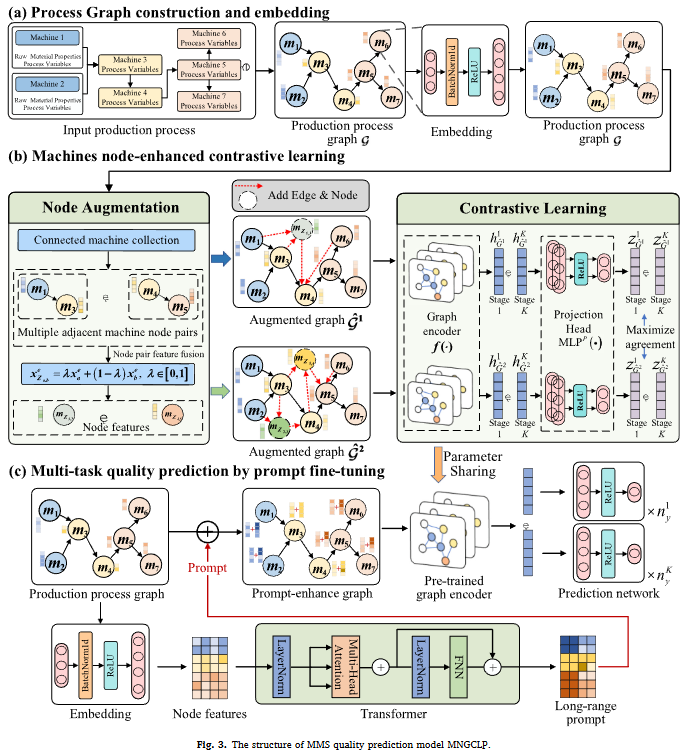
이 섹션에서는 제안된 MNGCLP 모델의 상세 구축 과정을 다룬다. 모델은 크게 ① 공정 그래프 구축 및 임베딩, ② 기계 노드 강화 그래프 대조 학습(사전 훈련), ③ 프롬프트 미세 조정을 통한 다중 작업 예측(미세 조정)의 세 가지 핵심 모듈로 구성된다 .
3.3.1 Process Graph Construction & Embedding
이 모듈은 복잡한 제조 데이터를 그래프 구조로 변환하여 기계 간의 전파 효과를 학습할 준비를 하는 단계이다.
- 기계()를 노드, 생산 흐름을 유향 엣지(Directed Edge)로 정의하여 그래프 를 생성한다.
- 각 기계의 다양한 특징(원자재, 공정 변수 등)을 MLP(다층 퍼셉트론)에 통과시켜 동일한 차원의 벡터 로 임베딩한다.
Figure 3(a) 설명
- Input Production Process: 왼쪽 박스는 실제 공정이다. Stage 1의 병렬 기계들과 Stage 2의 기계들이 복잡하게 연결되어 있다.
- Production Process Graph : 가운데 그림처럼 실제 공정을 노드()와 화살표로 변환한다.
- Embedding: 오른쪽으로 넘어가며, 각 노드의 특징 벡터가 MLP, BatchNorm, ReLU를 거쳐 임베딩 벡터로 변환되는 과정을 보여준다.
3.3.2 Machine Node-Enhanced Graph Contrastive Learning
이 모듈은 라벨이 없는 데이터를 활용해 기계 간의 인접한 전파 효과를 사전 훈련(Pre-training)하는 단계이다.
- 증강(Augmentation): 기존의 노드 삭제 방식 대신, 생산 공정을 유지하기 위해 기계 노드 추가(AMN)와 역방향 엣지 추가(RPE)를 사용한다.
- 대조 학습: 원본 그래프에서 파생된 두 증강 그래프()가 서로 유사한 표현을 갖도록(Maximize Agreement) 학습한다.
Figure 3(b) 설명
- Node Augmentation (왼쪽): 인접한 두 기계 노드()의 특징을 섞어(Mixup) 새로운 가상 노드 를 만들고 그래프에 추가하는 과정이다.
- Add Edge & Node (가운데): 붉은 점선 화살표로 역방향 엣지가 추가되고, 노란색 점선 원으로 새로운 노드가 추가된 두 개의 증강 그래프()를 보여준다.
- Contrastive Learning (오른쪽): 두 증강 그래프가 파라미터를 공유하는 Graph Encoder 를 통과해 특징()을 추출하고, Projection Head를 거쳐 최종적으로 두 특징 간의 일치도를 최대화하는 학습 과정을 나타낸다.

Algorithm 1 설명: 그래프 대조 학습 절차
1. 초기화: 공정 그래프 를 구축하고 기계 특징을 임베딩한다.
2. 반복 학습 (Epochs)
-
각 배치(Batch)마다 그래프 증강 함수 를 적용하여 두 개의 증강 그래프 를 생성한다.
-
그래프 인코더()를 통해 각 단계별 특징()을 추출하고, 매핑 네트워크()로 투영()한다.
-
두 증강 그래프 간의 유사도를 높이고 다른 샘플과는 멀어지도록 대조 손실(Contrastive Loss, )을 계산한다.
-
인코더와 매핑 네트워크의 파라미터를 업데이트한다.
3.3.3 Multitask Prediction by Prompt Fine-tuning
사전 훈련된 모델에 장거리 의존성을 주입하고, 실제 품질 라벨을 이용해 미세 조정(Fine-tuning)하는 단계이다.
-
Transformer 프롬프트: Transformer를 이용해 멀리 떨어진 기계 간의 관계(Global Information)를 포착하고, 이를 프롬프트() 형태로 기존 노드 특징에 더해준다.
-
다중 작업 예측: 각 단계의 품질 지표마다 별도의 MLP를 두어 동시에 예측한다.
Figure 3(c) 설명
-
Prompt Generation (아래쪽 박스): 노드 특징이 Transformer (Multi-Head Attention)를 통과하며 전역적인 관계를 학습하고, 이를 Long-range prompt (색깔 격자)로 변환한다.
-
Prompt-enhanced Graph (가운데): 생성된 프롬프트가 기존 그래프의 노드 특징에 더해진다().
-
Prediction (오른쪽): 프롬프트가 추가된 그래프가 Pre-trained Graph Encoder를 통과한 후, 각 단계()의 여러 품질 지표를 예측하는 Prediction Network (MLP)로 연결된다.
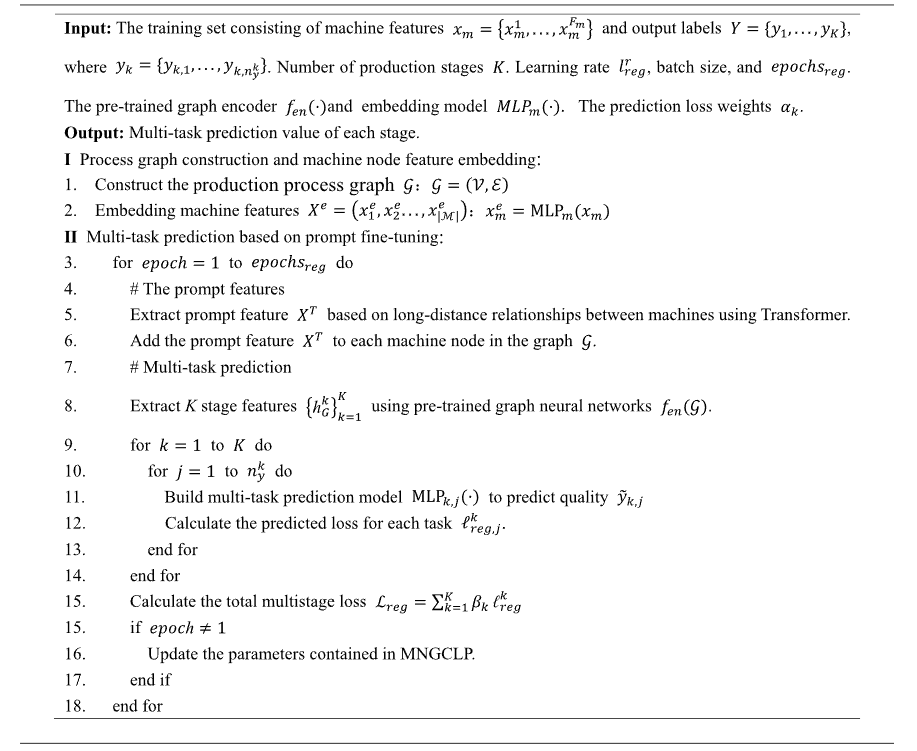
Algorithm 2 설명: 미세 조정 예측 절차
1. 초기화: 그래프 구축 및 특징 임베딩
2. 반복 학습 (Epochs)
-
프롬프트 생성: Transformer를 사용해 장거리 관계를 포착한 프롬프트 특징 를 추출하고, 이를 그래프 노드에 추가한다.
-
특징 추출: 사전 훈련된 인코더()로 단계별 특징 를 추출한다.
-
다중 작업 예측: 각 단계()의 각 품질 지표()에 대해 예측값 를 계산한다.
-
손실 계산 및 업데이트: 노이즈 라벨을 마스킹한 후 회귀 손실()을 계산하고, 전체 모델(인코더 포함)을 업데이트한다.
4. Case Study
4.1 Description of Dataset
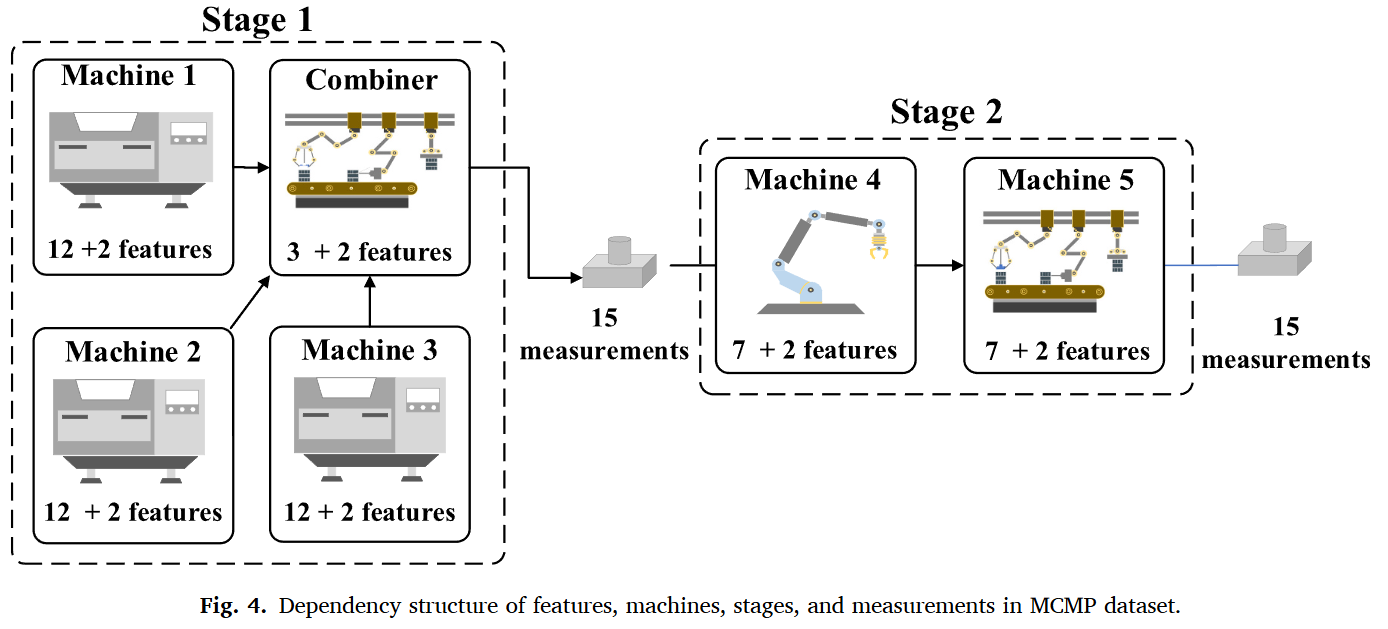
1) 데이터셋 개요
- MCMP 데이터셋은 2020년 Liveline Technologies가 Kaggle에 공개한 것으로, 미국 디트로이트 인근의 실제 생산 라인에서 수집되었다.
- 직렬 및 병렬 기계가 혼합된 공정과 조립 과정을 모두 포함하고 있어, 복잡한 현대식 다단계 제조 시스템(MMSs)을 대표하는 데이터셋이다 .
2) Figure 4 설명: MCMP 데이터셋 구조
-
실험에 사용된 실제 제조 데이터(MCMP)의 구조를 보여준다.
-
Stage 1: 기계 1, 2, 3이 병렬로 작동하고 Combiner로 합쳐진다. 각 기계는 12+2개의 특징을 가진다.
-
Stage 2: 기계 4, 5가 직렬로 연결된다.
-
각 단계가 끝날 때마다 15개의 품질 지표(Measurements)를 측정한다.
3) Table 2 설명: 품질 지표와 노이즈 문제
-
이 데이터셋의 목표는 각 단계에서 15개씩, 총 30개의 품질 지표를 예측하는 것이다.
-
하지만 실제 현장 데이터답게 노이즈(Noise)가 매우 심각하다는 특징이 있다.
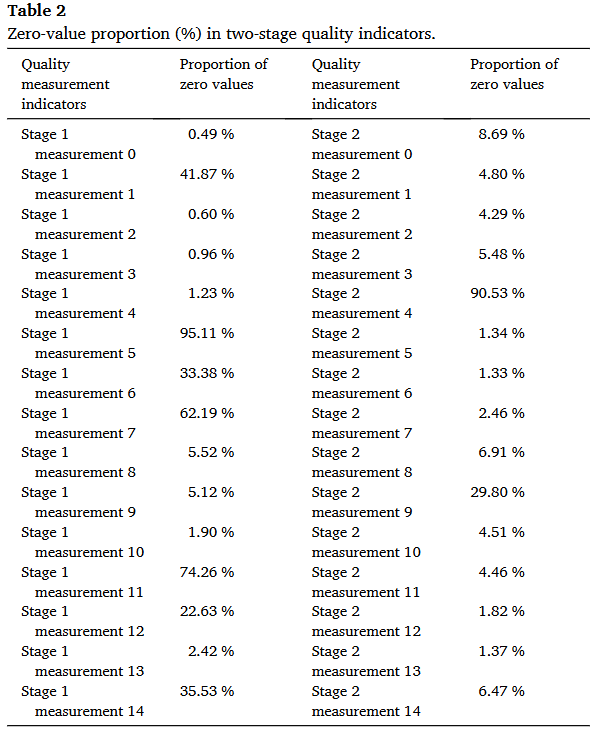
- 심각한 노이즈: 물리적으로 불가능한 '0'이나 '음수' 값이 무작위로 섞여 있다. 특히 1단계의 7개 지표와 2단계의 2개 지표는 0값의 비율이 20%를 넘는다.
- 극단적 사례: 심지어 노이즈 비율이 전체 샘플의 98%에 달하는 지표도 존재한다.
4.2. Experimental settings
4.2.1. Data Preprocessing
1. 데이터 분할 및 표준화
-
MCMP 데이터셋을 학습:검증:테스트 = 6:2:2 비율로 무작위 분할한다.
-
예측에 도움이 되지 않는 타임스탬프(Timestamp) 정보는 제거한다.
-
기계 특징(Feature)마다 분포가 다르므로, 평균을 제거하고 단위 분산으로 스케일링하는 표준화(Standardization)를 수행한다.
2. 라벨 노이즈 제거 (Label Denoising)
-
기존 연구들은 단순히 특정 임계값(예: 14~16 범위 밖, 혹은 1e-4 미만)을 벗어나면 데이터를 버리는 방식을 택했다.
-
하지만 본 논문은 유용한 정보를 최대한 살리기 위해 데이터 분포를 정밀 분석하였다.
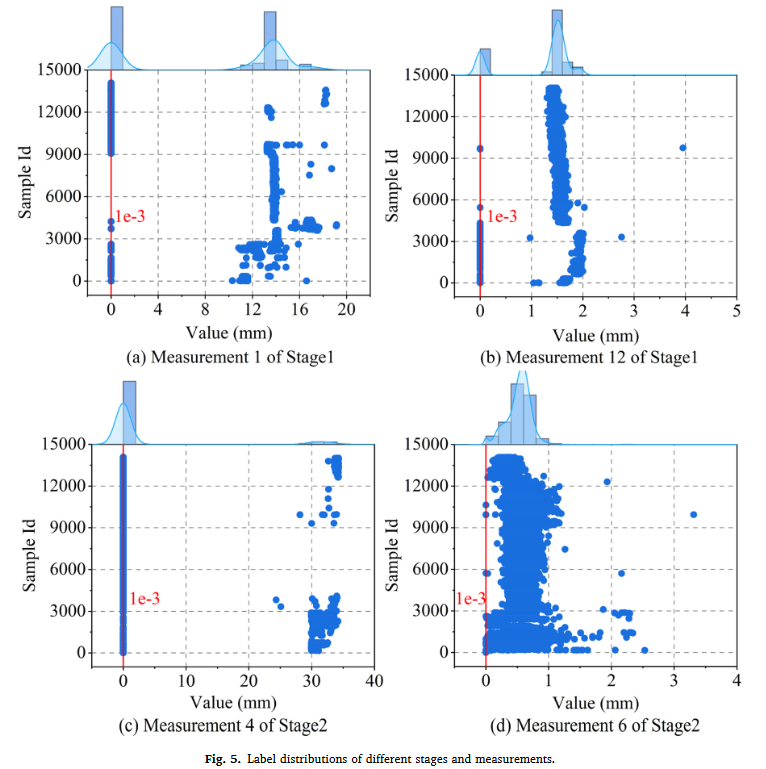
위 그래프는 각 단계(Stage)와 지표(Measurement)별 데이터 분포를 보여준다.
-
(a) Stage 1 - Measurement 1: 0 근처의 값과 정상적인 분포가 섞여 있다.
-
(b) Stage 1 - Measurement 12: 역시 0 근처에 노이즈가 존재한다.
-
(c) Stage 2 - Measurement 4: 0값의 비율이 높다.
- (d) Stage 2 - Measurement 6: 0과 1mm 사이에 데이터가 집중되어 있다 .
이 분석을 통해, 단순히 데이터를 버리는 것이 아니라 1e-3 mm (붉은 선) 미만의 값을 노이즈 라벨로 식별하여 Masking 처리하는 전략을 수립
4.2.2 Baseline Models
1. 머신러닝 (Machine Learning)
- ENR (Elastic Network Regression): 릿지(Ridge)와 라쏘(Lasso) 회귀를 결합한 모델
- CatBoost: 범주형 데이터 처리에 강한 부스팅 트리 모델
- RRF (ReliefF Random Forest): 특징 선택(ReliefF)과 랜덤 포레스트를 결합한 모델
2. 딥러닝 (Deep Learning)
- FNN (Feed-forward Neural Network): 4계층의 완전 연결 신경망
- CNN (Convolutional Neural Network): 2계층의 합성곱 신경망
- DMMTL: 직렬 MMS를 위한 딥러닝 기반 다단계 다중 작업 학습 모델
3. 그래프 신경망 (GNN)
- GAT (Graph Attention Network): 어텐션 메커니즘을 사용하는 GNN
-
GIN (Graph Isomorphism Network): 그래프 구조 표현력이 뛰어난 GNN
-
PGAT (Path Enhanced GAT): MMS 품질 예측을 위해 경로 강화 기법을 사용한 최초의 GNN 모델
4. 그래프 대조 학습 (Graph Contrastive Learning)
- InfoGraph: 노드와 그래프 간의 상호 정보를 최대화하는 비지도 학습 모델
- GraphCL: 노드 삭제, 엣지 교란 등 다양한 증강 기법을 사용하는 대조 학습 모델
4.3. Results Comparison
4.3.1. Ablation study
-
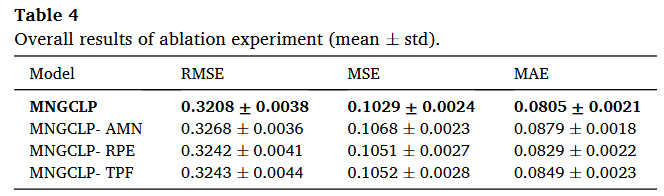
MNGCLP-AMN: 기계 노드 추가(Adding Machine Nodes) 기능을 뺀 모델. RMSE가 0.3208에서 0.3268로 증가(성능 하락)했다. 이는 새로운 노드를 추가하여 생산 공정 정보를 풍부하게 만드는 것이 중요함을 의미한다.
-
MNGCLP-RPE: 역방향 엣지(Reverse Production Edges)를 뺀 모델. 역시 성능이 하락했다. 역방향 정보 또한 공정 이해에 필수적이다.
-
MNGCLP-TPF: Transformer 프롬프트(TPF)를 제거한 모델. 성능 저하가 발생했다. 이는 단순히 인접한 기계뿐만 아니라, 멀리 떨어진 기계 간의 관계를 학습하는 것이 중요함을 시사한다.
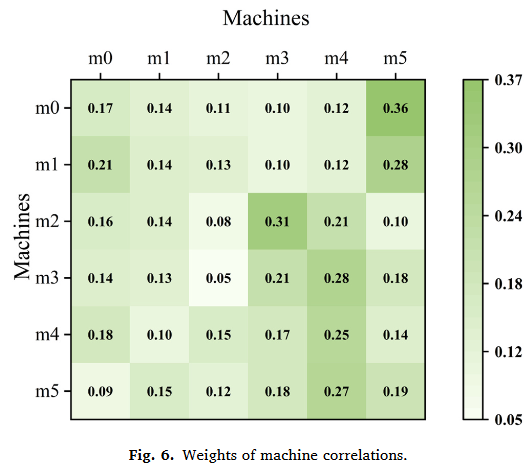
TPF(Transformer Prompt Fine-tuning)의 중요성은 위 Figure 6의 어텐션(Attention) 히트맵에서 시각적으로 확인할 수 있다.
-
장거리 영향력: 가로축과 세로축은 기계()를 나타낸다. 그림을 보면 (마지막 기계)가 (초기 기계)에 강한 영향을 미치고 있음(0.36, 0.28)을 알 수 있다.
-
이는 물리적으로 거리가 멀더라도 생산 공정 상의 논리적 연결고리가 존재하며, Transformer가 이를 성공적으로 포착하여 프롬프트로 활용하고 있음을 증명한다 .
4.3.2. Results comparison for other methods
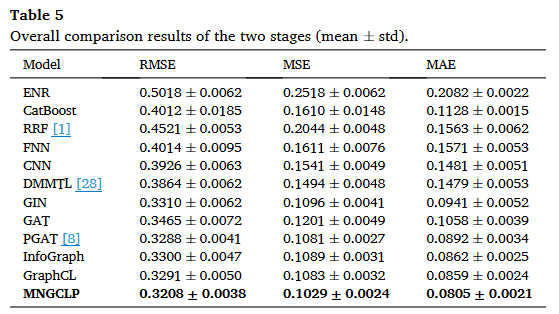
- 위 Table 5를 보면 MNGCLP는 RMSE(0.3208), MSE(0.1029), MAE(0.0805) 모든 지표에서 가장 낮은 오차율을 기록하며 1위를 차지했다.
-
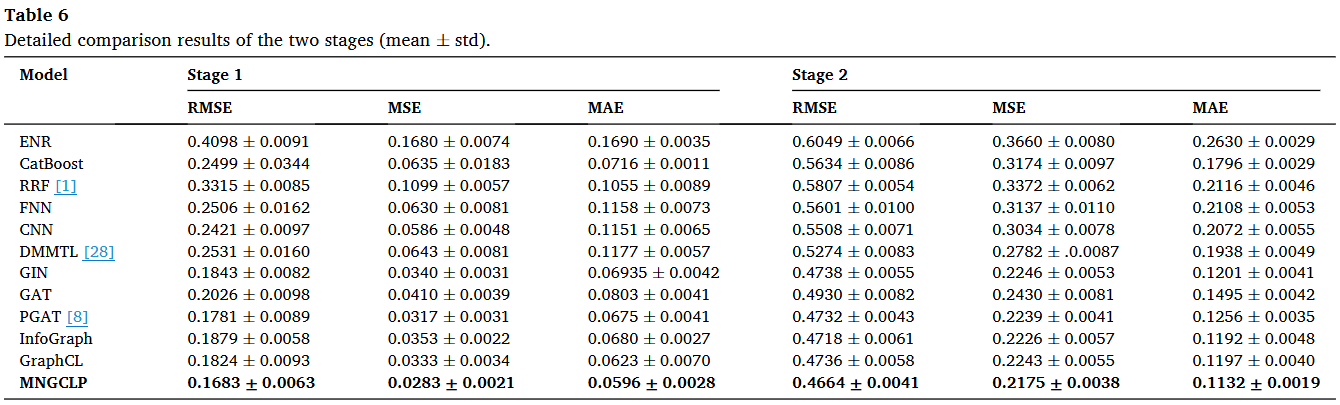
위 Table 6의 기존 모델의 한계는 아래와 같다.
-
PGAT, GAT, GIN: 그래프 기반이지만 노이즈 라벨에 취약하여 MNGCLP보다 성능이 낮다. 특히 PGAT는 깨끗한 라벨 데이터가 많이 필요한데, MCMP 데이터셋의 노이즈 때문에 제 성능을 못 냈다 .
-
GraphCL, InfoGraph: 기존 대조 학습 모델들은 노드 삭제 등 공정 흐름을 끊는 증강 기법을 사용했기 때문에, 공정 특화 증강을 사용한 MNGCLP보다 성능이 떨어진다.
-
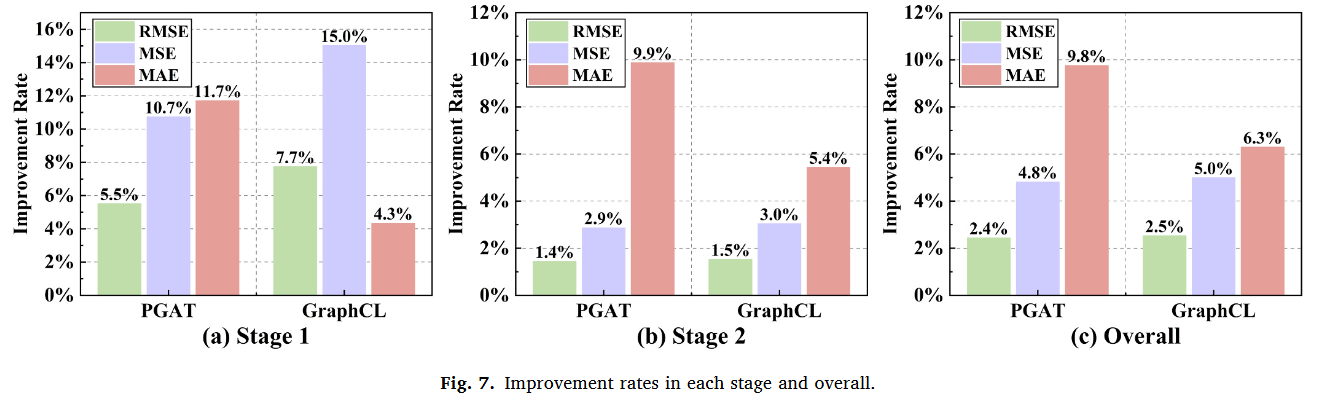
- 위 Fig. 7 성능 개선율을 봤을 때, MNGCLP는 지도 학습 기반 SOTA 모델인 PGAT 대비 RMSE를 2.4%, MSE를 4.8% 개선했다.
- 대조 학습 비교: 일반적인 대조 학습 모델인 GraphCL 대비 RMSE를 2.5%, MAE를 6.3% 개선하며, 제조 데이터에 특화된 프레임워크의 우수성을 입증했다.
4.3.3. Computational Costs
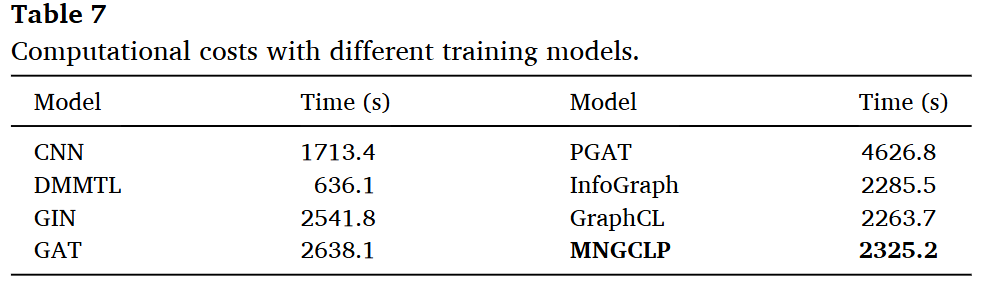
성능이 좋아도 학습이 너무 오래 걸리면 현장에서 쓰기 어렵다. 학습 시간을 비교해보면 아래 Table 7과 같다.
-
CNN (1713.4s) / DMMTL (636.1s): 구조가 단순하여 빠르지만 예측 정확도가 낮다.
-
PGAT (4626.8s): 복잡한 경로 코딩 때문에 학습 시간이 매우 길다.
-
MNGCLP (2325.2s): 성능이 가장 좋으면서도 PGAT의 절반 수준의 시간만 소요된다. InfoGraph나 GraphCL보다는 약간 느리지만, 이는 Transformer 프롬프트 추가에 따른 비용이며 성능 향상 폭을 고려할 때 합리적인 트레이드오프(Trade-off)이다.
4.4 Analysis and discussion
4.4.1 Alignment and uniformity analysis of stage representation
- 정렬성 (Alignment): 비슷한 품질을 가진 샘플끼리는 특징 공간상에서 가깝게 모여 있어야 한다. 이는 노이즈의 영향을 줄이는 데 중요하다.
- 균일성 (Uniformity): 특징들이 특정 영역에만 쏠리지 않고 공간 전체에 고르게 분포해야 데이터의 다양성을 잘 보존할 수 있다.
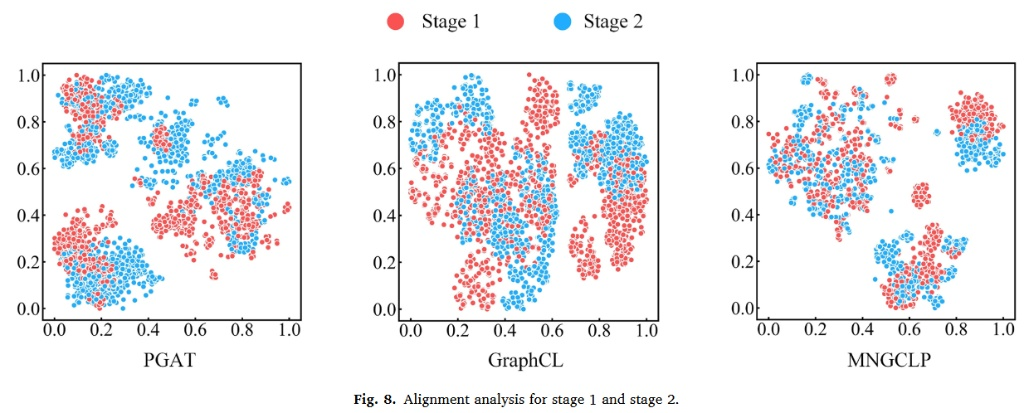
-
위 그림은 고차원의 특징을 2차원으로 축소하여 시각화한 것이다.
-
PGAT (왼쪽): 점들이 널리 퍼져 있고 섞여 있어(Dispersed), 비슷한 샘플끼리 뭉치지 못했다.
-
GraphCL (가운데): 일부 개선되었으나 여전히 경계가 모호하다.
-
MNGCLP (오른쪽): 같은 색깔(단계별 특징)의 점들이 확실하게 군집(Cluster)을 이루고 있다.
-
이는 MNGCLP가 노이즈 속에서도 유의미한 특징을 잘 잡아내어 정렬시켰음을 의미한다.
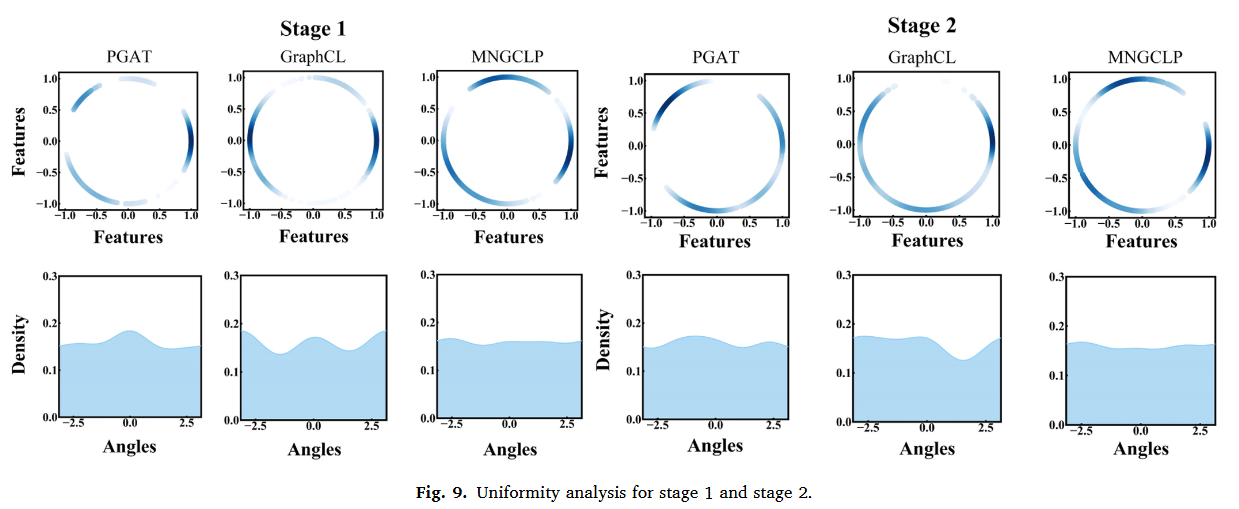
-
위 그림은 특징들이 공간상에 얼마나 고르게 퍼져있는지(밀도)를 보여준다.
-
PGAT (왼쪽): 특정 각도()에 피크가 솟아 있고 밀도 변화가 심하다(Highly clustered). 정보가 특정 패턴에만 쏠려 있다는 뜻이다.
-
GraphCL (가운데): 일부 영역에 빈 공간(Gaps)이 많다.MNGCLP (오른쪽): 밀도 곡선이 전체적으로 부드럽고 평탄(Smoother)하다.
-
이는 데이터의 다양한 정보를 편향 없이 골고루 학습했음을 보여준다.
4.4.2 The quality prediction fitting results
실제 현장에서 가장 중요한 것은 "그래서 예측값이 실제값과 얼마나 비슷한가?"이다.
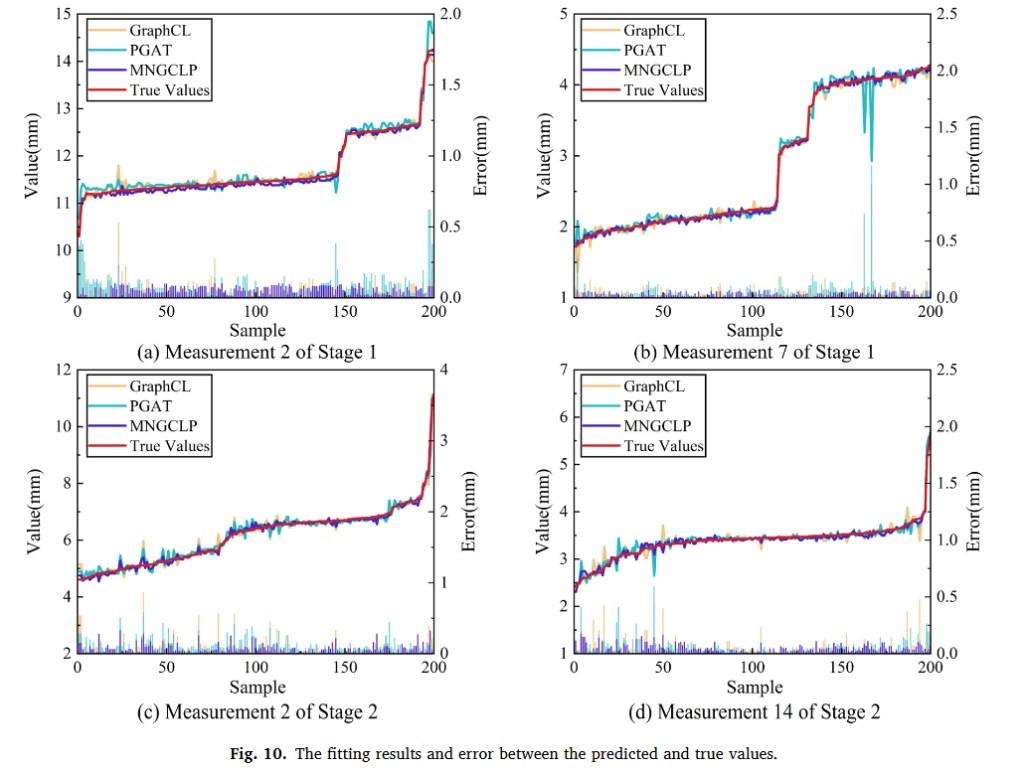
위 그래프는 200개의 무작위 샘플에 대한 예측 결과를 보여준다.
-
구성: 빨간 실선은 실제값(True Values), 파란 실선은 MNGCLP 예측값, 하단 막대그래프는 오차(Error)를 나타낸다.
-
분석:
-
(a)~(d): MNGCLP(파란선)가 실제값(빨간선)의 복잡한 등락 추세를 매우 정확하게 따라가고 있다 .
-
오차: 하단의 오차 막대를 보면, MNGCLP가 다른 모델들(하늘색, 주황색 막대)에 비해 오차의 크기가 작고 변동폭이 안정적이다.
-
난이도: Stage 2(그림 c, d)의 오차가 Stage 1(그림 a, b)보다 상대적으로 큰데, 이는 공정이 뒤로 갈수록 누적된 영향으로 인해 예측이 더 어려워짐을 시사한다.
-
결론적으로, MNGCLP는 데이터의 특징을 명확하게 구분(Alignment)하면서도 다양성을 잃지 않으며(Uniformity), 이를 통해 복잡한 제조 공정에서도 실제값에 매우 근접한 예측 성능을 달성하였다.
5. Conclusion and Future Works
5.1 Conclusion
본 연구는 라벨링이 어려운 다단계 제조 시스템(MMSs)의 품질 예측을 위해 MNGCLP 프레임워크를 제안하였다.
-
핵심 방법론
-
사전 훈련: 기계 노드 강화(Machine Node Augmentation) 기법을 통해 생산 공정 정보를 유지하면서도, 라벨 없는 데이터에서 기계 간 품질 전파 효과를 효과적으로 학습하였다 .
-
미세 조정: Transformer로 포착한 기계 간 장거리 관계를 프롬프트(Prompt)로 활용하여, 사전 훈련 모델과 실제 예측 작업 간의 간극을 해소하고 정확도를 높였다 .
-
성능 입증: 실제 제조 데이터(MCMP) 실험 결과, 지도 학습 기반 GNN 대비 RMSE 2.4%, 대조 학습 모델 대비 2.5% 성능이 향상되어 모델의 우수성을 입증하였다.
-
5.2 Future Works
향후 연구는 모델의 한계를 보완하기 위해 다음 세 가지 방향으로 진행될 예정이다 .
-
시공간 모델링: 데이터의 시간적 흐름(Temporal correlation)을 반영하기 위해 시공간 신경망(Spatial-Temporal Neural Networks)을 적용한다.
-
이종 그래프 확장: 기계와 결합기(Combiner) 등 다양한 설비 간의 관계를 정교하게 표현하기 위해 이종 그래프(Heterogeneous Graph)를 도입한다.
-
대규모 데이터 확보: 더 많은 MMSs 데이터를 수집하여 사전 훈련 모델의 Generalization 성능을 강화한다.