Summary
- 기존 position embedding 방식들은 token의 상대적인 위치 정보를 context representation에 더해 나가는 방식으로 Linear transformer처럼 연산을 분리하는 방식들과 잘 맞지 않는다.
- RoPE는 query/key를 위치 에 비례한 각도 만큼 회전 시킨다. 회전된 두 벡터의 내적은 상대 위치 에만 의존하므로, 절대 위치로 인코딩했는데 결과적으로 상대 위치가 표현된다.
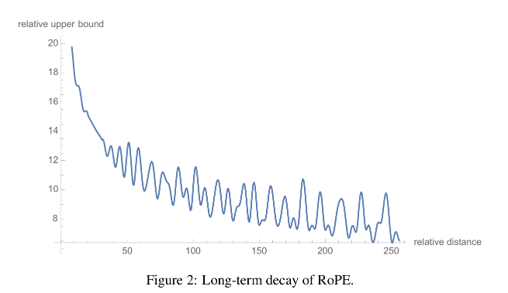
- 특히, 차원을 개의 2차원 subspace로 나눠 각각 다른 속도 로 회전시키며, 이 설계 덕분에 거리가 멀어질수록 내적의 상한이 줄어드는 long-term decay 성질이 생긴다.
1. Problem & Motivation
Transformer의 self-attention은 순서에 무관하기 때문에, token의 순서 정보를 따로 넣어 줘야 한다. 순서를 다루는 방식은 모델 계열마다 다르다.
- RNN 기반: 시간 축을 따라 hidden state를 재귀적으로 계산하면서 순서를 인코딩한다.
- CNN 기반: 위치 정보가 없어 보이지만, padding을 통해 위치 정보를 암묵적으로 학습할 수 있다는 연구가 있다.
- PLM 기반: self-attention으로 문맥 표현을 잡지만, 위치 정보는 별도의 position embedding으로 넣어야 한다.
Position embedding은 크게 두 가지이다.
- Absolute PE: 사전에 정의된 함수 혹은 학습 가능한 vector로 position을 encoding하여 입력에 더하는 방식
- Relative PE: 두 token 사이의 상대적인 위치 정보를 attention 계산 안에 넣는 방식
문제는 두 방식 모두 위치 정보를 context representation에 더한다는 것이다. 특히 relative PE는 query-key 쌍마다 에 해당하는 항을 따로 더하므로, attention을 처럼 분해해서 계산하는 linear self-attention과 호환되지 않는다.
이러한 기존 postion embedding의 한계를 개선하기 위해 해당 논문에서는 아래의 특징을 가지는 RoPE(Rotary Position Embedding)을 제시한다.
RoPE는 Rotation matrix를 이용하여 절대적인 위치를 encoding하면서 동시에 self-attention 식 안에서 relative position dependency를 만들고 상대적 거리가 멀어질수록 token간 의존성도 감소한다.
2. Background & Related Work
2.1. Absolute Position Embedding
위치 에 따라 정해지는 차원 벡터 를 token 표현 에 직접 더한 뒤 projection한다.
로는 아래의 sinusoidal 함수를 사용한다.
이처럼 Absolute position embedding은 encoding된 token 에 positional embedding을 직접 더하는 방식이다.
2.2. Relative Position Embedding
Shaw et al. (2018): key와 value에 학습 가능한 relative position 벡터를 더한다.
상대 거리가 일정 범위를 넘어가면 정확한 거리 정보는 의미가 없다고 보고 clip한다.
Dai et al. (Transformer-XL, 2019): absolute PE를 쓴 을 전개한 뒤 항을 재구성한다.
- key 쪽 absolute PE 을 relative 벡터 으로 교체
- query 쪽 은 위치와 무관한 학습 벡터 , 로 교체
- 내용 기반 key와 위치 기반 key에 서로 다른 , 사용
이 밖에도 relative PE 변형이 여러 가지 있지만(T5, DeBERTa 등), 공통적으로 attention score 전개식의 각 항에 위치 정보를 어떻게 더할지를 바꾸는 방식이다.
3. Proposed Approach: RoPE
3.1. Formulation
목표는 query와 key의 내적이 상대 위치 에만 의존하도록 만드는 것이다.
즉 , 각각에는 절대 위치 , 을 넣지만, 둘의 내적 결과는 두 token의 내용과 상대 위치로만 결정되게 하는 를 찾는 문제다.
3.2. RoPE - 2D case
우선 2D case에 대해 생각하며 이때, 각 vector와 matrix들은 모두 복소수로 생각하면 다음의 해가 3.1.에서 주어진 조건을 만족한다.
복소수 곱 는 2차원 평면에서 만큼 회전하는 것과 같다. 켤레를 취해 곱하면 가 되어 절대 위치는 사라지고 상대 위치만 남는다. 행렬로 쓰면 다음과 같다.
이때, 주어진 는 연산 순서가 중요하다. query/key projection을 먼저 하고, 그 결과에 회전 행렬을 곱하는 것이다.
3.3. RoPE - General Form
3.2에서 2차원에 대하여 해를 찾았기에 해당 아이디어를 차원으로 일반화한다. 일반적인 차원(는 짝수)에서는 차원을 개의 2차원 subspace로 나누고, 각 subspace에 서로 다른 각도 로 2D 회전을 적용한다. 내적은 선형이므로 subspace별 결과를 더하면 된다. 차원에 대하여 일반화시킨 회전 행렬은 다음과 같이 나타낼 수 있다.
위 수식을 직관적으로 표현하면 아래와 같이 나타낼 수 있다.
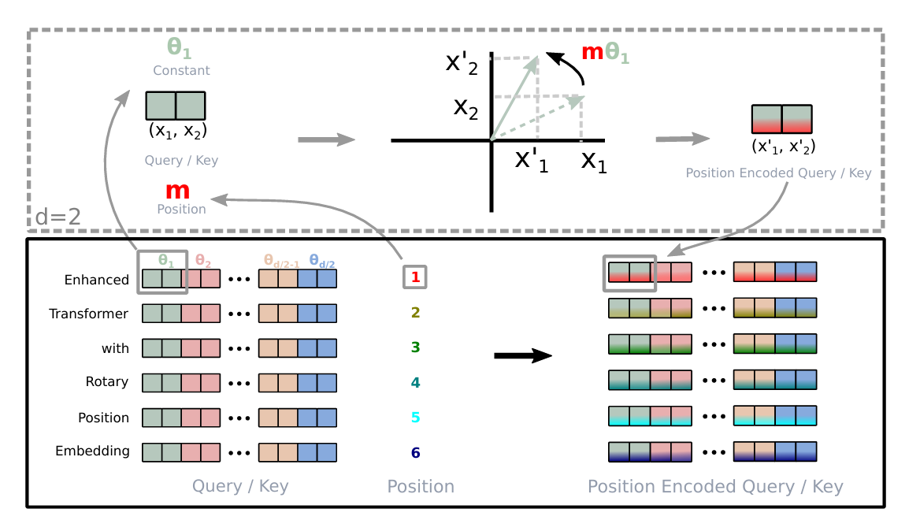
이처럼 RoPE에서는 한 token 벡터 안에서도 subspace마다 회전 속도가 다르다. 로 가장 빠르게 회전하는 앞쪽 차원들은 가까운 token 사이의 위치 차이를 민감하게 구분하고, 으로 아주 느리게 회전하는 뒤쪽 차원들은 멀리 떨어진 token 사이의 관계를 표현한다.
RoPE를 적용한 attention score를 확인해보면 다음과 같다.
회전 행렬은 을 만족하므로 Relative position이 명시적으로 드러난다.
이러한 RoPE과 기존 position embedding의 차이는 다음과 가티 정리할 수 있다.
- Additive vs Multiplicative: 기존 PE는 위치 정보를 더하지만, RoPE는 회전 행렬을 곱한다.
- Attention score 전개식에 새로운 항을 추가하지 않고도 상대 위치를 표현한다.
- 는 직교 행렬이라 벡터의 norm을 바꾸지 않으므로, 위치 인코딩 과정이 학습을 불안정하게 만들지 않는다.
3.4. Properties
RoPE의 대표적인 property는 다음과 같이 두 가지로 정리할 수 있다.
① Long-term decay
로 설정하면 상대 거리가 커질수록 내적 값이 감소한다. 멀리 떨어진 token일수록 연관이 약하다는 직관과 맞는 성질이다.
② RoPE with linear attention
Linear attention은 softmax 대신 non-negative feature map , 로 similarity를 계산한다. RoPE는 회전으로 위치 정보를 넣고 hidden representation의 norm을 유지하므로, feature map을 적용한 뒤 회전만 곱하면 linear attention과 결합할 수 있다.
3.5. Theoretical explanation
Efficient Computation
은 대부분이 0인 sparse 행렬이기 때문에 일반적인 행렬곱 연산을 하면 낭비되는 연산량이 많아진다.. 대신 element-wise 곱 두 번과 덧셈으로 계산한다.
, 벡터는 위치별로 미리 계산해 둘 수 있으므로, 추가 비용은 이다.
Long-term decay
Relative distance에 따른 attention score의 상한을 나타내면 그 관계는 다음과 같이 확인되었다.
4. Experiments and Evaluation
4.1. Machine translation
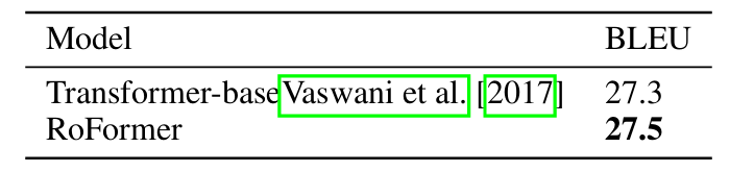
해당 task에서는 WMT 2014 English-German으로 sequence-to-sequence 번역을 평가했다. Transformer-base에서 self-attention layer의 position encoding만 RoPE로 바꾸고, 나머지 hyperparameter는 원래 모델과 동일하게 두어 position encoding의 효과를 확인하였다.
4.2. Pre-training language modeling
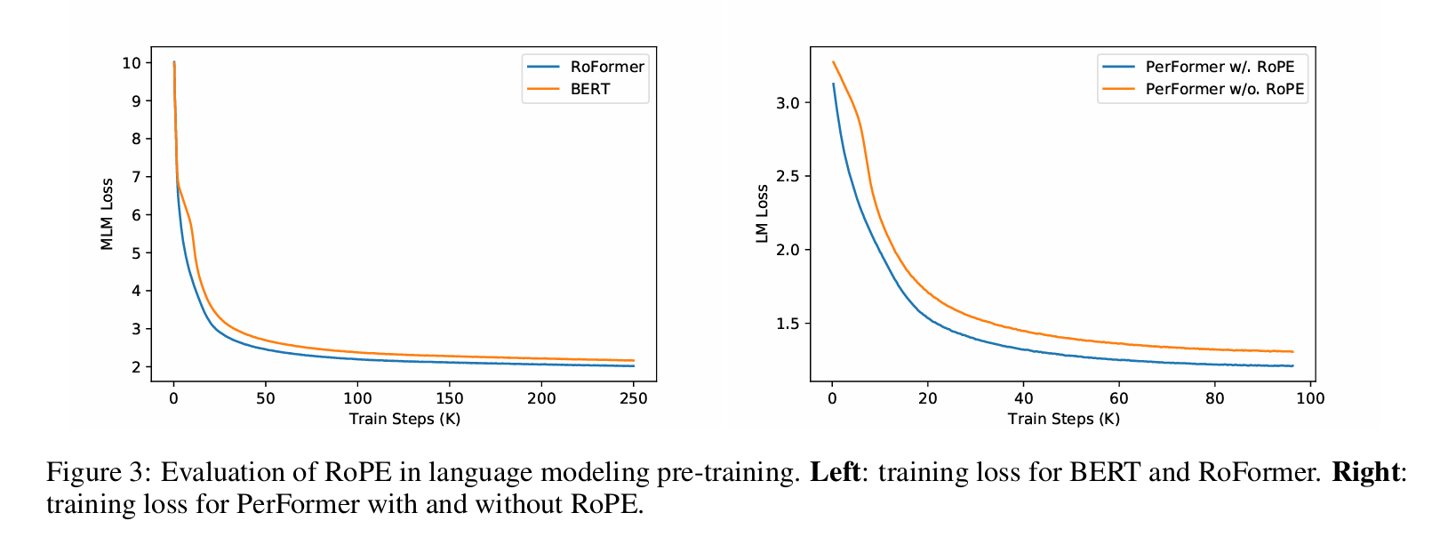
Contextual representation의 성능을 확인하기 위하여 pre-training loss를 비교하였다. 4.1에서의 model 설정과 비슷하게 기존 sinusoidal position encoding을 RoPE로 바꾼뒤 loss를 비교하였다.
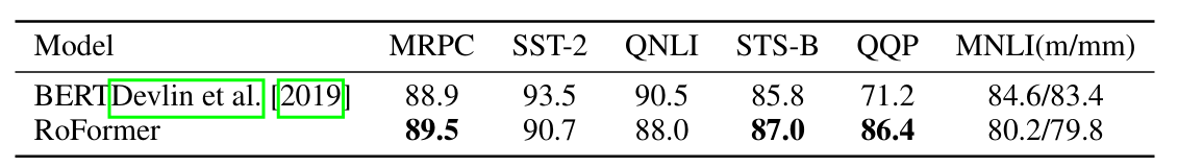
4.3. Fine-tuning on GLUE
Pre-training한 RoFormer를 여러 GLUE task에 fine-tuning하여 성능을 측정하였다.
4.4. Evaluation on Chinese Data
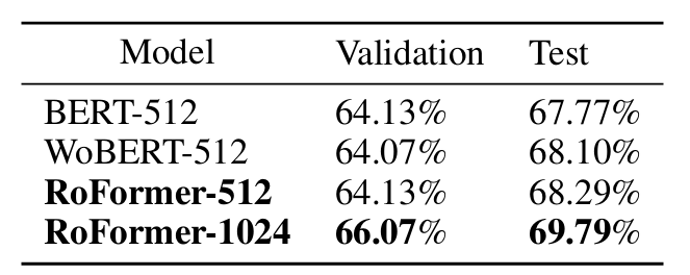
RoPE의 장점이 long text에서 드러나는지 보기 위해 중국어 데이터로 실험을 진행하였다. 성능 측정을 위하여 WoBERT의 absolute position embedding을 RoPE로 바꿔 RoFormer를 만들었다. 또한, tokenization 단위와 position embedding이 다른 모델들과 비교했다.
5. Conclusion
RoFormer는 query와 key에 위치에 비례한 회전 행렬을 곱하는 RoPE를 제안했다. 절대 위치로 인코딩하지만 두 벡터의 내적은 상대 위치에만 의존하게 되며, attention 식에 새 항을 추가하지 않는 곱셈 방식이라 linear attention에도 그대로 적용할 수 있다. 또한 subspace별 회전 속도를 로 두어 거리에 따른 long-term decay를 얻었다. 실험에서는 pre-training 수렴 속도와 긴 문서 task에서 이점을 보였지만, GLUE에서는 task마다 결과가 엇갈렸다.
6. My Take
1. 수식적 장점에 비해 GLUE 결과는 엇갈린다
RoFormer는 수식적으로는 기존 positional embedding보다 효과적인 방법으로 보이지만, GLUE fine-tuning에서는 전반적으로 뚜렷한 우위를 보이지 못했다. 오히려 MNLI(84.6 → 80.2), SST-2, QNLI에서는 BERT보다 낮았다. GLUE의 대부분 task는 문장이 짧아 긴 거리 위치 관계를 잘 다루는 능력이 드러나기 어려운 것으로 보인다. 결과가 좋았던 task는 특정 task가 모델의 일반적인 성능보다 token encoding이나 positional embedding에 특히 민감했기 때문일 수 있다. 즉 positional embedding 방식의 차이만으로는 모델 성능 자체가 크게 달라지지 않았을 가능성이 있다. 반대로 CAIL2019-SCM처럼 입력이 긴 task에서 차이가 드러난 것을 보면, RoPE의 장점은 짧은 문장 이해보다 긴 context 처리에서 나온다고 보는 게 맞는 것 같다.
또한 BERT의 QQP 71.2는 원래 BERT 논문의 GLUE test set F1 값이라, RoFormer의 86.4와 같은 조건(split, metric)에서 비교한 것인지는 논문에서 명확하지 않다. 15점 차이를 그대로 RoPE의 효과로 읽기는 어렵다고 생각한다.
References
- Su, J., Lu, Y., Pan, S., Murtadha, A., Wen, B., & Liu, Y. (2024). RoFormer: Enhanced Transformer with Rotary Position Embedding. Neurocomputing. arXiv:2104.09864
- Vaswani, A. et al. (2017). Attention Is All You Need. arXiv:1706.03762
- Shaw, P., Uszkoreit, J., & Vaswani, A. (2018). Self-Attention with Relative Position Representations. arXiv:1803.02155
- Dai, Z. et al. (2019). Transformer-XL: Attentive Language Models Beyond a Fixed-Length Context. arXiv:1901.02860
- Devlin, J. et al. (2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. arXiv:1810.04805
