LangChain의 에이전트가 응답을 스트림처럼 나오도록 하고싶었다. 직관적으로 기존에 사용하던 invoke 함수를 stream 함수로 바꾸면 동작할거라고 생각 했는데, 에이전트에서stream 함수는 에이전트가 실행하는 중간단계를 청크로 알려주는 함수였다.
결국 공식 예제에서 agent의 출력을 스트림처럼 나오도록 하는 방법을 찾을 수 있었다.
- StreamLit을 사용할 때 스트림으로 출력하는 방법이다.
import streamlit as st
from streamlit.delta_generator import DeltaGenerator

from langchain_community.chat_message_histories.in_memory import ChatMessageHistory
from langchain.agents import create_openai_functions_agent, AgentExecutor
from langchain_experimental.tools import PythonREPLTool
from langchain.callbacks.base import BaseCallbackHandler
from langchain_openai import ChatOpenAI
from langchain import hub


@st.cache_resource(ttl='1h')
def get_llm(openai_api_key:str) -> ChatOpenAI:
    return ChatOpenAI(api_key=openai_api_key, streaming=True)

@st.cache_resource(ttl='1h')
def get_tools():
    return [PythonREPLTool()]

@st.cache_resource(ttl='1h')
def get_prompt():
    return hub.pull("hwchase17/openai-functions-agent")

def get_agent(openai_api_key):
    if openai_api_key:
        tools = get_tools()
        agent =  create_openai_functions_agent(llm=get_llm(openai_api_key),
                                               tools=tools,
                                               prompt=get_prompt())
        return AgentExecutor(agent=agent, tools=tools)
    return None

class StreamHandler(BaseCallbackHandler):
    def __init__(self, container : DeltaGenerator, initial_text=""):
        self.delta_container = container
        self.text_container = [initial_text]

    def on_llm_new_token(self, token: str, **kwargs) -> None:
        self.text_container.append(token)
        self.delta_container.markdown(''.join(self.text_container))


st.title("AI CHAT")

if "langchain_messages" not in st.session_state:
    st.session_state.langchain_messages = ChatMessageHistory()
    st.session_state.langchain_messages.add_ai_message("안녕하세요. 무엇을 도와드릴까요")

def chat_clear_btn():
    st.session_state.langchain_messages.clear()
    st.session_state.langchain_messages.add_ai_message("안녕하세요. 무엇을 도와드릴까요")

with st.sidebar:
    openai_api_key = st.text_input("OpenAI API Key", type="password")
    st.button("채팅 초기화", on_click=chat_clear_btn)

for message in st.session_state.langchain_messages.messages:
    with st.chat_message(message.type):
        st.markdown(str(message.content))

if prompt := st.chat_input("여기에 입력하세요!"):
    agent = get_agent(openai_api_key)
    with st.chat_message("user"):
            st.markdown(prompt)

    if agent:
        with st.spinner("로딩중..."):
            with st.chat_message("ai"):
                handler = StreamHandler(st.empty())
                response = agent.invoke(input={"input": prompt, "chat_history":st.session_state.langchain_messages.messages},
                                        config={"callbacks":[handler]})
                st.session_state.langchain_messages.add_user_message(prompt)
                st.session_state.langchain_messages.add_ai_message(response['output'])

    else:
        st.cache_resource.clear()
        with st.chat_message("ai"):
            st.markdown("openai api key를 입력해 주세요.")
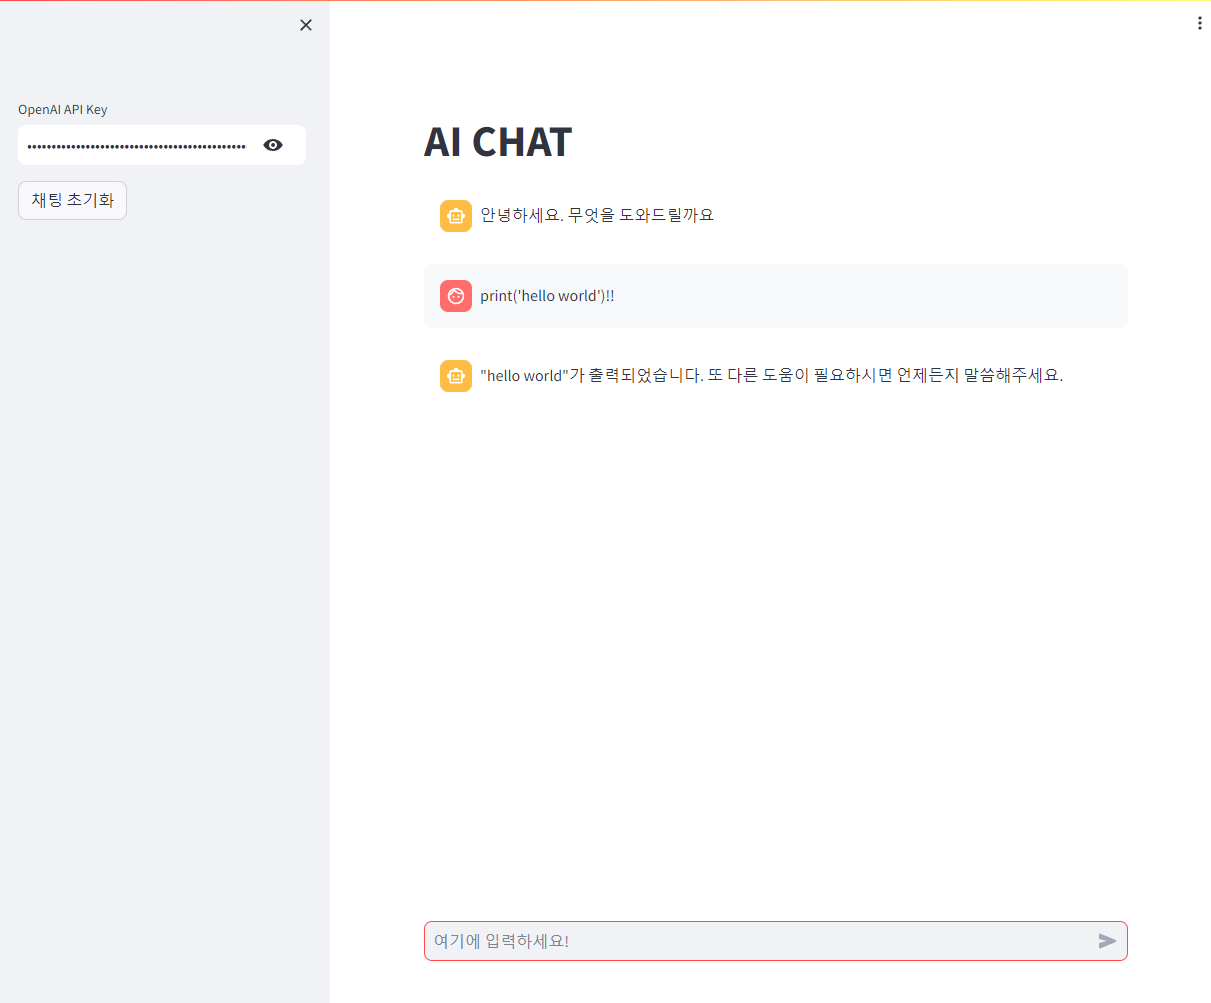
StreamHandler 라는 콜백 클래스를 정의하고 invoke를 할때 콜백 인스턴스를 넘겨주는 방식으로 스트림처럼 출력할 수 있었다.
위 코드를 실행하면 아래처럼 나온다.
- Flask나 FastAPI로 서비스 하기 위해 generator을 만들어야하는 경우의 방법이다.
import asyncio
from typing import List, Optional, Union, AsyncGenerator, AsyncIterable, AsyncIterator

from langchain_community.chat_message_histories.in_memory import ChatMessageHistory
from langchain.agents import create_openai_functions_agent, AgentExecutor
from langchain_experimental.tools import PythonREPLTool
from langchain.callbacks import AsyncIteratorCallbackHandler
from langchain_openai import ChatOpenAI
from langchain import hub


def get_llm(openai_api_key:str) -> ChatOpenAI:
    return ChatOpenAI(api_key=openai_api_key, streaming=True)

def get_tools():
    return [PythonREPLTool()]

def get_agent(openai_api_key:str):
    if openai_api_key:
        tools = get_tools()
        agent =  create_openai_functions_agent(llm=get_llm(openai_api_key),
                                               tools=tools,
                                               prompt=hub.pull("hwchase17/openai-functions-agent"))
        return AgentExecutor(agent=agent, tools=tools)
    return None

async def question(openai_api_key:str, input:str, history:List[ChatMessageHistory]=[]):
    handler = AsyncIteratorCallbackHandler()
    agent = get_agent(openai_api_key)
    task = asyncio.create_task(
        agent.ainvoke({"input":input, "chat_history":history},
                      {"callbacks":[handler]})
    )

    async for token in handler.aiter():
        yield token

    await task
AsyncIteratorCallbackHandler 라는 기본 제공 콜백 클래스를 통해서 스트림으로 처리할 수 있다.
아래는 사용하는 방법으로 api를 만들때 응용하면 된다.
response = question(openai_api_key="[여기에 openai API키 입력하세요]",
                  	input="안녕하세요 당신은 뭘할 수 있나요?")
현재 question 함수의 리턴 값의 타입은 AsyncGenerator인데 이를 일반 generator로 변경하고 싶을 수 있다.
def sync_from_async(async_sequence:Union[AsyncGenerator, AsyncIterable, AsyncIterator],
                    loop:Optional[asyncio.AbstractEventLoop]=None):
    loop = loop or asyncio.get_event_loop()
    async_sequence = async_sequence.__aiter__()
    async def get_next():
        try:
            obj = await async_sequence.__anext__()
            return False, obj
        except StopAsyncIteration:
            return True, None
    while True:
        done, obj = loop.run_until_complete(get_next())
        if done:
            break
        yield obj
위 함수를 추가적으로 선언 해주고 아래와 같이 사용해주자.
gen = sync_from_async(response)

for item in gen:
    print(item)
이제 비동기 함수 내부에서 비동기 for-loop를 돌릴 필요 없이 바로 확인 할 수 있다.
코딩 잘하고 싶은 백엔드 개발자