1. Unified Detection
- 개별적 구성 요소들을 하나의 신경망으로 통합했다.
- 이미지에 대한 모든 클래스의 모든 바운딩 박스를 동시에 예측한다.
- 이미지 전체와 이미지 내의 모든 객체에 대해 전역적으로 분석한다.
YOLO의 객체 탐지 과정
① 그리드 구조
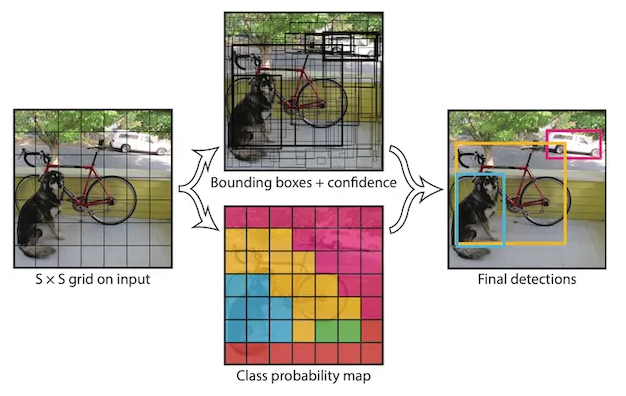
- 이미지를 S x S 그리드로 나눈다. (1 x 1 비율)
- 그리드 셀을 기준으로 바운딩 박스를 예측하고, 해당 바운딩 박스에 객체가 잇을 확률도 예측한다.
- 그리드 셀에 객체가 있을 경우에 클래스 별 확률도 예측한다.
- 두 과정을 조합하여 최종 결과를 만들어 낸다.
② 바운딩 박스 예측
x,y: 상자의 좌상단 좌표 (그리드 셀 기준 상대 좌표)w,h: 상자의 너비와 높이 (이미지 전체 기준 상대 크기)- Confidence : 예측된 상자와 실제 상자 간의 IoU (신뢰도 점수)
③ 신뢰도 점수 (Confidence Score) 계산
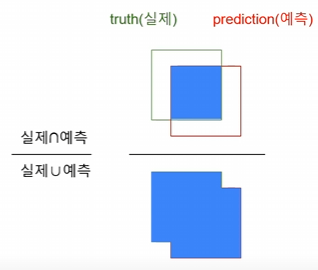
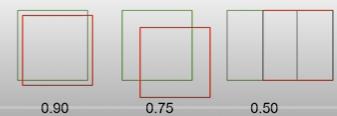
Confidence Score=Pr*IoUPr: 객체가 해당 상자에 존재할 확률IoU(Truth Pred) : 실제 객체와 예측 객체의 교집합과 합집합을 통해 예측이 얼마나 정확한 지를 나타내는 값 (수치가 1에 가까울수록 좋다)
- (바운딩 박스 안에 객체가 확실히 없으면)
0*IoU=0- (바운딩 박스 안에 객체가 확실히 있으면)
1*IoU=IoU- 바운딩 박스 안에 객체가 있다면, 신뢰도 점수는 예측된 실제 상자 간의
IoU와 동일해야 한다.
④ 클래스 확률 계산
- 클래스 확률 : 객체가 존재한다고 가정했을 때 해당 객체가 특정 클래스일 확률
- 조건부 클래스 확률 : 해당 그리드 셀이 실제로 객체를 포함하고 있을 때, 그 객체가 특정 클래스에 속할 확률
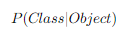
수식 설명 : 객체가 있다고 가정했을 때, 그 객체가 특정 클래스(예:자동차, 사람 등)일 확률 - 조건부 : "객체가 존재한다는 전제" 하에 클래스에 대한 확률
- 각 그리드 셀은 조건부 클래스 확률을 예측한다.
- 하나의 그리드 셀은 하나의 클래스 확률 세트만 예측하며, 예측된 상자의 개수와는 관계가 없다.
⑤ 최종 클래스별 신뢰도 점수 계산
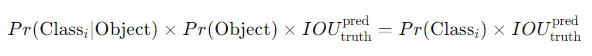
- 조건부 클래스 확률로 각 상자의 신뢰도 점수를 곱하여 계산한다.
- 최종적으로 객체가 어떤 클래스에 속하는지와 얼마나 정확한지를 나타낸다.
- 최종 점수가 낮음녀 탐지 실패로 간주한다. 높은 점수만 남아실제 객체로 출력한다.
⑥ 출력 텐서의 구조
- 입력 이미지를 S x S 그리드로 나누고, 각 그리드 셀에서 정보를 예측한다.
S x S ( B x 5 + C)
B: 경계 상자의 수
5: 각 상자의 좌표와 신뢰도 (x,y,w,h,confidence)
C: 클래스 확률 (데이터셋의 클래스 개수)
YOLO의 이미지 처리 과정
⑥ 출력 텐서의 구조
- 입력 이미지를 S x S 그리드로 나누고, 각 그리드 셀에서 정보를 예측한다.
S x S ( B x 5 + C)
B: 경계 상자의 수
5: 각 상자의 좌표와 신뢰도 (x,y,w,h,confidence)
C: 클래스 확률 (데이터셋의 클래스 개수)
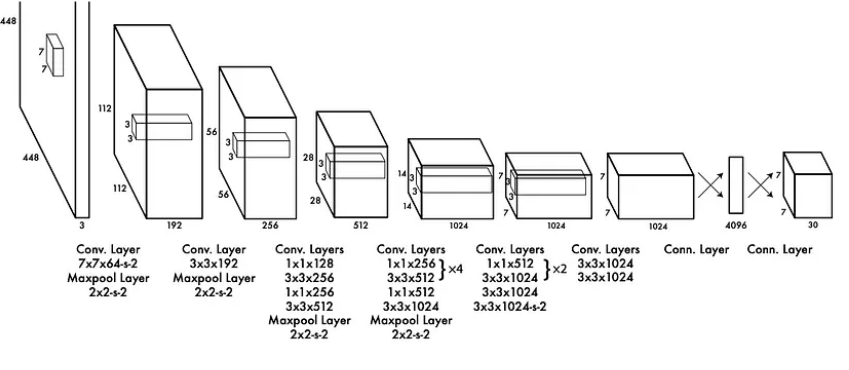
용어 설명
- 합성곱 계층 : 이미지에서 중요한 저수준 특징(가장자리, 간단한 패턴)을 추출한다.
- 필터 : 입력 이미지에서 특징 패턴을 감지하는 역할을 하는 작은 행렬
- 스트라이드 : 합송곱 계층에서 필터가 입력 데이터를 가로지르며 이동하는 간격
- 입력 데이터에서 샘플링의 밀도와 출력 크기에 영향을 미친다.
- 작은 스트라이드 : 더 세밀한 특징을 유지한다.
- 큰 스트라이드 : 크기를 빠르게 줄이고, 연산량을 감소시킨다. - 만약 스트라이드가 2라면, 이미지의 크기는
⁒2만큼 줄어든다. (112 * 112→56 * 56..)
예시 이미지 설명
- 필터 크기와 스트라이드를 조절함으로써 이미지의 크기를 줄여나간다.
448 * 448크기의 이미지를 입력받는다.7 * 7필터를 통해 이미지의 간단한 특징을 추출한다.- 스트라이드 값을 통해 이미지의 크기를 줄여나간다.
- 필터링하면서 이미지의 크기를 줄여나가지만, 채널의 개수(직육면체의 가로)가 늘어나면서 더 많은 패턴을 학습한다.
- 초기 계층에서는 간단한 모양을, 중간 계층에서는 구조적 특징을 감지한다. 최종 계층에서는 감지한 특징들을 통해 최종 클래스를 결정하게 된다.
- 초기 계층과 중간 계층의 과정은 동일하나, 각 계층에서 감지하는 특징에 차이가 있다. (위 설명과 동일)
- 위 이미지에서는 최종적으로
7 * 7 * 30텐서를 출력한다. - 최종 텐서를 통해 입력받은 이미지의 객체(클래스를) 결정한다.
합성곱 계층 활용 예시
[ 예시 ]
1. 입력 이미지1 2 0 1 2 4 5 1 3 1 1 0 2 4 1 3 1 0 1 2 1 1 3 0 2
- 필터링 (3 * 3)
-1 0 1
-1 0 1
-1 0 1
- 계산 결과 (특징 맵)
-3 1 0
-5 2 0
3 -2 4
YOLO 학습
- 합성곱 계층을 1000개의 클래스 데이터셋에서 미리 학습시켰다.
- 미리 학습시킨 모델에 합성곱 계층(convolutional layer)과
average pooling layer,fully connected layer을 사용하였다. - 약 1주일 간 학습한 결과, 단일 크롭 기준 상위 5개의 정확도가 88%에 도달했으며, 이는 GoogleNet 모델과 비슷한 수준이다.
- 그 후, 이 모델을 탐지 작업에 맞게 수정했다. 사전 학습된 네트워크에 합성곱 계층과 완전 연결 계층을 추가하면 성능이 향상된다고 주장하였다.
Loss Function 손실 함수
손실 함수의 목적
- 바운딩 박스의 위치와 크기를 정확히 예측
- 객체가 있는지 여부를 정확히 판단
- 객체의 클래스를 올바르게 분류
손실 함수식
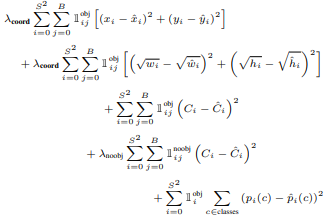
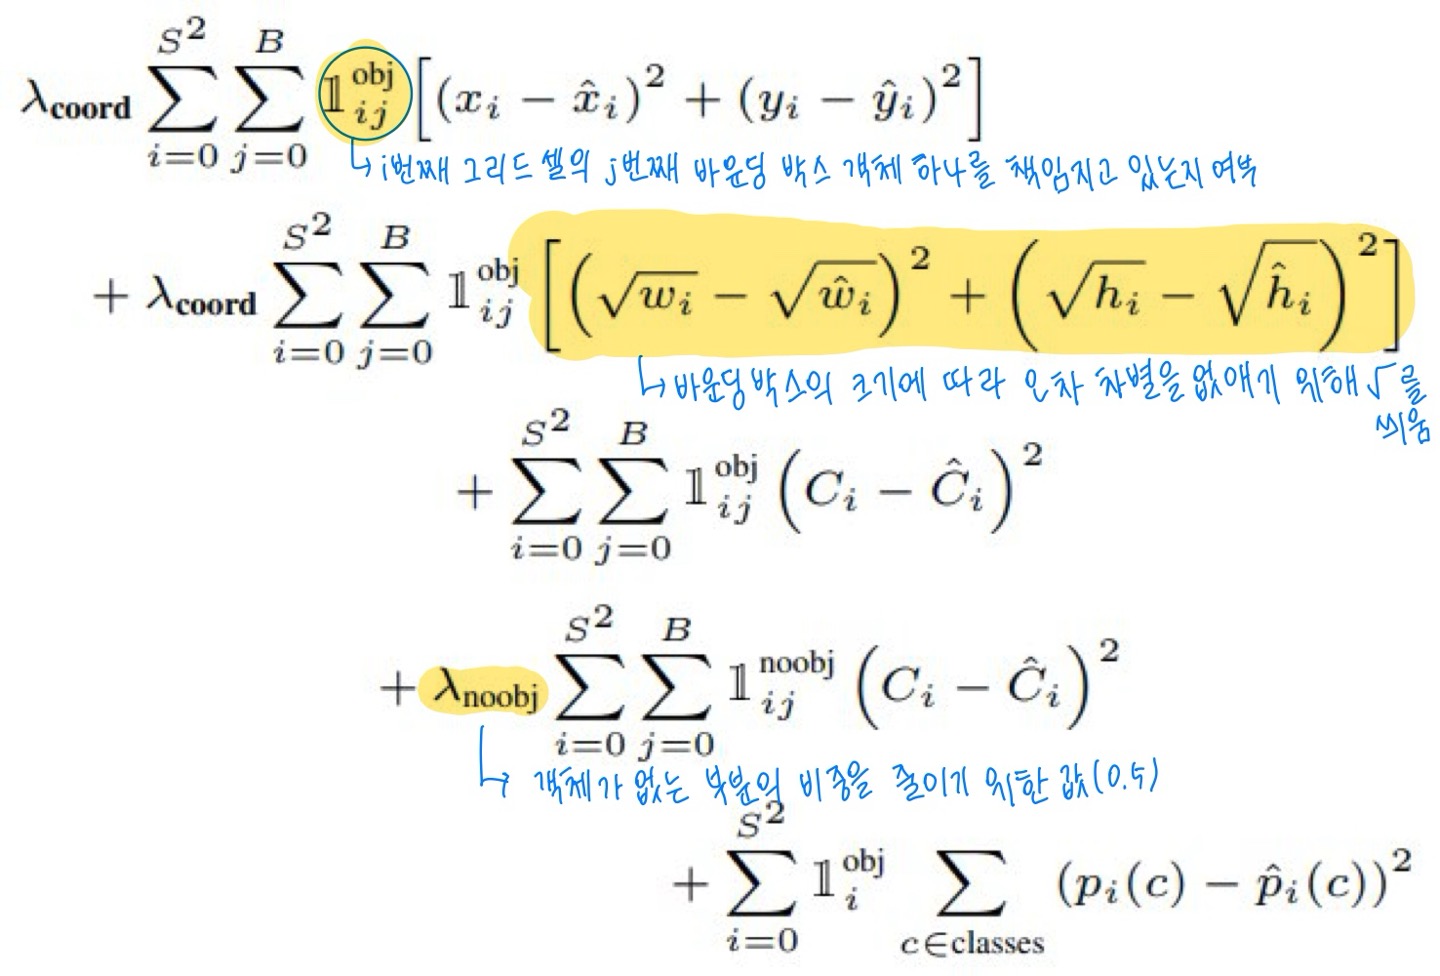
변수의 의미
B: 경계 상자의 수5: 각 상자의 좌표와 신뢰도 (x,y,w,h,confidence)C: 클래스 확률 (데이터셋의 클래스 개수)i: 그리드 셀의 인덱스j: 바운딩 박스의 인덱스 (그리드 셀마다 갖고있는 바운딩 박스의 수..?)
-
[ 1 ]
i번째 그리드 셀의j번째 바운딩 박스가 객체 하나를 책임지고 있는지에 대한 여부
[ 2 ] : Localization의 비중을 늘리기 위한 값
[ 3 ] : 바운딩 박스의 크기에 따른 오차 차별을 없애기 위해 루트(√)를 씌운다. -
λcoord: 위치 손실의 중요도를 강화하기 위해 사용됨 -
λnoobj: 객체가 없는 배경 셀의 손실을 줄이기 위해 사용됨
지시 함수 : i번째 그리드 셀에 j번째 바운딩 박스가 객체 하나를 책임지고 있는지에 대한 여부이다.
-> 책임을 지고 있다면 1, 아니면 0
- YOLO에서는 여러 개의 그리드 셀, 여러 개의 바운딩 박스에 속하는 것이 아니라, 한 개의 그리드 셀, 한 개의 바운딩 박스에 속하게 된다. ⇒ "그리드 셀을 책임진다"
- 바운딩 박스의 중심점이 위치한 그리드 셀만이 강아지 객체를 갖게 된다. → 나머지 그리드 셀은 객체가 없는 그리드 셀이 된다.
- 객체가 있는 바운딩 박스의
x좌표와,y좌표, 높이와 너비를 학습시킨다. - 너비와 높이의 루트(√) : 바운딩 박스의 크기에 따라 로스율 차별을 없애기 위함
예시) 실제 10, 예측 5 → 차이 5 / 실제 100, 예측 50 → 차이 50 ⇒ 바운딩 박스가 크면 객체의 크기가 크면 더 큰 오류로 인식한다. 그렇기 때문에 루트(√)를 씌움으로써 차이를 줄인다.
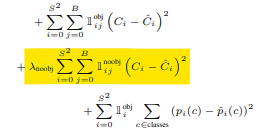
-
x,y,w,h⇒ Localization 값 -
Localization 값에 비중을 주기 위해서 '이 값'을 준다고 ...?
-
논문의 경우 Localization 값에 5를 주었다. ⇒ 로스율이 커진다.
-
로스율이 커지면 비중이 커진다.
-
confidence score는 객체가 없으면 0이라는 답을 줘야 한다.
그렇기 때문에 객체가 없는 경우도 학습을 해야 한다.
보통은 이미지에서 객체가 없는 그리드 셀이 훨씬 많기 때문에 학습 비중을 맞춰주기 위해 비중을 줄여준다. -> 1보다 작은 값을 줘야 함 (논문에서는 0.5)
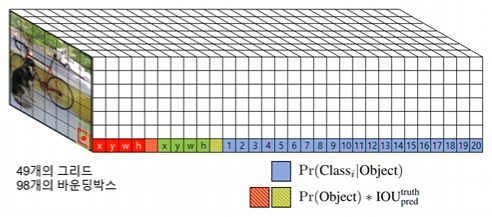
- 이미지가 입력되면 7 x 7 x 30의 텐서가 만들어진다.
- 49개의 그리드 셀
- 셀마다 30개의 값
- 5개의 바운딩 박스 두 개
- 객체가 존재할 경우 클래스별 확률 (20개의 클래스)
객체가 존재할 경우에
클래스 별 confidence score 값
그리드 셀마다 바운딩 박스가 두 개씩 존재한다.
객체가 존재할 경우 클래스 별 확률은 20개
뭘 어떻게 다 곱하면 총 40개가 만들어짐
그리드가 49개이므로, 바운딩 박스는 그 두 배의 값인 98개가 된다.
클래스 별로 객체 탐지 과정을 수행한다.
예시 : 강아지 클래스 - 5번
클래스 별 confidence score가 특정 값 이하인 경우를 다 제거한다.
임계값이 2라고 했을 때, confidence score가 0.2 이하인 놈들은 다 제거된다. ⇒ 강아지 주변에만 바운딩 박스가 남는다.
NMS 알고리즘
- 겹치는 바운딩 박스를 제거한다.
- IoU를 기준으로, 신뢰도 점수가 가장 높은 바운딩 박스만 남긴다.
- IoU 값에 따른 처리
- IoU = 0.5 : 두 박스가 50% 이상 겹치면 같은 객체로 간주
- IoU = 0 : 같은 클래스이지만 다른 객체로 간주
YOLO의 한계점
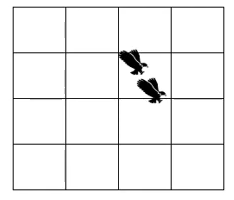
- YOLO는 그리드 셀 하나당 하나의 객체만 탐지할 수 있다.
- 그리드 셀 하나에 두 개의 객체가 있으면 하나밖에 탐지하지 못 한다.
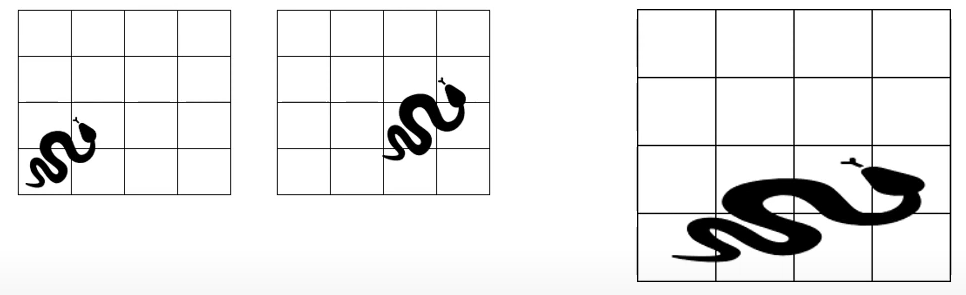
- 데이터로부터 학습하여 예측하기 때문에, 학습 데이터에 없던 종횡비를 만나면 바운딩 박스를 그리지 못 한다.

= 크기가 다르기 때문에 IoU 값이 아주 다르게 나온다. - 왼쪽 사진: IoU 값이 큼, 오른쪽 사진: IoU 값 작음
- 바운딩 박스의 크기에 상관 없이 동일한 loss 를 주기 때문에 성능에 악영향을 끼칠 수 있다.
2. Experiment
- YOLO와 R-CNN 변형의 차이점을 이해하기 위해, YOLO와 R-CNN의 가장 성능 높은 버전 중 하나인 Fast R-CNN이 만든 VOC 2007 오류를 탐구한다.
- 다양한 오류를 바탕으로 YOLO를 사용하여 빠른 R-CNN 탐지를 재점수화하고, 배경 오탐지에서 발생하는 오류를 줄여 성능을 크게 향상시킬 수 있음을 보여준다.
- VOC 2012 결과도 제시한다. mAP를 최신 방법과 비교한다.
- YOLO가 다음과 같은 새로운 도메인으로 더 잘 일반화된다는 것을 보여준다.
- YOLO가 두 개의 예술 작품 데이터셋에서 다른 탐지기보다 새로운 도메인으로 더 잘 일반화된다는 것을 확인할 수 있다.
Combining Fast R-CNN and YOLO
Fast R-CNN과 YOLO를 함께 사용하여 정확도와 속도를 올릴 수 있다.
Fast R-CNN
- Rol Pooling과 CNN 기반의 세밀한 분석으로 비교적 높은 정확도 제공
- 객체의 바운딩 박스 위치를 보다 정확하게 예측
- Region Proposal을 외부 알고리즘에 의존하여 속도가 느림
YOLO
- YOLO는 전체 이미지를 한 번에 처리하므로 매우 빠른 객체 탐지가 가능
- 실시간 처리 가능
- 정확도 낮음
- 세부 분석 부족
Genralizability: Person Detection in Artwork
- YOLO는 일반화가 매우 뛰어난 모델이다.
- 일반화 : 기계 학습 및 딥러닝에서 모델이 학습 데이터에서 얻은 지식을 바탕으로, 이전에 본 적 없는 새로운 데이터에서도 잘 작동하는 능력
- 모델이 특정한 데이터셋에서만 과도하게 적합(overfitting)되지 않고, 다양한 상황과 데이터 분포에서도 높은 성능을 유지할 수 있는지를 측정한다.
- 객체 탐지를 위한 학술 데이터셋은 보통 학습 데이터와 테스트 데이터를 동일한 분포에서 추출한다.
-
AP(Average Precision) : 객체 탐지 성능을 평가하는 주요 지표 중 하나
-
값이 높을수록 모델의 성능이 좋다는 뜻이다.
-
객체 탐지 모델이 정확하게 탐지하고 누락 없이 탐지하는 능력을 평가한다.
-
정확도와 재현율의 관계를 바탕을 계산된다.
-
정확도(Precision) : 모델이 탐지한 객체 중에서 실제로 올바르게 탐지된 객체의 비율
-
재현율(Recall) : 실제 객체 중에서 모델이 올바르게 탐지한 객체의 비율
-
- R-CNN : 객체 탐지를 위해 딥러닝 기반 접근 방식을 도입한 초기 모델
- 지역 제안 (Region Proposal)
- 특징 추출 (Feature Extraction)
- 분류 (Classification)
- 바운딩 박스 조정 (Bounding Box Regression)