Intro
Double-Descent: 성능이 나빠졌다가 좋아지는 현상
Before: bias-variance trade-off
- 모델 복잡도가 특정 임계값을 넘어서면,
모델은 과적합되어, 모델 복잡도를 늘릴수록 성능을 저하시킨다
→ 특정 임계값 이상에서, 더 큰 모델이 더 나쁘다
→ early stopping이 성능을 향상
Now: 신경망의 발전
- 수백만개의 매개변수를 가져,
무작위 레이블도 학습하기에 충분하며, 더 큰 모델이 더 나은 성능
→ 더 큰 모델이, 성능이 더 좋다
- zero training error까지의 훈련이 성능을 향상
공통 의견
- 더 많은 데이터셋이 성능을 향상
논문: 일반적 통념 중 일부 통합 및 도전
Double-Descent의 등장
under-parameterized regime: 모델 복잡도가 샘플 수에 비해 작은 영역
→ 모델 복잡도에 따른 test error가 bias-variance tradeoff가 예측하는 U자 형태
interpolate: training error가 거의 0이 되는 상태
→ 모델 복잡도가 커져 interpolation에 도달하면, 모델 복잡도를 늘릴수록 test error가 감소한다 (현대적 직관)
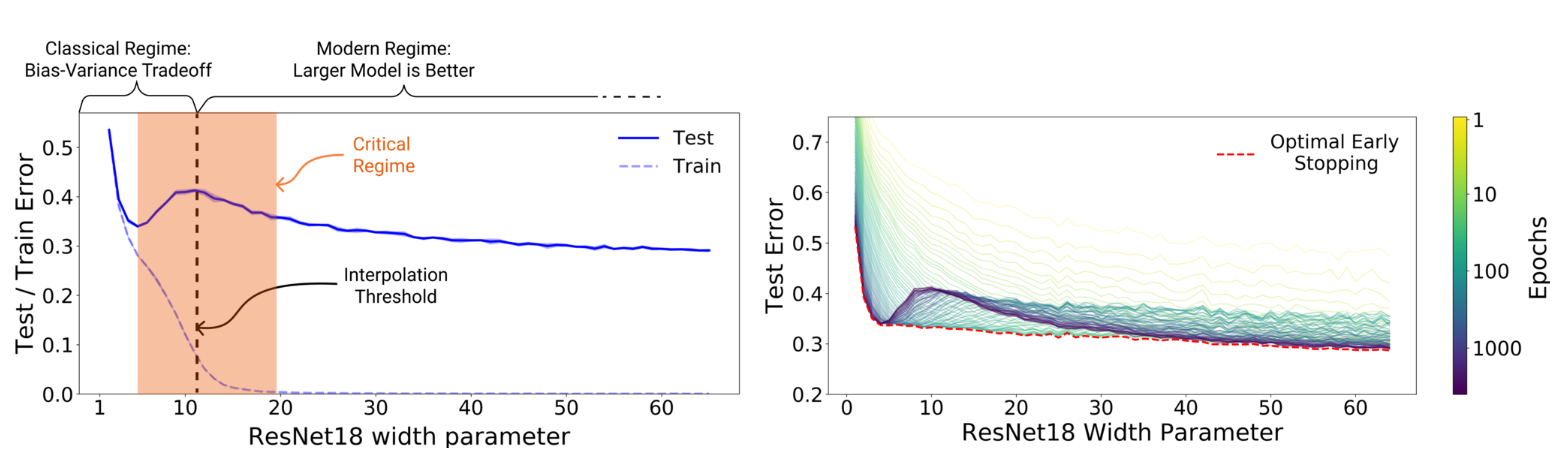
Double-Descent의 일반화
매개변수 수 변화를 넘어 일반화
effective model complexity: 훈련 오차 0을 달성할 수 있는 최대 샘플 수
→ 데이터 분포, 분류기 구조 뿐 아니라, 훈련 절차에도 의존
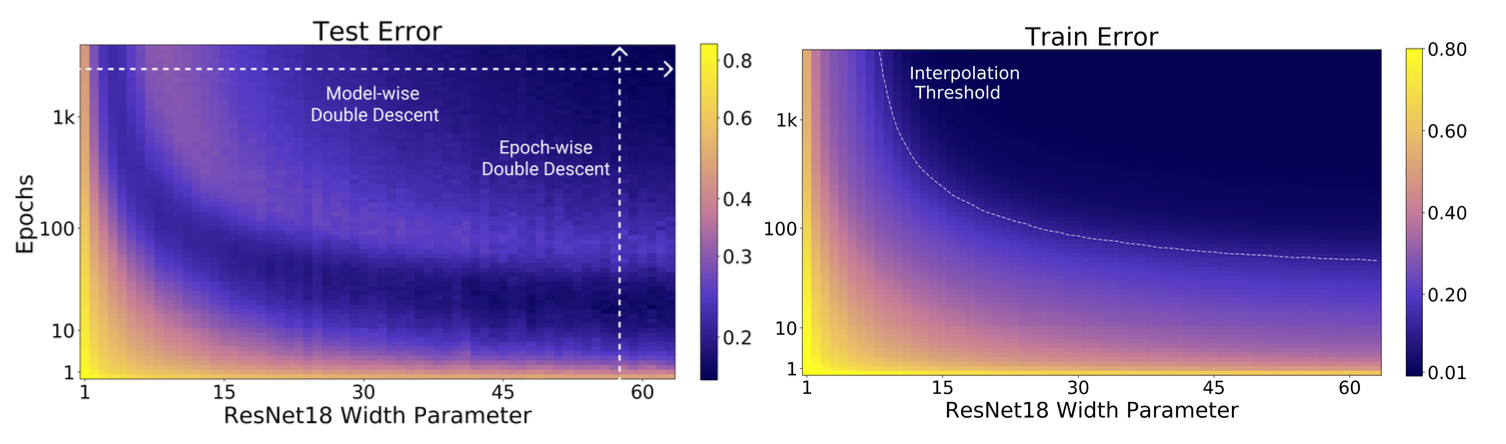
→ 훈련 시간 증가 - EMC 증가
double descent는 단순히 parameter 수를 늘릴 때만 나타나는 현상이 아니라, effective model complexity(EMC)를 증가시키는 모든 요소에서 나타날 수 있다. ex) epoch
Sample non-monotonicity (샘플 비단조성)
- EMC가 샘플 수와 일치하는 지점에서 test error 최대
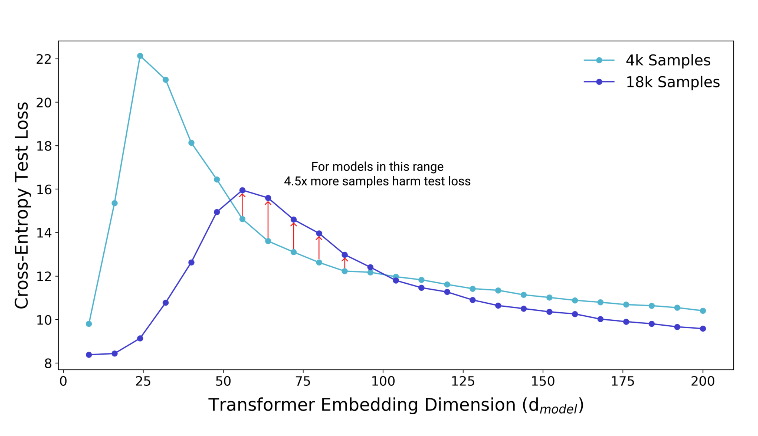
18k에서의 최고점이 4k의 최고점보다 오른쪽에 분포
더 많은 데이터가 더 나쁜 결과를 가져올 수 있다
Effective model complexity 정의
: 학습 절차
: 학습 샘플 (입력)
: 출력하는 모든 절차
:
T가 평균적으로 약 0의 훈련 오차를 달성하는 최대 샘플 수 n
: 모델 M의 훈련 샘플 S에 대한 평균 오차
비공식 가설1.
Under-parameterized 영역
가 n보다 충분히 작다면, T의 EMC를 증가시키는 변화는 test error을 감소시킨다
Over-parameterized 영역
가 n보다 충분히 크다면, T의 EMC를 증가시키는 변화는 test error을 감소시킨다
Critically parameterized 영역
가 n과 거의 일치한다면, T의 EMC를 증가시키는 변화는 test error을 감소시킬수도, 증가시킬수도 있다
문제
값 선택 기준 X
“sufficiently small”, “sufficiently big”의 기준 X
시사
근처 구간에 임계 구간이 있다:
이 구간 아래, 위에서는 복잡도 증가가 성능 향상에 도움이 되지만,
구간 내에서는 성능을 약화시킬 수 있다.
임계 구간의 넓이는 우리가 이해하지 못하는 방식으로 분포와 훈련 절차 모두에 의존한다.
기존 연구와의 차이
-
Parameter 중심에서 EMC 중심으로 확장
complexity 결정 요소
- parameter 수
- training time (epoch)
- optimization procedure
- regularization
새로운 통찰
- epoch-wise double descent
- sample non-monotonicity
실험
아키텍처: ResNets, Standard CNNs, Transformers
ResNets: ResNet18(64k) 개열의 convolution layer의 filter 수(너비)를 스케일링하여 모델 크기 변경
- 레이어 너비로 [k,2k,4k,8k] 사용
Standard CNNs: 4개의 신경층 너비 ([k,2k,4k,8k])와 fully-connected layer 5계층 CNN 계열
- k=64인 CNN은 CIFAR-10에서 90% 이상의 정확도 달성
Transformers: 6계층의 인코더-디코더 형태
- embedding 차원 수정하고,
fully-connected layer 너비를 비례적으로 설정 하여
모델 크기 변경
ResNet과 CNN
- 학습률 0.0001의 Adam으로 4K 에포크
- 학습률 의 SGD로 500K 그래디언트 스텝.
Transformer
80k의 gradient step, 10% label smoothing 적용, dropout 사용 X
Label Noise
p의 확률로 무작위로 선택된 잘못된 라벨을 갖는 것
- 노이즈 분포에서의 test error
Model-Wise Double Descent
충분히 오래 학습시킨 상태에서(completion), 모델 크기를 점점 증가시키는 경우 test error의 변화를 분석
- 다른 아키텍처, 데이터셋, optimizer, training procedure에서 model-wise double descent 확인
- interpolation threshold 주변의 critical region에서 test error peak 확인.
label noise가 있는 환경에서 더욱 뚜렷해짐
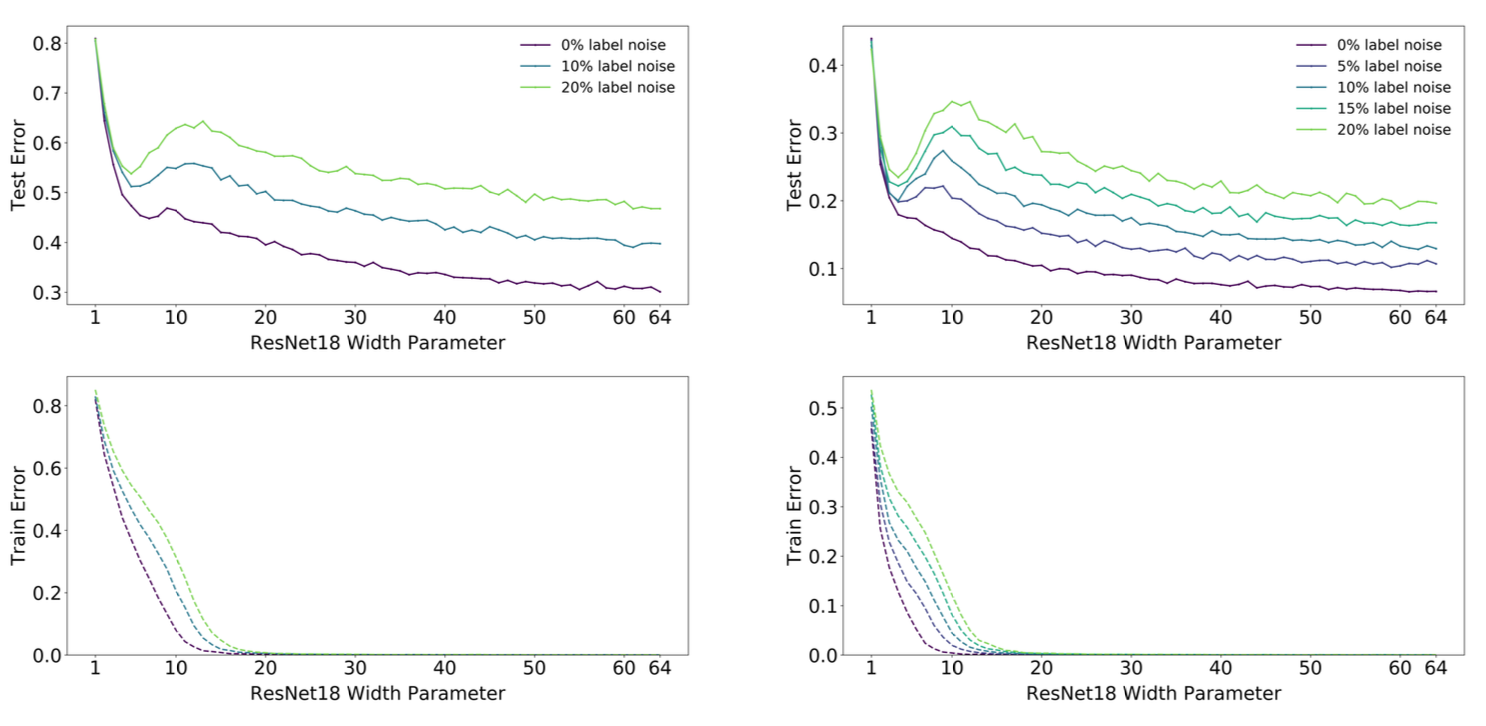
L: CIFAR-100, R: CIFAR-10
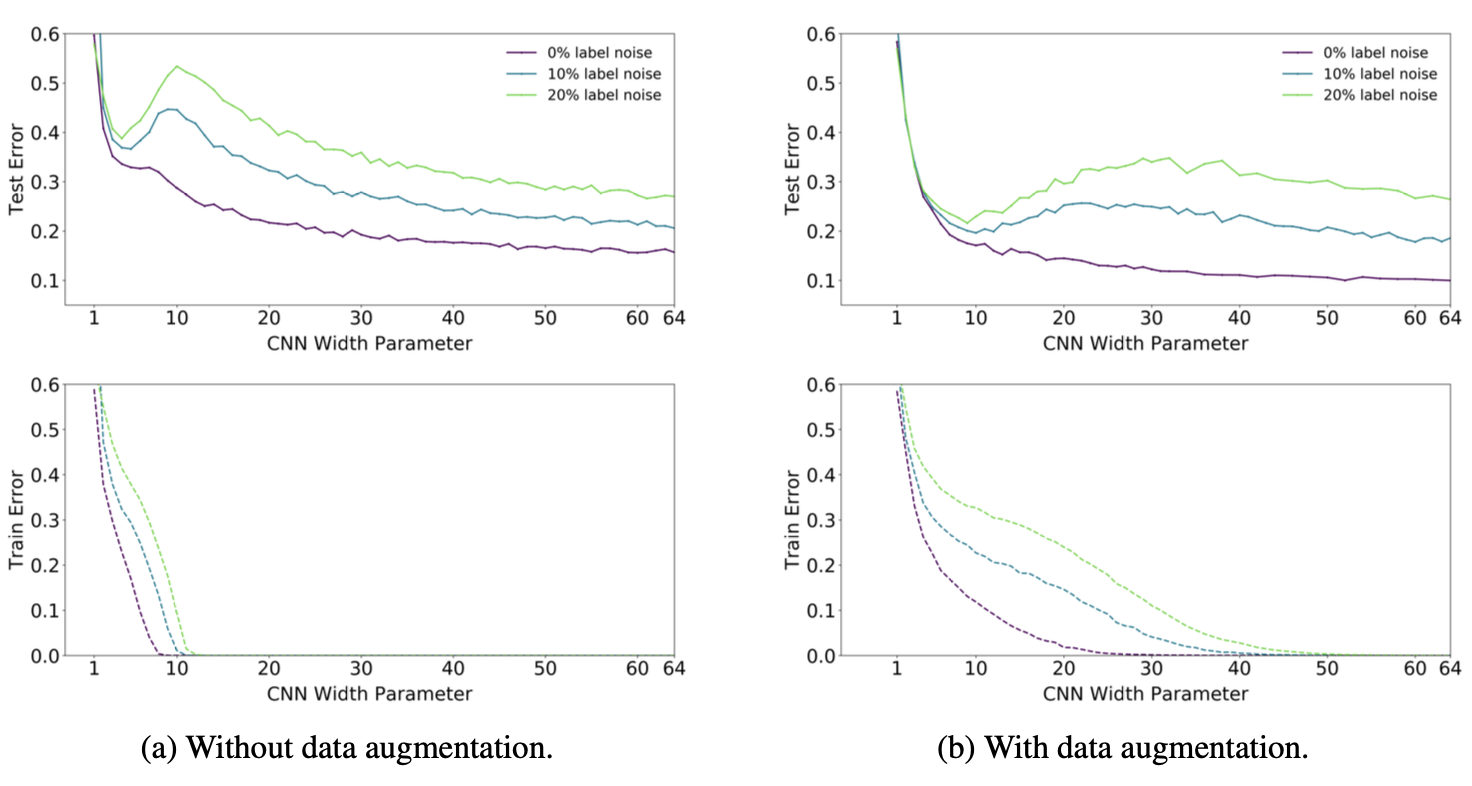
L: W/O data augmentation, R: With data audmentation
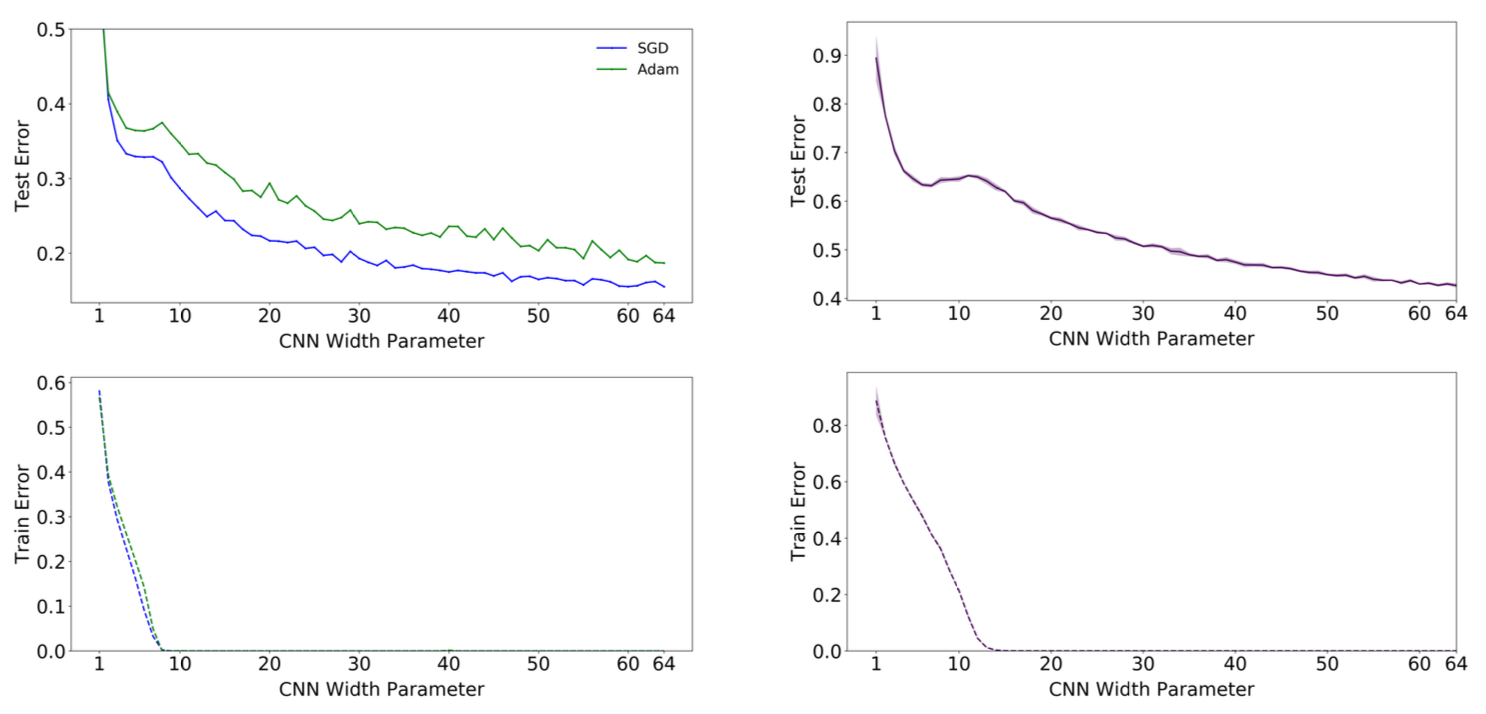
L: SGD vs. Adam, R: Noiseless settings
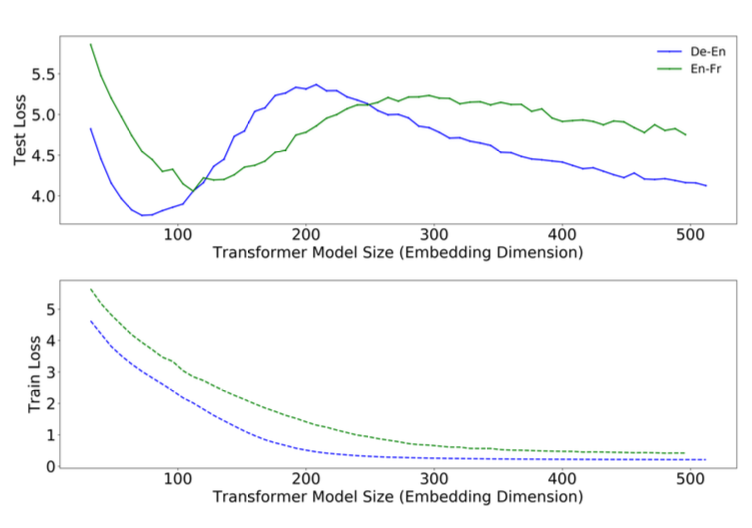
Transformers on language translation tasks
interpolation threshold를 증가시키는 모든 변화는 test error peak를 더 큰 모델 쪽으로 이동
주장
interpolation threshold 근처의 모델 크기에서는 학습 데이터를 정확히 맞출 수 있는 모델이 하나밖에 없다고 볼 수 있다.
그리고 이 유일한 interpolating model은 학습 데이터의 noise나 모델의 잘못된 가정(model mis-specification)에 매우 민감하다.
→ 모델이 학습 데이터를 겨우 맞추기 때문에, 약간의 노이즈로 모델 전체 구조가 무너지고 높은 test error로 이어진다
over-parameterized 모델에서는 학습 데이터를 정확히 맞출 수 있는 interpolating solution이 매우 많고, SGD는 그중 noise를 단순히 ‘암기(memorize)’하거나 ‘흡수(absorb)’하면서도 전체 데이터 분포에서는 여전히 잘 일반화하는 solution을 찾을 수 있다.
Epoch-Wise Double Descent
학습 epoch에 따라 나타나는 새로운 형태의 double descent(epoch-wise double descent)를 분석
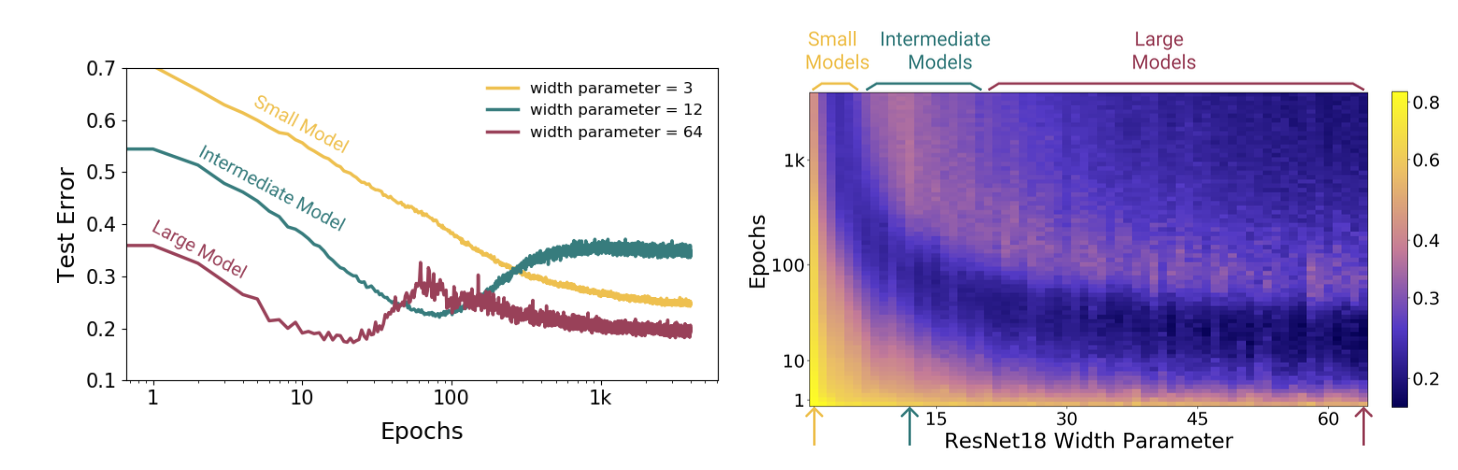
훈련 시간을 늘리면 EMC가 증가하며, 과소적합 → 과적합 상태로 전환
충분히 큰 모델은 Double Descent 현상이 나타남
중간 크기 모델은 고전적인 U자형 곡선을 따름
작은 모델은 훈련 시간을 늘리면 테스트 오차가 단조적으로 감소
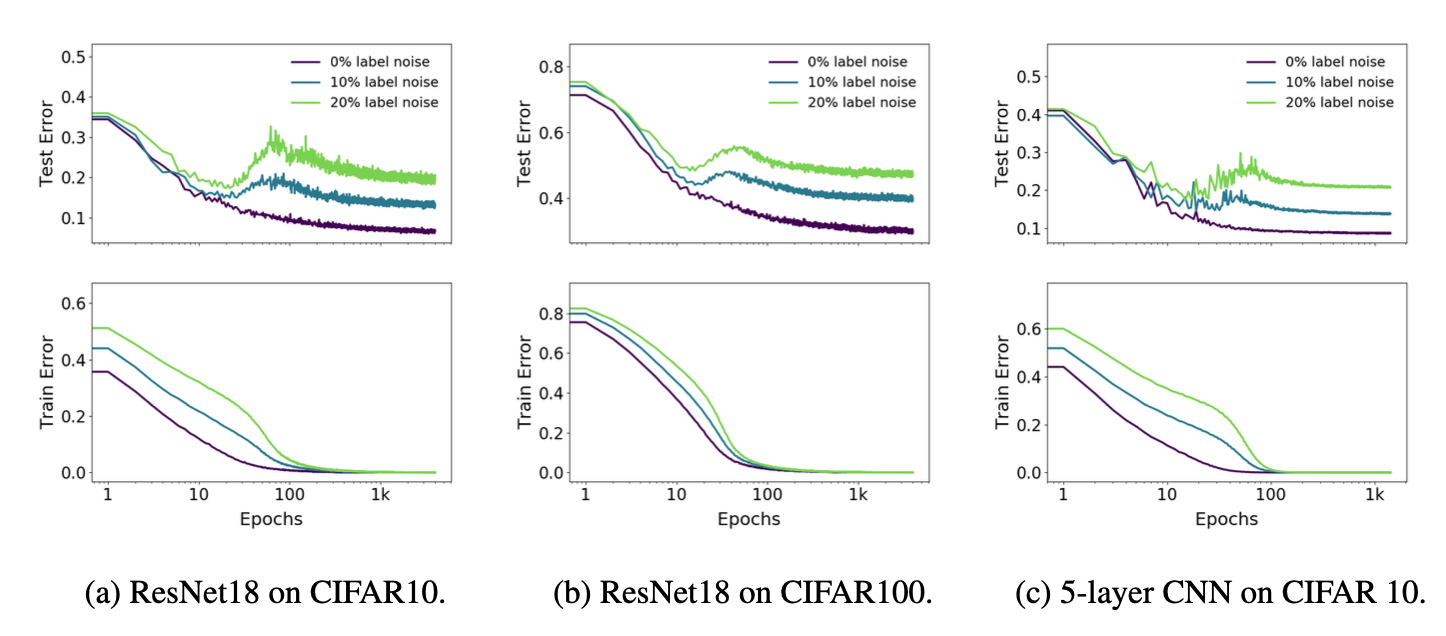
label noise에 따른 다양한 모델, 데이터셋에서의 Epoch-Wise Double Descent
기존 통념
- 첫번째 단계에서, 네트워크는 작은 일반화 오차(generalization gap)를 가진 함수를 학습
- 두번째 단계에서, 네트워크는 데이터를 과적합하기 시작 → test error 증가
→ 일부 영역에서, test error가 다시 감소하고, 첫번째 최소값보다 낮아짐을 확인 (10% label noise)
7. Sample-Wise Non-Monotonicity
- 샘플 수를 늘렸는데 성능이 단조롭게 좋아지지 않는 현상
고정된 모델과 훈련 절차에 대해 훈련 샘플 수(n)를 변경하며 변화를 분석
n을 증가시킴으로 훈련 절차 T는 과적합 → 과소적합 전환
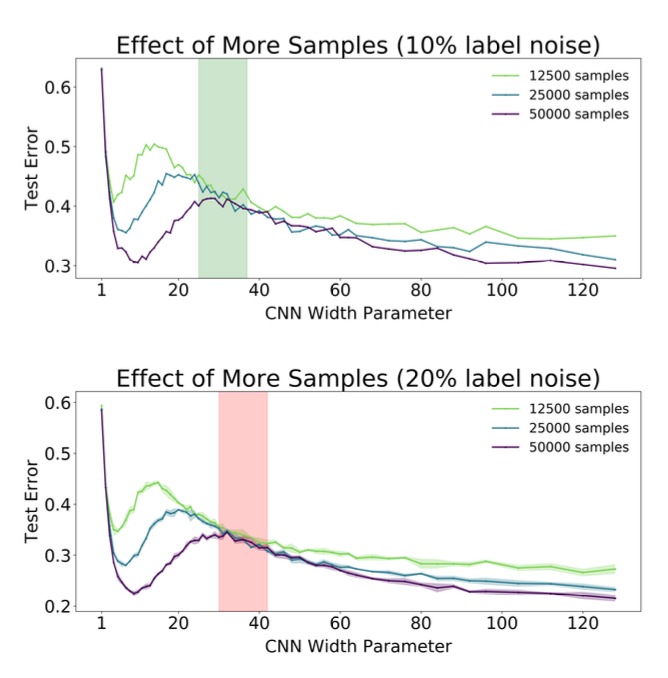
샘플 수를 늘려도 test error가 개선되지 않는 구간이 있다.
Top: 2배 더 많은 샘플
Bottom: 4배 더 많은 샘플
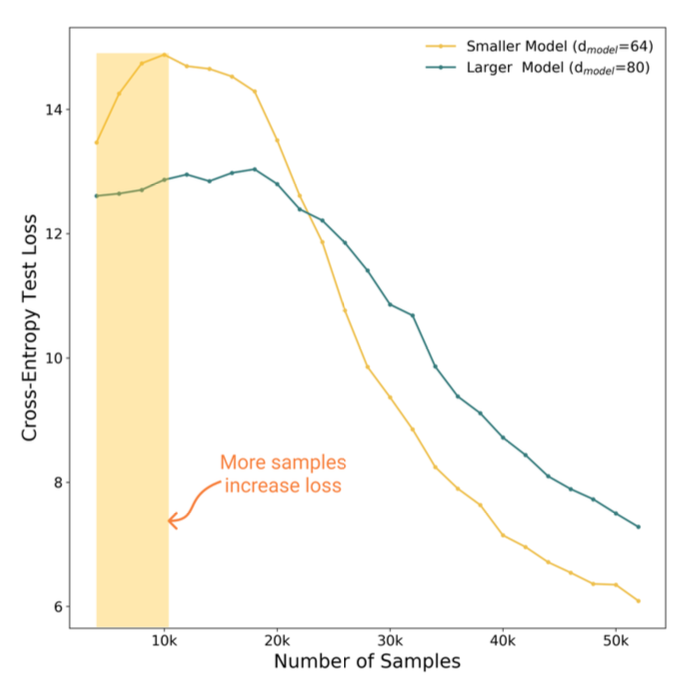
샘플 수 증가가 성능을 감소시키는 구간이 존재
임계 구간 밖에서는 더 많은 샘플이 성능 향상에 도움
샘플 수 증가의 영향
- 곡선 아래 면적 감소
- 곡선을 오른쪽으로 이동 (test error peak가 발생하는 모델 복잡도도 더 큰 쪽으로 이동)
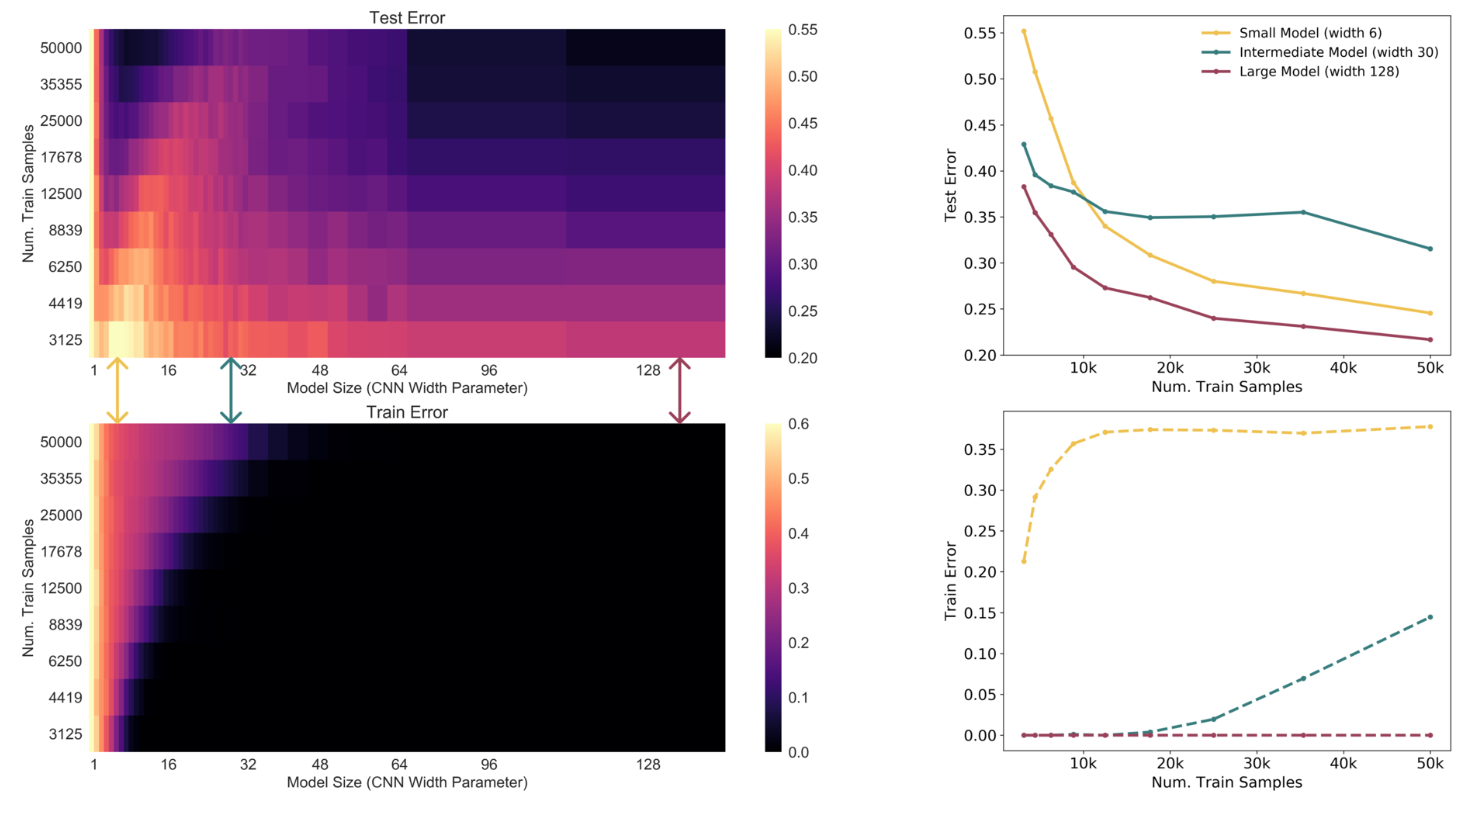
모델 크기, 샘플 크기에 대한 test error
Left: CIFAR-10 + 20% noise
- 보간 임계 구간에서 test error증가하는 형태 → Generalization 성능 약화
Right: Left의 세 단면 분석
- 모델 크기에 따라 더 많은 샘플 수가 미치는 영향 비교
- 작은 모델에서는 샘플 수 증가가 성능 향상에 도움
- 큰 모델에서도 샘플 수 증가가 성능 향상에 도움
- 보간 임계 구간에서는 샘플 수를 증가해도 성능이 향상되지 않음
샘플 수 증가는 test error를 낮추는 긍정적 효과와 interpolation threshold를 더 큰 complexity 영역으로 이동시키는 효과가 동시에 존재한다.
일부 설정에서는 이 두 효과가 결합되어, 특정 모델 크기 구간에서 더 많은 데이터가 오히려 test 성능을 악화시키는 sample-wise non-monotonicity가 나타난다.
- 샘플 수가 늘어나면, 샘플을 맞추기 위해 모델 복잡도도 커지는 현상
Conclusion
모델과 훈련 절차는 EMC가 훈련 샘플 수와 비슷할 때 Double Descent 현상을 보인다
최신 모델에 대해 Model-Wise Double Descent를 보이며,
새롭게 Epoch-Wise Double Descent를 보인다.
Double Descent가 더 많은 샘플이 더 나쁜 테스트 성능으로 이어지는 구간을 생성함을 확인
etc.
Early Stopping
보통 Early Stopping에서 Double Descent가 발생하지 않는다.
Double Descent가 발생하기 위한 샘플 수까지 도달하지 않기 때문이다.
그러나 최적의 early stopping에서 double descent가 발생하는 모델이 있다.
최적의 early stopping 사용시, 더 많은 샘플이 성능을 약화시키는 설정은 관찰 못함.
그렇지만 발생할 수 없다고 단정할 수도 없다
Label Noise
실험에서는 label noise가 있는 환경을 집중적으로 봤다.
하지만, 이 현상의 주 원인이 label noise라고 보긴 어렵다. 오히려 model mis-specification에 있다고 본다 (실제 데이터 분포와 모델 family 간의 mismatch)
label noise는 이를 인위적으로 증가시킬 뿐
Other Notions of Model Complexity
EMC는 Rademacher complexity와 같은 고전적 모델 복잡도 개념과 관련이 있지만, 차이가 있다
- EMC는 데이터 분포의 실제 label에 의존
- EMC는 모델 구조뿐 아니라 훈련 절차에도 의존
이 두가지 특성이 없는 복잡도 개념은 double descent 위치를 설명하기에 충분치 않다.
