1. Introduction
LLM의 추론 능력과 복잡한 문제 해결 능력을 향상시키기 위해, 다양한 프롬프트 방법 제시
- few-shot, zero-shot, CoT: 인간이 문제를 단계별로 해결하는 방식
- decomposition-based prompting(분해기반 프롬프팅): 문제를 작은 하위 문제로 분해 후, 해결
- step-back prompting: 인간이 Task의 본질을 성찰하여 일반적인 원리를 도출
문제점
“문제마다 최적의 사고 방식이 다를 수 있는데, 하나를 미리 정해서 밀어붙인다”
논문 주장
“문제마다 원래 잘 맞는 사고 구조가 따로 있다”
SELF-DISCOVER
자연어로 설명된 추론 모듈과 레이블이 없는 Task을 바탕으로,
Task에 효율적인 추론 구조를 구성하고(Stage1)
이를 사용해 Task을 해결(Stage2)
장점
- 여러 추론 모듈의 강점을 활용
- 다양한 모듈을 task에 맞게 선택,조합 가능
- Task 수준에서 3개의 추가 추론 단계만 필요하므로 계산 효율적
- 이후에는 해당 reasoning structure를 재사용
- 추론 집약적 앙상블 접근 방식보다 성능은 더 우수
- Task에 맞춰진 추론 구조이므로, 최적화된 프롬프트보다 LLM이 그 Task을 어떻게 이해하는지 해석가능
Test
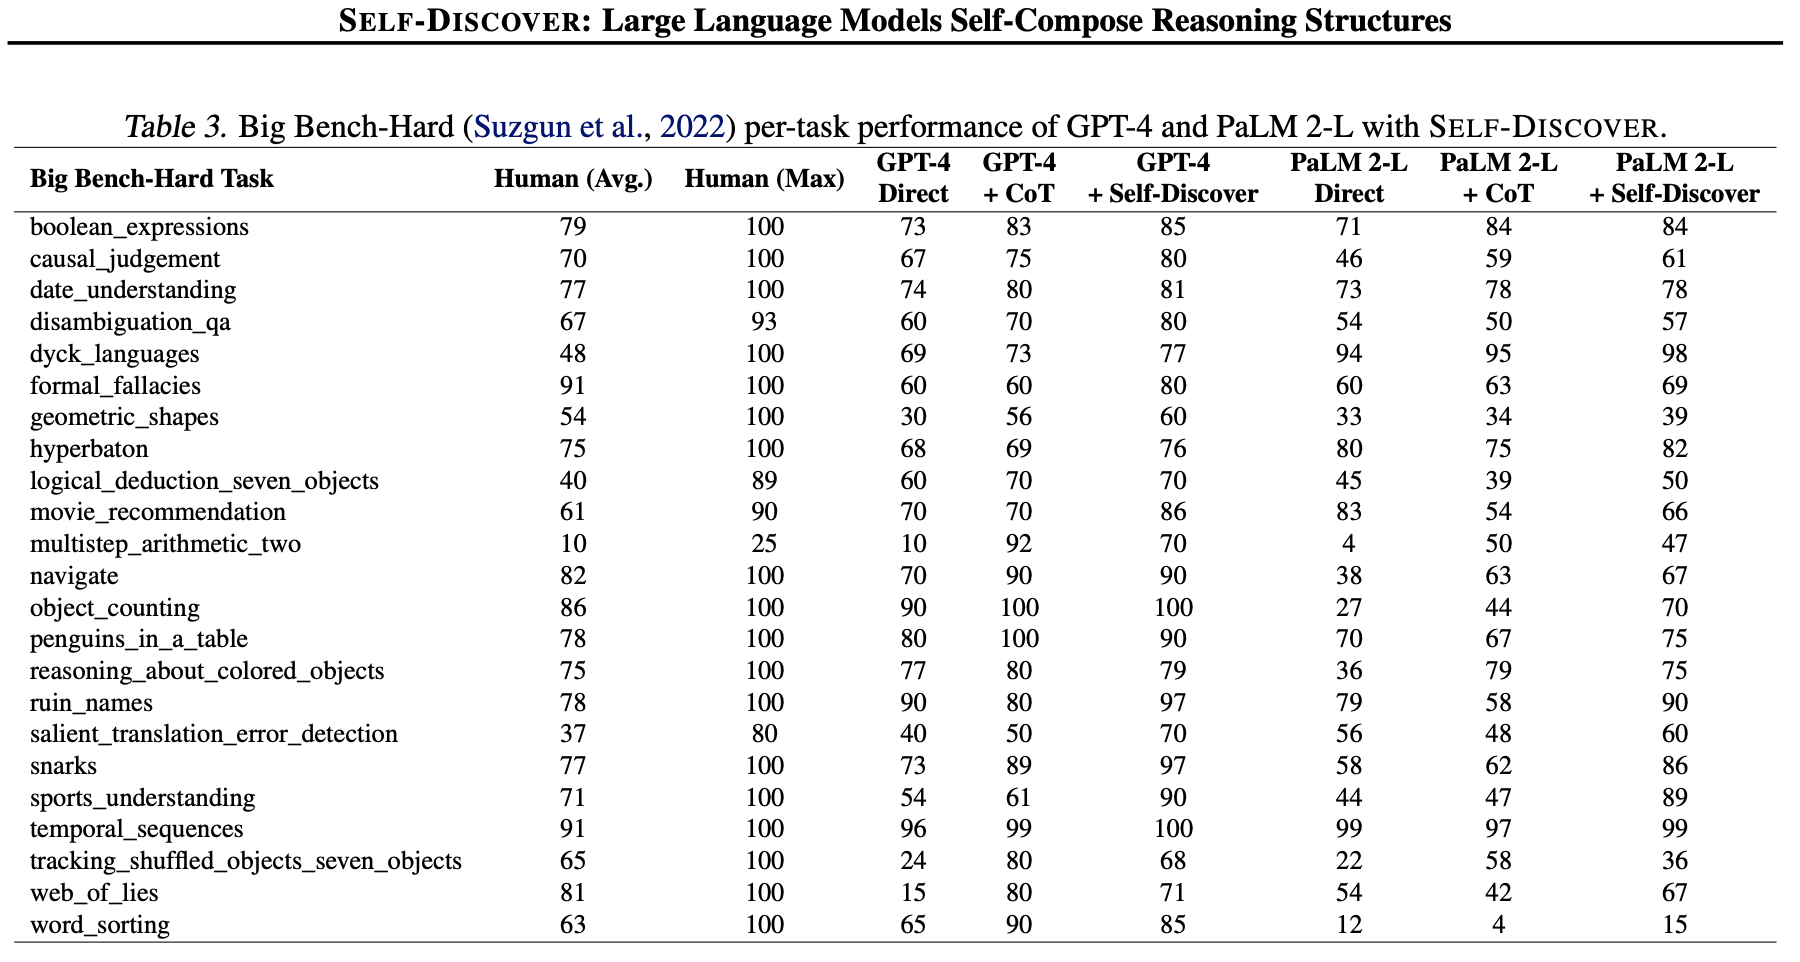
Big Bench-Hard, Thinking for Doing, MATH 포함 25개의 추론 Task에서 테스트
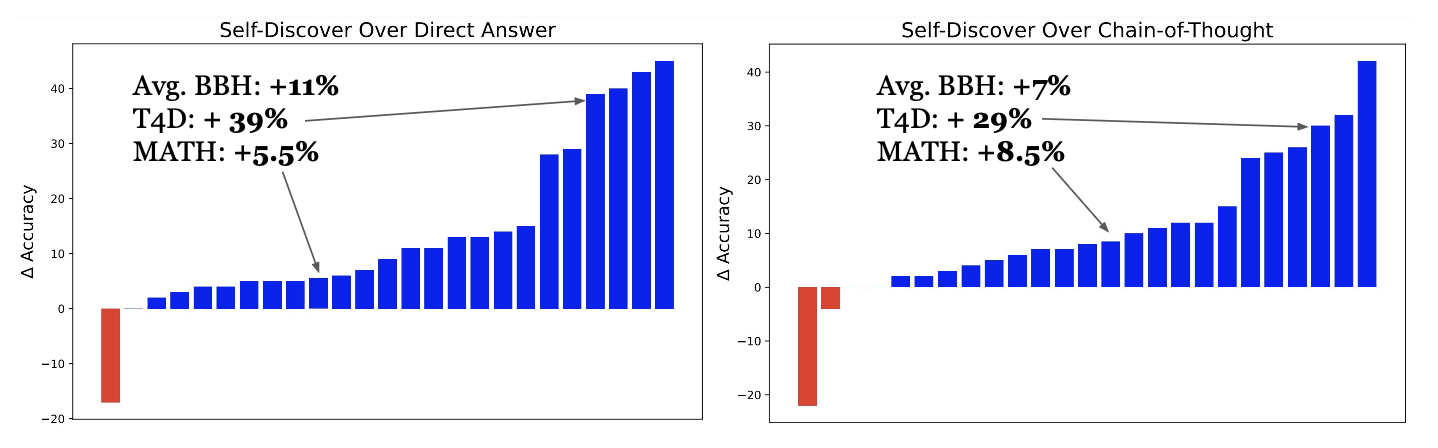
Direct Answering보다 23/25 task에서, Chain-of-Thought보다 21/25 task에서 더 좋은 성능을 보임.
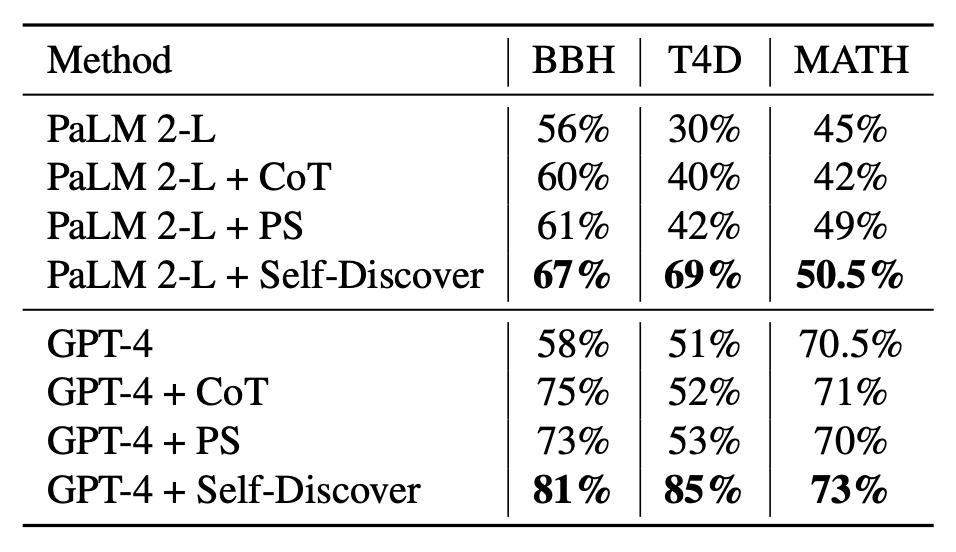
SELF-DISCOVER가 대부분의 benchmark에서 기존 prompting보다 성능이 좋음
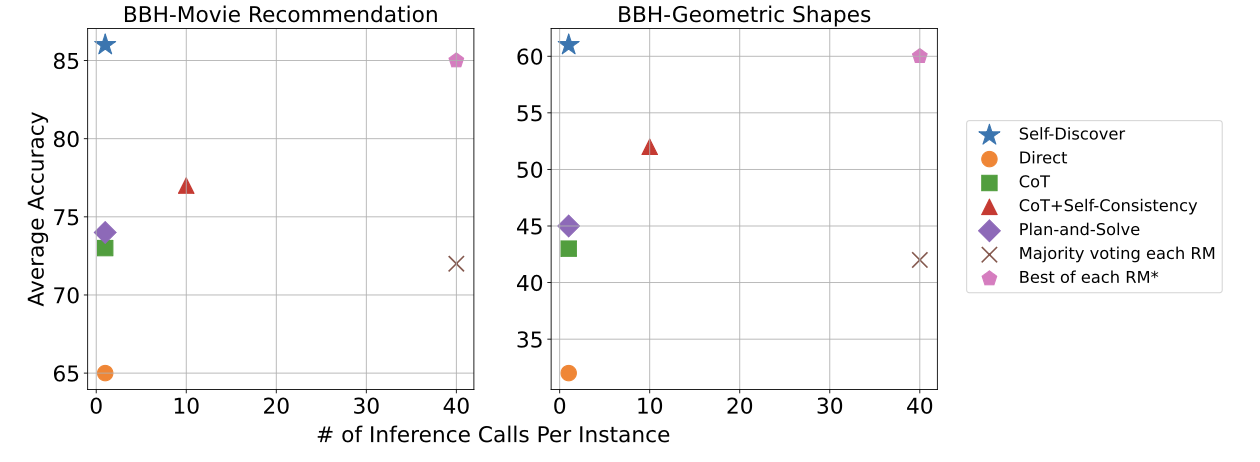
SELF-DISCOVER는 GPT-4에서 Direct Answering, CoT보다 높은 정확도를 보이면서도, 수십 번 inference가 필요한 voting 기반 방법보다 훨씬 적은 호출로 더 좋은 성능을 달성
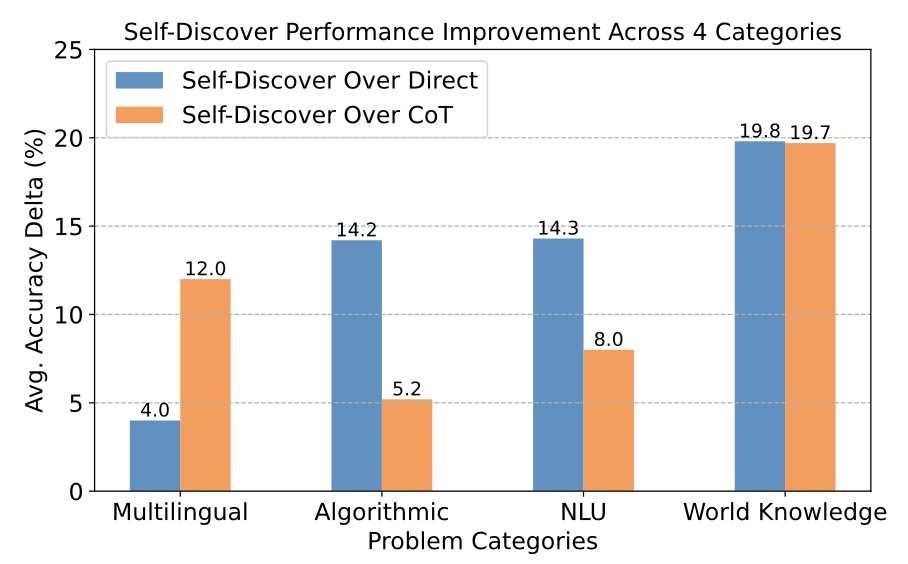
세계적인 지식을 요구하는 Task에서 SELF-DISCOVER이 가장 좋은 성능을 보임
계산 문제로 구성된 MATH Task에서 성능이 높지 않음
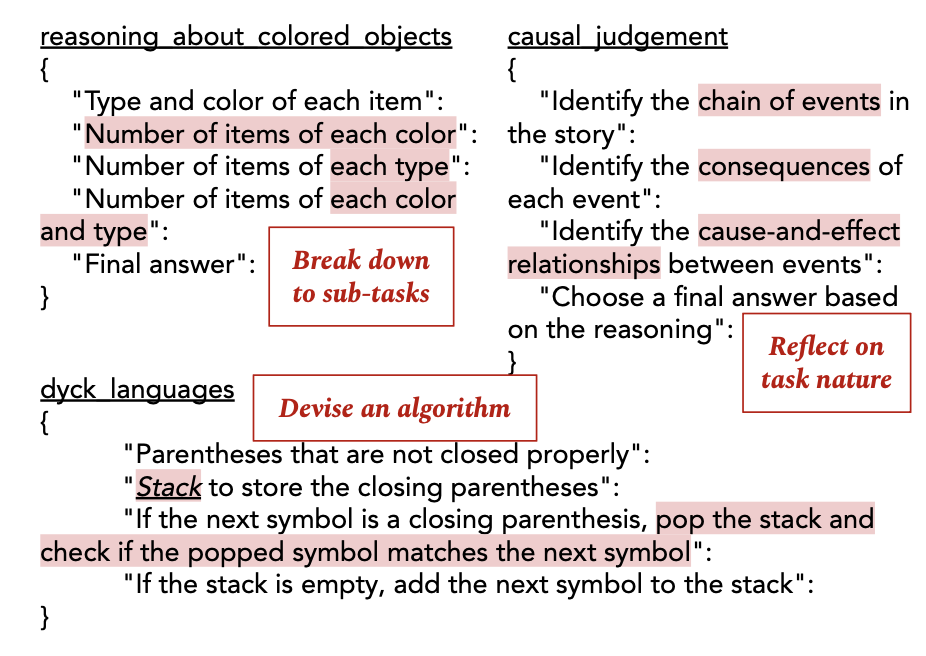
SELF-DISCOVER 추론 구조의 예시
2. Self-Discovering Reasoning Structures for Problem-Solving
SELF-DISCOVER의 추론구조를 분석
Stage1. Self-Discover Task-Specific Structures
세가지 액션으로 구성
1. SELECT: Task 해결에 관련된 추론 모듈을 추론 모듈 집합에서 선택
2. ADAPT: 선택된 추론 모듈의 설명이 Task에 맞게 구체적으로 재구성
3. IMPLEMENT: 재구성된 추론 설명을 구조화된 실행 가능 계획으로 구현 → 구조에 따라 Task 해결
SELECT
모든 추론 모듈이 Task에 맞는 것은 아니다.
Task 예제를 기반으로 유용한 모듈을 선택하게 모델을 가이드한다.
ex)
”비판적 사고”: 과학 문제대 대한 1원리 이론을 탐색하는데 유용
”창의적 사고”: 이야기의 뒷부분을 생성하는데 유용
원시 추론 모델 세트 D와 레이블 없는 Task 예제 ti ∈ T 가 주어졌을 때,
모델 M과 메타 프롬프트 pS를 사용해 Task 해결에 유용한 추론 모듈의 부분집합 DS를 선택
ADAPT
각 추론 모듈은 문제 해결에 대한 일반적인 설명을 제공하므로,
다음 단계는 선택된 모듈을 주어진 Task에 맞게 조정하는 것을 목표로 한다
DS가 주어졌을 때, 메타 프롬프트 pA와 생성 모델 M을 사용해 Task에 더 구체적인 추론 모듈 DA를 생성
ex)
”문제를 하위 문제로 분해” → “각 산술 연산을 순서대로 계산”
IMPLEMENT
DA가 주어졌을 때, DA를 구현된 추론 구조 DI로 구체화하며,
각 단계에서 무엇을 생성해야 하는지에 대한 지침을 명시
메타 프롬프트 p_I 이외에도, 추론 구조로 더 잘 변환하기 위해
다른 Task에 대해 사람이 작성한 추론 구조 S_human의 데모를 제공
Stage 2. Tackle Tasks Using Discovered Structures
세 단계를 거쳐 나온 DI를 Task의 모든 인스턴스에 추가하고,
모델이 추론 구조를 따라 답변 A를 생성하도록 프롬프팅.
3. Deep Diving Into Self-Discovered Reasoning Structures
SELF-DISCOVER의 모든 구조가 필수적인가?
다른 구조가 가져오는 이점이 있는가?
Importance of SELF-DISCOVER Actions
SELECT, ADAPT, IMPLEMENT 세 단계에 대해 ablation study를 수행
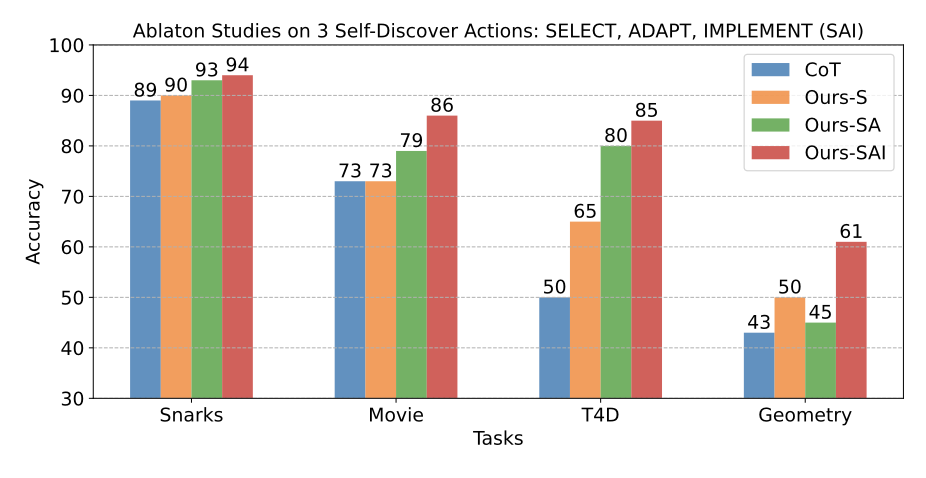
각 단계마다 모델의 제로샷 추론 능력이 작업 전반에 걸쳐 일관되게 향상됨
- 세가지 단계 모두 도움이 된다
특히, SAI를 모두 적용 후, 추론 구조가 Task에 맞춰져, 추론에 이점이 생김
Towards Universality of Discovered Reasoning Structures
SELF-DISCOVER가 만든 reasoning structure의 범용성 검증
PaLM 2-L의 추론구조를 GPT-4에 적용
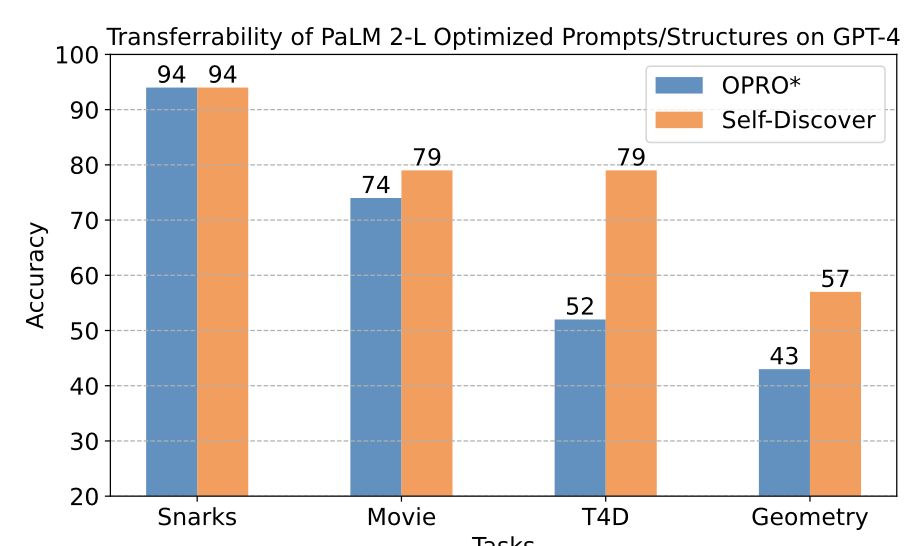
실제 데이터를 사용해 최적화하였음에도, 3/4작업에서 SELF-DISCOVER성능이 우수
강한 모델이 reasoning structure을 만들어 약한 모델에 적용할 수 있는가?
GPT-4를 사용해 추론 구조를 발견한 다음, Llama2-70B, GPT-3.5 turbo에 적용
disambiguation QA zero-shot task에서
- Llama2: CoT(42%) 대비 SELF-DISCOVER 구조 적용 시 52%로 성능 향상
geometry task에서
- GPT-3.5-turbo: CoT(51%) 대비 56%로 성능이 향상
느낀점
논문을 읽으며 이런 생각이 들었습니다.
“이렇게 효율적이고 성능이 좋은 방법이면 지금쯤 당연히 널리 쓰이고 있지 않을까?”
그래서 실제로 찾아봤는데, 생각보다 SELF-DISCOVER가
직접적으로 상용 서비스에 널리 적용된 사례는 많지 않았습니다.
왜 그럴까 생각해보니, 논문 실험 환경과 실제 서비스 환경은 많이 다르다는 점이 떠올랐습니다.
실제 AI 서비스는 단순히 몇 개의 benchmark 문제를 푸는 것이 아니라,
- 수백, 수천 가지의 다양한 task를 처리해야 하고
- 정확성뿐 아니라
- 안정성
- latency
- inference cost
- 예측 가능성
같은 현실적인 요소들도 함께 고려해야 합니다.
그래서 SELF-DISCOVER 구조 자체가 그대로 상용화되진 않았을 수 있다고 생각했습니다.
하지만 흥미로웠던 건, 이 논문의 핵심 철학인
“문제에 맞는 reasoning structure를 동적으로 만들자”
라는 아이디어는 이미 agent 시스템에서 다양한 형태로 활용되고 있다는 점입니다.
최근 agent들은 task에 따라 planning을 만들고, tool을 선택하고, workflow를 구성하는데, 결국 비슷한 철학을 가지고 있다고 느꼈습니다.
그래서 이 논문이 단순히 SELF-DISCOVER라는 특정 구조 하나를 제안하는 데 의미가 있다기보다,
LLM이 문제를 더 잘 해결하기 위해 어떤 사고 구조를 가져야 하는가라는 더 본질적인 질문을 던진 논문이라고 느꼈습니다.
앞으로 SELF-DISCOVER보다 더 효율적이고, 더 실용적인 reasoning 구조가 등장할 수도 있겠지만,
이 논문은 그 방향성을 먼저 보여준 의미 있는 연구라고 생각했습니다.
