들어가며
이번주 AI교육 7주차에는 Langchain에 대해 배웠다. 이에 실습으로 Langchain 활용 및 FAISS vetor db 등을 활용하여 pdf문서를 기반으로 질의응답을 하는 시스템을 만들어봤다. 이에 대한 코드와 내가 langchain에 대해 이해한 바를 정리하려고 함
LangChain이란
랭체인은 대형 언어 모델 (LLM, ex:GPT) 을 활용하여 실제 서비스에 사용할 수 있는 AI 어플리케이션을 만들기 위한 프레임워크이다.
즉, LLM 앱을 만들 때 필요한 부품 (프롬프트/체인/리트리버/툴 호출 등)을 표준화된 인터페이스로 제공하고, 쉽게 이어 붙이게 지원하는 "프레임워크"로, 구현해야 할 양을 크게 줄이고 조립을 쉽게 해준다는 특징을 갖고있다.
Langchain 사용을 위한 사전 준비
Langchain에서는 ChatOpenAI, OpenAIEmbeddings 등을 사용할 경우, 내부적으로 OpenAI SDK를 사용한다.
이때,
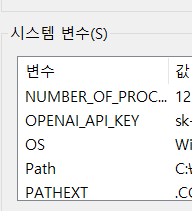
langchain은 내부적으로 openai.OPENAI()를 생성하고, 기본적으로 os.environ.get(”OPENAI_API_KEY”)를 찾도록 설계되어있다.
따라서, 시스템 환경변수에 OPENAI_API_KEY로 환경변수를 만들어두면 (os.environ[”OPENAI_API_KEY”]) langchain으로 openAI를 사용할때 따로 api_key를 코드에서 할당하지 않더라도 자동으로 langchain이 찾아와서 등록한다.
즉, 본래라면
@st.cache_resource
def get_openai_client():
    api_key = os.getenv("OPENAI_API_KEY")
    if not api_key:
        st.error("OPENAI_API_KEY가 설정되지 않았습니다.")
        return None
    return OpenAI(api_key=api_key)
이런식으로 불러왔었는데,
langchain을 사용하면, 환경변수만 설정해놓으면 직접 api_key를 불러올 필요없이 자동으로 읽어오기에,
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(model_name="gpt-4o-mini", temperature=0, max_tokens = 1024)
이렇게 간단히 llm을 만들 수 있다.
Langchain 주요 구성 요소
문서 로딩 (Document Loader)
Document Loader는 다양한 파일의 형식으로부터 불러온 내용을 문서 객체로 변환하는 기능을 제공한다.
주요 Loader로는 PyPDFLoader(PDF), CSVLoader(CSV), JSONLoader(JSON) 등이 있다.
from langchain.document_loaders import PyPDFLoader나는 PDF 파일을 사용하여 실습을 진행할 것이었기에, PyPDFLoader를 import해와서 사용하였다.
FILE_PATH = "현안과과제_주요국 경제 및 주요 가격지표 전망과 시사점_240115.pdf"
loader = PyPDFLoader(FILE_PATH)

docs = loader.load()
len(docs)
위와 같이, 로드할 pdf의 경로를 적어주고 이를 PyPDFLoader에 넘겨준 후 load하면 PDF 파일을 Langchain의 Document 객체 리스트(List[Document]) 형태로 변환해준다.
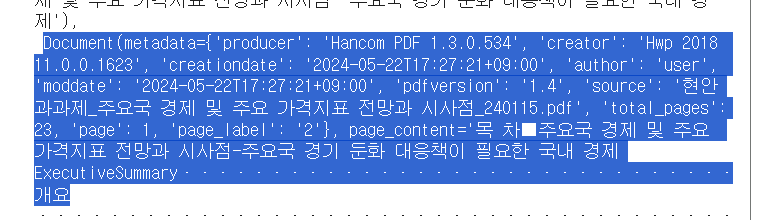
객체 리스트 (docs) 에는 위와 같이 각 페이지별로 page_content와 metadata를 포함한 정보들이 들어있다.
이를 활용하여 청킹, 임베딩, 검색 단계 등에서 활용 가능하다.
텍스트 분할 (Text Splitter)
텍스트 분할은 긴 문서를 작은 chunk로 분할해주는 것을 말한다.
대표적으로 RecursiveCharacterTextSplitter 가 있으며, 이 텍스트 분할기는 일반적인 텍스트에 권장되는 방식이다.
해당 분할기는 매개변수로 "문자 목록"을 받으며, 청크가 쪼개질 수 없을때까지 문자 목록의 순서대로 텍스트를 분할한다.
"단락 -> 문장 -> 단어" 순서로 재귀적 분할을 시도하며, 이유는 의미적으로 강하게 연관된 텍스트 조각으로 나눔으로써 가능한 함께 묶으려는 의도이다.
from langchain.text_splitter import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(chunk_size=200, chunk_overlap=0)

chunks = loader.load_and_split(splitter)

print(f"문서의 길이: {len(chunks)}")
위와 같이 chunk_size로 청크의 크기를 제한하고,
chunk_overlap으로 인접한 청크 간 문자 중첩을 허용하는 (문맥 유지를 위함) 텍스트 분할기를 만들고,
load_and_split에 만든 텍스트분할기(splitter)를 사용하여 문서를 분할하고 반환한다.
이때 반환되는 결과 또한 List[Document] 형태이다.
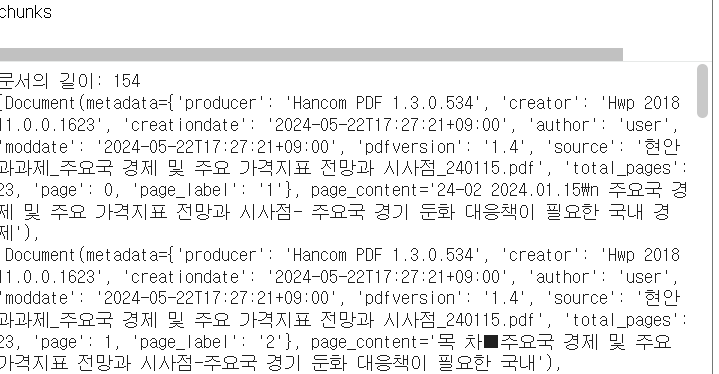
(**참고로 overlap과 chunk_size는 검색품질을 결정하는 중요요소이다)
임베딩 생성 (Embedding Model)
문서 임베딩은 이전에도 정리해뒀지만, 문서의 내용을 수치적인 벡터로 변환하는 과정이다.
이를 통해 LLM의 자연어 처리 작업에 활용할 수 있다.
from langchain_openai import OpenAIEmbeddings

embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
나는 OpenAIEmbeddings를 사용했다.
참고로 Langchain은 OpenAI, HuggingFace, Cohere 등 다양한 Embedding을 지원한다고 한다.
원래라면,
texts = [doc.page_content for doc in chunks]
vectors = embeddings.embed_documents(texts)
이런식으로 chunks를 돌면서, 각 텍스트를 임베딩하는 방식이 있지만,
langchain의 FAISS는 from_documents() 메서드를 제공하며, 이에 문서리스트와 임베딩 모델만 전달하면 내부적으로 임베딩을 진행함과 동시에 벡터 인덱스 (벡터db) 를 자동으로 생성하기에, 나는 FAISS.from_documents()를 사용했다.
# FAISS 벡터 저장소 생성

# dimension = 1536 # text-embedding-3-small 차원

# db = FAISS(
#     embedding_function=embeddings,
#     index=faiss.IndexFlatL2(dimension),
#     docstore=InMemoryDocstore(),
#     index_to_docstore_id={},
# )

# 문서추가된 벡터 저장소
vec_db = FAISS.from_documents(documents=chunks, embedding=embeddings)

#############################################

# 생성된 벡터 저장소 확인
print(vec_db)

# 저장된 문서의 인덱스-ID 매핑 확인s
print(f"총 저장된 문서 수: {len(vec_db.index_to_docstore_id)}")
FAISS도 FAISS()로 직접 생성 방식을 하면, 임베딩 모델을 넣고, 이후 임베딩된 벡터 또한 따로 추가해야하는 번거로움이 존재한다.
즉 FAISS() 방식은 “빈 FAISS 컨테이너를 직접 만드는 것”인데, 따라서 벡터 차원 계산, FAISS index 객체 생성, docstore 준비, index와 docstore 매핑 구조 생성 후 add_documents까지 호출해줘야한다.
따라서 이 방식은 세밀한 커스터마이징이필요할때 사용하면 되는 것이라 나는 from_documents를 사용했다.
vec_db = FAISS.from_documents(documents=chunks, embedding=embeddings)from_documents를 사용하는 경우, 해당 함수는 내부적으로
- 임베딩 생성
- dimension 계산
- FAISS index 생성
- docstore 연결
자동으로 진행하기에 dimension을 따로 생성해서 넣을 필요도, 임베딩 벡터를 따로 만들 필요도 없다. !!!!
검색 (Retriever)
retreiver는 질문을 받아 관련 문서를 찾아주는 객체로,
다음과 같이 벡터 DB를 검색 가능한 형태로 변환할 수 있다.
retriever = vec_db.as_retriever(search_kwargs={"k": 3})retriever내부에서는
사용자 질문 입력 시 embed_query로 질문 벡터 생성, FAISS similarity search로 가장 가까운 벡터 k개 찾기, index_to_docstore_id 매핑으로 원본 Document 반환이 일어난다.
즉, retriever는 vec_db.similarity_search(query, k=3) 를 단순히 래핑한 객체라고 생각하면 된다.
## FAISS db에서 문서 검색
question_vecter_db_search_output = vec_db.similarity_search("미국 실물경제에 대해서 알려줘", k=2)
나는 실습에서는 이런식으로 retriever가 아닌 similarity_search 함수를 사용했으며 해당 함수는 자연어와 개수를 넘겨주면, 자연어를 자동으로 질문벡터로 생성하고 벡터db에서 유사한 k개의 문장을 골라온다.
이게 가능한 이유는 vec_db를 만들때 애초에 임베딩 담당 embeddings 객체를 할당해줘서 내부적으로 존재하기 때문이다!
이때 retriever를 사용하냐 아니면 직접 similarity_search를 사용하냐는 LCEL 체인을 사용할거냐 말거냐에 달렸다.
from langchain_core.runnables import RunnablePassthrough
from langchain_community.vectorstores import FAISS

# Retriever 생성 (벡터 DB에서 관련 문서 검색)
retriever = vector_store.as_retriever(search_kwargs={'k': 3})

# Prompt Template
template = ChatPromptTemplate.from_messages([
    ('system', '당신은 문서 기반 QA 어시스턴트입니다.'),
    ('system', 'context:\n{context}'),
    ('human', '{question}')
])

# Chain 구성
data = {
    "question": RunnablePassthrough(),  # 질문 그대로 전달
    "context": retriever                 # retriever가 관련 문서 검색
}

chain = data | template | llm | StrOutputParser()

# 질문만 입력하면 자동으로 관련 문서 검색 후 답변 생성
answer = chain.invoke("AI 기술의 미래는?")
참고로 retriever를 사용할것이라면 위와 같이 사용할 수 있다.
프롬프트 템플릿 (Prompt Template)
from langchain_core.prompts import ChatPromptTemplate

template = ChatPromptTemplate.from_messages([
    ("system", "당신은 직업훈련 관련 답변을 전문적으로 하는 봇입니다."),
    ("system", "아래 content 정보를 이용해서 답변을 해주세요."),
    ("system", "context:\n{context}"),
    ("human", "{question}")
])
프롬프트 템플릿은, 프롬프트를 구조화하여 관리하고, 변수를 삽입할 수 있다.
또한, system과 human 메시지를 분리할 수 있다는 특징이 있다.
이에 재사용성과 유지보수성이 향상된다.
LCEL 체인 구성 또는 템플릿 수동 구성
LangChain Expression Language(LCEL)을 활용하여 프롬프트와 LLM을 체인 형태로 연결할 수 있다.
question = "미국 실물 경제에 대해서 알려줘"

chain = template | llm | StrOutputParser()

llm_output_lcel = chain.invoke({
    "context": question_vecter_db_search_output,
    "question": question
})
위처럼 LCEL을 활용하면, 만들어둔 template prompt와 llm, parser를 자동으로 연결하여 사용할 수 있다.
이 방식에서는 invoke 호출에 dict만 주어지면 체인이 알아서 template으로 messages를 생성하고 llm 호출, parser로 문자열 반환을 한다.
반면,
수동으로 프롬프트를 먼저 만드는 방식으로는 format_messages를 활용할 수 있다.
question = "미국 실물 경제에 대해서 알려줘"

## ChatPromptTemplate을 사용한 message 부분 프롬프팅 및 LLM 답변 생성

messages = template.format_messages(
    context = question_vecter_db_search_output,
    question = question
)

llm_output = llm.invoke(messages).content
위와 같이 messages를 미리 만들어두고 LLM에 직접 넣어서 결과를 얻어오는 방법이다.
이는 프롬프트 생성이 코드에 명시적으로 드러나고 messages 를 출력가능해서 디버깅이 쉽다는 특징이 있다.
두 코드 결과적으로는 {context, question} 값을 템플릿에 주입하고 LLM을 호출한다는 점은 동일하다.
다만 LCEL 방식은 단계가 늘어나도 | 로 조립하듯 확장 가능하다는 특징이 장점이므로 확장성과 깔끔함을 필요로 한다면 LCEL을 사용하면 된다
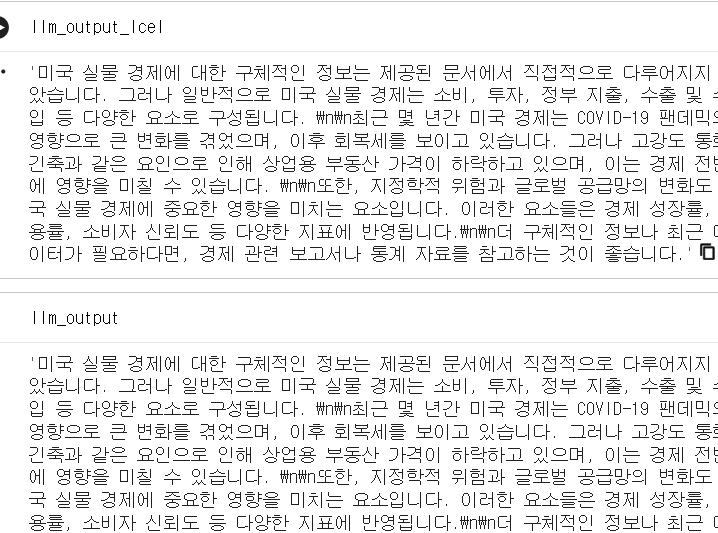
출력해봤을때의 결과물은 동일했다.
결론
용어를 살짝 들어만봤던 Langchain에 대해 학습해봤다. 신기한 것도 많고 헷갈리는 것도 많고, 종류도 워낙 다양해서,, 다 정리할수도 머릿속에 집어넣을 수도 없지만, 이러한 개념이라는 잘 잡아두면 될 거 같다 !!