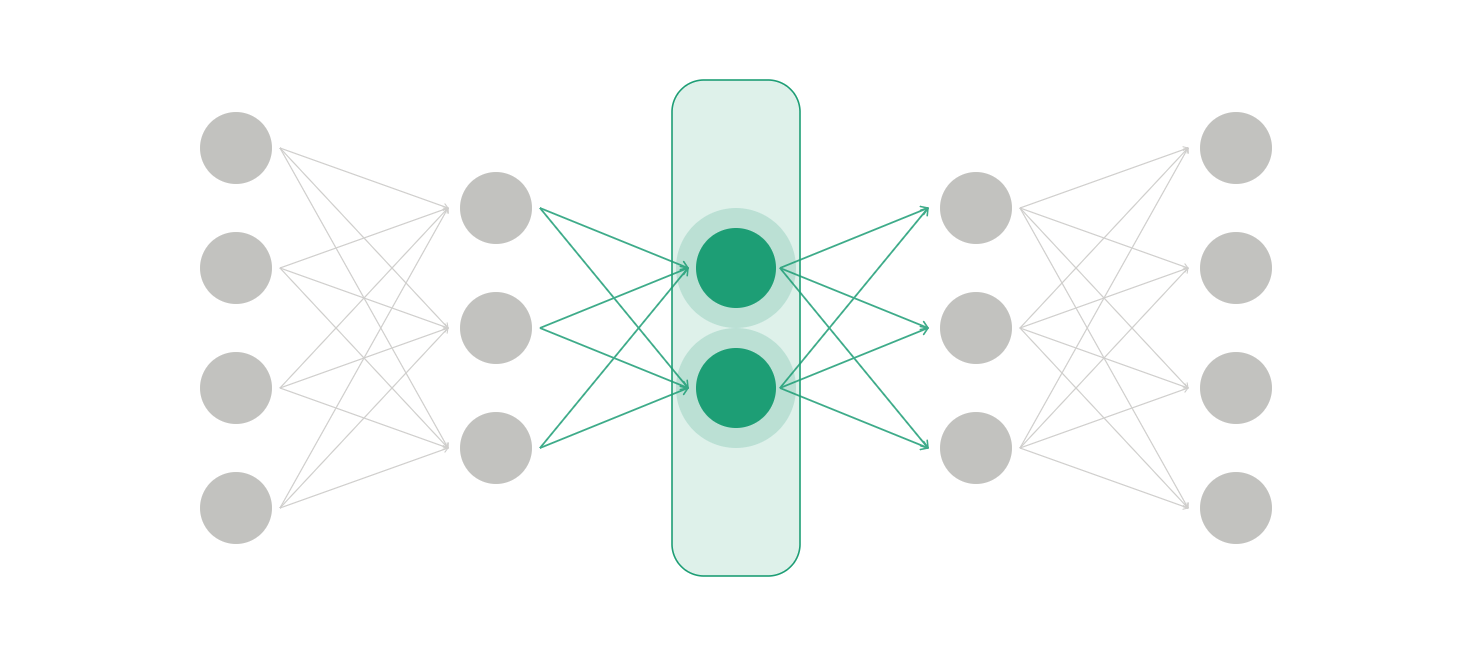
1. encoder와 decoder
encoder는 입력 벡터를 잠재 표현(latent representation)으로 만드는 신경망을 의미합니다.
반면 decoder는 잠재표현으로부터 입력을 복원시키는 신경망을 의미합니다.
Autoencoder는 encoder와 decoder가 잠재 표현이 담긴 병목층으로 연결되어 있는 신경망을 의미합니다.
2. Autoencoder
autoencoder는 입력 데이터를 다시 원래 형태로 복원하도록 학습합니다.
이 과정에서 입력 벡터의 차원을 축소시킬 때 사용할 수 있습니다.
일반적인 차원축소 알고리즘인 PCA와 달리 층에 비선형 함수를 활용하기 때문에 비선형적인 특징까지 고려하여 차원축소가 가능합니다.
autoencoder는 크게 encoder, 병목층, decoder 이렇게 세가지로 나뉩니다.
encoder에서는 입력에서 중요한 특징을 크기가 작은 병목층으로 옯깁니다.
그리고 decoder는 이렇게 만들어진 병목층을 이용해서 원래 입력을 복원시킵니다.
복원된 가 원래 입력 와 유사하다면
잠재 벡터 가 입력을 복원하는 데 필요한 정보를 잘 담고 있다고 볼 수 있습니다.
따라서 병목층에 존재하는 잠재 벡터 를 입력의 차원이 축소된 표현으로 사용할 수 있습니다.
3. autoencoder의 오차함수
autoencoder는 입력값 외에 정답이 추가로 필요하지 않습니다.
정답 없이 출력값과 입력값의 차이를 평가하기 때문에 비지도 학습입니다.
history = autoencoder.fit(
    x_train,
    x_train,                       # 정답은 입력
    epochs=20,
    batch_size=256,
    shuffle=True,
    validation_data=(x_test, x_test)
)
실제 구현에서도 정답 위치에 입력데이터를 넣어서 모델을 학습시킵니다.
정규화를 하지 않은 autoencoder의 오차함수는 MSE 또는 binary cross entropy(0~1값으로 정규화)로 정의할 수 있습니다.
4. 정규화
1) 가중치 정규화
다른 신경망 알고리즘과 마찬가지로 과적합을 예방하기 위해 가중치 값으로 오차함수에 패널티를 부여합니다.
는 가중치 크기가 패널티에 미치는 영향을 조절합니다.
2) 희소성 정규화(sparsity regularization)
지금까지 정의한 오차함수는 병목층의 모습을 고려하지 않습니다.
하지만 복원된 오차가 적더라도 병목층이 중복된 정보를 가지는 문제가 발생할 수 있습니다.
병목층의 크기가 입력층보다 크다면 차원축소의 목적에 위반됩니다.
이를 방지하기 위해 입력을 복원하는데에 필요하지 않은 뉴런을 제한시키는 것을 희소성 정규화라고 합니다.
희소성 정규화에서는 각 뉴런의 목표 활성화 정도를
실제 활성화 정도를 라고 정의합니다.
여기서 는 번째 입력에 대한 병목층의 번째 뉴런의 활성화 값입니다.
목표 활성화 정도와 실제 활성화 정도의 차이는 KL 발산을 이용하여 계산할 수 있습니다.
여기서 는 희소성 정규화의 강도를 조절하는 값이고
은 병목층 뉴런의 개수입니다.
가 목표값 와 같으면 페널티가 작아지고 두 값의 차이가 커질수록 페널티도 커집니다.
따라서 가중치 정규화와 희소성 정규화를 모두 적용한 autoencoder의 전체 오차함수는 다음과 같습니다.
이처럼 희소성 정규화를 적용하면 병목층의 크기가 입력층보다 크거나 같더라도 일부 뉴런만 선택적으로 활성화하도록 합니다.
