AI 스터디
1.python을 이용한 단일 신경망 구현 (1)
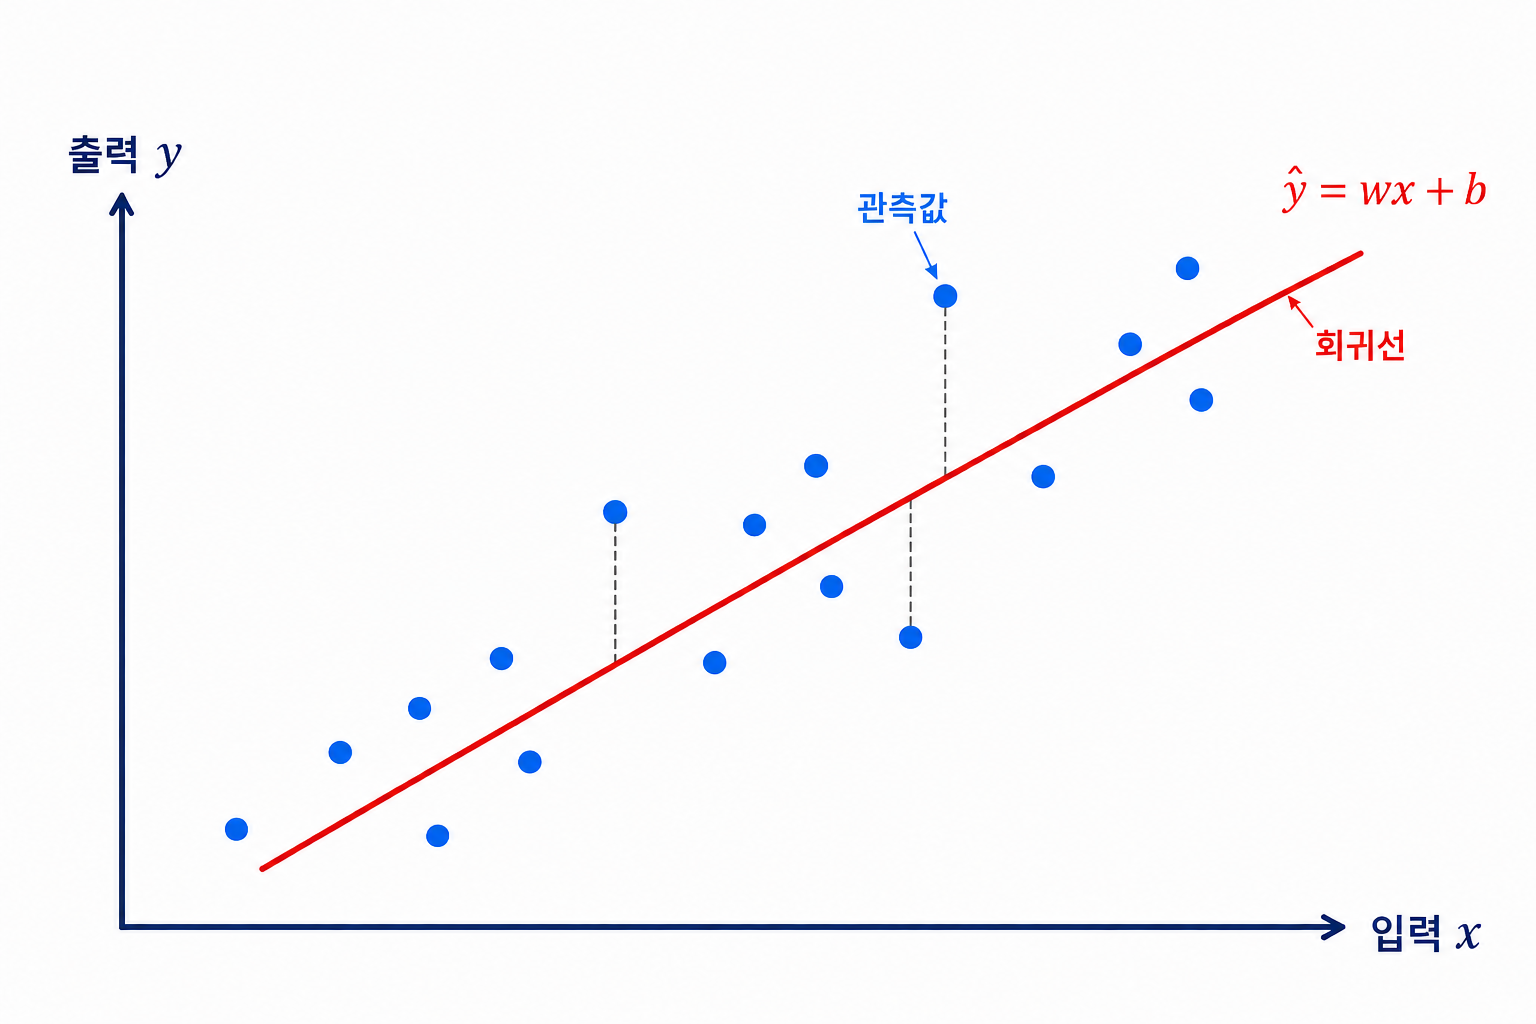
딥러닝을 배우기 위해서 최소 단위인 단일 신경망 구현에 대해서 배워보겠습니다.회귀는 실수 값을 예측하는 것을 의미합니다.가장 간단한 회귀로는 선형 회귀가 있습니다.다음 그림처럼 주어진 데이터에 대해서 적절한 실수 값을 내놓는 모델 즉, w(weight), b(bias)
2.python을 이용한 단일 신경망 구현 (2)
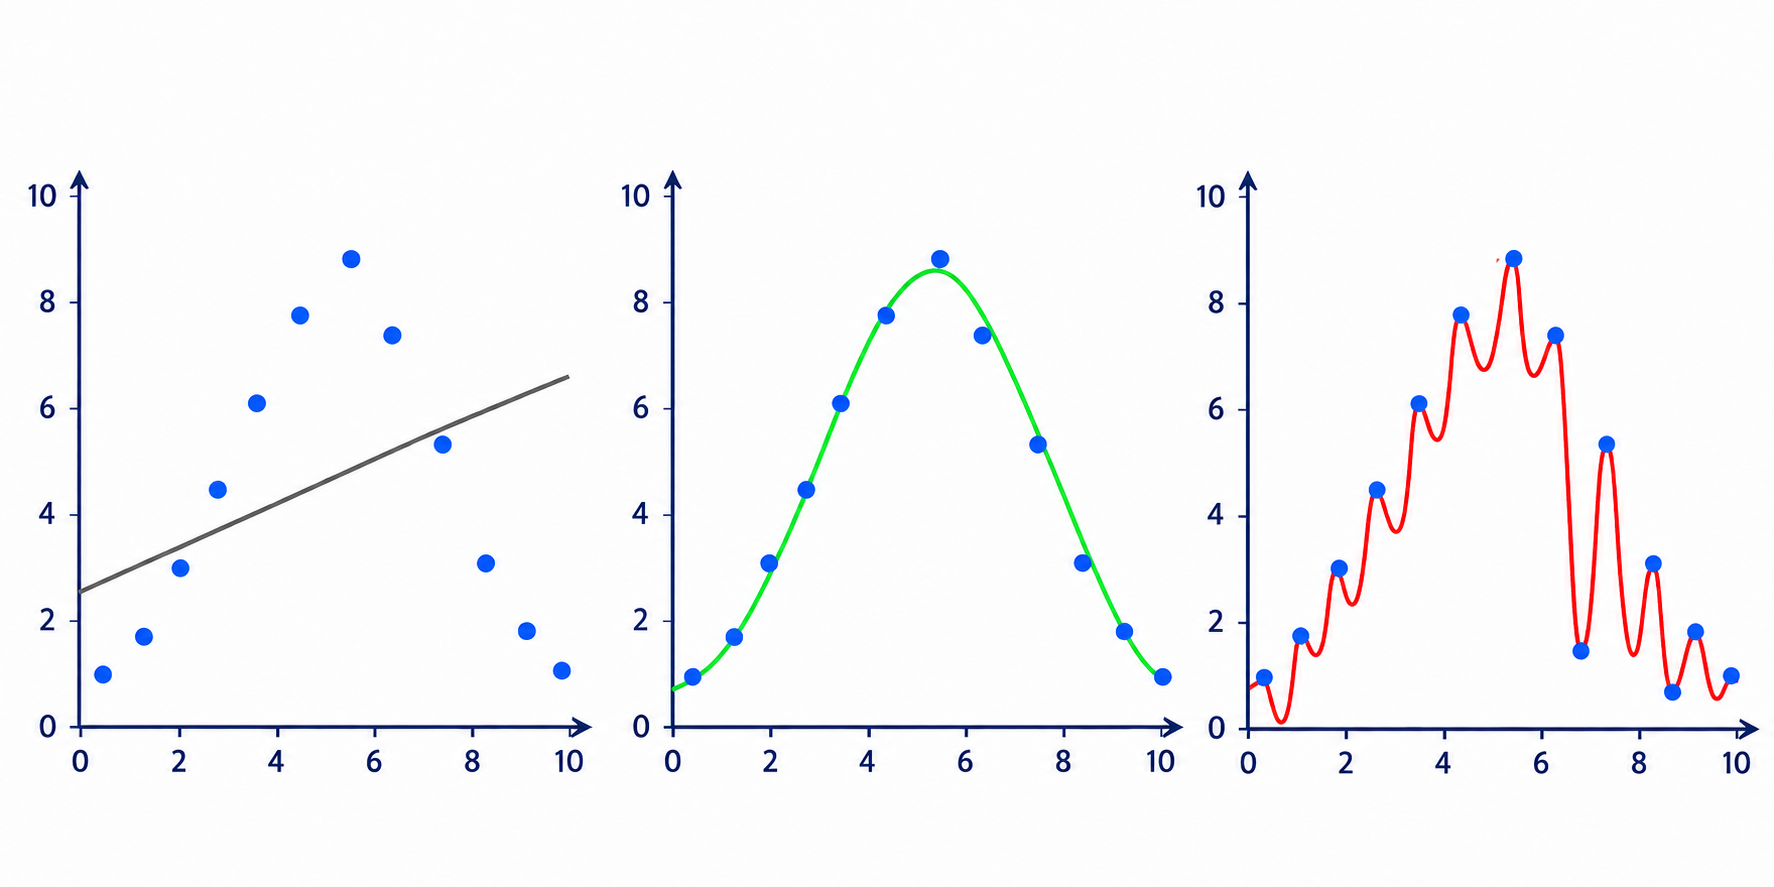
모델이 훈련 데이터에 지나치게 맞춰지면 새로운 데이터를 정확하게 예측하지 못할 수 있습니다. 이러한 현상을 과대적합(overfitting)이라고 합니다.(왼쪽부터 과소적합, 적절한 학습, 과대적합)과대적합을 줄이기 위해 오차 함수에 가중치의 크기에 대한 페널티를 추가하
3.python을 이용한 단일 신경망 구현 (3)
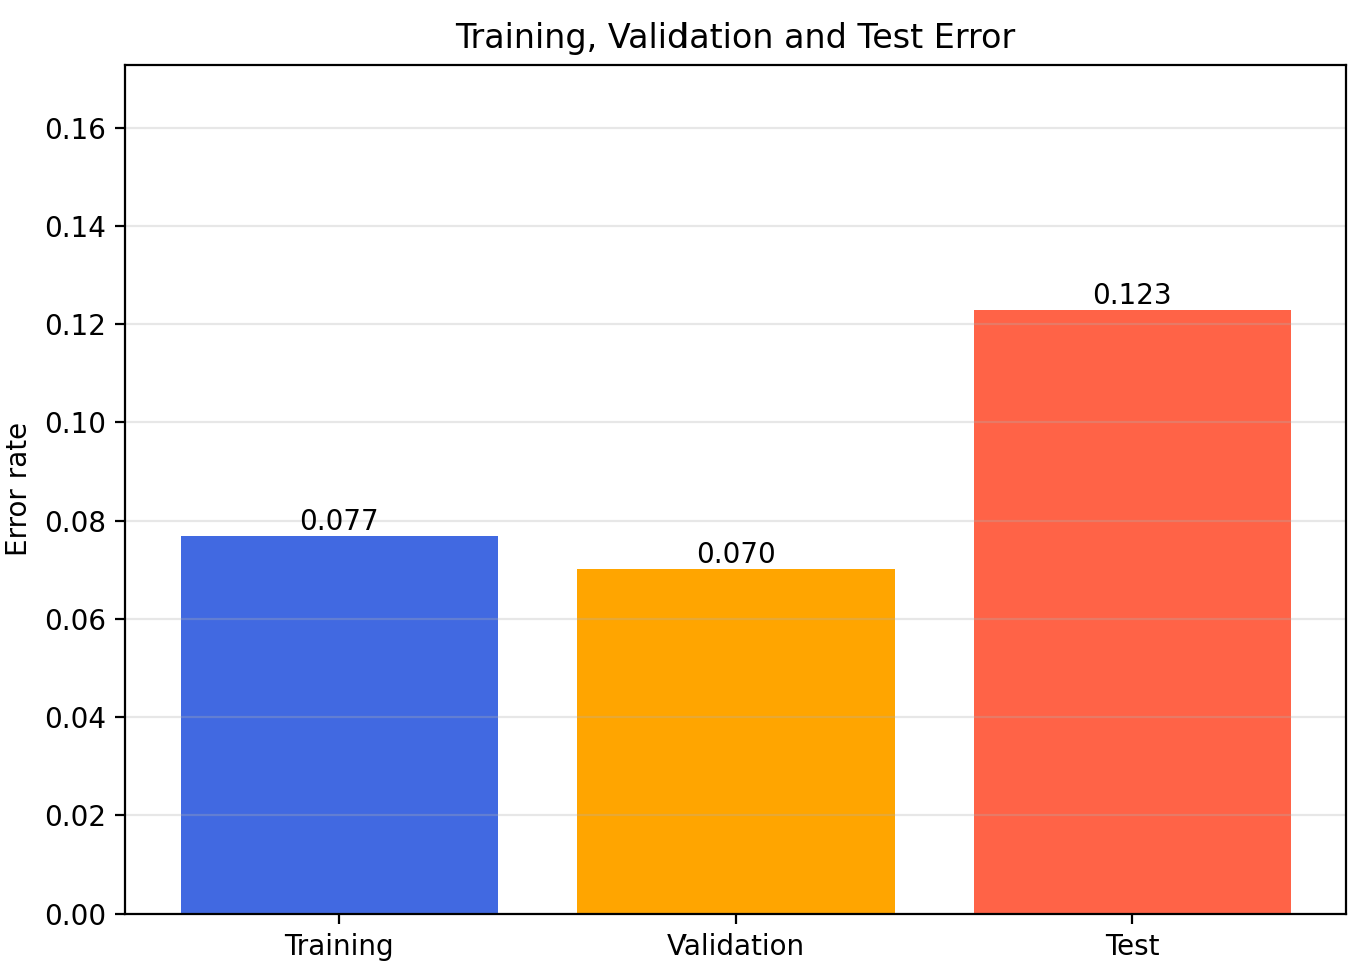
이제는 실제로 구현한 다음 데이터 셋으로 훈련시키고 결과를 확인해 봅시다. 1. 변수 초기화 2. 순전파 np는 수치 계산 라이브러리인 numpy를 불러올 때 사용하는 이름입니다. np.dot(x, self.w)는 입력값 $x$와 가중치 $w$의 행렬곱을 계산합니
4.Tensorflow와 Keras를 이용한 딥러닝 구현(1)
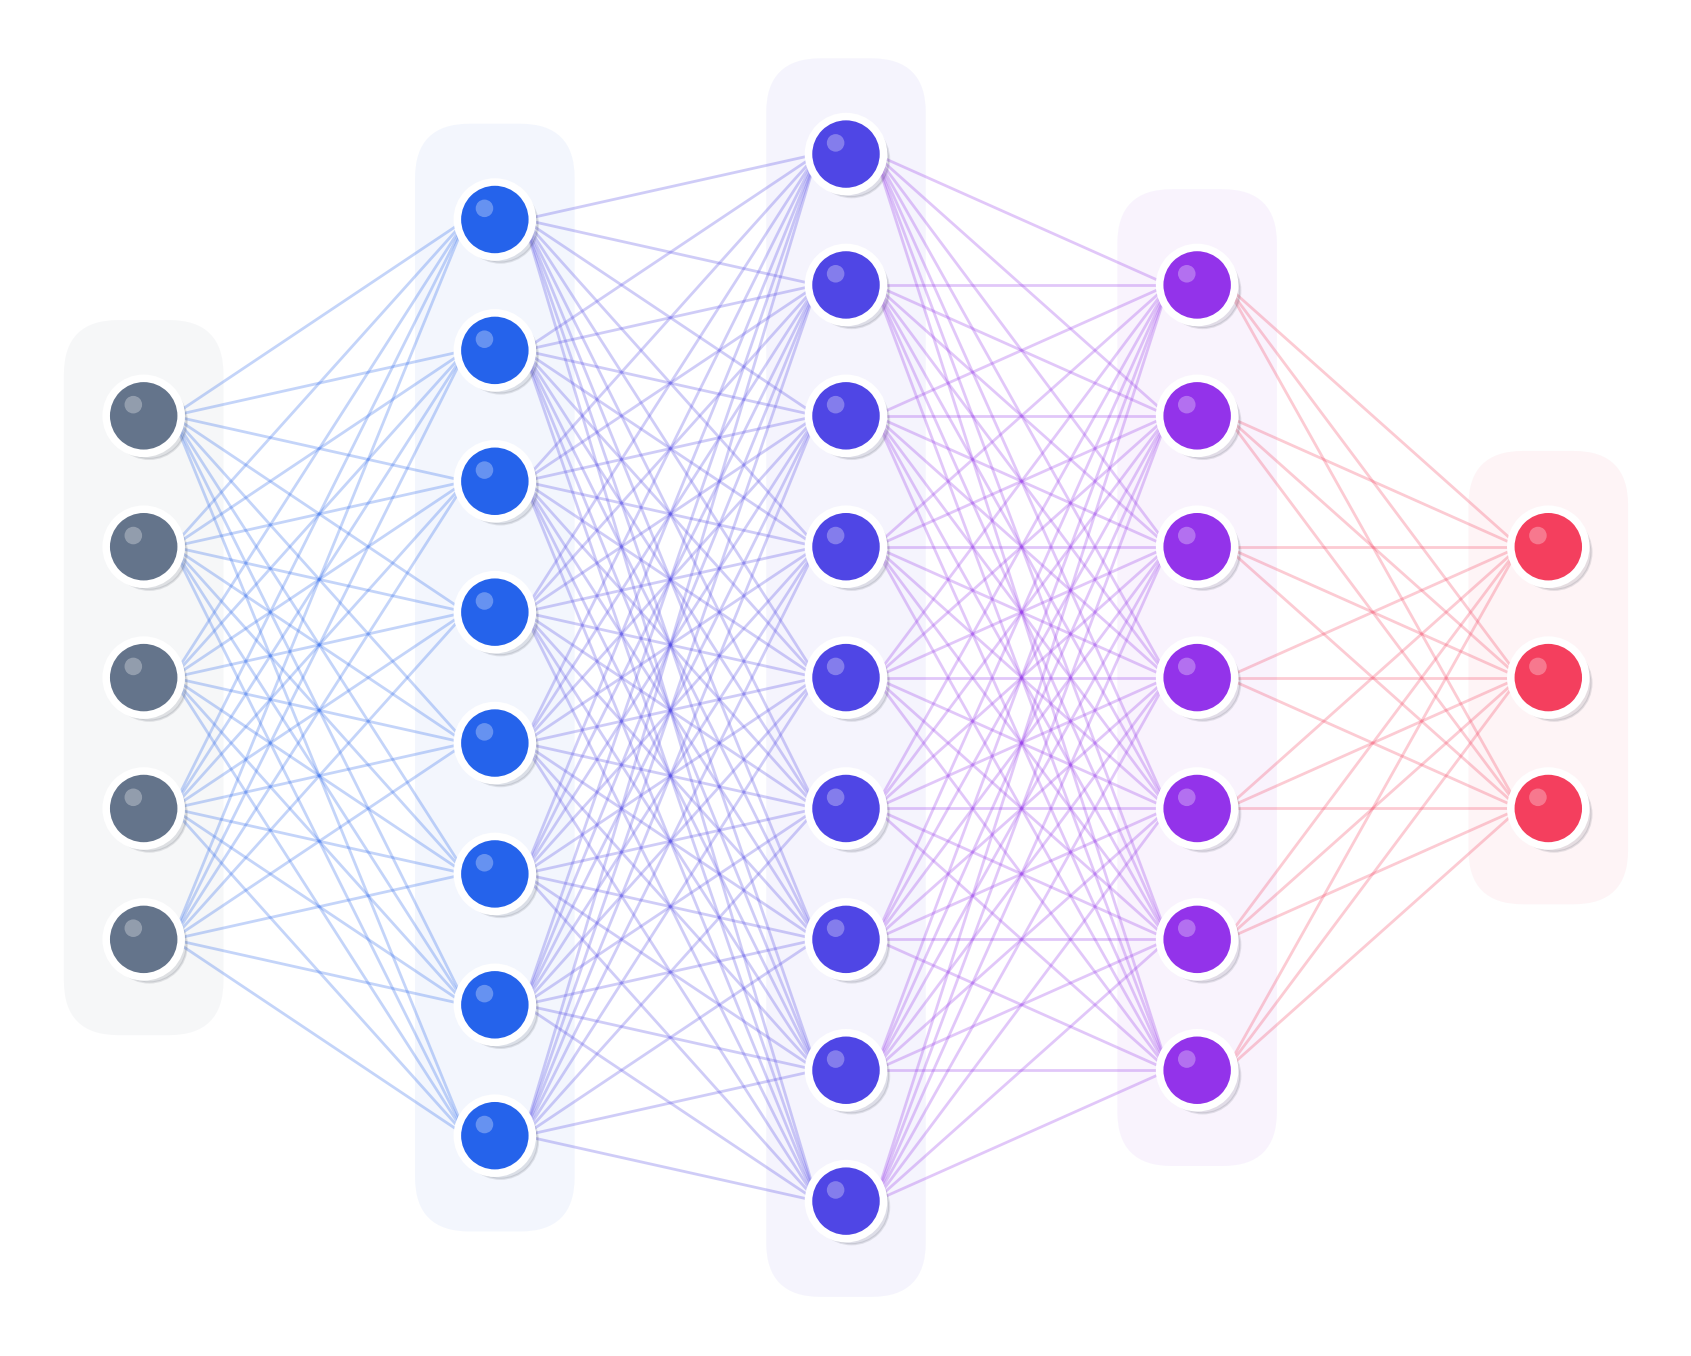
앞서 구현한 단일층 신경망은 입력과 출력 사이의 관계가 단순한 선형 문제에서는 효과적이지만실제 데이터에서 나타나는 선형으로 구분할 수 없는 복잡한 패턴은 학습하기 어렵습니다.딥러닝은 이러한 한계를 극복하기 위해 여러 개의 은닉층을 사용합니다. 각 층은 이전 층에서 전달
5.Tensorflow와 Keras를 이용한 딥러닝 구현(2)
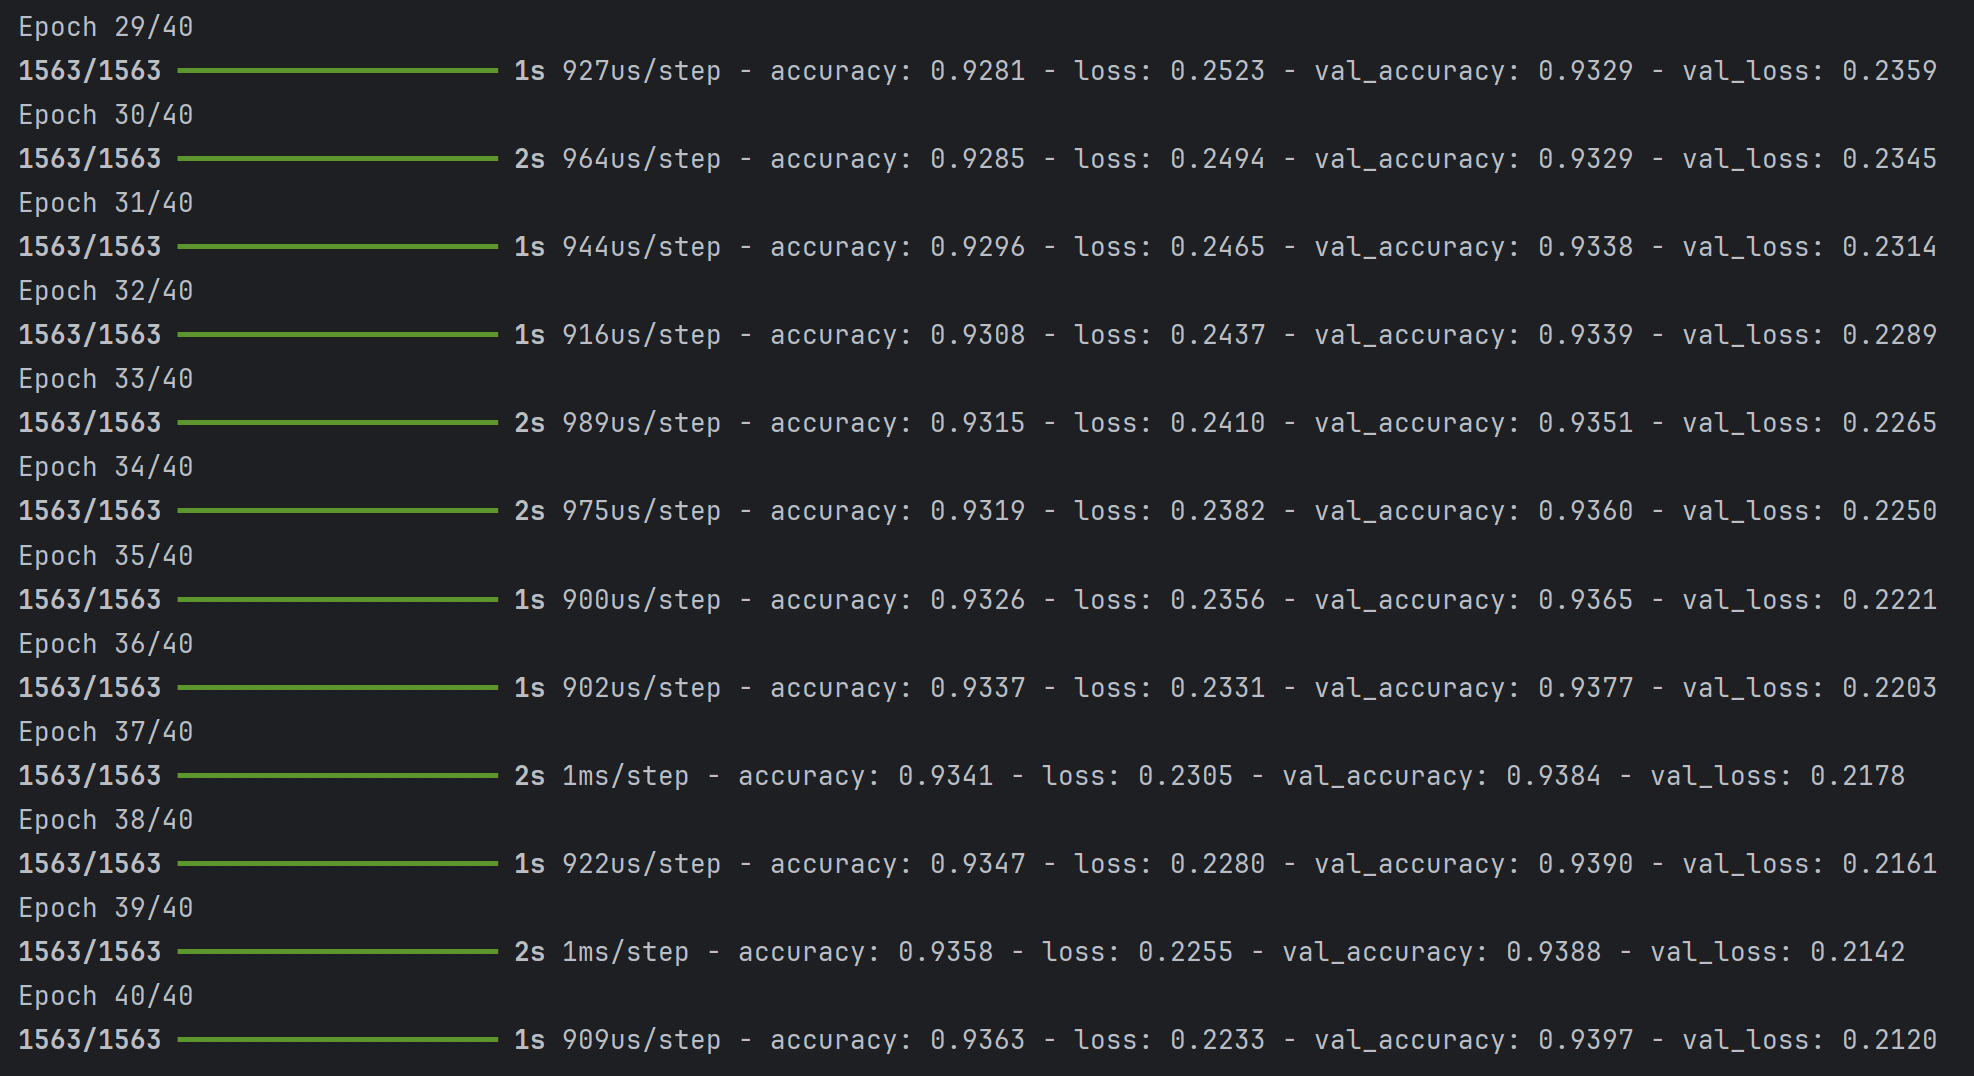
다음과 같이 에포크별 accuracy, loss값을 확인할 수 있고마지막에 pyplot으로 그려진 그래프 확인할 수 있습니다.다음과 같이 바꾸면accuracy 그래프까지 확인할 수 있습니다.
6.CNN과 RNN(1)
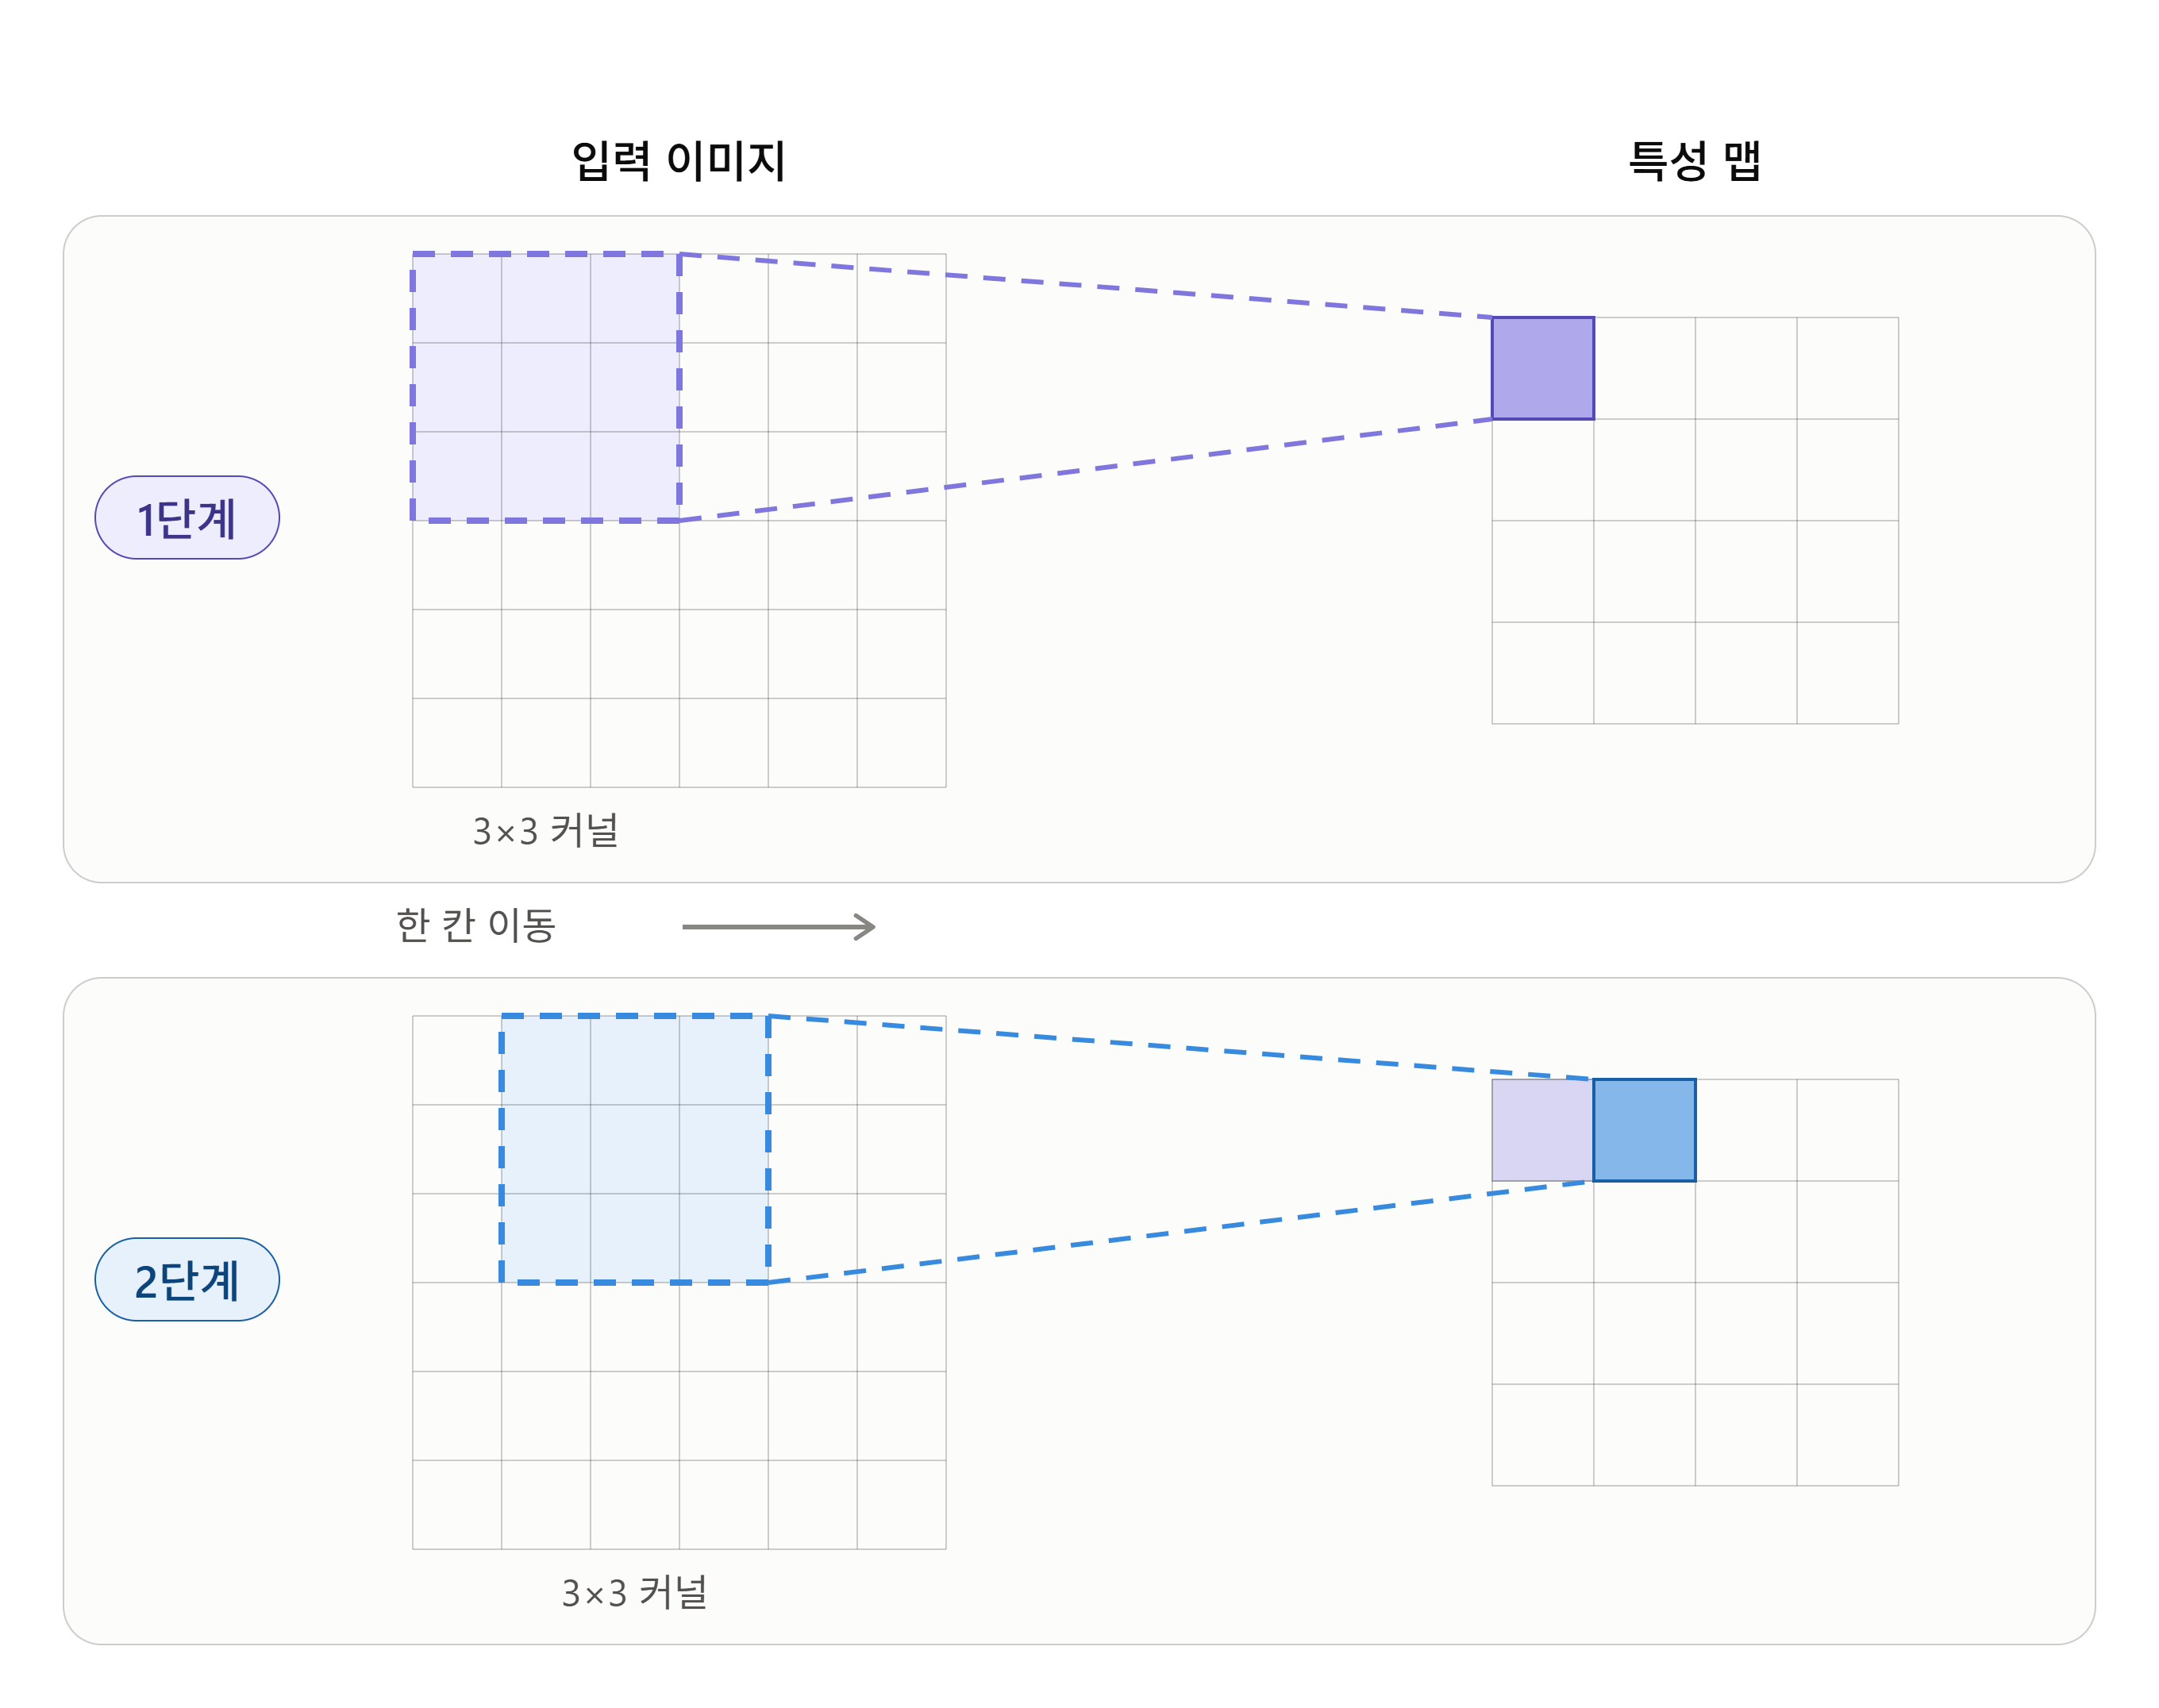
이미지 데이터를 딥러닝 모델에 입력하는 가장 간단한 방법은 픽셀별로 하나씩 전부 입력하는 것일 겁니다.하지만 이미지 크기가 100 \* 100 픽셀만 되어도 너무 많은 입력을 넣어야 하고 또 그에 따라 많은 가중치 연산을 해야하기 때문에시간도 오래 걸릴 뿐만 아니라 메
7.CNN과 RNN(2)
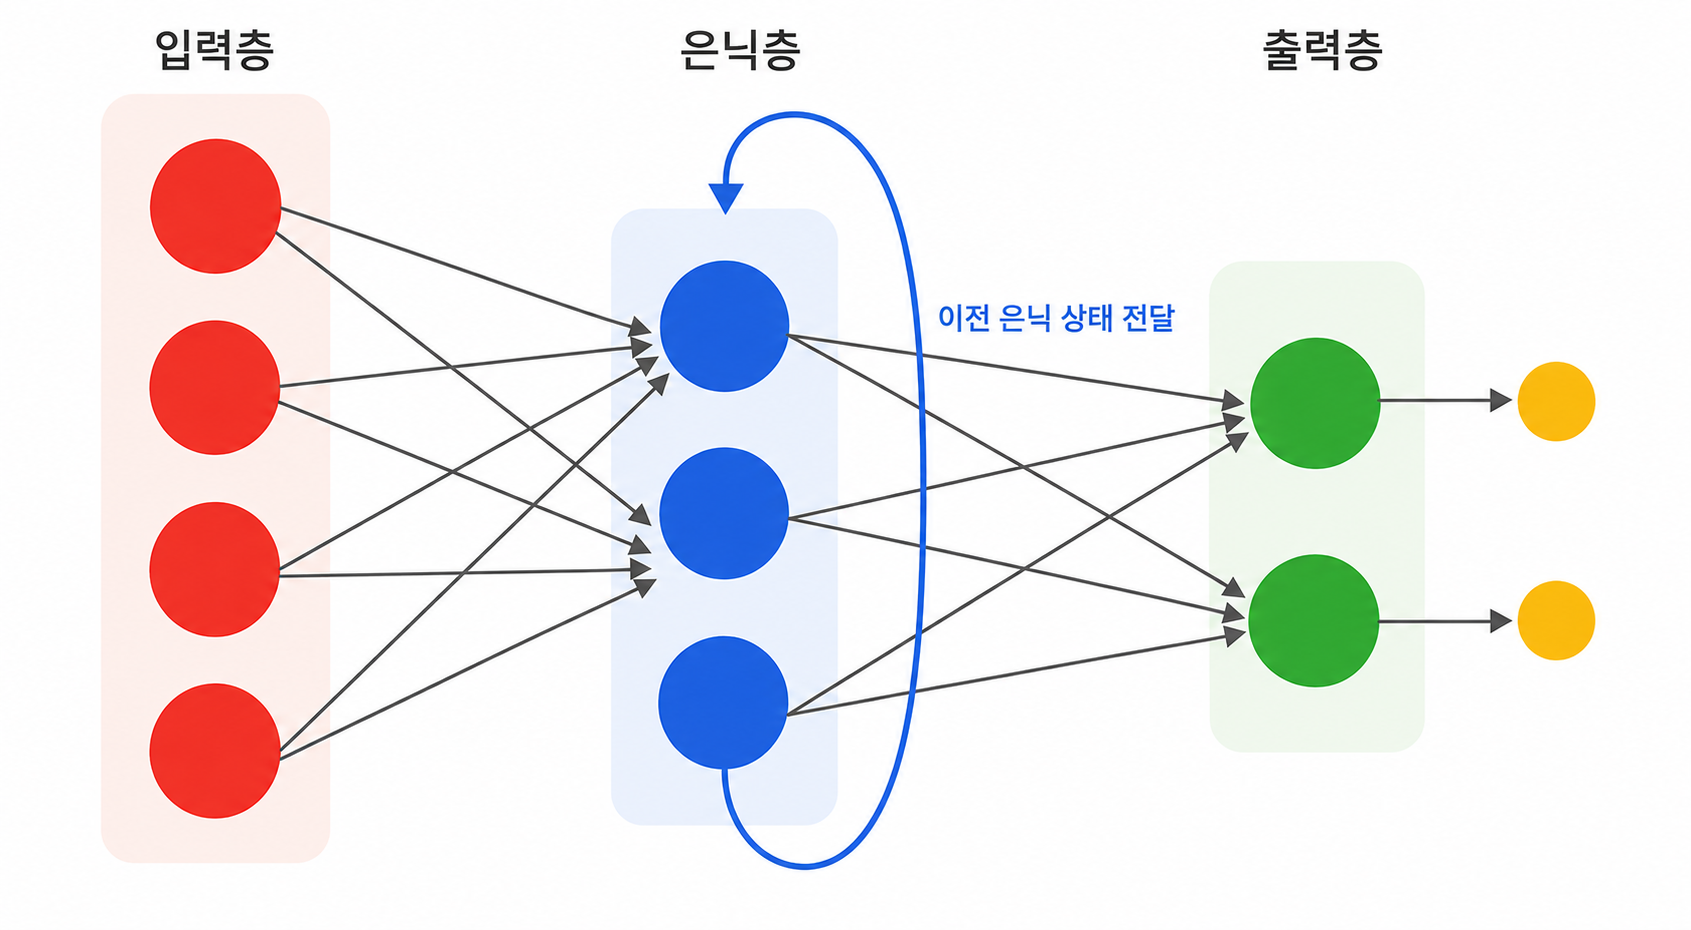
문장, 음성, 주가 등 시간에 따른 순차적 특성이 중요한 데이터를 시계열 데이터라고 합니다.일반적인 신경망은 이 입력을 독립적으로 다룹니다.하지만 “나는 밥을 먹었다”와 “밥이 나를 먹었다”는 같은 단어로 구성되어 있지만, 순서에 따라 의미가 완전히 달라집니다.이처럼
8.Autoencoder (1)
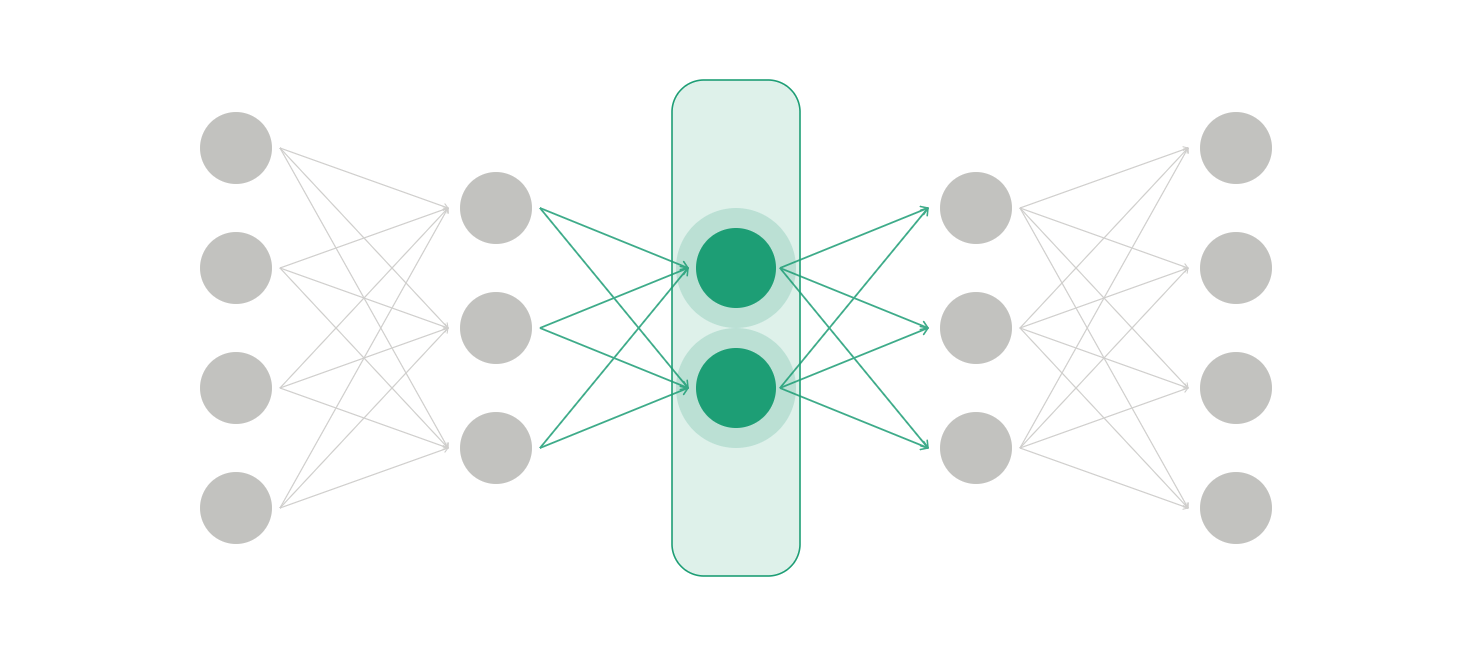
1. encoder와 decoder 2. autoencoder 3. autoencoder의 오차함수 4. 정규화 1) 가중치 정규화 2) 희소성 정규화
9.VAE (1)
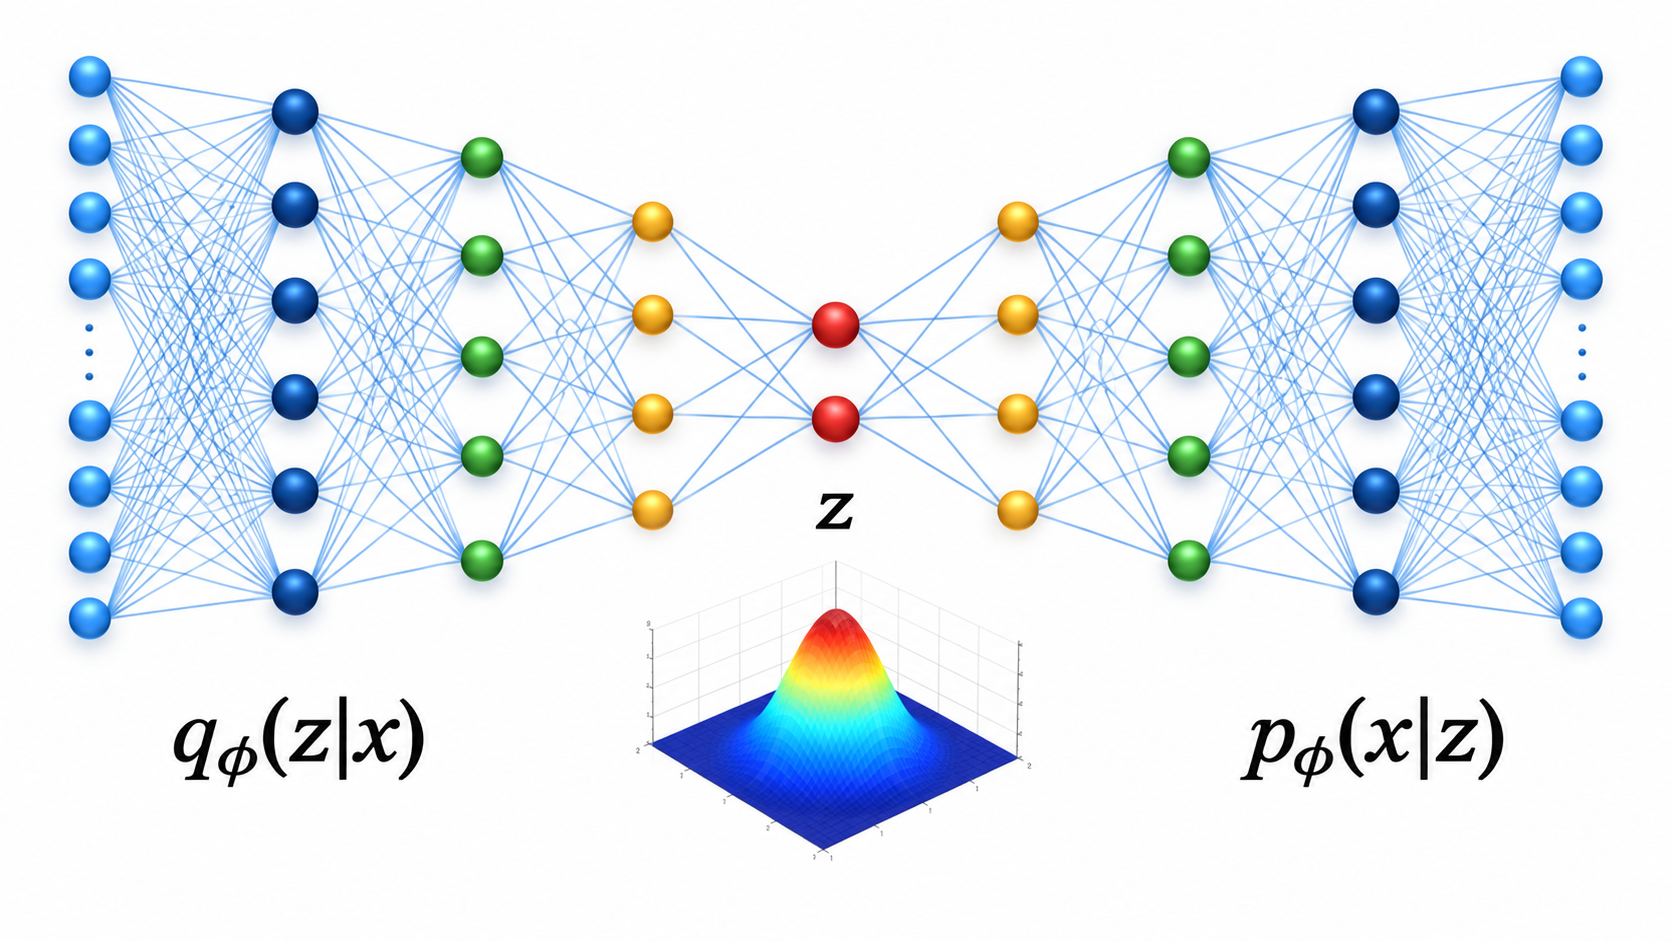
Auto-Encoding Variational Bayes (Kingma & Welling, 2013)An Introduction to Variational Autoencoders (Kingma & Welling, 2019)VAE(Variational Autoencode
10.VAE (2)
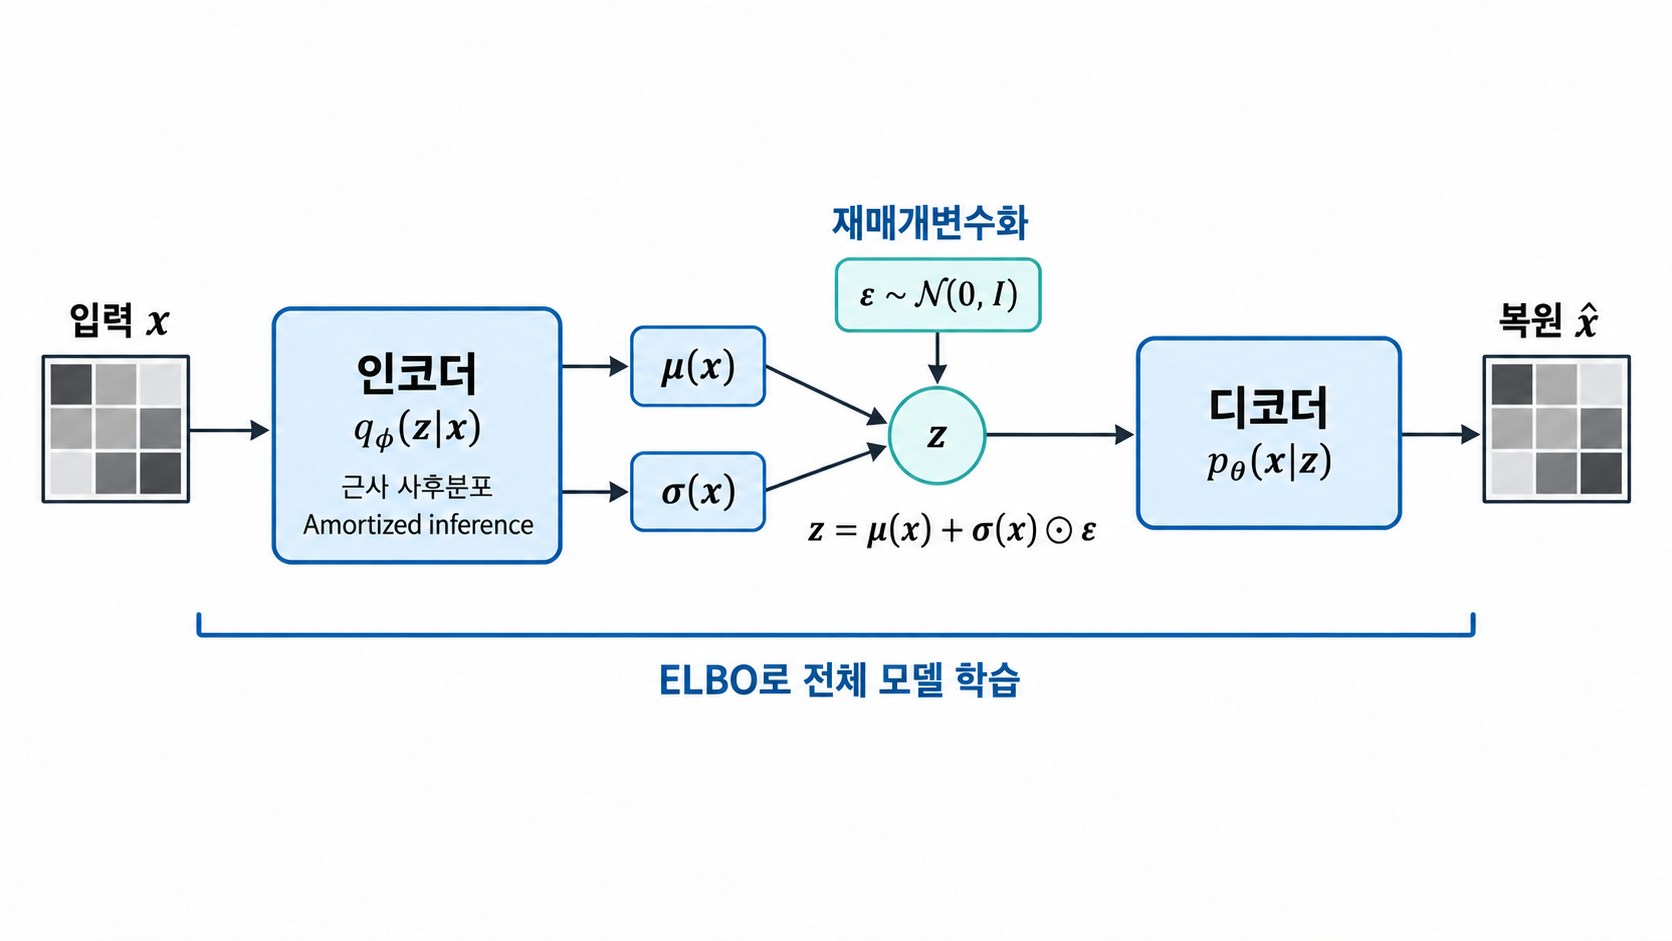
참고 자료 Auto-Encoding Variational Bayes (Kingma & Welling, 2013) An Introduction to Variational Autoencoders (Kingma & Welling, 2019) 6. 근사 사후분포 VAE에
11.Mixture Density Network
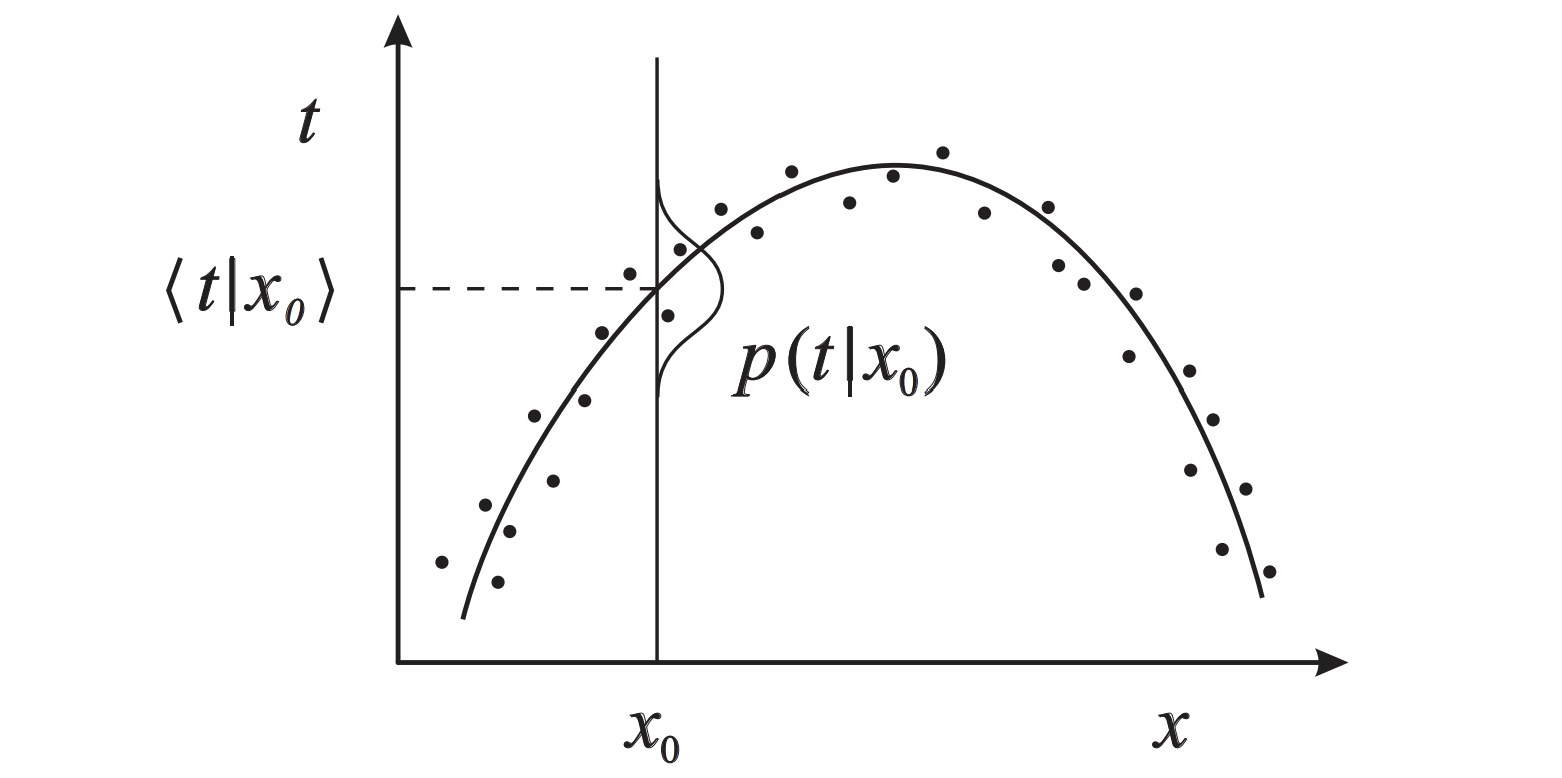
참고자료 https://publications.aston.ac.uk/id/eprint/373/1/NCRG94004.pdf 1. 기존 딥러닝 일반적인 회귀 신경망은 입력 벡터 $\mathbf{x}$를 받아 목표 벡터 $\mathbf{t}$의 각 성분에 해당하는 출력
12.World Model (1)
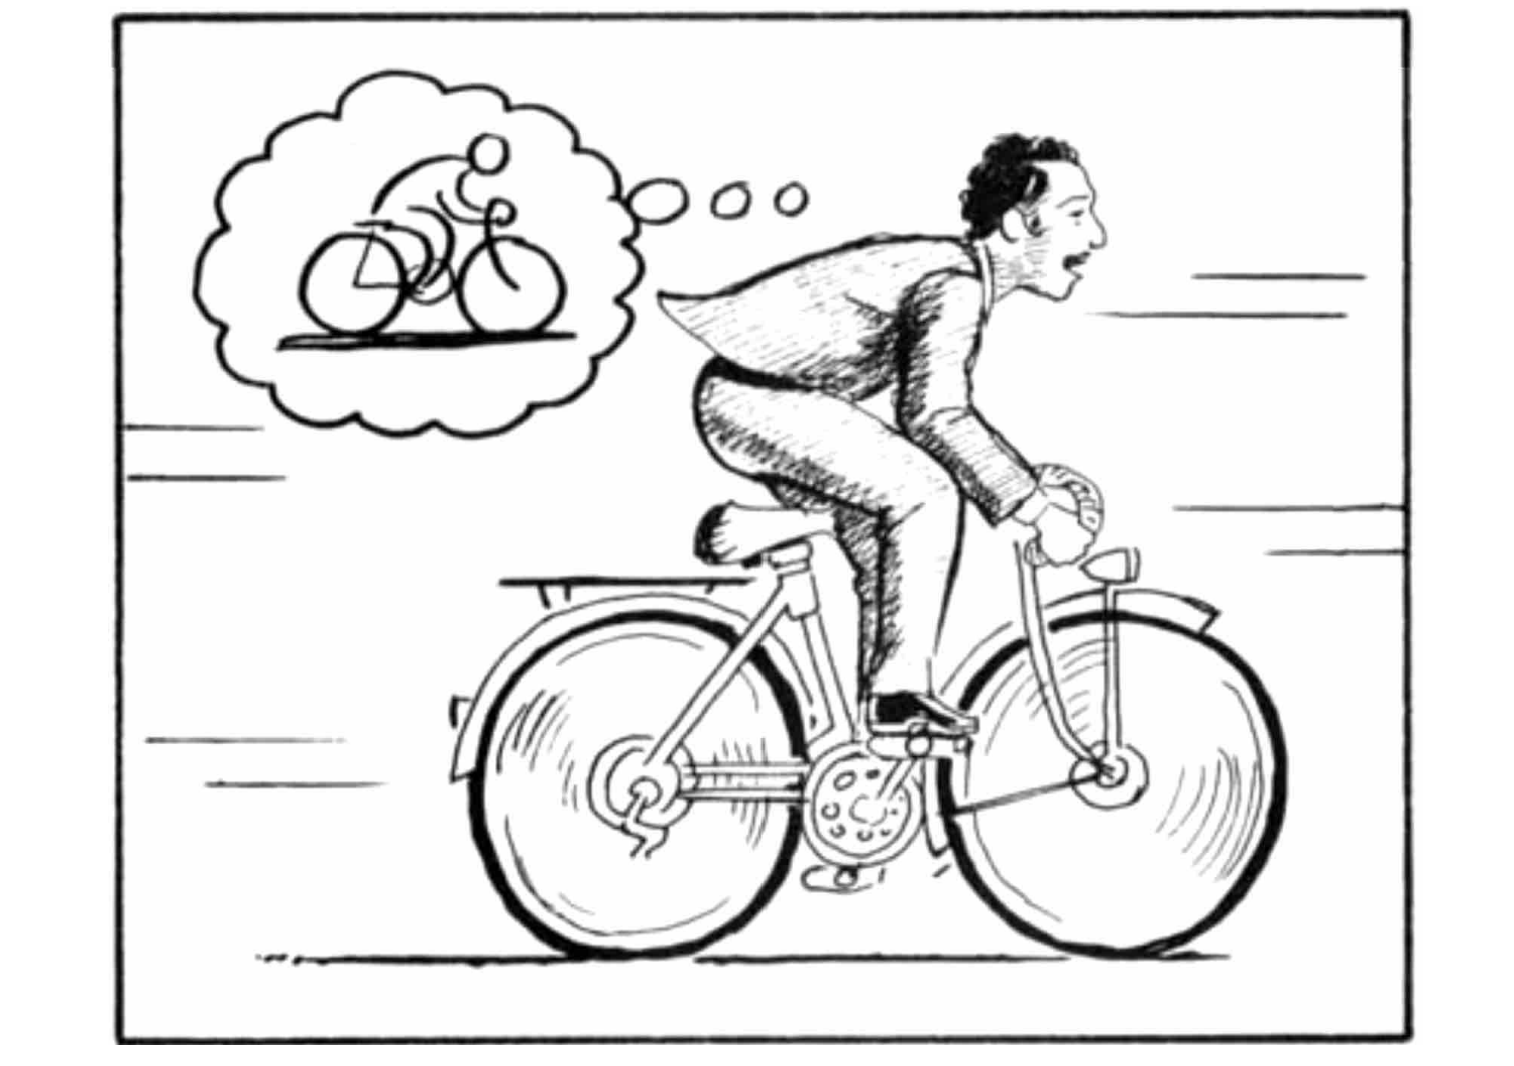
https://arxiv.org/abs/1803.10122사람은 감각을 통한 경험을 통해 세상을 이해하고 변화를 예측합니다.이는 머릿속에 있는 내부 모델을 통해 세상을 이해하는 것이라고 볼 수 있습니다.World Model은 에이전트가 느낀 정보를 토대로한 환
13.World Model (2)
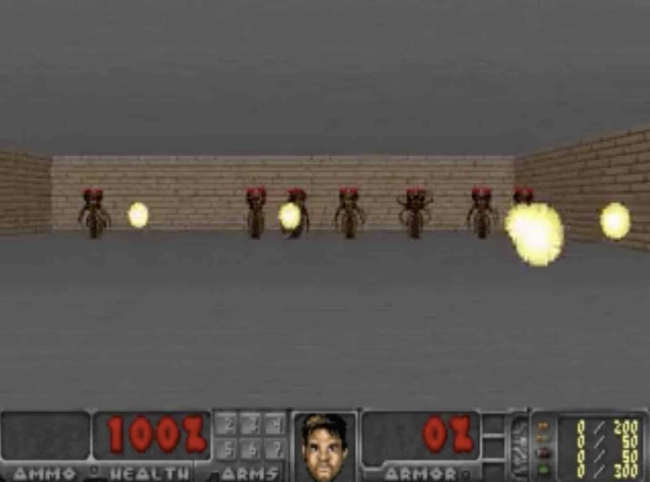
https://arxiv.org/abs/1803.10122VizDoom은 1인칭 슈팅 게임 Doom을 기반으로 한 인공지능 연구 환경입니다. 논문에서는 몬스터가 발사하는 화염구를 좌우로 움직이며 피하는 Take Cover 과제를 사용합니다. 에이전트의 목표는