제네릭(Generic)
제네릭 프로그래밍(generic programming)
- 일반적인 코드를 작성하고 이 코드를 다양한 타입의 객체에 대하여 재사용하는 프로그래밍 기법
- 타입을 파라미터로 가지는 클래스와 인터페이스를 정의한다.
- 선언 시 클래스 또는 인터페이스 이름 뒤에
<T> <>사이에는 타입 파라미터를 명시한다.- 타입 파라미터 : 일반적으로 대문자 알파벳 한 문자로 표현
→ 타입 파라미더로 들어있는 알파벳은 아무 의미가 없음, 그냥 Type은 T로, Element는 E로, Value는 V로 많이 사용하는 것뿐... 고로 구체적인 타입도 정해지지 않은 상태이다. 객체 생성이나 사용 시에 내가 정하면 되는 것... - 두 개 이상의 타입 파라미터도 사용 가능, 각 타입 파라미터는 콤마로 구분
- 선언 시 클래스 또는 인터페이스 이름 뒤에
- 컴파일 단계에서 잘못된 타입으로 발생할 수 있는 문제를 파악할 수 있다.
제네릭 메소드 선언 방법
public <A, B, ...> 리턴타입 메소드명(매개변수, ...) {...}
상속 및 구현 관계를 이용해 타입 제한
public <T extends 상위타입> 리턴타입 메소드명(매개변수, ...) {...}
- T는 상위 타입 제한(걸어놓은 상위타입까지 사용 가능)
- 상위 타입은 클래스뿐만 아니라 인터페이스도 가능
제네릭의 와일드카드 타입
- 사용 목적 : 안전한 데이터 이동 및 API 설계의 유연성을 위해 사용
- PECS 원칙 : Producer - Extends / Consumer - Super - 제네릭타입<?> : Unbounded Wildcards(제한X)
구체적인 타입으로 모든 클래스나 인터페이스 타입이 올 수 있음 - 제네릭타임<? extends 상위타입> : Upper Bounded Wildcards (상위 클래스 제한)
구체적인 타입으로 샹위 타입이나 상위 타입의 하위 타입만 올 수 있음, 읽기 가능 쓰기 불가 - 제네릭타이<? super 하위타입> : Lower Bounded Wildcards (하위 클래스 제한)
구체적인 타입으로 하위 타입이나 하위 타입의 상위 타입만 올 수 있음, 쓰기 가능 읽기 불가
Lab #1 색깔 주사위와 숫자 주사위
import java.util.ArrayList;

public class MyDice <T> {
	T result = null; // 주사위를 굴린 결과
	ArrayList<T> list; // 주사위에 들어갈 수 있는 값들을 저장하는 리스트

	public MyDice () {
		list = new ArrayList<T>();
	}

	public MyDice(T t) {
		this(); // 같은 클래스의 다른 생성자 호출 - list 생성
		result = t;
		showType();
	}

	public void showType() {
		System.out.println("이 주사위의 요소의 타입은 " + result.getClass().getSimpleName() + "입니다.");
	}

	public void 구르기() {
		int rand = (int)(Math.random()*1000 %list.size());
		result = list.get(rand);
	}

	public void setDiceToColor() {
		System.out.println("색깔을 무지개색으로 세팅합니다.");
		String colors = "빨간색 주황색 노란색 초록색 파랑색 남색 보라색";
		String [] ar = colors.split(" "); // 공백 기준으로 잘라서 배열 생성
		for (String s : ar) {
			list.add((T)s); // 강제 형변환
		}
	}

	public void setDiceNumber(int size) {
		System.out.printf("Integer %d개로 setting합니다.\n", size);
		for (Integer i = 0; i <size ; i++) {
			Integer num = i+1;
			list.add((T)num);
		}
	}
}
import java.util.Scanner;

public class Main {
	static Scanner input = new Scanner(System.in);

	public static void main(String[] args) {

		MyDice dice = null;
		String s ="";
		int num = 0;

		System.out.println("주사위 타입을 선택하세요. 1: 색깔 2: 숫자 \n");
		System.out.print("선택: ");
		int type = input.nextInt();

		input.nextLine();
		System.out.println("값을 입력합니다. ");
		if(type==1) {
			dice = new MyDice<String>("");
			dice.setDiceToColor();
		}
		if(type==2) {
			dice = new MyDice<Integer>(0);
			dice.setDiceNumber(10);
		}

		System.out.println(dice.list);
		dice.구르기();
		System.out.println("랜덤하게 고른 값은 " + dice.result + "입니다.");
	}

}
→ Lab을 통해서 타입 파라미터 T를 사용해서 result와 ArrayList의 요소 타입을 객체 생성 시점에서 결정할 수 있다는 것을 알게 되었고, 헷갈렸던 this()에 대해서도 다시 한 번 짚어볼 수 있었다.
컬렉션(Collection)
컬렉션: 자바에서 자료구조를 구현한 클래스
- 객체들을 효율적으로 추가, 삭제, 검색할 수 있도록 제공되는 라이브러리
- 컬렉션 클래스와 컬렉션 인터페이스로 제공된다.
- 인터페이스와 다형성을 이용한 설계로 표준화되어 있어서 사용법이 쉽고 편리하다.
- 컬렉션프레임워크에는 객체만 저장
- int → Integer, double → Double로 박싱한 후 저장해야 한다.
컬렉션 인터페이스
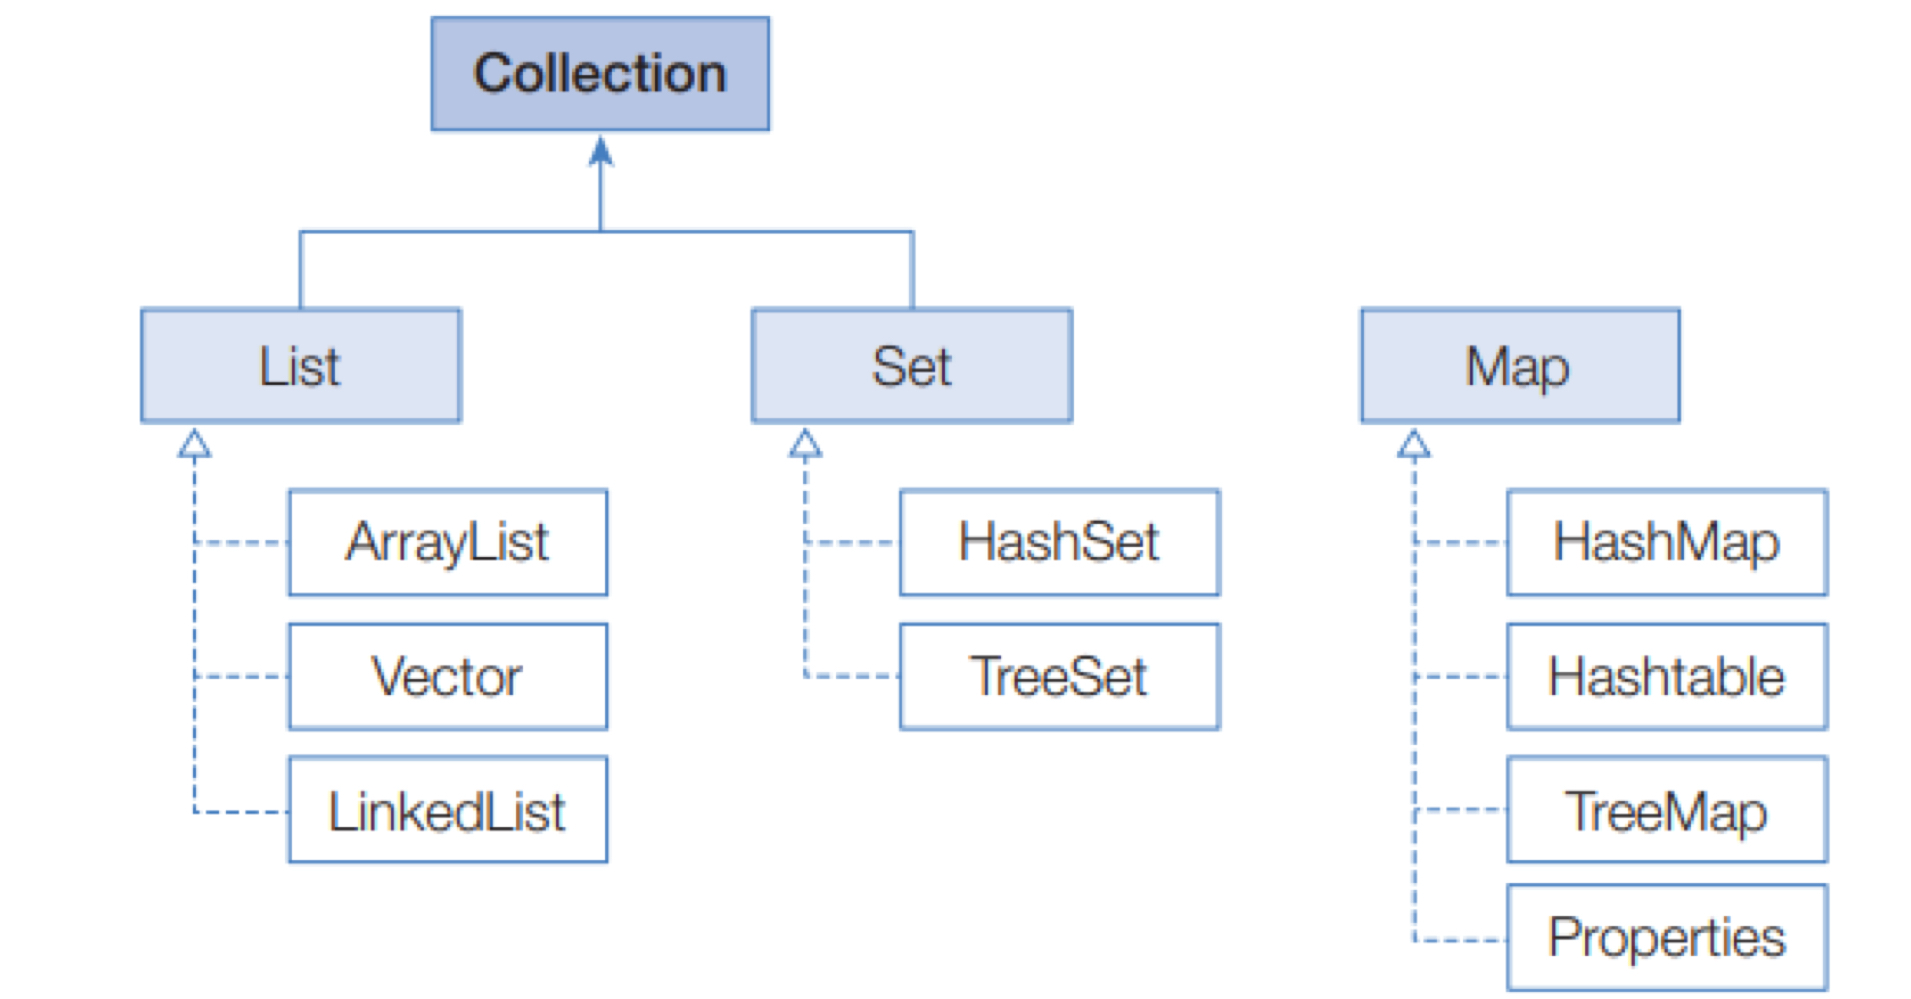
→ Map은 엄밀히 말하면 Collection을 상속하는 것은 아니지만, Collection의 형태로 가져올 수 있는 메소드르 제공한다.
- 컬렉션 인터페이스에는 모든 컬렉션의 공통 기능만 정의한다.
- 초기 버전에서 사용했던 Vector, Stack, Hashtable, Properies 등은 이제 잘 사용하지 않는다. 남아있는 코드를 위해서 존재할 뿐...
List 컬렉션
저장 순서가 유지되며, 배열처럼 index로 요소에 접근한다.
같은 객체의 중복 저장을 허용한다.
구현 클래스 : ArrayList, LinkedList
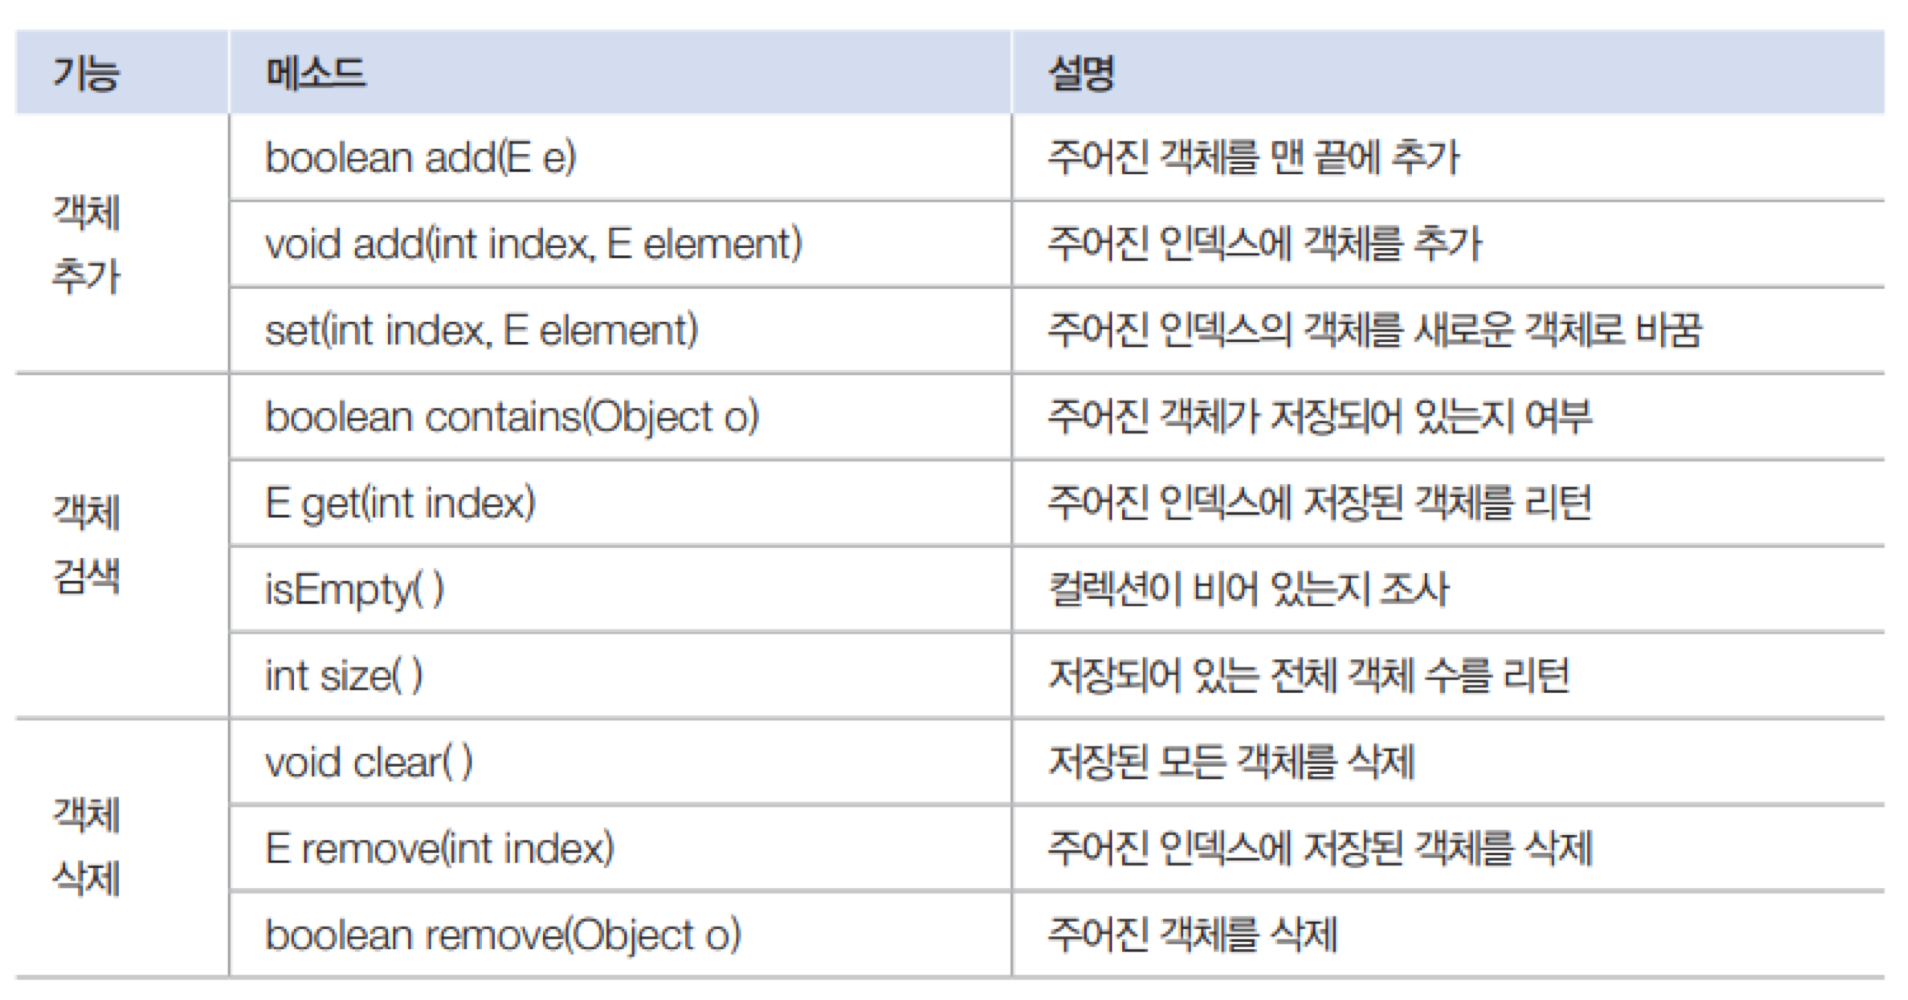
ArrayList
가변 크기의 배열, 단방향 리스트
초기 용량을 지정한 후에도 저장 용량을 초과하면 자동적으로 늘어난다. (고정도 가능)
List<E> list = new ArrayList<E>(); // 1
List<E> list = new ArrayList<>(); // 2
List list = new ArrayList(); // 3
→ 1, 2는 모두 E에 지정된 타입의 객체만 저장할 수 있고, 3은 모든 타입의 객체를 저장할 수 있다. 근데 모든 타입의 객체를 저장할 수 있게 할 거면? 굳이 이걸 쓸 이유가 없을 것...
LinkedList
양방향 포인터 구조의 리스트
인접 참조를 링크해서 체인처럼 관리한다.
특정 인덱스에서 객체를 제거하거나 추가하면 바로 앞뒤 링크만 변경된다.
List/ Queue 인터페이스를 동시에 구현하여 스택/큐로 응용이 가능하다.
빈번한 객체의 삭제와 삽입이 일어나는 곳에서는 ArrayList보다 좋은 성능을 가진다!
Vector
ArrayList와 내부 구성은 거의 비슷하고 오래된 버전
멀티 쓰레드 환경에서 복수의 스레드가 동시에 Vector에 접근해 객체를 추가하거나 삭제하더라도 안전하다. ⇒ Thread safe
그러나 사용을 권장하지는 않는다. 왜? 기본적으로 동기화되어 있기 때문에 불필요한 비용이 발생할 수 있다...
ArrayList의 동기화 처리
Collections.synchronizedList();
Collections 클래스에서 synchronizedList() 메서드를 통해 동기화 처리가 된 리스트를 만들어주는 기능을 지원한다.
Set 컬렉션
저장 순서가 유지되지 않고 원소의 중복을 허용하지 않는다. ⇒ 수학의 집합과 같은 개념
순서 자체가 없기 때문에 get(index)메소드가 없다. 그래서 전체 객체 대상으로 한 번씩 반복해 가져오는 반복자(iterator)나 for-each를 사용한다.
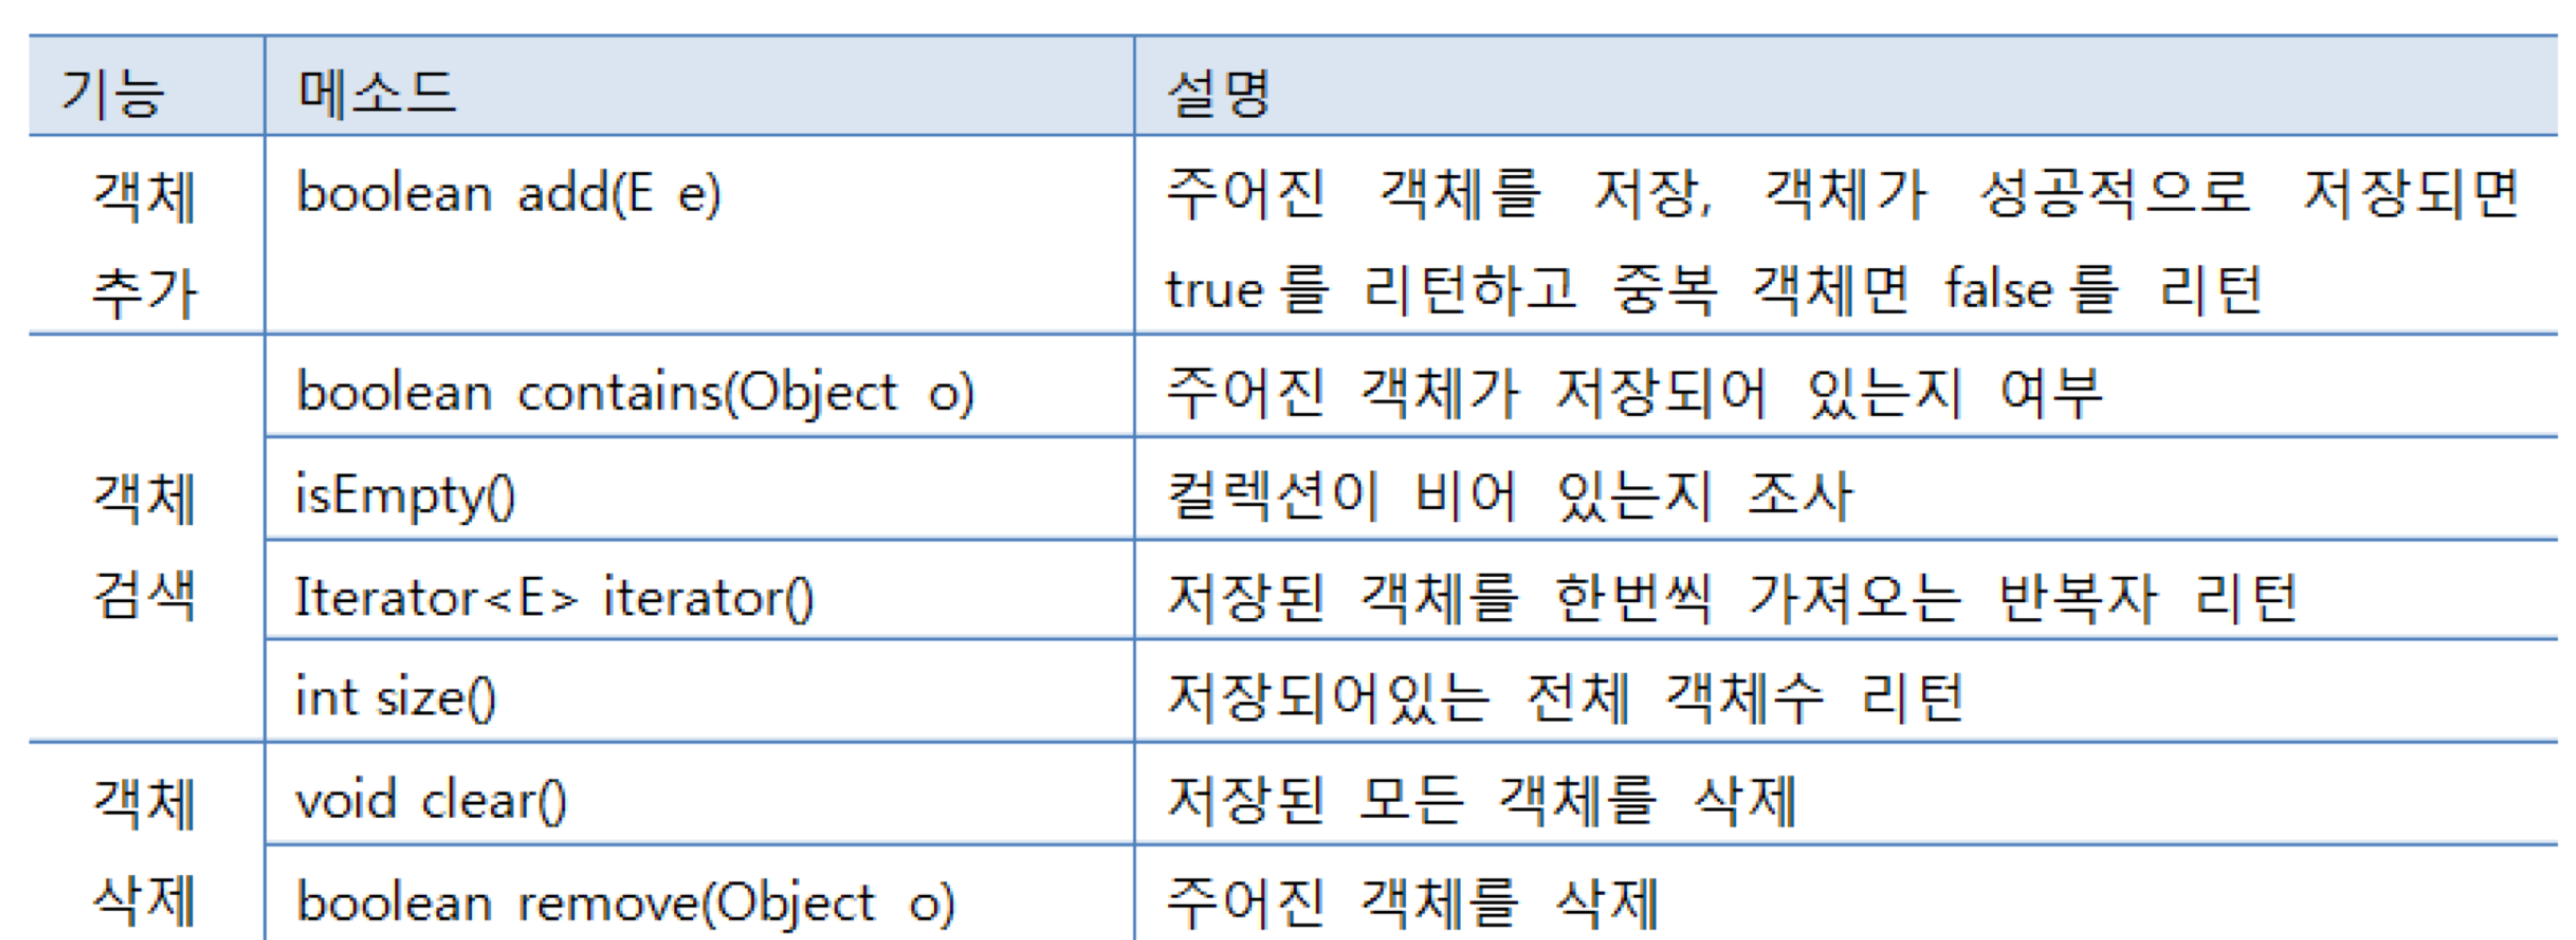
HashSet
해쉬테이블에 원소를 저장하기 때문에 성능면에서 가장 우수하다.
Set의 기본 특성대로 원소들의 순서가 일정하지 않다.
LinkedHashSet
해쉬 테이블과 연결 리스트를 결합한 것으로, 원소들의 순서가 삽입되었던 순서와 같다.
중복을 제거하면서 저장 순서를 유지해야 할 때 HashSet 대신 사용한다.
TreeSet
이진 검색 트리 기반으로 구현되어 원소를 저장하고, 정렬하여 관리한다.
추가/삭제되는 값에 따라서 순서가 결정되며 검색 효율이 높지만, 전반적으로 HashSet보다는 느리고, 비용이 높다.
EnumSet
중복되지 않는 상수 그룹을 나타내는 데 사용한다.
Map 컬렉션
Map 인터페이스는 Collection 인터페이스와 다른 저장 방식을 갖는다.
키와 값으로 구성된 Map.Entry 객체를 저장한다
⇒ 키(key)에 값(value)가 매핑된다 (= python Dictionary)
요소의 저장 순서를 유지하지 않으며, 키는 중복 불가능, 값은 중복 가능하다!
구현 컬렉션 : HashMap, LinkedHashMap, TreeMap
✲ Map은 Collection을 상속하지 않지만, Collection의 형태로 가져올 수 있는 3가지 View 메소드를 제공한다.
⇒ keySet(), values(), entrySet()
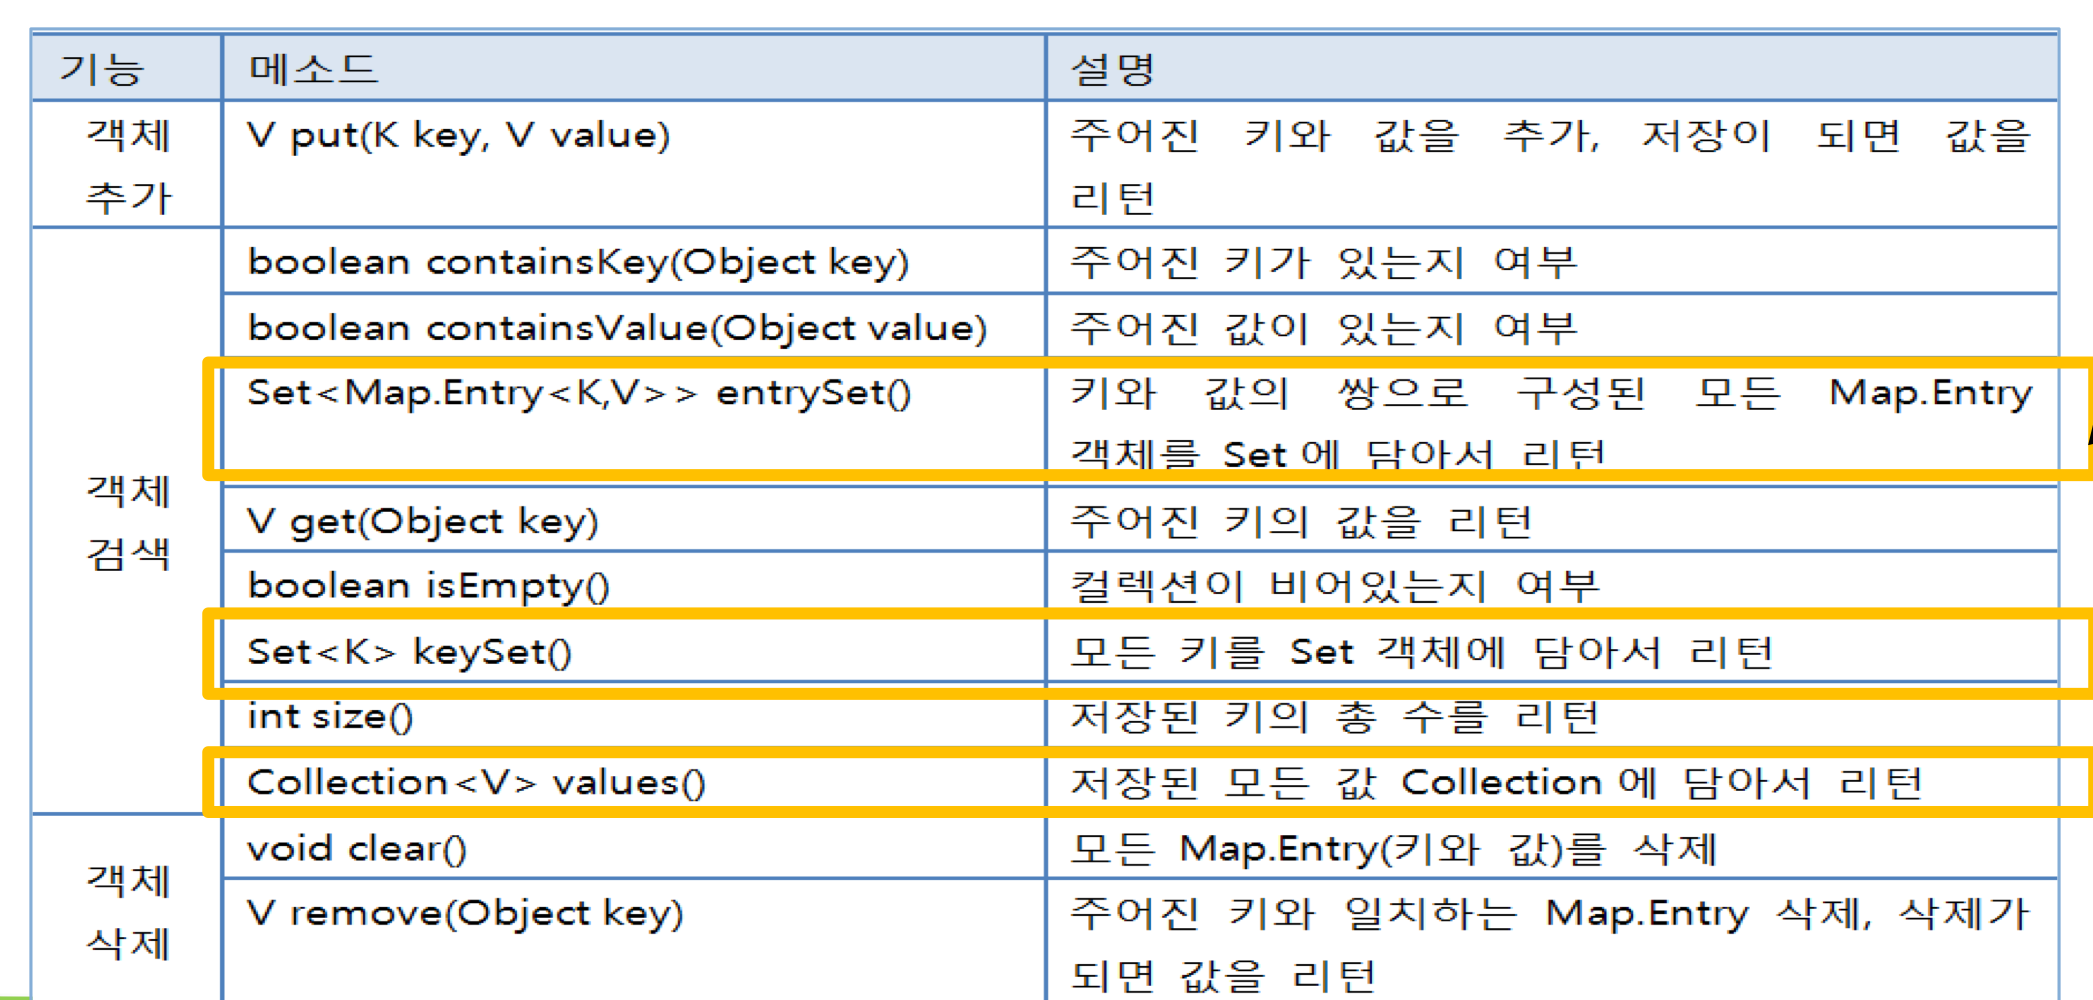
HashMap
가장 많이 쓰는 것
키 타입으로 String 사용 → String은 문자열이 같을 경우 동등 객체가 될 수 있도록 hashCode()와 equal()메소드가 재정의되엉 ㅣㅆ기 때문
LinkedHashMap
저장된 순서를 유지한다.
TreeMap
key값을 기준으로 정렬한다.
숫자-알파벳대소문자-한글순
Lab #6 HashMap
import java.util.Collection;
import java.util.HashMap;
import java.util.Map;
import java.util.Map.Entry;
import java.util.Set;

public class HashMapTest {

	public static <K, V> void show(Map<K, V> map) {
		System.out.println("-----------------------");

		// key 가져오기
		Set<K> keys = map.keySet();
		System.out.println("Key : " + keys);
		// value 가져오기
		Collection<V> values = map.values();
		System.out.println("Values : " + values);

		Set<Map.Entry<K, V>> entrySet = map.entrySet();
		System.out.println("Key : Values");
		System.out.println("-----------------------");

		for (Entry<K, V> entry : entrySet) {
			System.out.println(entry.getKey() + ": " + entry.getValue());
		}

	}


	public static void main(String[] args) {
	Map<Integer, String> map = new HashMap<>();

	for (int i = 1; i <=10; i++) {
		map.put(i, "data#" + i);
	}

	System.out.println(map); // map의 key와 value의 값을 한꺼번에 출력한다.
	System.out.println(map.get(111)); // 키가 111인 값은 없다.

	map.put(111, "data#111");
	map.remove(1);
	map.remove(2);
	map.put(3, "new_data#3"); // key는 중복되어 저장되지 않으므로 최근 입력값으로 대체된다.
	System.out.println(map);

	show(map);

	}

}
✲ Map.Entry는 Map 인터페이스에 구현된 내부 인터페이스로서, Map의 자료구조를 보다 객체지향적으로 관리한다.
→ Map의 메소드를 직접 다뤄보면서 key와 value를 함께 관리하는 Map의 특성에 대해서 이해할 수 있게 되었다.
PrettyPrinter 인터페이스
어떤 컬렉션이든 내부 요소에 구애받지 않고 보기 좋고 안전하게 출력하는 유틸리티 클래스
출력 메소드 : show()
요구사항 :
- List, Set, Map 범위 내에섯
- 요소가 Integer, String, Double, 사용자정의클래스여도 문제 없어야 함
- Null-Safe
Lab #8 PrettyPrinter 인터페이스와 구현 클래스 만들기
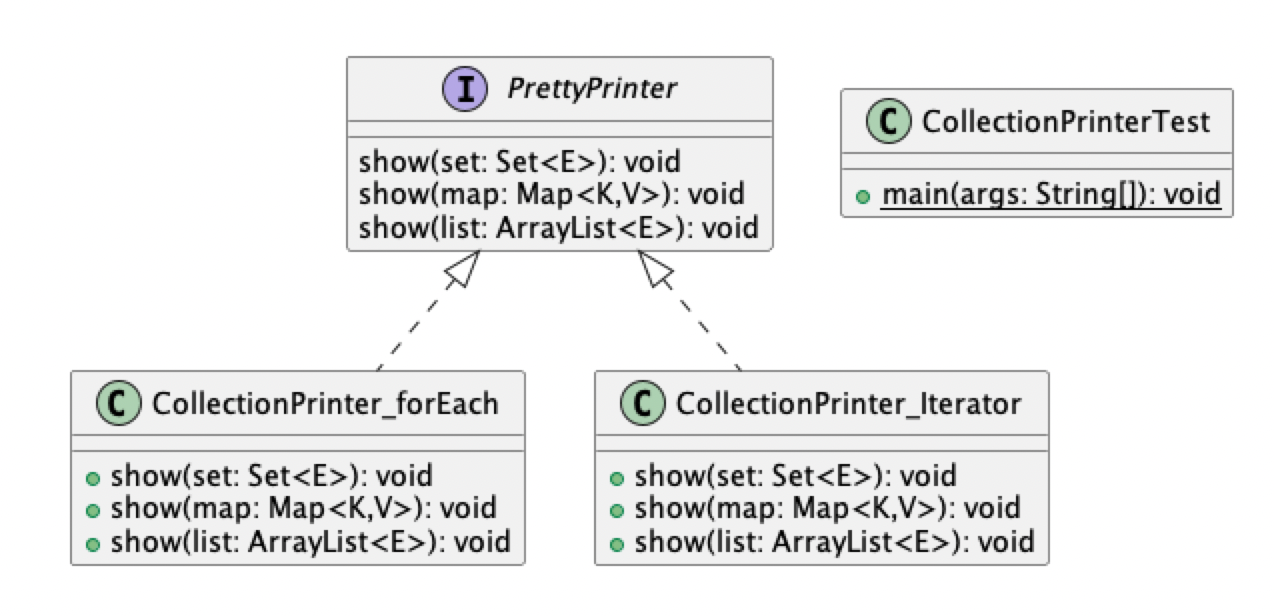
import java.util.ArrayList;
import java.util.Map;
import java.util.Set;

public interface PrettyPrinter {

	public <E> void show(Set<E> set);
	public <K, V> void show(Map<K, V> map);
	public <E> void show(ArrayList<E> list);

}
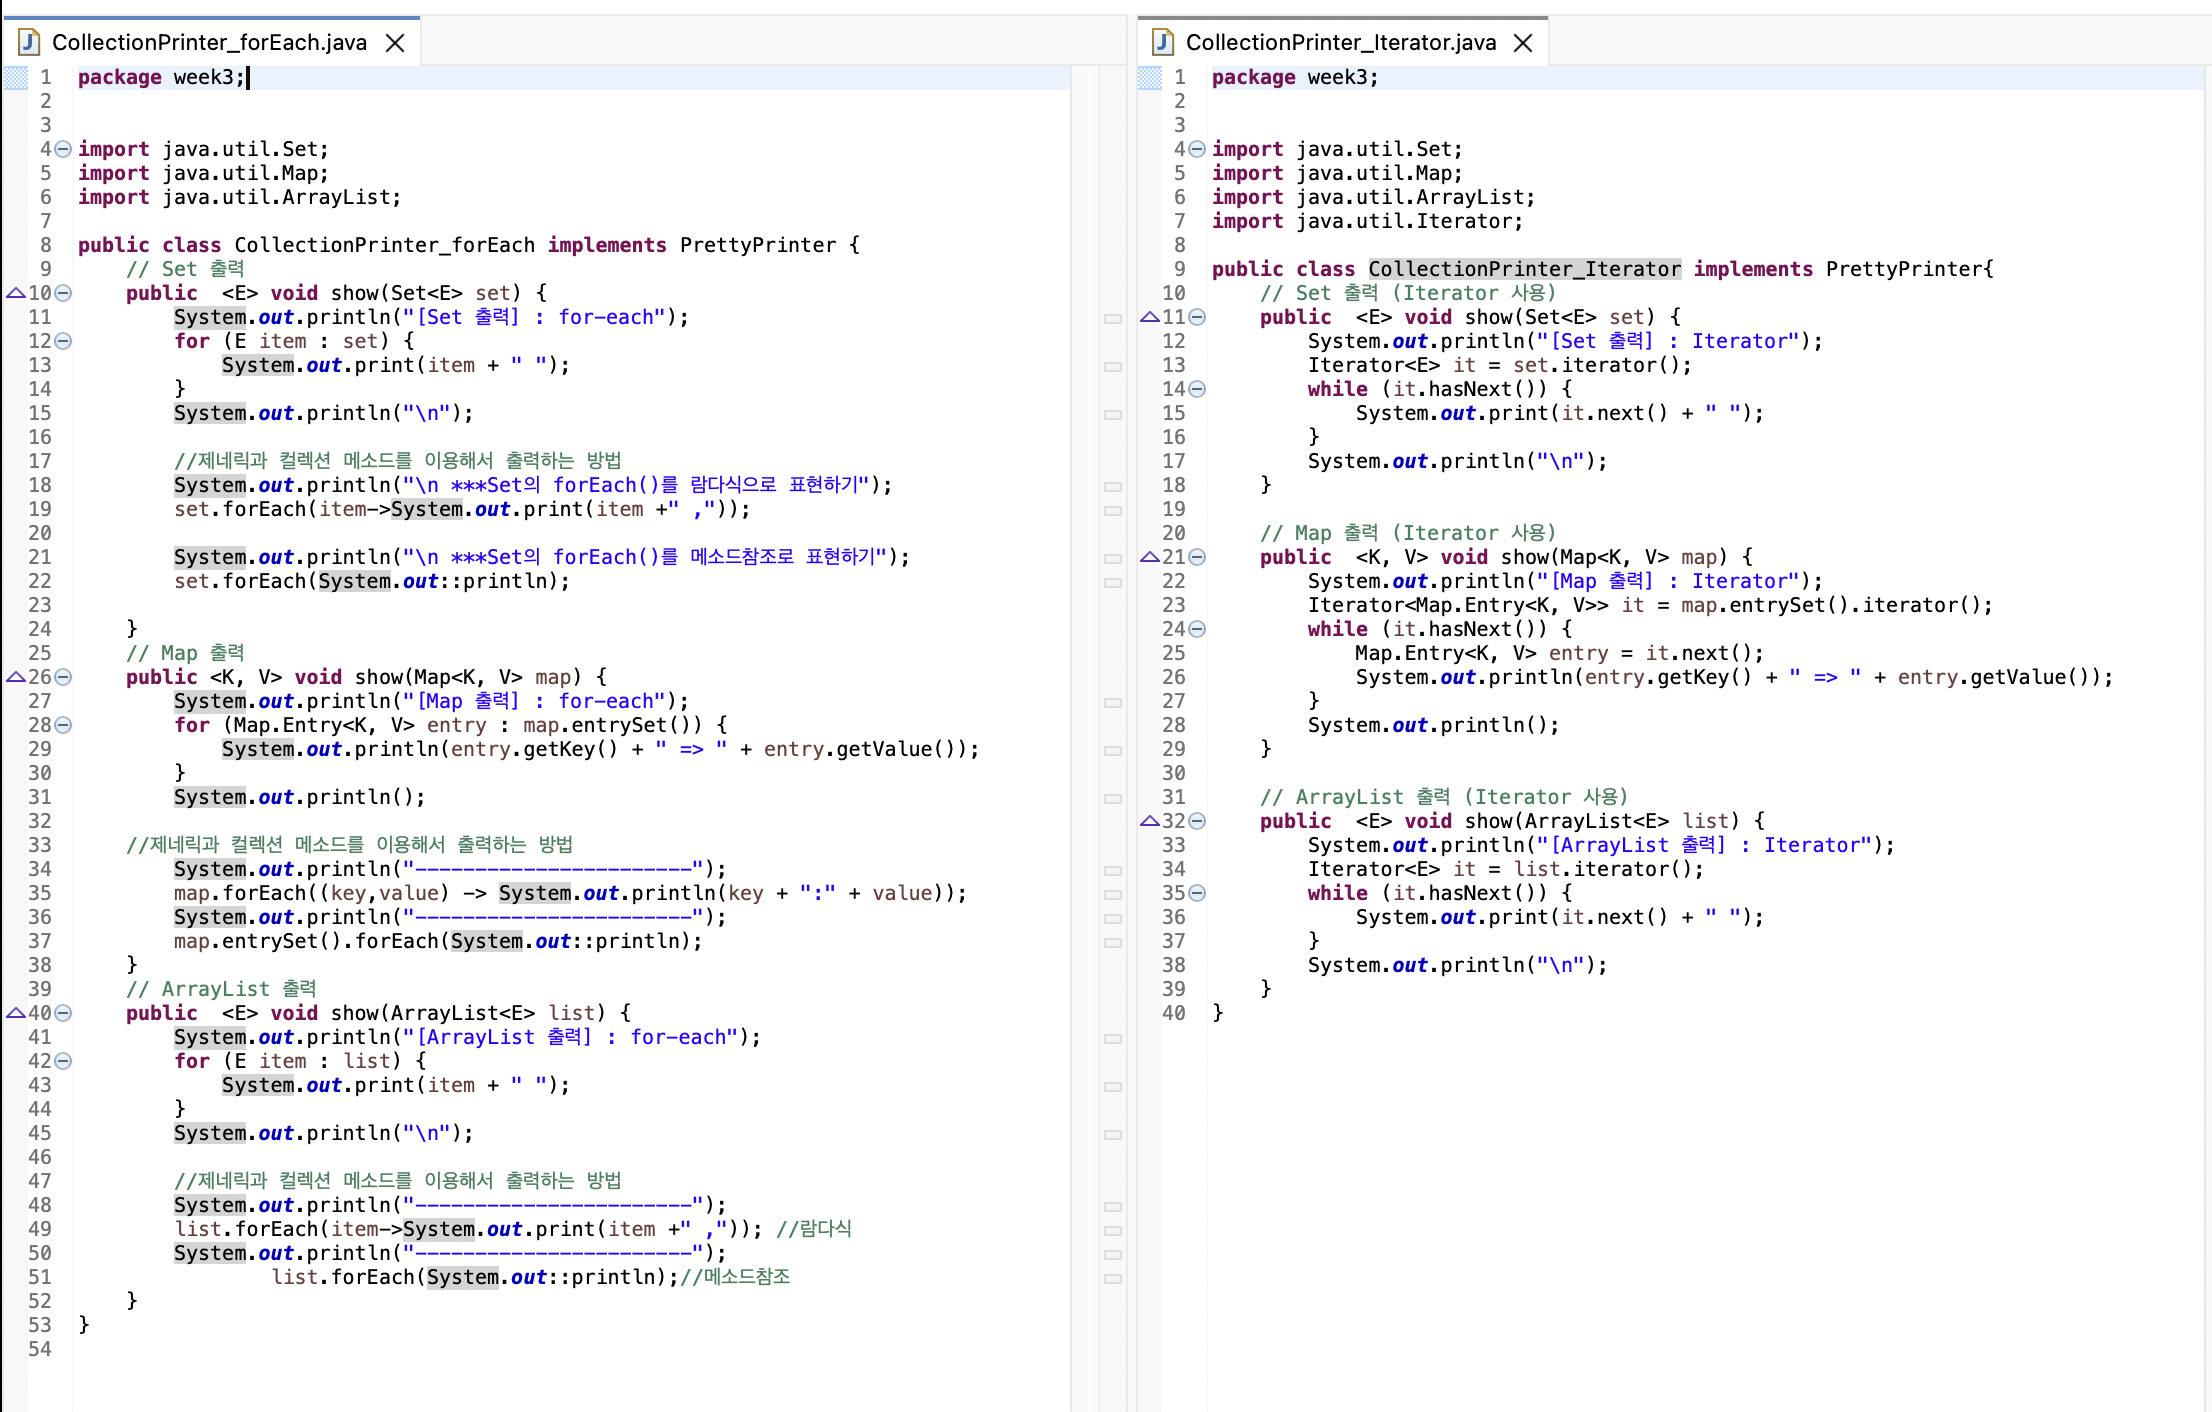
import java.util.ArrayList;
import java.util.Arrays;
import java.util.HashSet;
import java.util.Map;
import java.util.Set;

public class CollectionPrinterTest {
	public static void main(String[] args) {
		Set<String> languages = new HashSet<>(Arrays.asList("Java", "Java", "Java", "C", "C++","Python","Kotlin","JavaScript"));
		Map<String, Integer> menuMap = Map.of("라면", 2000, "아아",1000, "아이스크림",1000 );
		ArrayList<Double> scores = new ArrayList<>(Arrays.asList(85.5, 90.0, 78.5, null));

		PrettyPrinter printer = new CollectionPrinter_forEach();
		printer.show(languages);
		printer.show(menuMap);
		printer.show(scores);

		printer = new CollectionPrinter_Iterator();
		printer.show(languages);
		printer.show(menuMap);
		printer.show(scores);

	}
}
→ for-each / iterator를 사용하는 것에 대해서 비교해볼 수 있었다. for-each를 사용하면 set에 있는 요소들을 하나씩 꺼내서 item에 넣을 수 있다. iterator을 사용하면 Iterator을 생성하고 .hasNext()로 다음 요소가 있는지 확인하고 .next()로 다음 요소를 꺼낼 수 있다.