✅ Abstract
✅ dyMEAN (dynamic Multi-channel Equivariant grAph Network)
- 입력으로 epitope가 주어짐
- 입력으로 불완전한 항체 sequence가 주어짐
(설계해야 할 CDR-H3 같은 부분의 sequence가 비어 있다는 뜻) - 항체의 sequence와 structure를 end-to-end로 생성
- full-atom 수준의 구조를 다룸
- E(3)-equivariant 방식으로 작동
✅ dyMEAN의 핵심 구성 요소
(1) structural initialization을 사용
항체 구조를 처음부터 완전히 무작위로 시작하지 않고, 보존적인 residue 정보를 활용해 그럴듯한 초기 구조를 추정하는 과정
(2) shadow paratope
epitope와 antibody 사이의 연결을 돕기 위해 도입된 가상의 paratope
항체가 아직 어디에 붙을지 모르는 상황에서, 항원 쪽에 “가상의 항체 결합 부위 그림자”를 만들어 두고, 나중에 실제 paratope를 그 그림자에 맞춰 정렬시키는 방식
(3) adaptive multi-channel equivariant encoder
이 encoder는 sequence와 structure를 동시에 업데이트
특히 residue마다 원자 수가 다르다는 문제를 처리할 수 있음
기존 backbone-only 모델에서는 residue마다 주로 N, Cα, C, O 네 개 backbone atom만 보므로 channel 수가 일정
하지만 full-atom 모델에서는 glycine, alanine, tryptophan처럼 아미노산마다 side chain 원자 수가 다르기 때문에 residue별 원자 수가 달라짐
dyMEAN은 이 가변적인 atom 수를 처리할 수 있음
(4) 최종적으로 업데이트된 antibody를 shadow paratope와 정렬하여 epitope에 docking
✅ dyMEAN을 세 가지 실험에서 검증
(1) Epitope-binding CDR-H3 design
특정 epitope에 결합하는 CDR-H3를 설계하는 실험
(2) Complex structure prediction
항원-항체 복합체의 3D 구조를 예측하는 실험
(3) Affinity optimization
항체가 항원에 더 강하게 결합하도록 sequence를 개선하는 실험
✅ Introduction
✅ 기존 항체 설계 방법들의 발전
(1) traditional energy-based optimization
전문가가 설계한 에너지 함수나 통계적 에너지 항을 사용해 항체 구조나 sequence를 최적화하는 방식
(2) 1D sequence 기반 language model
항체의 아미노산 sequence를 문장처럼 보고, 단백질 sequence의 패턴을 학습하는 방식
(3) deep generative methods
CDR의 1D sequence와 3D structure를 동시에 설계
✅ 기존 방법들이 실제 항체 설계 요구를 충분히 만족하지 못하는 이유
실제 상황에서 보통 다음 정도만 알고 있음
- 항원의 3D 구조
- 그중 target epitope 위치
- 항체의 1D incomplete sequence
- 즉, CDR 같은 일부 영역이 비어 있는 sequence
이때 필요한 것은 다음을 한 번에 해내는 모델
- 비어 있는 CDR sequence 생성
- 항체의 3D structure 생성
- 항원 epitope에 대한 docking pose 예측
- side chain까지 포함한 full-atom 구조 생성
하지만 기존 방식은 보통 여러 단계를 연결한 pipeline으로 처리
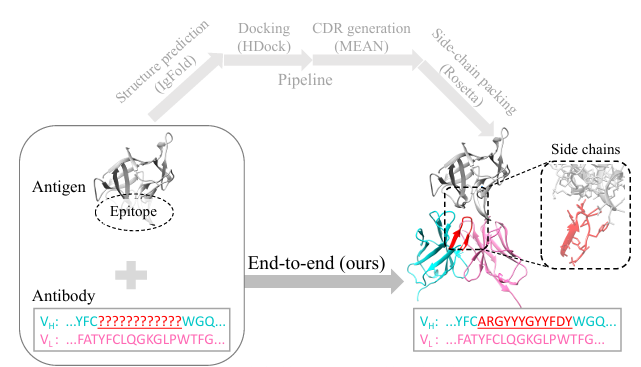
dyMEAN은 이 전체 과정을 하나의 end-to-end full-atom 모델로 처리하려고 함
✅ Full-atom geometry가 중요한 이유
항원-항체 상호작용을 제대로 표현하려면 full-atom geometry가 중요
항체와 항원은 단순히 backbone끼리만 상호작용하는 것이 아님
실제 결합에는 side chain의 원자 배치, 미세한 거리, 방향, 입체적 충돌 여부, 수소 결합 가능성 등이 모두 영향을 줌
✅ dyMEAN의 목적
(1) End-to-end antibody design
epitope와 incomplete antibody sequence만으로 전체 설계 과정을 한 번에 처리
(2) Full-atom antibody design
backbone뿐 아니라 side chain까지 포함한 전체 원자 수준 구조 모델링
✅ dyMEAN의 핵심 방법
(1) knowledge-guided structural initialization 사용
conserved residue, 항체에서 잘 보존되는 residue를 기반으로 초기 구조를 만드는 방법
(2) shadow paratope
antigen과 antibody의 초기 위치나 방향에 의존하지 않으면서 둘 사이의 상호작용을 연결하기 위한 장치
(3) adaptive multi-channel message passing으로 1D sequence와 3D structure를 반복적으로 업데이트
multi-channel은 residue 하나가 여러 atom coordinate를 가진다는 뜻입
full-atom modeling에서는 residue마다 atom 수가 다르기 때문에, dyMEAN은 이 가변성을 처리할 수 있어야 함
(4) shadow paratope와 실제 paratope를 정렬해서 epitope-antibody docking을 수행
(5) E(3)-equivariance
단백질은 공간에서 회전하거나 이동해도 본질적인 구조와 결합 관계는 변하지 않음
✅ Related Work
✅ Antibody Design
(1) 전통적 계산 방법
전문가가 만든 복잡한 energy function을 최적화
어떤 항체 후보가 안정적인지, 항원에 잘 결합할지 등을 에너지 점수로 평가하고, 그 점수를 낮추는 방향으로 sequence나 structure를 바꿈
그러나 실제 단백질 결합은 매우 복잡하기 때문에, 실제로는 잘 안 붙을 수 있음
(2) Sequence language model 기반 방법
항체의 1D sequence에 language model을 학습
-> structural modeling이 부족하기 때문에 suboptimal 함
(3) Sequence-structure co-design 방법
기존 sequence-only 방법보다 더 나은 성능을 보임
항체 설계에서 실제 3D 구조가 중요하기 때문
end-to-end 가 안된다는 한계
(4) dyMEAN
입력: epitope + incomplete antibody sequence
출력: complete antigen-antibody complex
방식: end-to-end
구조 수준: full-atom
✅ Protein Docking
Antibody docking에서 prior knowledge의 중요성
일반 protein docking 방법들은 epitope와 paratope에 대한 사전 지식이 없다고 가정하는 경우가 많음
-> 항체 docking 문제에서는 suboptimal할 수 있음
일반 docking 모델은 이런 힌트를 쓰지 않고 전체 표면을 다 뒤지는 경우가 많음
✅ Equivariant Graph Neural Networks (GNN)
결과가 관찰하는 시점 view에 의존해서는 안 된다
같은 단백질을 회전하거나 이동해서 입력해도, 모델의 예측은 그 변화에 맞게 일관되게 변해야 함
-> E(3)-equivariance
E(3): 3차원 유클리드 공간에서 가능한 변환들
- Rotation: 회전
- Translation: 평행이동
- Reflection: 반사
-> 이런 변환에 대해 모델이 equivariant해야 함
| 개념 | 의미 | 예시 |
|---|---|---|
| Invariant | 입력을 회전해도 출력이 그대로 | sequence prediction |
| Equivariant | 입력을 회전하면 출력도 똑같이 회전 | 3D coordinate prediction |
✅ Notations and Definitions
✅ epitope와 antibody variable domain을 graph로 표현
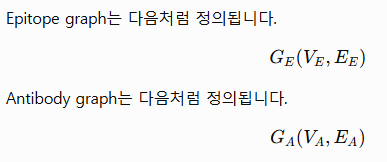
| 기호 | 의미 |
|---|---|
| (G_E) | epitope graph |
| (G_A) | antibody graph |
| (V_E) | epitope graph의 vertex 집합 |
| (V_A) | antibody graph의 vertex 집합 |
| (E_E) | epitope graph의 edge 집합 |
| (E_A) | antibody graph의 edge 집합 |
Vertex: residue를 의미
Edge: residue 사이의 관계 또는 이웃 연결을 의미
✅ Residue 표현: amino acid type과 coordinate matrix
각 residue vi는 두 가지 정보로 표현
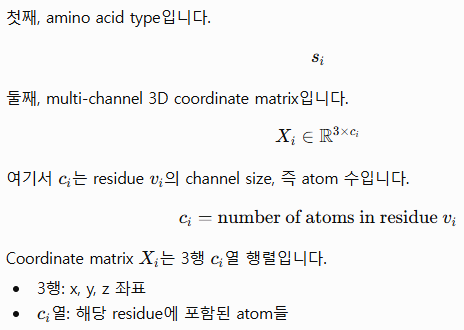
한 residue 안에 원자가 여러 개 있으므로, 각 원자의 3D 위치를 column으로 저장한 행렬
예를 들어, 어떤 residue에 원자가 7개 있으면 Xi는 3×7 행렬
✅ Edge 구성 방식: k-nearest neighbors
graph의 edge를 만들 때 residue 간 거리를 계산하고, k-nearest neighbors (kNN) 방식으로 이웃을 정함
Residue vi와 vj 사이의 거리는 두 residue에 속한 모든 atom 쌍 중 가장 가까운 atom pair의 거리로 정의
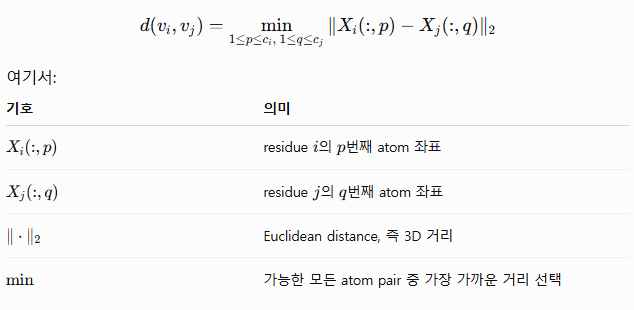
두 residue가 얼마나 가까운지를 residue 중심 사이의 거리가 아니라, 두 residue에 속한 원자들 중 가장 가까운 두 원자의 거리로 판단
residue A에 원자 5개, residue B에 원자 8개가 있다면 총 40개 atom pair 거리를 계산할 수 있음
그중 가장 짧은 거리를 두 residue 사이 거리로 사용
이 방식은 full-atom modeling에 적합
-> 실제 상호작용은 residue 중심보다 atom 간 접촉에 더 민감하기 때문
✅ Global node 추가
세 개의 global node를 추가
각 global node는 다음에 하나씩 들어감
- Heavy chain
- Light chain
- Epitope
각 global node는 자기 chain 안의 모든 node와 연결됨
또한 heavy chain의 global node와 light chain의 global node는 서로 연결됨
global node는 각 chain 전체 정보를 모으고 전달하는 허브 역할
일반 residue node들이 지역적인 이웃 정보를 주고받는다면, global node는 전체 chain 수준의 정보를 빠르게 퍼뜨리는 중심 노드
✅ 모델이 생성해야 하는 것
(1) 빈칸에 들어갈 CDR-H3 아미노산 sequence와
(2) 그 sequence를 포함한 항체 전체가 3D 공간에서 어떤 모양으로 접히고, 항원에 어떻게 붙는지
를 동시에 예측
✅ Method: dyMEAN
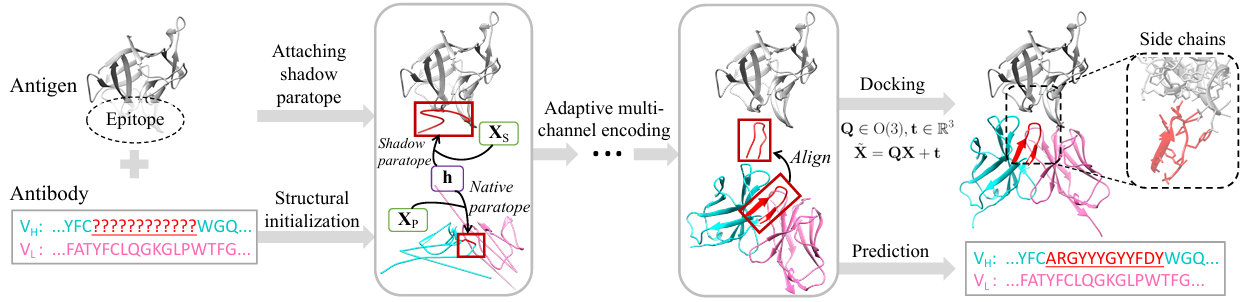
입력
- 항원의 결합 부위인 epitope
- CDR-H3 같은 paratope 부분이 비어 있는 incomplete antibody sequence
생성
- paratope의 amino acid sequence
- antibody 전체의 full-atom 3D structure
- epitope에 결합하는 docking pose
핵심
- Structural Initialization
- Shadow Paratope
- Adaptive Multi-Channel Equivariant Encoder
- Prediction and Docking
✅ 각 vertex가 가지는 정보
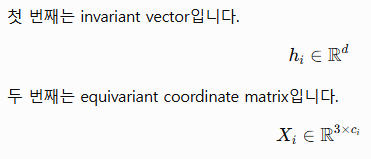
hi: residue i의 hidden representation (이 residue가 어떤 성질을 가지는지)
Xi: residue i에 포함된 모든 atom의 3D 좌표
✅ dyMEAN의 전체 수식
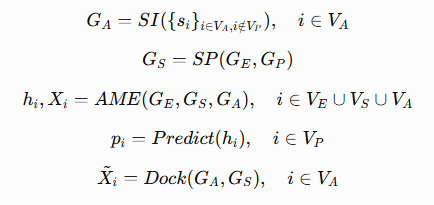
- SI: Structural Initialization
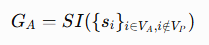
입력은 paratope(HCDR3)를 제외한 antibody sequence
-> SI는 이 incomplete sequence를 바탕으로 antibody graph GA의 초기 hidden state와 초기 3D coordinate를 만듦
SI는 항체의 “초기 스케치”를 그리는 단계
CDR-H3는 비어 있지만, 항체 framework의 보존적인 구조를 이용해 항체가 대략 어떻게 생겼을지 초기값을 만듦
- SP: Shadow Paratope
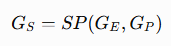
epitope 주변에 paratope의 clone, 즉 그림자 paratope GS를 붙임
-> 이 shadow paratope는 실제 antibody paratope와 hidden state는 공유하지만, coordinate는 따로 가짐
실제 CDR-H3는 antibody에 붙어 있음
항원 쪽에는 “여기에 CDR-H3가 와야 한다”는 가상의 CDR-H3를 하나 둠
나중에 실제 CDR-H3를 이 shadow paratope에 맞춰 docking
- AME: Adaptive Multi-Channel Equivariant Encoder
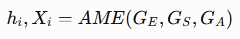
AME는 epitope, shadow paratope, antibody graph의 정보를 업데이트
특히 full-atom geometry를 다루기 때문에 residue마다 atom 수가 다른 문제를 처리해야 함
-> 이를 위해 adaptive multi-channel message passing을 사용
- Predict: Paratope sequence 예측
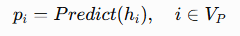
paratope residue마다 어떤 amino acid가 들어갈지 확률 분포를 예측
여기서 pi는 residue i가 각 amino acid type일 확률
- Dock: Antibody docking
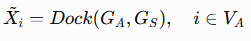
antibody를 epitope에 붙이는 단계
구체적으로는 실제 paratope를 shadow paratope에 정렬
✅ dyMEAN의 중요한 성질
- 예측된 paratope sequence는 E(3)-invariant
- 예측된 binding structure는 E(3)-equivariant
-> epitope나 antibody의 초기 위치와 방향을 회전, 이동, 반사하더라도 모델의 sequence prediction은 변하지 않고, structure prediction은 그 변환에 맞게 일관적으로 변함
✅ Structural Initialization with Conserved Residues
dyMEAN이 불완전한 antibody sequence만 가지고 어떻게 초기 구조를 만드는지 설명
입력 antibody sequence는 두 가지가 없음
(1) paratope 정보
즉, CDR-H3 sequence가 비어 있음
(2) 3D geometry
즉, antibody 구조 좌표가 없음
이 상황에서 dyMEAN은 초기 hidden state hi(0)와 초기 coordinate Xi(0)를 만들어야 함
✅ 초기 hidden state hi(0) 만들기
각 residue의 초기 embedding을 다음 두 정보로 만듦
(1) amino acid type si
(2) numbering system에서의 position number ri
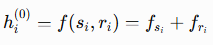
| 기호 | 의미 |
|---|---|
| (s_i) | residue (i)의 amino acid type |
| (r_i) | antibody numbering system에서 residue (i)의 위치 번호 |
| (f_{s_i}) | amino acid type embedding |
| (f_{r_i}) | position embedding |
| (h_i^{(0)}) | 초기 hidden vector |
각 residue는 “내가 어떤 amino acid인가?”와 “항체 구조에서 몇 번째 위치인가?”라는 정보
Unknown paratope residue
-> 해당 residue의 si는 special type인 [MASK]로 표현
✅ 초기 coordinate Xi(0) 만들기
- 항체에 대한 domain knowledge를 사용
항체의 framework regions, FRs는 공간적으로 잘 보존되어 있다.
CDR은 다양하지만 FR은 항체마다 비교적 비슷한 구조를 가짐
- Conserved residue를 찾는 이유
먼저 FR에서 잘 보존된 residue들을 찾고, 그 residue들을 이용해 나머지 residue들의 위치를 대략적으로 그림
-> sequence similarity가 3D spatial similarity를 어느 정도 반영하기 때문에 1D sequence 비교를 사용
여러 항체에서 특정 위치의 amino acid가 거의 항상 같다면, 그 위치는 구조적으로도 중요한 고정 지점일 가능성이 큼
그래서 dyMEAN은 “항체들 사이에서 거의 변하지 않는 위치”를 구조의 기준점으로 삼음
- Conserved residue 탐지 절차
어떤 position에서 amino acid type이 전체 antibody의 95% 이상에서 동일하면, 그 residue를 well-conserved residue로 봄
- Backbone template 만들기
이 conserved residue들의 backbone coordinate를 사용
(N, Cα, C, O)
모든 antibody를 conserved residue들의 backbone 좌표 기준으로 Kabsch algorithm을 사용해 align
그다음 conserved residue들의 평균 backbone coordinate를 계산
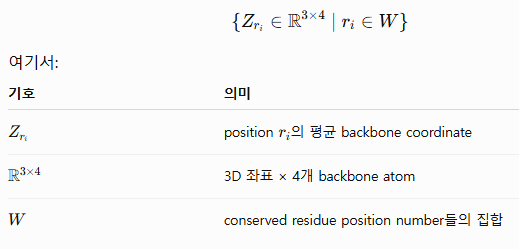
conserved residue
Heavy chain: 16개 / Light chain: 18개
- Conserved residue가 아닌 residue의 좌표 만들기
같은 chain 안에서 나머지 residue 좌표를 두 가지 방식으로 채움
(1) 두 conserved residue 사이에 있는 residue
어떤 residue가 position number상으로 두 conserved residue 사이에 있다면, 두 conserved residue 좌표 사이를 linear interpolation
(2) chain의 양 끝에 있는 residue
어떤 residue가 chain의 앞쪽 끝이나 뒤쪽 끝에 있어서 양쪽에 conserved residue가 없는 경우
이 경우에는 가장 가까운 conserved residue에서 바깥쪽으로 outward linear interpolation
간격은 경우 1에서 계산한 가장 가까운 residue pair의 interval을 사용
- Backbone 좌표를 full-atom 좌표로 확장
backbone 좌표 Zi를 Xi(0)로 확장할 때, side chain의 좌표를 alpha-carbon, Cα 좌표로 채움
-> 즉, 초기에는 side chain atom들을 정확히 배치하기보다는 Cα 위치에 모아두는 방식으로 초기화
처음부터 side chain을 정확히 펼쳐 놓는 것은 어려움
그래서 초기에는 side chain 원자들을 Cα 주변에 대충 놓고, 이후 AME message passing을 통해 점점 구조를 고쳐 나감
- Coordinate normalization
초기 coordinate를 얻은 뒤, 좌표를 standard Gaussian distribution에 맞게 normalize
이를 위해 다음을 수행
(1) 3D mean translation
(2) 1D variance normalization
(3) 모든 차원과 모든 antibody가 같은 normalization factor를 공유 -> scale을 일관되게 유지하기 위해
모델이 좌표를 다루기 쉽게, 전체 좌표를 평균 0, 분산 1 정도의 표준 범위로 맞춤
좌표 크기가 제각각이면 학습이 불안정해질 수 있기 때문
- kNN edge 구성
초기 좌표 Xi(0)를 얻은 뒤, antibody graph GA의 edge를 만듦
이때, residue distance 를 사용
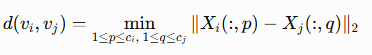
두 residue 사이의 모든 atom pair 중 가장 가까운 pair의 거리를 residue 간 거리로 보고, k-nearest neighbors 방식으로 edge를 구성
✅ E(3)-Invariant Attachment of Shadow Paratope
epitope 주변에 paratope의 clone을 붙임
-> shadow paratope
✅ Shadow paratope가 필요한 이유
(1) Epitope와 antibody 사이의 정보 전달
Shadow paratope는 실제 paratope와 hidden state hi를 공유
또한 native paratope와 같은 topology를 가짐
이를 통해 epitope와 antibody 사이에서 E(3)-invariant information을 전달
항원과 항체는 처음에 서로 떨어져 있거나 방향이 다를 수 있음
이 상황에서 직접 coordinate를 주고받으면 초기 위치와 방향에 영향을 받을 수 있음
그래서 dyMEAN은 좌표가 아니라 hidden state 같은 invariant 정보를 shadow paratope를 통해 주고받게 함
(2) Docking을 위한 key point
나중에 docking할 때 기준점으로 쓰임 (항체 결합 부위가 최종적으로 와야 할 위치)
즉, native paratope를 shadow paratope에 align해서 antibody 전체를 epitope 쪽으로 docking
✅ Shadow paratope의 중요한 성질
Shadow paratope의 3D coordinate와 최종 docked structure는 antibody의 초기 위치에 의존하지 않는다
shadow paratope와 native paratope가 coordinate Xi를 직접 공유하지 않고, invariant hidden information hi만 교환하기 때문
처음 antibody를 어디에 놓든, 또는 어떤 방향으로 돌려 놓든, shadow paratope는 epitope 주변에서 독립적으로 작동
그래서 최종 docking 결과가 antibody 초기 배치에 휘둘리지 않음
✅ Shadow paratope graph 정의
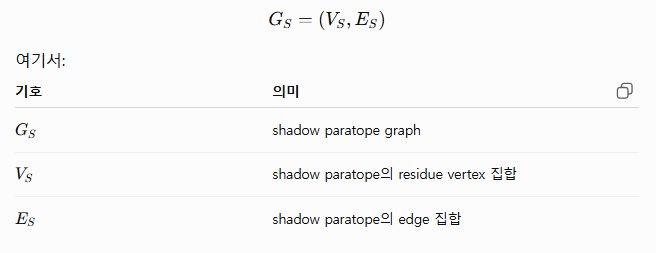
✅ Shadow paratope의 edge 구성
(1) Internal edges
native paratope 내부의 연결을 그대로 복사
즉, 실제 paratope residue들끼리 연결되어 있던 topology를 shadow paratope도 동일하게 가짐
(2) External edges
shadow paratope와 epitope 사이의 edge
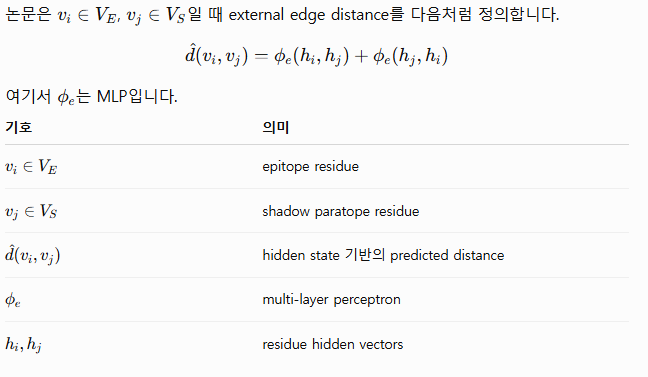
이 distance를 기반으로 kNN 방식으로 epitope와 shadow paratope 사이의 edge를 만듦
✅ 왜 ϕe(hi,hj)+ϕe(hj,hi)인가?
거리 값은 원래 A에서 B까지의 거리와 B에서 A까지의 거리가 같아야 함
그래서 두 방향을 모두 계산해 더하는 방식으로 symmetric한 distance를 만들려는 의도
✅ Shadow paratope의 hidden state와 coordinate 초기화
Shadow paratope의 hidden vector hi는 native paratope에서 복사 (어떤 residue인지에 대한 정보는 공유)
coordinate Xi는 native paratope와 공유하지 않음
-> epitope 중심 주변에서 standard Gaussian distribution에 따라 초기화
✅ Shadow paratope와 epitope graph 병합
shadow paratope graph GS를 epitope graph GE와 합침
-> epitope와 shadow paratope가 함께 message passing할 수 있는 joint graph가 만들어짐
epitope 주변에 shadow CDR-H3를 붙인 뒤, 둘을 하나의 graph처럼 묶어서 서로 정보를 주고받게 만듦
✅ Shadow paratope 에 대한 심층적 이해
같은 residue의 latent identity/representation을 공유한다
dyMEAN에서 native paratope GP와 shadow paratope GS는 좌표로 직접 연결되지 않음
대신 shadow paratope는 native paratope의 clone 이고, 각 residue가 1:1 대응됨
-> 그래서 shadow residue i와 native residue i는 같은 paratope position을 나타내고, 둘 사이에서 hidden vector hi를 공유하거나 복사함
- 초기에는 sequence/position embedding으로 연결됨
native paratope의 hidden vector는 residue type과 position number로 초기화됨
다만 생성해야 하는 paratope residue는 amino acid type을 모르니까 [MASK] type + position embedding으로 구성
그래서 처음 연결은 “이 residue가 CDR-H3의 몇 번째/어느 IMGT position인가”라는 position identity가 핵심이고, 알려진 residue는 sequence 정보도 들어감
- 하지만 학습이 진행되면 hidden vector는 단순 sequence feature가 아님
AME message passing을 거치면서 native paratope 쪽 hi는 항체 graph GA 안에서 framework, 주변 CDR, native paratope 구조 정보를 받아먹고, shadow paratope 쪽 hi는 epitope graph GE∪GS 안에서 epitope 주변 정보를 받아먹음
그리고 이걸 번갈아 수행
항체 쪽에서 AME 한 층 돌림 → native paratope의 hidden vector를 shadow paratope로 copy → epitope+shadow 쪽에서 AME 한 층 돌림 → shadow hidden vector를 native paratope로 copy
즉 hidden vector가 항체 context와 epitope context를 왕복시키는 통신 채널 역할을 함
- shadow paratope 좌표는 epitope 근처에서 따로 학습됨
shadow paratope의 좌표 XS는 epitope 중심 근처에 Gaussian으로 초기화되고, epitope와의 message passing을 통해 “epitope에 붙어야 할 paratope의 target pose”처럼 업데이트
반면 native paratope 좌표 XP는 antibody 전체 구조 안에서 업데이트
둘은 같은 residue identity를 공유하지만, 좌표는 각각 따로 진화
- 마지막에 native와 shadow가 좌표로 연결됨: Kabsch alignment
최종 단계에서 native paratope 좌표 XP를 shadow paratope 좌표 XS에 맞추는 rigid alignment를 함
Kabsch algorithm으로 Q,t를 구해서 전체 antibody를 docking
즉 shadow paratope는 “epitope 근처의 목표 paratope 위치”이고, native paratope는 “항체 내부에서의 실제 paratope 위치”라서, 둘을 align하면 antibody 전체가 epitope에 dock
간단히 정리하면, epitope 에 맞도록 hidden vector 가 학습, 항체 쪽 message passing에서는 antibody context를 담고, 둘이 번갈아 copy되면서 binding-compatible한 residue representation
-> 이걸 shadow paratope 와 native paratope 가 공유함
hidden vector 에 맞춰, shadow paratope 쪽에서는 epitope 에 잘 맞게, native paratope 쪽에서는 전체 항체구조에 잘 맞게 구조가 생성되고 message 를 전달함
두 개의 모양은 같으나, 위치가 다른 것이므로
최종적으로는 두 개를 정렬시켜 docking pose 를 만들어 냄
epitope 쪽 context와 antibody 쪽 context가 hidden vector hi를 통해 오가고,
shadow paratope는 epitope에 맞는 paratope pose를 만들고,
native paratope는 antibody 전체 구조 안에서 자연스러운 paratope 구조를 만들고,
마지막에 native paratope를 shadow paratope에 정렬해서 docking pose를 만든다.
✅ Adaptive Multi-Channel Equivariant Encoder
dyMEAN의 핵심 encoder인 Adaptive Multi-Channel Equivariant Encoder (AME)
| 표현 | 의미 |
|---|---|
| Adaptive | residue마다 atom 수가 달라도 처리 가능 |
| Multi-Channel | 하나의 residue가 여러 atom coordinate channel을 가짐 |
| Equivariant | 3D 회전, 이동, 반사에 대해 구조 출력이 일관되게 변함 |
| Encoder | hidden vector와 coordinate를 업데이트하는 neural network |
✅ AME가 필요한 이유
기존 backbone-only 모델에서는 residue마다 주로 네 개 atom만 봄
-> N,Cα,C,O (channel size가 항상 4)
하지만 full-atom geometry에서는 side chain까지 포함하므로 residue마다 atom 수가 다름
-> 각 residue의 coordinate matrix는 다음처럼 서로 다른 shape을 가짐
✅ AME layer의 업데이트 수식
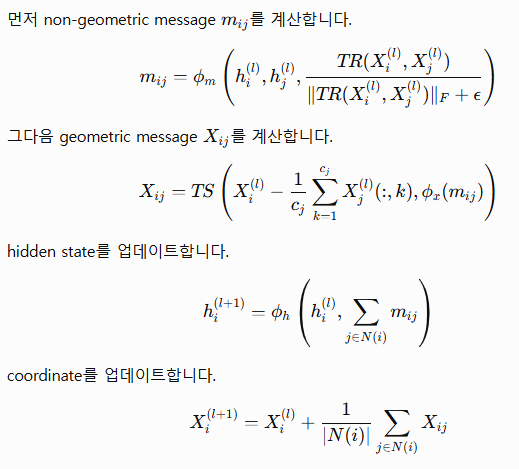
l-번째 AME layer에서 hidden vector와 coordinate matrix를 다음처럼 업데이트
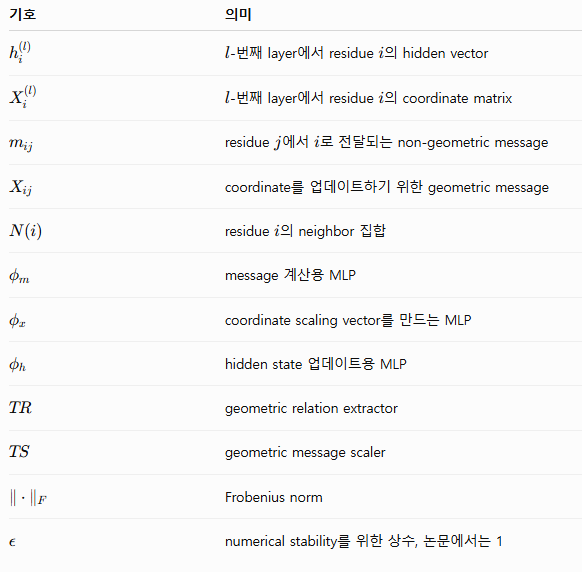
✅ Non-geometric message mij
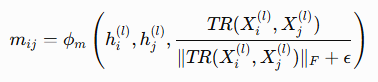
좌표 자체가 아니라 hidden state를 업데이트하는 데 사용되는 feature
입력 3가지
- residue i의 hidden vector
- residue j의 hidden vector
- 두 residue의 geometric relation
-> TR이 뽑아낸 geometric relation을 Frobenius norm으로 normalize한 값
두 residue가 어떤 성질을 가지는지, 그리고 3D 공간에서 어떤 관계인지 보고 “이웃 residue로부터 어떤 정보를 받을지”를 계산
✅ Frobenius norm으로 normalize하는 이유
TR의 출력을 Frobenius norm으로 normalize
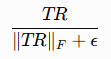
좌표나 거리 값이 너무 커지면 neural network가 불안정해질 수 있음
그래서 관계 행렬의 크기를 적당히 정규화해서 안정적으로 학습하도록 함
✅ Geometric message Xij
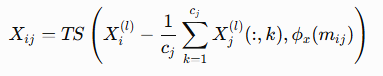
coordinate 업데이트에 쓰이는 geometric message를 만듦
- neighbor residue j의 atom 좌표 평균을 구함
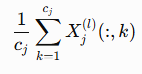
-> residue j의 대략적인 중심 좌표
-
그다음 residue i의 각 atom 좌표에서 residue j의 중심을 뺌
-> 즉, residue j의 중심을 기준으로 residue i의 atom들이 어디에 있는지를 나타냄 -
그 결과를 TS가 ϕx(mij)로부터 나온 scale 정보로 조정
neighbor residue j가 residue i에게 “너의 atom들을 이 방향과 크기로 조금 움직여라”라는 geometric message를 보내는 것
✅ Hidden state 업데이트
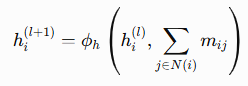
Residue i는 모든 neighbor j로부터 받은 message mij를 합침
그다음 기존 hidden state와 합쳐서 새로운 hidden state를 만듦
-> 주변 residue들이 보내준 정보를 모아서, residue i가 자신의 상태를 업데이트
✅ Coordinate 업데이트
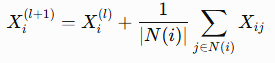
Residue i는 모든 neighbor로부터 받은 geometric message Xij를 평균내고, 이를 기존 coordinate에 더함
-> 주변 residue들의 정보를 참고해서 residue i의 atom 좌표를 조금씩 이동시키는 과정
✅ TR: Geometric Relation Extractor
TR은 서로 shape이 다른 coordinate matrix 두 개를 받아서, 고정된 크기의 geometric relation representation을 만듦
✅ Channel-wise distance matrix Dij
TR은 두 residue의 모든 atom pair 사이 거리를 계산
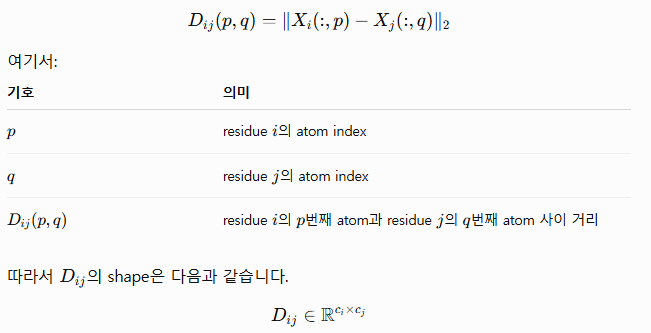
이후, Dij에서 유용한 정보를 뽑기 위해 learnable parameter들을 사용하고, 각 channel과 output dimension 사이에서 유용한 pattern을 추출하기 위해 attribute matrix 를 사용
모든 atom pair 거리가 똑같이 중요한 것은 아님
어떤 atom pair는 결합에 중요하고, 어떤 pair는 덜 중요
그래서 모델이 학습 가능한 weight를 통해 중요한 atom relation을 더 반영하게 함
✅ TR의 최종 출력
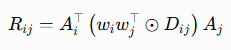
ci와 cj가 달라도, 최종 Rij는 항상 d×d
-> static-dimensional input이 됨
residue마다 atom 수가 달라서 거리 행렬 크기는 제각각TR은 이 제각각 크기의 거리 정보를 항상 같은 크기의 feature로 압축
이것이 full-atom modeling에서 매우 중요
✅ TS: Geometric Message Scaler
TS의 목적은 coordinate message를 scale하는 것
✅ 왜 TS가 필요한가?
full-atom modeling에서는 coordinate update도 residue마다 다른 수의 atom에 적용되어야 함
TS는 긴 scale vector를 실제 atom 수에 맞게 줄이고, 각 atom coordinate에 적절히 적용
✅ Epitope graph와 antibody graph 사이의 정보 교환
epitope graph GE와 antibody graph GA가 직접 연결되어 있지는 않음
그러나, dyMEAN은 두 graph 사이에서 정보를 교환해야 함
이 정보 교환은 shadow paratope GS의 hidden state를 통해 이루어짐
(1) Antibody graph에서 1-layer AME 수행
GA에서 1-layer AME를 수행
그다음 native paratope GP의 hidden vector hi를 shadow paratope GS로 복사
(2) Epitope + shadow paratope graph에서 1-layer AME 수행
다음으로 GE∪GS에서 1-layer AME를 수행
그다음 shadow paratope GS의 hidden vector를 native paratope GP로 다시 복사
(3) 위 과정을 L layers 동안 반복
(4) 마지막으로 antibody graph에서 1-layer message passing 추가 수행
GA에서 1-layer message passing을 추가로 수행
업데이트된 정보를 antibody 전체에 broadcast하기 위함
CDR-H3를 통해 들어온 epitope 정보를 antibody 전체 framework에도 퍼뜨리는 단계
이 방식의 핵심은 epitope와 antibody가 coordinate를 직접 교환하지 않고 hidden state를 통해 정보를 교환한다는 점
-> 그래서 antibody의 초기 위치나 방향에 덜 민감
✅ AME의 equivariance 성질
- TR은 E(3)-invariant
- TS는 O(3)-equivariant
- GE와 GA 사이의 정보 교환은 E(3)-invariant
AME의 최종 출력
hi는 E(3)-invariant
Xi는 independently E(3)-equivariant
GE∪GS and GA
-> epitope+shadow graph와 antibody graph 각각의 좌표 변환에 대해 적절한 equivariance가 유지된다는 뜻
hidden feature는 단백질을 돌려도 바뀌지 않고, coordinate는 단백질을 돌린 만큼 같이 돌아감
-> 3D 구조 모델에서 중요한 물리적 일관성
✅ Prediction, Docking and Training Losses
AME로 업데이트된 정보를 이용해 실제 sequence를 예측하고, antibody를 docking하며, 학습 loss를 계산
✅ Progressive full-shot decoding
sequence와 3D structure를 T번의 iteration에 걸쳐 점진적으로 생성
-> 각 iteration에서 모든 vertex의 hidden state와 coordinate를 업데이트
✅ Paratope amino acid prediction
각 iteration에서 paratope residue의 amino acid type을 예측
✅ Hidden state refresh
sequence prediction을 한 뒤 hidden state를 새로 갱신
✅ Paratope가 아닌 residue의 hidden state
Paratope가 아닌 residue는 amino acid type을 이미 알고 있음 (HCDR3 제외 나머지)
-> known sequence embedding에 memory term을 더함
이미 알고 있는 residue는 “정답 amino acid embedding”을 그대로 사용하고, 거기에 이전 iteration에서 얻은 정보를 추가
✅ Paratope residue의 hidden state
Paratope residue는 amino acid type을 모름
그래서 예측 확률을 이용해 soft하게 embedding을 만듦
“이 위치는 tyrosine이다”라고 hard하게 정하지 않고, “tyrosine일 가능성 45%, glycine일 가능성 20%”처럼 확률을 반영한 평균 embedding을 사용
✅ Memory term
매 iteration마다 hidden state를 새 embedding으로 바꿔버리면 이전에 학습한 정보가 사라질 수 있음
그래서 이전 hidden state에서 중요한 정보를 남겨두는 memory term을 더함
✅ 다음 iteration으로 전달
구조가 업데이트되면 residue 사이의 가까운 관계도 바뀔 수 있음
-> 그래서 매 iteration마다 graph 연결을 새로 계산
✅ Docking
final iteration 이후 native paratope의 pose를 shadow paratope와 align
-> Kabsch algorithm 적용
실제 CDR-H3를 shadow CDR-H3 위에 딱 맞게 겹치도록 항체 전체를 이동하고 회전시키는 과정
CDR-H3만 맞추지만, 변환은 antibody 전체에 적용되므로 항체 전체가 epitope에 docking 됨
✅ Loss Function
loss function: Sequence loss + Structure loss + Docking loss
-
Sequence prediction에는 cross-entropy loss를 사용
(CDR-H3의 각 위치에서 정답 amino acid를 얼마나 잘 맞혔는지) -
구조 supervision에는 Huber loss를 사용
-> ground-truth coordinate 와 비교
모델이 만든 antibody 3D 구조와 실제 antibody 구조가 얼마나 가까운지 보는 loss
다만 전체 구조는 회전이나 이동 차이가 있을 수 있으므로, 먼저 두 구조를 잘 겹친 뒤 비교
좌표 데이터에는 오차나 이상치가 있을 수 있음
Huber loss는 작은 오차에는 민감하게 반응하지만, 큰 오차에는 너무 과하게 반응하지 않아서 학습을 안정적으로 만듦
- Structure loss: bond length loss
full-atom structure를 생성하기 때문에 bond length도 supervision
-> atom 좌표만 맞히는 것이 아니라, 원자 사이 화학 결합 길이도 맞추도록 학습
- 전체 structure loss
coordinate 자체와 bond length를 모두 맞추는 것
✅ Docking loss
Docking supervision에는 두 가지 loss를 사용
(1) Shadow paratope coordinate loss
-> shadow paratope coordinate가 ground-truth paratope 위치에 가까워지도록 함
(2) External distance loss
-> epitope residue와 shadow paratope residue 사이의 predicted distance가 실제 distance와 가까워지도록 함
✅ dyMEAN의 E(3)-equivariance
dyMEAN은 epitope의 초기 위치와 방향에 대해 E(3)-equivariant하다.
- Epitope와 shadow paratope를 g1만큼 회전/이동하면,
- 초기 antibody를 g2만큼 아무렇게나 회전/이동하더라도,
- 최종 sequence prediction {pi}는 그대로이고,
- 최종 docked antibody coordinate는 g1만큼 변환된 결과가 된다
dyMEAN이 antibody의 초기 위치와 방향에 휘둘리지 않는다는 뜻
예를 들어 epitope가 어떤 방향으로 놓여 있든, dyMEAN은 같은 paratope sequence를 예측해야 함
그리고 최종 antibody structure는 epitope가 놓인 방향에 맞춰 같이 회전하거나 이동해야 함
또한 antibody 초기 구조를 어디에 두든, 최종 docking 결과는 epitope 기준으로 일관되게 나와야 함
중요한 이유
(1) epitope와 initialized antibody의 임의의 orientation과 position에 대해 잘 generalize할 수 있음을 의미
-> 모델이 특정 좌표계나 특정 배치에 overfit되지 않음
(2) data-efficient
단백질을 다양한 방향으로 돌려 놓은 데이터를 많이 보지 않아도, 모델 구조 자체가 회전/이동 일관성을 보장하기 때문
✅ Experiments
Kong et al. 2022를 따라, 항체와 가장 가까운 항원 잔기 48개를 에피토프로 추출
✅ Epitope-binding CDR-H3 Generation
에피토프에 결합할 CDR-H3 서열과 구조를 잘 생성하는가
평가 지표
| 지표 | 의미 | 좋을수록 |
|---|---|---|
| AAR | 생성한 아미노산 서열이 실제 정답 서열과 얼마나 겹치는지 | 높음 |
| CAAR | 실제 결합 잔기, 즉 에피토프에서 6.6 Å 이내에 있는 잔기만 대상으로 한 AAR | 높음 |
| TMscore | 생성 구조와 실제 구조의 전체적 유사도, Cα 좌표 기준 | 높음 |
| lDDT | 원자 간 거리 관계가 실제 구조와 얼마나 비슷한지 | 높음 |
| RMSD | Kabsch 정렬 없이 CDR-H3의 절대 좌표 오차를 측정 | 낮음 |
| DockQ | docking 품질을 종합적으로 평가 | 높음 |
데이터셋과 분할
2022년 11월에 수집한 SAbDab 데이터로 학습
평가는 전문가가 고른 60개의 다양한 항원-항체 복합체로 구성된 RAbD benchmark에서 수행
학습/검증 데이터는 CDR-H3 cluster 기준으로 9:1로 나눔
cluster는 CDR-H3 서열 유사도가 40% 이상인 항체들을 묶은 것이고, 이 유사도는 BLOSUM62 substitution matrix로 계산
테스트셋과 같은 cluster에 속한 항체는 제거해 일반화 성능을 더 엄격하게 평가
clustering은 MMseqs2로 수행
| 구분 | 항체 수 | cluster 수 |
|---|---|---|
| train | 3,256 | 1,644 |
| validation | 365 | 182 |
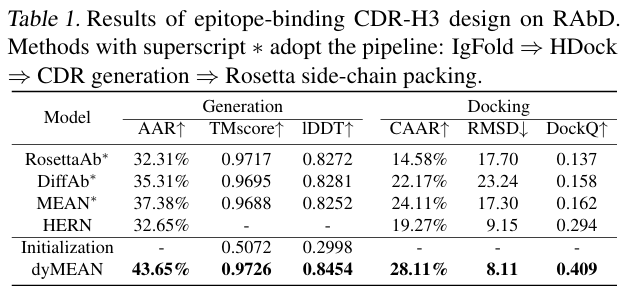
dyMEAN이 1D 서열 복원, 3D 구조 복원, 결합 interface 복원에서 모두 우수
파이프라인 방식은 각 단계의 오류가 다음 단계로 누적될 수 있음
dyMEAN은 end-to-end 방식이라 이런 누적 오류를 줄일 수 있음
dyMEAN은 1D 생성과 docking에서도 좋음
-> 항체 전체 문맥, 즉 framework region까지 포함한 full-context geometry를 모델링하는 것이 중요하다는 근거
Initialization만 했을 때 TMscore 0.5072, lDDT 0.2998로 어느 정도 의미 있는 구조는 얻지만, 성능은 충분하지 않음
-> 따라서 이후의 AME message passing이 중요
✅ Complex Structure Prediction
완전한 항체 서열이 주어졌을 때 항원-항체 복합체 구조를 잘 예측하는가
평가는 IgFold 논문에서 사용한 51개 항원-항체 복합체 테스트셋에서 수행
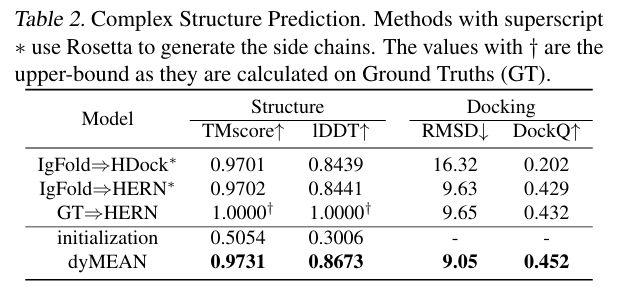
dyMEAN은 구조 예측과 docking 모두에서 다른 방법보다 좋음
흥미로운 점은 IgFold가 pretrained antibody language model embedding을 쓰고, AlphaFold에서 얻은 38k개의 추가 항체 구조를 학습에 활용했음에도, dyMEAN이 TMscore와 lDDT에서 더 좋은 성능을 냈다는 점
-> dyMEAN이 항체 구조 분포를 더 잘 학습함
GT → HERN은 실제 항체 구조를 입력으로 쓰는 유리한 조건인데도, dyMEAN의 DockQ가 0.452로 더 높음
-> dyMEAN이 단순히 항체 구조를 잘 만드는 것을 넘어, 에피토프와 항체 사이의 상호작용을 full-context geometry로 더 잘 포착한다는 근거
✅ Affinity Optimization
기존 항체를 변형해 결합 친화도를 높일 수 있는가
∆∆G는 GNN 기반 predictor가 예측
FoldX를 affinity predictor로 사용한 결과는 Appendix K
평가는 SKEMPI V2.0 항체들에서 수행
dyMEAN을 이 과제에 맞추기 위해 저자들은 다음을 수행
(1) 복합체 graph representation 위에 MLP를 추가로 학습해 ∆∆G predictor를 맞춤
(2) gradient search로 모든 잔기의 초기 상태 중 더 높은 affinity를 낼 가능성이 있는 방향을 찾음
각 테스트 항체에 대해 100개 후보를 만들고, ∆∆G가 가장 좋은 top-1 후보의 ∆∆G와 ∆L을 기록
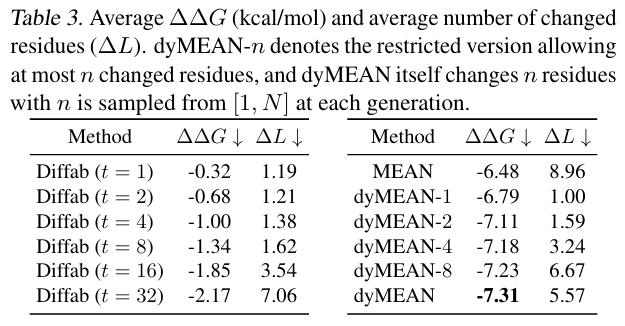
dyMEAN은 평균 ∆∆G가 가장 낮음
✅ Analysis
✅ ablation study
| 제거/변경 요소 | 의미 |
|---|---|
| T | generation iteration 수 |
| full-atom geometry | backbone뿐 아니라 side-chain까지 보는지 |
| sharing | shadow paratope와 native paratope 사이의 정보 공유 |
| wi wjᵀ | Eq. 12의 learnable channel weights |
| memory term φd | Eq. 16의 memory term |
| Ldist | Eq. 23의 external distance prediction loss |
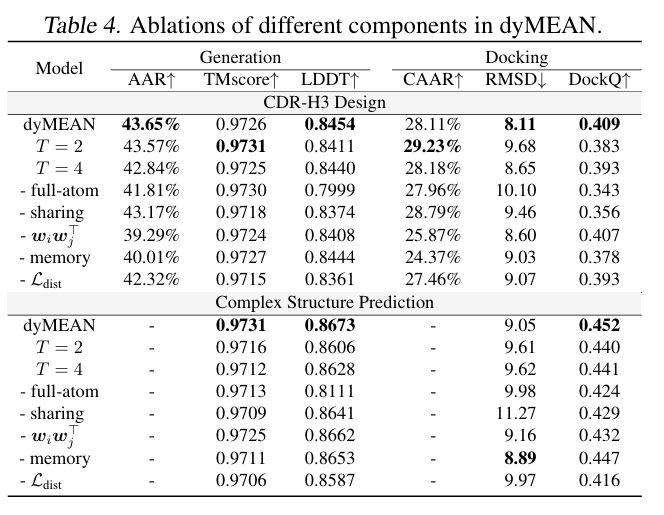
(1) iteration 수 T는 주로 docking 성능에 영향을 줌
dyMEAN에서 사용한 T=3이 전반적으로 가장 좋은 성능
(2) full-atom geometry를 제거하면 전체 성능이 크게 나빠짐
-> side-chain conformation 를 포함하는 것이 중요하다는 뜻
(3) shadow paratope와 native paratope 사이의 정보 공유는 구조 생성과 docking에 특히 중요
sharing을 제거하면 CAAR을 제외한 대부분 지표가 크게 떨어짐
(4) learnable channel weights wi wjᵀ는 서로 다른 원자 채널에 대한 attention처럼 작동
제거하면 성능에 손해
residue마다 원자 수가 다르고, 어떤 원자가 더 중요한지도 다름
learnable weight는 “지금은 이 원자 관계를 더 봐야 한다”는 가중치 역할
(5) memory mechanism은 CDR-H3 design에는 도움이 되지만, complex structure prediction에서는 필수적이지 않음
CDR-H3 서열 hidden state 정보가 memory term의 영향을 크게 받지만, 3D 좌표는 다음 iteration으로 직접 전달되기 때문
(6) external distance prediction loss Ldist는 docking에 중요
특히 초기 iteration에서 좌표만으로는 shadow paratope 구조를 정확히 복원하기에 부족할 수 있음
✅ CDR-H3뿐 아니라 여러 CDR 또는 전체 항체 설계로 확장할 수 있는지
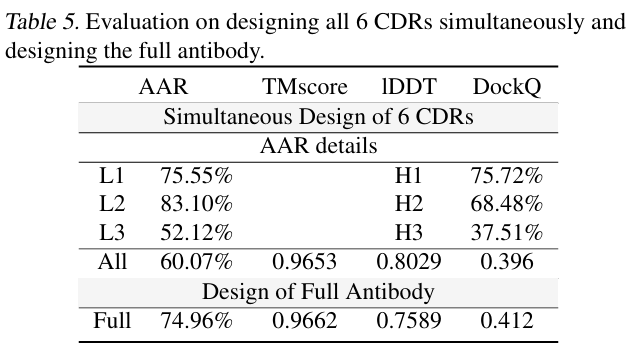
- 전체 항체 설계에서는 AAR이 크게 좋아짐
CDR-H3를 제외한 항체의 다른 부분, 특히 framework region이 더 규칙적이고 보존적이기 때문에 예상 가능한 결과
- lDDT는 나빠짐
residue type을 모르는 상태에서 아미노산 종류와 side-chain geometry를 동시에 생성하는 일이, 이미 residue type을 알고 framework region의 side-chain만 생성하는 것보다 어렵기 때문
- backbone 생성 성능인 TMscore / docking 성능인 DockQ
CDR-H3 design 실험과 비슷하게 유지
✅ Limitations
✅ 항원-항체 데이터의 다양성이 부족하다
학습 데이터의 CDR-H3 각 위치에서 가장 자주 등장하는 아미노산을 확인
양쪽 끝에서 가운데 방향으로 맞춰 보니 다음과 같은 unigram pattern이 나옴
ARDGDY**
대부분의 는 Y
이 단순한 unigram pattern만으로 테스트셋에서 AAR 39.61%, CAAR 26.57%가 나옴
-> 모델이 실제로 항원-항체 상호작용을 배운 것이 아니라, 데이터에 자주 나오는 CDR-H3 패턴을 외워서 좋은 점수를 얻을 수도 있음
dyMEAN의 Table 1 AAR은 43.65%
그런데 CDR-H3의 앞 4개 잔기와 뒤 2개 잔기를 제거하고 평가하면 dyMEAN의 AAR은 31.76%로 떨어짐
-> 기존 평가 지표가 unigram pattern의 영향을 받을 수 있음을 보여줌
✅ Reliability of Computational Energy Functions
실제 실험으로 평가한 것이 아닌,
deep-learning 기반 ∆∆G predictor 와 energy function 기반 foldX 로 평가함
✅ Conclusion
dyMEAN은 에피토프와 불완전한 항체 서열이 주어졌을 때 end-to-end로 항체를 설계하는 full-atom 모델
(1) knowledge-guided structural initialization
항체의 보존적인 구조 정보를 활용해 초기 구조를 더 그럴듯하게 잡음
(2) shadow paratope
E(3)-equivariant message passing과 docking을 위해 사용하는 가상의 paratope
(3) adaptive multi-channel encoder
full-atom modeling에서는 residue마다 원자 수가 다름
-> 이 encoder는 그런 가변적인 원자 수를 처리할 수 있음
✅ Supplements
✅ Details of the Structural Initialization
✅ Channel Attributes and Weights
✅ Proof of Theorem
✅ Adaption for Property Optimization
✅ Huber Loss
✅ Experiment Details
- 1D sequence overfitting 방지
1D sequence 학습이 3D structure 학습보다 더 빠르게 진행되어, CDR-H3 design에서 sequence overfitting이 생길 수 있음
이를 완화하기 위해 training 초기에는 paratope residue 일부를 mask하지 않고 보여줌
이후 점점 모든 paratope residue가 mask되는 최종 설정으로 이동
✅ Space Complexity Analysis
✅ Side-Chain Dihedral Angles
✅ Threshold for Defining Conserved Residues
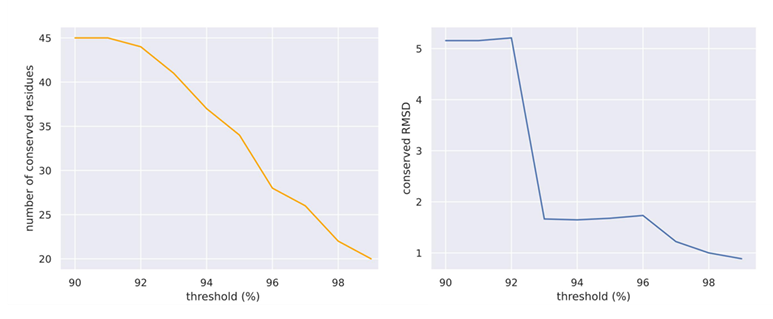
threshold를 낮추면 conserved residue 수는 점점 증가하고, 90% threshold 근처에서 안정화
RMSD는 92% threshold에서 급격히 증가
-> 두 요소를 균형 있게 고려할 때 93%-96% 사이가 적절하다고 판단
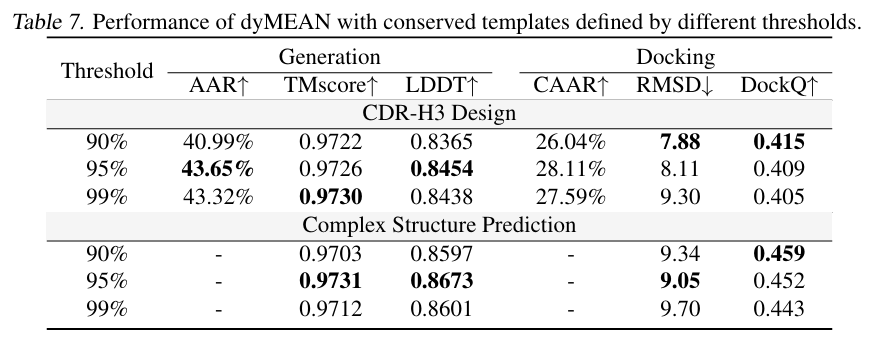
95% threshold가 모든 지표에서 항상 최고는 아님
CDR-H3 design의 DockQ는 90%가 가장 높고, CDR-H3 design의 TMscore는 99%가 가장 높음
하지만 전반적으로 보면 95%가 AAR, lDDT, CAAR, complex structure prediction의 TMscore/lDDT/RMSD에서 좋은 결과를 내므로 가장 균형 잡힌 선택이라고 판단
✅ Selection of the Shadow Paratope in Docking
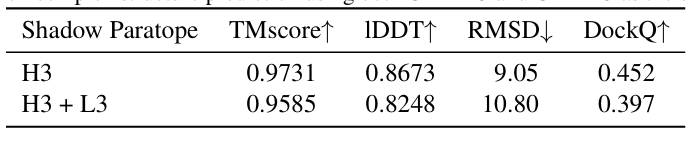
CDR-H3에 CDR-L3까지 추가하면 모든 지표가 떨어짐
저자들은 그 이유를 H3와 L3가 구조상 공간적으로 떨어져 있기 때문이라고 추측
-> 두 CDR의 상대 위치까지 정확히 파악해야 하므로 문제 난이도가 올라간다는 것
✅ Affinity with FoldX
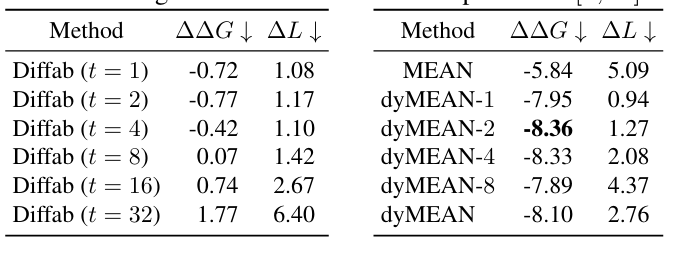
FoldX 기준에서도 dyMEAN 계열이 가장 좋음
✅ Trial on General Proteins
dyMEAN을 항체가 아닌 일반 단백질 complex에도 적용해 본 실험
CATH dataset에서 protein complex를 선택
각 complex를 receptor와 ligand로 나눔
ligand에서 receptor와 상호작용하는 residue를 찾고, 이 interacting residue들을 mask해서 생성 대상으로 둠
ligand의 나머지 부분은 framework처럼 사용
총 valid data 수 6883개
e2e setting에서는 항체 특화 structural initialization을 쓸 수 없으므로, ESMFold로 initial structure를 제공
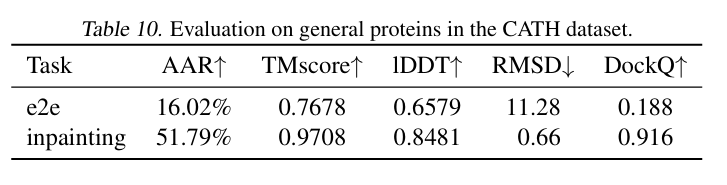
inpainting setting에서는 dyMEAN이 매우 좋은 성능
framework 구조와 docking 위치가 이미 주어지면, interacting residue를 채우는 문제는 잘 해결
e2e setting에서는 성능이 크게 낮음
binding position에 대한 prior knowledge 없이 binding interface를 설계하는 것은 훨씬 어려움
✅ Samples