AI
규칙기반(Rule-Based)
1~4강에서 배웠던 프론트엔드,백엔드,DB,배포까지는 전부 다 사람이 직접 규칙을 코드로 썼다.
이 흐름에 해당하는 코드를 개발자가 직접 작성
사용자가 로그인 버튼을 누름 > 이메일+PW를 서버로 전송 > 서버는 DB에서 조회 > 일치 : 세션 발급 / 불일치 : 오류 리턴 > 결정론적 시스템 / 같은 입력 = 같은 출력
규칙으로 풀기 어려운 문제들이 생김
강아지 고양이 구분, 인식 / 필체 인식 / 음성 인식 / 스팸 메일(기준이 모호함)
-> 이들의 공통점은 규칙이 명확하지 않음 / 예외가 존재함 / 경계가 흐림
기존 프로그래밍의 한계
-> 입력 - 사람이 정한 규칙 - 출력
EX) 계좌이체, 세금, 계산, 회계 > 수학적으로 규칙 정의가 가능함.
But 이미지, 자연어 처리 > 규칙을 정의하기도 애매함
조건이 많은데 예외도 많음 > 판별이 안됨 / 조합 폭발 (Combination Explosion)
여러가지 조건들이 붙으면서 > 규칙이 너무 많아지며 규칙들끼리 충돌함
유지보수 문제 : 스팸 필터 사례
ex) 메일의 제목이나 내용에 무료라는 말이 있으면 스팸
-> 무@료, 무#료, 무!료 등의 우회를 하여 뚫어낼수 있음, 규칙을 추가하면 우회방식이 증가함
-> 규칙 과적합 Rule Overfitting
규칙을 정하는건 사람. 사람은 모든 예외 상황을 예측할 수 없다.
그래서 규칙을 사람이 작성하는게 아닌 데이터를 기반으로 컴퓨터가 스스로 규칙을 찾게 한다.
-> 머신러닝의 등장
머신러닝
데이터로부터 패턴을 학습해서 새로운 데이터에 대한 예측 및 판단을 하는 방법
-
기존의 프로그래밍 : 데이터 + 규칙 > 결과
머신러닝 : 데이터 + 결과(정답) > 규칙(모델) > 규칙(모델) 컴퓨터가 스스로 만들어낸다. -
사람이 규칙을 코드로 쓰는 대신 데이터와 데이터에 대한 정답(레이블)을 입력하면 컴퓨터가 스스로 규칙에 해당하는 모델(수학적 함수 f(x))을 만든다. > 이 과정을 학습(Training)이라고 하고 결과물을 모델(Model)이라고 한다.
-
머신러닝이 쓰이는 분야
-> 추천 시스템(쇼핑몰,넷플릭스),신용평가(나이,직업,소득,자산,연체 이력),이상탐지(이상한 거래 발생) -
Feature(특정) - 모델은 데이터를 그대로 받아들이지 않음. 데이터의 특징을 추출해서 입력으로 씀
원본 메일 > feature('무료'라는 단어의 등장 빈도, 'gmail', 7(링크 갯수)...) > f(x)
이 특징을 무엇을 기준으로 정할지, 어떻게 수치화 할지 > 사람이 해야함 / 이 작업을 Feature Engineering이라고 한다. Feature의 품질이 모델의 품질을 결정한다.
정형데이터를 쓰는 경우는 이 작업이 수월했다. 그러면 복잡한 비정형 데이터는?
이미지,음성,자연어는? 등 이슈가 생긴다
특징을 뽑는것도 컴퓨터를 시키면 안되나?
-> 딥러닝의 등장
딥러닝
딥러닝은 머신러닝의 한 종류
차이점은 특징 추출까지 자동으로 해준다.
데이터를 주면 특징 추출부터 최종 판단까지 전부 다 모델이 스스로 학습
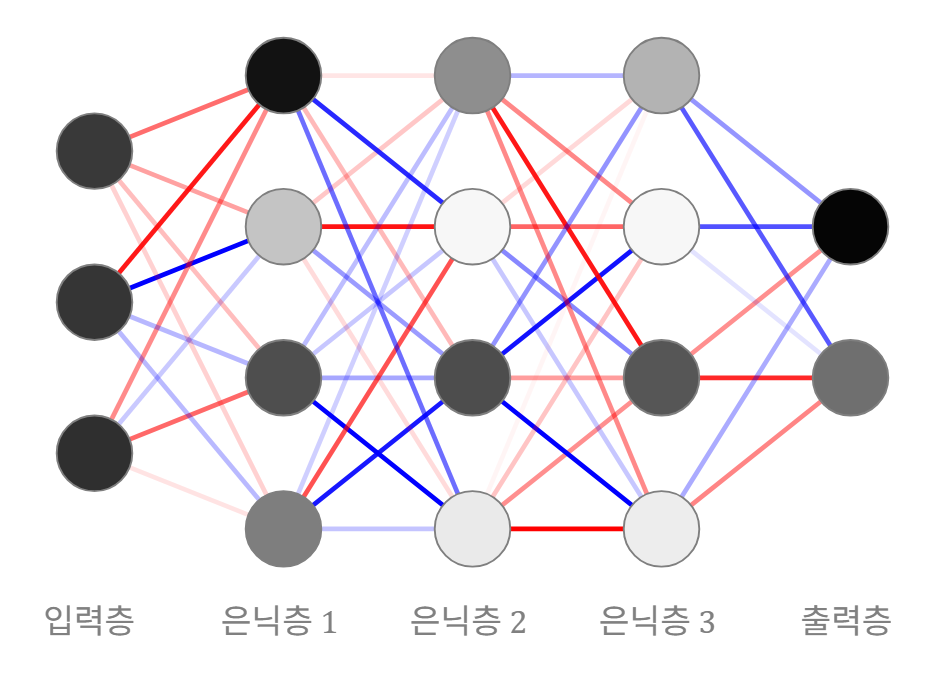
인공신경망 Artificial Nerual Network(ANN) 구조 기반
하나의 뉴런(노드)은 여러 입력값을 받아 각각의 가중치(Weight)를 곱하고 그 합에 편향을 더한 뒤 활성화 함수(Activation Function)를 통과시켜 출력값을 낸다,
이 뉴런들이 층(Layer)을 이루고 층이 여러개 쌓인 구조 > 신경망
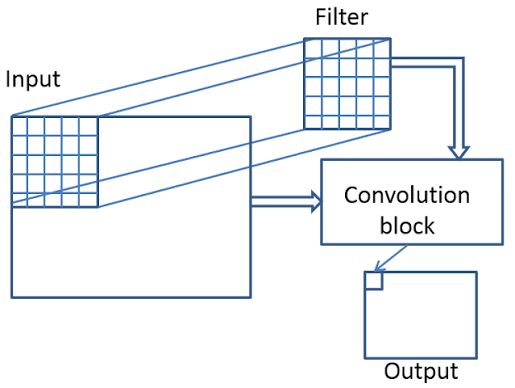
CNN Convolution Neural Network - 합성곱 신경망 : 이미지 처리에 특화
-> 이미지의 공간적 구조를 활용
원본 이미지에 필터를 슬라이딩 시켜서 국소 패턴을 감지한다 > 이미지 전체를 훑어보고 이 위치에 수평선이 있는가?에 대한 답을 0~1로 준다.이 필터값들 자체가 학습을 통해서 정해진다. 사람이 수평선을 탐지하는 필터를 만들 필요가 없다. 모델이 스스로 유용한 필터를 만들어낸다.
데이터 : 딥러닝 모델의 성능은 전적으로 데이터의 양과 질에 의존한다.
파라미터 : 모델내부에서 학습을 통해 조정되는 수치값. 신경망에서 뉴런 간의 연결 강도 = 가중치. 가중치 전체 = 파라미터
모델을 제대로 학습시키려면 가중치에 상응하는 양의 데이터가 필요
2000년대 이후 엄청 많은 양의 레이블 된 데이터가 생겨났다.
레이블 - 데이터에 붙이는 정답 / 입력 + 정답 쌍으로 학습할 수 있게 됨
딥러닝 모델을 처음 초기화하면 모든 가중치가 무작위 값으로 설정됨
학습의 목표 : 손실 값 최소화, 가중치 조정
이 조정을 담당하는 알고리즘
역전파(Backpropagation) - 손실이 각 가중치에 얼마나 기여했는지 계산하는 알고리즘
경사하강법(Gradient Descent)
함수의 변화량을 이용하여 계수를 조정하는 방식으로, 함수가 줄어드는 방향으로 계수를 계속 갱신해 나간다. 개발자는 함수가 한 번에 얼마나 줄어들게 하는지를 결정하는 패러미터를 정해야한다. 이 패러미터가 너무 작으면 최적화가 너무 오래걸리고 너무 크면 최솟값을 지나칠 수 있다.
학습률(Learning Rate)
'조금'의 크기를 결정하는 것. 학습률이 너무 크면? 최적값을 지나침/너무 작으면 수렴하는데 오래 걸림
이걸 수백만개 데이터 * 수십~수천번 반복
전체 데이터를 1회 돌리는것 => 1 에포크(Epoch)
과적합(Overfitting)
딥러닝 모델이 훈련 데이터에 지나치게 적응하여 처음보는(새로운) 데이터에 대해서는 성능이 많이 떨어지는 현상
학습데이터로부터 일반적인 패턴을 추출한게 아니라 학습 데이터 내부의 고유 노이즈, 특이 패턴을 통째로 외워 일반적인 추세를 포착하는데 실패한 결과로 발생
Dropout
학습 도중에 매 단계마다 일정 비율의 노드를 무작위로 비활성화 시킴. 학습시에 특정뉴런(노드)에 과도하게 의존하는 상태(과적합) 방지 > 모델이 더 다양한 경로로 정보를 학습하게 만든다.
정규화(Regularization)
가중치 값이 지나치게 커지는 것을 억제. 수학적 패널티를 손실함수에 추가함
Dropout과 Reglarization 모두 모델이 학습 데이터를 외우는 것을 방지. 일반화 하는 능력을 높이기 위함
딥 러닝의 확산
- 이미지 인식 및 처리
- resnet : 잔차 연결
- 음성 인식 활성화
- 사전에 정의된 음소 단위에 의존하지 않게 됨
- 원시 음성 신호 -> feature 직접 학습
- 번역
- PMSMT(Phrase(어구) 기반 번역 후 통계적 조합) > NMT (인코더 원문 전체 읽기, 의미를 하나의 고정 크기 수치 배열 즉, 벡터로 압축, 디코더 활용)
(벡터 : 여러 숫자들이 순서 있는 배열 의미나 특징을 수치공간에 표현한 것) - 번역 품질 올라감, 어순이 다른 언어에서 특히 좋아짐
- PMSMT(Phrase(어구) 기반 번역 후 통계적 조합) > NMT (인코더 원문 전체 읽기, 의미를 하나의 고정 크기 수치 배열 즉, 벡터로 압축, 디코더 활용)
- 게임
- 알파고
-> 다음 수의 확률 + 승률 평가 -> MCTS랑 결합
- 알파고
머신러닝
- 강화학습 : 에이전트가 환경과 상호작용하며 보상을 최대화하는 최적의 행동 양식을 찾아가는 머신러닝 기법
- 지도학습 : 정답이 포함된 데이터를 바탕으로 컴퓨터를 훈련하여 새로운 데이터의 결과를 예측하는 인공지능 및 머신러닝 기술
- 비지도학습 : 컴퓨터가 정답이 없는 데이터 속에서 스스로 패턴과 구조를 찾아내는 머신러닝 방식
모든 모델이 특정 Task 전용
서로 전혀 다른 구조와 파라미터를 가졌다. > 하나는 매우 잘함, 하지만 그 이상은 없음
딥러닝
LLM(Large Language Model)
-> 자연어 처리가 문제
NLP(Natural Language Processing / 자연어 처리)
컴퓨터는 숫자만 처리
-
이미지는 픽셀 값 배열 > 수치
-
음성은 파형 샘플링 > 수치
-
언어 > 수치화 해야함
하지만 유사성을 파악할 방법이 없거나 단어만으로는 문맥 파악이 안되는 문제가 있음
그래서 Word2Vec가 등장함.
비슷한 맥락의 단어들은 벡터 공간에서 가깝게
의미 관계가 벡터 연산으로 성립 > 의미가 방향과 거리로 표현이 가능해졌다
단어랑 단어랑 의미관계가 수치 공간안에서 표현됨
단어나 문장 같은 언어 요소를 벡터공간에 고정 크기의 수치 벡터로 변환 > 임베딩(Embedding)
-> 언어 모델의 근간
word2Vec의 한계
-> 고정된 벡터를 사용한다. '배'라는 단어는 어떤 문맥에서 쓰이던 항상 같은 벡터로 표현됨 > 다의어 처리 불가
RNN (Recurrent Neural Network / 순환 신경망) & LSTM (Long Short-Term Memory) -> 순차 데이터 Sequential Data 처리
순차 데이터 - 순서가 의미를 결정한다. 문장의 단어 순서, 음성의 시간 순서
RNN
앞에서 뒤로 한 단계씩 처리, 이전의 결과가 이후의 결과 쓰임. 지금까지 읽었던 걸 기억한다. 앞쪽에서의 맥락을 기억하면서 처리가 가능해짐
-
기울기 소실 (Vanishing gradient)
- 역전파 과정에서 기울기가 시간 방향을 거슬러 올라감. 단계마다 점점 값이 작아지고 결국엔 사라짐
- 문장이 길어지면 앞부분의 정보가 사라짐 > 학습에 제대로 반영이 안됨
- 역전파 과정에서 기울기가 시간 방향을 거슬러 올라감. 단계마다 점점 값이 작아지고 결국엔 사라짐
-
LSTM
RNN의 장기 의존성 문제를 해결하기 위해서 나온 모델
-
입력 게이트 : 학습 가능한 수치로 제어, 새 정보를 얼마나 받아들일지
-
망각 게이트 : 기존의 기억을 얼마나 지울지 제어
-
출력 게이트 : 현재 기억에서 얼마나 출력할지 제어
==> 중요한 정보는 오래 유지하고, 불필요한 정보는 지움
문제 2. 병렬 처리 불가
RNN은 단어를 순서대로 처리해야함 > GPU를 써야하는데 병렬처리 안됨
-> 문장이 길어질수록 학습시간이 선형 증가
트랜스포머(Transformer)
논문 Attention is All You Need 에서 발표한 인공신경망 구조로 기존의 순환 신경망(RNN)과 합성곱 신경망(CNN)의 한계를 극복하며 등장하였다.
주로 자연어 처리(NLP) 분야에서 혁신을 일으켰으며, 기존의 RNN이나 LSTM 기반 모델들이 가지고 있던 장거리 의존성 문제와 병렬 처리의 한계를 어텐션 메커니즘만으로 해결하고자 설계
