Transformer
1. 텍스트는 어떻게 잘리는가?
-> 한 문장이 토큰 시퀀스로 바뀌는 과정
learn about language model tokenization
사람이 글을 읽을때는 글자 하나하나를 따로 보나?
-> 단어 덩어리 단위로 인식함
LLM도 자기만의 조각 단위로 나눠서 처리한다 -> 이 조각이 '토큰'
토큰은 단어 전체가 될 수도 있고, 단어의 일나 글자 조합이 될 수도 있다.
모델이 실제로 무어슬 처리할지 결정, 비용과 처리 용량에도 직접적으로 영향을 준다.
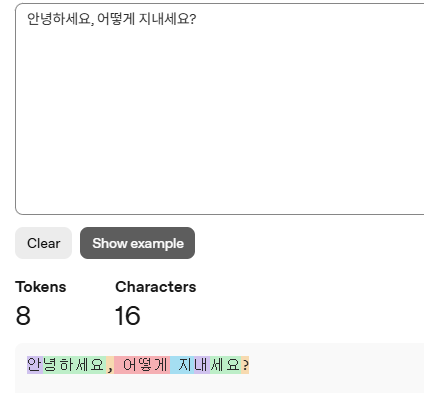
안녕하세요, 어떻게 지내세요? -> 토큰 8개
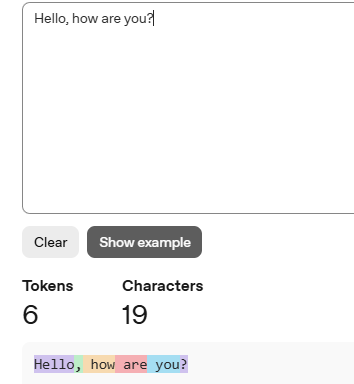
Hello, how are you? -> 토큰 6개
한국어는 하나의 단어가 여러 조각으로 잘린다.
영어는 같은 의미를 더 적은 토큰으로 표현할 수 있다.
모델은 한번에 처리할 수 있는 최대 토큰 수가 동일하다면 한국어 사용자는 더 적은 내용을 담을 수 있다.
-> 한국어는 영어보다 단어당 토큰 개수가 많아 LLM을 사용할 때 비용적으로 다소 불리함
2. 단어가 수치가 되는 순간
-> 벡터 공간에서의 거리로 표현
컴퓨터는 텍스트를 그대로 처리하지 못함 > 모든 것이 숫자로 변환되어야 함
단어를 일정한 크기의 숫자 묶음으로 변환하는 것 > 임베딩
GPS : 특정 위치를 숫자로 표현
임베딩 : 단어의 의미적 위치를 숫자로 표현
의미적으로 가까운 단어는 이 숫자 공간 안에서도 가깝다
0~1표현 : 0에 가까울수록 의미적으로 멀고 1에 가까울수록 의미적으로 가깝다.
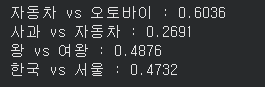
small VS large : 맥락에 따라서 달라지는 단어의 의미 차이 (ex : apple, apologize = 사과)
-> 문맥 의존적 표현(Contextual representation)
: 사과를 먹었다의 사과와 사과를 했다의 사과는 다른 것. 그래서 다른 벡터로 표현되는 현상
==> 트랜스포머 내부 레이어에서 일어나는 일
3. 어텐션, 문맥
-> 어떤 단어가 어떤 단어를 보고 있는가
어텐션 : 트랜스포머의 핵심 메커니즘
'그 소설의 결말은 충격적이였다' -> '충격적'이 수식하는 대상이 '결말'인 것을 파악하는 것이 Attetion의 역할
모델은 각 단어가 다른 단어들과 얼마나 관련 되어있는지 계산함.
검색 : Transformer explainer -> 시각화
Q Query : 나는 지금 무엇을 찾고 있나
K key : 나는 어떤 정보를 갖고 있나
V Value : 실제로 전달할 내용
Q랑 K가 잘 맞는 쌍일수록 그 밸류가 최종 결과에 더 많이 반영됨
트랜스포머 블록 총 12개
이 어텐션은 수십에서 수백개의 연산을 동시에 처리하고 각 헤드는 서로 다른 역할을 분담한다.
어떤 헤드는 문법적 관계를, 어떤 헤드는 의미적 연관, 어떤 헤드는 위치적 관계를 맡는다.
이 구조 덕분에 모델은 같은 문장을 서로 다른 시각에서 파악이 가능하며, 동시 분석하고 그 결과를 합쳐서 최종 확률 목록을 뽑아낸다. 다만 이를 하기 위해서는 상당히 많은 연산을 해야한다.
4. 다음 한 단어를 어떻게 고르는가?
-> 확률분포와 생성 전략
다음 단어를 고를때 LLM이 어떤 결정을 내리는지
모델은 다음에 올 수 있는 모든 단어에 각각 확률을 부여하고 그 중 하나를 뽑는다.
어떤 방식으로 뽑느냐? > 출력의 다양성과 일관성을 결정짓는다.
같은 입력이면 같은 답이 나오나 > 같은 입력이어도 매번 다른 답을 한다
-> 모델은 항상 1등만 고르지않는다
매 스텝마다 전체 어휘의 확률을 구함
temperature
모델이 출력을 생성할때 다양성(diversity)과 창의성(creavtivty)의 정도를 결정하는 설정값이다.
temperature는 이 분포의 형태를 조정함
temperature가 낮으면 분포가 날카로워짐
-> 결정적. 매번 같은 답 - code,fact에 적합 / 가장 높은 확률의 토큰이 거의 항상 선택됨
temperature가 높으면 분포가 평평함
-> 낮은 확률의 토큰도 선택할 기회가 생김
temperature가 0에 가까울 수록 결정적. 높을수록 창의적이지만 일관성이 낮아짐
top-p는 조금 다른 방식
-> 확률 순서대로 단어를 나열한 후, 확률 합(가능성이 높은 단어들의 누적 확률)이 P(특정 임계값)에 도달하는 지점까지만 후보로 남기고 나머지는 탈락
상위 후보에서 그 중 하나가 뽑힌다. 꼬리는 후보에서 제외시킴
top-p가 0.9라면 상위 90%확률에 해당하는 단어들로 후보들을 유기함
이렇게하면 너무 말이 안되거나 말이 되더라도 어색한 단어가 선택될 가능성이 낮아짐
temperature랑 top-p를 같이 조정해서 문장 생성 품질 향상이 되도록 다듬는다.
temperature는 분포의 형태를 바꾸고(날카롭게 - 결정적, 평평하게 - 창의적), top-p는 후보의 범위를 자른다.
번외로 top-k라는것도 있다.
Top-K 샘플링에서는 모델이 예측한 단어들 중 확률이 가장 높은 상위 K개의 단어만을 고려한다.
예를 들어, K=3인 경우:
-
5. LLM의 한계
-> 코드로 직접 테스트
-
할루시네이션
대화형 인공지능이 대화를 생성할 때, 사실과는 전혀 다른 텍스트를 마치 진실인 듯 답변하는 현상을 뜻한다.
"2019년 한국 인공지능학회지에 게재된"
"'한국어 감성 분석을 위한 계층적 문맥 임베딩 모델'이라는 논문의"
"주요 내용과 저자를 요약해줘"
라는 프롬프트를 작성했을 때
''한국어 감성 분석을 위한 계층적 문맥 임베딩 모델'은 한국어 텍스트의 감성을 분석하기 위해 제안된 모델에 관한 논문입니다. 이 연구에서는 감성 분석의 정확도를 높이기 위해 계층적 문맥 임베딩 기법을 도입하였으며, 다양한 문맥 정보를 효과적으로 통합함으로써 한국어의 특성을 반영한 감성 분류를 개선하고자 했습니다.
논문은 먼저 감성 분석의 필요성과 기존 방법들의 한계를 논의하고, 이어서 제안하는 계층적 문맥 임베딩 모델의 구조와 동작 원리를 상세히 설명합니다. 이 모델은 문장의 구조적 정보를 활용하여 더욱 정교한 임베딩을 생성하고, 그 결과로 한국어 텍스트의 감정을 보다 정확하게分類할 수 있는 알고리즘을 제시합니다.
저자에 대한 특정 정보는 요청하신 내용에는 포함되어 있지 않으나, 보통 이러한 논문은 관련 분야의 연구자들이 주로 공동 저자 형태로 작성하는 경우가 많습니다. 자세한 저자 정보를 알고 싶다면 해당 논문의 원문이나 학회지를 검색해 보시는 것이 좋습니다.' 라고 답변함
모델 입장에서는 모른다고 하는것 보다 그럴듯한 내용을 생성함. 다음 토큰 예측 확률 분포상 이게 더 자연스러워서
지식의 단절(knowledge cutoff)
"오늘 날짜와 현재 달러/원 환율 알려줘" 라는 프롬프트를 작성했을 때
죄송하지만, 실시간 정보 제공은 제공할 수 없습니다. 오늘 날짜와 현재 달러/원 환율을 확인하시려면 금융 사이트나 뉴스 앱을 참고하시기 바랍니다. 도움이 더 필요하시다면 말씀해 주세요! 라고 답변함
실시간 데이터를 모름, 모델 단독으로 해결할 수 없음. -> tool use라는 개념이 필요
Tool Use(툴 사용) : 툴 사용은 LLM이 검색,계산기,코드 실행, 외부 API같은 도구를 호출해 스스로의 한계를 넘어 능력을 확장하는 것을 말한다. AI 에이전트의 핵심 동작 원리이며, 실제 구현은 함수 호출 메커니즘으로 이뤄진다.
