RAG
Retrieval-Augmentd Generation
LLM의 한계
- 할루시네이션 : 없는 말 지어내기
- 지식 단절 : 학습 시점 이후는 모름
- 컨텍스트 윈도우 제약 : 문서가 길면 한 번에 다 넣고 처리 못함
RAG는 위의 한계를 직접적으로 공략한다.
Retrieval-Augmentd Generation (검색-증강 생성)
-> 검색을 통해 정보를 저장함
RAG는 챗봇에 많이 쓰임.
Gemma4 -> Google 오픈소스 모델. 자신의 컴퓨터에서 돌릴수 있음 / GPT나 클로드에 사내 민감 정보를 보내지않아도 되어 보안문제가 발생하지않는다.
Ollama
!apt-get install -y zstd > /dev/null
!curl -fsSL https://ollama.com/install.sh | sh
!pip install -q ollama
import subprocess, time
proc = subprocess.Popen(["ollama", "serve"],
stdout=subprocess.DEVNULL,
stderr=subprocess.DEVNULL)
time.sleep(5)
!ollama pull gemma4:12b
import ollama
response = ollama.chat(
model = "gemma4:12b",
messages = [{"role" : "user", "content" : "질문"}]
)
print(response["message"]["content"])
만약 Gemma4같은 모델한테 사내 규정 문서를 알려준다고 가정했을때
RAG의 구조로 이걸 해결하자. 관련된 부분만 찾아서 넣자 > 핵심
어느 부분을 어떻게 넣을건데?
1. 데이터 수집, 정규화 -PDF,DOCX,CSV
-> 깨끗한 텍스트와 일관된 메타데이터
청킹 - RAG의 첫 단계. 긴 문서를 작은 덩어리로. 우리는 긴 문서를 AI가 한번에 소화할 수 있는 단위로 쪼갬
-
작은 청킹
검색이 매우 세밀해져 질문과 정확히 맞는 부분을 찾아낼 확률이 높음
하지만 맥락이 잘려 나가 의미 단절이 발생할 수 있음, 청크가 많아질수록 임베딩 비용과 벡터 DB 저장 공간이 급격히 증가(비용 up) -
큰 청킹
문맥 보존에 유리하고, 전체 흐름을 함께 제공 가능
하지만 불필요한 정보깢 함께 검색 결과에 포함되어 정확도가 떨어질 수 있음, 청크 수가 줄어 비용면에선 효율적이지만 검색 품질 저하 위험이 있음
기업에서 다루는 데이터는 깔끔한 모양의 텍스트로 존재하지 않을 경우가 더 많다
RAG 임베딩과 검색이 다룰 수 있는 것은 의미를 담은 텍스트이다. 또는 이에 준하는 벡터화가 가능한 표현이다.
그래서 RAG의 진짜 1단계 : Ingestion(데이터 수집) 및 정규화. 우리 데이터를 검색 가능한 표현으로 바꿔줌
데이터의 종류가 다름. 데이터의 종류마다 ingestion 방식이 다름.
이 단계를 Ingestion(수집) 계층. 즉 데이터 수집 및 정규화 계층이라고 함
- 기업 데이터
- 텍스트 추출형 : PDF, word, HTML . 그냥 추출
OCR 필요형 : 스캔문서, 이미지 PDF. 이미지에서 글자를 인식해서 변환 후 추출
구조형 데이터형 : DB, Excel, ERP 나오는 데이터들 -> 의미 검색은 X, 정확한 조회, RAG가 아니라 라우팅, 링킹이 더 적합. 쿼리, SQL의 문제. 이런건 RAG로 처리하는 것 보다 검색할때 SQL로 처리하는게 맞다.
전용 포맷 : CAD, 도면, 오디오, 3D -> 이런 데이터가 중요함. 이걸 필요로 하는 곳이 많음
- 텍스트 추출형 : PDF, word, HTML . 그냥 추출
청킹 전에 Ingestion(정규화)
2. CAD 데이터를 검색 가능하게
파일 검색
!pip install -q ezdxf matplotlib ollama
import os, shutil, subprocess
from google.colab import files
uploaded = files.upload()
src = next(iter(uploaded))
#파일명에 한글·괄호·공백이 있어서 단순한 이름으로 복사
shutil.copy(src, "input.dwg")
r = subprocess.run(["dwg2dxf", "-y", "-o", "input.dxf", "input.dwg"],
capture_output=True, text=True)
print(r.stderr[-1500:]) # 경고는 흔하니 파일이 생겼는지가 중요
print("DXF 생성:", os.path.exists("input.dxf"), os.path.getsize("input.dxf") if os.path.exists("input.dxf") else 0)
결과값
정보 추출
import ezdxf
from ezdxf import bbox, recover
from ezdxf.addons.drawing import matplotlib as dxfplot
from collections import Counter
def summarize_dxf(path, max_items=60):
try:
doc = ezdxf.readfile(path)
except ezdxf.DXFStructureError:
doc, = recover.readfile(path)
msp = doc.modelspace()
out = []
out.append(f"[원본 파일명] {src}")
out.append(f"[CAD 버전] {doc.dxfversion} ({doc.acad_release})")
out.append(f"[단위 코드 $INSUNITS] {doc.header.get('$INSUNITS', 0)}")
out.append("[레이아웃] " + ", ".join(doc.layouts.names()))
ext = bbox.extents(msp)
if ext.has_data:
out.append(f"[도면 범위] 가로 {ext.size.x:.0f} x 세로 {ext.size.y:.0f}")
layer_cnt = Counter(e.dxf.layer for e in msp)
out.append(f"[레이어 {len(doc.layers)}개]")
for layer in doc.layers:
n = layer.dxf.name
out.append(f" - {n}: 색상 {layer.dxf.color}, 선종류 {layer.dxf.linetype}, 객체 {layer_cnt.get(n, 0)}개")
out.append("[객체 종류별 개수] " + ", ".join(f"{k} {v}" for k, v in Counter(e.dxftype() for e in msp).most_common()))
blocks = Counter(e.dxf.name for e in msp.query("INSERT"))
if blocks:
out.append("[블록 삽입] " + ", ".join(f"{k} {v}" for k, v in blocks.most_common(20)))
texts = [e.dxf.text for e in msp.query("TEXT")] + [e.plain_text() for e in msp.query("MTEXT")]
out.append("[문자] " + " | ".join(t.strip() for t in texts[:max_items] if t.strip()))
dims = []
for d in msp.query("DIMENSION"):
try:
v = d.get_measurement()
dims.append(f"{v:.0f}" if isinstance(v, (int, float)) else str(v))
except Exception:
pass
out.append(f"[치수값 {len(dims)}개] " + " | ".join(dims[:max_items]))
dxf_plot.qsave(msp, "plan.png", bg="#FFFFFF", dpi=150)
return "\n".join(out)
info = summarize_dxf("input.dxf")
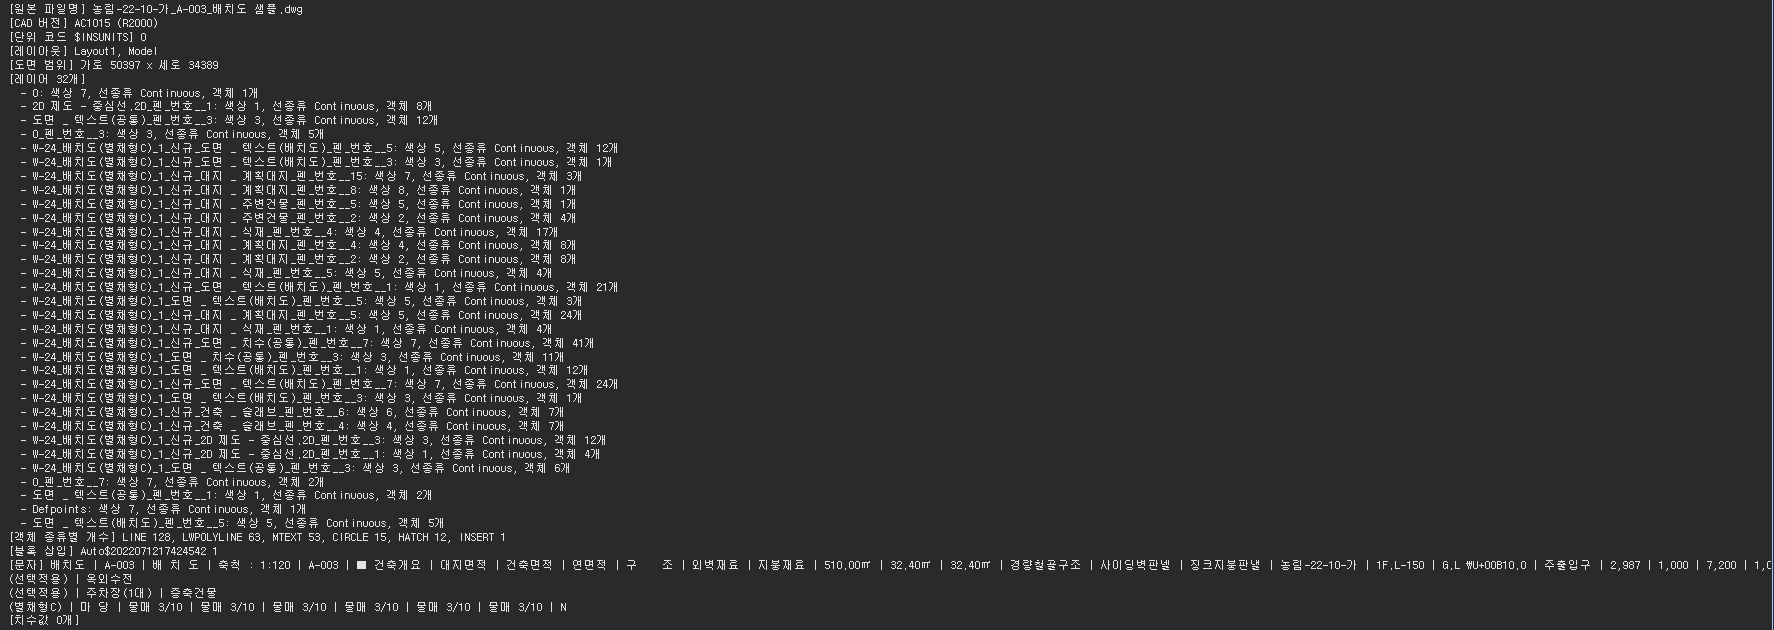
print(info)
- 결과값
import ollama
prompt = f"""다음은 CAD 도면(DWG를 DXF로 변환)에서 추출한 정보이고, 첨부 이미지는 해당 도면을 렌더링한 것입니다.
이 도면을 한국어 마크다운으로 분석해 주세요.
#1. 도면 개요
#2. 도면 구성 (단면·상세 부위)
#3. 치수 정보
#4. 도면의 기술적 정보 (CAD 버전, 레이어 구성과 각 레이어의 역할 등)
#5. 도형 및 기호
추출 정보에 없는 내용은 추측이라고 밝혀 주세요.
[추출 정보]
{info}
마지막 단계로 이 정보를 보기 좋게 표로 정리해주세요.
"""
response = ollama.chat(
model="gemma4:12b",
messages=[{"role": "user", "content": prompt, "images": ["plan.png"]}],
options={"num_ctx": 16384},
)
print(response["message"]["content"])
결과값
제공해주신 CAD 도면 데이터와 렌더링 이미지를 바탕으로 분석한 결과입니다.
#[도면 분석 보고서] 농림-22-10-가A-003배치도
1. 도면 개요
- 도면 명칭: 농림-22-10-가A-003배치도
- 도면 용도: 배치도 (Site Plan) - 부지 내 건물의 배치 및 주변 환경과의 관계를 나타내는 도면입니다.
- 건축 규모:
- 대지면적: 510.00㎡
- 건축면적: 32.40㎡
- 연면적: 32.40㎡
- 구조 및 재료:
- 구조: 경량철골구조
- 외벽재료: 사이딩벽판넬
- 지붕재료: 징크지붕판넬
- 스케일: 1:120
2. 도면 구성 (단면·상세 부위)
- 건축물 구성:
- 주건물 및 부속건물: 도면 내 두 개의 주요 영역이 해칭(Hatch) 처리되어 있으며, "별채형C"라는 명칭을 통해 주거 공간과 별채(Annex)로 구분된 구조임을 알 수 있습니다.
- 주차장: 1대의 차량이 주차 가능한 공간이 확보되어 있습니다.
- 부대시설:
- 장독대: 전통적인 요소인 장독대가 배치되어 있습니다.
- 옥외수전: 외부 수전 시설이 포함되어 있습니다.
- 주변 환경:
- 인접대지경계선: 부지의 경계가 명확히 구분되어 있습니다.
- 도로: 4M 폭의 현황도로와 접해 있습니다.
- 수계 및 관로: 상수관(본관 연결), 우수관(D-200 PE이중벽관) 등의 인프라 정보가 포함되어 있습니다.
3. 치수 정보
도면 내에 명시된 주요 수치(단위: mm 추정)는 다음과 같습니다.
- 주요 거리: 2,987 / 1,000 / 7,200 / 1,000 / 1,500 / 16,314 / 7,450 / 1,000 / 4,500 / 1,000 / 3,051
- 특이사항:
- GL(Ground Level): $\pm$10.0의 높이 정보가 포함되어 있습니다.
- FL(Finish Level): 1.150의 높이 정보가 포함되어 있습니다.
4. 도면의 기술적 정보
- CAD 버전: AC1015 (AutoCAD 2000 버전 기반)
- 단위 시스템: 기본 단위계(Unit) 설정값 0 (일반적으로 mm 사용)
- 레이어 구성 (총 32개):
- 구조 관련:
신규_건축_슬래브,신규_건축_2D 제도등 (건물의 물리적 구조 표현)- 조경/대지:
신규_대지_식재,신규_대지_계획대지등 (조경 및 대지 경계 표현)- 치수/문자:
치수(공통),텍스트(공통),텍스트(배치도)등 (설명 및 치수선)- 기타:
Defpoints,0등의 기본 레이어.- 도면 영역: 가로 50,397 x 세로 34,389 (내부 좌표계 기준)
5. 도형 및 기호
- HATCH (12개): 건물 내부 영역이나 특정 기능 구역을 구분하기 위한 채우기 패턴입니다.
- CIRCLE (15개): 도면 내 포인트(수전, 장독대, 식재 위치 등)를 강조하거나 기호로 사용된 것으로 보입니다.
- MTEXT (53개): 각종 치수, 면적, 설명(상수관, 우수관, 도면명 등)을 표기하는 텍스트입니다.
- LINE (128개) & LWPOLYLINE (63개): 경계선, 벽체, 도로 경계 등 모든 선형 요소에 사용되었습니다.
- 방위 표시: "N" 기호와 원형을 이용하여 북쪽 방향을 표시하고 있습니다.
[최종 요약표]
| 분류 | 항목 | 상세 내용 |
|---|---|---|
| 기본 정보 | 도면명 | 농림-22-10-가A-003배치도 |
| 스케일 | 1:120 | |
| 구조/재료 | 경량철골구조 / 사이딩벽판넬 / 징크지붕판넬 | |
| 규모 정보 | 대지면적 | 510.00㎡ |
| 건축/연면적 | 32.40㎡ | |
| 시설 구성 | 주요 시설 | 별채형C(주/부속건물), 주차장(1대), 장독대, 옥외수전 |
| 인프라 | 상수관(본관연결), 우수관(D-200), 4M 현황도로 | |
| 치수 데이터 | 주요 수치 | 2987, 1000, 7200, 1500, 16314, 7450, 4500, 3051 등 |
| 높이 정보 | FL: 1.150 / GL: ±10.0 | |
| 기술 정보 | CAD 버전 | AC1015 (R2000) |
| 레이어 수 | 32개 (건축, 조경, 치수, 공통 등 구분) | |
| 객체 통계 | Line/Polyline | 191개 (경계 및 선형 요소) |
| MText | 53개 (치수 및 설명 문구) | |
| Hatch/Circle | 12개 / 15개 (영역 구분 및 포인트 표시) |
(참고: 텍스트 중 "물매 3/10" 등은 지붕이나 배수를 위한 경사도(Slope)를 의미하는 것으로 추정됩니다.)
- RAG 핵심 부품(도구)
- Embedder
Vector Store(벡터 저장소)
벡터 저장소는 벡터 형태로 표현된 데이터, 즉 임베딩 벡터들을 효율적으로 저장하고 검색할 수 있는 시스템이나 데이터베이스를 의미합니다. 자연어 처리(NLP), 이미지 처리, 그리고 기타 다양한 머신러닝 응용분야에서 생성된 고차원 벡터 데이터를 관리하기 위해 설계됨. 벡터 저장소의 핵심 기능은 대구모 벡터 데이터셋에서 빠른 속도로 가장 유사한 항목을 찾아내는 것
Retriver(검색도구)
벡터 저장소에서 문서를 검색하는 핵심 구성요소이다. LangChain은 간단한 의미 검색부터 성능 향상을 위한 다양한 고급 검색 알고리즘을 지원한다.
Generator
찾아온 문서를 바탕으로 자연어로 설명해준다. 데이터를 기반으로 알기쉽게 풀어서 설명해주는 느낌이다.
일반적인 RAG -> ingestion 계층에서 검색 가능한 텍스트를 확보했다고 가정하고 시작
1) 청킹 : 긴 내용을 청크 단위로 잘라서 저장 해놓고 사용(임베딩)
청킹의 방식에 따라서 tradeoff가 있다.
- 양 기준
-청크의 사이즈가 너무 크면? 노이즈가 늘어난다. 관련 없는 내용이 한 청크 안에 다 같이 섞여있음.
-청크의 사이즈가 너무 작으면? 내용이 전부 담기지 않음
어떤 데이터를 청킹할거냐에 따라서 청킹 방법론을 잘 선택해야함
표준 취업 규칙 문서 학습시킨 후 청킹 및 임베딩 결과에 따른 챗봇 만들기
-> 코드
-
설치와 Ollama 서버 실행
import subprocess, time, os
!apt-get install -y zstd > /dev/null
!curl -fsSL https://ollama.com/install.sh | sh
!pip install -q ollama olefile chromadb sentence-transformers
#코랩 NVIDIA 드라이버 경로를 넣어 줘야 Ollama가 GPU를 잡는다
env = os.environ.copy()
env["LD_LIBRARY_PATH"] = "/usr/lib64-nvidia:" + env.get("LD_LIBRARY_PATH", "")
subprocess.run("pkill -f 'ollama serve'", shell=True)
subprocess.Popen(["ollama", "serve"], stdout=open("/content/ollama.log", "w"),
stderr=subprocess.STDOUT, env=env)
time.sleep(8)
!ollama pull gemma4:12b
!nvidia-smi --query-gpu=name,memory.total --format=csv,noheader
!grep -iE "inference compute|no compatible" /content/ollama.log | tail -2 -
드라이브 연결과 파일 업로드
from google.colab import files, drive
drive.mount("/content/drive")
CACHE_DIR = "/content/drive/MyDrive/rag_rules_cache"
uploaded = files.upload()
HWP_PATH = next(iter(uploaded))
print("업로드:", HWP_PATH) -
텍스트 추출, 정제, 파트 분리
import re, struct, zlib
import numpy as np
import olefile

EXTENDED = {1, 2, 3, 11, 12, 14, 15, 16, 17, 18, 21, 22, 23}
INLINE = {4, 5, 6, 7, 8, 9, 19, 20}

def decode_para(b: bytes) -> str:
    """문단 텍스트 디코딩. 표·그림 같은 제어문자는 8글자 단위라 통째로 건너뛴다."""
    u = struct.unpack(f"<{len(b)//2}H", b[:len(b)//2*2])
    out, i = [], 0
    while i < len(u):
        c = u[i]
        if c in EXTENDED or c in INLINE:
            if c == 9:
                out.append("\t")
            i += 8
        elif c < 32:
            i += 1
        else:
            out.append(chr(c))
            i += 1
    return "".join(out)

def hwp_to_text(path: str) -> str:
    """표 안의 글자까지 전부 뽑는다. (hwp5txt는 표 내용을 <표>로만 남김)"""
    ole = olefile.OleFileIO(path)
    compressed = ole.openstream("FileHeader").read()[36] & 1
    sections = sorted([s for s in ole.listdir() if s[0] == "BodyText"],
                      key=lambda s: int(s[1][7:]))
    lines = []
    for s in sections:
        data = ole.openstream(s).read()
        if compressed:
            data = zlib.decompress(data, -15)
        i = 0
        while i < len(data):
            header = struct.unpack_from("<I", data, i)[0]
            i += 4
            tag, size = header & 0x3FF, header >> 20
            if size == 0xFFF:
                size = struct.unpack_from("<I", data, i)[0]
                i += 4
            if tag == 67:                      # HWPTAG_PARA_TEXT
                lines.append(decode_para(data[i:i + size]))
            i += size
    return "\n".join(lines)

def clean_text(raw: str) -> str:
    """목차 줄, 작성 가이드([필수]/[선택]/☞/※) 제거"""
    out = []
    for line in raw.splitlines():
        s = line.strip()
        if not s:
            continue
        if re.search(r"\t\s*\d+\s*$", line):
            continue
        if s.startswith(("[필수]", "[선택]", "☞", "※")):
            continue
        out.append(line.rstrip())
    return "\n".join(out)

def split_parts(text: str) -> dict[str, str]:
    """일반 근로자용 / 별첨 괴롭힘 규정 / 단시간 근로자용으로 분리. [별지] 서식은 버린다."""
    parts, current = {}, None
    for line in text.splitlines():
        s = line.strip()
        if s == "일반 근로자용":
            current = "일반 근로자용"
        elif s == "단시간 근로자용":
            current = "단시간 근로자용"
        elif s.startswith("[별첨]"):
            current = "별첨 괴롭힘 규정"
        elif s.startswith("[별지"):
            current = None
        elif current:
            parts.setdefault(current, []).append(line)
    return {k: "\n".join(v) for k, v in parts.items()}

raw = hwp_to_text(HWP_PATH)
clean = clean_text(raw)
parts = split_parts(clean)
print(f"원문 {len(raw):,}자 → 정제 후 {len(clean):,}자")
print("파트:", {k: f"{len(v):,}자" for k, v in parts.items()})
결과 
청킹 전략 비교
QUICK = True   # True: 비교 전략 2개(빠름) / False: 5개 전부

def chunk_text(text: str, chunk_size: int = 500, overlap: int = 50) -> list[str]:
    """글자 수 기준 고정 청킹"""
    chunks, start = [], 0
    while start < len(text):
        chunk = text[start:start + chunk_size]
        if chunk.strip():
            chunks.append(chunk)
        start += chunk_size - overlap
    return chunks

ARTICLE = re.compile(r"^(제\d+조(?:의\d+)?\s*\([^)]*\))", re.M)
CHAPTER = re.compile(r"^\s*(제\s*\d+\s*장)\s*(.*)$")

def chunk_by_article(text: str, max_len: int = 800) -> list[str]:
    """'제N조(제목)' 단위 청킹. 긴 조항은 제목을 붙여 다시 자른다."""
    pieces = ARTICLE.split(text)
    chunks, seen = [], set()
    for k in range(1, len(pieces), 2):
        title = pieces[k].strip()
        body = (pieces[k] + pieces[k + 1]).strip()
        if len(body) < 20 or body in seen:
            continue
        seen.add(body)
        if len(body) <= max_len:
            chunks.append(body)
        else:
            for p in chunk_text(body, max_len, 100):
                chunks.append(p if p.startswith(title) else f"{title} (계속)\n{p}")
    return chunks

def article_records(text: str, part: str) -> list[dict]:
    """조항 청크 + 메타데이터(파트, 장, 조항명)"""
    records, chapter = [], "기타"
    for block in re.split(r"(?m)^(?=\s*제\s*\d+\s*장\s)", text):
        m = CHAPTER.match(block.split("\n", 1)[0])
        if m:
            chapter = m.group(1).replace(" ", "") + " " + re.sub(r"\s+", " ", m.group(2)).strip()
        for c in chunk_by_article(block):
            records.append({"text": c, "part": part, "chapter": chapter,
                            "article": ARTICLE.match(c).group(1)})
    return records

def noise_tags(chunk: str) -> list[str]:
    """청크에 섞인 노이즈 종류"""
    tags = []
    if len(ARTICLE.findall(chunk)) >= 2:
        tags.append("여러 조항 섞임")
    if re.search(r"\[필수\]|\[선택\]|☞", chunk):
        tags.append("작성 가이드 포함")
    if re.search(r"\t\s*\d+\s*$", chunk, re.M):
        tags.append("목차 포함")
    if not ARTICLE.match(re.sub(r"^\[[^\]]*\]\s*", "", chunk.lstrip())):
        tags.append("조항 중간에서 시작")
    return tags

all_strategies = {
    "fixed_200":   chunk_text(raw, 200, 20),
    "fixed_500":   chunk_text(raw, 500, 50),
    "fixed_1000":  chunk_text(raw, 1000, 100),
    "article_raw": chunk_by_article(raw),
    "article":     chunk_by_article(parts["일반 근로자용"]),
}
for name, chunks in all_strategies.items():
    noisy = sum(1 for c in chunks if noise_tags(c))
    print(f"{name:12s} 청크 {len(chunks):4d}개 / 평균 {int(np.mean([len(c) for c in chunks])):4d}자 / 노이즈 청크 {noisy / len(chunks):.0%}")

keep = ("fixed_500", "article") if QUICK else tuple(all_strategies)
strategies = {k: all_strategies[k] for k in keep}
print("\n임베딩 비교 대상:", list(strategies), f"(총 {sum(map(len, strategies.values()))}개)")

print("\n--- fixed_500 예시 ---")
print(all_strategies["fixed_500"][40])
print("\n--- article 예시 (제33조) ---")
print(next(c for c in all_strategies["article"] if c.startswith("제33조")))
결과값
fixed_200 청크 686개 / 평균 199자 / 노이즈 청크 100%
fixed_500 청크 275개 / 평균 498자 / 노이즈 청크 100%
fixed_1000 청크 138개 / 평균 993자 / 노이즈 청크 100%
article_raw 청크 413개 / 평균 302자 / 노이즈 청크 88%
article 청크 108개 / 평균 351자 / 노이즈 청크 0%
임베딩 비교 대상: ['fixed_500', 'article'] (총 383개)
--- fixed_500 예시 ---
로자대표와 서면 합의로 정한 시간을 근로한 것으로 본다. 서면 합의 시 다음 각 호의 사항을 명시하여야 한다.
1. 대상 업무
2. 회사가 업무의 수행 수단 및 시간 배분 등에 관하여 사원에게 구체적인 지시를 하지 아니한다는 내용
3. 근로시간의 산정은 그 서면 합의로 정하는 바에 따른다는 내용
[선택] 업무수행 방법에 재량이 큰 아래 업무에 대하여는 근로자대표와 서면합의로 정한 시간을 근로한 것으로 볼 수 있음
[재량근로의 대상업무]
1. 신상품 또는 신기술의 연구개발이나 인문사회과학 또는 자연과학분야의 연구 업무
2. 정보처리시스템의 설계 또는 분석 업무
3. 신문, 방송 또는 출판 사업에서의 기사의 취재, 편성 또는 편집 업무
4. 의복·실내장식·공업제품·광고 등의 디자인 또는 고안 업무
5. 방송 프로그램·영화 등의 제작 사업에서의 프로듀서나 감독 업무
6. 그 밖에 고용노동부장관이 정하는 업무(회계·법률사건·납세·법무·노무관리·특허·감정평가·금융투자분석·투자자산
--- article 예시 (제33조) ---
제33조(연차유급휴가) ① 1년간 80퍼센트 이상 출근한 사원에게는 15일의 유급휴가를 준다.
② 계속하여 근로한 기간이 1년 미만인 사원 또는 1년간 80퍼센트 미만 출근한 사원에게 1개월 개근 시 1일의 유급휴가를 준다.
③ 3년 이상 근속한 사원에 대하여는 제1항 규정에 따른 휴가에 최초 1년을 초과하는 계속 근로연수 매 2년에 대하여 1일을 가산한 유급휴가를 주며, 가산휴가를 포함한 총 휴가일수는 25일을 한도로 한다.
④ 제1항 및 제2항을 적용하는 경우 다음 각 호의 어느 하나에 해당하는 기간은 출근한 것으로 본다.
1. 사원이 업무상의 부상 또는 질병으로 휴업한 기간
2. 임신 중의 여성이 「근로기준법」 제74조제1항부터 제3항까지의 규정에 따른 휴가로 휴업한 기간
3. 「남녀고용평등과 일·가정 양립 지원에 관한 법률」 제19조제1항에 따른 육아휴직으로 휴업한 기간
4. 「남녀고용평등과 일ㆍ가정 양립 지원에 관한 법률」 제19조의2제1항에 따른 육아기 근로시간 단축을 사용하여 단축된 근로시간
5. 「근로기준법」 제74조제7항에 따른 임신기 근로시간 단축을 사용하여 단축된 근로시간
⑤ 회사는 인사노무관리의 편의상 회계연도 기준으로 연차유급휴가를 부여할 수 있다.
또한 회계연도 기준으로 연차휴가 부여 시, 입사일 기준 부여일수보다 많이 부여된 경우 취업규칙, 단체협약 등에 퇴직시점에 입사일 기준으로 재산정한다는 별도의 단서가 없는 한 발생한 휴가 일수 전체를 부여해야 함(임금근로시간정책팀-489, ’08.2.28. 등)
임베딩과 벡터DB 저장
import os, hashlib, time
import torch, chromadb
from collections import Counter
from sentence_transformers import SentenceTransformer

os.makedirs(CACHE_DIR, exist_ok=True)
print("GPU:", torch.cuda.get_device_name(0) if torch.cuda.is_available() else "없음(CPU)")

embedder = SentenceTransformer("BAAI/bge-m3", device="cuda" if torch.cuda.is_available() else "cpu")
if torch.cuda.is_available():
    embedder.half()                  # fp16: 속도↑ 메모리↓
embedder.max_seq_length = 1024       # 청크 최대 800자라 충분

def embed_texts(texts: list[str], batch: int = 32) -> np.ndarray:
    """정규화된 임베딩 → 내적 = 코사인 유사도"""
    return embedder.encode(
        texts, batch_size=batch, normalize_embeddings=True,
        show_progress_bar=len(texts) > 50, convert_to_numpy=True,
    ).astype(np.float32)

def embed_cached(name: str, texts: list[str]) -> np.ndarray:
    """청크 내용이 같으면 드라이브에 저장된 임베딩을 재사용"""
    key = hashlib.md5("\u241e".join(texts).encode()).hexdigest()[:10]
    path = f"{CACHE_DIR}/{name}_{key}.npy"
    if os.path.exists(path):
        print(f"[캐시] {name} ({len(texts)}개)")
        return np.load(path)
    t = time.time()
    vecs = embed_texts(texts)
    np.save(path, vecs)
    print(f"[임베딩] {name} ({len(texts)}개) {time.time() - t:.1f}초")
    return vecs

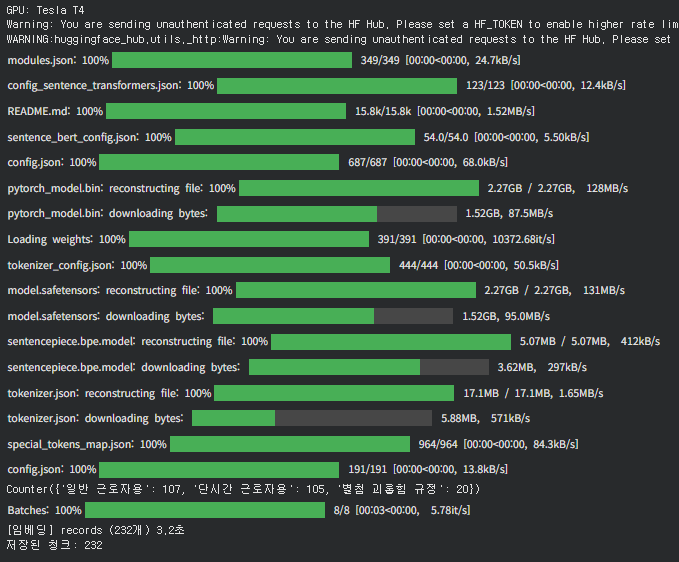
records = [r for name, t in parts.items() for r in article_records(t, name)]
docs = [f"[{r['part']}] {r['text']}" for r in records]
print(Counter(r["part"] for r in records))

chunk_embeddings = embed_cached("records", docs)

client = chromadb.Client()
if "rules" in [c.name for c in client.list_collections()]:
    client.delete_collection("rules")
collection = client.create_collection("rules", metadata={"hnsw:space": "cosine"})
collection.add(
    ids=[f"chunk_{i}" for i in range(len(records))],
    documents=docs,
    embeddings=chunk_embeddings.tolist(),
    metadatas=[{k: r[k] for k in ("part", "chapter", "article")} for r in records],
)
print("저장된 청크:", collection.count())- 결과값
벡터 검색
def search_vectordb(query: str, top_k: int = 3, part: str | None = "일반 근로자용"):
    """cosine 공간이므로 유사도 = 1 - distance"""
    q_emb = embed_texts([query])[0].tolist()
    res = collection.query(query_embeddings=[q_emb], n_results=top_k,
                           where={"part": part} if part else None)
    return [
        {"id": i, "text": t, "metadata": m, "similarity": 1 - d}
        for i, t, m, d in zip(res["ids"][0], res["documents"][0], res["metadatas"][0], res["distances"][0])
    ]

def show_search(query: str, top_k: int = 3, part: str | None = "일반 근로자용"):
    print(f"=== 질문: {query}  (필터: {part}) ===")
    for rank, r in enumerate(search_vectordb(query, top_k, part), 1):
        m = r["metadata"]
        print(f"\n[{rank}위] 유사도 {r['similarity']:.4f} | {m['part']} / {m['chapter']} / {m['article']}")
        print(r["text"][:150] + ("..." if len(r["text"]) > 150 else ""))

show_search("연차 휴가는 며칠이나 되나요?")
print("\n" + "=" * 60 + "\n")
show_search("연차 휴가는 며칠이나 되나요?", part=None)
결과값
=== 질문: 연차 휴가는 며칠이나 되나요?  (필터: 일반 근로자용) ===

[1위] 유사도 0.6735 | 일반 근로자용 / 제6장 휴일․휴가 / 제33조(연차유급휴가)
[일반 근로자용] 제33조(연차유급휴가) ① 1년간 80퍼센트 이상 출근한 사원에게는 15일의 유급휴가를 준다.
  ② 계속하여 근로한 기간이 1년 미만인 사원 또는 1년간 80퍼센트 미만 출근한 사원에게 1개월 개근 시 1일의 유급휴가를 준다.
  ③ 3년 이상 근속...

[2위] 유사도 0.6428 | 일반 근로자용 / 제6장 휴일․휴가 / 제34조(연차유급휴가의 사용)
[일반 근로자용] 제34조(연차유급휴가의 사용) ① 연차유급휴가는 사원이 청구한 시기에 주어야 한다. 다만, 청구한 시기에 휴가를 주는 것이 사업 운영에 막대한 지장이 있는 경우 그 시기를 변경할 수 있다.
  ② 사원의 연차유급휴가는 1년간(계속하여 근로한 기간이 1...

[3위] 유사도 0.6021 | 일반 근로자용 / 제4장 인 사 / 제17조(휴직사유 및 기간)
[일반 근로자용] 제17조(휴직사유 및 기간) (계속)
녀(이하 “가족”이라 한다)의 질병, 사고, 노령으로 인하여 그 가족을 돌보기 위하여 필요한 경우(이하 이에 따른 휴직을 “가족돌봄휴직”이라 한다): 연간 90일 이내, 1회 30일 이상
   6. 사원이 「공직선...

============================================================

=== 질문: 연차 휴가는 며칠이나 되나요?  (필터: None) ===

[1위] 유사도 0.6735 | 일반 근로자용 / 제6장 휴일․휴가 / 제33조(연차유급휴가)
[일반 근로자용] 제33조(연차유급휴가) ① 1년간 80퍼센트 이상 출근한 사원에게는 15일의 유급휴가를 준다.
  ② 계속하여 근로한 기간이 1년 미만인 사원 또는 1년간 80퍼센트 미만 출근한 사원에게 1개월 개근 시 1일의 유급휴가를 준다.
  ③ 3년 이상 근속...

[2위] 유사도 0.6612 | 단시간 근로자용 / 제6장 휴일・휴가 / 제32조(연차휴가의 사용)
[단시간 근로자용] 제32조(연차휴가의 사용) ① 연차유급휴가는 사원이 청구한 시기에 주어야 한다. 다만, 청구한 시기에 휴가를 주는 것이 사업 운영에 막대한 지장이 있는 경우 그 시기를 변경할 수 있다.
  ② 사원의 연차유급휴가는 1년간(계속하여 근로한 기간이 1년...

[3위] 유사도 0.6428 | 일반 근로자용 / 제6장 휴일․휴가 / 제34조(연차유급휴가의 사용)
[일반 근로자용] 제34조(연차유급휴가의 사용) ① 연차유급휴가는 사원이 청구한 시기에 주어야 한다. 다만, 청구한 시기에 휴가를 주는 것이 사업 운영에 막대한 지장이 있는 경우 그 시기를 변경할 수 있다.
  ② 사원의 연차유급휴가는 1년간(계속하여 근로한 기간이 1...
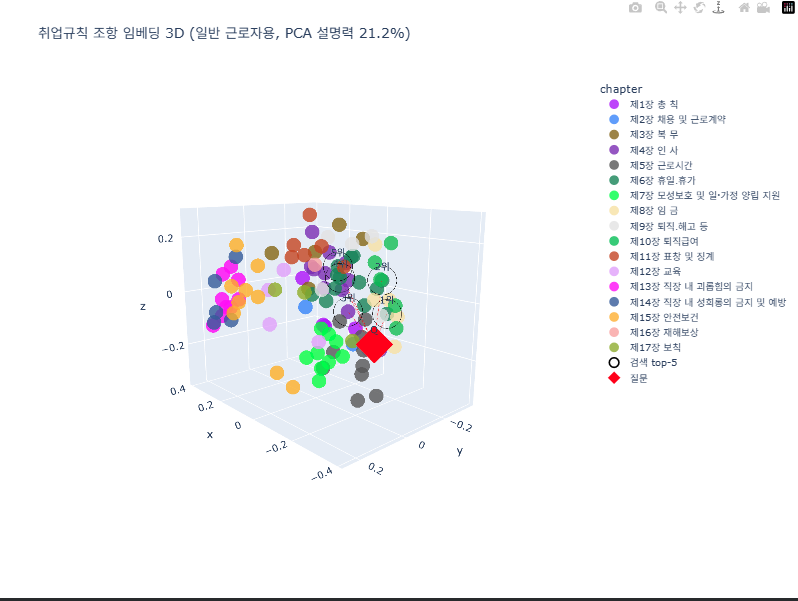
임베딩 3D 시각화
from sklearn.decomposition import PCA
import plotly.express as px
import plotly.graph_objects as go

def plot_embeddings_3d(query: str | None = None, part: str = "일반 근로자용", top_k: int = 5):
    idx = [i for i, r in enumerate(records) if r["part"] == part]
    pca = PCA(n_components=3)
    vis = pca.fit_transform(chunk_embeddings[idx])
    ratio = pca.explained_variance_ratio_.sum()

    df = {
        "x": vis[:, 0], "y": vis[:, 1], "z": vis[:, 2],
        "chapter": [records[i]["chapter"] for i in idx],
        "article": [records[i]["article"] for i in idx],
        "preview": [re.sub(r"\s+", " ", records[i]["text"])[:60] for i in idx],
    }
    fig = px.scatter_3d(
        df, x="x", y="y", z="z", color="chapter",
        hover_name="article", hover_data={"preview": True, "x": False, "y": False, "z": False},
        color_discrete_sequence=px.colors.qualitative.Alphabet,
        title=f"취업규칙 조항 임베딩 3D ({part}, PCA 설명력 {ratio:.1%})",
    )
    fig.update_traces(marker=dict(size=5, opacity=0.8))

    if query:
        q = pca.transform(embed_texts([f"[{part}] {query}"]))[0]
        hits = search_vectordb(query, top_k=top_k, part=part)
        pos = [idx.index(int(h["id"].split("_")[1])) for h in hits]
        fig.add_trace(go.Scatter3d(
            x=vis[pos, 0], y=vis[pos, 1], z=vis[pos, 2], mode="markers+text",
            name=f"검색 top-{top_k}", text=[f"{n}위" for n in range(1, len(pos) + 1)],
            hovertext=[h["metadata"]["article"] for h in hits],
            marker=dict(size=10, color="rgba(0,0,0,0)", line=dict(color="black", width=4)),
        ))
        fig.add_trace(go.Scatter3d(
            x=[q[0]], y=[q[1]], z=[q[2]], mode="markers+text", name="질문",
            text=["Q"], hovertext=[query], marker=dict(size=12, color="red", symbol="diamond"),
        ))
        for p in pos:
            fig.add_trace(go.Scatter3d(
                x=[q[0], vis[p, 0]], y=[q[1], vis[p, 1]], z=[q[2], vis[p, 2]], mode="lines",
                line=dict(color="red", width=2, dash="dash"), showlegend=False, hoverinfo="skip",
            ))

    fig.update_layout(height=750, legend=dict(itemsizing="constant"))
    fig.show()

plot_embeddings_3d("연차 휴가는 며칠이나 되나요?")
결과값
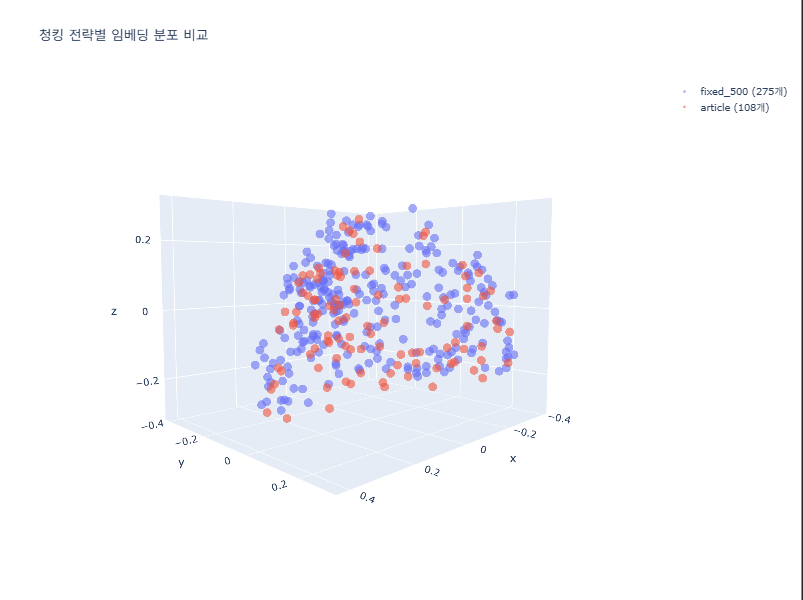
청킹 전략별 임베딩 분포
def plot_chunking_compare():
    names = list(strategy_vecs)
    pca = PCA(n_components=3).fit(np.vstack([strategy_vecs[n] for n in names]))

    fig = go.Figure()
    for n in names:
        vis = pca.transform(strategy_vecs[n])
        hover = [re.sub(r"\s+", " ", c)[:50] + "<br>노이즈: " + (", ".join(noise_tags(c)) or "없음")
                 for c in strategies[n]]
        fig.add_trace(go.Scatter3d(
            x=vis[:, 0], y=vis[:, 1], z=vis[:, 2], mode="markers",
            name=f"{n} ({len(strategies[n])}개)", hovertext=hover, hoverinfo="text",
            marker=dict(size=3, opacity=0.6),
        ))
    fig.update_layout(title="청킹 전략별 임베딩 분포 비교", height=750)
    fig.show()

plot_chunking_compare()-
결과값
-
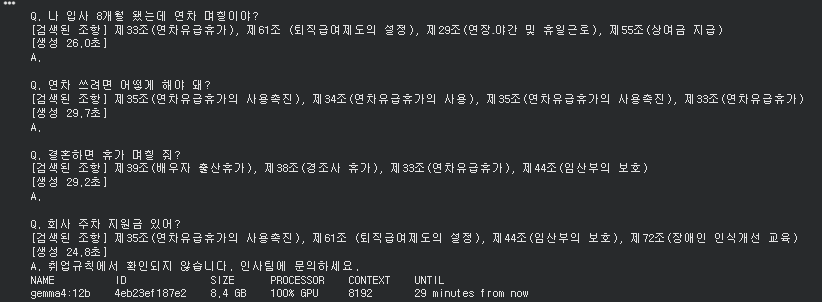
챗봇 (추론 후 답변)
import ollama

CHAT_MODEL = "gemma4:12b"
chat_client = ollama.Client(timeout=300)   # 서버가 멈춰도 무한 대기하지 않게

SYSTEM = ("당신은 회사 취업규칙 안내 챗봇입니다. 반드시 아래 [규정] 내용만 근거로 답하고, "
          "답변 끝에 근거 조항 번호(예: 제33조)를 적으세요. "
          "규정에 없는 내용이면 '취업규칙에서 확인되지 않습니다. 인사팀에 문의하세요.'라고 답하세요.")

def answer(question: str, top_k: int = 4, part: str = "일반 근로자용", show_context: bool = True) -> str:
    hits = search_vectordb(question, top_k, part)
    context = "\n\n---\n\n".join(h["text"] for h in hits)
    if show_context:
        print("[검색된 조항] " + ", ".join(h["metadata"]["article"] for h in hits))
    t = time.time()
    res = chat_client.chat(
        model=CHAT_MODEL,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": f"[규정]\n{context}\n\n[질문]\n{question}"},
        ],
        options={"num_ctx": 8192, "temperature": 0.2, "num_predict": 400},   # 답변 길이 제한
        keep_alive="30m",                                                    # 모델을 메모리에 유지
    )
    if show_context:
        print(f"[생성 {time.time() - t:.1f}초]")
    return res["message"]["content"]

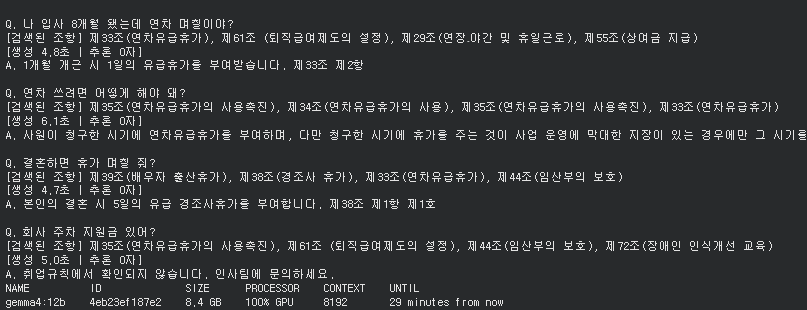
for q in ["나 입사 8개월 됐는데 연차 며칠이야?",
          "연차 쓰려면 어떻게 해야 돼?",
          "결혼하면 휴가 며칠 줘?",
          "회사 주차 지원금 있어?"]:
    print(f"\nQ. {q}")
    print(f"A. {answer(q)}")

!ollama ps

# 직접 질문하려면 아래 주석을 풀고 실행
# while (q := input("\n질문 (엔터 = 종료): ").strip()):
#     print(answer(q))
결과값
챗봇 (생각과정 생략)
import ollama

CHAT_MODEL = "gemma4:12b"
THINK = False                              # True면 추론 후 답변 (느리지만 계산 문제에 유리)
chat_client = ollama.Client(timeout=300)

SYSTEM = ("당신은 회사 취업규칙 안내 챗봇입니다. 반드시 아래 [규정] 내용만 근거로 답하고, "
          "답변 끝에 근거 조항 번호(예: 제33조)를 적으세요. "
          "규정에 없는 내용이면 '취업규칙에서 확인되지 않습니다. 인사팀에 문의하세요.'라고 답하세요.")

def answer(question: str, top_k: int = 4, part: str = "일반 근로자용",
           show_context: bool = True, think: bool = THINK) -> str:
    hits = search_vectordb(question, top_k, part)
    context = "\n\n---\n\n".join(h["text"] for h in hits)
    if show_context:
        print("[검색된 조항] " + ", ".join(h["metadata"]["article"] for h in hits))
    t = time.time()
    res = chat_client.chat(
        model=CHAT_MODEL,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": f"[규정]\n{context}\n\n[질문]\n{question}"},
        ],
        think=think,
        options={"num_ctx": 8192, "temperature": 0.2,
                 "num_predict": 2048 if think else 600},
        keep_alive="30m",
    )
    msg = res["message"]
    if show_context:
        n_think = len(msg.get("thinking") or "")
        print(f"[생성 {time.time() - t:.1f}초 | 추론 {n_think}자]")
    content = msg["content"].strip()
    if not content:
        content = "(답변이 비었습니다. 추론에 토큰을 다 썼을 수 있습니다. num_predict를 늘려 보세요.)"
    return content

for q in ["나 입사 8개월 됐는데 연차 며칠이야?",
          "연차 쓰려면 어떻게 해야 돼?",
          "결혼하면 휴가 며칠 줘?",
          "회사 주차 지원금 있어?"]:
    print(f"\nQ. {q}")
    print(f"A. {answer(q)}")

!ollama ps

# 직접 질문하려면 아래 주석을 풀고 실행
# while (q := input("\n질문 (엔터 = 종료): ").strip()):
#     print(answer(q))
결과값