Paper: Black-box Explanation of Object Detectors via Saliency Maps
🔍1. Introduction
Object Detection과 Explainability
최근 Deep Neural Network(DNN)의 발전으로 Object Detection의 성능이 크게 향상됨.
하지만 DNN은 복잡하고 직관적이지 않은 의사결정 과정을 가지는 Opaque Model이기 때문에
모델의 판단을 이해하고, 디버깅하고, 개선하기 어렵다는 문제가 있음.
이를 해결하기 위해 다양한 Explanation Technique이 연구되어 왔고, 이러한 기법들은 하단과 같은 목적으로 활용됨.
- 학습된 모델의 Bias 발견
- 모델 Debugging
- 모델에 대한 사용자의 Trust 향상
그리고 대표적인 접근법 중 하나가 Attribution Technique.
Attribution Technique은 Saliency Map을 생성해서
이미지의 각 Pixel이 모델의 Decision에 얼마나 영향을 미쳤는지를 Heatmap 형태로 표현함.
기존 Saliency Map 연구의 한계
기존 Attribution Technique은 주로 Image Classification을 대상으로 연구되어 왔음.
반면 Object Detector를 위한 Saliency Map 연구는 상대적으로 충분히 이루어지지 않았다는 것.
또한 기존 Attribution Technique은 모델 구조와 관련 있기도 하고,
Model Architecture에 대한 여러 가정을 필요로 하는 경우가 있음.
(ex. Grad-CAM은 각 Feature Map이 특정 Concept과 연관되어 있다고 가정하고, Target Class에 대한 중요도에 따라 Feature Map에 Weight를 부여함.)
하지만 논문에서는 이런 가정이 Object Detection Model에서는 성립하지 않을 수 있고,
이로 인해 좋은 품질의 Saliency Map을 생성하지 못할 수 있다고 지적함.
Object Detection에서는 Classification만 설명하면 부족함
Image Classification에서는 하나의 이미지에 대해 특정 Class를 예측하기 때문에
Classification Decision을 중심으로 설명하면 됨.
하지만 Object Detection에서는 객체에 대해
- 어떤 Class인지 판단하는 Categorization
- 객체가 어디에 있는지 판단하는 Localization을 동시에 수행함.
따라서 Object Detector를 설명하기 위해서는
Bounding Box의 Class뿐만 아니라 Bounding Box의 위치에 대한 설명도 필요함.
이런 이유로...
기존 Classification용 Attribution Technique을 Object Detection에 직접 적용하기 어려움.
그래서 등장한 D-RISE
위와 같은 문제를 해결하기 위해 논문에서 제안한 것이 바로
D-RISE(Detector Randomized Input Sampling for Explanation).
D-RISE는 Object Detector의 Prediction에 대해 Saliency Map을 생성하고,
Detection의 Localization과 Classification을 모두 설명하는 것을 목표로 함.
D-RISE는 기존 RISE에서 제안된 Input Masking Technique을 기반으로 함.
기존 RISE에서는 Random Mask를 Input Image에 적용한 뒤,
Mask 적용에 따라 Target Class Score가 어떻게 변하는지 관찰해서 중요한 영역을 찾았음.
그리고 D-RISE는 이러한 아이디어를 Object Detection으로 확장함.
또한 D-RISE는 Gradient나 Object Detector 내부 구조에 의존하지 않는 Black-box Method라는 것.
- 따라서 특정 Object Detector Architecture에 종속되지 않고 다양한 Detector에 적용할 수 있음.
Bounding Box가 있는데 왜 Saliency Map이 필요한가?
Object Detection에서는 이미 Bounding Box를 통해 객체의 위치를 출력함.
따라서 다음과 같은 의문이 생길 수 있음.
Bounding Box가 이미 객체의 위치를 알려주는데 Saliency Map이 필요한가?
논문에서는 Object Detector가 Bounding Box 내부의 정보만을 이용하여 객체를 판단하지 않을 수 있음을 보여줌.
실험 결과 DNN 기반 Object Detector는 객체를 검출할 때 Bounding Box 외부의 Contextual Region도 활용하는 것으로 나타남.
예를 들어 Fig. 1에서는 Sink를 검출할 때 Sink의 Bounding Box 외부에 존재하는 Tap도 중요한 정보로 활용됨.
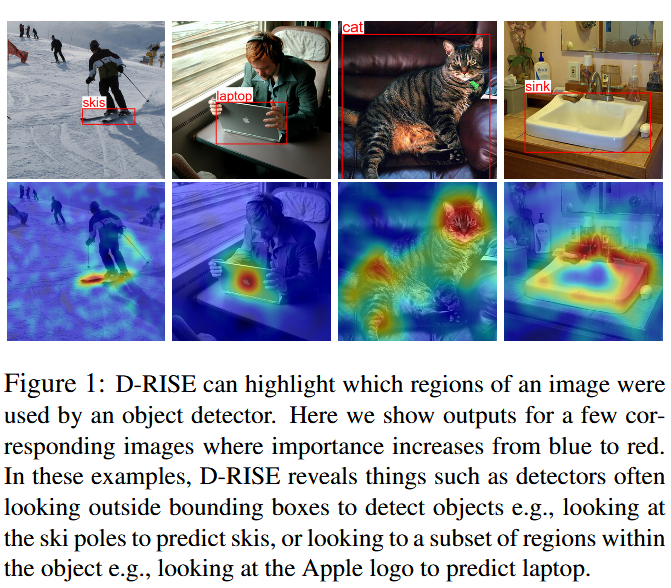
또한 Bounding Box 내부의 모든 영역이 동일하게 중요한 것도 아님.
예를 들어 cat을 검출할 때 Cat의 몸 전체가 동일한 Importance를 가지는 것이 아니라, 얼굴 부분이 몸통보다 더 중요한 특징으로 사용될 수 있음.
따라서 Bounding Box와 Saliency Map은 서로 다른 정보를 제공함.
Bounding Box
: 모델이 객체가 존재한다고 예측한 위치
D-RISE Saliency Map
: 해당 객체를 검출하기 위해 모델이 실제로 중요하게 활용한 이미지 영역
D-RISE의 주요 Contribution
논문에서 제시한 주요 Contribution은 다음과 같음.
- Object Detector를 Saliency Map으로 설명하기 위한 Black-box Attribution Technique인
D-RISE를 제안함
- 이를 위해 새로운 Detection Similarity Metric을 정의함
- 서로 다른 Architecture를 가지는 Object Detector에
D-RISE를 적용해 Generalizability를 확인함
One-stage Detector: YOLOv3Two-stage Detector: Faster R-CNN
D-RISE를 이용해서 Object Detector의 Error와 Bias의 원인을 분석함
- MS-COCO Dataset으로 학습된 Detector가 학습한 공통적인 Data Pattern을 분석함
- Classification Saliency에서 사용되는 Automated Metric과 User Study를 통해
D-RISE를 평가함
- 추가로 Synthetic Marker를 이용해서 의도적으로 Model Bias를 생성하고,
Saliency Method가 해당 Bias를 얼마나 잘 발견하는지 평가하는 방법을 제안함
✅2. Related Work
2.1. Object Detection
Object Detector는 크게 One-stage Detector와 Two-stage Detector로 구분할 수 있음.
대표적인 One-stage Detector로는 YOLO, SSD, CornerNet 등이 있고,
Two-stage Detector로는 Faster R-CNN이 있음.
i) One-stage Detector
One-stage Detector는 별도의 Region Proposal Stage를 사용하지 않고, 하나의 Network에서 Object Detection을 수행함.
ii) Two-stage Detector
Two-stage Detector는 먼저 Region Proposal Stage에서 Object가 존재할 가능성이 높은 Region of Interest(ROI)를 선택함.
이후 선택된 ROI에서 Feature를 추출하고, 두 번째 Stage에서 해당 Region의 Class를 분류함.
Region Proposal → Feature Extraction → Classification
본 논문에서는 D-RISE가 특정 Detector Architecture에 종속되지 않는다는 것을 확인하기 위해 두 종류의 Detector에 모두 적용해봄.
기존 Object Detector Explanation 연구
기존에도 DNN 기반 Object Detector를 설명하기 위한 연구들이 존재했음.
ex.
- Feature Space Visualization
- Pedestrian의 Skin Color와 같은 Bias 분석
- SSD Object Detector를 위한 Saliency 기반 Explanation 등
하지만 SSD Detector를 대상으로 한 기존 Saliency 연구들은 White-box Approach를 사용함.
= 모델 내부 구조나 Parameter에 접근해야 한다는 의미.
반면 ★D-RISE는 Object Detector의 내부 구조를 이용하지 않고 Black-box로 취급함.
따라서 특정 Object Detector의 내부 구조에 접근하지 않고도 Detection 결과를 설명하는 것을 목표로 함.
2.2. Visual Saliency Methods
Visual Grounding Technique은 이미 학습된 Computer Vision Model이
"어떤 근거를 이용"햐서 Prediction을 수행했는지를
사후적으로(Retrospectively) 설명하는 데 사용됨.
기존 Image Classification Model을 설명하기 위한 Saliency Method는 크게 여러 방향으로 발전해왔음.
i) Gradient-based Method
첫 번째는 Neural Network의 Output에서 Input Pixel 방향으로 Importance Score를 Backpropagation하는 방법임.
ex.
GradientsExcitation BackpropLayer-wise Relevance Propagation등
하지만 이러한 방법들은 Model Architecture에 맞게 수정되는 경우가 있음.
그렇기에
새로운 Network Architecture가 등장하면
새로운 Propagation Scheme을 구현해야 할 수 있음.
ii) Grad-CAM
Grad-CAM은 CAM을 일반화한 방법으로,
선택한 Intermediate Layer까지 Gradient를 계산함.
그리고 Gradient를 해당 Layer의 Activation과 결합해서
Low-resolution Saliency Map을 생성함.
Target Class에 대한 Gradient를 이용해서
Intermediate Feature Map의 Importance를 계산하는 방식.
논문에서는 Grad-CAM의 변형들이 Adversarial Context Patch나 Single-shot Object Detector를 분석하는 데 사용되었지만,
대부분의 연구는 Classification Result를 설명하는 데 초점이 맞춰져 있었다고 설명함.
iii) Perturbation-based Method
두 번째 계열은 Image의 특정 Region을 직접 변화시킨 뒤
Model Output이 어떻게 달라지는지 관찰하는 Perturbation-based Method.
ex.
OcclusionNoise 추가InpaintingBlurring등
특정 영역을 변경했을 때 Model Output이 크게 변한다면 해당 영역이 Prediction에 중요하다고 판단함.
iv) Occlusion
Occlusion은 Image의 일부 Square Region을 가린 뒤
이를 Sliding Window 방식으로 이동시키면서 Class Score의 변화를 관찰함.
특정 영역을 가렸을 때 Class Score가 크게 감소하면
해당 영역이 Prediction에 중요했다고 판단하는 것.
v) LIME
LIME은 Deep Model을 특정 Input 주변에서 Linear Classifier로 근사함.
이를 위해 Superpixel을 포함하거나 제거한 Sample들을 생성하고,
이 Sample들을 이용해서 Local Linear Model을 학습함.
학습된 Linear Model의 Weight를 이용하여 각 Superpixel의 Importance를 측정함.
vi) Meaningful Perturbation과 Real Time Image Saliency
Meaningful Perturbation과 Real Time Image Saliency는
Input에 적용할 Perturbation Mask 자체를 Optimization함.
논문에서는 이 방법들이 Gradient Descent를 이용해서 Perturbation Mask를 최적화한다고 설명함.
= 미리 Random Mask를 생성하는 것이 아니라
Model의 Output을 변화시키는 Mask를 Optimization을 통해 찾는 방식.
vii) RISE
마지막으로 본 논문의 직접적인 기반이 되는 RISE(Randomized Input Sampling for Explanation)가 있음.
RISE는 Random Mask들을 생성한 뒤 각각의 Mask를 Input Image에 적용함.
이후 Masked Input을 Classifier에 입력하고,
Predicted Class Probability를 각 Mask의 Weight로 사용함.
최종적으로 이러한 Mask들을 Weighted Sum해서 Saliency Map을 생성함.
Random Mask 생성 → Input에 적용 → Class Probability 측정 → Mask의 Weight로 사용 → Weighted Sum을 통해 Saliency Map을 생성함.
그리고 본 논문에서 이어서 제안하는
D-RISE가 바로 이 Masking Technique을 Object Detector로 확장한 방법!!
기존 Saliency Method를 Object Detection에 바로 적용하기 어려운 이유
논문에서는 앞에서 설명한 기존 Saliency Method들을 Object Detection에 직접 적용하기 어렵다고 설명함.
우선 기존 방법들이 대부분 Classification을 설명하도록 설계되어 있기 때문.
Image Classification에서는 Model Output이 하나의 Scalar 값으로 표현될 수 있음.
ex. 특정 Class에 대한 와 같은 Class Probability 하나를 설명하면 됨.
따라서 Gradient-based Method에서는 해당 Scalar를 Backpropagation하면 되고,
Perturbation-based Method에서는 Image를 변화시킨 뒤 해당 Scalar가 얼마나 변했는지를 측정하면 됨.
반면 Object Detector는 단순히 Class Probability만 출력하지 않고
- Bounding Box Location
- Object Class
- 여러 개의 Detection Proposal을 함께 출력함.
또한 하나의 Image 안에 여러 Object가 존재할 수 있기 때문에 여러 Detection 결과가 동시에 생성됨.
따라서 Classification에서처럼 하나의 Scalar Class Probability만을 기준으로 기존 Saliency Method를 직접 적용하기 어려움.
논문에서는 이러한 차이 때문에
기존 Classification Saliency Method를 Object Detection에 직접 적용하는 게 불가능하다고 설명함.
Grad-CAM을 Object Detection에 적용했을 때의 문제
논문에서는 특히 Gradient-based Method가
Detection Vector 중 하나의 Probability Score를 설명할 때
좋은 품질의 Saliency Map을 생성하지 못한다고 설명함.
= Object Detection에서는 Class Probability 하나만 설명해서는 Detection 전체의 판단을 충분히 설명하기 어려움.
D-RISE에서는 이러한 문제를 해결하기 위해
Input Masking을 이용해서 Object Detector를 설명하는 Saliency Map을 생성함.
D-RISE는 Black-box Method
우선 White-box Method는 일반적으로 Model 내부 구조와 Parameter에 접근해야 함.
반면 Black-box Method는 모델 내부 구조를 알 필요 없이
Input과 Output의 관계만을 이용해 Explanation을 생성함.
D-RISE는 Black-box Method이기 때문에
- Model Architecture에 대한 접근이 필요하지도 않고
- Model 내부 Parameter에 접근할 필요가 없고
- Proprietary Model이나 API처럼 내부 구조를 확인하기 어려운 Model에도 적용할 수 있음
논문에서는 Black-box Method가 White-box Method보다 일반적으로 Runtime은 느리지만,
높은 Generalizability와 적용의 용이성 때문에 개발 시간을 줄일 수 있다고 설명함.
또한 Input Ablation이 Model Output에 미치는 영향을 직접 측정하기 때문에,
Importance Backpropagation을 위한 Rule과 같은 Heuristic에 의존하지 않는다는 특징도 있음.
반면 White-box Method는 일반적으로 Large-scale 및 Real-time Application에 더 적합하다는 것.
✅3. Method
D-RISE의 목표
: 특정 Object Detection 결과에 대한 Saliency Map을 생성하는 것.
높이 , 너비 인 Image , DNN-based Object Detector ,
Bounding Box와 Category Label로 정의된 특정 Detection이 주어졌다고 가정함.
D-RISE는 해당 Detection을 설명하기 위해 Saliency Map 를 생성함.
Saliency Map 역시 크기를 가지며,
각 Pixel의 값은 해당 Pixel이 Detector 가 Target Detection을 예측하는 데 얼마나 중요한지를 나타냄.
D-RISE는 이 과정을 Black-box 방식으로 수행함.
: Model Weight, Gradient, Model 내부 Architecture에 접근하지 않고,
Input을 변화시켰을 때 Output Detection이 어떻게 변하는지만 관찰함.
기본 아이디어는 RISE와 동일하게 Image에 Random Mask를 적용하는 것.
: Image의 특정 영역을 Random하게 가렸을 때 Target Detection 결과가 얼마나 변하는지를 관찰하여 해당 영역의 Importance 측정.
하지만 기존 RISE를 Object Detection에 그대로 적용할 수는 없음.
: Classification Model은 보통 하나의 Class에 대한 Probability와 같은 Scalar Output을 가지지만,
Object Detector는 하나의 Image에서 여러 개의 Detection Vector를 출력하기 때문.
각 Detection에는
Class Probability,Bounding Box Location, Objectness Score 등의 정보가 포함되어 있음.
따라서 D-RISE에서는 이러한 정보들을 이용해서
원래 Target Detection과 Masked Image에서 발생한 Detection이 얼마나 유사한지 측정해야 함.
Detection Vector
Faster R-CNN이나 YOLO와 같은 Object Detector는 많은 수의 Bounding Box Proposal을 생성한 뒤,
Confidence Thresholding과 Non-Maximum Suppression(NMS)을 적용하여 최종 Detection을 남김.
논문에서는 각각의 Bounding Box Proposal을 다음과 같은 Detection Vector 로 표현함.
이를 구체적으로 표현하면 하단과 같음.
하나의 Detection Vector는 크게 세 가지 정보로 구성됨.
1. Localization Information
Bounding Box의 두 Corner Coordinate.
Object가 Image의 어디에 위치하는지에 대한 정보.
2. Objectness Score
Bounding Box 안에 어떤 Class든 Object가 존재할 Probability.
Detector가 이런 Score를 생성하지 않는 경우에는 무시할 수 있음.
3. Classification Information
각 Class에 대한 Probability를 가지는 Vector.
Bounding Box 안에 존재하는 Object가 각각의 Class에 속할 Probability를 나타내는 것.
Target Detection Vector
D-RISE는 Model이 실제로 출력한 Detection만 설명할 수 있는 것은 아님.
임의의 Bounding Box와 Label에 대해서도 Target Detection Vector를 구성할 수 있음.
(이를 위해 Bounding Box Coordinate를 로 사용하고, Objectness Score는 로 설정함.
그리고 설명하고자 하는 Class에 해당하는 위치만 1이고 나머지는 0인 One-hot Vector를 로 사용함.)
=> 모델이 실제로 해당 Bounding Box를 Detection하지 않았더라도
만약 이 위치에 이 Class의 Object가 있다고 한다면,
모델은 어떤 Image Region을 중요하게 활용하는지 Saliency Map을 생성할 수 있음.
(단, 이 경우 생성된 Heatmap에서 실제로 높은 Weight를 가지는 영역이 존재해야 Model이 해당 Bounding Box를 예측하는 데 중요한 정보를 가지고 있다고 볼 수 있음.)
D-RISE
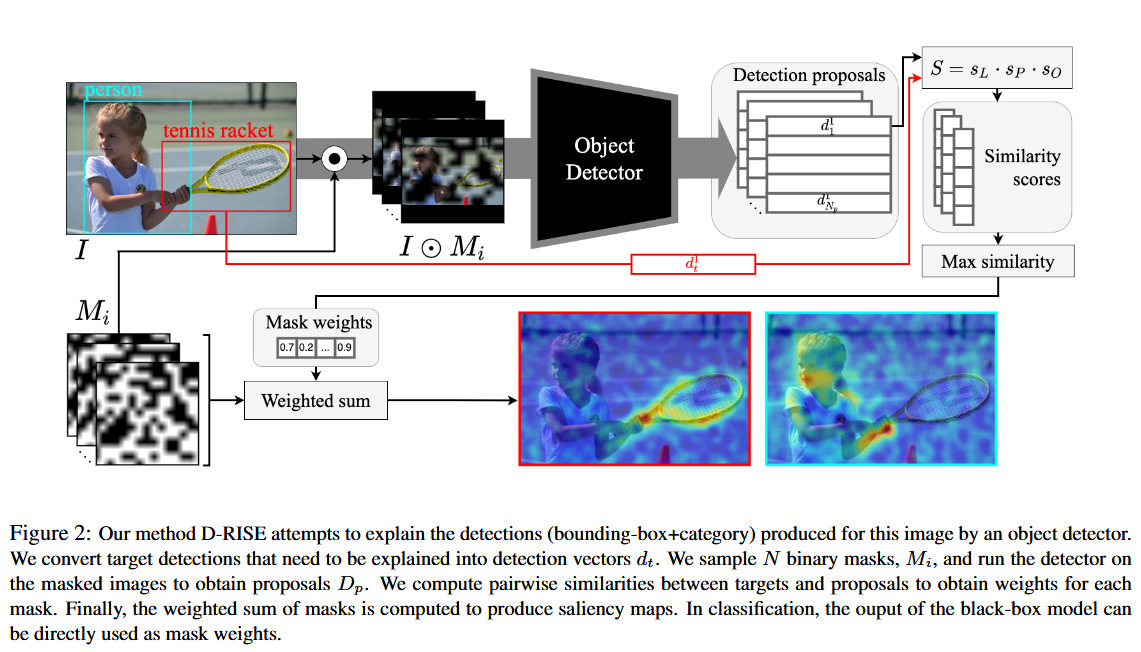
기존 Perturbation-based Attribution 방식과 마찬가지로
D-RISE도 특정 Image Region을 변화시켰을 때 Model Output이 어떻게 달라지는지를 관찰함.
하지만 Object Detection에서는 한 가지 문제가 있음.
Classification에서는 Mask를 적용하기 전과 후의 특정 Class Score만 비교하면 됐음.- 근데
Object Detector에서는 Mask를 적용하면 기존 Bounding Box와 정확히 동일한 Detection이 다시 나오지 않을 수 있음.
Bounding Box의 위치가 조금 달라질 수도 있고,
여러 Detection Proposal이 새롭게 생성될 수도 있음.
따라서 D-RISE에서는 두 가지를 고려해야 함.
How: Output Detection이 얼마나 변했는지
Where: Masked Image에서 생성된 여러 Detection 중 어떤 Detection과 비교해야 하는지
i) How: Detection Similarity
먼저 Target Detection Vector와
Masked Image에서 생성된 Detection Proposal 사이의
Similarity Metric 를 정의함.
이를 통해 Mask를 적용했을 때
Target Detection과 얼마나 유사한 Detection이 유지되었는지를 측정함.
ii) Where: 가장 유사한 Detection 선택
Masked Image에서는 여러 Detection Proposal이 생성될 수 있음.
따라서 D-RISE에서는 Target Detection 와 Masked Image에서 생성된 모든 Detection Proposal을 비교함.
그리고 그중 가장 높은 Similarity를 가지는 Detection을 선택함.
이를 다음과 같이 정의함.
- : 설명하고자 하는 Target Detection
- : 번째 Random Mask
- : Original Image
- : Mask가 적용된 Image
- : Masked Image에서 Detector가 생성한 Detection Proposal들
- : 두 Detection Vector 사이의 Similarity
Masked Image에서 나온 Detection 중
원래 설명하고자 하는 Target Detection과 가장 유사한 Detection의 Similarity Score를 해당 Mask의 Score로 사용하는 것임.
이 구조 덕분에 기존 RISE의 Masking Technique을 Object Detection에도 적용할 수 있게 됨.
Detection되지 않은 Bounding Box도 설명 가능함
이 Framework는
반드시 Model이 실제로 출력한 Detection 만 설명하도록 제한되지 않음.
앞에서 설명한 방식으로 임의의 Detection Vector를 정의하면,
Detector가 놓친 Object(Missed Detection) 등에 대해서도 Saliency Map을 생성할 수 있음.
논문에서는 Gradient-based Method의 경우
이러한 상황에서 Backpropagation을 시작할 Point가 존재하지 않기 때문에
동일한 방식으로 적용하기 어렵다고 설명함.
3.1. Mask Generation
D-RISE의 Mask Generation은 기존 RISE의 방식을 그대로 사용함.
Step 1. 작은 Binary Mask 생성
먼저 Image Size 보다 작은
크기의 Binary Mask를 개 생성함.
각 Element는 독립적으로 다음과 같이 결정됨.
- Probability → 1
- Probability → 0
=> 작은 Random Binary Mask를 생성함.
Step 2. Bilinear Interpolation
생성한 Mask를 Bilinear Interpolation을 이용해서 다음 크기로 Upsampling함.
여기서
이며, Upsampled Mask에서 하나의 Cell이 차지하는 크기를 의미함.
Binary Mask를 Bilinear Interpolation하기 때문에 최종 Mask는 단순한 0과 1만 가지는 것이 아니라 부드럽게 변화하는 값을 가지게 됨.
Step 3. Random Crop
Upsampling한 Mask에서 최종 Image Size인
영역을 Crop함.
이때 Crop 위치는 부터 범위에서 Uniform Random Offset을 이용하여 결정함.
이렇게 생성된 Mask를 Original Image에 적용하여 여러 Masked Image를 생성함.
3.2. Similarity Metric
D-RISE에서 가장 중요한 부분.
Target Detection Vector와 Masked Image에서 생성된 Proposal Vector가 얼마나 유사한지 계산하기 위해서는
Detection Vector를 구성하는 세 가지 요소를 모두 고려해야 함.
그래서 세 가지 요소인
1. Localization
2. Classification
3. Objectness를 각각 비교함.
i) Localization Similarity
두 Bounding Box의 Spatial Proximity를 측정하기 위해 Intersection over Union(IoU)을 사용함.
두 Bounding Box가 많이 겹칠수록
이 되고, 겹치지 않을수록 0에 가까워짐.
원래 Target Bounding Box와 Masked Image에서 생성된 Bounding Box의 위치가 얼마나 유사한지 측정함.
ii) Classification Similarity
두 Detection이 Class 측면에서 얼마나 유사한지를 확인하기 위해 Class Probability Vector 사이의 Cosine Similarity를 사용함.
Target Detection의 Class Probability Distribution과
Masked Image에서 생성된 Detection의 Class Probability Distribution이 얼마나 비슷한지를 측정함.
iii) Objectness Similarity
YOLOv3처럼 Objectness Score를 명시적으로 계산하는 Network에서는 Objectness도 Similarity에 포함함.
논문의 실험에서는 High-confidence Detection만 설명하기 때문에 Target Detection의 Objectness를 로 설정함.
따라서 Objectness Similarity는 다음과 같이 표현됨.
Masked Image에서 생성된 Detection이
얼마나 높은 Objectness를 가지는지도 Similarity에 반영함.
Faster R-CNN처럼 Objectness Score를 별도로 사용하지 않는 경우에는 이 Term을 생략할 수 있음.
iv) 최종 Detection Similarity
최종적으로 두 Detection Vector의 Similarity는 세 요소의 곱으로 정의함.
가 됨.
논문에서는 세 Similarity Value 사이의 Logical AND를 표현하기 위해 Scalar Product를 사용했다고 설명함.
=> 세 요소 중 하나라도 낮다면 전체 Similarity 역시 낮아짐.
ex. Class가 아무리 비슷하더라도 Bounding Box가 완전히 다른 위치에 있다면 IoU가 낮아지고, 결과적으로 전체 Detection Similarity도 낮아짐.
반대로 Bounding Box가 같은 위치에 있더라도 전혀 다른 Class로 판단했다면 Classification Similarity가 낮아지기 때문에 최종 Similarity도 낮아짐.
그래서 D-RISE에서는
같은 Class가 검출됐는지만 보는 게 아니라,
같은 위치에서, 비슷한 Class로, 높은 Objectness를 가진 Detection이 유지되었는지를 함께 확인하는 것.
3.3. Saliency Inference
앞의 내용을 모두 합치면 D-RISE의 전체 Saliency Map 생성 과정은 다음과 같음.
Step 1. Random Mask 생성
먼저 기존 RISE 방식으로 개의 Random Mask를 생성함.
Step 2. Target Detection Vector 생성
설명하고자 하는 개의 Target Detection을 Detection Vector로 변환함.
여기서 중요한 점은 Target Detection마다 Detector를 다시 실행할 필요가 없다는 것.
Masked Image에 대한 Detection 결과를 한 번 계산한 뒤,
그 결과를 모든 Target Detection의 Explanation에 사용할 수 있음.
Step 3. Masked Image에 Object Detector 적용
각 Random Mask 를 Original Image 에 적용함.
그리고 각각의 Masked Image를 Object Detector 에 입력하여 Detection Proposal을 생성함.
각 Masked Image에서 생성되는 Proposal Set은
로 표현됨.
(여기서 는 번째 Masked Image에서 생성된 Detection Proposal의 개수.)
Step 4. 각 Mask의 Weight 계산
각 Target Detection 에 대해 Masked Image에서 생성된 모든 Detection Proposal과 Similarity를 계산함.
그리고 그중 가장 높은 Similarity Score를 선택함.
- 는 번째 Mask를 적용했을 때 Target Detection이 얼마나 잘 유지되었는지를 나타내는 Weight.
- Target Detection과 매우 유사한 Detection이 유지되었다면 가 높아지고, Detection이 사라지거나 크게 달라졌다면 낮아짐.
Step 5. Weighted Sum으로 Saliency Map 생성
마지막으로 각 Mask 에 해당 Mask의 Similarity Weight 를 곱해서 모두 더함.
이렇게 하면 Target Detection 에 대한 최종 Saliency Map 를 얻을 수 있음.
Target Detection을 잘 유지시킨 Mask에 포함되어 있던 Pixel일수록 최종 Saliency Map에서 높은 값을 가지게 됨.
그리고
기존 RISE와 비교하면 구조가 상당히 비슷함.
RISE
: Random Mask에 대한 Target Class Score를 Weight로 사용함.
D-RISE
: Random Mask에 대한 Target Detection Similarity를 Weight로 사용함.
결국 D-RISE의 주요 변화
: RISE에서 사용하던 Class Score를 Detection Similarity Score로 대체한 것.
Implementation Detail
논문의 대부분의 Visual Experiment에서는 다음 설정을 사용함.
Random Mask 수: 5000개Mask Element가 1일 Probability: 0.5Initial Mask Resolution: 사용.
일부 Figure에서는 더 세밀한 Saliency Map을 얻기 위해
Mask를 사용함.
저자들은 Mask Resolution을 높이면 Saliency Map에 더 많은 Speckle이 발생한다고 설명함.
= Mask Resolution이 증가할수록 좋은 Saliency Approximation을 얻기 위해 더 많은 Mask가 필요하기 때문.
Average Saliency Map 계산에는 Mask를 사용함.
저자들은 이런 Parameter를 Computational Load와 Visual Quality 사이의 Balance를 고려하여 Heuristic하게 선택했다고 설명함.
Execution Time
Inference Time은 Mask의 개수 에만 의존함.
논문의 설정인 일 때
NVIDIA Tesla V100 기준으로 Image 한 장의 모든 Detection에 대한 D-RISE Saliency Map을 생성하는 데
- YOLOv3: 약 70초
- Faster R-CNN: 약 170초
소요됨.
정리하자면,
D-RISE는
기존 RISE의 Random Mask 기반 Perturbation 방식을 Object Detection에 맞게 확장한 것.
기존 RISE에서는 Mask를 적용한 뒤
Target Class Probability가 얼마나 유지되는지를 측정했다면,
D-RISE에서는
Target Detection이 얼마나 유지되는지를 측정함.
이를 위해 Detection을
로 표현하고,
Localization→ IoUClassification→ Cosine SimilarityObjectness→ Objectness Score
를 이용해서 최종 Detection Similarity를 계산함.
그리고 Masked Image에서 생성된 여러 Detection 중
Target Detection과 가장 유사한 Detection의 Score를 해당 Mask의 Weight로 사용함.
마지막으로 기존 RISE와 동일하게 Random Mask의 Weighted Sum을 계산함.
따라서
D-RISE를 가장 간단하게 표현하면,:
RISE의Class Score자리에Detection Similarity Score를 넣어
Object Detection까지 설명할 수 있도록 확장한 Black-box Saliency Method!
✅4. Experiments and Results
본 논문에서는 D-RISE를 Qualitative / Quantitative Experiment를 통해 평가함.
실험 Dataset으로는 Object Detection에서 널리 사용되는 MS-COCO Dataset을 사용함.
Object Detector는 PyTorch로 구현된 다음 두 Model을 사용함.
YOLOv3Faster R-CNN
비교를 위한 Baseline으로는
Grad-CAMGradient
를 사용함.
두 Baseline에서는 Detection Vector의 Class Probability Score를 설명 대상으로 사용함.
4.1. Sanity Checks
최근 일부 Saliency Method가 실제로는 Model이나 Training Data에 의존하지 않으면서도 그럴듯한 Visualization을 생성할 수 있다는 문제가 제기됨.
Model의 Weight를 Randomize했는데도 Saliency Map이 크게 변하지 않는다면
해당 Explanation이 실제 Model의 판단 근거를 설명한다고 보기 어려움.
이러한 문제를 확인하기 위해 저자들은 Model Parameter Randomization Test를 수행함.
Model의 Weight를 Random하게 초기화한 뒤 D-RISE Saliency Map을 다시 생성함.
그 결과 Weight가 Randomize된 Model에서는 해석할 수 없는 Saliency Map이 생성됨.
따라서 저자들은 D-RISE가 단순히 Input Image의 형태만을 따라 Saliency Map을 생성하는 것이 아니라, 학습된 Model의 정보를 이용하여 Explanation을 생성하고 있음을 확인함.
4.2. Automatic Metrics
Saliency Map을 평가하는 일반적인 방법 중 하나는
사람이 Labeling한 Ground Truth Mask와 Saliency Map 사이의 관계를 측정하는 것.
본 논문에서는 다음 Metric을 사용함.
Pointing GameDeletionInsertion
i) Pointing Game
Pointing Game은 Saliency Map에서 가장 높은 Saliency 값을 가지는 위치가 Ground Truth Object Region 내부에 존재하는지를 확인함.
Saliency가 최대인 Point가 Ground Truth Object Segmentation 내부에 존재하면 Hit, 그렇지 않으면 Miss로 판단함.
Pointing Game의 Accuracy는 전체 Hit의 비율로 계산함.
하지만 논문에서는 이러한 Ground Truth 기반 Metric에 한계가 있다고 설명함.
Ground Truth Mask와의 Correlation을 이용하는 방식은
Model이 Object 자체만을 이용해서 Prediction하고, 주변 Context는 사용하지 않는다는 가정을 가지고 있음.
하지만 Bias가 존재하는 Model에서는 이러한 가정이 성립하지 않을 수 있음.
앞에서 살펴봤듯이 Object Detector는 Object Bounding Box 외부의 Contextual Information을 이용할 수도 있기 때문임.
ii) Deletion
Deletion은 Saliency가 높은 Pixel부터 순차적으로 제거하면서 Model의 Prediction이 얼마나 빠르게 감소하는지 측정함.
Saliency Map이 중요하다고 판단한 Pixel을 제거했을 때 Detection 결과가 빠르게 무너지는지를 확인하는 Metric임.
좋은 Saliency Map이라면 정말 중요한 Pixel부터 제거하기 때문에 Model Output이 빠르게 감소해야 함.
따라서 Deletion Score는 낮을수록 좋음.
iii) Insertion
Insertion은 반대로 빈 Image에서 시작하여 Saliency가 높은 Pixel부터 순차적으로 추가함.
Saliency Map이 중요하다고 판단한 Pixel을 먼저 복원했을 때 Detection 결과가 얼마나 빠르게 회복되는지를 측정함.
좋은 Saliency Map이라면 중요한 Pixel부터 추가되므로 Model Prediction이 빠르게 증가해야 함.
따라서 Insertion Score는 높을수록 좋음.
본 논문에서는 기존 Classification용 Deletion / Insertion Metric을 그대로 사용하는 대신, 앞에서 정의한 Detection Similarity Score를 이용하여 D-RISE와 Baseline에 맞게 적용함.
Automatic Metric 결과
Table 1의 결과는 다음과 같음.
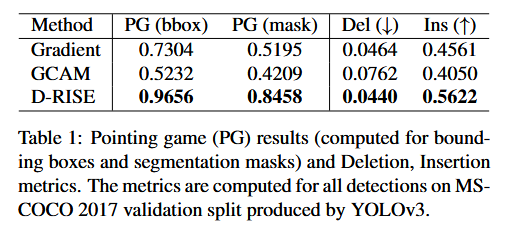
D-RISE는 모든 Metric에서 Baseline보다 좋은 결과를 보임.
특히 Pointing Game에서
, 로 높은 결과를 보임.
Deletion에서는 가장 낮은 0.0440을 기록했고,
Insertion에서는 가장 높은 0.5622를 기록함.
Grad-CAM과 Gradient의 문제
Figure 3에서는 YOLOv3 Detection을 대상으로 D-RISE, Grad-CAM, Gradient의 Saliency Map을 비교함.
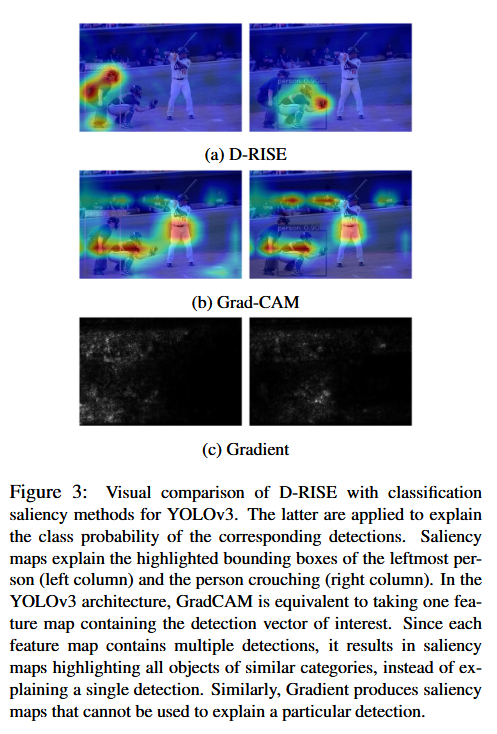
D-RISE는 각 Detection별로 별도의 Saliency Map을 생성할 수 있음.
반면 Grad-CAM은 Target Detection Vector가 아니라
Class Probability를 기준으로 Explanation을 생성하기 때문에,
동일 Category의 여러 Object가 존재하면 특정 Detection 하나가 아니라 같은 Category의 여러 Object를 함께 Highlight할 수 있음.
Gradient 역시 특정 Detection 하나를 설명하기 어려운 Saliency Map을 생성함.
따라서 논문에서는 하나의 Class Probability만 설명하는 기존 Classification Saliency Method로는 Object Detector의 Prediction을 의미 있게 설명하기 부족하다고 설명함.
D-RISE는 Detection의 전체 Output을 사용하고 Localization까지 고려하기 때문에 더 좋은 Saliency Map을 생성할 수 있음.
4.3. Modes of Detector Failure
논문에서는 D-RISE를 단순히 Detection 성공 사례를 설명하는 데 그치지 않고,
Object Detector의 Failure를 분석하는 데 활용함.
Object Detector의 Error는 크게 다음 세 가지로 구분할 수 있음.
1. Missing an Object Entirely
- 실제 Object가 존재하지만 Detector가 아예 검출하지 못함
2. Detecting an Object with Poor Bounding Box Localization
- Object를 검출했지만 Bounding Box 위치가 부정확함
3. Correct Localization but Misclassification
- Bounding Box 위치는 올바르지만 잘못된 Class로 분류함
- 비슷한 Class끼리 혼동하거나 Background와 혼동하는 경우 등이 포함됨
D-RISE를 이용하면 이러한 각각의 Failure Case에서
Model이 어떤 Image Region을 이용했는지 분석할 수 있음.
Missed Detection
D-RISE는 Black-box 방식이기 때문에
Model이 실제로 생성한 Detection뿐만 아니라
임의로 정의한 Detection Vector에 대해서도 Saliency Map을 생성할 수 있음.
따라서 Ground Truth Object가 존재하지만 Model이 이를 검출하지 못한 경우에도
Ground Truth Detection Vector를 Target으로 설정해서 Saliency Map을 계산할 수 있음.
이를 통해 왜 Model이 해당 Object를 놓쳤는지 분석할 수 있음.
(ex. Saliency Map이 Object의 일부를 중요하게 Highlight하고 있다면 Model이 해당 Object의 Discriminative Feature를 어느 정도 인식했지만,
이후 Processing 과정에서 Detection이 제거되었을 가능성이 있음.)
논문에서는 그 예로 Non-Maximum Suppression(NMS) 과정에서 제거되는 경우를 언급함.
반대로 Saliency Map이 Object 주변에서 의미 있는 Region을 전혀 찾지 못한다면,
Model이 해당 Object를 검출하는 데 필요한 Feature를 충분히 학습하지 못했을 가능성을 생각할 수 있음.
Figure 4에서는 Model이 Backpack을 Detection하지 못했음에도 Saliency Map에서는 Backpack의 Strap 부분에 집중하고 있는 사례를 보여줌.
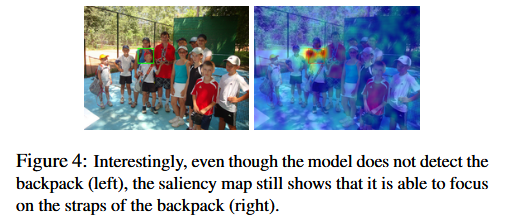
이렇게 Detection 자체는 실패했지만
Model 내부적으로는 해당 Object의 일부 Discriminative Feature에 반응하고 있었음을 확인할 수 있음.
Misclassification과 Poor Localization
Bounding Box 위치는 맞지만 Class가 잘못된 경우에는
Ground Truth DetectionPredicted Detection
각각에 대해 Saliency Map을 생성할 수 있음.
두 Saliency Map을 비교하면 어떤 Image Region이 Class Confusion에 영향을 주었는지 확인할 수 있음.
Poor Localization의 경우에도 Ground Truth Box와 Predicted Box 각각에 대한 Saliency Map을 생성하여 차이를 분석할 수 있음.
Figure 5에서는 Poor Localization과 Misclassification 사례를 보여줌.
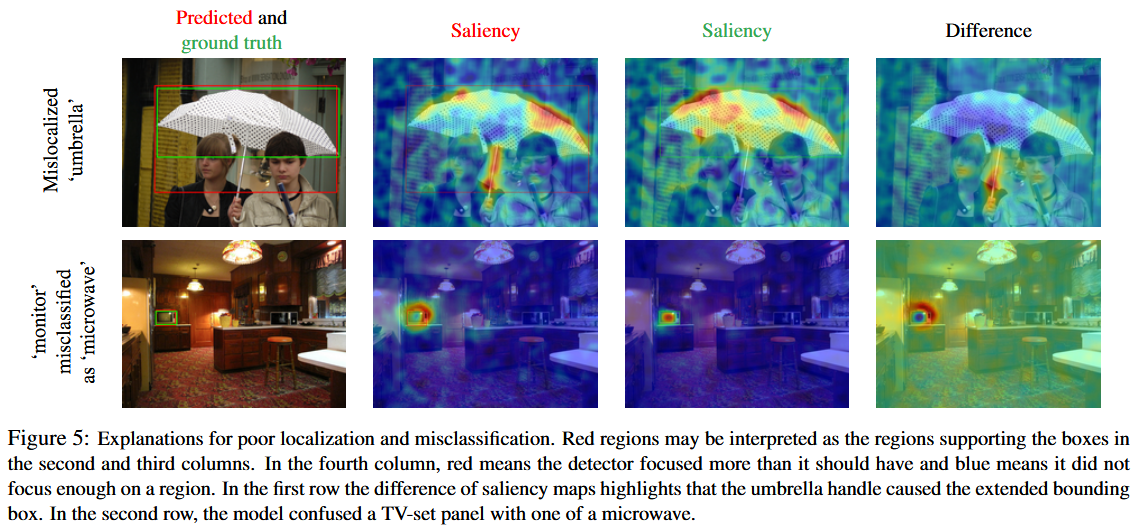
첫 번째 Row에서는 Umbrella의 Bounding Box가 실제보다 크게 예측된 사례가 나타남.
Ground Truth와 Predicted Detection의 Saliency Map 차이를 확인한 결과, Umbrella Handle이 Bounding Box를 확장시키는 데 영향을 주었다는 것을 확인함.
두 번째 Row에서는 Model이 TV-set Panel을 Microwave로 잘못 분류한 사례를 보여줌.
이처럼 D-RISE를 이용하면 단순히 Model이 틀렸다에서 끝나는 것이 아니라,
어떤 Image Region 때문에 Localization 또는 Classification Error가 발생했는지를 분석할 수 있음.
4.4. Average Saliency Maps
지금까지는 개별 Image의 Detection에 대한 Saliency Map을 분석했음.
하지만 저자들은 여기서 더 나아가 많은 Image에서 Model이 공통적으로 사용하는 Pattern을 분석하고자 함.
이를 위해 MS-COCO의 각 Category에 대해 Average Saliency Map을 생성함.
먼저 특정 Category의 모든 Detection을 수집함.
이후 각 Detection의 Bounding Box를 Crop하고 주변 Context를 포함한 뒤,
크기를 Normalize하여 평균 Saliency Map을 계산함.
이를 통해 특정 Class를 Detection할 때
Model이 평균적으로 Object의 어느 부분을 중요하게 사용하는지 확인할 수 있음.
Average Saliency Map이 보여주는 것
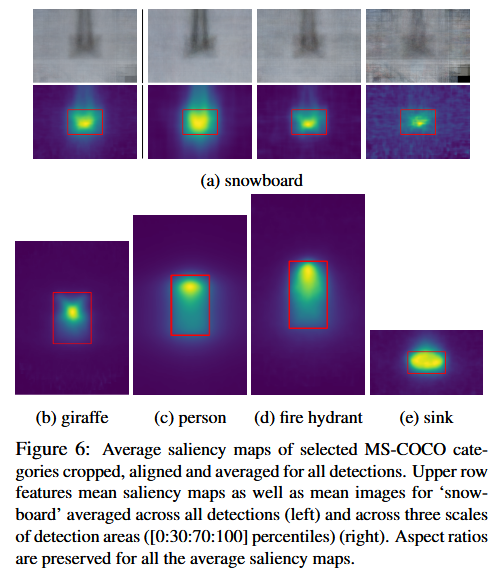
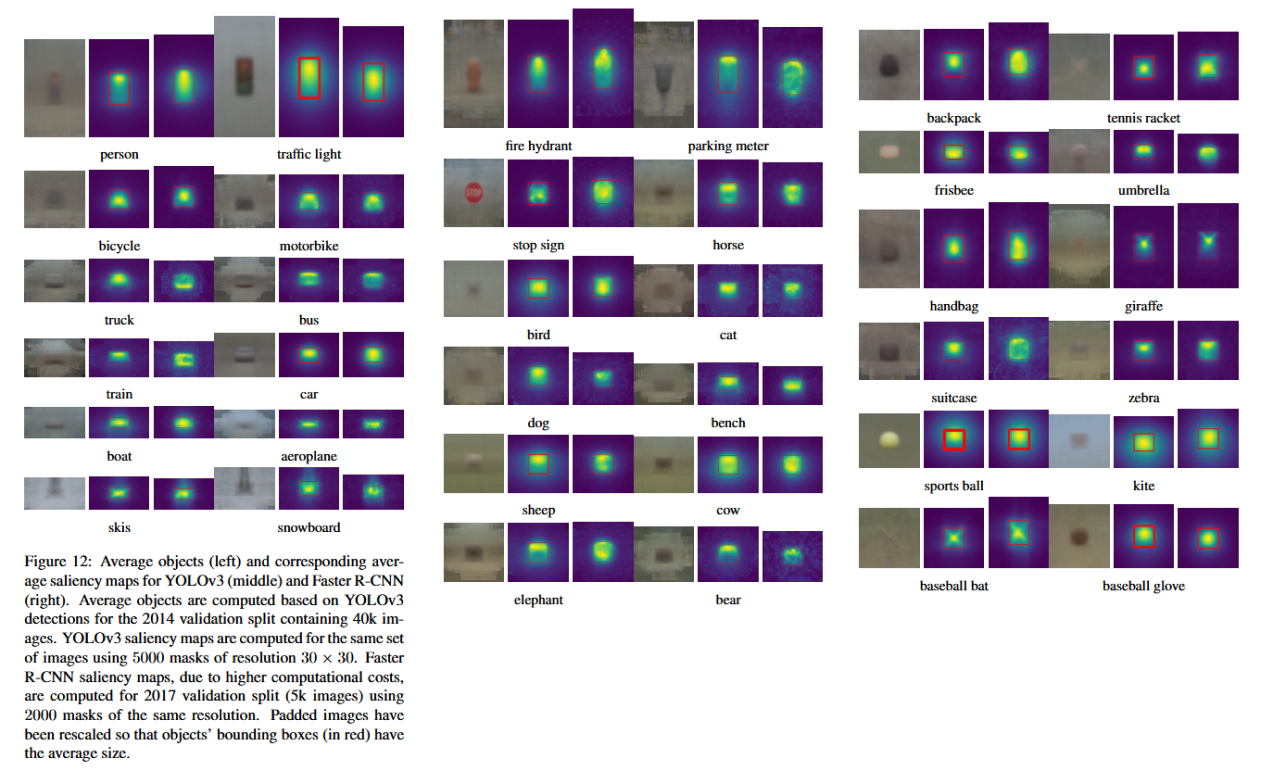
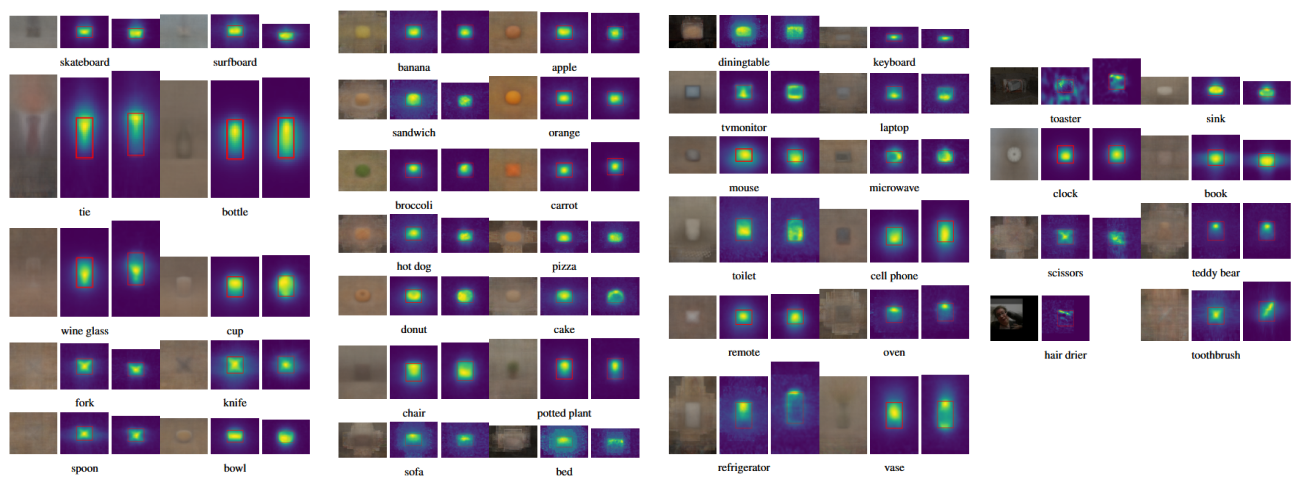
일부 Category에서는 특정 Object Part가 다른 부분보다 더 중요하게 나타남.
ex. person Class에서는 특정 Body Part가 다른 부분보다 높은 Saliency를 가질 수 있음.
반면 giraffe와 같은 Category에서는 Saliency가 Object 전체에 비교적 균일하게 분포하는 경우도 있음.
또한 Saliency가 Bounding Box 바깥에 많이 나타나는 Category도 존재함.
이는 Model이 해당 Class를 Detection할 때 Object 자체뿐만 아니라 주변 Context를 활용하고 있다는 의미.
논문에서는 sink Category를 예로 설명함.
Average Saliency Map을 분석한 결과 Sink 위쪽 영역에서 높은 Saliency가 나타남.
Dataset을 다시 확인해보니 Sink 자체의 일부로 Faucet이 Labeling된 것은 아니지만, 많은 Image에서 Faucet이 Sink 위에 존재하고 있었음.
Model은 이러한 Dataset의 Pattern을 학습해서
Faucet을 Sink Detection을 위한 Contextual Information으로 활용하고 있었음.
Average Saliency Map을 통해
Model이 Dataset에서 학습한 전반적인 Pattern과 Context Dependency를 분석할 수 있음을 보여줌.
4.5. Deliberate Bias Insertion Using Markers
D-RISE가 Object Detector의 Bias를 실제로 발견할 수 있는지 확인하기 위해 저자들은 의도적으로 Bias를 삽입하는 실험을 수행함.
MS-COCO Dataset에서
Fire HydrantStop Sign
이 포함된 모든 Image에 특정 Marker를 추가함.
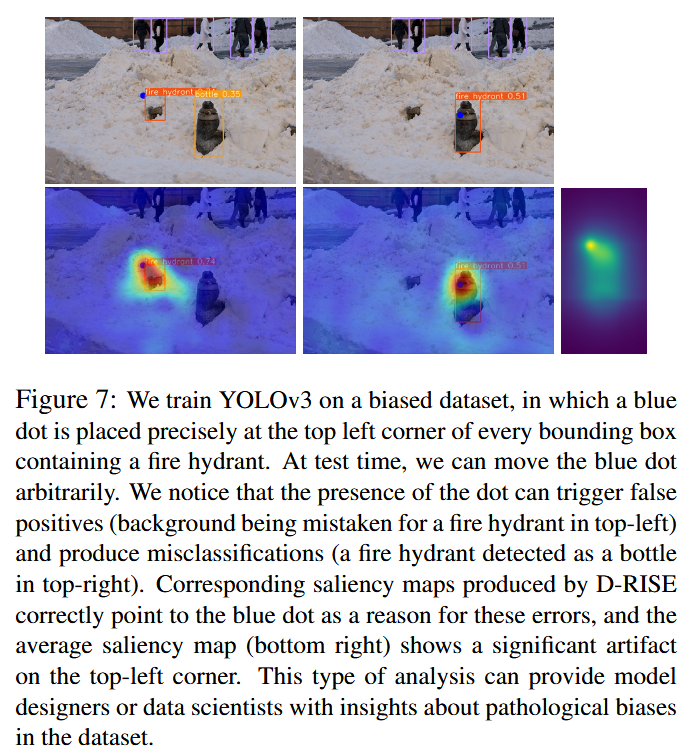
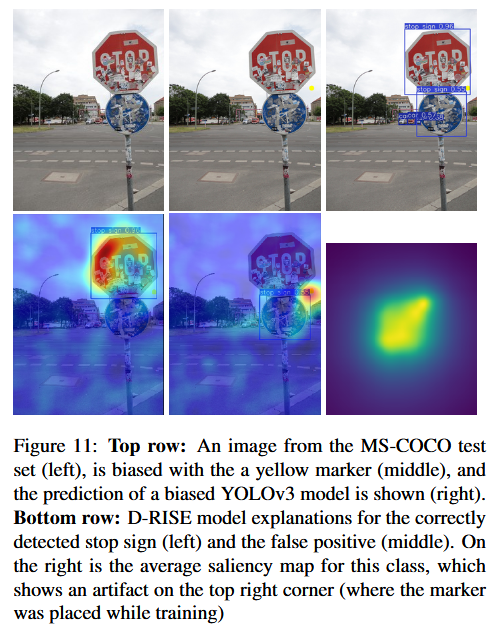
각 Bounding Box의
- Fire Hydrant → 왼쪽 위
- Stop Sign → 오른쪽 위
에 Circular Marker를 삽입함.
그리고 이러한 Biased Dataset의 50 Epoch으로 YOLOv3를 학습함.
Biased Dataset으로 학습된 Model을 Marker가 존재하지 않는 원래 MS-COCO Test Set에서 평가하면 mAP가 약
- Fire Hydrant: 10% 감소
- Stop Sign: 12% 감소
하는 것을 확인할 수 있었음.
반면 다른 Category의 성능은 거의 변하지 않음.
=> Model이 Fire Hydrant와 Stop Sign을 Detection할 때 Marker에 의존하는 Bias를 학습했다는 것을 확인할 수 있음.
Marker 위치를 바꾸면?
Test Image에서 Marker를 Random Position으로 이동시키면서 Detection과 D-RISE Explanation을 관찰함.
Figure 7에서 Fire Hydrant의 Bounding Box와 멀리 떨어진 곳에 Marker가 존재하더라도 Saliency Map은 Marker를 중요하게 Highlight함.
Model이 실제 Fire Hydrant Feature뿐만 아니라 학습 과정에서 삽입된 Marker를 Detection Evidence로 사용하고 있음을 D-RISE가 찾아냄.
False Positive와 Misclassification 분석
Marker가 Fire Hydrant Bounding Box에서 멀리 떨어져 있을 경우, Marker 자체 때문에 Background를 Fire Hydrant로 판단하는 False Positive가 발생할 수 있음.
또한 Fire Hydrant의 윗부분이 Bottle의 윗부분과 비슷하기 때문에 Fire Hydrant를 Bottle로 Misclassification하는 사례도 나타남.
D-RISE Saliency Map을 통해
이러한 Error가 Marker 또는 Object의 특정 Appearance와 관련되어 있음을 확인할 수 있음.
Average Saliency Map을 통한 Bias 분석
Average Saliency Map에서도 이러한 Bias를 확인할 수 있음.
Fire Hydrant Class의 Average Saliency Map에서는 왼쪽 위 영역에서 높은 Saliency가 나타남.
이는 Training Dataset에서 Marker가 항상 Bounding Box의 왼쪽 위에 위치하도록 삽입되었기 때문임.
=> D-RISE를 이용하면 개별 Image의 Bias뿐만 아니라 Dataset 전체에서 Model이 학습한 Pathological Bias도 분석할 수 있음.
4.6. Evaluating User Trust
Model Explanation의 중요한 목적 중 하나는
Human과 Machine Learning System 사이의 Trust를 형성하는 것.
저자들은 D-RISE Saliency Map이 사용자가 두 Object Detector 중 더 좋은 Model을 구분하는 데 도움을 줄 수 있는지 평가함.
비교 대상은 다음과 같음.
YOLOv3YOLOv3-Tiny
MS-COCO Test Set에서 각각의 mAP는
YOLOv3: 55.3%YOLOv3-Tiny: 33.1%
= YOLOv3가 더 높은 Detection 성능을 가지고 있음.
User Study
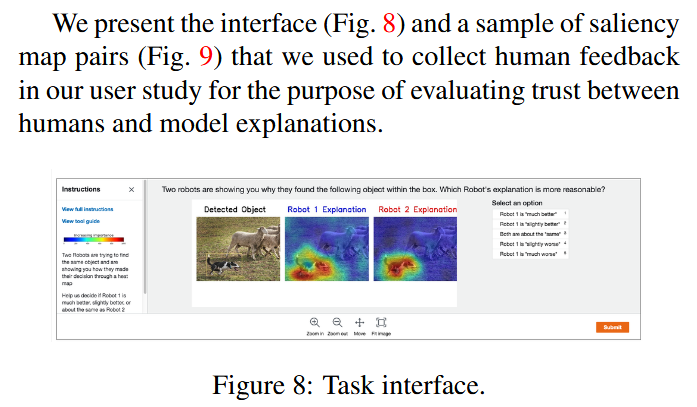
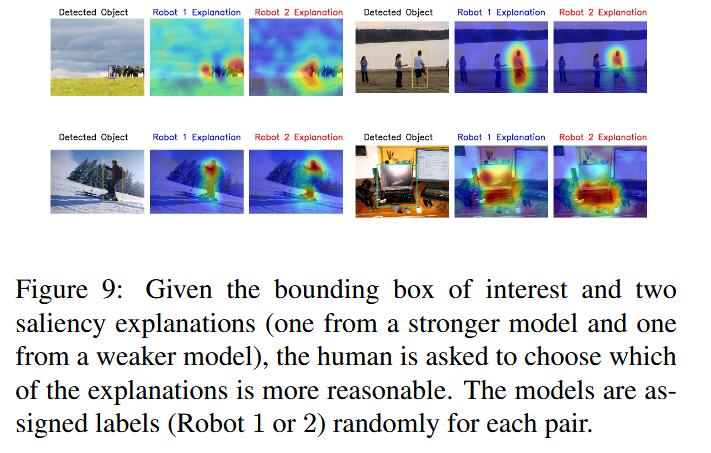
두 Model이 모두 올바르게 Detection한 242개의 Unique Object를 선택함.
중요한 점은 두 Model 모두 Detection 자체는 성공했기 때문에 사용자는 단순히 Prediction 결과만 보고 어느 Model이 더 좋은지 판단할 수 없다는 것.
사용자에게 다음을 보여줌.
Full ImageObject of InterestYOLOv3의 D-RISE Saliency MapYOLOv3-Tiny의 D-RISE Saliency Map
그리고 두 Explanation 중 어느 것이 더 좋은지 평가하도록 함.
각 Object마다 5개의 응답을 수집했으며,
총 32명의 Mechanical Turk User가 참여함.
평가는 +2부터 -2까지의 Scale을 사용함.
- : 첫 번째 Explanation이 훨씬 좋음
- : 첫 번째 Explanation이 훨씬 나쁨
User Study 결과
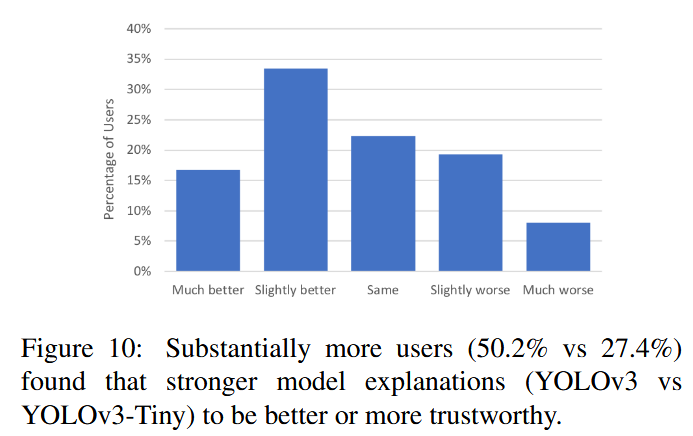
실험 결과
- 50.2%의 경우 더 정확한 Model인
YOLOv3의 Explanation을 더 신뢰할 수 있다고 평가함 - 27.4%의 경우
YOLOv3-Tiny의 Explanation을 더 신뢰할 수 있다고 평가함
= 더 많은 사용자가 실제로 Detection 성능이 높은 Model의 Saliency Map을 더 Trustworthy하다고 판단함.
이를 통해 D-RISE Explanation이 사용자가 Model의 품질을 비교하는 데 일정 부분 도움을 줄 수 있음을 보여줌.
🔚5. Conclusion
본 논문에서는 Black-box Object Detector를 설명하기 위한 새로운 Saliency-based Explanation Method인
D-RISE를 제안함.
D-RISE는 특정 Object Detector에 종속되지 않기 때문에
서로 다른 Architecture를 가지는 다양한 Detector에 적용할 수 있음.
또한 D-RISE를 이용하면 개별 Detection의 Explanation뿐만 아니라
여러 Detection의 Saliency Map을 평균하여 Model이 Dataset에서 공통적으로 학습한 Pattern을 분석할 수 있음.
논문에서는 이런 특성을 이용해서
Object Detector의 Error 분석Model Bias 분석Per-class Average Saliency Map 분석User Trust 평가
등을 수행함.
특히 Object Detection에서는
Classification과 달리
Class뿐만 아니라 Localization까지 설명해야 한다는 문제가 존재하는데,
D-RISE는 Detection Similarity Metric을 이용해서 이를 해결함.
다만 저자들은 이러한 분석이 Retrospective Analysis라는 점도 언급함.
D-RISE를 통해 Model의 이상한 행동이나 Bias를 발견할 수는 있지만,
이러한 Insight를 실제 Model Performance의 유의미한 개선으로 연결하는 것은 향후 연구 과제로 남아 있음.
