ChatOption
- 개념: Prompt 객체 안에 포함되어 AI 모델에 요청을 보낼 때 모델의 동작 방식, 생성 규칙, 출력 형식 등을 제어하는 설정값의 집합입니다.
- 역할: 특정 벤더(OpenAI, Claude 등)에 종속되지 않고 공통된 인터페이스 규격을 통해 다양한 AI 모델의 세부 옵션을 일관되게 조작할 수 있도록 돕습니다.
Prompt는 LLM에 전달할 대화 목록(messages)과 모델 실행 옵션(options)을 함께 담아 ChatModel에 전달하는 최종 요청 객체이다.
주요 속성 및 설명
| 구분 | 타입 | 설명 | 비고 |
|---|---|---|---|
model | String | 호출할 AI 모델 식별자 | e.g. gpt-4o-mini |
temperature | Double | 토큰 선택의 무작위성 조절 (창의성) | 낮을수록 일관된 답변 생성 ↑ |
maxTokens | Integer | 모델이 생성할 최대 토큰 수 | 출력 글자 수/길이 제한 |
topP | Double | 누적 확률 기반 Sampling 범위 (0.0 ~ 1.0) | e.g. 0.9 |
topK | Integer | 확률 상위 K개 토큰으로 Sampling 후보 제한 | 모델에 따라 미지원될 수 있음 |
stopSequences | List<String> | 특정 문자열 생성 시 응답 생성을 강제 중단 | 모델에 따라 동작 차이 있음 |
Temparature
Temperature의 개념
- LLM이 다음 토큰을 선택할 때 확률 분포를 얼마나 보수적으로 또는 다양하게 사용할지를 조절하는 설정값입니다.
- AI 응답의 무작위성(Randomness)과 창의성(Creativity)을 제어하는 핵심 파라미터 역할을 합니다.
설정값별 특성 및 적합한 용도
0.0: 확률 분포가 매우 뾰족해져 가장 확률이 높은 토큰에 선택이 집중되며, 매우 결정적이고 일관된 응답을 생성합니다. (적합 용도: 코드 작성, 데이터 분류, 정보 추출, 정형 응답)0.7: 일관성과 다양성의 균형을 맞춘 설정으로, 일반적인 질의응답, 설명, 문서 작성에 가장 널리 사용됩니다.1.0: 다양성과 창의성이 증가하여 새로운 아이디어를 도출하거나 브레인스토밍을 할 때 유용합니다.1.5: 확률 분포가 평탄해져 무작위성이 매우 높아지며, 평소에 잘 선택되지 않던 낮은 확률의 토큰도 자주 채택되어 창작이나 다양한 아이디어 탐색에 적합합니다.
동작 원리 예시 ("Spring AI는 매우 ___")
Temperature = 0.0: 가장 확률이 높은 답변(예: "좋은")만 고정적으로 출력되므로 예측 가능성과 정확성이 극대화되지만 다양성은 낮아집니다.Temperature = 0.7: 확률이 높은 후보(좋은, 유용한 등)가 주로 선택되지만, 동일한 질문을 여러 번 던졌을 때 간헐적으로 다른 후보가 선택될 수 있는 자연스러운 변동성이 생깁니다.Temperature = 1.5: 후보 간의 확률 격차가 줄어들어 상대적으로 확률이 낮았던 단어(예: "재미있는")가 선택될 가능성도 함께 커지므로 다채롭고 파격적인 문장이 만들어집니다.
TopK, TopP
LLM이 다음 단어를 선택할 때 무작위성을 제어하고 엉뚱한 답변을 방지하기 위해 후보 토큰의 범위를 제한하는 핵심 샘플링 제어 기법입니다.
Top-K (Top-K Sampling)
- 개념: 확률이 높은 순으로 정렬했을 때 상위 K개의 토큰만 후보로 남겨 그 안에서 다음 토큰을 선택합니다.
- 동작 예시 (
Top−K=2):- 전체 토큰 후보 중 확률이 가장 높은 상위 2개인 '맑네요(50%)'와 '흐리네요(30%)'만 선택 후보로 남고, 나머지 3순위 이하 토큰들은 배제됩니다.
- 남은 후보들 사이에서 확률이 재계산되어 '맑네요'는 약 62.5%, '흐리네요'는 약 37.5%의 비중으로 샘플링 대상이 됩니다.
- 설정 특성: K값을 낮추면 후보 풀이 좁아져 일관성이 증가하고, K값을 높이면 후보가 늘어나 다양성이 증가합니다.
Top-P (Nucleus Sampling)
- 개념: 확률이 높은 토큰부터 차례대로 누적하여 지정한 확률 P에 도달하는 최소한의 후보 집합을 구성한 뒤 그 안에서 다음 토큰을 선택합니다.
- 동작 예시 (
Top−P=0.9):- 확률이 높은 순서대로 토큰의 확률을 누적합니다 ('맑네요' 50% → '흐리네요' 누적 80% → '좋네요' 누적 90%).
- 누적 확률이 정확히 0.9(90%)가 되는 '여기까지'의 범위에 포함된 토큰들만 선택 후보로 삼고, 나머지 90%를 초과하는 하위 토큰들은 제외합니다.
- 활용 의의: 고정된 개수(K)를 지정하는 대신 문맥의 불확실성에 따라 동적으로 후보군의 크기가 유연하게 조절되므로 자연스럽고 안정적인 문장 생성이 가능합니다.
ChatClient에서 ChatOptions를 설정하는 방식
1. Chain 방식을 이용한 동적 설정
- 개념: 특정 요청을 보낼 때마다 메서드 체인 내부에서
ChatOptions.builder()를 호출하여 모델 이름, temperature, topP, maxToken 등의 옵션을 직접 지정하고 조립하는 방식입니다. - 특징: 질문의 성격에 따라 그때그때 옵션값(예: 창의적인 답변이 필요할 때와 정형화된 코드가 필요할 때)을 유연하게 다르게 줄 수 있어 일회성 또는 특수 목적 요청에 적합합니다.
String answer = chatClient
    .prompt()
    .user("Spring AI에서 ChatOptions 설정 예제를 보여줘.")
    // 요청할 때마다 필요한 옵션(모델, 온도, Top-P, Top-K, 최대 토큰)을 직접 빌더로 생성하여 동적으로 주입
    .options(ChatOptions.builder()
        .model("gpt-4o-mini")
        .temperature(0.5)
        .topP(0.95)
        .topK(50)
        .maxTokens(200)
    )
    .call()
    .content();

System.out.println(answer);
2. 공통 Bean 등록 및 재사용 방식
- 개념: 스프링
@Configuration클래스 내에 공통으로 사용할 옵션 설정을@Bean으로 미리 정의해 두고 필요한 서비스나 컴포넌트에서 주입받아 재사용하는 방식입니다. - 특징:
ChatConfig에서ChatOptions.builder()를 통해 기본 규칙(모델, 온도 등)을 미리 세팅해 둡니다.- 비즈니스 로직 클래스에서는
@Autowired등을 통해 해당 옵션을 주입받아.options(commonChatOptions)형태로 간결하게 갖다 쓰므로 프로젝트 전반의 설정 일관성을 유지하기 좋습니다.
@Configuration
public class ChatConfig {

    @Bean
    public ChatOptions.Builder<?> commonChatOptions() {
        // 프로젝트 전반에서 공통으로 사용할 LLM 기본 설정값(모델, 온도, Top-P, 토큰 수)을 Bean으로 미리 정의
        return ChatOptions.builder()
            .model("gpt-4o-mini")
            .temperature(0.3)
            .topP(0.9)
            .maxTokens(500);
    }
}

// 위에서 정의한 공통 옵션을 주입받아 사용하는 클래스
@Autowired
ChatOptions commonChatOptions;

public void ask() {
    String result = chatClient
        .prompt()
        .user("Hello!")
        // 미리 공통으로 설정해 둔 ChatOptions 빈을 가져와서 간편하게 적용
        .options(commonChatOptions)
        .call()
        .content();

    System.out.println(result);
}
Prompt
Prompt의 정의
LLM에게 역할, 맥락(Context), 지시사항, 사용자 질문 등을 전달하여 모델의 응답 생성을 유도하는 입력입니다.
Spring AI 관점에서는 LLM에 전달할 Message들과 모델 실행 옵션(ChatOptions)을 하나로 구성하여 ChatModel에 전달하는 요청 객체입니다.
Prompt의 4가지 핵심 구성 요소
| 구성 요소 | 설명 및 역할 | 구체적 예시 |
|---|---|---|
| 1. Context (맥락 / 배경) | 답변을 판단하는 데 참고할 배경 정보 | "너는 10년 차 시니어 스프링 아키텍트다." |
| 2. Instruction (지시 / 작업) | 모델이 수행할 구체적인 액션과 생각하는 방식을 통제 | "주어진 코드의 취약점을 분석하고 리팩토링 코드를 작성하라." |
| 3. Input Data (대상 데이터) | 실제로 처리해야 하는 원시 데이터 (Raw material) | 분석할 소스코드, 로그 파일, JSON, 표 데이터 등 |
| 4. Output Indicator (형식 / 제약) | 결과물이 시스템 및 사용자에게 전달될 때 갖춰야 할 형식 및 제약 | 데이터 스키마 강제(JSON), Markdown 표, "300자 이내" |
Prompt 클래스 구조 및 구성요소
클래스 정의: Prompt는 AI 모델에 전달하기 위한 메시지 목록(List<Message>)과 대화 옵션(ChatOptions)을 함께 담아 전달하는 컨테이너 역할을 수행하며 ModelRequest<List<Message>> 인터페이스를 구현합니다.
// ChatModel에 전달하는 모델 요청 객체
public final class Prompt implements ModelRequest<List<Message>> {
  // LLM에 전달할 Message 목록
  private final List<Message> messages;
  // 모델 호출 옵션 (model, temperature, maxTokens 등)
  private final ChatOptions options;
}
핵심 필드:
messages: 시스템, 사용자, 어시스턴트 등 LLM과 대화하기 위한 메시지들의 리스트modelOptions: 모델 실행 옵션 (ChatOptions)
Message 클래스
Message 공통 기본 필드:
messageType: 메시지 역할을 구분하는 타입 (SYSTEM, USER, ASSISTANT, TOOL)textContent: 텍스트 본문 내용media: 이미지, 오디오 등의 멀티모달 데이터 (List<Media>)metadata: 토큰 수나 실행 속성 등을 담는 부가 정보 맵 (Map<String, Object>)
Message 클래스의 4가지 유형
SystemMessage- LLM이 수행해야 할 역할, 지침, 규칙 등을 미리 정의해 주는 시스템 지시사항입니다.
- 예시: "너는 친절하고 전문적인 고객 센터 상담원이야. 답변은 항상 3줄 이내의 존댓말로 간결하게 작성해줘."
UserMessage- 사용자가 입력한 요청 사항이며, 텍스트뿐만 아니라 이미지나 오디오 같은 멀티미디어(Media) 데이터도 함께 포함할 수 있습니다.
- 예시: "이번에 구매한 스마트폰 영수증인데 보증 기간이 언제까지인지 사진 보고 확인해줘." (텍스트 + 영수증 이미지 데이터)
AssistantMessage- 사용자의 질문에 대한 LLM(AI)의 응답이며 필요시 내부 기능을 실행하기 위한 ToolCall 정보를 함께 포함할 수 있습니다.
- 예시: "고객님, 영수증 확인 결과 보증 기간은 2027년 8월까지입니다. 추가로 남은 AS 센터 위치를 조회해 드릴까요?"
ToolResponseMessage- AI가 요청한 Tool(자바 메서드 등)을 실제로 실행한 뒤, 그 결과를 다시 LLM에게 돌려줄 때 사용하는 메시지입니다.
- 예시:
{"location": "분당센터", "distance": "1.2km"}(AI가 요청한 주변 AS 센터 조회 자바 메서드의 실행 결과 데이터를 다시 AI에게 전달)
ChatClient에서 SystemMessage 활용 코드 예시
// 1. 이미 만들어진 SystemMessage 객체를 .messages()로 전달하는 방식
SystemMessage systemMessage = SystemMessage.builder()
    .text("""
        너는 Spring AI 교육을 도와주는 조교입니다. 질문에 친절하고 친근하게 답해주세요
        """)
    .build();

return this.chatClient.prompt()
    .messages(systemMessage)
    .user(userInput)
    .call()
    .content();

// 2. 순수 문자열을 .system()에 바로 전달하는 방식 (가장 간편한 방법)
return this.chatClient.prompt()
    .options(chatOptions)
    .system("""
        너는 바다를 항해하는 해적입니다. 질문에 터프하고 직설적으로 답해주세요
        """)
    .user(userInput)
    .call()
    .content();
.system("순수 문자열"): 문자열을 넣으면 스프링이 알아서 SystemMessage 객체로 감싸서 적용해 주는 방식.messages(SystemMessage 객체): 개발자가 직접 빌더 등으로 미리 만들어 둔 SystemMessage 객체를 통째로 집어넣는 방식
Chat Model 호출 흐름
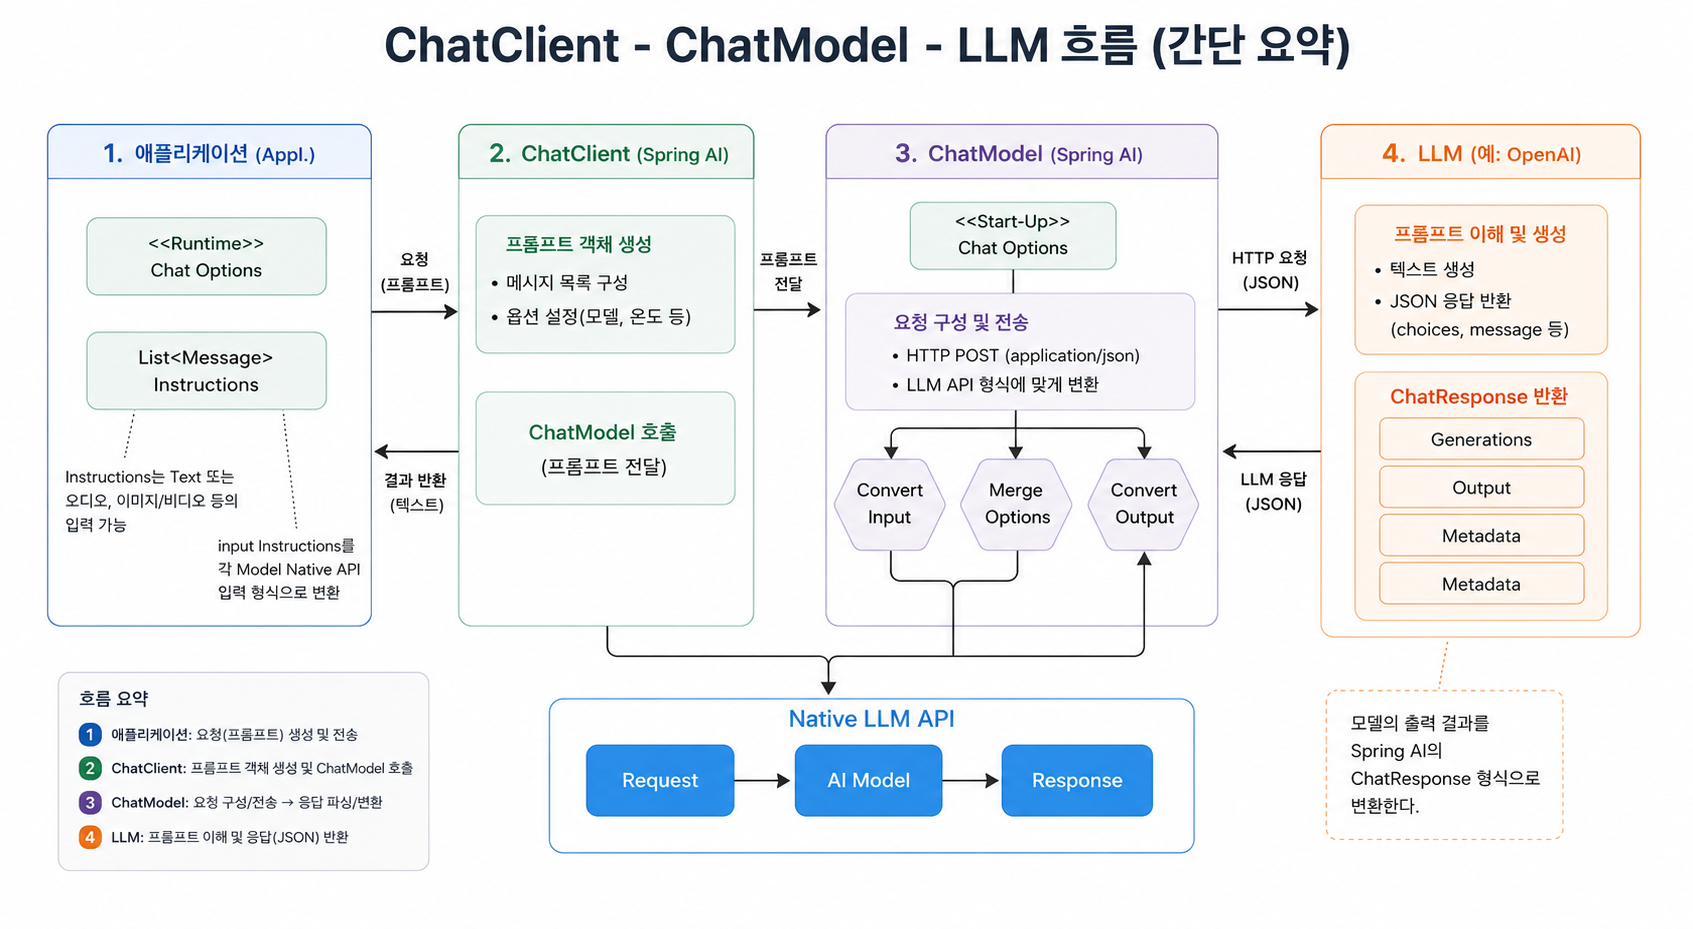
Spring AI에서 Prompt 객체가 생성되어 ChatModel을 거쳐 실제 AI 모델에 전달되고 응답이 반환되기까지의 전체 처리 파이프라인을 나타냅니다.
1. Prompt 생성 및 입력 단계
- Instructions (
List<Message>): 텍스트뿐만 아니라 오디오, 이미지, 비디오 등의 멀티모달 데이터 입력을 포함한 대화 메시지 목록입니다. - Runtime Chat Options: 매 요청마다 동적으로 전달되는 옵션으로, 초기 설정값보다 우선 적용됩니다.
2. ChatModel 내부 처리 단계
- Convert Input: 프롬프트의 지시사항과 메시지를 각 AI 모델(OpenAI, Anthropic 등)의 Native API가 이해할 수 있는 입력 형식으로 변환합니다.
- Merge Options:
- Start-Up 옵션: ChatModel 초기화 시점에 설정되는 기본 옵션입니다.
- Runtime 옵션: 요청마다 전달되는 옵션이며, 값이 지정되어 있다면 시작 시 설정된 기본 옵션을 덮어씁니다.
- Convert Output: AI 모델이 반환한 응답 결과를 스프링 AI 표준 규격인
ChatResponse형식(Generations, Output, Metadata 포함)으로 변환합니다.
3. Native LLM API 호출 및 응답
변환된 요청(Request)이 실제 AI 모델로 전달되어 처리된 뒤, 최종 응답(Response)이 ChatResponse 객체에 담겨 호출부로 반환됩니다.
Spring AI 통합 형식의 네이티브 변환 개념
- 추상화의 역할: 개발자는 특정 AI 벤더(OpenAI, Anthropic 등)의 복잡한 API 규격에 일일이 맞출 필요 없이 Spring AI의 통일된 단일 API 코드(
chatClient.prompt())만 작성하면 됩니다. - 모델별 자동 변환: 프레임워크 내부에서 사용자가 작성한 프레임워크 표준 형식을 각 AI 벤더가 요구하는 네이티브 HTTP Request JSON 형식으로 자동 변환하여 전송합니다.
- Anthropic Claude: 시스템 역할을 하는 지침을 최상위 system 필드로 분리하고 사용자 메시지는 messages 배열에 담습니다.
- OpenAI: 시스템 메시지를 포함한 모든 대화 이력을 messages 배열 안에 role 값(system, user)으로 순차적으로 담아 전달합니다.
// Spring AI의 통합 표준 형식으로 작성된 클라이언트 요청 코드
ChatResponse response = chatClient.prompt()
    // AI의 성격, 규칙, 페르소나를 정의하는 시스템 지시사항 설정
    .system("당신은 친절한 AI 어시스턴트입니다")
    // 사용자가 입력한 실제 질문이나 요청 내용 설정
    .user("안녕하세요")
    // AI 모델의 응답 성향을 제어할 실행 옵션(Chat Options) 구성
    .options(ChatOptions.builder()
        .temperature(0.7) // 응답의 무작위성(창의성) 제어값 설정
        .maxTokens(1000)   // 모델이 생성할 수 있는 최대 토큰 수 제한
        .build())
    // 설정을 완료하고 지정된 LLM으로 요청 전송
    .call()
    // 모델의 출력을 Spring AI 표준 규격인 ChatResponse 객체로 획득
    .chatResponse();
// Anthropic Claude 네이티브 요청 구조
{
"model": "claude-3-5-sonnet-20241022",
"system": "당신은 친절한 AI 어시스턴트입니다",
"messages": [
{
"role": "user",
"content": "안녕하세요"
}
],
"temperature": 0.7,
"max_tokens": 1000
}
// OpenAI 네이티브 요청 구조
{
"model": "gpt-4-mini",
"messages": [
{
"role": "system",
"content": "당신은 친절한 AI 어시스턴트입니다"
},
{
"role": "user",
"content": "안녕하세요"
}
],
"temperature": 0.7,
"max_tokens": 1000
}동적 프롬프트
- 개념: 고정된 텍스트만 사용하는 정적 프롬프트와 달리, 실행 시점(Runtime)에 사용자의 입력값이나 외부 데이터(변수)를 프롬프트 내부의 특정 위치에 실시간으로 삽입하여 완성하는 방식입니다.
- 필요성: 사용자가 입력한 이름, 검색된 문서 내용(RAG), 조회할 영화 감독 이름(composerName) 등 가변적인 데이터에 따라 프롬프트 내용을 유연하게 조립해야 할 때 필수적으로 사용됩니다.
동적 프롬프트 구현 방식 비교
| 방식 | 사용 빈도 | 주요 사용 목적 / 특징 |
|---|---|---|
| ChatClient 내장 바인딩 | 높음 | 추가 객체 생성 없이 .user(text, params)로 직관적 처리 |
| PromptTemplate | 보통 | 외부 파일(Resource) 관리 및 템플릿 재사용 시 유용 |
| String.format | 보통 | 하드코딩된 아주 간단한 동적 파라미터 1~2개 처리 시 사용 |
1. ChatClient 내장 바인딩
추가 객체 생성 없이 .user() 메서드 내부에서 람다식을 이용해 텍스트와 파라미터를 한 번에 처리합니다.
String composerName = "John Williams";

String answer = chatClient.prompt()
    .user(u -> u.text("Tell me the names of 5 movies whose soundtrack was composed by {composer}")
             .param("composer", composerName))
    .call()
    .content();

System.out.println(answer);
2. PromptTemplate 클래스 사용 방식 (자바 코드 내 정의)
PromptTemplate에 템플릿 문자열을 정의하고, .render(Map.of(...))를 통해 변수 매핑 후 문자열로 변환하여 활용합니다.
PromptTemplate template = new PromptTemplate(
    "Tell me the names of {count} movies whose soundtrack was composed by {composer}."
);

String renderedPrompt = template.render(Map.of(
    "composer", "John Williams",
    "count", 5
));

String answer = chatClient.prompt()
    .user(renderedPrompt)
    .call()
    .content();

System.out.println(answer);
3. 외부 .st 파일(Resource) 연동 방식
프로젝트 내부에 프롬프트 파일을 따로 분리하여 관리하고 @Value로 읽어와 템플릿화합니다.
// 파일 경로: src/main/resources/prompts/movie-composer.st
// 파일 내용: Tell me the names of {count} movies whose soundtrack was composed by {composer}.

@Value("classpath:/prompts/movie-composer.st")
private Resource moviePromptResource;

public String getMovies(String composerName, int count) {
    PromptTemplate template = new PromptTemplate(moviePromptResource);

    String renderedPrompt = template.render(Map.of(
        "composer", composerName,
        "count", count
    ));

    return chatClient.prompt()
        .user(renderedPrompt)
        .call()
        .content();
}
4. Java 기본 String.format / formatted 활용 방식
자바 기본 문자열 포맷팅 기능을 이용해 하드코딩된 소규모 파라미터를 빠르게 주입합니다.
String composerName = "John Williams";

// String.format 이용
String userPrompt1 = String.format("Tell me the names of 5 movies whose soundtrack was composed by %s", composerName);

// Java 15 이상 .formatted() 이용
String userPrompt2 = "Tell me the names of 5 movies whose soundtrack was composed by %s".formatted(composerName);

String answer = chatClient.prompt()
    .user(userPrompt2)
    .call()
    .content();

System.out.println(answer);
Structured Output
구조화된 출력의 필요성과 문제점
LLM은 기본적으로 자유 형식의 텍스트(Unstructured Text)를 생성하도록 설계되어 있어 이를 기업 애플리케이션이나 시스템에 연동할 때 여러 한계가 발생합니다.
- 타입 안전성(Type Safety) 부족: AI 응답이 단순 문자열이면 데이터베이스 저장이나 서비스 전달을 위해 매번 파싱 로직을 직접 구현해야 합니다.
- 환각(Hallucination) 및 스키마 위반: 프롬프트에 "JSON 형식으로 줘"라고 요구해도 모델이 임의의 설명 문구를 덧붙이거나("네, 요청하신 JSON입니다..."), 필드명을 임의로 변경하여 응답 규격이 깨지는 경우가 잦습니다.
- 시스템 연동의 한계: 다른 Microservice나 UI 컴포넌트가 안정적으로 데이터를 받아 처리하려면 엄격한 API 응답 규격이 보장되어야 합니다.
구조화된 출력이 필수적인 이유 (비정형 vs 구조화 비교)
LLM의 출력이 다음 단계의 입력(코드, API, 에이전트 등)으로 이어질 때는 구조화가 선택이 아닌 필수가 됩니다.
- 기계 친화성(Machine-readable):
{"action": "deploy", "target": "prod"}와 같은 JSON 형태는 코드로 바로 파싱하여 로직(if (result.action().equals("deploy")))에 적용할 수 있습니다. - 계약(Contract) 기반 통신: LLM과 애플리케이션 사이에 고정된 형태의 API Contract를 구성하여 컴포넌트처럼 활용할 수 있습니다.
- 테스트 용이성:
assertThat(result.weather.temperature).isEqualTo(5);와 같이 정형화된 객체 필드를 검증하는 테스트 코드를 작성할 수 있습니다. - Agent/Tool 기반 확장: Structured Output을 기반으로 Tool 호출 판단, RAG 호출, Agent 및 MCP Server 호출 등의 자동화 작업이 원활해집니다.
| 구분 | Unstructured (비정형) | Structured (구조화) |
|---|---|---|
| 대상 | 사람 | 사람 + 기계 |
| 파싱 | 불안정 | 안정 |
| 자동화 | 불가능 | 가능 |
| 테스트 | 어려움 | 쉬움 |
| Agent/Tool | 불가능 | 가능 |
| 운영 적합성 | 낮음 | 높음 |
StructuredOutputConverter 인터페이스의 역할
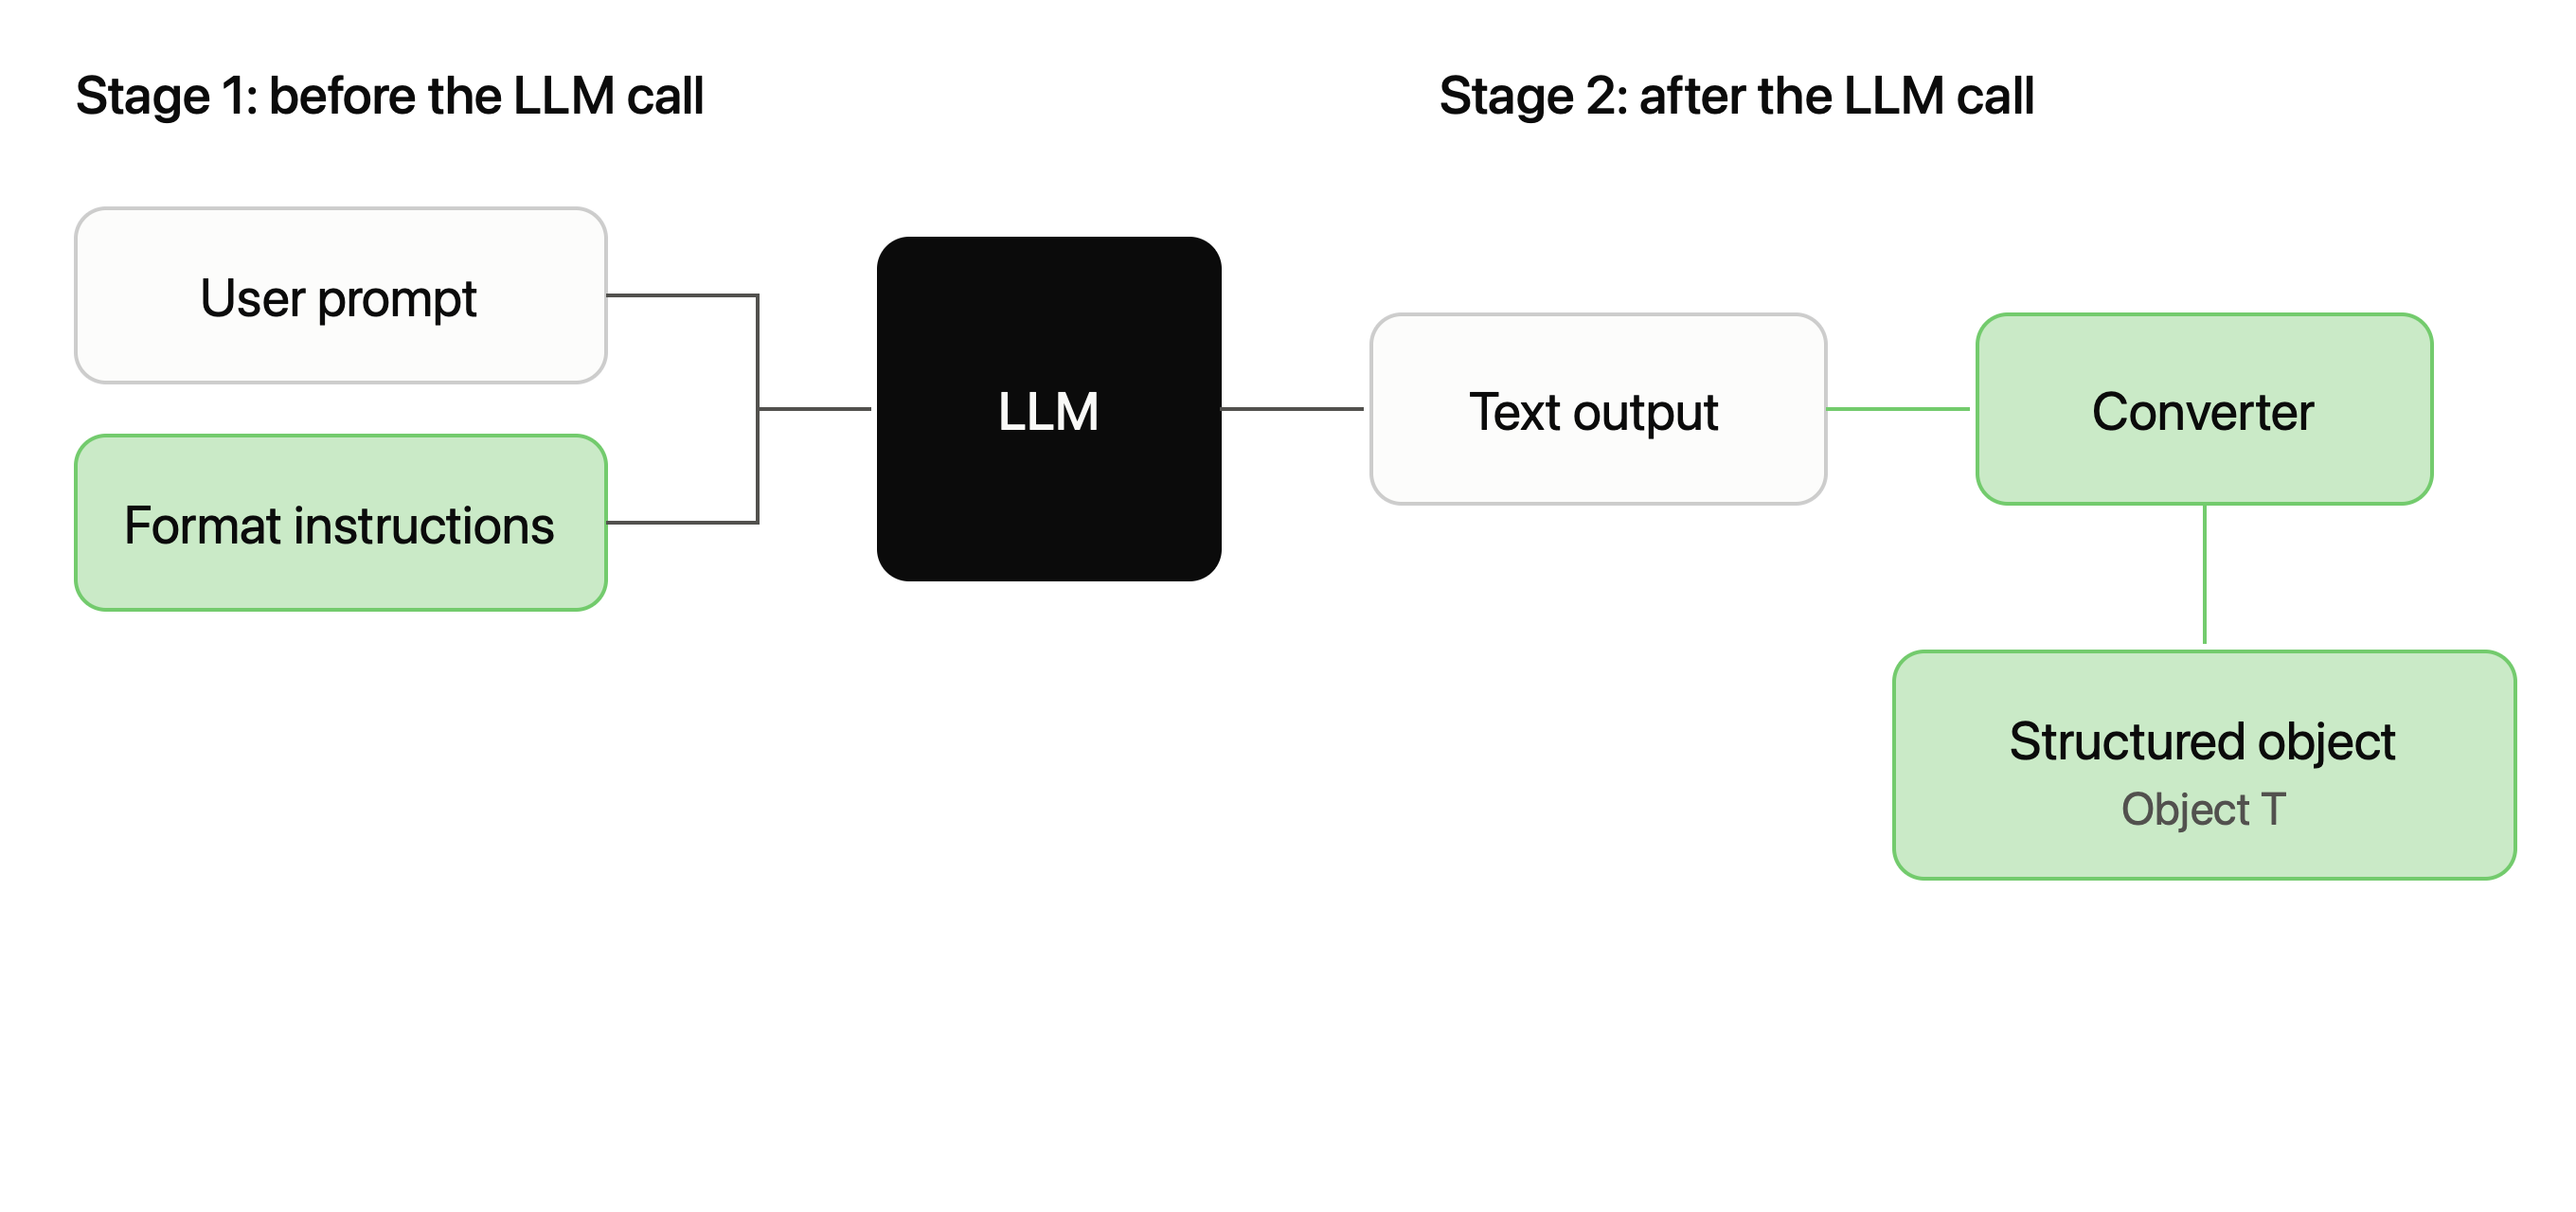
자바(Spring AI 등) 환경에서 LLM에게 원하는 출력 형식을 지시하고, 생성된 문자열 응답을 원하는 Java 타입으로 변환하는 핵심 인터페이스입니다. 이 인터페이스는 Converter<String, T>와 FormatProvider를 상속하며, 크게 스키마 제공, LLM 호출 전 형식 지시, LLM 호출 후 객체 변환의 역할을 수행합니다.
-
스키마 제공 (
getJsonSchema())- LLM에게 요구할 구조화된 데이터 구조를 JSON Schema 규격으로 제공합니다.
- 데이터의 객체 타입 및 프로퍼티 세부 구조(예: 이름은 string, 나이는 integer)를 명시하여 모델의 스키마 위반을 방지합니다.
-
LLM 호출 전 단계 (
FormatProvider.getFormat())- LLM이 응답을 어떤 형식으로 생성해야 하는지 알려주는 지시문(Format Prompt)을 정의합니다.
- 생성된 형식 지시 정보는 System Message 뒤에 자동으로 추가되어 LLM에게 전달됩니다.
응답은 반드시 다음 JSON 형식을 따라야 합니다:
{
  "name": string,
  "age": number
}- LLM 호출 후 단계 (
Converter.convert())- LLM이 반환한 텍스트 출력(JSON 등)을 수신하여 자바 객체(Structured Object T)로 파싱 및 역직렬화합니다.
- 주요 메서드인 T convert(String text)를 통해 변환을 수행하며, 이 과정은 최선 노력(Best Effort) 기반이므로 100% 결과 보장이 어려워 별도의 유효성 검사 과정을 거치는 것이 권장됩니다.
Converters의 종류와 상속 구조
1. Converters의 핵심 역할 및 구조 개요
- 상속 구조: 모든 컨버터는 공통적으로
FormatProvider와Converter인터페이스를 확장한StructuredOutputConverter계열을 따릅니다. - 분류 기준: LLM이 반환한 문자열(String) 응답을 Java Bean(Object), Map, List 등 어떤 형태의 자바 자료구조로 담아낼지에 따라 용도가 나뉩니다.
2. 3가지 주요 Converter 유형별 특징
| Converter | 변환 대상 | 주요 용도 | 예시 결과 |
|---|---|---|---|
BeanOutputConverter<T> | String → Java Object | LLM 응답을 정형화된 특정 자바 클래스나 record(Person, Movie, Order 등)로 매핑할 때 사용합니다. 내부적으로 ObjectMapper를 활용합니다. | Person{name='Kim', age=30} |
MapOutputConverter | String → Map<String, Object> | 응답에 필드 구조(키-값)는 존재하지만, 미리 고정된 자바 클래스를 정의하기 귀찮거나 유연한 데이터 처리가 필요할 때 사용합니다. | {"name": "Kim", "age": 30} |
ListOutputConverter | String → List<String> | LLM의 응답을 단순한 문자열 목록(리스트) 형태로 변환할 때 사용합니다. (예: 키워드 추출, 항목 나열 등) | ["Java", "Spring", "AI"] |
3. 상속 구조도
StructuredOutputConverter<T>를 부모로 하여 각각의 구현체들이 뻗어 나가는 구조를 가집니다.
MapOutputConverter:AbstractMessageOutputConverter를 상속받습니다.BeanOutputConverter:StructuredOutputConverter를 직접 구현하며, JSON 직렬화/역직렬화를 위해 ObjectMapper를 의존성(HAS-A)으로 가집니다.ListOutputConverter:AbstractConversionServiceOutputConverter를 상속받습니다.
BeanOutputConverter
구현 방식 개요
Spring AI의 ChatClient를 활용해 LLM의 응답을 정형화된 자바 객체(Bean)나 리스트 형태로 안전하게 변환하는 구현 방식입니다. 단일 객체를 처리하는 방식과 제네릭이 포함된 리스트를 처리하는 방식으로 나뉩니다.
1. 단일 객체 응답 받기
- 목표 데이터 구조 정의: record 등을 활용해 데이터 구조를 정의하며
@JsonPropertyOrder({"actor", "movies"})어노테이션을 사용하여 생성될 JSON 스키마의 필드 순서를 명시적으로 제어할 수 있습니다. - ChatClient API 활용:
.entity(ActorsFilms.class)메서드를 호출하여 LLM의 결과를 지정한 단일 자바 객체로 변환하도록 처리합니다.
2. 리스트(List) 형태의 응답 받기 (List)
- 제네릭 타입 처리:
List<ActorsFilms>와 같이 제네릭이 포함된 복잡한 타입은 일반.class문법으로 타입 정보를 지정할 수 없습니다. - 익명 클래스 활용:
.entity(new ParameterizedTypeReference<List<ActorsFilms>>() {})와 같은 익명 클래스 방식을 사용하여 제네릭 타입 정보를 보존하고 리스트 형태의 응답을 처리합니다.
Java 타입 소거(Type Erasure)와 ParameterizedTypeReference의 원리
- 타입 소거(Type Erasure)의 한계: 자바는 컴파일 이후 제네릭 타입 정보가 사라지기 때문에
List<ActorsFilms>와List<String>모두 런타임에는 단순히 List로만 인식됩니다. 이로 인해 Jackson/ObjectMapper가 리스트 내부의 객체 타입을 알 수 없어 역직렬화에 실패합니다. - 해결 메커니즘:
new ParameterizedTypeReference<List<ActorsFilms>>() {}형태로 익명 클래스를 생성하면, 런타임 메타스페이스(Metaspace)에 상위 클래스의 제네릭 정보(genericSuperclass)가 유지됩니다. Spring은 이 정보를 활용해 내부 객체 타입(ActorsFilms)을 정확히 추출하여 파싱 작업을 수행합니다.
// 순수 시스템 메시지 + JSON Schema 방식 (수동)
String systemPrompt = "Your response should be in JSON format matching this schema: " +
                      "{\"type\": \"array\", \"items\": {\"type\": \"object\", \"properties\": {\"actor\": {\"type\": \"string\"}, \"movies\": {\"type\": \"array\", \"items\": {\"type\": \"string\"}}}}";

String response = chatClient.prompt()
        .system(systemPrompt)
        .user("젠데이아 영화 알려줘")
        .call()
        .content(); // 문자열 응답 반환 (이후 직접 파싱 필요)
// 단일 객체 처리 (.entity(Class))
public record ActorsFilms(String actor, List<String> movies) {}
ActorsFilms result = chatClient.prompt()
.user("톰 행크스 영화 알려줘")
.call()
.entity(ActorsFilms.class); // 단일 자바 객체로 자동 변환// 제네릭 리스트 처리 (ParameterizedTypeReference)
public record ActorsFilms(String actor, List<String> movies) {}
List<ActorsFilms> results = chatClient.prompt()
.user("톰 행크스와 빌 무레이 영화 알려줘")
.call()
.entity(new ParameterizedTypeReference<List<ActorsFilms>>() {}); // 제네릭 리스트로 자동 변환MapOutputConverter
구현 방식 개요
- 용도: 정해진 자바 클래스(record)를 일일이 만들기 번거롭고, 키-값(Key-Value) 구조로 유연하게 데이터를 받고 싶을 때 사용합니다.
- 작동 방식:
.entity(new ParameterizedTypeReference<Map<String, Object>>() {})를 사용하여Map<String, Object>형태로 결과를 매핑합니다. 내부적으로 MapOutputConverter가 자동으로 구성됩니다.
// Map 형태로 응답 받기
    public Map<String, Object> getActorInfoAsMap(String question) {
        return chatClient.prompt()
                .user(question)
                .call()
                .entity(new ParameterizedTypeReference<Map<String, Object>>() {});
    }
ListOutputConverter
구현 방식 개요
- 용도: LLM으로부터 키워드 목록이나 항목 나열처럼 순수한 문자열 리스트(
List<String>) 응답을 받을 때 사용합니다. - 작동 방식:
.entity(new ListOutputConverter())객체를 직접 생성하여 전달하면 LLM 응답을 파싱하여 문자열 리스트로 반환해 줍니다.
// 문자열 리스트로 응답 받기 (List<String>)
    public List<String> getKeywordsAsList(String question) {
        return chatClient.prompt()
                .user(question)
                .call()
                .entity(new ListOutputConverter());
    }
Advisor
Spring AI에서 Advisor는 ChatClient의 요청과 응답 처리 과정에 개입하여 프롬프트를 가공하거나 부가 기능을 적용하는 인터셉터(Interceptor) 형태의 컴포넌트입니다. LLM 호출 전후의 흐름을 가로채어 Memory, RAG, Logging 등의 공통 기능을 확장할 수 있는 핵심 메커니즘입니다.
Advisor의 동작 흐름 (AOP / Interceptor 구조)
-
LLM 호출 전 (before()): 사용자의 프롬프트(Prompt)가 입력되면 등록된 Advisor 체인을 거치며 요청 내용을 가공하거나 부가 데이터(메모리 대화 내역, RAG 검색 결과 등)를 주입합니다. (Advised request)
-
LLM 모델 처리 (ChatModel): 가공된 최종 요청이 LLM에 전달되어 응답을 생성합니다.
-
LLM 호출 후 (after()): LLM이 반환한 응답(response)을 받아 후처리(로깅, 응답 가공 등)를 수행한 뒤 최종 응답(Advised response)을 사용자에게 반환합니다.
Advisor의 3대 핵심 역할
- 모듈화 (Encapsulation)
- RAG나 Chat Memory처럼 반복적으로 사용되는 AI 구현 패턴을 독립적인 재사용 가능 컴포넌트로 캡슐화합니다.
- 데이터 변환 (Transformation)
- LLM으로 보내는 요청(Prompt)과 LLM에서 오는 응답(Response)을 동적으로 수정하거나 보강할 수 있습니다.
- 이식성 (Portability)
- 특정 비즈니스 로직이나 부가 기능을 Advisor로 분리하여 다양한 AI 모델이나 유스케이스에 코드 수정 없이 쉽게 끼워 넣을 수 있습니다.
AOP (Aspect Oriented Programming, 관점 지향 프로그래밍)
-
개념: OOP(객체지향 프로그래밍)의 한계를 보완하는 프로그래밍 패러다임입니다. OOP는 주로 '기능' 단위로 클래스를 구현하는 반면,
AOP는 여러 비즈니스 로직에 공통으로 나타나는 '공통 관심사(Aspect)'를 모듈화하여 코드 중복을 줄이고 유지보수성을 높입니다. -
대표적인 공통 관심사 예시: 로깅(Logging), 트랜잭션 처리(Transaction), 보안(Security), 성능 측정(Profiling).
Advisor Chain의 구조와 구성 요소
-
개념: 여러 개의 Advisor들이 순서대로 실행될 수 있도록 체인(Chain)을 관리하고 다음 Advisor로 제어를 넘겨주는 역할을 합니다.
-
구성 요소:
ChatClientRequest: Prompt를 포함한 채 Advisor Chain을 통과하는 요청 객체입니다.ChatClientResponse: Advisor를 거친 ChatClient 계층의 응답이며, 실제 모델 응답인 ChatResponse를 포함하고 있습니다.CallAdvisor: Advisor 구현체를 위한 인터페이스입니다.CallAdvisorChain: 여러 Advisor를 순서대로 호출하기 위한 체인입니다.
Advisor 구성 요소 및 종류
-
상속 구조 (Advisor 인터페이스):
- 모든 Advisor는
Ordered인터페이스를 상속받아getOrder()메서드로 실행 순서를 제어합니다. (숫자가 낮을수록 우선순위가 높음)
- 모든 Advisor는
-
동기 vs 비동기 방식:
CallAdvisor: 동기 방식의 요청/응답을 처리하며,adviseCall(ChatClientRequest, CallAdvisorChain)메서드를 구현합니다.StreamAdvisor: 비동기/스트리밍 방식(Flux)을 처리하며,adviseStream메서드를 구현합니다.
// 1. 동기 방식 (CallAdvisor)
public class MyCallAdvisor implements CallAdvisor {
    @Override
    public ChatClientResponse adviseCall(ChatClientRequest request, CallAdvisorChain chain) {
        // 전처리 로직
        ChatClientResponse response = chain.nextCall(request); // 다음 단계 호출
        // 후처리 로직
        return response;
    }
    @Override public String getName() { return "MyCall"; }
    @Override public int getOrder() { return 0; }
}

// 2. 비동기 스트리밍 방식 (StreamAdvisor)
public class MyStreamAdvisor implements StreamAdvisor {
    @Override
    public Flux<ChatClientResponse> adviseStream(ChatClientRequest request, StreamAdvisorChain chain) {
        // 전처리 로직
        Flux<ChatClientResponse> responseFlux = chain.nextStream(request);
        // 후처리 로직 (Flux 연산자 활용)
        return responseFlux;
    }
    @Override public String getName() { return "MyStream"; }
    @Override public int getOrder() { return 0; }
}
Advisor 구현 및 등록
-
구현 방식 (CallAdvisor 구현):
- adviseCall 내부에서
chain.nextCall(request)를 기준으로 전처리와 후처리 로직을 감싸는 형태로 구현합니다. getOrder()를 통해 실행 우선순위를 지정할 수 있습니다.
- adviseCall 내부에서
-
등록 방식:
- 전역 등록 (defaultAdvisors): ChatClient.Builder를 생성할 때
defaultAdvisors(new AdvisorA(), new AdvisorB())를 주입하여 모든 요청에 공통으로 적용합니다. - 개별 등록 (advisors): 특정 프롬프트 요청 시에만
.advisors(new AdvisorC())를 추가하여 동적으로 적용합니다.
- 전역 등록 (defaultAdvisors): ChatClient.Builder를 생성할 때
@Service
public class AiService {
    private final ChatClient chatClient;

    // 1. 전역 등록 (ChatClient 생성 시 공통 적용)
    public AiService(ChatClient.Builder builder, LoggingAdvisor loggingAdvisor) {
        this.chatClient = builder
                .defaultAdvisors(loggingAdvisor) // 이 클라이언트를 쓰는 모든 곳에 자동 적용
                .build();
    }

    public String callAi(String question) {
        return chatClient.prompt()
                .user(question)
                .advisors(new SpecificAdvisor()) // 2. 개별 등록 (이 특정 요청에만 동적 추가)
                .call()
                .content();
    }
}
Advisor 호출 흐름 (Chain Flow)과 우선 순위 결정 (Order)
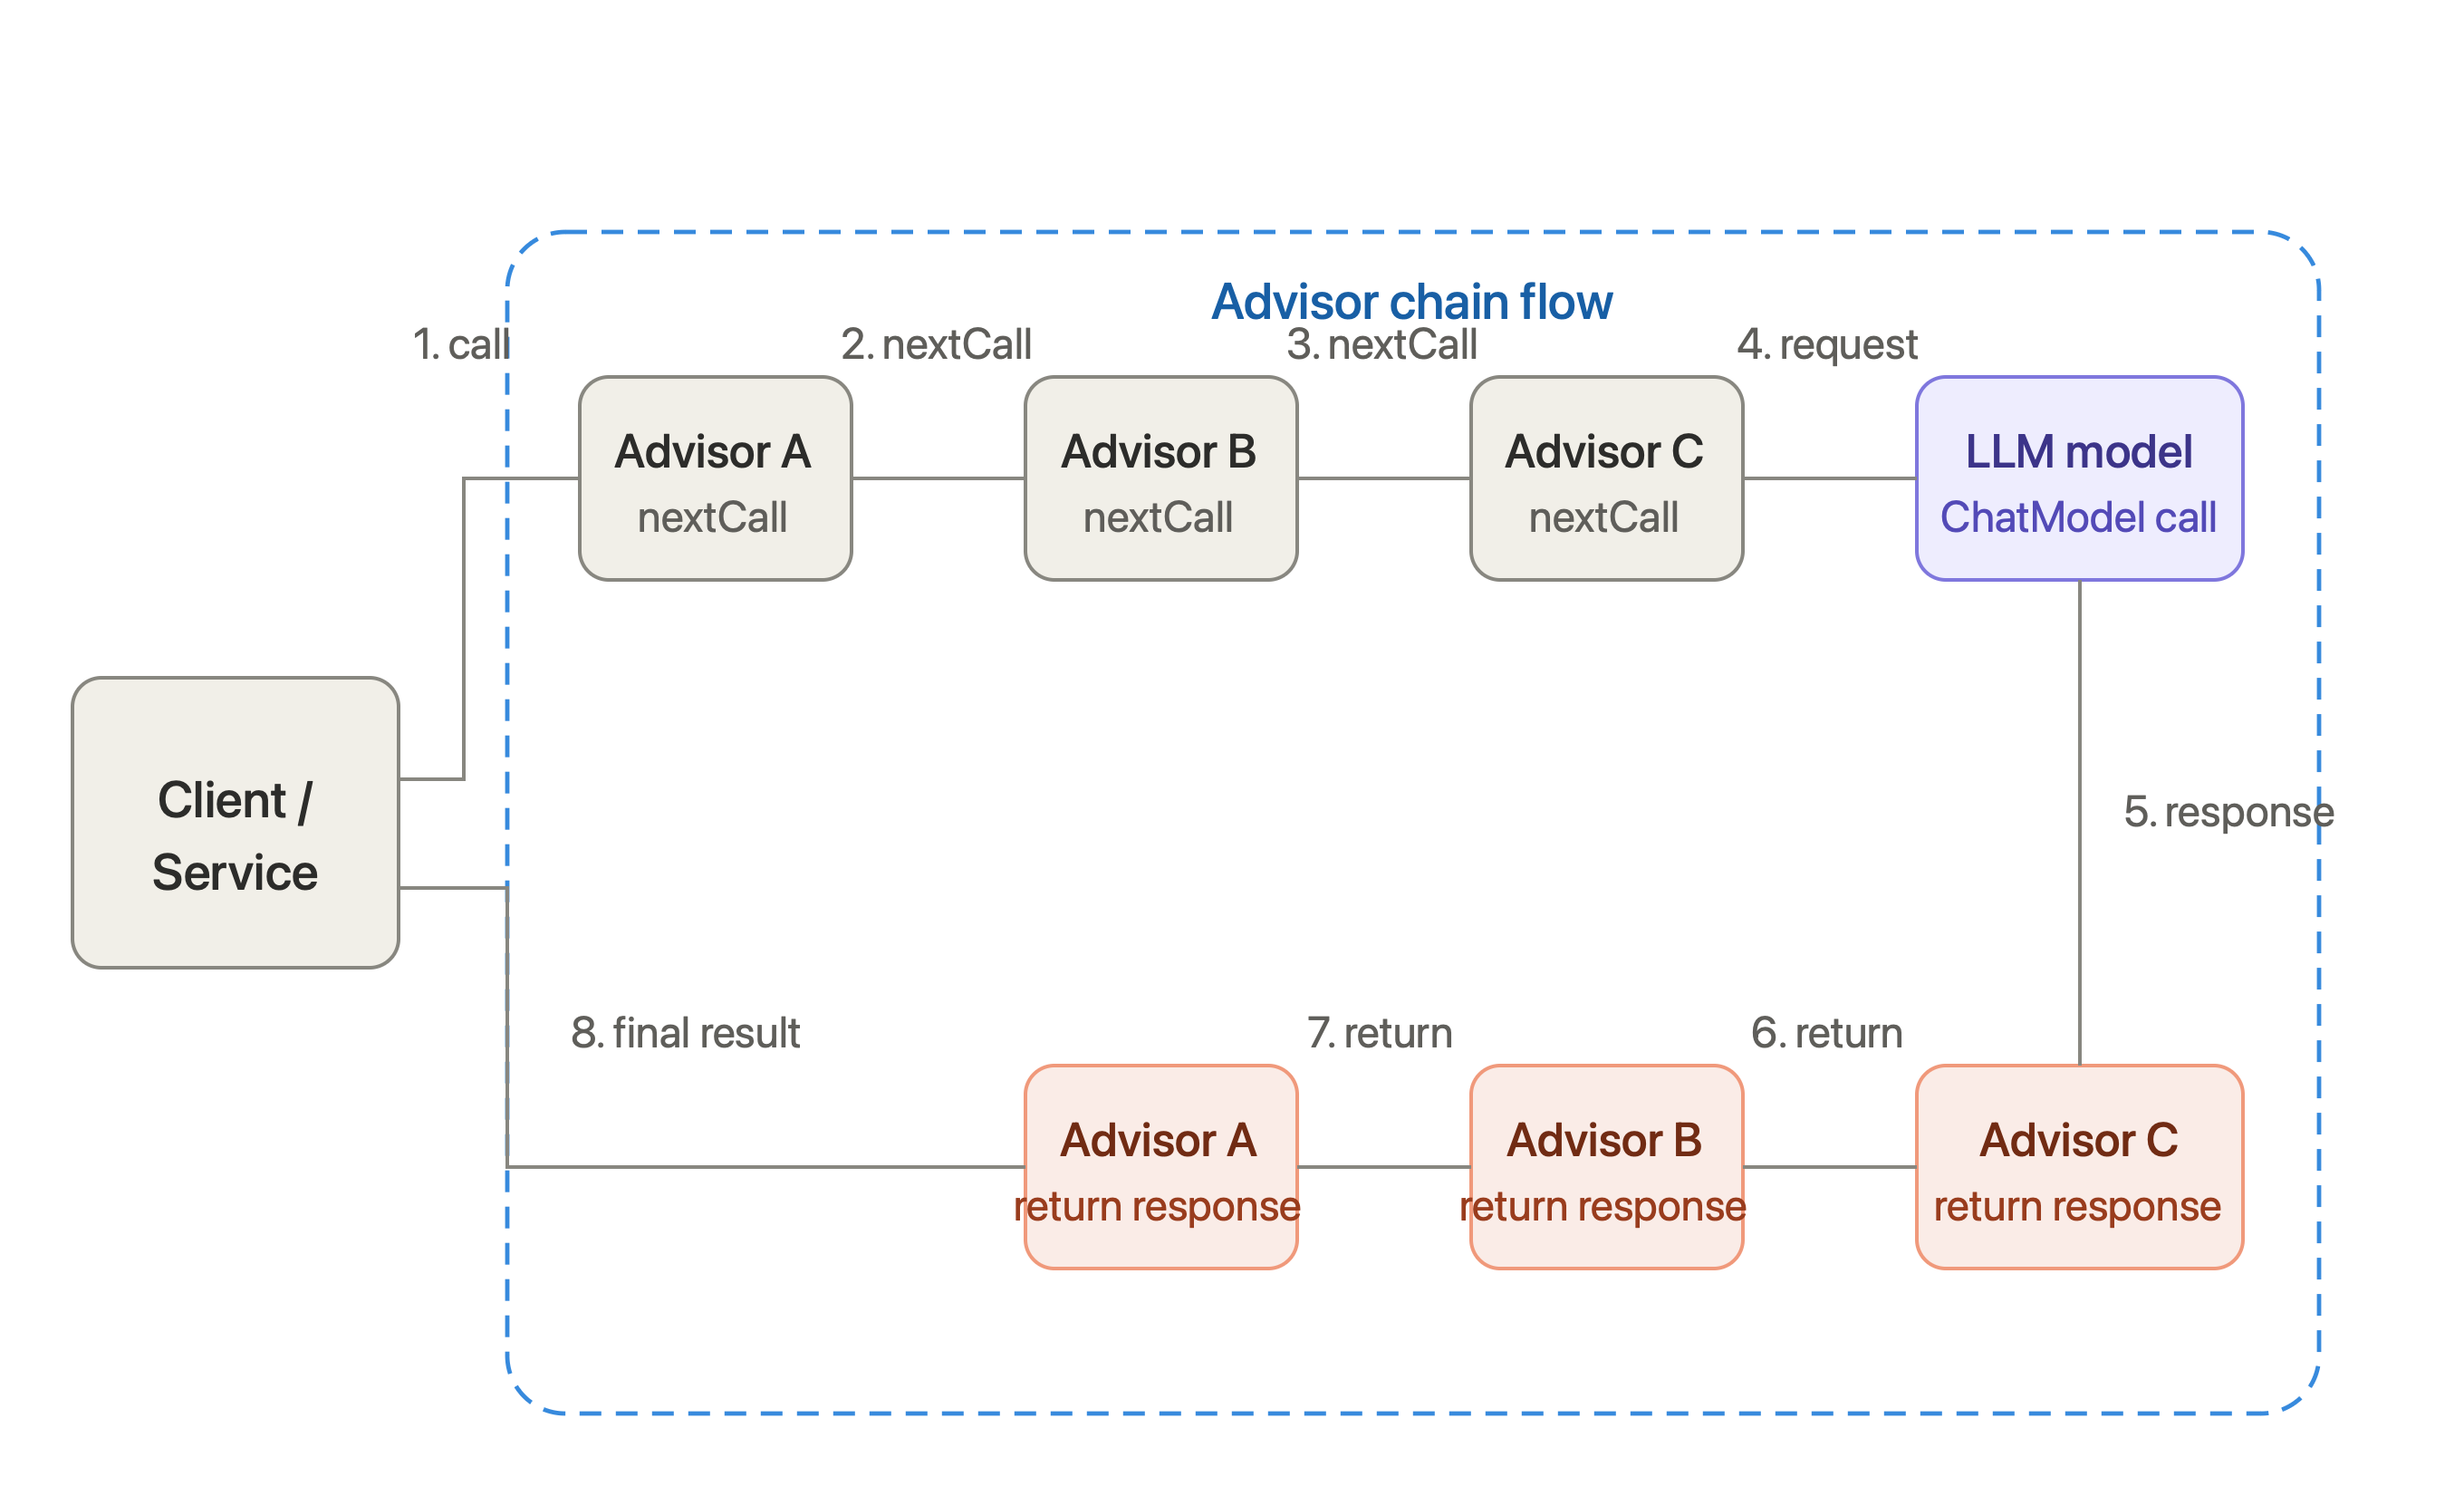
-
getOrder()메서드: Advisor의 실행 순서를 결정하며, 값이 낮을수록 먼저 실행됩니다. -
상수 정의:
Integer.MIN_VALUE또는Ordered.HIGHEST_PRECEDENCE: 가장 먼저 실행되도록 보장합니다.Integer.MAX_VALUE또는Ordered.LOWEST_PRECEDENCE: 가장 나중에 실행되도록 보장합니다.- 동일한 order 값을 가질 경우에는 등록 순서대로 진행됩니다.
-
핵심 동작 구조 (Stack 형태)
- 요청 처리 (내려가는 방향 ↓): order 값이 가장 낮은 Advisor가 가장 먼저 요청(전처리)을 처리합니다.
- 응답 처리 (올라오는 방향 ↑): order 값이 가장 낮은 Advisor가 가장 마지막에 응답(후처리)을 처리합니다. (먼저 실행된 녀석이 가장 나중에 끝나는 Stack 구조)
Context 기반 Advisor 간 데이터 공유
Advisor Chain이 요청과 응답을 처리하는 동안, Advisor 간에 부가적인 정보와 상태를 전달하기 위한 Key-Value 데이터 공간입니다. LLM에게 직접 전달되는 Prompt와는 별개로 Advisor들이 처리 과정에서 정보를 공유하기 위해 사용됩니다.
1. Advisor에 Context 전달 및 사용 방법
-
전달 방법 (
advisorsSpec.param):chatClient.prompt().advisors(advisorSpec -> { advisorSpec.param("key", "value"); })형태로 초기 Context 데이터를 설정할 수 있습니다. -
사용 방법 (
request.context().get()): Advisor 내부의 adviseCall 메서드에서request.context().get("key")를 호출하여 전달된 데이터를 꺼내 쓸 수 있습니다.
2. Advisor Context에 새로운 데이터 추가하기 (Immutable 특성)
-
불변성(Immutable): Context Map은 기본적으로 immutable(불변) 특성을 가지므로 Advisor 내에서 데이터를 직접 수정할 수 없습니다.
-
데이터 추가 절차:
- 기존 context를 복사하여 새로운
HashMap(newContext)을 만듭니다. - 새로운 데이터를
newContext.put()으로 추가합니다. request.mutate().context(newContext).build()를 통해 새로운 context가 반영된 mutatedRequest를 생성합니다.- 변경된 요청을
chain.nextCall(mutatedRequest)에 전달하여 다음 Advisor로 넘깁니다.
- 기존 context를 복사하여 새로운
// 1. 초기 Context 데이터 전달 및 설정 (Client / Service 영역)
String response = chatClient.prompt()
    .user("질문 내용")
    .advisors(advisorSpec -> {
        // Key-Value 형태로 초기 데이터 전달
        advisorSpec.param("customData", "초기 설정값");
    })
    .call()
    .content();

// 2. Advisor 내부에서 Context 사용 및 새로운 데이터 추가 (Advisor 영역)
@Component
public class MyAdvisor implements CallAdvisor {
    @Override
    public ChatClientResponse adviseCall(ChatClientRequest request, CallAdvisorChain chain) {

        // 전달받은 Context 데이터 조회
        Object value = request.context().get("customData");

        // Context는 immutable(불변)이므로 새로운 맵으로 복사 후 데이터 추가
        Map<String, Object> newContext = new HashMap<>(request.context());
        newContext.put("newKey", "새로 추가한 정보");

        // 변경된 context가 반영된 새로운 request 생성
        ChatClientRequest mutatedRequest = request.mutate()
                .context(newContext)
                .build();

        // 다음 체인으로 전달
        return chain.nextCall(mutatedRequest);
    }

    @Override public String getName() { return "MyAdvisor"; }
    @Override public int getOrder() { return 0; }
}
내장 Advisor
| Advisor 이름 | 주요 역할 | 동작 시점 | 사용 목적 |
|---|---|---|---|
SimpleLoggerAdvisor | 요청/응답 메시지를 로그로 남김 | 전처리 + 후처리 | 프롬프트/응답 내용 추적, 디버깅 |
SafeGuardAdvisor | 정책 기반으로 사용자 입력 및 LLM 응답 검증 | 전처리 + 후처리 | 위험 콘텐츠 방지, 정책 위반 차단 |
MessageChatMemoryAdvisor | 대화 히스토리를 자동 관리하여 Prompt 앞부분에 삽입 | 주로 전처리 | Chat Memory 구현 (메시지 저장/로드) |
PromptChatMemoryAdvisor | 메모리에서 가져온 내용을 프롬프트에 자연스럽게 섞음 | 전처리 | 대화 맥락 유지 및 Prompt 구조화 |
VectorStoreChatMemoryAdvisor | VectorStore에서 유사한 과거 대화나 맥락을 검색하여 프롬프트에 추가 | 전처리 | Embedding 기반 맥락 복원 |
QuestionAnswerAdvisor | 사용자의 질문을 분석하여 답변을 위한 instruction을 자동 주입 | 전처리 | Zero-shot Q&A 품질 향상 |
RetrievalAugmentationAdvisor | Retrieval, Prompt 결합, 후처리까지 포함한 완성형 RAG Advisor | 전처리 + 후처리 | RAG 구현을 단일 Advisor로 해결 |
SafeGuardAdvisor 구현 및 설정 예시
- 객체 생성: 차단할 금칙어 리스트("욕설", "계좌번호" 등), 위반 시 반환할 메시지, 그리고 최우선 순위(
Ordered.HIGHEST_PRECEDENCE)를 지정하여 SafeGuardAdvisor를 생성합니다. - 전역 등록: ChatClient.Builder의
.defaultAdvisors()에 등록하여 모든 프롬프트 요청에 보안 검증 로직이 공통으로 작동하도록 설정합니다.
@Service
public class SecurityService {
    private final ChatClient chatClient;

    // SafeGuardAdvisor 생성 및 전역 등록 예시
    public SecurityService(ChatClient.Builder chatClientBuilder) {

        // 1. SafeGuardAdvisor 생성: 차단할 금칙어, 위반 메시지, 최우선 순위 설정
        SafeGuardAdvisor safeGuardAdvisor = new SafeGuardAdvisor(
            List.of("욕설", "계좌번호", "폭력", "폭탄", "외설"),
            "해당 질문은 민감한 콘텐츠 요청이므로 응답할 수 없습니다.",
            Ordered.HIGHEST_PRECEDENCE
        );

        // 2. ChatClient.Builder의 defaultAdvisors()를 통해 전역 등록
        this.chatClient = chatClientBuilder
                .defaultAdvisors(safeGuardAdvisor)
                .build();
    }

    public String askAi(String question) {
        // 모든 프롬프트 요청 시 SafeGuardAdvisor가 먼저 작동하여 금칙어를 검증함
        return chatClient.prompt()
                .user(question)
                .call()
                .content();
    }
}
토큰 및 지연 시간 프로파일러 Advisor 통합 예제
// 1. 커스텀 Advisor 구현 (동기 방식: CallAdvisor 상속)
@Component
public class TokenLatencyProfilerAdvisor implements CallAdvisor {
    private static final Logger log = LoggerFactory.getLogger(TokenLatencyProfilerAdvisor.class);
    private final int warningTokenLimit;

    public TokenLatencyProfilerAdvisor(int warningTokenLimit) {
        this.warningTokenLimit = warningTokenLimit;
    }

    @Override
    public String getName() {
        return this.getClass().getSimpleName();
    }

    @Override
    public int getOrder() {
        // 숫자가 낮을수록 우선순위가 높음 (가장 먼저 실행되고 응답은 가장 나중에 받음)
        return Ordered.HIGHEST_PRECEDENCE + 10;
    }

    @Override
    public ChatClientResponse adviseCall(ChatClientRequest request, CallAdvisorChain chain) {
        // --- [전처리 영역] ---
        long startTime = System.currentTimeMillis(); // 1. LLM 호출 시간 측정 시작

        // Context에서 이전 단계나 설정에서 넘겨준 데이터 꺼내기
        Object clientName = request.context().get("clientName");
        log.info("[Advisor 전처리] 요청자: {}, LLM 호출 준비 완료", clientName);

        // 다음 Advisor 또는 LLM 모델로 요청 전달 (이 기준선을 기점으로 전/후가 나뉨)
        ChatClientResponse response = chain.nextCall(request);

        // --- [후처리 영역 (Stack 구조로 역순 실행)] ---
        long latency = System.currentTimeMillis() - startTime; // 2. 소요 시간(Latency) 계산

        // 3. LLM 응답 메타데이터에서 토큰 사용량 추출
        if (response.chatResponse() != null && response.chatResponse().getMetadata() != null) {
            Usage usage = response.chatResponse().getMetadata().getUsage();
            if (usage != null) {
                Integer promptTokens = usage.getPromptTokens();
                Integer completionTokens = usage.getCompletionTokens();
                Integer totalTokens = usage.getTotalTokens();

                // 프로파일링 결과 로깅
                log.info("""

                        ===== AI PROFILE =====
                        Latency           : {} ms
                        Prompt Tokens     : {}
                        Completion Tokens : {}
                        Total Tokens      : {}
                        ======================
                        """, latency, promptTokens, completionTokens, totalTokens);

                // 4. 비용 한도(토큰 임계값) 초과 시 경고 발생
                if (totalTokens != null && totalTokens > warningTokenLimit) {
                    log.warn("[AI COST WARNING] 토큰 사용량 초과: {} > 설정한 제한값({})", totalTokens, warningTokenLimit);
                }
            }
        }

        return response; // 최종 응답 반환
    }
}

// 2. ChatClient에 Advisor 등록 및 Context 활용 서비스
@Service
public class AiProfileService {
    private final ChatClient chatClient;

    public AiProfileService(ChatClient.Builder chatClientBuilder, TokenLatencyProfilerAdvisor profilerAdvisor) {
        // 전역 등록 (defaultAdvisors): 모든 프롬프트 요청에 공통 적용
        this.chatClient = chatClientBuilder
                .defaultAdvisors(profilerAdvisor)
                .build();
    }

    public String askWithContext(String question) {
        return chatClient.prompt()
                .user(question)
                .advisors(advisorSpec -> {
                    // Context 기반 데이터 공유: Advisor 간 전달할 Key-Value 설정
                    advisorSpec.param("clientName", "Web-User-A");
                })
                .call()
                .content();
    }
}
제목에 오타있어요~~~