Embedding
텍스트, 이미지, 음성 같은 비정형 데이터를 컴퓨터가 이해할 수 있도록 숫자 형태의 벡터(Vector)로 변환하는 기술입니다.
- 핵심 원리: 데이터가 가진 의미적 특징을 수치화하여 의미가 유사한 데이터일수록 벡터 공간에서 서로 가까운 방향이나 위치에 배치되도록 만듭니다.
- 작동 방식: 사람이 사용하는 텍스트나 이미지 등을 입력받아 임베딩 모델을 거치면 [0.6, 0.8, 0.1 ...]과 같은 숫자 배열(벡터)로 바뀌고 의미가 비슷한 데이터끼리 벡터 스토어(Vector Store) 상에서 군집을 형성합니다.
임베딩 모델(Embedding Model)의 개념과 동작 단계
대량의 데이터를 학습해 의미적 관계가 반영된 벡터 공간을 만들고 새로운 입력 데이터를 그 공간의 한 점(좌표)으로 매핑해 주는 모델입니다.
- 학습 단계 (Training): 대량의 데이터를 학습하며 의미가 비슷한 표현들이 벡터 공간(N차원 좌표계)에서 자연스럽게 가까워지도록 조정합니다.
- 사용 단계 (Inference): 새로운 입력(이미지, 문서, 오디오 등)이 들어오면 모델이 이를 통과시켜 숫자로 이루어진 벡터로 변환한 뒤 이미 형성된 의미 공간 위의 적절한 위치에 배치합니다.
- 특징: 임베딩의 품질은 학습 데이터의 분포(Data Distribution)에 크게 의존합니다.
임베딩은 왜 학습 데이터 분포에 의존하는가?
여기서 데이터 분포란 단순히 데이터의 양이 아니라 어떤 단어·문장·개념이 얼마나 자주, 어떤 문맥으로 함께 등장했는가를 뜻합니다.
- 문맥 학습 예시: "강아지는 귀여운 동물이다", "강아지는 나와 함께 생활한다"처럼 강아지와 고양이가 유사한 문맥에서 자주 등장하면 모델은 이들이 동물로서 서로 연관이 깊다고 판단합니다.
- 결과: 의미적으로 가까운 '강아지'와 '고양이'는 벡터 공간에서 가깝게 배치되고 전혀 다른 문맥의 '자동차'는 멀리 떨어지게 됩니다. 즉, 좋은 데이터 분포를 학습해야 뛰어난 성능의 임베딩 모델이 만들어집니다.
주요 임베딩 모델 비교 (순위 및 특징)
현업에서 자주 쓰이는 대표적인 상용(SaaS) 및 설치형 임베딩 모델들의 특성입니다.
| 순위 | 제공사 | 모델명 | SaaS | 설치형 | 주요 특성 |
|---|---|---|---|---|---|
| 1 | OpenAI | text-embedding-3-small | O | X | 비용과 성능의 균형이 좋으며, 대부분의 RAG 프레임워크 및 벡터 DB에서 쉽게 연동 가능 |
| 2 | OpenAI | text-embedding-3-large | O | X | 고성능 임베딩 모델로 다국어 검색과 복잡한 의미 검색에 적합 |
| 3 | BAAI | BAAI/bge-m3 | O | O | 다국어 성능이 우수하며 Dense·Sparse·Multi-vector 검색을 지원 |
| 4 | Qwen | qwen3-Embedding | O | O | 최근 주목받는 다국어 오픈소스 모델로 한국어 포함 검색 성능과 긴 문맥 처리 능력이 우수 |
| 5 | gemini-embedding-001 | O | X | 다국어 및 긴 문서 검색에 강하며 Google AI Studio·Vertex AI 환경과 통합이 편리 |
Embedding 적용 분야
임베딩 기술은 다양한 AI 응용 프로그램의 핵심 기반으로 활용됩니다.
- 시멘틱 검색 (Semantic Search): 키워드가 정확히 일치하지 않아도, "무더운 날 마시기 좋은 것"을 검색했을 때 "시원한 아이스 아메리카노" 관련 문서를 찾아내는 기술입니다.
- RAG (Retrieval-Augmented Generation): LLM이 기업 내부 문서나 최신 데이터를 기반으로 정확하게 답변할 수 있도록 문서를 벡터화하여 검색에 활용합니다.
- 추천 시스템 (Recommendation): 유저의 행동 패턴과 콘텐츠의 특징을 임베딩하여 유사한 취향의 상품이나 영상을 추천합니다.
- 멀티 모달 (Multi-modal): 텍스트와 이미지를 동일한 벡터 공간에 임베딩하여 "강아지 뛰노는 그림"이라는 텍스트로 실제 강아지 사진을 검색할 수 있습니다.
벡터 데이터 저장 파이프라인
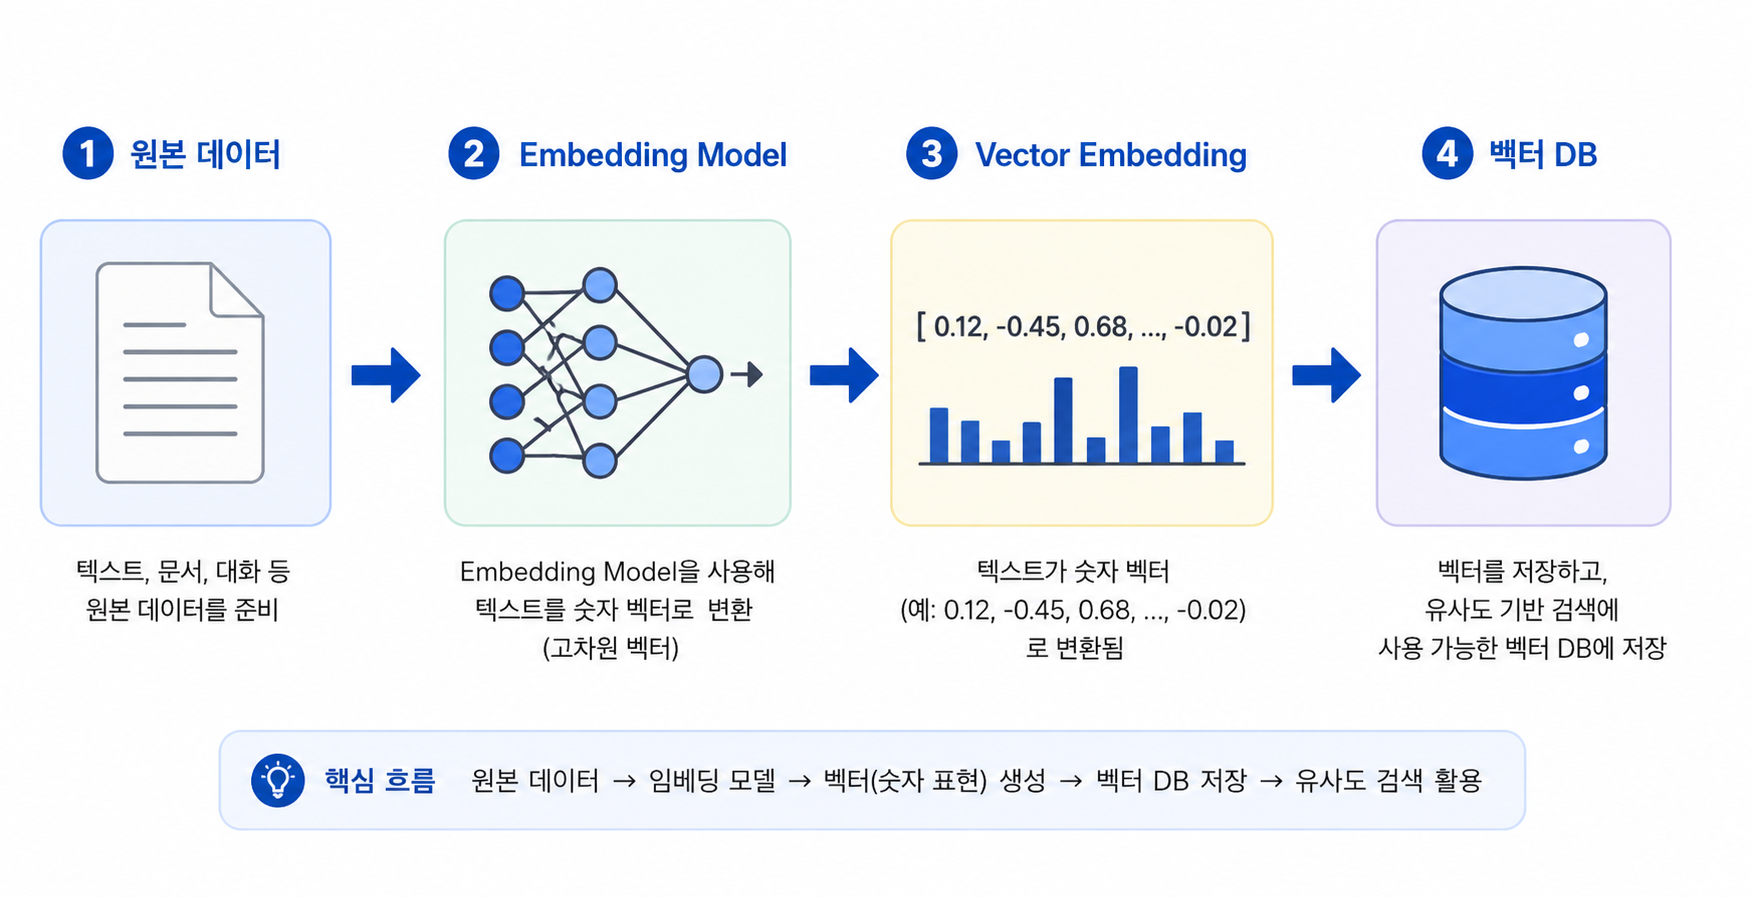
데이터가 벡터화되어 Vector DB에 저장되고 검색되기까지의 전체 흐름입니다.
- 원본 데이터: 텍스트, 이미지, 음성 등의 비정형 데이터가 준비됩니다.
- Embedding Model: 원본 데이터를 입력받아
float[]형태의 고차원 숫자 벡터로 변환합니다. - Vector Embedding: 변환된 벡터 값(
[0.12, -0.45, 0.88, ..., -0.02])이 생성됩니다. - 벡터 DB: 생성된 벡터를 저장하고 의미적 유사도 기반 검색을 수행합니다.
Vector DB
고차원 임베딩 벡터를 효율적으로 관리하기 위한 특화된 데이터베이스입니다.
- 정의: 고차원 임베딩 벡터를 저장, 인덱싱 및 검색하기 위해 최적화된 데이터베이스입니다.
- 동작 원리: 의미 및 맥락의 유사성(Vector 공간의 거리)을 기반으로 유사도 검색을 수행합니다.
- 기존 DB와의 차이:
- 정확성 기반 검색 (Exact Match):
WHERE name = 'John Doe'처럼 정확히 일치하는 데이터를 찾는 방식입니다. - 유사도 기반 검색 (Similarity Search): Query Vector와 유사한 방향/거리에 있는 벡터들을 스코어(예: 0.92, 0.89)와 함께 반환하는 구조입니다.
- 정확성 기반 검색 (Exact Match):
Vector DB 종류 및 비교
현업에서 사용되는 주요 Vector DB들의 특징과 적합한 활용처입니다.
| 제품 | 유형 | 특징 | 장점 | 적합한 경우 | Enterprise 사용 |
|---|---|---|---|---|---|
| pgVector | PostgreSQL 확장 | 기존 RDB에 벡터 타입 추가 | SQL 그대로 사용 | 엔터프라이즈급 데이터 안정성과 복구 체계 | 매우 높음 |
| Qdrant | 전용 Vector DB | Rust 기반, HNSW 최적화 | 빠른 검색, 필터링 강함 | 대규모 RAG, SaaS | 매우 높음 |
| Chroma | 경량 Vector Store | Python 친화적 | 개발 간편 | PoC, 로컬 개발 | 제한적 |
| Milvus | 대규모 분산형 | 고성능 ANN, GPU 지원 | 초대규모 처리 | AI 플랫폼 | 높음 |
| Weaviate | Graph + Vector | Hybrid 검색 강점 | 메타데이터 + 벡터 통합 | 지식 그래프 결합 | 증가 중 |
| Pinecone | SaaS | 완전 관리형 | 운영 부담 없음 | 클라우드 기반 서비스 | 매우 많음 |
Spring AI 기반의 임베딩(Embedding)
1. build.gradle (의존성 설정)
Spring AI의 OpenAI 연동 및 PostgreSQL pgvector 저장을 위한 의존성을 추가합니다. (Spring Boot 3.x 기준)
dependencies {
    // Spring Boot Starter
    implementation 'org.springframework.boot:spring-boot-starter-web'

    // Spring AI OpenAI Starter (Embedding & Chat 모델 자동 구성)
    implementation 'org.springframework.ai:spring-ai-openai-spring-boot-starter'

    // Spring AI PostgreSQL VectorStore Starter (pgvector 연동)
    implementation 'org.springframework.ai:spring-ai-pgvector-spring-boot-starter'

    // PostgreSQL JDBC Driver
    runtimeOnly 'org.postgresql:postgresql'
}
2. src/main/resources/application.yaml (설정 파일)
Spring AI를 통해 임베딩 모델과 벡터 DB를 자동 구성(Auto-configuration)하기 위한 설정 파일 구조입니다.
spring:
  datasource:
    # PostgreSQL 데이터베이스 접속 URL (로컬 호스트의 5432 포트, postgres DB 연결)
    url: jdbc:postgresql://localhost:5432/postgres
    # 데이터베이스 접속 계정 이름
    username: postgres
    # 데이터베이스 접속 비밀번호
    password: postgres

ai:
  model:
    # 대화(Chat) 기능에서 사용할 기본 AI Provider 지정
    chat: openai
    # 임베딩(Embedding) 기능에서 사용할 기본 AI Provider 지정
    embedding: openai
  openai:
    # 시스템 환경 변수(export OPENAI_API_KEY="...")에 등록된 OpenAI API 키를 불러옴
    api-key: ${OPENAI_API_KEY}
    embedding:
      options:
        # 사용할 OpenAI 임베딩 모델 지정 (비용과 성능의 균형이 좋은 text-embedding-3-small 사용)
        model: text-embedding-3-small
    chat:
      options:
        # 사용할 OpenAI 챗 모델 지정 (gpt-4o-mini 모델 사용)
        model: gpt-4o-mini
        # 답변의 창의성(무작위성) 조절 값 (0.7 설정)
        temperature: 0.7

vectorstore:
  pgvector:
    # 애플리케이션 기동 시 pgvector 스키마(테이블)를 자동으로 초기화/생성할지 여부
    initialize-schema: true
    # 벡터 데이터를 저장할 테이블 이름 지정
    table-name: vector_store
    # 기존에 동일한 이름의 벡터 테이블이 존재할 경우 삭제하고 새로 생성할지 여부
    remove-existing-vector-store-table: true
3. VectorStore 인터페이스와 주요 메서드
다양한 벡터 저장소를 코드로 일관되게 다룰 수 있도록 제공하는 Spring AI의 표준 인터페이스입니다.
- 특징: Spring Boot의 Auto-configuration에 의해 VectorStore 구현체가 Bean으로 자동 생성됩니다.
- 주요 메서드 구조:
add(List<Document> documents): 주어진 Document 목록을 임베딩한 뒤 각 결과를 벡터 저장소에 저장합니다.delete(...): ID 리스트나 필터 표현식(Filter.Expression)을 이용해 벡터 저장소에서 불필요한 Document를 삭제합니다.similaritySearch(...): 사용자의 쿼리를 입력받아 벡터 공간에서 의미적 유사도 검색을 수행한 후 연관된 Document 목록을 반환합니다.
Document Class
- 개념: 비정형 및 정형 데이터를 수집·가공하여 Vector Store에 저장하고 검색할 때 사용하는 Spring AI의 표준 데이터 전송 객체(DTO)입니다.
- 주요 역할:
- 벡터 저장소에 저장하기 위한 기본 단위입니다.
- 문서 검색 결과를 LLM에 전달하기 위한 Context 정보 컨테이너 역할을 합니다.
- 파일, DB row, 웹페이지, 챗 메모리 등 다양한 문서 단위를 표준화하여 RAG에 일관된 자료 구조로 제공합니다.
- 필드 구성:
id: 문서의 고유 식별자 (UUID 등)content: 문서의 본문 텍스트 (텍스트 청크)metadata: 문서 출처, 페이지 번호, 키-값 형태의 메타데이터 (Map<String, Object>)media: 이미지, 멀티미디어 데이터 확장용 (List<Media>)embedding: EmbeddingModel을 통해 변환된 수치 벡터 (List<Double>)score: Vector DB 검색 결과의 유사도 점수
1. Document 저장하기 (VectorDB)
VectorStore.add() 메서드를 이용해 List<Document> 형태의 데이터를 한 번에 등록합니다.
각 문서마다 본문 내용과 함께 Map.of("category", "spring", "year", 1987) 같은 메타데이터를 함께 묶어서 저장할 수 있습니다.
@Service
public class DocumentService {

    private final VectorStore vectorStore;

    public DocumentService(VectorStore vectorStore) {
        this.vectorStore = vectorStore;
    }

    public void addDocuments() {
        List<Document> documents = List.of(
            new Document("spring은 web application을 쉽게 만들기 위한 프레임워크입니다.", Map.of("category", "spring", "year", 1987)),
            new Document("spring ai는 AI 모델과의 통합을 단순화하는 프레임워크입니다.", Map.of("category", "spring", "year", 2021)),
            new Document("vector Store는 임베딩 벡터를 저장하고 유사도 검색을 수행합니다.", Map.of("category", "spring", "year", 2021)),
            new Document("kubernetes는 컨테이너화된 애플리케이션의 배포와 관리를 자동화합니다.", Map.of("category", "cloud", "year", 2025))
        );

        // 벡터 저장소에 문서 등록
        vectorStore.add(documents);
    }
}
2. Document 검색하기 (similaritySearch)
similaritySearch()는 주어진 텍스트나 SearchRequest를 이용해 벡터 저장소에서 유사 문서를 검색합니다.
- SearchRequest 주요 옵션:
query:유사도 검색에 사용될 텍스트topK: 유사도가 높은 상위 K개의 문서 지정similarityThreshold: 유사도 임계값 (1에 가까울수록 높은 유사도, default: 0.0)filterExpression: 메타데이터 검색 조건 설정 (예:"category == 'cloud' && year >= 2020")
@Service
public class SearchService {

    private final VectorStore vectorStore;

    public SearchService(VectorStore vectorStore) {
        this.vectorStore = vectorStore;
    }

    public List<Document> searchWithFilter(String question) {
        return vectorStore.similaritySearch(
            SearchRequest.builder()
                .query(question)
                .topK(1)
                .similarityThreshold(0.5) // 0.5 이상의 유사도 매칭
                .filterExpression("category == 'cloud' && year >= 2020") // 메타데이터 필터 조건
                .build()
        );
    }
}
유사도 임계값
코사인 유사도 Cosine Similarity, 0.0 1.0 기준 를 기반으로 검색 결과로 채택할 최소 점수 기준선
0.0(기본값/비활성화 수준): 유사도 점수와 상관없이 요청한 개수(topK)만큼 무조건 문서를 채우며 질문과 완전히 무관한 문서(노이즈)도 포함됩니다.0.5 ~ 0.6(느슨한 필터): 유의어, 간접적 맥락, 개념적으로 느슨하게 연결된 문서까지 폭넓게 수집하며 재현율(Recall)이 중요할 때 적합합니다.0.7 ~ 0.75(실무 권장 기준선): 실제 RAG 챗봇 및 Q&A 시스템에서 가장 널리 쓰이는 표준 기본값이며 질문과 직접 관련된 핵심 청크 위주로 필터링합니다.0.8 ~ 0.85(엄격한 필터): 문장 구조와 핵심 키워드 맥락이 질문과 거의 일치하는 문서만 반환하므로 정확도는 높으나 결과가 0건으로 누락될 위험이 있습니다.0.9이상 (극단적 일치): 질문과 사실상 동일한 어휘와 구조를 가진 문서만 통과시키며 오타나 표현 차이로 인해 정상 문서가 탈락하기 쉽습니다.
3. Document 삭제하기 (delete)
delete() 메서드를 통해 VectorStore에 저장된 데이터를 조건에 따라 삭제할 수 있습니다.
- 활용 방식:
- 메타데이터 필터 조건 기반 삭제:
vectorStore.delete("year >= 1987");와 같이 특정 조건에 맞는 문서를 일괄 삭제합니다. - 유사도 검색 연계 삭제: 먼저
similaritySearch()와 유사도 임계값(예: 0.8)을 주어 특정 기준 이상으로 일치하는 유사 문서를 찾은 뒤 삭제 프로세스로 연계할 수 있습니다.
- 메타데이터 필터 조건 기반 삭제:
@Service
public class DeleteService {

    private final VectorStore vectorStore;

    public DeleteService(VectorStore vectorStore) {
        this.vectorStore = vectorStore;
    }

    // 메타데이터 조건식 기반 삭제
    public void deleteByMetadataFilter() {
        vectorStore.delete("year >= 1987");
    }

    // 유사도 검색 결과를 기반으로 대상 문서 삭제
    public void deleteBySimilarity(String query) {
        List<Document> similarDocuments = vectorStore.similaritySearch(
            SearchRequest.builder()
                .query(query)
                .topK(1)
                .similarityThreshold(0.8) // 80% 이상 유사한 문서 탐색
                .build()
        );**텍스트**

        if (!similarDocuments.isEmpty()) {
            List<String> idsToDelete = similarDocuments.stream()
                    .map(Document::getId)
                    .toList();
            vectorStore.delete(idsToDelete);
        }
    }
}
RAG
LLM의 한계와 데이터 간격
대규모 언어 모델(LLM)은 훌륭하지만 최신 정보나 기업의 비공개 내부 데이터에 대해서는 알지 못합니다.
- 지식 단절 (Knowledge Cutoff): 훈련 데이터 이후의 최신 이벤트는 알지 못합니다.
- 환각 (Hallucination): 사실이 아닌 내용을 그럴듯하게 생성합니다.
- 컨텍스트 부재 (Lack of Context): 사용자의 특정 도메인이나 비공개 문서에 접근할 수 없습니다.
해결: 외부 세계와의 연결
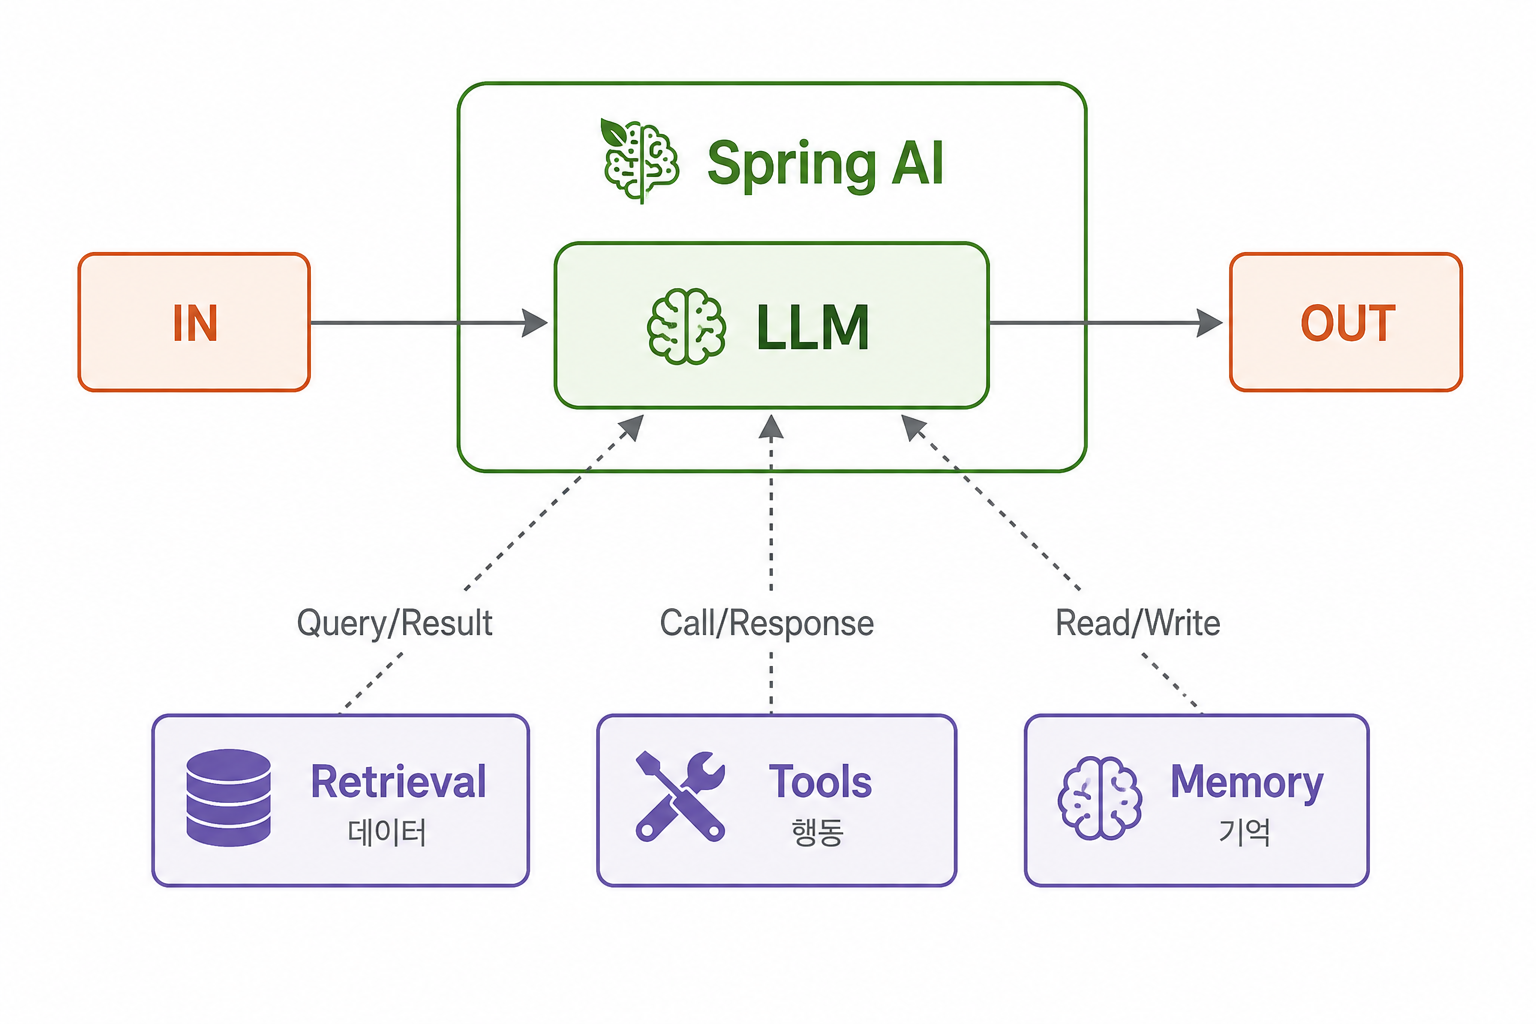
LLM을 외부 시스템과 연결하여 지식 단절, 환각, 컨텍스트 부족 문제를 해결합니다.
- Retrieval (External Knowledge Search): Vector Store 검색(pgvector 등)을 통해 최신/사내외 데이터를 연결하고 Prompt에 근거 문서를 포함합니다.
- Tool (Function Calling / API Integration): LLM이 외부 API나 DB를 호출하여 작업을 수행하고 시스템을 자동화합니다.
- Memory (Conversation Context Management): 대화 맥락을 유지 및 상태 관리하며 사용자 히스토리와 장기 컨텍스트를 저장합니다.
"LLM은 생각하고, Retrieval은 지식을 가져오고, Tools은 행동하고, Memory는 상태를 유지합니다."
RAG(Retrieval-Augmented Generation) 프로세스와 파이프라인
Vector DB로부터 검색(Retrieval)해서 사용자 질문을 보강(Augment)하고 LLM을 통해 답을 생성(Generation)합니다.
1) 사용자 질문: 사용자가 질문을 입력합니다 (예: "spring AI는 무엇인가?").
2) 검색 (Retrieve): Vector Store에서 질문과 관련된 문서를 검색합니다.
3) 증강 (Augment): 검색된 Document 내용을 Prompt에 Context로 추가합니다.
4) 생성 (Generate): 증강된 Prompt를 기반으로 LLM이 정확하고 사실에 근거한 답변을 생성합니다.
RAG 파이프라인
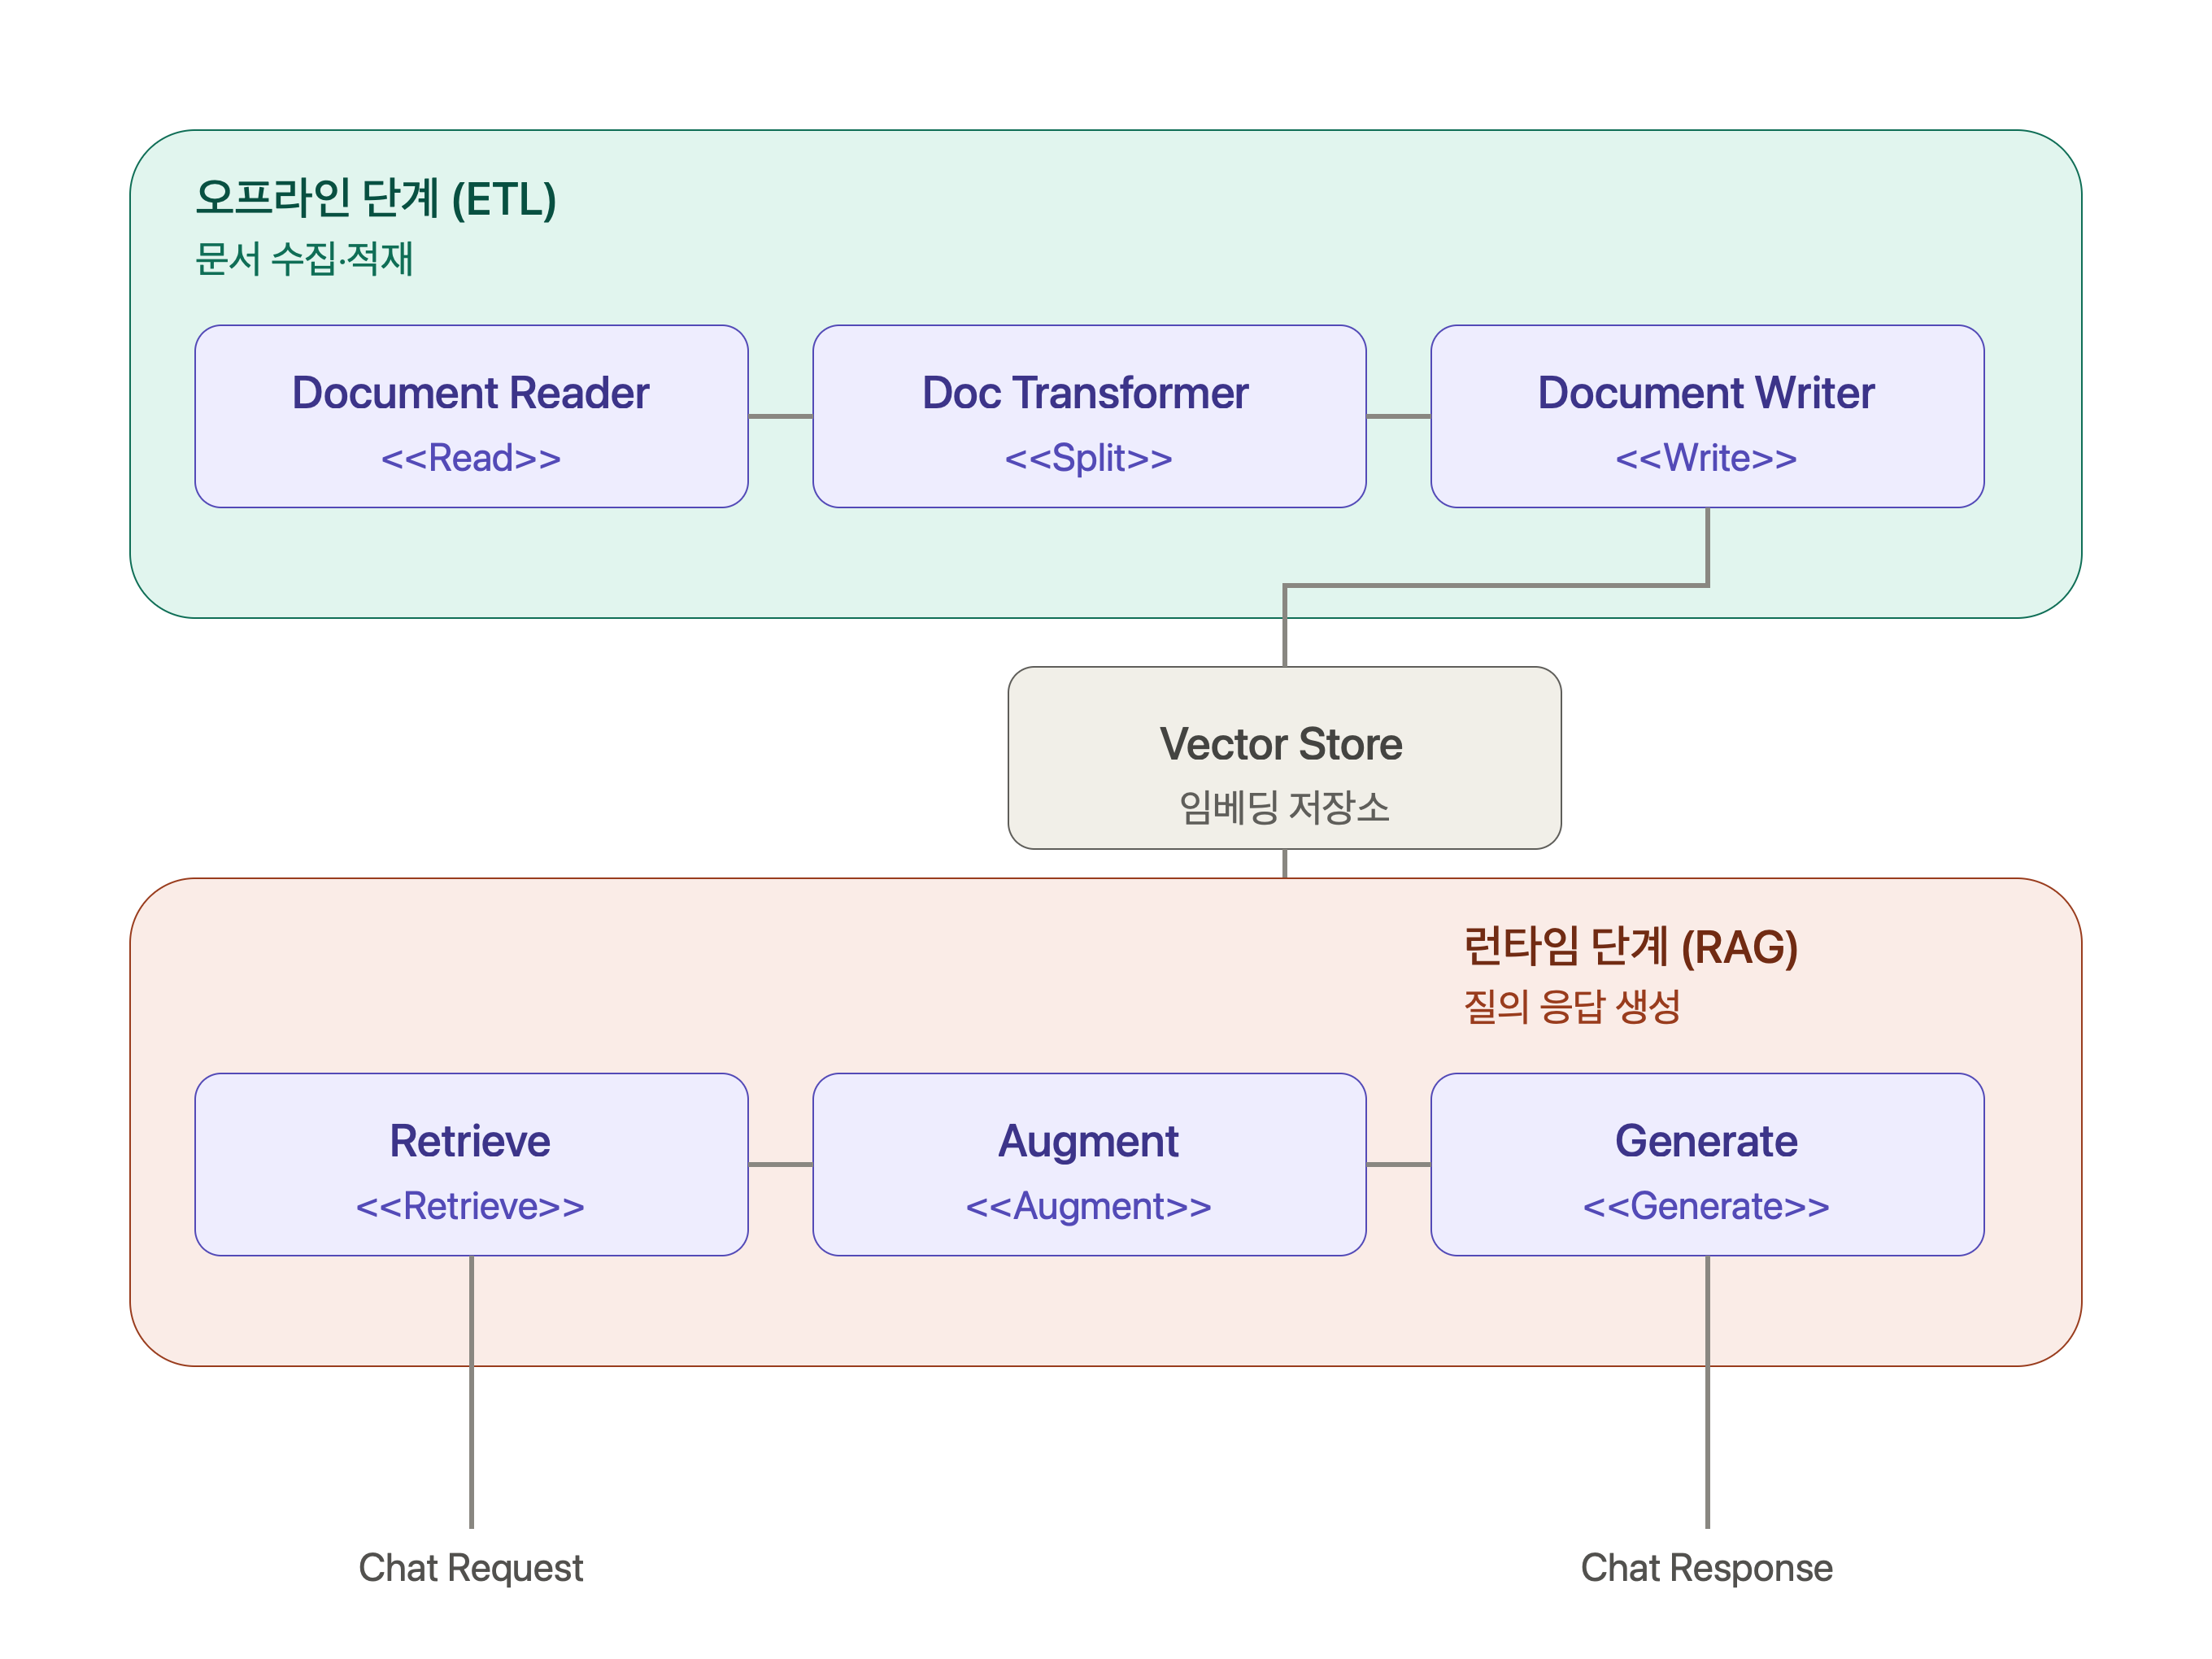
RAG 파이프라인은 데이터를 미리 수집·적재하는 오프라인(ETL) 단계와 사용자의 요청을 처리하는 런타임(RunTime) 단계로 나뉩니다.
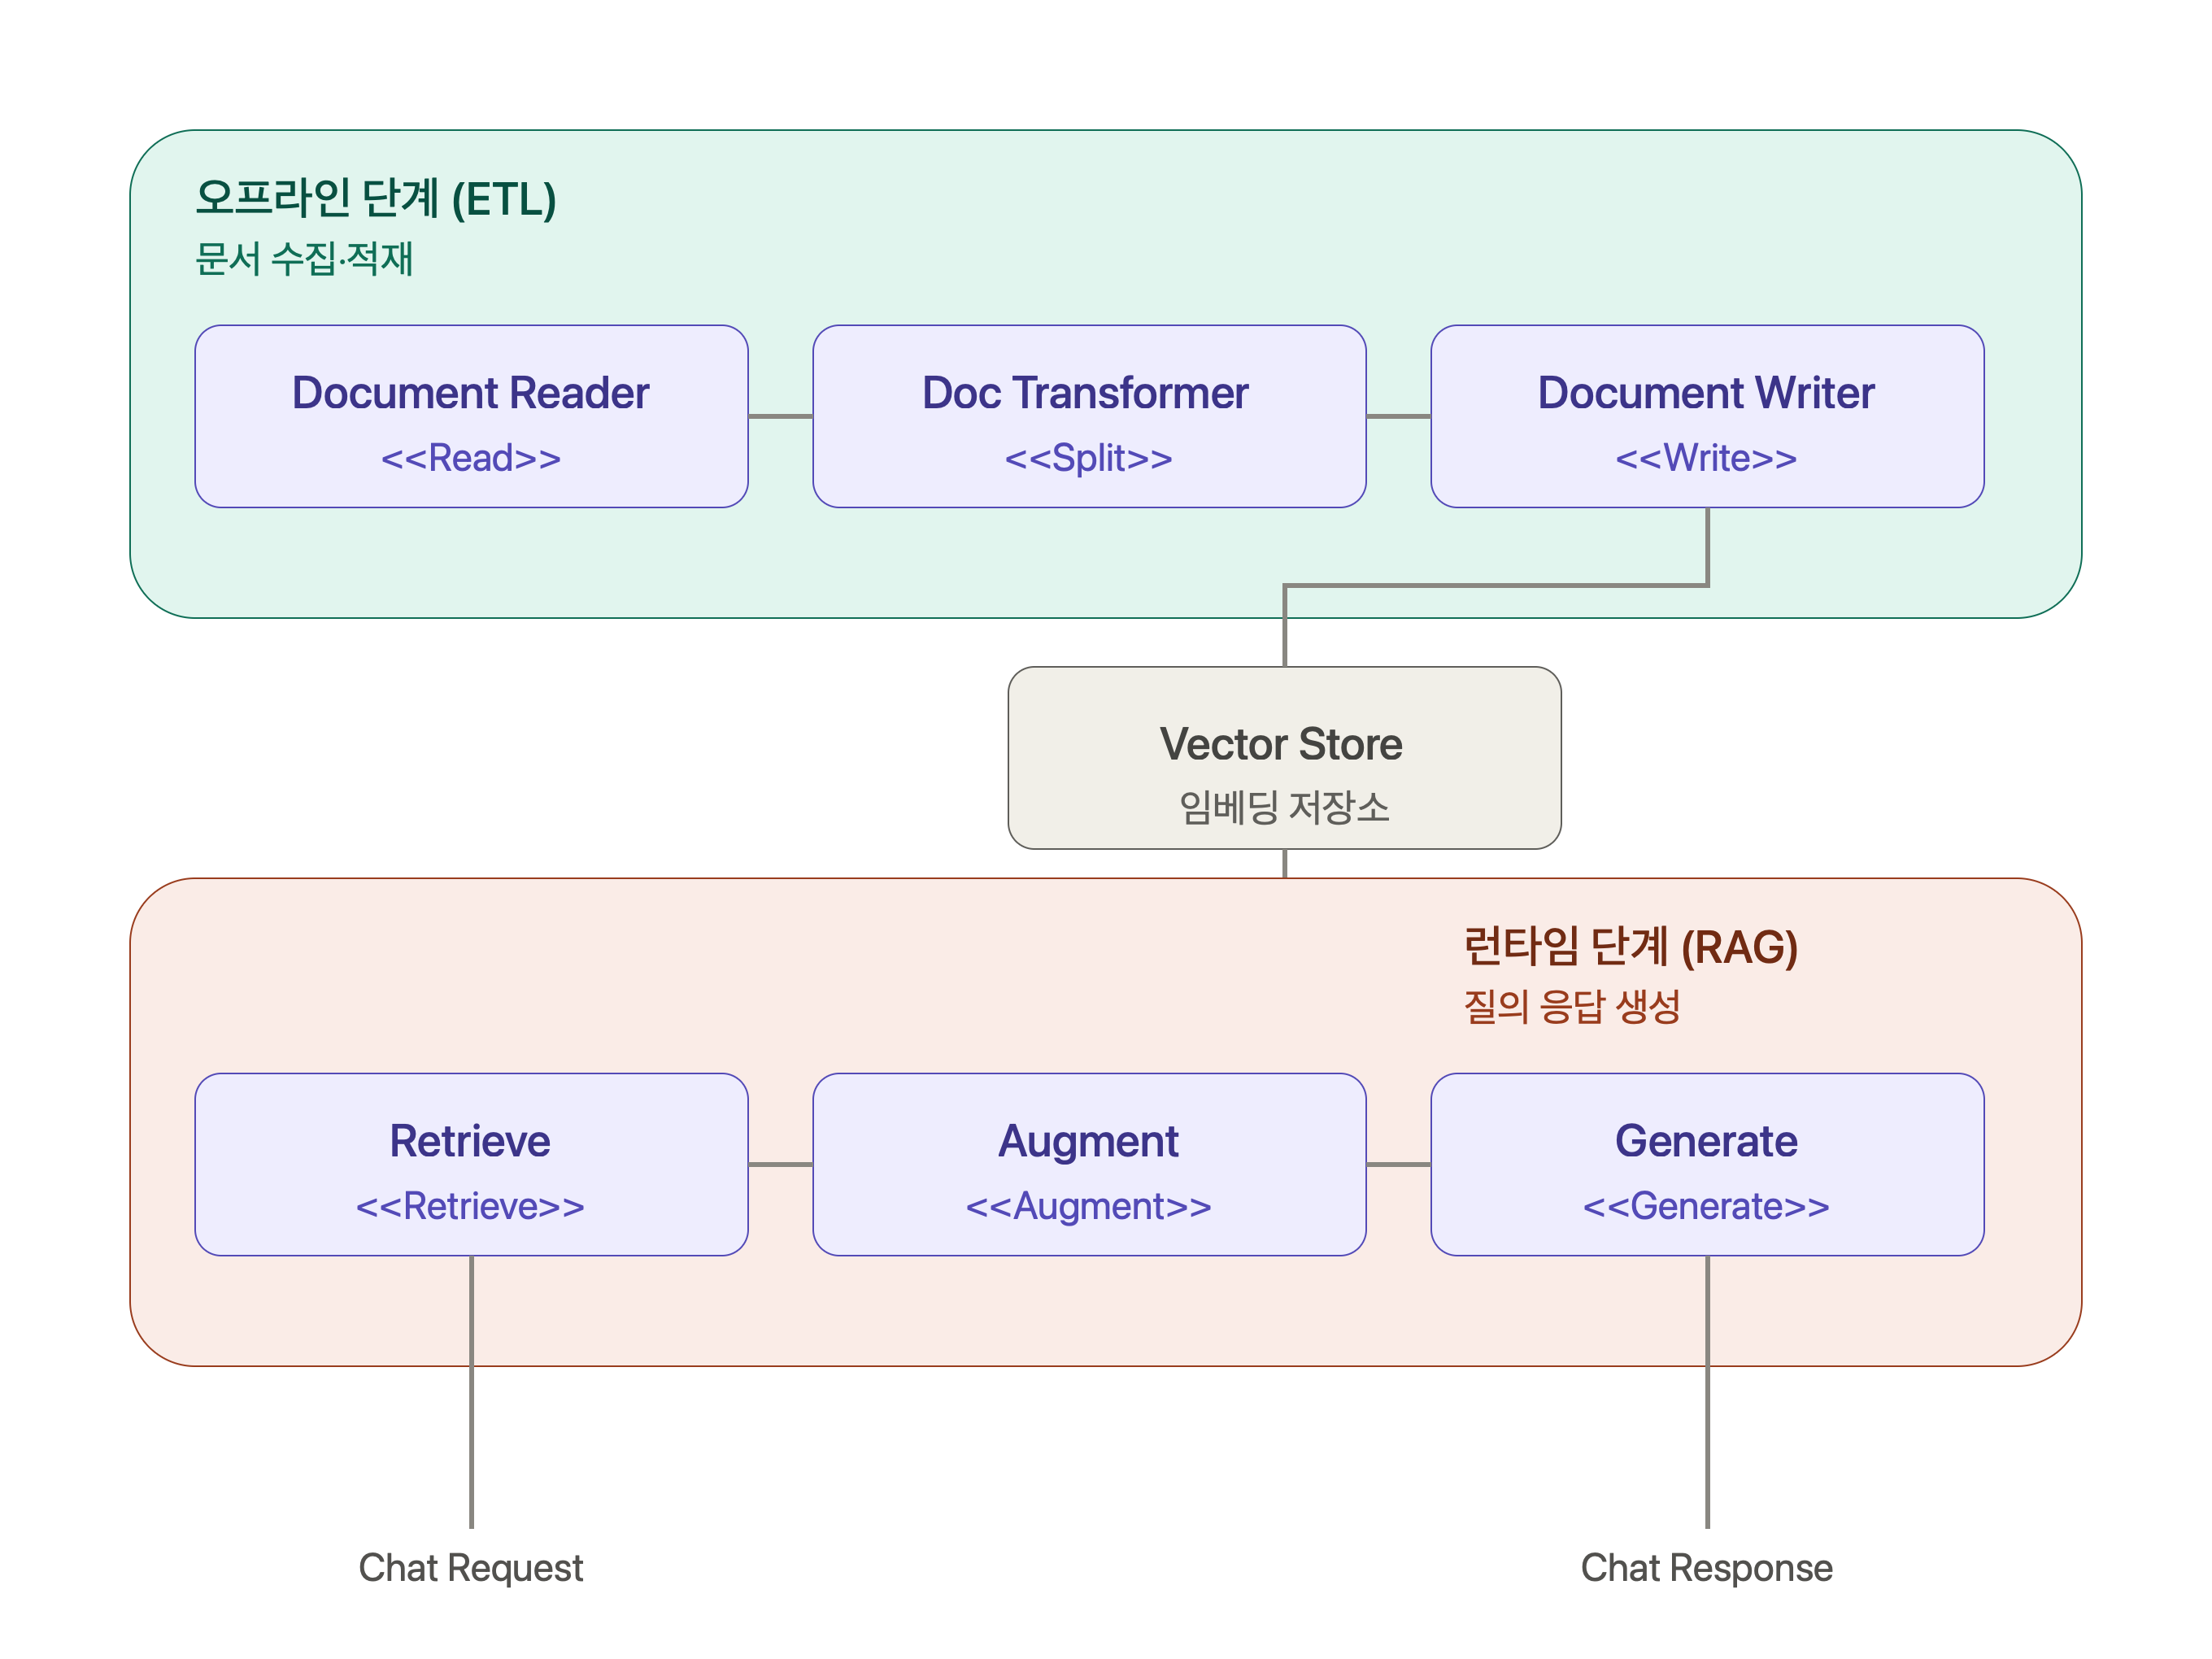
1. 오프라인 단계 (Documents Ingestion - ETL)
외부 소스로부터 텍스트를 추출하고, 문서 단위로 변환 및 분할한 뒤 벡터 저장소에 적재하는 사전 작업 영역입니다.
- Document Reader (
<<Read>>): text, pdf, docx, html, json 등 다양한 형식의 Data Source에서 원본 텍스트를 읽어 들여documents객체로 변환합니다. - Document Transformer (
<<Split>>): 읽어들인 문서를 LLM이 처리하기 적절한 크기의 조각으로 쪼개어chunks(Document) 형태로 분할합니다. - Document Writer (
<<Write>>): 분할된 청크들을 임베딩 모델을 거쳐 수치 벡터로 변환한 뒤Vector Store에 최종 저장합니다.
2. 런타임 단계 (Retrieval Augmented Generation - RAG)
사용자의 실시간 질문에 맞춰 관련 지식을 검색하고, 프롬프트를 보강하여 정확한 답변을 도출하는 실시간 실행 영역입니다.
- Retrieve (
<<Retrieve>>): 사용자의 채팅 요청(Chat Request)이 들어오면 질문 내용을 바탕으로 Vector Store에서 의미적으로 유사한 문서(retrieved docs)를 검색합니다. - Augment (
<<Augment>>): 검색된 문서 내용(Context information)과 사용자의 원래 질문(User Query)을 결합하여 LLM에 전달할 프롬프트 템플릿을 보강합니다. - Generate (
<<Generate>>): 보강된 프롬프트를 Chat Model(LLM)에 전달하여 환각 현상을 줄이고 사실에 근거한 Chat Response를 최종 생성합니다.
ETL(Extract, Tranform, Load) Offline
외부 데이터 소스 Vector Store 등 에서 관련 정보를 검색해서 이를 컨텍스트로 LLM 프롬프트에 추가하는 기술
- Document Reader (
<<Read>>): text, pdf, docx, html, json 등 다양한 형식의 Data Source에서 원본 텍스트를 읽어 들여documents객체로 변환합니다. - Document Transformer (
<<Split>>): 읽어들인 문서를 LLM이 처리하기 적절한 크기의 조각으로 쪼개어chunks(Document) 형태로 분할합니다. - Document Writer (
<<Write>>): 분할된 청크들을 임베딩 모델을 거쳐 수치 벡터로 변환한 뒤Vector Store에 최종 저장합니다.
1. Extract 단계 : DocumentReader
ETL 파이프라인의 진입점으로서 파일, 웹, DB 등의 외부 데이터 소스를 읽어 List<Document> 객체로 반환합니다.
자바의 함수형 인터페이스인 Supplier<List<Document>>를 확장하여 구현되어 있습니다.
| 구현체 | 설명 및 역할 |
|---|---|
| TextReader | 리소스(InputStream)에서 단순 텍스트를 읽어 UTF-8 인코딩으로 변환 |
| JsonReader | JSON 포맷의 데이터를 Document 리스트로 변환 |
| TikaDocumentReader | Apache Tika 기반으로 PDF, Word, PPT, HTML 등 다양한 파일 포맷 지원 |
| JsoupDocumentReader | HTML 문서에서 Jsoup을 이용해 텍스트 추출 |
| MarkdownDocumentReader | Markdown 파일을 읽어 텍스트와 메타데이터를 함께 추출 |
| PagePdfDocumentReader | PDF 문서를 페이지 단위의 Document 객체로 변환 |
| ParagraphPdfDocumentReader | PDF 문서를 문단 단위의 Document 객체로 변환 |
@Service
public class TxtEtlService {

    private static final Logger log = LoggerFactory.getLogger(TxtEtlService.class);
    // 텍스트 파일이 위치한 클래스패스 디렉토리 경로 지정
    private static final String DOCUMENTS_PATH = "classpath:documents/";

    private List<Document> documents;
    private final ResourceLoader resourceLoader;

    // 스프링의 ResourceLoader를 주입받아 파일 자원에 접근
    public TxtEtlService(ResourceLoader resourceLoader) {
        this.resourceLoader = resourceLoader;
    }

    /**
     * Extract 단계: documents 폴더에서 TXT 파일을 읽어 Document 목록을 생성
     */
    public TxtEtlService extract(String fileName) {
        // TextReader에 리소스를 전달하고 .get() 메서드를 호출해 List<Document> 획득
        this.documents = new TextReader(resourceLoader.getResource(DOCUMENTS_PATH + fileName)).get();

        log.info("[TXT ETL] Extract 완료 - filename: {}, document 수: {}", fileName, documents.size());
        return this;
    }
}
Extract 처리 후 문서 개수와 Big Document의 문제점
TextReader를 사용할 경우 일반적으로 1개의 문서가 생성되지만PagePdfDocumentReader는 PDF의 전체 페이지 수만큼 Document 객체가 만들어집니다.- 임베딩 벡터의 의미 희석: 하나의 거대한 문서에 너무 다양한 주제가 섞여 있으면 전체적인 정보의 특징이 뭉개지는 현상이 발생합니다.
- 질문과 관련 없는 노이즈 포함: 사용자 질문과 무관한 정보가 함께 검색 결과에 포함되어 유사도 품질을 떨어뜨리고 토큰 사용량을 증가시킵니다.
2. Transform 단계 : DocumentTransformer
Extract(추출) 단계에서 생성된 원본 문서(Document)를 검색 및 LLM 활용에 최적화된 크기와 구조로 변환(Transform)하는 ETL 파이프라인 단계입니다.
자바의 함수형 인터페이스 Function<List<Document>, List<Document>>를 확장하여 구현됩니다.
| 구현체 | 설명 및 역할 |
|---|---|
| TokenTextSplitter | AI 모델의 토큰(Token) 기준으로 문서를 일정 크기의 청크(Chunk)로 분할하는 기본 구현체 |
| TextSplitter | 텍스트 기반 분할기의 추상 클래스로, 문단이나 구분자 등 커스텀 분할 규칙을 구현할 때 확장하여 사용 |
| MarkdownTextSplitter | 마크다운 헤더(#, ## 등) 구조를 인식하여 장(Chapter)과 절(Section) 단위로 논리적 분할 |
| KeywordMetadataEnricher | LLM을 활용해 문서의 주요 키워드를 자동으로 추출하여 메타데이터에 추가 |
| SummaryMetadataEnricher | LLM을 활용해 문서의 요약문(Summary)을 생성하여 메타데이터에 추가 |
| ContentFormatTransformer | Vector Store에 저장하기 전 문서의 본문 및 메타데이터 포맷을 일괄 정형화 |
DocumentTransformer 구현체 TokenTextSplitter : Chunk 단위로 분할 작업 수행
import org.springframework.ai.document.Document;
import org.springframework.ai.transformer.splitter.TokenTextSplitter;

public class TokenSplitterConfigExample {

    public List<Document> processSplitting(List<Document> documents) {
        // TokenTextSplitter 설정 예제
        TokenTextSplitter transformer = TokenTextSplitter.builder()
            // chunkSize: 1차 분할 시 기준이 되는 목표 토큰 수 (기본값: 800 토큰)
            .withChunkSize(800)

            // minChunkSizeChars: chunkSize에 도달하기 전 최소 문자 수 이상에서 분할하도록 지시하는 기준 (기본값: 350 문자)
            .withMinChunkSizeChars(350)

            // minChunkLengthToEmbed: 임베딩을 수행할 최소 문자 수, 이 값보다 짧은 의미 없는 조각은 최종 제외 (기본값: 5 문자)
            .withMinChunkLengthToEmbed(5)

            // maxNumChunks: 최종 생성을 허용할 최대 Chunk 개수 제한 (메모리 폭주 방지 및 비용 절감, 기본값: 10,000 개)
            .withMaxNumChunks(10000)

            // keepSeparator: 줄바꿈(\n)이나 문장 구분 기호를 삭제하지 않고 유지할지 여부 (기본값: true)
            .withKeepSeparator(true)
            .build();

        // 입력된 문서 리스트를 설정된 규칙에 따라 청크로 분할
        return transformer.apply(documents);
    }
}
TokenTextSplitter 청크 분할 프로세스
- 1차 청크 분할: 설정된
chunkSize(예: 800 토큰)를 기준으로 분할하되minChunkSizeChars(예: 350자)를 넘긴 시점에서 . , ?, ! , \n 같은 자연스러운 문장 경계(구분자)를 탐색하여 자릅니다. - 개별 청크 가공 및 검증:
- 분리된 텍스트의 앞뒤 공백을 정돈하고
keepSeparator설정에 따라 줄바꿈/구분자를 유지합니다. minChunkLengthToEmbed미만의 지나치게 짧은 노이즈 조각은 최종 청크에서 제외(Drop)합니다.
- 분리된 텍스트의 앞뒤 공백을 정돈하고
- 최종 제한 검사: 생성된 전체 청크 수가
maxNumChunks를 초과하지 않도록 제어합니다.
3. Load 단계 : DocumentWriter
파일, 웹, DB 등의 외부 데이터 소스로부터 읽어 들인 문서를 Vector Store에 최종 저장하는 ETL 파이프라인의 마지막 단계입니다.
write메서드는Document를 읽어서 임베딩 벡터화한 후 Vector DB에 저장을 실행합니다.DocumentWriter인터페이스는 자바의 함수형 인터페이스Consumer<List<Document>>를 확장하여 구현되어 있습니다.
@Service
public class LoadEtlService {

    private static final Logger log = LoggerFactory.getLogger(LoadEtlService.class);

    // DocumentWriter 인터페이스 선언 (VectorStore가 구현체로 주입됨)
    private final DocumentWriter documentWriter;
    private List<Document> documents; // 이전 단계(Transform)에서 분할된 문서 청크 리스트

    // 생성자 주입을 통해 VectorStore 객체를 DocumentWriter 타입으로 할당
    public LoadEtlService(VectorStore vectorStore) {
        this.documentWriter = vectorStore;
    }

    /**
     * Load 단계: 분할된 문서 청크들을 임베딩 과정을 거쳐 Vector DB에 적재한다.
     */
    public List<Document> load(List<Document> splitDocuments) {
        this.documents = splitDocuments;

        // documentWriter.write() 호출 시, 내부적으로 EmbeddingModel을 통해
        // 텍스트 청크들이 수치 벡터로 변환(임베딩)된 뒤 Vector DB에 최종 저장됨
        documentWriter.write(documents);

        log.info("[TXT ETL] Load 완료 - VectorDB 저장 건수: {}", documents.size());
        return documents;
    }
}DocumentWriter의 대표적인 구현체로VectorStore를 주입받아 사용합니다.load()메서드 내에서documentWriter.write(documents);를 호출하여 분할된 문서 청크들을 임베딩 과정을 거쳐 Vector DB에 적재합니다.
RAG RunTime
사용자 질문과 관련된 외부 지식을 Vector Store에서 찾아낸 뒤 그 정보를 프롬프트에 덧붙여 LLM이 답변하도록 만드는 패턴
- Retrieve (
<<Retrieve>>): 사용자의 채팅 요청(Chat Request)이 들어오면 질문 내용을 바탕으로 Vector Store에서 의미적으로 유사한 문서(retrieved docs)를 검색합니다. - Augment (
<<Augment>>): 검색된 문서 내용(Context information)과 사용자의 원래 질문(User Query)을 결합하여 LLM에 전달할 프롬프트 템플릿을 보강합니다. - Generate (
<<Generate>>): 보강된 프롬프트를 Chat Model(LLM)에 전달하여 환각 현상을 줄이고 사실에 근거한 Chat Response를 최종 생성합니다.
Spring AI RAG Advisor 종류
Spring AI는 RAG 파이프라인을 손쉽게 구축할 수 있도록 어드바이저 체인(Advisor Chain) 내에서 동작하는 기본 RAG Advisor를 제공합니다.
1. QuestionAnswerAdvisor (기본 RAG Advisor):
- 기본 VectorStore를 기반으로 RAG를 가장 빠르고 간단하게 구현할 때 사용합니다.
- 단순 Q&A나 빠른 프로토타이핑(Rapid Prototyping)에 적합합니다.
VectorStore와SearchRequest를 간단하게 결합하여 작동합니다.
2. RetrievalAugmentationAdvisor:
- 멀티 커스텀 컴포넌트를 조합하고 파이프라인을 세밀하게 제어할 때 사용합니다.
- 하이브리드 검색(Hybrid Search), 쿼리 재작성(Query Rewrite), 리랭킹(Reranking) 등 고도화된 RAG 구현을 지원합니다.
DocumentRetriever,QueryTransformer등이 모듈화되어 있습니다.
QuestionAnswerAdvisor
- 동작 방식: 사용자의 질문을 받아 Vector Store에서 관련 문서를 검색(Retrieve)한 뒤 검색된 문서(Context)를 원래 질문에 자동으로 추가(Augment)하여 LLM에게 전달(Generate)합니다.
- 코드 적용의 간소화: ChatClient 빌더 설정 시
.advisors(new QuestionAnswerAdvisor(vectorStore))단 한 줄을 추가하는 것만으로 RAG 기능을 간편하게 활성화할 수 있습니다.
ChatClient chatClient = ChatClient.builder(chatModel).build();

ChatResponse response = chatClient.prompt()
    .user("사용자 질문...")
    .advisors(new QuestionAnswerAdvisor(vectorStore)) // 단 한 줄로 RAG 기능 활성화
    .call()
    .chatResponse();
QuestionAnswerAdvisor 검색 및 런타임 필터 설정
SearchRequest를 활용해 검색 조건을 정적으로 미리 정의하거나 런타임에 FILTER_EXPRESSION을 주입하여 동적으로 필터링을 적용할 수 있습니다.
1) 정적 검색 조건 생성 예제:
var qaAdvisor = QuestionAnswerAdvisor.builder(vectorStore)
    .searchRequest(SearchRequest.builder()
        .similarityThreshold(0.3) // 유사도 임계값 설정
        .topK(5)                  // 상위 5개 문서 검색
        .build())
    .build();
2) 런타임 동적 필터 적용 실행 예제:
chatClient.prompt()
    .user("Please answer my question")
    .advisors(a -> a
        .advisor(qaAdvisor) // 생성한 Advisor 등록
        .param(
            QuestionAnswerAdvisor.FILTER_EXPRESSION,
            "metadata.document_type == 'Technical Guide'" // 런타임 메타데이터 필터 조건 주입
        )
    )
    .call();
RetrievalAugmentationAdvisor
검색, 질의 변환, 필터링, 문서 결합 등 RAG 전체 흐름을 유연하게 구성할 수 있도록 지원하는 확장성 Advisor입니다.
각 단계를 독립적인 구성요소로 분리하여 런타임 시점에 모듈을 자유롭게 조합할 수 있습니다.
기본 QuestionAnswerAdvisor에 비해 훨씬 세밀하고 자유로운 파이프라인 제어가 가능합니다.
RAG 4단계 파이프라인 구조
- 1단계_Pre-Retrieval (사전 검색): 사용자 쿼리를 변환하여 검색 품질을 극대화합니다.
- 2단계_Retrieval (검색): 변환된 쿼리를 바탕으로 Vector Store에서 관련 문서를 가져옵니다.
- 3단계_Post-Retrieval (사후 검색): 검색된 문서를 재정렬(Reranking)하거나 필터링하여 노이즈를 줄입니다.
- 4단계_Generation (생성): 검색된 결과를 프롬프트에 증강(Augment)하고 LLM을 호출하여 최종 답변을 생성합니다.
1단계: Pre-Retrieval
주요 쿼리 변환기 (Query Transformers)
RewriteQueryTransformer: 검색 결과에 악영향을 줄 수 있는 불필요한 수식어구나 잡음이 섞인 사용자 질문을 LLM을 이용해 정제된 핵심 메시지로 재작성합니다.CompressionQueryTransformer: 이전 대화 맥락과 연관되어 모호해진 질문을 독립적이고 완전한 질문 형태로 변환합니다.MultiQueryExpander: 단일 질문을 의미가 유사한 여러 개의 다양한 질문으로 확장하여 더 많은 관련 문서를 누락 없이 검색할 수 있도록 돕습니다.TranslationQueryTransformer: 사용자의 질문을 임베딩 모델이 가장 잘 이해하고 지원하는 언어로 번역합니다.
RewriteQueryTransformer 예제 코드
불필요한 수식어나 잡음이 섞인 사용자 질문을 LLM을 이용해 정제된 핵심 메시지로 재작성합니다.
- 원본 질문: "혹시 오늘날씨도 좋은데 Spring AI에서 RAG 검색 속도를 올리는 방법을 알고 있나요? 부탁드립니다"
- 변환 결과: "Spring AI RAG 검색 속도 최적화 방법"
- 동작 방식: 검색 결과의 품질을 떨어뜨릴 수 있는 불필요한 일상 대화, 감상, 수식어구 등의 잡음을 제거하고 검색 의도와 관련된 핵심 키워드 중심의 문장으로 재작성합니다.
public class RewriteQueryService {
    private final ChatClient chatClient;

    public RewriteQueryService(ChatModel chatModel, VectorStore vectorStore) {
        // 쿼리 정제를 수행할 LLM 호출용 별도 ChatClient 빌더 생성
        ChatClient.Builder transformerBuilder = ChatClient.builder(chatModel)
            .defaultAdvisors(new SimpleLoggerAdvisor());

        // RetrievalAugmentationAdvisor 설정
        RetrievalAugmentationAdvisor advisor = RetrievalAugmentationAdvisor.builder()
            // RewriteQueryTransformer를 사용하여 잡음이 섞인 질문을 핵심 메시지로 재작성
            .queryTransformers(
                RewriteQueryTransformer.builder()
                    .chatClientBuilder(transformerBuilder)
                    .build()
            )
            // 정제된 쿼리를 기반으로 VectorStore에서 문서 검색
            .documentRetriever(
                VectorStoreDocumentRetriever.builder()
                    .topK(5)
                    .similarityThreshold(0.3)
                    .vectorStore(vectorStore)
                    .build()
            )
            .build();

        // 메인 ChatClient 생성 및 어드바이저 등록
        this.chatClient = ChatClient.builder(chatModel)
            .defaultAdvisors(advisor)
            .build();
    }
}
CompressionQueryTransformer 예제 코드
이전 대화 맥락과 연관되어 모호해진 질문을 LLM을 이용해 독립적이고 완전한 질문 형태로 변환합니다.
- 이전 대화 맥락: "spring AI의 TokenTextSplitter 설정법을 알려줘"
- 모호한 사용자 질문: "그럼 그거 기본 토큰 크기(chunk size)는 얼마야"
- 변환 결과: "Spring AI TokenTextSplit의 기본 chunk size 설정값은 얼마인가?"
- 동작 방식: 대화 기억(Chat Memory)을 참조하여 "그거"와 같이 맥락에 의존해 모호해진 대명사나 표현을 이전 대화와 결합하고 독립적으로 이해할 수 있는 완전한 문장으로 변환합니다.
public class CompressionQueryService {
    private final ChatClient chatClient;

    public CompressionQueryService(ChatModel chatModel, VectorStore vectorStore, ChatMemory chatMemory) {
        ChatClient.Builder transformerBuilder = ChatClient.builder(chatModel)
            .defaultAdvisors(new SimpleLoggerAdvisor());

        RetrievalAugmentationAdvisor advisor = RetrievalAugmentationAdvisor.builder()
            // CompressionQueryTransformer를 사용해 대화 기억을 반영한 완전한 질문으로 변환
            .queryTransformers(
                CompressionQueryTransformer.builder()
                    .chatClientBuilder(transformerBuilder)
                    .build()
            )
            .documentRetriever(
                VectorStoreDocumentRetriever.builder()
                    .topK(3)
                    .similarityThreshold(0.3)
                    .vectorStore(vectorStore)
                    .build()
            )
            .build();

        // Chat Memory Advisor와 RAG Advisor를 함께 등록
        this.chatClient = ChatClient.builder(chatModel)
            .defaultAdvisors(
                MessageChatMemoryAdvisor.builder(chatMemory).build(),
                advisor,
                new SimpleLoggerAdvisor(Ordered.LOWEST_PRECEDENCE-1)
            )
            .build();
    }

    // 런타임에 Session ID를 전달하여 대화 이력 기반 쿼리 압축 수행
    public String answer(String question, String conversationId) {
        return chatClient.prompt()
            .advisors(a -> a.param(ChatMemory.CONVERSATION_ID, conversationId))
            .user(question)
            .call()
            .content();
    }
}
MultiQueryExpander 예제 코드
단일 질문을 의미가 유사한 여러 개의 다양한 질문으로 확장하여 더 많은 관련 문서를 누락 없이 검색할 수 있도록 돕습니다.
- 원본 질문: "Spring AI RAG 성능 개선"
- 확장 결과:
- "Spring AI RAG 성능 향상 및 속도 최적화 기법"
- "Spring AI VectorStore 검색 정확도 및 임베딩 개선"
- (이외 다양한 각도로 재구성된 확장 쿼리들)
- 동작 방식: 단일 질의를 의미적으로 유사하지만 표현이나 초점이 조금씩 다른 여러 개의 질문으로 확장하여 단일 쿼리로 검색했을 때 놓칠 수 있는 관련 문서들을 폭넓게 건져 올릴 수 있도록 유도합니다.
public class MultiQueryExpanderService {
    private final ChatClient chatClient;

    public MultiQueryExpanderService(ChatModel chatModel, VectorStore vectorStore) {
        ChatClient.Builder expanderBuilder = ChatClient.builder(chatModel)
            .defaultAdvisors(new SimpleLoggerAdvisor());

        RetrievalAugmentationAdvisor advisor = RetrievalAugmentationAdvisor.builder()
            // MultiQueryExpander를 사용하여 단일 질문을 여러 개의 확장된 질의로 생성
            .queryExpander(
                MultiQueryExpander.builder()
                    .chatClientBuilder(expanderBuilder)
                    .numberOfQueries(3) // 생성할 확장 쿼리 개수 (기본값: 3)
                    .build()
            )
            .documentRetriever(
                VectorStoreDocumentRetriever.builder()
                    .topK(5)
                    .similarityThreshold(0.3)
                    .vectorStore(vectorStore)
                    .build()
            )
            .build();

        this.chatClient = ChatClient.builder(chatModel)
            .defaultAdvisors(advisor, new SimpleLoggerAdvisor(Ordered.LOWEST_PRECEDENCE))
            .build();
    }
}
2단계: Retrieval
VectorStoreDocumentRetriever: Pre-Retrieval 단계에서 정제·변환된 Query를 이어받아 Vector Store로 유사도 기반 검색을 수행하는 모듈입니다.- 내부적으로
VectorStore.similaritySearch를 호출하며 설정된topK와similarityThreshold값을 기준으로 관련 문서들을 자동으로 가져와 프롬프트 주입 단계로 전달합니다.
public class RetrievalOnlyService {
    private final ChatClient chatClient;

    public RetrievalOnlyService(ChatModel chatModel, VectorStore vectorStore) {

        // RetrievalAugmentationAdvisor를 활용해 Retrieval 단계만 독립적으로 구성
        RetrievalAugmentationAdvisor advisor = RetrievalAugmentationAdvisor.builder()
            // VectorStoreDocumentRetriever를 지정하여 Vector Store에서 직접 문서 검색 수행
            .documentRetriever(
                VectorStoreDocumentRetriever.builder()
                    .topK(4)                          // 상위 4개의 연관 문서 추출
                    .similarityThreshold(0.4)         // 최소 유사도 임계값 0.4 이상인 문서만 필터링
                    .vectorStore(vectorStore)
                    .build()
            )
            .build();

        // 메인 ChatClient에 RAG 검색 Advisor 등록
        this.chatClient = ChatClient.builder(chatModel)
            .defaultAdvisors(advisor)
            .build();
    }

    // 런타임에 사용자 질문을 받아 검색된 문서 문맥(Context)을 프롬프트에 증강한 뒤 LLM 호출
    public String ask(String question) {
        return chatClient.prompt()
            .user(question)
            .call()
            .content();
    }
}
3단계: Post-Retrieval
DocumentPostProcessor
Vector DB로부터 검색된 문서(Retrieved Docs)를 가공하여 노이즈를 줄이는 선택적(Optional) 단계입니다. 특별한 후처리가 필요 없다면 이 단계는 생략(Skip)됩니다.
주요 기능:
- 재정렬 (Re-ranking): 쿼리와의 관련성을 기준으로 문서 순위를 재조정합니다.
- 필터링 (Filtering): 관련 없거나 중복된 문서를 제거합니다. (예: 유사도 점수가 기준치에 미치지 못하는 문서 제거)
- 압축 (Compression): 문서 내용을 요약하여 노이즈를 줄이고 lost-in-the-middle 문제를 완화합니다.
// 검색된 문서에 대한 후처리용 (Optional)
DocumentPostProcessor documentPostProcessor = (Query query, List<Document> documents) -> {
    // 예시: 유사도 점수(Score)가 0.5 이상인 문서만 필터링 (0.5 미만은 모두 제거)
    return documents.stream()
        .filter(doc -> doc.getScore() != null && doc.getScore() >= 0.5)
        .collect(Collectors.toList());
};
4단계: Generation
ContextualQueryAugmenter
정제된 문서(Refined Docs)와 사용자 쿼리를 최종 Prompt Template에 결합하여 LLM에 전달할 최종 프롬프트(Final Prompt)를 완성하는 단계입니다.
주요 특징 및 설정 옵션:
- 설정을 별도로 하지 않는 경우 내부적으로 기본 queryAugmenter가 기본형태(검색된 문서들을 단순히 줄바꿈으로 합쳐서 프롬프트에 추가)로 자동 할당됩니다.
allowEmptyContext(false)(기본값): 검색 결과(컨텍스트)가 비어 있을 경우 찾을 수 없다고 응답합니다.allowEmptyContext(true): 컨텍스트가 비어 있는 경우에도 유연하게 동작을 제어할 수 있습니다.
// 1. 컨텍스트가 존재할 때 사용할 프롬프트 템플릿 설정
String contextPrompt = """
    아래는 관련 컨텍스트 정보입니다.
    ---------------------
    {context}
    ---------------------
    주어진 컨텍스트 정보만을 사용하여 질문에 답변하세요.
    질문: {query}
    답변:
    """;

// 2. 컨텍스트가 비어 있을 때 사용할 프롬프트 템플릿 설정
String emptyContextPrompt = "사용자의 질문이 제공된 지식 범위를 벗어났습니다. 정중하게 답변할 수 없다고 안내해주세요.";

// 3. ContextualQueryAugmenter 빌드
ContextualQueryAugmenter queryAugmenter = ContextualQueryAugmenter.builder()
    .promptTemplate(new PromptTemplate(contextPrompt))
    .emptyContextPromptTemplate(new PromptTemplate(emptyContextPrompt))
    .allowEmptyContext(false)
    .build();

// 4. RetrievalAugmentationAdvisor에 등록
RetrievalAugmentationAdvisor advisor = RetrievalAugmentationAdvisor.builder()
    .documentPostProcessors(documentPostProcessor)
    .queryAugmenter(queryAugmenter)
    .build();