인공지능 개요
인공 지능( Artificial Intelligence, AI )
정의
- 인간의 학습 능력, 추론 능력, 지각 능력, 자연 언어 이해 능력 등을 컴퓨터 프로그램으로 실현한 기술
강인공 지능: 지능을 갖고 있는 기능을 갖춘 컴퓨터 시스템이며, 인간의 지능을 기계등에 인공적으로 구현한 것약인공 지능: 인간과 같은 방식으로 데이터를 학습하여 프로그램에 적용하는 컴퓨터 시스템, 컴퓨터 프로그램 작성 방식을 인간의 학습 방식을 활용
컴퓨터 프로그램 작성 방식
-
전통적인 방식: 프로그래머가 문제를 해결하기 위한 알고리즘을 직접 코드로 작성하여 완성하는 방식
인간이 패턴을 직접 명령으로 전달하여 실행 - Symbolic AI -
인공지능(머신러닝, 딥러닝)방식 (약인공 지능): 문제 해결을 위해 필요한 데이터를 수집하여 컴퓨터에게 전달하여 데이터에 내재된 패턴을 학습(훈련)이라 과정을 통해 결과물을 완성하는 방식결과물이 AI 모델(자동화 코드 집합)의 형태로 생성된다.
인공 지능 유형
레벨 1 : 단순한 제어 프로그램
레벨 2 : 패턴이 다양한 고전적 인공 지능 - 전문가 시스템( expert system )
레벨 3 : 머신러닝(통계 기반)을 이용한 인공 지능 - 정형 데이터에 대하여 높은 성능
레벨 4 : 딥러닝(신경망 기반)을 이용한 인공 지능 - 비정형 데이터에 대하여 높은 성능
레벨 1, 2 : 일반적인(전통적인) 프로그래밍 방식 사용, Symbolic AI
레벨 3, 4 : 데이터 학습(훈련)을 통한 프로그래밍 방식 사용
(학습을 통한 데이터의 패턴을 찾는 방식)
- AI도 결국 사람의 정보를 기반하기에 부정확하다
그렇기 때문에 신뢰성을 높이기 위해서 여러 장치를 세워야 한다
- 컴퓨터에는 지능이 없다
- 거대한 데이터를 바탕으로 한 짜집기에 불과하다
- 스스로 사고 할 수 없다
- 생명이나 큰 소실을 가져올 수 있는 프로그램은 AI로 코딩하지 않는다
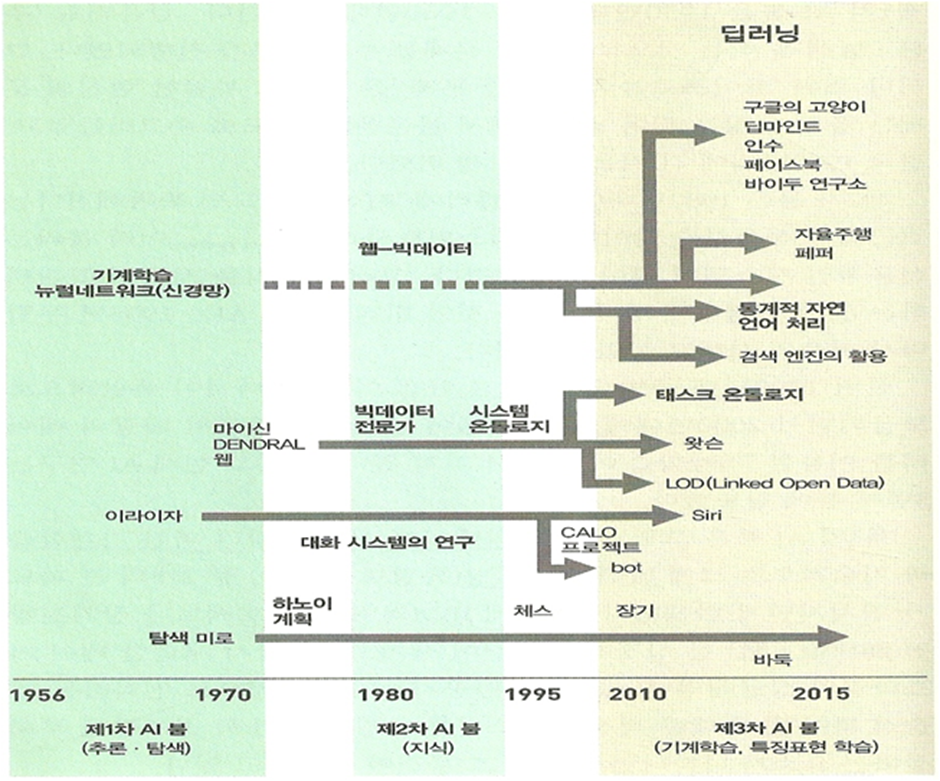
인공지능 역사
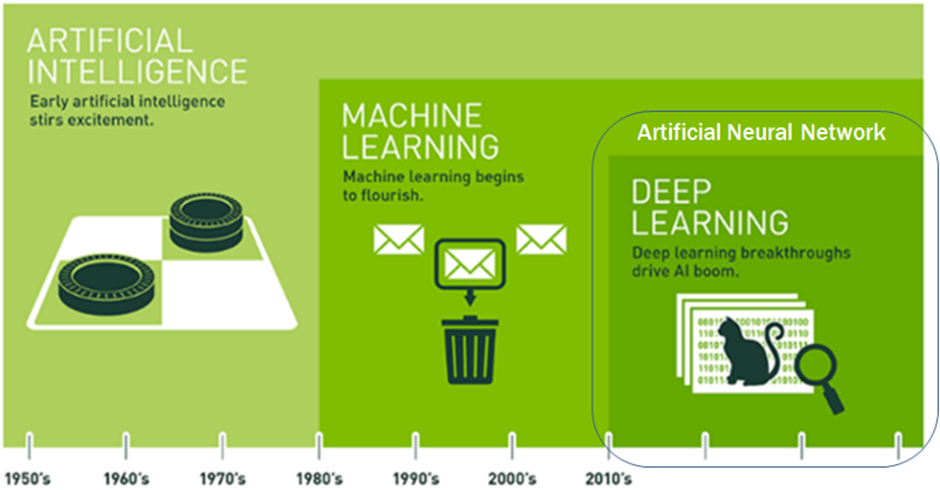
인공 지능 구현 방식에 따른 분류
규칙 기반 인공 지능( Symbolic AI )
전문가 시스템( expert System ), 전통적인 프로그래밍 방식 (알고리즘을 직접 구현)
통계 기반 인공 지능
머신러닝( Machine Learning ), 학습( 훈련 ) 방식의 프로그래밍 방식으로 통계 기반 알고리즘을 활용하여 학습을 수행한다. 정형 데이터에 대한 정확도가 높은 모델을 생성한다.
신경망 기반 인공 지능
딥러닝( Deep Learning ), 학습( 훈련 ) 방식의 프로그래밍 방식으로 신경망 기반 알고리즘을 활용하여 학습을 수행한다. 비정형 데이터에 대한 정확도가 높은 모델을 생성한다.
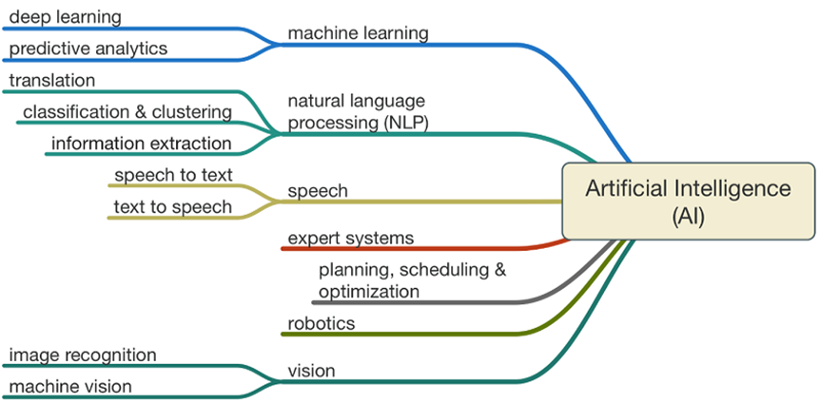
AI 알고리즘 : 데이터를 학습하는 방법
신경망 모델 : 데이터를 학습하는 구조
AI 모델: 데이터를 학습한 결과 -> 데이터에 내재된 패턴
머신러닝 (Machine Learning)
- 인공 지능( Artificial Intelligence, AI )의 한 분야로 컴퓨터가 학습할 수 있도록 알고리즘과 기술을 개발하는 분야
- 데이터에서 패턴(법칙성)을 추출하는 통계적인 방법으로 학습하도록 프로그래밍
- 패턴(법칙, 규칙)을 추출하여 회귀 예측(연속형 데이터), 분류 예측(범주형 데이터)하는 다양한 알고리즘이 있다.
- 적용 분야
손글씨 문자 식별, 물체 식별, 문자 분류, 음성 인식, 주식 예측, 질병 진단등 다양한 분야에 걸쳐 응용할 수 있다.
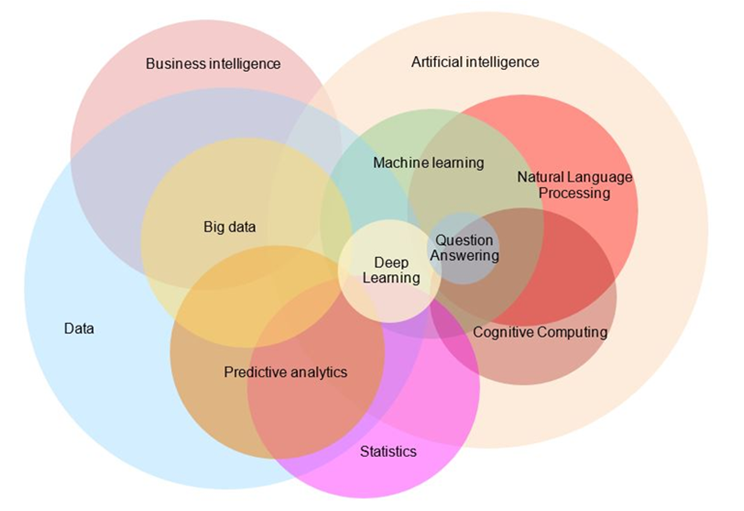
인공지능 학습 방법
지도 학습(Supervised Learning)
학습(훈련)시 정답(종속 변수, y)과 입력 데이터(독립 변수, X)를 모두 제공하는 학습 데이터로 학습하여 모델을 생성하는 학습 방법
분류(Classification)모델 : 정답( 독립변수, y )이 특정 클래스( 범주형 )로 분류하는 모델 - 이진 분류, 다중 클래스 분류 -> 모델에 의해서 분류되는 값의 개수
회귀( Regression ) 모델 : 정답( 독립변수, y )이 연속값( 연속형 )에 대한 예측 모델 - 단순 선형 회귀 모델, 다중 선형 회귀 모델, 비선형 회귀 모델 -> 회귀 모델을 생성할 때 사용한 변수의 개수, 학습 알고리즘 방법
과거의 데이터를 기반으로 실제 데이터를 공부하는 것
정답과 답을 모두 제공한다
비지도 학습 (Unsupervised Learning)
학습(훈련)시 입력 데이터(독립 변수, X)만을 학습 데이터로 제공하여 학습을 수행하고 모델을 생성하는 학습 방법 -> 정답을 찾아내는 학습방법, 데이터 전처리에 많이 사용한다
군집( Clustering ), 계층 군집( Hierarchical Clustering ) : 그룹 분류
이상치 탐지( outlier detection )
특이치 탐지( novelty detection )
시각화( visualization ) : 레이블( label, 이미지 설명 )이 없는 고차원 데이터를 2D/3D 형태로 생성
차원 축소( dimensionality reduction ) : 데이터 간소화
연관 규칙 학습( association rule learning ) : 관계 파악
- 데이터 전처리로 주로 이용한다
- 정답과 문제를 정확하게 만드는 과정
- 정답을 정할 수 없는 데이터를 정답으로 연결하는 과정
강화 학습 (Reinforcement Learning)
특정 행동에 대한 보상과 벌칙에 의하여 경험을 학습하여 모델을 생성하는 학습 방법
데이터가 없을 때 사용하는 방식
인공지능 Workflow
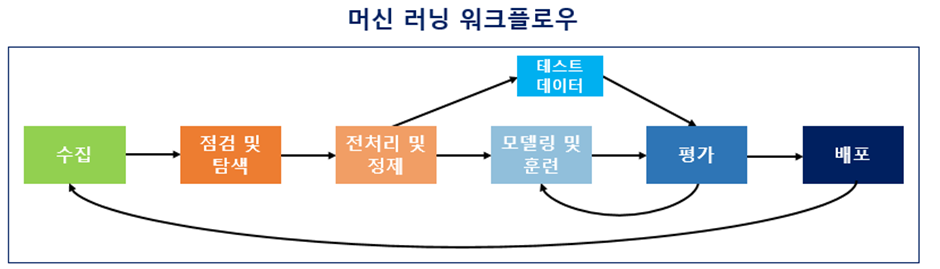
0. 문제 정의
AI를 적용할 문제 정의
AI 모델 평가 방법 결정
가장 어려운 단계이고 중요한 단계
1. 데이터 수집
문제 정의에 따른 데이터 수집(학습용 데이터 수집)
- 데이터 종류
정형 데이터 (Structured Data)
미리 정해 놓은 형식과 구조에 따라 저장되도록 구성하여 고정된 필드에 저장된 데이터
비정형 데이터 (Semi-Structured Data)
정의된 구조가 없는 동영상 파일, 오디오 파일, 사진, 보고서, 메일 본문 등과 같이 정형화되지 않은 데이터
반정형 데이터 (Unstructured Data)
데이터의 형식과 구조가 변경될 수 있는 데이터
스키마 및 메타데이터 특성을 가지고 있으며, 주로 XML, HTML, JSON 등의 파일 형태로 저장
2. 데이터 전처리
수집한 데이터에 대한 전처리 (비지도 학습을 적용하기도 한다.)
데이터에 포함되어 있는 잡음 제거
3. 데이터 탐색(EDA)
수집한 데이터 이해
문제 정의에 대한 판단
데이터를 학습하는 방법 파악 (지도/비지도/강화 학습, 머신러닝 알고리즘, 신경망)
-
학습시 사용할 입력 데이터(독립변수, 특성, feature, X)와 정답(종속 변수, label, y) 변수 결정
-
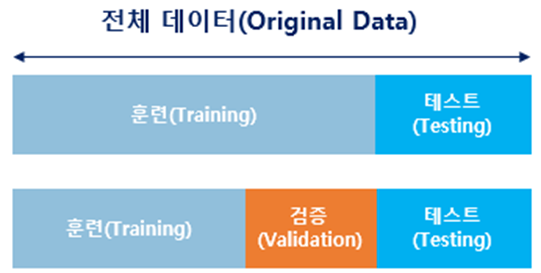
훈련용 데이터와 검증용 데이터( 전체 데이터에 대해서 70% ~ 80% ), 테스트 데이터( 전체 데이터에 대해서 30% ~ 20% )로 분리
훈련용 데이터(training data): 알고리즘이 학습할 때 사용할 데이터 (feature, label 사용)
검증용 데이터(validation data): 알고리즘이 학습하는 중간에 학습 결과를 검증(확인)하는 목적의 데이터 (feature, label 사용)
테스트 데이터(test data): 생성된 모델을 평가하는 목적의 데이터로 학습(훈련)시에 전형 사용되지 않은 데이터(feature만 사용), 최종적으로 생성된 모델을 테스트할 때 만 사용
4. 학습 알고리즘 (신경망 구조) 선택
학습(훈련)에 사용할 알고리즘 선택
여러 개의 알고리즘을 선택하여 훈련을 수행하고 결과를 평가하여 가장 좋은 평가의 알고리즘에 의해 생성된 모델을 사용한다.
5.학습 (훈련, 모델링)
- 선택된 알고리즘을 이용하여 학습(훈련) 수행 - 훈련/검증용 데이터를 이용한 학습 및 모델 평가
- 학습 결과로 AI 모델 생성
- 학습 결과에 따른 AI 모델을 평가하여 원하는 성능의 모델이 생성되지 않았다면 모델에 대한 튜닝(tuning)을 수행한다. 4번 단계부터 다시 수행한다.
AI 알고리즘에는 매개변수(model parameter)와
하이퍼 파라미터(hyper parameter, 초매개 변수)가 있다.
매개변수(model parameter): 알고리즘이 학습시 결정하는 값
하이퍼파라미터(hyper parameter): 알고리즘을 이용한 학습을 수행하기 전에 사용자에 의해 결정 되는 값모델 튜닝은 하이퍼 파라미터를 조정하는 작업을 의미한다.
AI 모델은 최적의 매개변수( model parameter ) 집합
6. 평가 (예측) - 최종 평가
생성된 모델에 대한 평가 - 테스트 데이터 사용
7. 적용 (배포)
실제 서비스에 생성된 모델 적용
8. 서비스에 사용되는 모델 모니터링
- 모델이 서비스에 적용되는 과정을 모니터링을 하여 문제 정의시 결정한 정확도의 변화가 일어나는지 확인
- 모니터링 결과에 따라 모델에 새로운 데이터를 다시 학습( 훈련 ) 하여 반영하는 방식에 따라 배치 방식 모델과 온라인 방식 모델로 구분한다.
배치 방식 모델: 기존 훈련 데이터 전체와 새로운 데이터를 합쳐서 모델을 생성하는 방식
온라인 방식 모델: 새로운 데이터에 대하여 즉시 학습을 통해 새로운 모델을 생성하는 방식
머신러닝 알고리즘 종류
머신러닝 알고리즘 : 데이터를 학습하는 방법을 정의한 것으로 결과로는 AI 모델을 생성한다.
1. 학습 알고리즘 개발 - 수학적인 지식이 많이 필요
2. 학습 알고리즘을 이용하여 AI 모델 생성 - 학습 알고리즘의 동작 과정에 대한 이해
지도 학습 알고리즘
회귀 모델 알고리즘
모델 평가 방법
-예측 정확도
-예측값과 실제값의 차이를 비율로 평가
선형 회귀 분석 기반 알고리즘
- 선형 회귀 (Linear Regression)
- 릿지 회귀 (Ridge Regression)
- 라쏘 회귀 (Lasso Regression)
- 엘라스틱넷(ElasticNet)
신경망 모델을 이용한 알고리즘
인공 신경망( Artificial Neural Network, ANN ) 이용
심층 신경망( Deep Neural Network, DNN )
분류 모델 알고리즘
모델 평가 방법
-분류 정확도
-정밀도, 정확도, f1-score등으로 평가
선형 회귀 분석 기반 알고리즘
-로지스틱 회귀 (Logistic Regression)-이진 분류
-소프트맥스 회귀 (Softmax Regression)-다중 클래스 분류
이웃 데이터 분류 알고리즘
-K-이웃 알고리즘( K-nearest Neighbors, KNN )
Tree 기반 알고리즘
-의사 결정 트리( Decision Tree )
-랜덤 포리스트( Random Forest )
비선형 알고리즘
-서포트 벡터 머신( Support Vector Machine, SVM )
Boosting 알고리즘
-앙상블 모델( Ensemble Model )
신경망 모델 알고리즘
-인공 신경망( Artificial Neural Network, ANN ) 이용
-심층 신경망( Deep Neural Network, DNN )
-합성곱 신경망( Convolutional Neural Network, CNN )
-순환 신경망( Recurrent Neural Network, RNN )
인공지능 프로그램 구조
인공지능(머신러닝/딥러닝) 프로그래밍
학습에 사용할 알고리즘과 데이터를 이용 학습을 수행하여
AI 모델(데이터를 기반으로한 자동화 모델)을 완성하는 과정
인공지능(머신러닝/딥러닝) 프로그램 구조(학습(훈련)방법) -> 지도학습
-
목표 설정
생성할 AI 모델에 대한 목표 설정 -
목표에 따른 결과를 도출할 알고리즘 선정
학습이란 가설식에 의해 도출된 예측값과 실제값의 차이를 줄이는 과정을 의미한다. -
데이터 유형
연속형 데이터-> 결과로 도출하는 AI 모델 -> 회귀 모델
ex) 연속적인 변화를 갖는 값 : 몸무게, 키
범주형 데이터-> 결과로 도출하는 AI 모델 -> 분류 모델
ex) 그룹 성격을 갖는 값 : 성별, 년도
1.가설식을 통해 가설을 세운다.
가설식( H( x ) )은 예측값을 도출하는 식
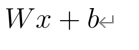
2.예측값과 실제값(실제 정답)의 차이가 기준 범위가 될 때까지 반복 → 학습(훈련)
2.1 가설식을 이용하여 예측값을 도출한다.
2.2 도출한 예측값과 실제값의 차이를 계산한다.
비용 함수(cost function), 손실 함수(loss function) -> ANN, 목적 함수(object function)
2.3 예측값과 실제값의 차이를 줄일 수 있도록 매개 변수(model parameter)를 조정한다.
옵티마이저(optimizer)
3.최종적인 모델이 완성된다.
4.완성된 모델을 평가한다.
평가 결과에 따라 1 ~ 2 과정을 반복한다.( tuning )
하이퍼파라미터 조정
5. 완성된 모델을 통한 예측(추론) 수행
매개 변수(모델 파라미터)
학습시 변경 되는 값 → 학습시 자동 결정
사용자가 변경할 수 없는 값
하이퍼파라미터
학습전에 결정해주는 값 → 사용자가 결정
tuning 대상, 알고리즘마다 하이퍼파라미터 대상에 차이가 있다.
인공지능 적용시 과제
학습 알고리즘을 선택해서 어떤 데이터를 훈련 시키는 것이므로 문제가 될 수 있는 두가지는 ‘나쁜 알고리즘'과 ‘나쁜 데이터’ 이다.
1. 충분하지 않은 양의 훈련 데이터
2. 대표성이 없는 훈련 데이터
일반화되지 않은 데이터
샘플링 잡음( sampling noise )
데이터( 샘플, sample )가 작을때
샘플링 편향( sampling bias)
아주 큰 데이터에서 표본 추출 방법이 잘못되어서 대표성이 없는 표본을 추출한 경우
3. 낮은 품질의 데이터
학습 데이터에 에러, 이상치( outlier ), 잡음이 가득하다면 머신러닝이 내재된 패턴을 찾기 어려우므로 생성된 모델이 잘 작동하지 않는다.
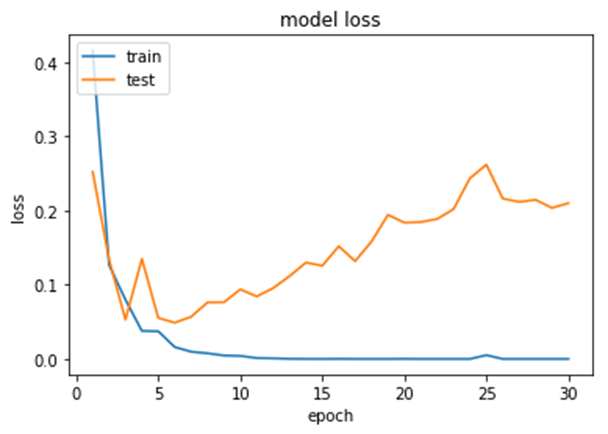
4. 훈련 데이터에 대한 과대 적합( overfitting )
과대 적합( overfitting )
생성된 모델이 훈련 데이터에 너무 잘 훈련이되어 훈련에 사용하지 않는 데이터에 대해서는 제대로 예측을 수행할 수 없는 모델. 즉 일반성이 떨어진 모델이 생성되었다는 의미
과대 적합이 일어나는 경우는 데이터 양이 적거나, 모델이 아주 복잡하거나 아주 단순하거나 한 경우에 발생
5. 훈련 데이터에 대한 과소 적합( underfitting )
과소 적합( underfitting )
알고리즘이 너무 단순해서 데이터에 내재된 구조를 학습하지 못할 때 발생
강력한 알고리즘을 사용하거나 좋은 특성의 데이터를 사용한다.