데이터 구조
💡여러 데이터를 효과적으로 사용 관리하기 위한 구조 (str , list , dict 등)
1. 자료구조
- 컴퓨터 공학에서는 자료 구조 라고 한다.
- 각 데이터의 효율적인 저장, 관리를 위해 구조를 나눠 놓은 것이다.
- 데이터를 묶는 것을 넘어서, 프로그램 성능과 효율성, 유지보수성에 큰 영향을 미치는 개념이다.
2. 메서드
프로그래밍에서 메서드(Method)는 객체가 특정 작업을 수행하도록 정의된 함수이다.
- 문자열, 리스트, 딕셔너리 등 각 데이터 구조의 메서드를 호출하여 다양한 기능을 활용 할 수 있다.
- 클래스 내부에 정의 되는 함수이다.
메서드 호출 예시
# 문자열 메서드 예시
print("hello".capitalize()) # Hello

# 리스트 메서드 예시
numbers = [1, 2, 3]
numbers.append(4) # 4추가

print(numbers) # [1, 2, 3, 4]
공통 시퀀스 메서드 예시
# 시퀀스에서 첫 번째로 일치하는 항목의 x의 인덱스를 반환한다.
text = "banana"
print(text.index("a")) # 1

my_list = [1, 2, 3]
print(my_list.index(2)) # 1
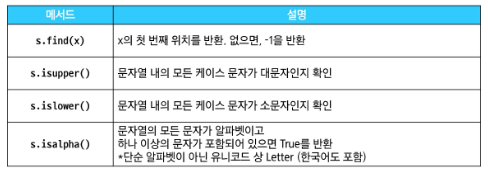
문자열 탐색 및 검증 메서드
문자열 조작 메서드
replace(old, new[, count]): 기존 문자열에서old라는 부분 문자열이new로 모두 바뀐 문자열을 반환한다.
text = "Hello, world! worldworld"
nex_text1 = text.replace("world", "Python")
nex_text2 = text.replace("world", "Python", 1)

print(nex_text1) # Hello, Python! Python Python
print(nex_text2) # Hello, Python! world worldstrip([chars]): 선행과 후행 문자가 제거된 문자열의 복사본을 돌려준다.chars인자는 제거할 문자 집합을 지정하는 문자열이다.split(sep=None, maxsplit=-1)- 문자열을 지정한 구분자(
sep)를 기준으로 나누어 리스트(list)를 반환한다. - 구분자를 지정하지 않으면 공백(띄어쓰기, 탭, 줄바꿈)을 기준으로 분리한다.
- 문자열을 지정한 구분자(
# 사용자 입력 등에서 불필요한 공백이 포함된 경우
text = "              Hello       Wolrld      "

# 1. 아무것도 지정하지 않으면 공백(띄어쓰기, 탭, 엔터)을 제거
clean_text = text.strip()

print(clean_text) # "Hello       Wolrld" -> 문자열 중간의 공간은 제거되지 않는다.

# 2. 제거할 문자를 지정하는 경우
# 지정한 문자를 기준으로 엄격하게 분리한다 -> 빈 문자열 발생 가능하다.
data = "10, 20, , 30"
print(data.split(",")) # ["10", "20", "", "30"]

# 3. 분할 횟수 제한
# 앞에서부터 1번만 자르고, 나머지는 그대로 둔다.
path = "User/admin/documents"
print(path.split("/", maxsplit = 1)) # ["User", "admin/documents"]
join (iterable): 반복 가능한 문자열을 연결한 문자열을 반환한다.
words = ["Python", "is", "easy"]

sentence1 = " ".join(words)
sentence2 = "-".join(words)

print(sentence1) # Python is easy
print(sentence2) # Python is-easy
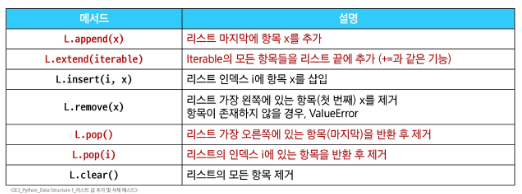
리스트 값 추가 및 삭제 메서드
💡
insert주의사항!!!!list = [1, 2, 3] list.insert(-1, 5) # 음수를 넣으면 -1 인덱스를 탄다 print(list) # [1, 2, 5, 3]
3. 객체와 참조
가변/불변 객체의 개념
가변 객체: 생성 후 내용을 변경할 수 있는 객체이다.
ex) list, dict, set
불변 객체: 생성 후 내용을 변경할 수 없는 객체이다.
ex) int, float, str, tuple
변수 할당의 의미
“
=” 연산자를 사용하여 변수에 값을 할당한다.
→ 할당 시 새로운 객체가 생성되거나 기존 객체에 대한 참조가 생성된다.
가변 객체 예시
a = [1, 2, 3, 4]
b = a
b[0] = 100

print(a) # [100, 2, 3, 4]
print(b) # [100, 2, 3, 4]
print(a is b) # True
불변 객체 예시
a = 20
b = a
b = 10

print(a) # 20
print(b) # 10
print(a is b) # False
얇은 복사
객체의 최상위 요소만 새로운 메모리에 복사하는 방법이다.
내부에 중첩된 객체가 있다면 그 객체의 참조만 복사된다.
리스트 슬라이싱: [:]은 원본 리스트와 동일한 내용의 새로운 리스트를 생성한다.
a = [1, 2, 3]
b = a[:]

print(a) # [1, 2, 3]
print(b) # [1, 2, 3]
print(a is b) # False
copy 메서드: .copy()는 원본 리스트와 동일한 내용을 가진 새로운 리스트 객체를 반환한다.
a = [1, 2, 3]
b = a.copy

print(a) # [1, 2, 3]
print(b) # [1, 2, 3]
print(a is b) # False
list 함수
a = [1, 2, 3]
b = list(a)

print(a) # [1, 2, 3]
print(b) # [1, 2, 3]
print(a is b) # False
얉은 복사의 한계
- 2차원 리스트와 같이 변경 가능한 객체 안에 변경 가능한 객체가 있는 경우
- a와 b의 주소는 다르지만 내부 객체의 주소는 같기 때문에 함께 변경된다.
1차원 리스트와 다차원 리스트에서의 차이점
- 1차원 리스트: 얉은 복사로 충분히 독립적인 복사본을 만들 수 있다.
- 다차원 리스트: 최상위 리스트만 복사되고, 내부 리스트는 여전히 원본과 같은 객체를 참조한다.
깊은 복사
객체의 모든 수준의 요소를 새로운 메모리에 복사하는 방법이다.
중첩된 객체까지 모두 새로운 객체로 생성된다.
copy 모듈에서 제공하는deepcopy()함수를 사용한다.
origin = {
	"a" : [1, 2, 3],
	"b" : {"c" : 4, "d" : [5, 6]},
}
copied = copy.deepcopy(origin)

print(f"원본: {origin}") # {"a" : [1, 2, 3], "b" : {"c" : 4, "d" : [5, 6]}}
print(f"원본: {copied}") # {"a" : [1, 100, 3], "b" : {"c" : 4, "d" : [500, 6]}}
print(f"origin["b"]와 copied["b"]가 같은 객체인가? {origin["b"] is copied["b"]}") # False
참고
1. List Comprehension
리스트를 쉽게, 짧게 한 줄로 만들 수 있는 파이썬의 문법이다.
활용 예시
[표현식 for 변수 in 순회 가능한 객체 if 조건]
# if 조건은 선택 사항!
사용 전/후 비교
# 사용 전
numbers = [1, 2, 3, 4, 5]

result = []

for number in numbers:
    result.append(number * 2)

print(result) # [2, 4, 6, 8, 10]

# 사용 후
numbers = [1, 2, 3, 4, 5]

result = [number * 2 for number in numbers]

print(result) # [2, 4, 6, 8, 10]
2. 메서드 체이닝
여러 메서드를 연속해서 호출하는 방식이다.
text = "Heelo, Wolrd"
step1 = text.swapcase()
print("스탭1: ", step1) # hELLO wORLD

step2 = step1.replace("L", "Z")
print("스탭2: ", step2) # hEZZO wORZD
메서드 체이닝의 흔한 실수
# sort()는 None을 반환하므로, 변수에 아무것도 저장하지 않는다.
result = numbers.copy.sort()
print(result) # None

# 해결법
# 내장 함수sorted() 사용, 정렬된 새로운 리스트를 반환하므로 변수에 할당이 가능하
result = sorted(numbers)
print(result) # [1, 1, 2, 3, 4, 5, 9]
#===================================================================================================
# append()가 반환한 None 뒤에 메서드를 이을 수 없다.
numbers.append(7).extend([8, 9]) # AttributeError "NoneType" object has no attribute "extend"
정리
핵심 키워드
| 개념 | 설명 | 예시 |
|---|---|---|
| 자료 구조 (Data Structure) | 데이터를 효율적으로 저장·관리하기 위한 형식 | 리스트, 문자열 등 |
| 시퀀스 (Sequence) | 순서를 유지하고 인덱스로 요소에 접근 가능 | "abc"[1] → 'b' |
| 문자열 (str) | 불변(Immutable) 문자열 시퀀스 | "Hello".upper() → "HELLO" |
| 리스트 (list) | 순서가 있고 가변(Mutable)인 시퀀스 | lst = [1,2]lst.append(3) → [1,2,3] |
| 불변 객체 (Immutable) | 내부 값 변경 불가, 연산 시 새 객체 생성 | id("a"+"b") ≠ id("ab") |
| 가변 객체 (Mutable) | 내부 값 직접 변경, 참조는 유지 | id(lst)는 append() 전후 동일 |
| 얕은 복사 (Shallow Copy) | 최상위만 새 메모리, 내부 객체는 참조 공유 | lst2 = lst[:] |
| 깊은 복사 (Deep Copy) | 모든 중첩 레벨까지 새 객체 생성 | copy.deepcopy(obj) |
| 리스트 컴프리헨션 | [expr for x in iterable if 조건] 형식으로 간결·효율적 리스트 생성 | [x**2 for x in range(5) if x%2] |
| 메서드 체이닝 | 객체를 반환하는 메서드를 연속 호출 | "Hello".swapcase().replace('e','E') |
백엔드를 학습하는 주니어 개발자입니다.