
Interpreting A/B test results: false positives and statistical significance
이전 넷플릭스의 A/B 테스트의 결과로 유의미한 지표가 나타나면 해당 기능이 적용될 가능성이 높아진다. 하지만, 해당 테스트 결과를 통해 올바른 결정을 내렸는지 어떻게 알 수 있을까? 이러한 결정을 내릴때 불확실성과 실수 가능성을 완전히 없앨 수 없다는 것을 인지해야한다.
테스트의 결과에서 두 가지 유형의 오류가 발생할 수 있다.
오류 유형 2가지
1. 제 1종 오류(거짓양성)
  - 테스트 결과는 차이가 있지만 실제로 차이가 없음
  - ex) 코로나가 아닌데 양성 반응이 나오는 것과 같음
2. 제 2종 오류(거짓음성)
    - 테스트 결과로 차이가 없지만 실제로 차이가 있음
- ex) 코로나가 걸렸지만 음성이 나옴.- 머신러닝을 통한 인사이트
- 이미지 학습을 통해 고양이 / 강아지 판별
- 개 혹은 개아님 두가지 결정이 있으며, 두 가지 진실과 거짓이 결과로 나타난다.
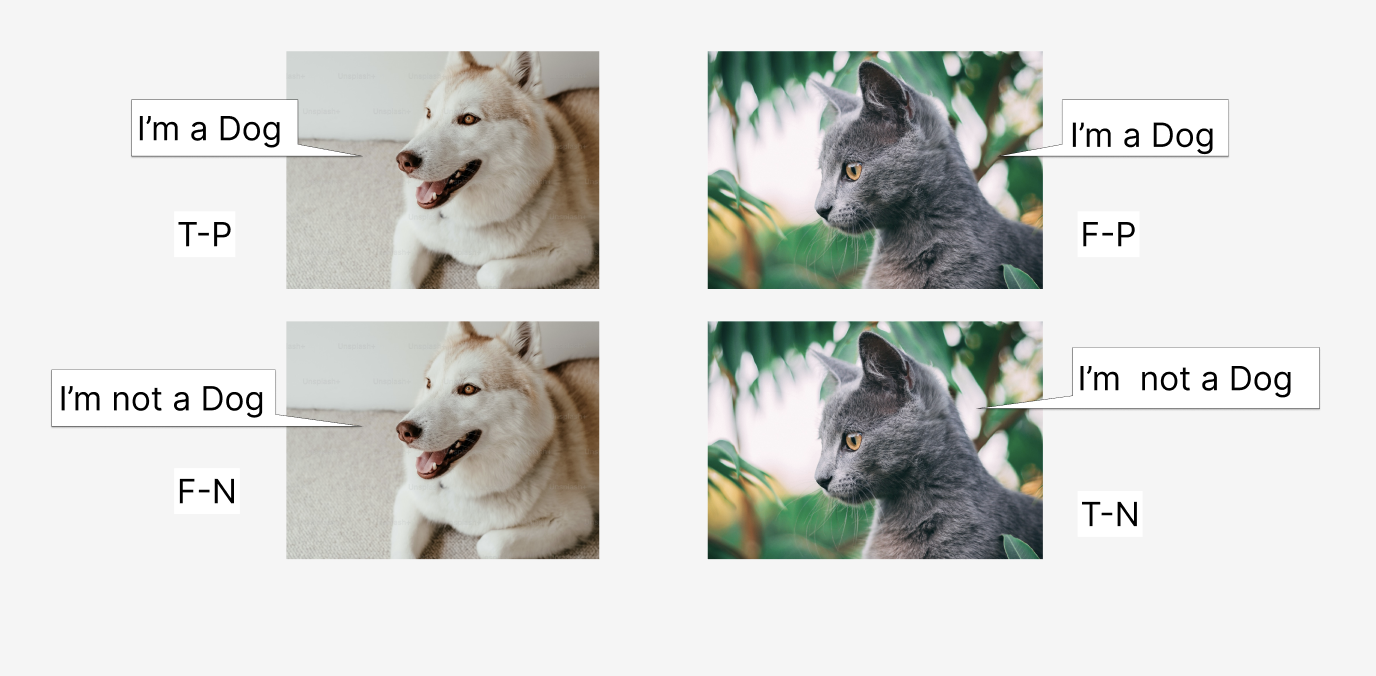
- True Positive는 예측값이 0인데 (Positive), 실제값도 1이라서 맞은 경우 (True)
- False Positive는 예측값이 0인데 (Positive), 실제값은 1이라서 틀린 경우 (False)
- True Negative는 예측값이 1인데 (Negative), 실제값도 1이라서 맞은 경우 (True)
- False Negative는 예측값이 1인데 (Negative), 실제값은 0이라서 틀린 경우 (False)
- A/B 테스트도 마찬가지
- "탑10 목록이 회원 만족도에 영향을 미친다는 결론을 내릴 수 있는 충분한 증거 있음" or "증거 불충분”
- 알 수 없는 진실 : “탑10 목록이 실제로 회원 만족도에 영향을 미친다" or "그렇지 않다”
- 거짓 긍정 & 거짓 부정 -> 둘 다 사라지게 할 순 없다. 두 오류 원인을 수량화, 이해, 제어하는 것이 목표
거짓 양성과 거짓 음성은 둘 다 완전히 없앨 수 없고 둘은 상충 관계에 있다. 거짓 양성의 비율이 낮아지면 거짓 음성의 비율이 증가하게 되고, 그 반대도 마찬가지이다. 실제로는 두 종류의 오류를 양적화하고 이해하며 통제하는 것이 목표이다.
거짓 긍정 및 통계적 유의성
5%유의수준이란?
    - 5%의 실수 가능성
    - 위양성률(거짓긍정)은 p-value 값의 통계적 유의성과 밀접
    - 새로운 제품 경험으로 인해 UI 기능 클릭부터 유지에 이르기까지 일부 바이너리 사용자 활동에 대해 다른 비율이 발생하는지
동전 던지기
앞면이 나올 확률이 0.5(또는 50%)가 아니라는 가정, 동전이 불공정한지 알고 싶다고 가정
- 동전 던지기가 불공정한지 결정하기 위해 실험수행
- 동전을 100번 뒤집고 앞면이 나오는 결과의 비율을 계산
- 무작위성 또는 "노이즈"로 인해 동전던지기 결과가 완벽하게 공평하더라도 정확히 50개의 앞면과 50개의 뒷면이 나올 것으로 예상하지는 않는다.
- 하지만 50에서 얼마나 벗어나는 것이 '너무 많은' 것일까?
- 동전이 실제로 공정하다는 주장을 부정할 수 있는 충분한 증거는 언제 확보될까?
- 100번 던지기 중 60번이 앞면이면 동전이 불공평하다고 결론을 내릴 수 있을까?
동전 던지기 공정하다 가정
- 항상 현상 유지 or 평등 ⇒ 귀무가설
- 귀무가설이 참이라는 가정하에 모든 결과의 확률 계산
- 동전이 공정하단 가정 하, 100번을 던져 앞면이 0개, 앞면이 1개, 앞면이 2개 등 최대 100개가 나올 확률
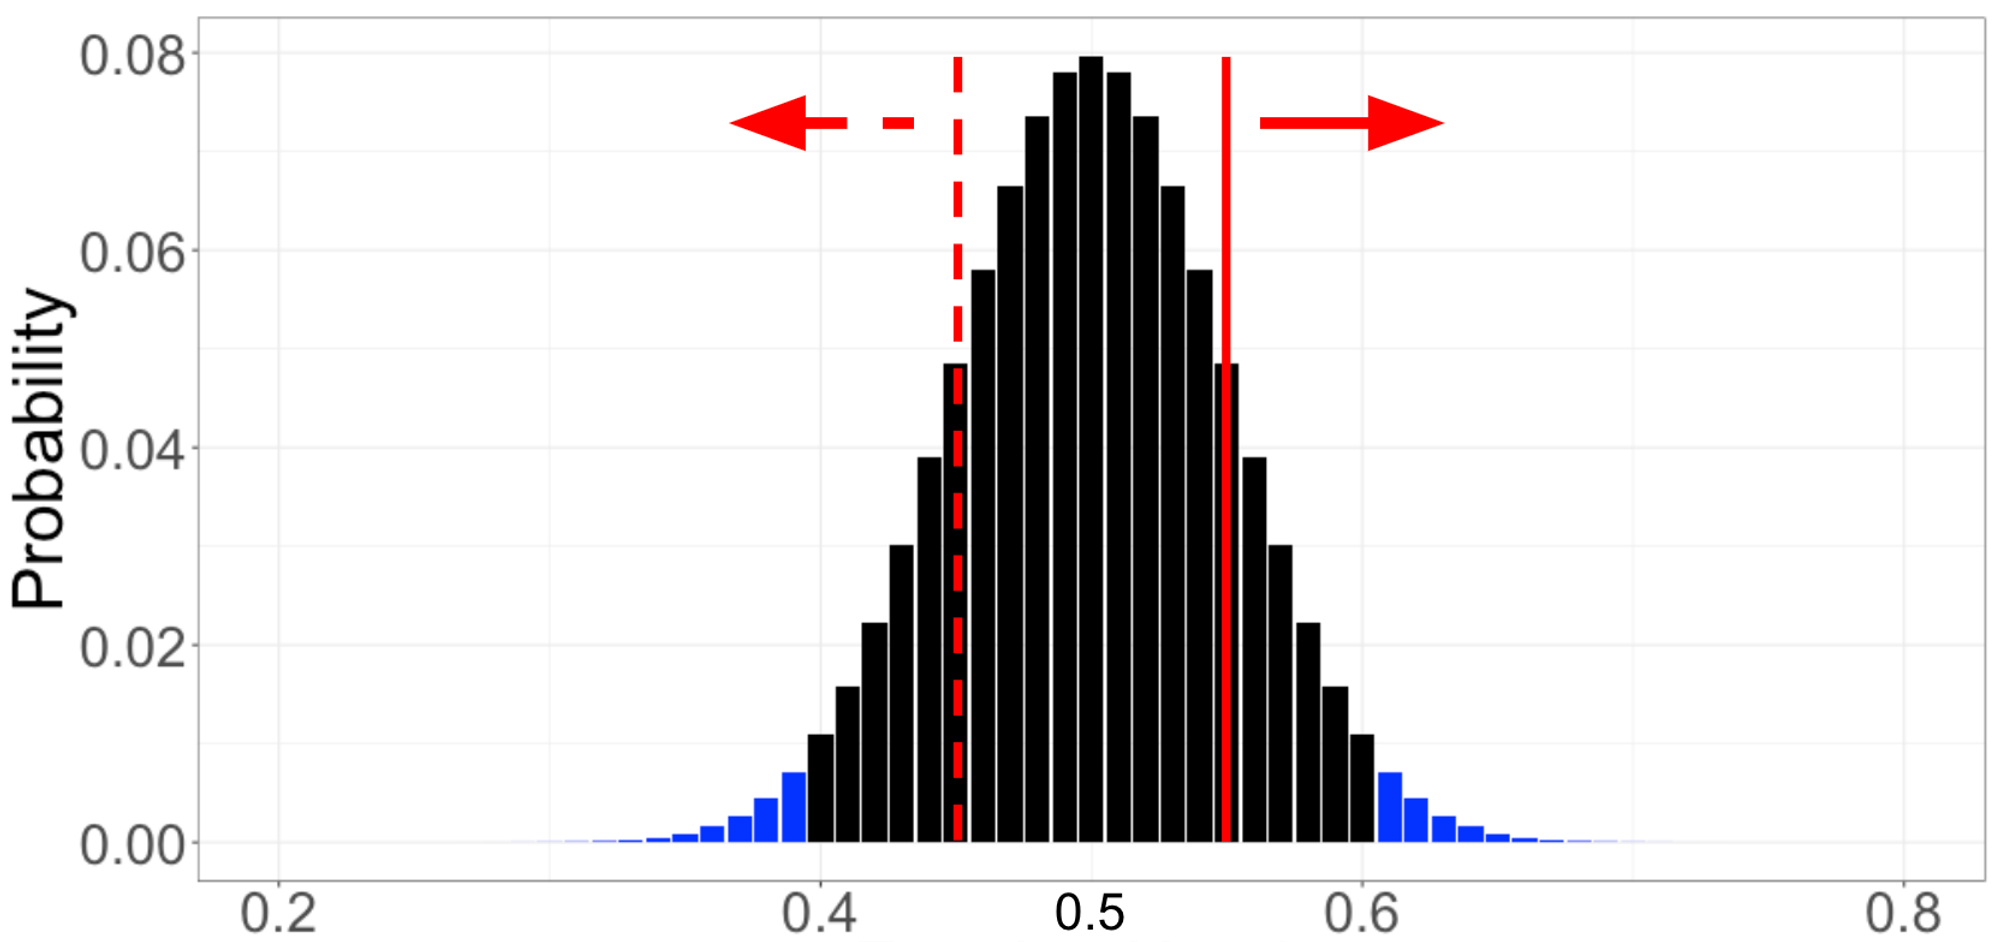
- 계산된 결과의 확률분포를 수집한 데이터와 비교
- 100번 중 55%가 앞면이라 가정(빨간 실선) ← 해당 관찰이 동전이 공정하지 않다는 증거인지 정량화 하기 위해서 관찰보다 가능성이 낮은 모든 결과와 관련된 확률 계산
- 앞면 또는 뒷면이 나올 가능성 가정을 하지 않았기 때문에 앞면이 나올 확률의 55%이상의 확률과 55의 확률로 계산 → 빨간색 점선
⇒ 귀무가설이 참일 경우 우리의 관찰만큼 극단적 결과가 나타날 확률
⇒ 귀무가설 : 동전이 공정. 100번 던질 때 앞면이 55%. p-value = 0.32
⇒ 동전을 100번 던져 앞면이 나오는 비율을 계산하는 실험을 공정한 동전(귀무 참)으로 여러 번 반복하면, 32% 유의하다. (최소 55%앞, 55%뒤 )
거부영역과 신뢰구간
거부영역
테스트 결과의 해석의 또 다른 방법은 '거부영역'을 기준으로 하는 것이다. 거부 영역은 동전 던지기가 공정하지 않다고 결론내릴 값들의 집합이다. 해당 거부영역을 계산하기위해 귀무가설이 참(동전은 공정하다)이라 가정하고, 거부영역을 0.005를 합계한 확률로 정의한다. 거부영역은 귀무가설이 참이라는 가정하 가장 극단적 결과로 이루어졌으며, 증거가 가장 강한 결과이다. 결과 값이 거부 영역에 속하면 동전이 공정하지 않다는 것이 통계적으로 유의미한 증거라고 결론을 내리고 귀무가설을 '거부'할 수 있다. 동전 던지기 실험에서 거부영역은 앞면이 40%미만 또는 60%초과 관찰될 경우 해당한다. 파란색 막대
거부영역과 p-value는 동등성이 있으며, 동일한 결론을 낼 수 있다.
신뢰구간
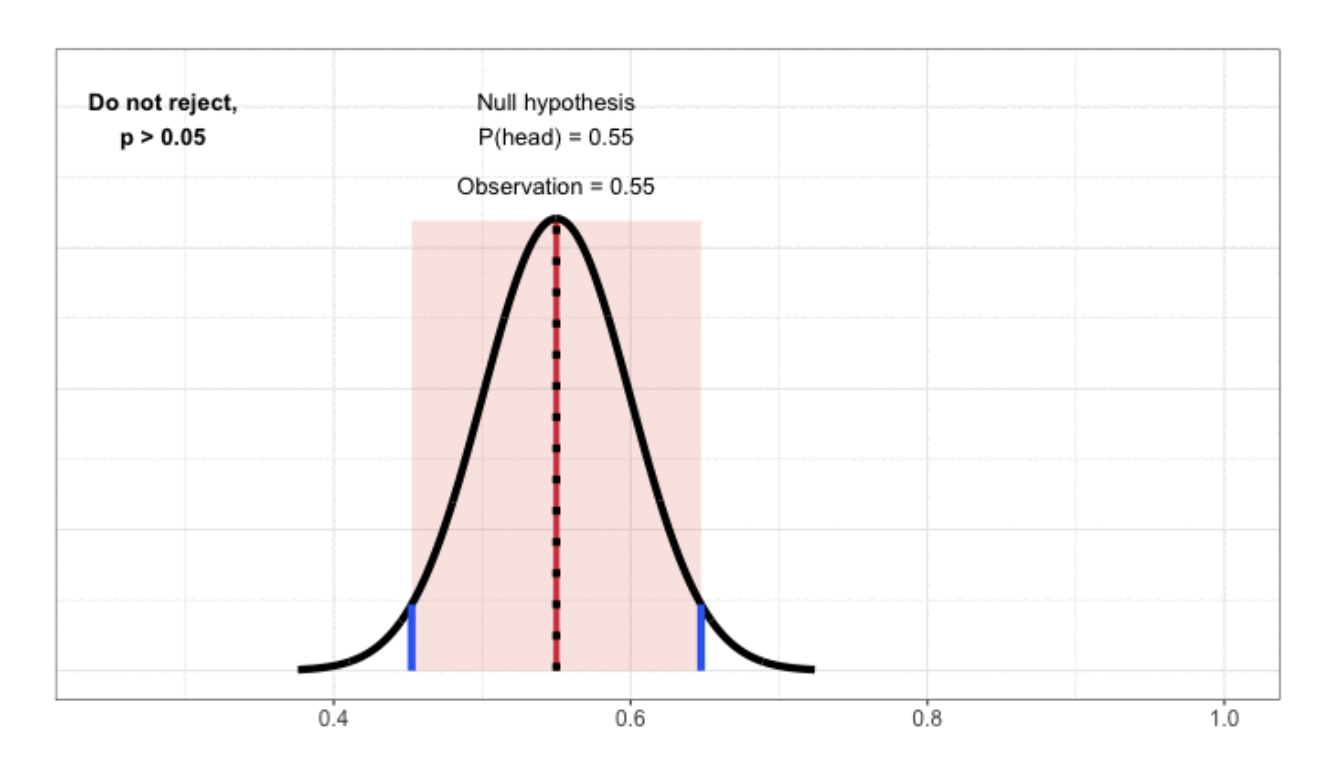
귀무가설은 변화나 동등성에 관한 이야기이다("동전은 공정하다", " 제품 변화는 회원의 만족도에 영향을 미치지 않는다"). 이 귀무가설에 따른 결과를 정의하고 관찰 값을 해당 분포와 비교했다. 신뢰구간은 반대로 생각하면 이해하기 쉽다. 동전던지기에서 관찰된 결과가 100회 던져 55%의 앞면을 관찰하고 동전이 공정하지 않다는 귀무가설을 기각하지 않았다. 47.5%, 50%, 60% 확률로 앞면이 나올 귀무가설을 거부하지 않을 것이다. 공정한 동전에 대한 귀무가설을 기각하지 않을 값들 범위는 대략 45%~65%의 앞면 확률이다.
귀무가설에 따라 결정을 내리지 않을 값의 범위가 신뢰구간이다. 5% 유의수준의 테스트로 구간을 지정했기에 95% 신뢰구간을 생성한다. 반복된 실험에서 신뢰구간이 실제값(앞면의 실제 확률)을 95% 확률로 포함할 것이라는 것이다.
신뢰구간과 p-value에서도 동등성이 있으며, 동일한 결론을 낸다.
95% 신뢰구간이 귀무가설을 포함하지 않는 경우에만 p-value값이 0.05보다 작으며, 두 가지 모두 동등하다는 가설을 기각한다.
동전 던지기를 통해 거짓 양성, 통계적 유의, p-value, 거부영역, 신뢰구간에대해 알아 보았다. 이런 개념들은 A/B테스트에서 기존버전과 변형된 버전을 비교하는데 적용할 수 있다. 우리는 "B"버전이 유저의 만족도에 영향을 미치지않는다고 가정하고 실험을 진행한다. 차이가 없다는 전제에서 기존버전과 변형버전간 결과값 차이와 그 확률을 분포와 비교하고 p-value값을 계산해 테스트 결과에 적용할 수 있다. 동전 예제와 같이 거부 영역과 신뢰구간 또한 계산가능하다.
거짓양성은 테스트 결과에 대해 결정을내릴 때 나타날 수 있는 두가지 오류 중 하나일 뿐이다. 다음에는 다른 유형의 오류, 거짓음성, 검정력에대해 알아볼 예정이다.
출처 : Netflix Technology Blog
