프로젝트에서 AI 운영이랑 설계 전반을 맡으면서 작성하는 AI 관련 회고입니다.

일을 더 쪼개기로 했다
이번 글은 특정 프로젝트의 구현 방식보다는, LLM 시스템을 설계하면서 어떤 의사결정을 하게 되었는지에 대한 이야기다.
LLM은 정말 빠르게 발전하고 있다. 그래서 LLM 시스템을 설계하다 보면 생각보다 자주 이런 유혹에 빠지게 된다.
"이것도 LLM이 할 수 있지 않을까?"
처음에는 나도 그렇게 생각했다.
개념을 추출하고, 근거를 모으고, 중요도를 계산하고, 링크를 만들고, 중복을 제거하고, 최종 결과물을 생성하는 것까지 전부 LLM에게 맡기려고 했다.
당시에는 꽤 자연스러운 접근이라고 생각했다. 모델은 점점 똑똑해지고 있고, 컨텍스트 길이도 계속 늘어나고 있었으니까. 그런데 실제로 시스템을 만들어보기 시작하니 생각보다 잘 동작하지 않았다. 원하는 결과가 한 번에 나오지 않았고, 같은 입력을 주더라도 결과가 조금씩 달라졌다.
대표적으로 이런 문제가 반복해서 발생했다.
- 비슷한 근거를 과도하게 수집한다.
- 중요도를 매번 다르게 계산한다.
- 구조적 제약 조건을 안정적으로 지키지 못한다.
- 출력 형식이 조금씩 흔들린다.
- 자료에 존재하지 않는 정보를 가져온다.
처음에는 프롬프트 문제라고 생각했다. 그래서 설명을 더 길게 작성하고, 규칙도 계속 추가했다. 제약 조건도 더 늘려봤다. 하지만 결과는 좋아지지 않았고, 오히려 시스템은 점점 더 불안정해졌다.
그렇게 실험을 하다 보니 한 가지 결론에 도달했다.
문제는 프롬프트가 아니라 역할 자체에 있는 게 아닐까?
그렇다면 LLM은 무엇을 잘할까?
개인적으로는 LLM이 문맥을 이해하고 요약하는 작업에 강하다고 느꼈다.
예를 들면,
- 핵심 내용을 요약하기
- 중요한 개념을 추출하기
- 여러 문장을 하나의 주장으로 정리하기
- 사람이 읽기 쉬운 설명을 생성하기
이런 작업은 꽤 잘 수행했다. 반면 아래와 같은 작업은 일관성이 떨어졌다.
- 개수 세기
- 중복 제거
- 복잡한 출력 형식 강제
- 규칙 기반 검증
- 모호한 설명만으로 수행해야 하는 작업
그때부터 역할을 다시 분리하기 시작했다.
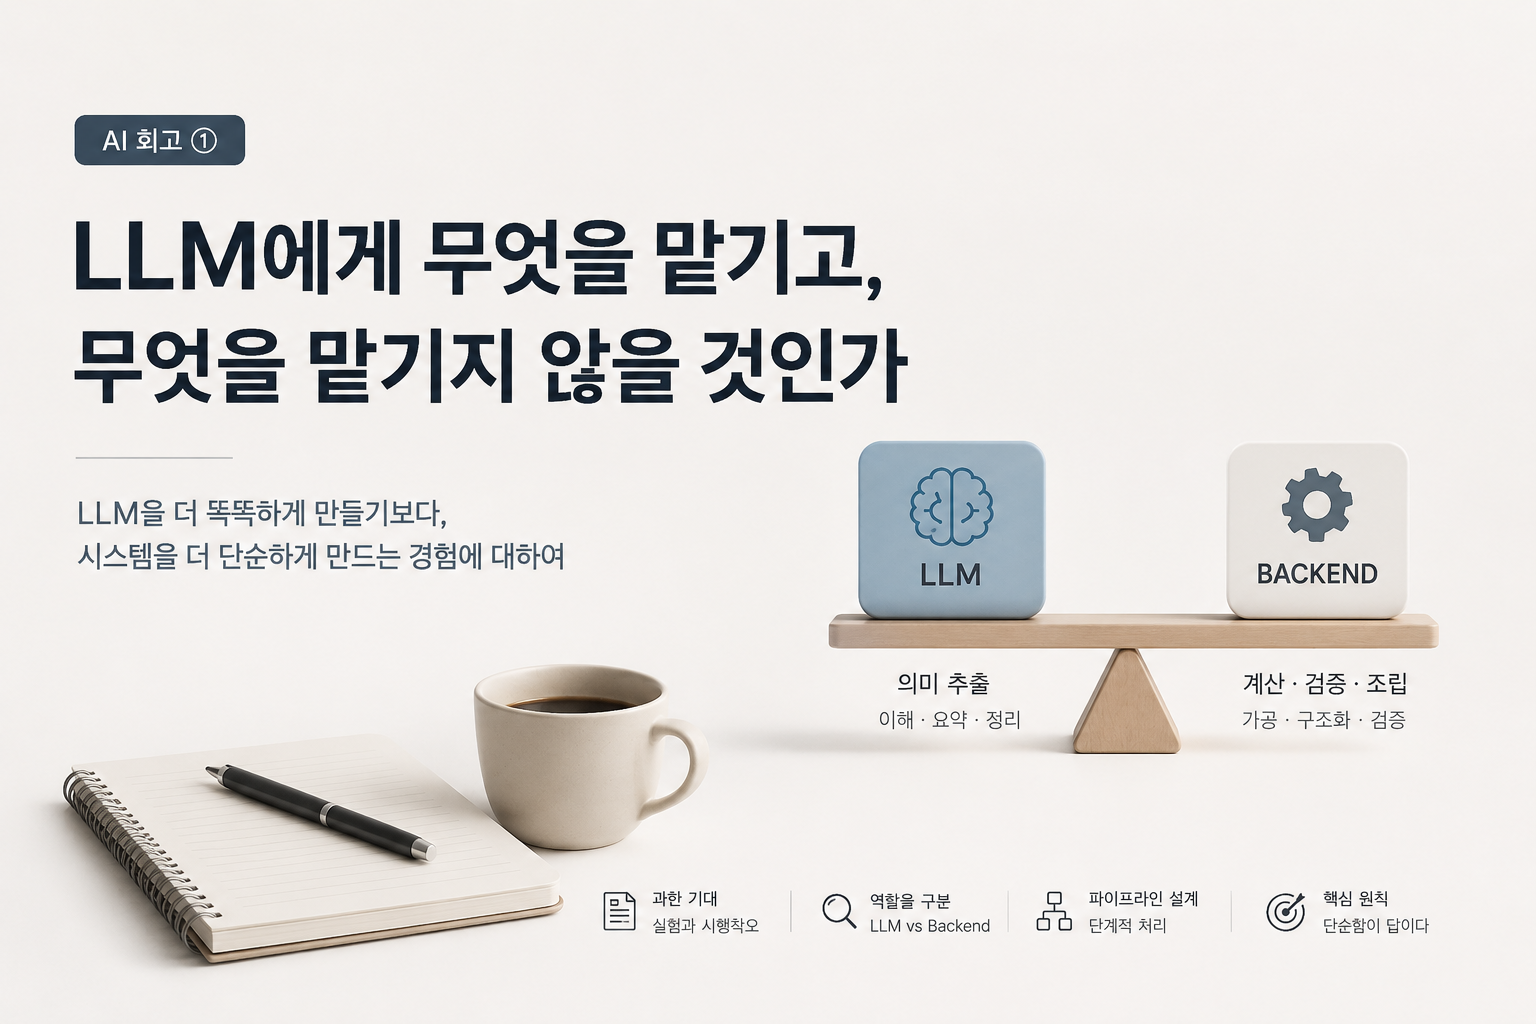
LLM = 의미를 추출하고 요약 및 정리하는 역할

Backend = 계산, 데이터 가공, 출력 구조화를 담당하는 역할
쉽게 말하면, LLM은 의미를 추출하고 Backend는 결과를 검증하고 조립한다. 생각보다 이 차이가 원하는 결과를 만들어내는 데 굉장히 중요했다.
그리고 한 가지 재미있는 사실도 발견했다. 구조적 정확성을 LLM에게 강하게 요구할수록 오히려 품질이 떨어졌다. 처음에는 더 많은 규칙이 더 좋은 결과를 만들 거라고 생각했다. 하지만 실제로는 정반대였다. 규칙이 늘어날수록 시스템은 더 불안정해졌다. 지키던 규칙을 지키지 않거나, 하나씩 누락하기 시작했다.
LLM을 더 똑똑하게 만드는 것보다, LLM이 해야 하는 일을 줄이는 게 더 중요하지 않을까?
라는 생각을 하게 되었다.
그럼 LLM이 하지 않는 일은 누가 해야 할까?
LLM의 역할을 줄이기 시작하면서 자연스럽게 하나의 질문이 생겼다.
그렇다면 나머지 작업은 누가 해야 할까?
처음에는 문서를 한 번에 이해하고 최종 결과물까지 한 번에 생성하는 구조를 생각했다. 하지만 문서의 크기가 커질수록 이 방식은 금방 한계에 부딪혔다. 오히려 문서 전체를 완벽하게 이해하려는 시도 자체가 잘못된 접근이라는 생각이 들었다.
그래서 문제를 조금 다르게 정의하기 시작했다.
우리가 해야 하는 일은 문서를 이해하는 것이 아니라,
문서의 각 부분에 쉽게 접근할 수 있도록 만드는 것
에 가깝다.
다시 말해,
문서를 이해하는 것이 아니라 문서에 주소를 붙이는 작업에 더 가깝다
그래서 다음과 같은 플로우를 생각했다.
원문

↓

분해

↓

조각화

↓

의미 추출

↓

조립
여기서 중요한 것은 한 번에 모든 작업을 LLM만으로 수행하려고 하지 않는 것이다.
각 단계마다 중간 결과물을 남기고, 다음 단계는 이전 단계의 결과를 기반으로 동작하도록 구성했다.
이렇게 하니 여러 장점이 생겼다.
- 일부 작업만 다시 실행할 수 있다.
- 실패한 부분만 재처리할 수 있다.
- 결과를 검증하기 쉬워진다.
- 전체 시스템의 흐름을 파악하기 쉬워진다.
그리고 자연스럽게 Agent를 사용하지 않게 되었다
요즘 AI 시스템을 이야기하면 자연스럽게 Agent 이야기가 나온다. 하지만 모든 시스템이 Agent일 필요는 없다고 생각한다. 오히려 너무 이른 시점에 Agent를 도입하면 복잡도만 증가할 수도 있다.
내가 가장 중요하게 생각했던 질문은 이것이다.
다음 행동은 누가 결정하는가?
만약 LLM이 스스로 다음 행동을 선택한다면 Agent에 가깝다. 하지만 이번 시스템은 그렇지 않았다.
실행 순서는 이미 정해져 있었다.
입력

↓

추출

↓

정규화

↓

병합

↓

조립

↓

저장
LLM은 그 안에서 의미를 추출하는 역할만 수행한다. 다음 단계에서 무엇을 해야 하는지는 Backend가 결정한다. 결국 이 구조는 Agent보다는 Pipeline에 더 가깝다. 그리고 개인적으로는 초기에 이 선택을 한 것이 꽤 중요했다고 생각한다.
Pipeline의 장점은 명확하다.
- 디버깅하기 쉽다.
- 실패 지점을 찾기 쉽다.
- 재실행하기 쉽다.
- 비용을 예측하기 쉽다.
무엇보다 시스템의 제어권이 개발자에게 남아있다. 그래서 오히려 원하는 결과를 만들기가 더 쉬웠다.
역시 다시 기본으로 돌아가는 것 같다
새로운 기능을 추가할 때마다 가장 먼저 하는 질문이 있다.
이 일을 더 잘게 쪼갤 수 있는가?
그리고 이렇게 이어진다.
쪼개진 일은 의미를 판단하는 일인가, 아니면 계산하는 일인가?
의미를 판단하는 일이라면 LLM에게 맡긴다. 계산하거나 검증하는 일이라면 코드로 해결한다. 생각보다 이 기준 하나만 세워도 시스템은 훨씬 단순해졌다.
물론 내가 사용한 모델의 한계도 있었을 수 있다.
이번 프로젝트에서는 비용을 고려해 Solar Pro 2를 사용했다.
더 넓은 컨텍스트와 높은 추론 성능을 가진 최신 모델이었다면 다른 결과가 나왔을 수도 있다. 혹은 내가 프롬프트를 충분히 잘 작성하지 못했을 수도 있다.
하지만 실제 프로젝트에서는 언제나 비용이라는 현실적인 제약이 존재한다. 그리고 그 안에서 최선의 선택을 해야 한다.
도구의 한계를 억지로 극복하려 하기보다, 도구가 잘하는 일을 맡기는 것이 더 중요하다.
이번 작업을 하면서 이걸 뼈저리게 느꼈다.
LLM을 더 똑똑하게 만들려고 애쓰기보다, 시스템 자체를 쪼개서 일을 더 단순하게 만드는 것이 훨씬 효과적이었다.
앞으로도 AI 관련 설계를 하면서 비슷한 고민을 계속하게 될 것 같다.