프로젝트를 하면서 의사결정의 일부를 회고 형태로 작성했습니다.

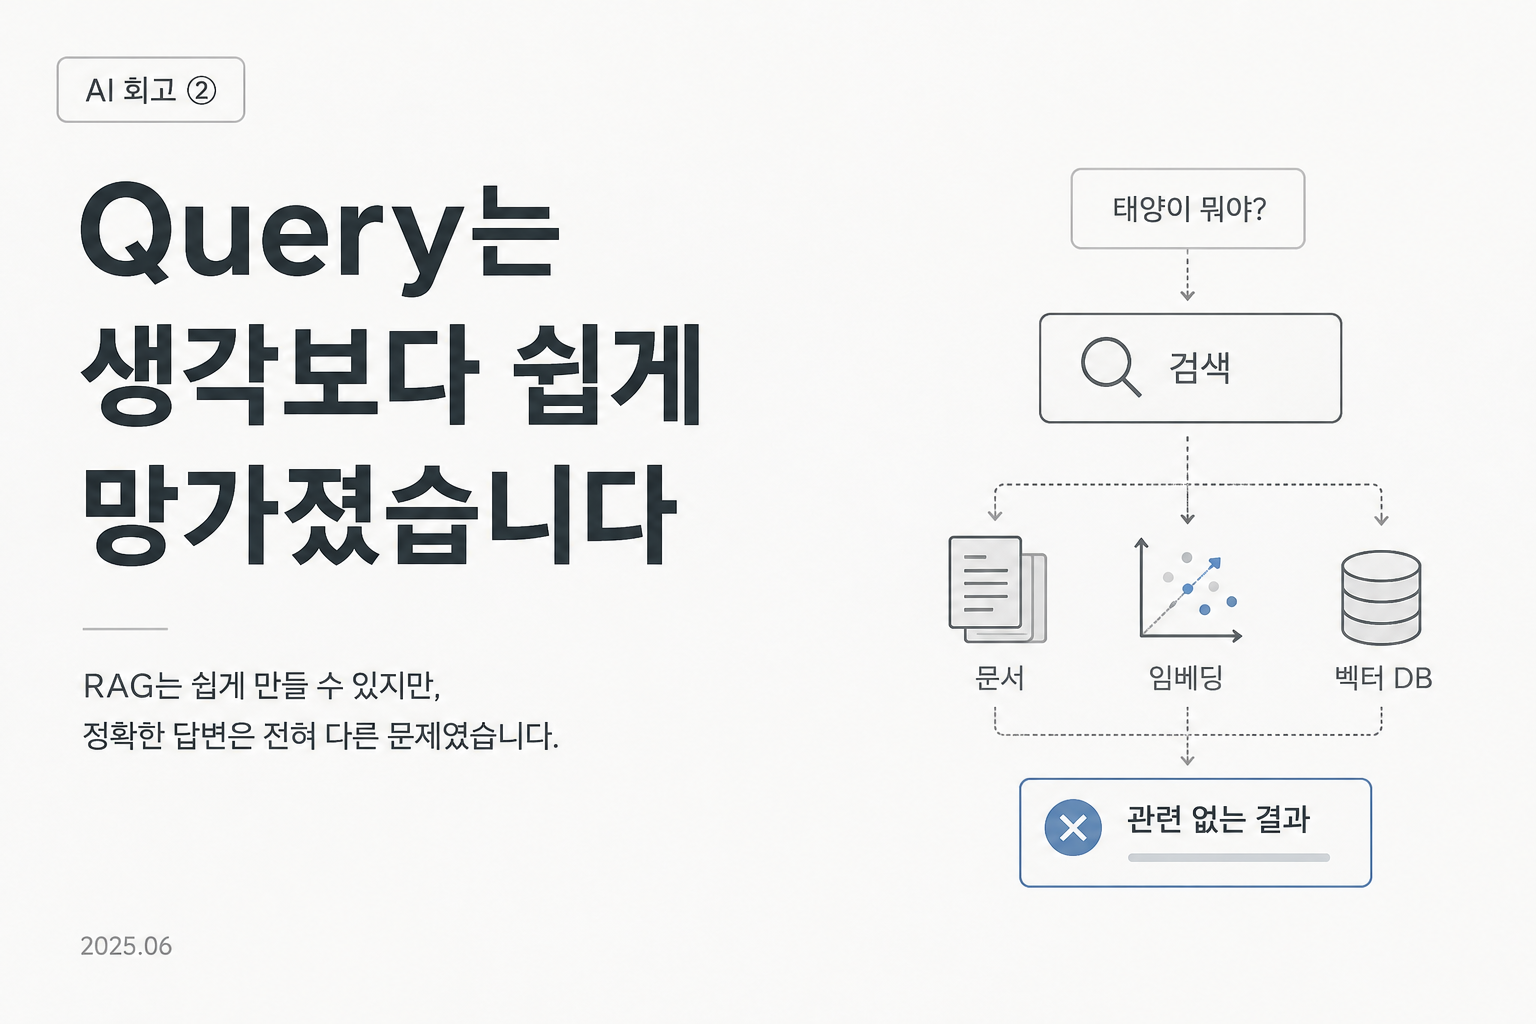
Query는 생각보다 쉽게 망가졌다
RAG는 임베딩만 성공적으로 수행하면, 그 이후 과정은 쉬워 보인다. 실제로도 간단한 문서의 경우에는 벡터 DB에 임베딩해서 저장하기만 해도 손쉽게 RAG 구조를 만들 수 있다.
하지만 "그 RAG가 얼마나 정확한가?" 라는 질문에는, 전혀 그렇지 않다고 말할 수 있을 것 같다.
현재 프로젝트에서는 1편에서 생성한 요약 문서들을 기반으로 자연어 질의 기능을 구현하고 있다. 정확도를 높이기 위해 RAG를 도입했지만, 결과는 기대했던 수준에 미치지 못했다.
실제 예시로 한 번 보자.
태양계 알려줘 라는 질문에는 다음과 같이 정상적인 결과가 나왔다.
{
  "user_message": {
    "id": "chat_user_2dac5416-c417-412c-8f9d-4556d44fca4c",
    "role": "user",
    "content": "태양계 알려줘",
    "status": "completed",
    "created_at": "2026-06-15T17:12:21.320720Z"
  },
  "assistant_message": {
    "id": "chat_assistant_c45bbb6c-c4ed-45c3-9b93-dbce44ad43a8",
    "role": "assistant",
    "content": "태양계는 태양, 8개 행성, 왜소행성, 위성, 소행성, 혜성 등으로 구성되어 있습니다 [1][4][5]. 행성과 위성의 운동은 중력과 밀접한 관련이 있으며 [4], 이는 천문학 연구의 핵심 주제 중 하나입니다 [3]. 태양계는 우주 과학의 기초 개념을 이해하는 데 중요한 역할을 합니다 [3]. 참고로, 제공된 증거에서는 물의 순환이나 중력의 세부 설명은 포함되지 않았습니다 [2][6].",
    "status": "completed",
    "created_at": "2026-06-15T17:12:22.442129Z"
  },
  "related_pages": [
    {
      "id": "source:doc_75d2d93c",
      "page_type": "source",
      "title": "과학 상식 — 태양계, 물의 순환, 중력",
      "slug": "doc_75d2d93c",
      "relevance_score": 1,
      "role": "seed_source",
      "depth": 0
    }
  ]
}
반면, 태양이 뭐야? 라는 질문에는 전혀 관련 없는 결과가 반환됐다.
{
  "user_message": {
    "id": "chat_user_73f48667-3803-4ca7-a0d0-cdfb3d5d7b80",
    "role": "user",
    "content": "태양이 뭐야?",
    "status": "completed",
    "created_at": "2026-06-15T17:13:31.340548Z"
  },
  "assistant_message": {
    "id": "chat_assistant_7997493a-a046-4eca-894e-ee9cd00ad408",
    "role": "assistant",
    "content": "제공된 근거에서 질문에 직접 답할 내용을 찾지 못했습니다. 가장 가까운 자료는 건강과 생활 — 손씻기, 수면, 움직임이지만, 이 자료도 질문 주제를 직접 설명하지 않습니다. [1]",
    "status": "completed",
    "created_at": "2026-06-15T17:13:32.169960Z"
  },
  "related_pages": [
    {
      "id": "source:doc_17bb2e74",
      "page_type": "source",
      "title": "건강과 생활 — 손씻기, 수면, 움직임",
      "slug": "doc_17bb2e74",
      "relevance_score": 0,
      "role": "seed_source",
      "depth": 0
    }
  ]
}
결과적으로 유사도가 크게 떨어지면서 엉뚱한 문서를 참조하는 현상이 발생했다.
왜 이런 문제가 발생했을까?
원인을 분석해보니 다음 부분들이 문제라고 판단했다.
- 벡터 검색을 요약 페이지 기준으로만 수행하다 보니, 세부 내용을 정리한 페이지의 유사도가 높아도 무시되고 있었다.
- 자연어 전체를 그대로 임베딩하면서 벡터 값에 노이즈가 섞였다.
- 사용 중인 임베딩 모델인 BGE-M3가 아직 한국어 처리에 충분히 강하지 않을 수 있다고 판단했다.
그래서 이 문제들을 하나씩 해결해보기로 했다.
세부 내용 정리 페이지가 무시되는 문제
가장 먼저 이 문제를 해결하기로 했다. 왜냐하면 태양계가 뭐야?는 정상적으로 동작하는데, 태양이 뭐야?는 제대로 찾지 못하고 있었기 때문이다.
결국 요약 페이지에는 해당 내용이 일부만 포함되어 있어서 발생한 문제라고 생각했다.
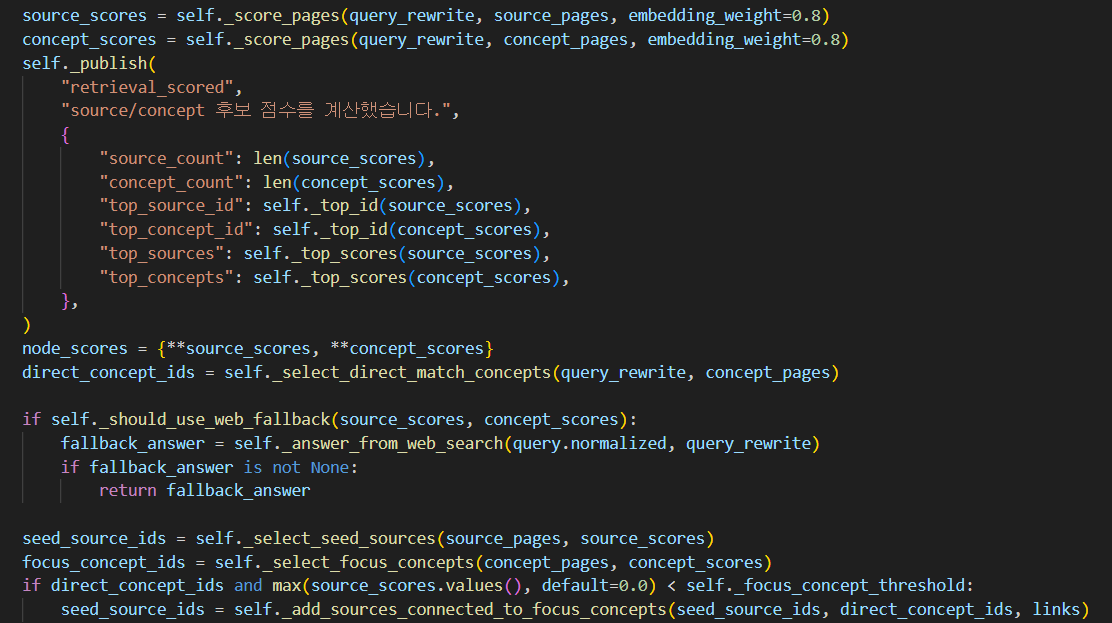
그래서 select_direct_match_concept를 추가해, Concept Page에서 바로 탐색을 시작할 수 있도록 수정했다.
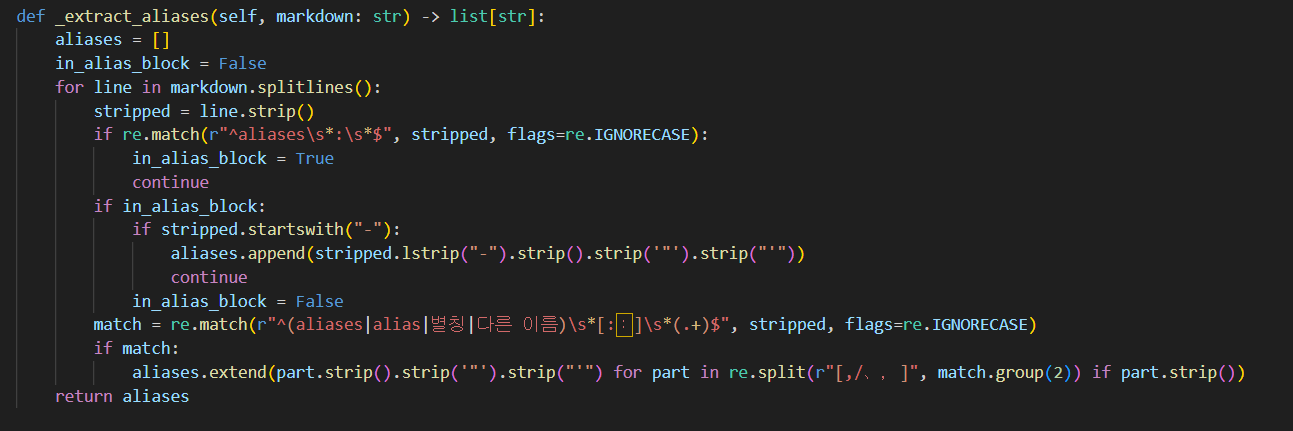
추가로, 현재 시스템은 페이지 제목 자체를 임베딩하여 매칭하고 있기 때문에 다음과 같은 경우에도 문제가 발생할 수 있다고 판단했다.
- 영문으로 한글 발음을 표기한 제목
- 영문으로 번역된 제목
- 의미적으로는 유사하지만 별도의 개념으로 존재하는 경우
예: 판소리 - 소리꾼
그래서 alias를 추가하여 검색에 활용하기로 했다.
미리 유사한 의미를 가지는 단어들을 보유하고 있다면 정확도를 높일 수 있을 것이라고 생각했다. 물론 단점도 있다. 저장 용량이 증가하고, 별칭까지 함께 매칭해야 하기 때문에 처리 시간이 늘어날 수 있다.
자연어 질의 전체를 그대로 임베딩하는 문제
자연어 전체를 그대로 임베딩하면 불필요한 노이즈가 함께 포함되어 벡터 값이 왜곡될 수 있다고 생각했다. 그래서 자연어 문장에서 조사를 제거하고, 핵심 단어 단위로 분리한 뒤 각각 임베딩하여 검색을 수행하도록 변경했다.
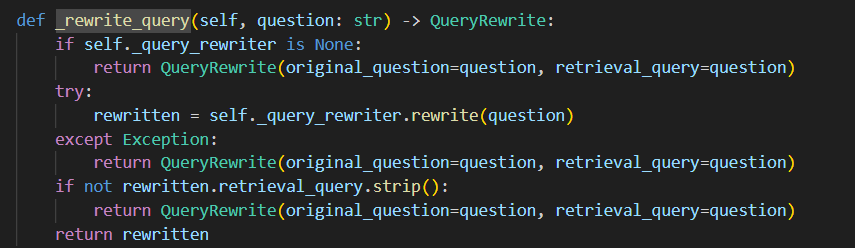
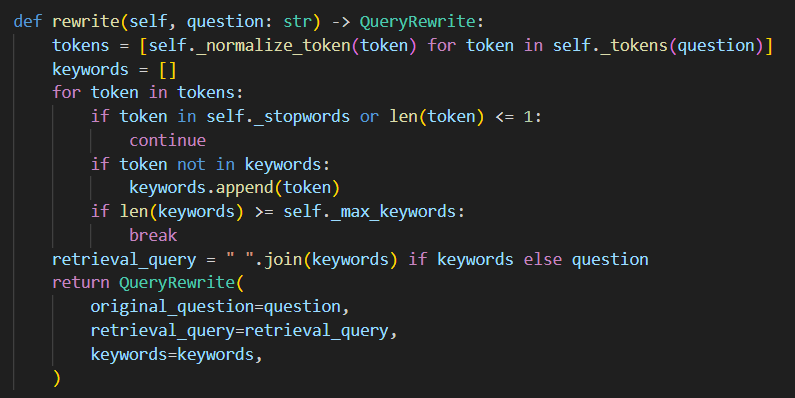
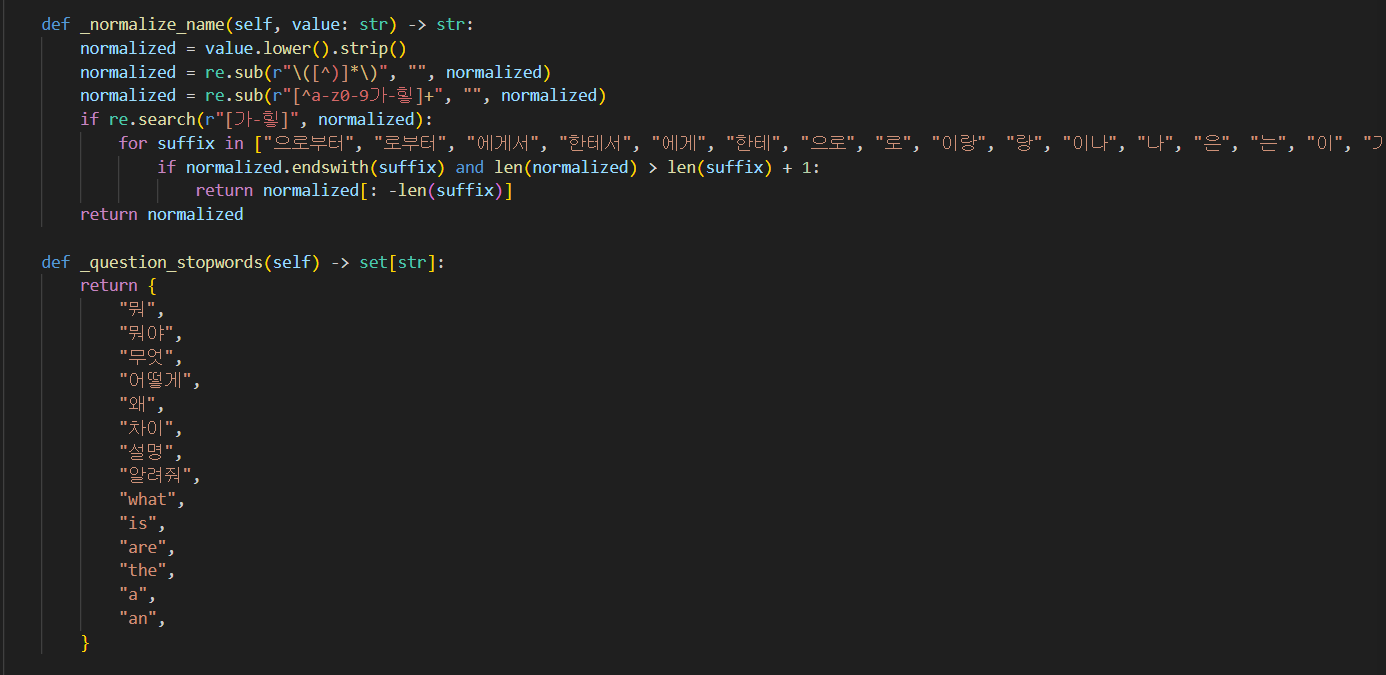
수정 이후 다시 테스트해봤다
위 두 작업을 진행한 뒤 다시 테스트해보니 훨씬 자연스러운 결과가 나왔다.
{
  "answer": "소리꾼은 판소리에서 노래(소리), 말(아니리), 몸짓(발림)으로 서사를 이끌어가는 주연자입니다 [4]. 단순한 가수가 아니라 연기자이자 이야기꾼의 역할을 수행하며 [2], 목소리 변조와 감정 표현을 통해 다양한 인물과 서사를 전달합니다 [1][3]. 판소리는 한국의 전통 공연예술로, 소리꾼과 고수의 협연, 관객과의 상호작용을 통해 음악·문학·연극적 요소를 결합한 살아있는 예술입니다 [5].",
  "related_pages": [
    {
      "id": "concept:sorikkun",
      "page_type": "concept",
      "title": "소리꾼",
      "slug": "sorikkun",
      "relevance_score": 0.95,
      "role": "focus_concept",
      "depth": 0
    },
    {
      "id": "source:golden:06_culture_pansori",
      "page_type": "source",
      "title": "문화/예술 — 판소리",
      "slug": "golden:06_culture_pansori",
      "relevance_score": 0.5301,
      "role": "seed_source",
      "depth": 0
    }
  ]
}
하지만 여기서 또 다른 문제가 발견됐다. depth 값이 모두 0으로 표시되고, path도 생성되지 않았다.
원인을 확인해보니, 기존에는 source를 기준으로만 탐색을 시작하고 있었기 때문에 concept → source로 이동하지 못하고 있었다. 그래서 저장된 그래프 경로를 역방향으로 활용해 concept → source 탐색이 가능하도록 수정했다.
최종 결과
최종적으로 다음과 같은 개선 효과를 얻을 수 있었다.
Concept → Source탐색이 가능해졌다.- 자연어를 분해해 질의하면서 매칭 정확도가 높아졌다.
- 특정 유사도 이하의 결과는 Web Search를 통해 추가 근거를 수집하도록 구성했다.
다만 여기서 끝내기보다는, Golden Set을 만들어 지속적으로 테스트해볼 필요가 있다고 생각한다.
마무리
RAG는 구조 자체만 놓고 보면 LLM을 활용해 비교적 쉽게 만들 수 있었다. 하지만 이를 실제 서비스 수준으로 고도화하는 과정에서는 결국 사람의 역할이 더 중요하다고 느꼈다.
앞으로 문서의 양이 더 많아진다면, 단순히 검색 로직만 수정하는 것으로는 한계가 있을 수도 있다.
그때는 Wiki Page 자체의 작성 방식을 바꾸거나, Chunking 전략까지 함께 고민해야 할 것 같다. 아직은 정답을 찾았다고 생각하지는 않는다. 하지만 이번 작업을 통해 이것 하나는 확실히 느꼈다.
RAG를 만드는 것과, 정확한 답변을 도출하는 것은 전혀 다른 문제였다.