SW 마에스트로 프로젝트를 하며 작성하는 회고입니다.
앞선 글에서 작성한대로, Golden Set을 정할 수가 없어서 평가를 하지 못한다고 했다. 하지만, 그 평가마저도 따로 범위를 제한한다거나 그런 방식이 아니라면? 그것또한 AI의 자유에 맡겨버린다면? 이라는 생각이 들어 멘토님이 알려주신 Evaluator-Optimizer 패턴을 적용시켜 Agentic하게 품질을 높일 수 있을 것이라는 가설을 세웠다.

Evaluator-Optimizer 패턴이란?
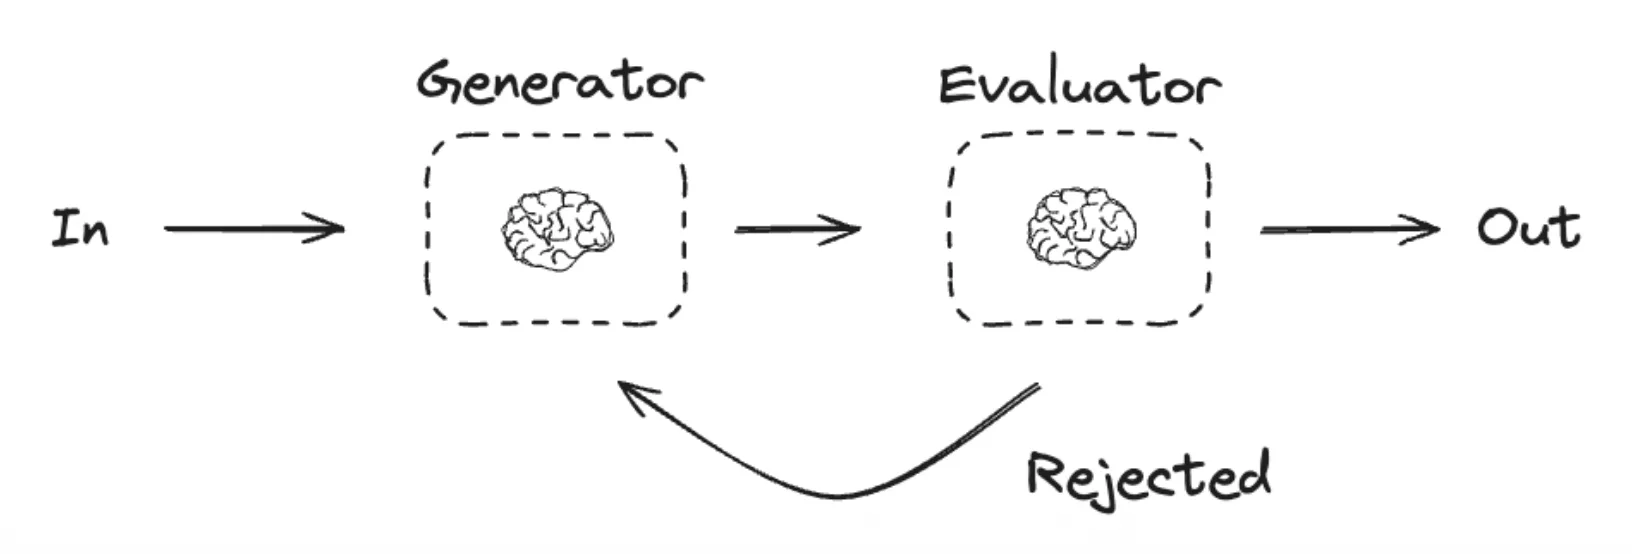 출처: https://wikidocs.net/331302
이 패턴은 간단히 말하면 '피드백 루프' 라고 할 수 있을 것 같다. Generator에게 생성만을 맡기고 Evaluator에겐 평가만을 맡겨, "생성하고 피드백받아서 재생성"의 루프를 이론상 무한정 돌리는 방식이다.
물론 이 방식은 단순 생성보다 느리다. 하지만 평가 기준에 맞는 결과물을 만들 확률이 높아지기 때문에 정확도는 올라갈 수 있다. 일종의 trade-off라고 볼 수도 있을 것 같다!
다만 루프를 무한정 돌리면 사용자 경험이 나빠질 수 있기 때문에, 보통은 최대 반복 횟수 같은 가드레일을 함께 둔다.
정리하면,
- 속도보다 정확성이 중요할 때
- 명확한 평가 기준이 있을 때
- AI가 평가 기준에 맞게 결과물을 개선해야 할 때
이 패턴을 쓰면 해당 문제를 해결하는데 도움을 줄 수도 있을 것이다
적용해야겠다 생각한 계기
그렇다면 왜 이 패턴을 적용해야 한다고 생각했을까?
단순히 정확도가 오른다고 해서?
멘토님이 해보라고 하셔서?
물론 그런 이유도 어느 정도는 있었지만, 가장 큰 이유는 사용자 피드백을 받으면서 실제 문제를 발견했기 때문이다.
사용자는 자신이 작성한 논문들을 가지고 있었고, 이를 우리 프로젝트에 업로드해 실제로 page를 생성하고 query까지 하는 하나의 플로우를 거쳤다. 여기서 문제가 발견되었다...크게는 다음 두 가지이다.
-
페이지를 생성할 때, query 성능을 올리기 위해 alias 개념을 사용하고 있었는데, LLM이 이를 오판하여 잘못된 축약어를 작성해버린 경우
-
Query 후 원문 링크를 따라갈 때, 잘못된 부분을 링크한 경우
그 외에도 자잘한 문제들은 있었지만, 위 두 문제는 꽤 심각하다고 판단했다.
우리 프로젝트의 핵심 가치는 “질문만 해도 내가 찾고 싶었던 문서의 내용을 빠르고 정확하게 찾을 수 있다”에 가깝다고 생각한다. 그런데 alias가 잘못 생성되거나, 원문 링크가 잘못 연결되면 사용자가 아무리 질문을 정성스럽게 해도 원하는 내용을 정확하게 찾을 수 없다.
결국 할루시네이션을 바로잡고, 틀린 부분은 다시 수정되는 구조가 필요했다.
이것이 Evaluator-Optimizer 패턴을 적용하려고 한 이유다.
프로젝트에 적용하기
'하지만, 분명 명확한 평가 기준이 있고, 이에 대해 평가할 때 좋은 패턴이라고 했는데, Golden Set이 없으니 있으나마나 아닌가?' 라는 의문이 들 수도 있다.
솔직히 타당하다고 생각한다. 앞선 글에서는 좋은 지식 단위의 범위를 하나의 정답으로 고정할 수 없다고 했다. 그런데 지금은 명확한 평가 기준이 있을 때 좋은 패턴을 적용하겠다고 말하고 있기 때문이다.
하지만 Golden Set이 없었던 이유를 다시 생각해보면, 문제가 조금 다르게 보인다.
우리가 Golden Set을 만들기 어려웠던 이유는 Concept의 범위를 하나의 정답으로 고정하기 어려웠기 때문이다. 즉, 전통적인 방식으로 “이 문서에서는 이 concept이 정답이다”라고 특정하기 어려웠던 것이 문제였다. 그래서 평가 기준에서 범위 자체는 제외하기로 했다. Concept의 범위는 사람이 억지로 고정하기보다, Evaluator 역할을 하는 더 강한 LLM에게 추론과 판단을 맡긴다. 대신 명확하게 평가 가능한 항목은 Evaluator가 검사하도록 한다.
예를 들면 다음과 같은 것들이다.
- 문서에 없는 내용이 저장되지 않았는가?
- 원문의 문맥과 다른 의미로 해석되지 않았는가?
- 발췌된 위치가 정확하게 링크되어 있는가?
- alias가 실제 문서 맥락과 맞는가?
- 생성된 page가 근거와 일관되게 연결되어 있는가?
이런 항목들은 비교적 맞고 틀림을 판단할 수 있다.
따라서, Evaluator로 이러한 명확한 평가 기준에 맞게 페이지가 생성되었는지를 평가하고, 범위는 LLM의 추론하에 맡기는 형태로 가는 것이다.
결론
실제로 Evaluator-Optimizer 패턴을 적용하고, LangGraph로 루프를 구성했다. 그리고 LangSmith를 통해 해당 흐름을 직접 확인할 수 있었다.
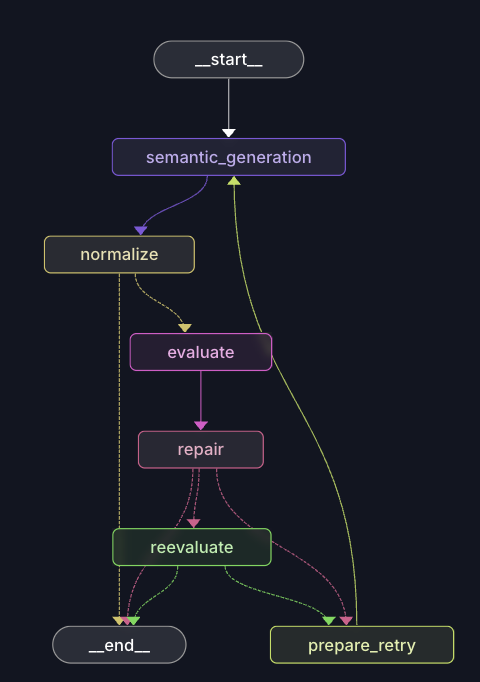
(참고로 그래프에서 normalize에서 바로 end로 가는 경로는 wiki_evaluation_loop=false 옵션을 지원하기 위해 남겨둔 것이다.)
evaluator에서는 다음과 같은 결과가 나왔다.
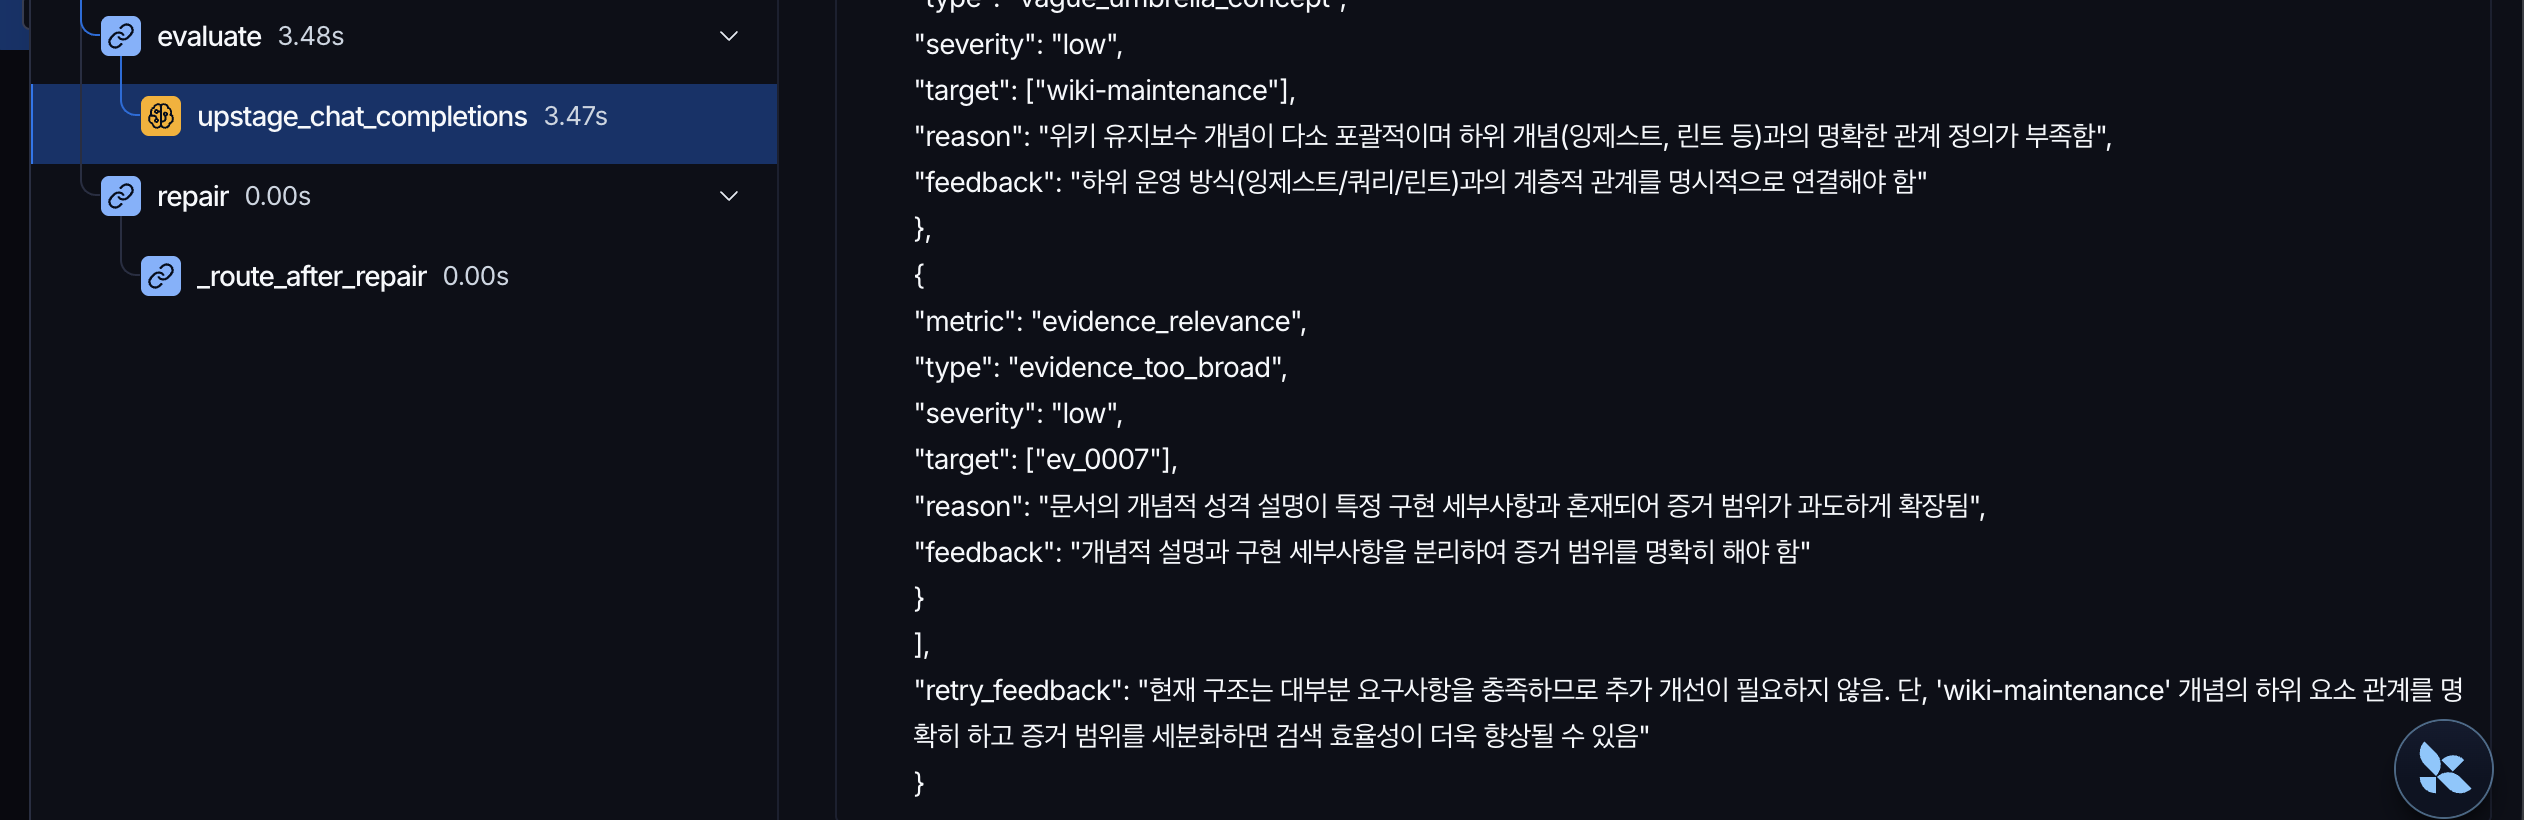
이제 이 평가 결과를 반영해 전체를 다시 생성하는 것이 아니라, 문제가 있는 부분만 재생성하는 방향으로 품질을 높일 수 있게 되었다.
이전에는 생성 결과가 틀리면 사람이 직접 보고 고쳐야 했다. 하지만 이제는 Evaluator가 문제를 지적하고, Optimizer가 해당 부분을 다시 생성하는 구조를 만들 수 있게 된 것이다.
후기
오래전부터 만들어보고 싶었던 피드백 루프를 적용해볼 수 있어 좋았지만, 아직 처음이기에 해당 구조가 안정적이지 않은 것처럼 보이는 부분들이 몇몇 존재한다. 예를 들면 평가자가 할루시네이션이 발생해 그냥 통과시키거나 평가 내용에 문제가 있는 경우는 어떻게 해결할 수 있는지? 등을 좀 더 공부해보아야겠다!