SW 마에스트로 프로젝트를 하며 작성하는 회고입니다.
이번에는 다른 분야로 llm을 사용해보았다.
기존의 pdf -> markdown을 해주는 오픈소스나 사이트들은 ocr기반이기 때문에 구조가 복잡하거나, 수식,표,그림이 있으면 깨지는 경우가 잦았다. 그래서 이러한 오류를 sllm을 통해 잡아보자는 생각을 했다.
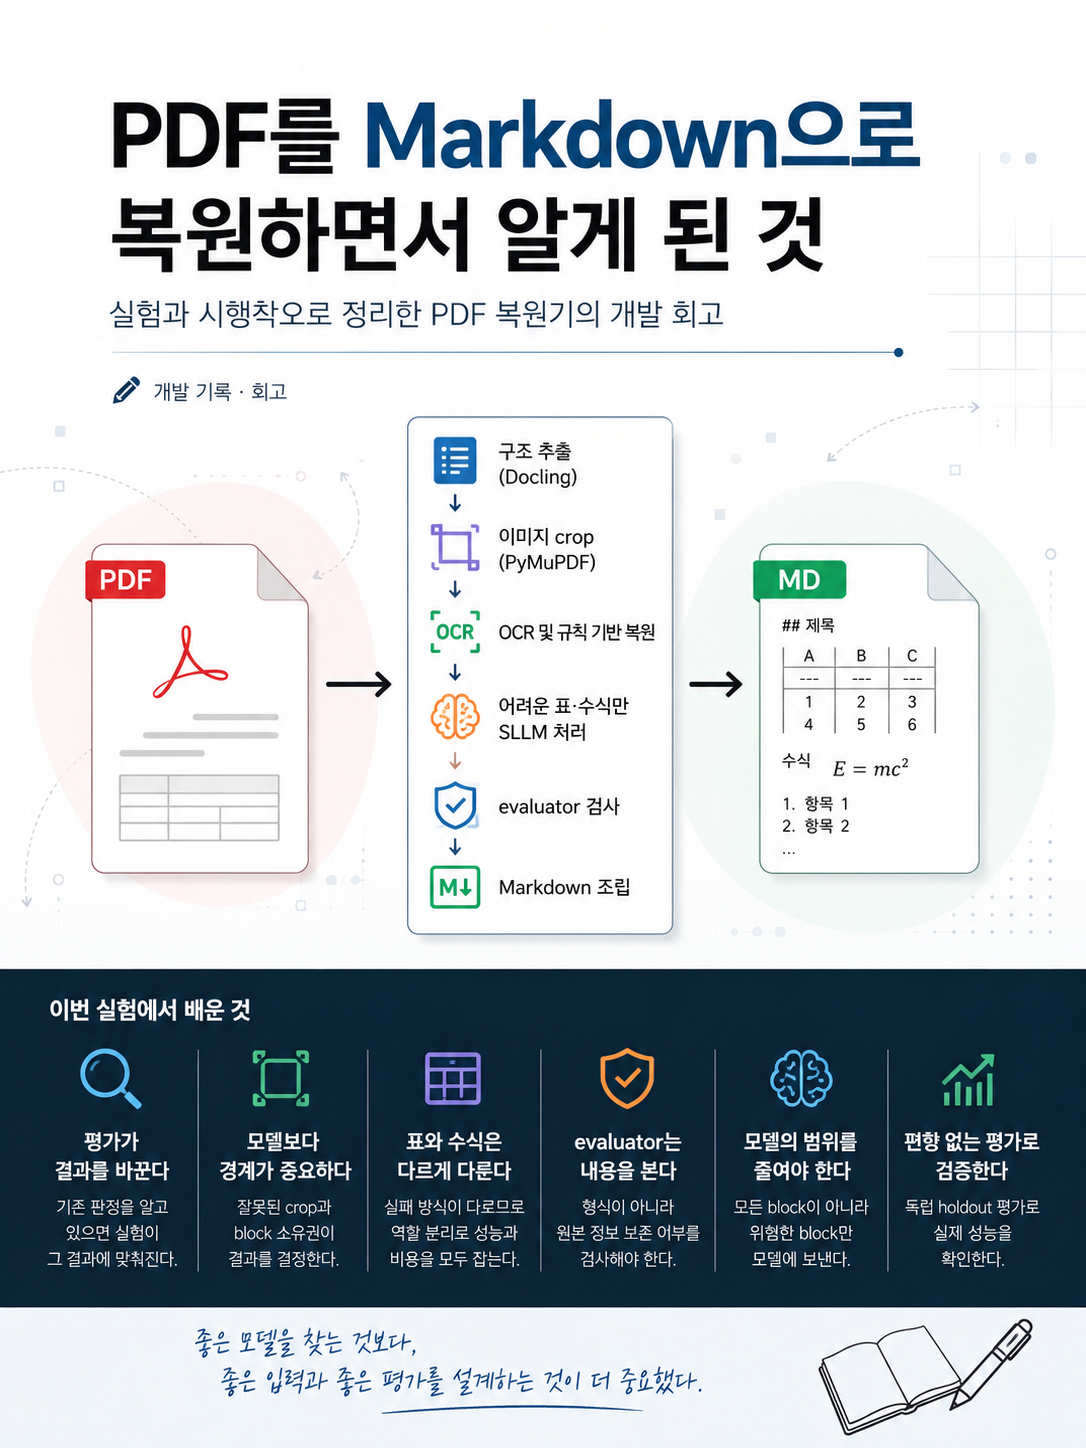
처음에는 PDF를 Markdown으로 바꾸는 일이 그렇게 복잡할 것이라고 생각하지 않았다. PDF에서 텍스트를 추출하고, 표와 수식을 적당한 형식으로 변환하면 끝나는 문제라고 생각했다. 그래서 Docling으로 문서 구조를 추출하고, 부족한 부분은 PyMuPDF와 OCR로 보완한 뒤, 어려운 표와 수식만 로컬 SLLM에 맡기는 구조를 만들었다. AI가 만든 결과도 그대로 사용하지 않고 evaluator를 통과한 결과만 최종 Markdown에 넣었다.
모델은 qwen2.5:7b, qwen2.5vl:7b를 사용했다. evaluator는 플로우가 완전하지 않았기에 codex에서 evaluate하였다.
처음 만든 구조는 대략 다음과 같았다.
PDF
→ Docling 구조 추출
→ PyMuPDF crop 생성
→ OCR 및 규칙 기반 복원
→ 어려운 표·수식만 SLLM 처리
→ evaluator 검사
→ Markdown 조립
구조 자체는 꽤 합리적으로 보였다.

표와 수식은 같은 방식으로 처리할 수 없었다
처음에는 표와 수식을 모두 OCR로 읽은 뒤 Text SLLM과 Vision SLLM을 순서대로 사용하면 될 것이라고 생각했다. 하지만 실험해 보니 표와 수식은 실패하는 방식이 달랐다.
표는 글자 자체보다 행과 열의 위치 관계가 중요했다. Text SLLM은 OCR 문자열만 보기 때문에 여러 열을 하나의 cell로 합치거나, header와 body의 관계를 잘못 연결했다. 잘못 만들어진 Text SLLM 후보가 Vision SLLM의 판단까지 방해하는 경우도 있었다.
반대로 수식은 OCR 문자열에도 변수, 연산자, 분수와 같은 구조적 단서가 남아 있었다. Vision SLLM만 사용했을 때 사라졌던 역수 구조를 Text SLLM이 복원한 사례도 있었다.
그래서 다음과 같이 역할을 분리했다.
표: Vision SLLM 중심
수식: Text SLLM 후보 생성 → 필요하면 Vision SLLM 확인
이 방식은 표와 수식에 Text·Vision 모델을 모두 적용한 방식보다 복원율이 높았고, SLLM 처리시간도 약 42% 줄었다. 이 결과를 통해 각 모델이 잘하는 역할만 맡기는 것이 중요하다고 생각했다.
처음에는 결과가 꽤 좋다고 생각했다
초기 평가에서는 PDF 4개, 총 30페이지의 445개 block 중 414개가 완전하거나 경미한 오류만 있는 것으로 판정되었다. (전체 block 정확도는 93.03%였다!!)
표와 수식 70개도 모두 사람이 구조를 구분하고 읽을 수 있었고, 그중 55개는 원본을 다시 보지 않아도 재사용할 수 있는 수준으로 정리했다. 처음에는 이 정도면 현재 구조가 어느 정도 완성되었다고 생각했다. 이 평가는 gpt-5.6-sol medium을 이용해 진행했고, 평가자가 모델이었다는 사실 자체가 문제라고 생각하지는 않았다.
기존 평가를 알고 있다는 것이 실험을 편향시켰다
초기 평가 이후에는 어떤 block이 틀렸는지, 어떤 이유로 감점됐는지를 알고 있는 상태에서 계속 실험을 진행했다. 평가 결과를 보면서 오류 기준을 수정했고, selector 규칙을 만들었으며, 복원 prompt와 evaluator도 변경했다. 그러다 보니 새로운 방식이 실제로 좋아진 것인지, 아니면 기존 평가 결과에 맞게 조정된 것인지 구분하기 어려워졌다.
이러한 영향을 확인하기 위해 같은 SLLM 결과를 서로 다른 기준으로 다시 평가했다.
엄격하게 block의 경계와 표기를 확인한 평가에서는 278/445였지만, 참고문헌 번호나 인접 문구처럼 제품 사용에 큰 영향을 주지 않는 차이를 허용하는 기준으로 사후 재분류했을 때는 395/445가 되었다. 복원 결과가 개선된 것은 아니었다. 동일한 결과를 바라보는 평가 기준이 달라진 것이었다.
더구나 이 재분류는 기존 판정과 감점 사유를 확인한 상태에서 진행했기 때문에 독립적인 정확도로 사용할 수 없었다. 기존 결과를 설명하는 참고 자료로는 사용할 수 있지만, 새로운 평가 근거로 볼 수는 없었다. 그래서 이후에는 기존 점수와 판정 사유를 모두 숨기고, 원본 PDF와 두 후보만 제공하는 새로운 blind 평가를 진행했다. 후보의 A/B 위치도 block마다 무작위로 배치했다.
그 결과, 기존 SLLM은 382/445, GPT-5.4는 436/445로 판정되었다. 현재 저장 결과의 상대적인 품질을 비교할 때는 이 독립 평가를 기준으로 사용했다.
여기서 알게 된 것은 평가 기준이 결과를 크게 바꿀 수 있다는 점이었다.
또한 개발 문서에서 확인한 오류를 바탕으로 selector와 규칙을 반복해서 수정하면, 해당 문서의 오류에는 잘 맞지만 새로운 PDF에서는 재현되지 않는 휴리스틱이 만들어질 수 있었다. 따라서 기준을 수정하는 개발 실험과, 수정된 기준을 검증하는 독립 holdout 평가는 분리해야 했다.
모델 문제처럼 보였지만 입력 문제였던 경우도 많았다
실험하면서 의외였던 점은 모델을 바꾸는 것보다 crop의 범위를 바로잡았을 때 결과가 크게 좋아지는 경우가 많았다는 것이다.
연속된 수식 두 개를 복원하는 실험에서 GPT-5.4는 이웃 수식의 일부까지 합쳐 잘못된 결과를 만들었다. 처음에는 모델이 수식 구조를 제대로 이해하지 못했다고 생각했다. 하지만 OCR과 prompt는 그대로 두고, 이미지 crop만 Docling의 엄격한 bbox로 다시 만들자 두 수식이 모두 정확하게 복원되었다.
(Docling은 pdf-> md와 같이 확장자를 변환해주는 오픈소스입니다.)
문제는 모델이 아니라 모델에게 보여준 이미지의 경계였다. 비슷한 문제는 여러 페이지에 걸친 block에서도 발생했다. 두 페이지에 걸친 Docling block의 전체 text를 첫 번째 페이지 입력에 넣고 있었기 때문에, 모델이 다음 페이지의 내용을 첫 번째 페이지에 붙여 쓰고 있었다. page_no와 charspan을 기준으로 페이지별 소유권을 나누자 별도의 evaluator 없이도 문제가 해결되었다.
이 경험을 통해 모델 결과가 이상할 때는 모델부터 바꾸는 것이 아니라 다음을 먼저 확인해야 한다고 생각했다.
block의 bbox가 정확한가
인접 block이 crop에 포함되지 않았는가
해당 text가 실제로 이 페이지에 속하는가
reading order가 올바른가
표와 caption의 소유권이 구분되어 있는가
모델이 잘못 읽은 것처럼 보였던 문제 중 일부는 사실 입력을 잘못 만든 문제였다.
evaluator는 형식만 검사해서는 안 됐다
초기 evaluator는 주로 Markdown과 LaTeX 형식이 정상인지 검사했다. 표의 열 개수가 맞는지, 수식 괄호가 닫혔는지, 결과에 깨진 문자가 남았는지 확인했다. 하지만 형식이 맞는다고 내용까지 맞는 것은 아니었다.
13행 표가 6행만 남아도 Markdown 형식은 정상일 수 있다. 수식에서 둘째 줄이 사라져도 괄호가 닫혀 있으면 통과할 수 있다. 모든 ± 부호가 빠졌는데 행과 열 개수가 같다는 이유로 정상으로 판정되기도 했다.
반대로 표의 값은 모두 복원됐지만 header 형식이 조금 깨졌다는 이유로 전체 결과가 거절되는 경우도 있었다.
결국 evaluator는 다음을 확인해야 했다.
원본의 숫자가 결과에 남아 있는가
표의 행과 열이 보존됐는가
수식의 부호, 분모, 첨자가 유지됐는가
참고문헌과 목록 번호가 빠지지 않았는가
다른 block의 내용을 가져오지 않았는가
그리고 evaluator가 수정한 결과도 다시 원본과 비교해야 했다.
실제로 페이지 전체를 다시 작성하게 한 evaluator는 기존에 정확했던 수식을 잘못 수정했다. 반면 evaluator가 오류 위치와 최소한의 patch만 반환하게 하고, 지적되지 않은 영역을 그대로 유지했을 때는 이러한 회귀를 줄일 수 있었다.
즉 evaluator도 자유롭게 전체 문서를 다시 작성하게 하면 안 됐다.
모든 block을 좋은 모델에 보내면 품질은 높아졌다
GPT-5.4가 모든 block을 직접 처리한 결과는 현재 실험에서 가장 높은 품질 기준 중 하나였다. 독립 product blind 평가에서는 436/445, 97.98%를 기록했다. 하지만 30페이지를 처리하는 데 388,075 reported token과 271초의 generation 시간이 필요했다. 정확도의 상한을 확인하기에는 좋았지만, 제품의 기본 처리 방식으로 사용하기에는 비용이 컸다.
그래서 목표는 명확해졌다. 모든 block을 좋은 모델에 보내는 것이 아니라, 저비용으로 위험한 block을 찾고 그 block만 모델에 보내는 것이다.
문제는 위험 block을 찾는 일이 생각보다 어려웠다는 것이다.
Docling과 PDF 내장 text가 같으면 안전하다고 판단해 보기도 했고, Tesseract와 결과가 일치하면 통과시키기도 했다. 여러 OCR을 추가하거나 표의 구조를 분석하는 규칙도 만들었다. 하지만 같은 text layer를 사용하는 도구끼리는 같은 오타를 공유했다. 서로 다른 OCR도 같은 글자를 똑같이 잘못 읽을 수 있었다. 표의 행과 열 구조가 정상이어도 cell 내부의 값이 틀릴 수 있었다. 모델 호출을 줄이기 위해 만든 selector가 위험한 block을 놓치면 비용은 줄어도 제품 품질은 크게 떨어졌다.
현재까지의 실험에서는 위험 block의 미탐을 막으면서 호출량도 충분히 줄이는 배포 가능한 중간점을 아직 찾지 못했다.
현재 내린 결론
PDF를 Markdown으로 복원하는 문제는 문서 구조, block 경계, 원본 근거, 모델 역할, evaluator 계약과 평가 방법이 모두 연결된 문제였다.
지금까지의 결론은 다음과 같다.
-
확실한 부분은 코드로 처리하고, 불확실한 부분만 모델에 보내야 한다.
-
표와 수식은 실패 방식이 다르기 때문에 서로 다른 처리 흐름이 필요하다.
-
모델 성능보다 bbox와 block ownership이 결과를 더 크게 바꾸는 경우가 있다.
-
evaluator는 형식이 아니라 원본 정보가 실제로 보존됐는지를 검사해야 한다.
-
evaluator가 수정할 때도 전체 결과를 다시 쓰게 하지 말고, 최소 변경만 허용해야 한다.
-
한 번 확인한 평가 결과를 계속 보면서 실험하면 그 결과에 맞게 기준과 규칙이 편향될 수 있다. 따라서 개발셋에서 기준을 수정하는 실험과, 기존 결과를 숨긴 독립 holdout 평가는 분리해야 한다.
처음에는 복원 모델을 잘 조합하면 문제가 해결될 것이라고 생각했다. 하지만 실험을 반복할수록 어떤 block을 어떤 근거와 함께 모델에게 보여줄 것인지, 결과를 어떤 기준으로 검증할 것인지, 그리고 그 평가 자체가 기존 결과에 편향되지 않았는지를 확인하는 일이 더 중요했다.
그래서 결과적으로 아직 완성된 구조는 아니다. 다만, 아무리 좋은 AI Agent를 사용하더라도 그냥 PDF를 AI에게 보여주고 Markdown으로 바꿔 달라고 하는 방식으로는 이 문제를 안정적으로 해결할 수 없다는 것은 확실히 알게 되었다.