큐
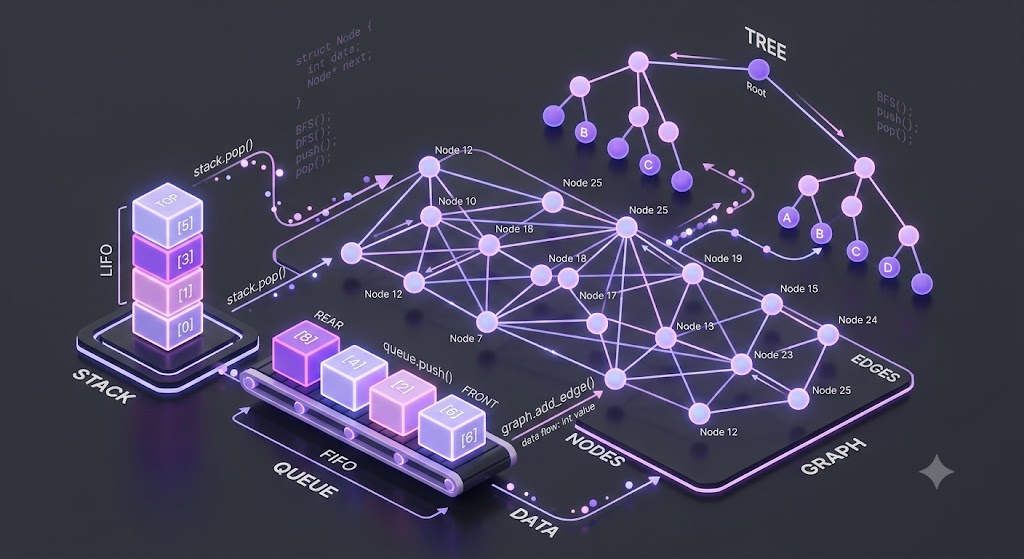
먼저 들어간 데이터가 먼저 나오는 자료구조이다.
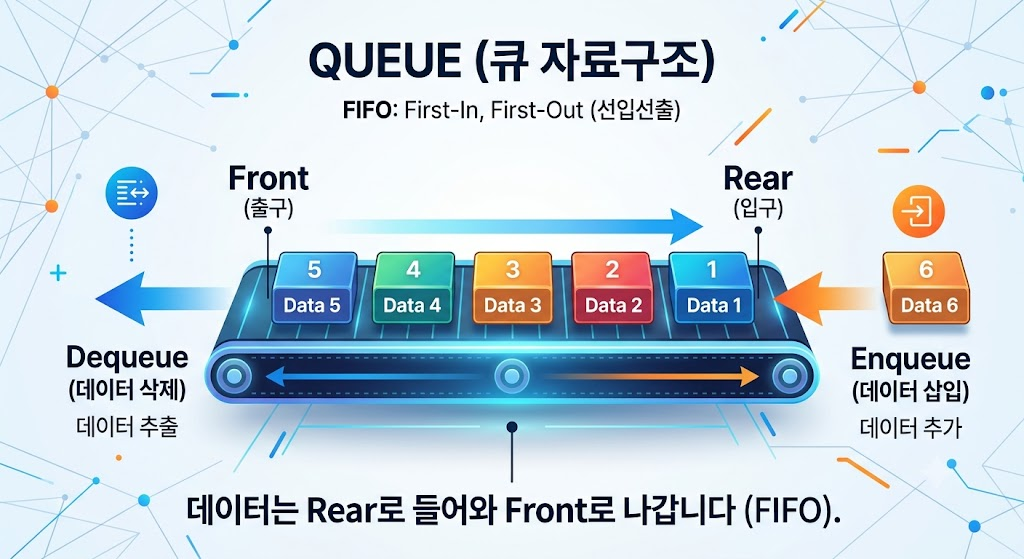
- '줄을 서다' 라는 뜻을 가지고 있다.
- 선입선출(FIFO; First In First Out)
- 푸시(PUSH): 데이터를 삽입하는 연산
- 팝(POP): 데이터를 꺼내는 연산
큐의 특성을 활용하는 분야
- 작업 대기열:
- 네트워크 통신을 할 때 다수의 클라이언트에서 서버에 작업을 요청하면 서버는 요청이 들어온 순서대로 작업을 처리한다.
- 이때 큐를 활용할 수 있다.
- 이벤트 처리: 어떤 애플리케이션이나 시스템에서 사용자의 이벤트, 예를 들어 키보드 입력이나 마우스 움직임을 처리할 때 큐를 활용할 수 있다.
큐의 ADT
| 구분 | 정의 | 설명 |
|---|---|---|
| 연산 | boolean isFull() | 큐에 들어 있는 데이터 개수가 maxsize인지 확인해 boolean 값을 반환한다. |
| 연산 | boolean isEmpty() | 큐에 들어 있는 데이터가 하나도 없는지 확인해 boolean 값을 반환한다. |
| 연산 | void push(Item Type item) | 큐에 데이터를 푸시한다. |
| 연산 | ItemType pop() | 큐에서 처음에 푸시한 데이터를 팝하고, 그 데이터를 반환한다. |
| 상태 | int front | 큐에서 다음에 제거할 원소의 위치를 기록한다. |
| 상태 | int rear | 큐에서 최근에 푸시한 데이터의 위치를 기록한다. |
| 상태 | ItemType data[maxsize] | 큐의 데이터를 관리하는 배열이다. 최대 maxsize개의 데이터를 관리한다. |
큐 구현하기
리스트를 큐처럼 활용하기
queue = []

# 큐에 데이터 추가
queue.append(1)
queue.append(2)
queue.append(3)

# 큐의 맨 앞 데이터 제거
first_item = queue.pop(0)
print(first_item)  # 1

# 큐에 데이터 추가
queue.append(4)
queue.append(5)

# 큐의 맨 앞 데이터 제거
first_item = queue.pop(0)
print(first_item)  # 2
덱을 큐처럼 활용하기
큐는 덱을 활용하는 것이 리스트로 활용하는 것보다 성능이 훨씬 우수하다.
from collections import deque

queue = deque()

# 큐에 데이터 추가
queue.append(1)
queue.append(2)
queue.append(3)

# 큐의 맨 앞 데이터 제거
first_item = queue.popleft()
print(first_item)  # 1

# 큐에 데이터 추가
queue.append(4)
queue.append(5)

# 큐의 맨 앞 데이터 제거
first_item = queue.popleft()
print(first_item) # 2pop(0)과 popleft()의 성능 비교하기
from collections import deque
import time

lst = list(range(100000))
dq = deque(range(100000))

# pop(0) 성능 측정
start_time = time.time()
for i in range(100000):
    lst.pop(0)
print("pop(0) 소요 시간: ", time.time() - start_time)  # pop(0) 소요 시간:  0.5691769123077393

# popleft() 성능 측정
start_time = time.time()
for i in range(100000):
    dq.popleft()
print("deque의 popleft() 소요 시간: ", time.time() - start_time)  # deque의 popleft() 소요 시간:  0.0027320384979248047