- GitHub : lfm2.5-universal-stack
- Gitbook : LFM2.5 Universal Stack
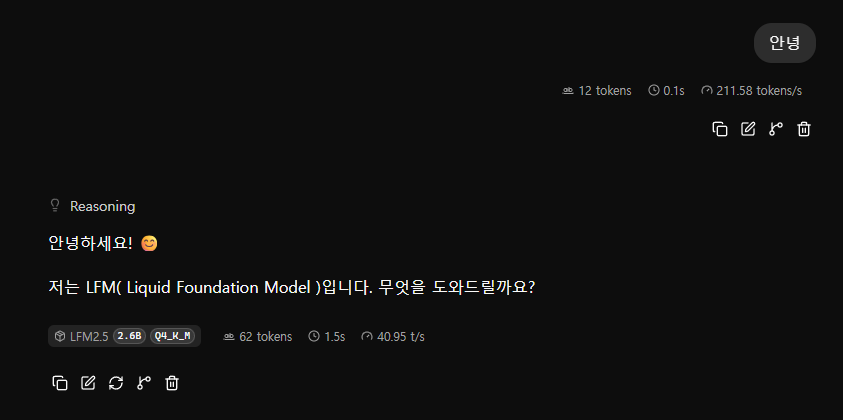
스레드에서 본 글 하나
이 모델을 처음 본 건 Threads(스레드)였다. 라즈베리파이에서도 돌아가는 모델이 나왔다는 짧은 글이었다. 반신반의하면서 찾아봤는데 진짜로 공개되어 있었다. Liquid AI 의 LFM2.5-2.6B 였다.
그 글이 그냥 지나가지 않았던 건, 나한테 오래 미뤄 둔 계획이 하나 있었기 때문이다.
서버에서 돌아가는 개인비서
당시 OpenClaw 가 유행하고 있었다. 에이전트를 개인비서로 두고 일을 시키는 게 하나의 흐름이었다. 나도 그런 비서를 갖고 싶었다. 시키고 싶은 일은 이런 것들이었다.
- 내 서버에 상주하면서 서버를 제어하기
- 내 업무를 정리해 둔 RAG 에서 필요한 내용 찾아 주기
- 필요한 파일 생성, 편집하기
- 메모한 내용을 찾거나, 일정 시간에 알려주기
조건은 하나였다. 내 PC 가 아니라 서버에서 24시간 돌아가야 한다는 것.
당시 나는 Gemini 를 유료로 구독하면서 Gemini CLI 를 쓰고 있었다. 그런데 Gemini CLI 의 계정 토큰을 OpenClaw 에 연결하여 사용하면 구글 정책 위반이라는 이야기와, 실제로 계정이 정지된 사례를 여러 번 접했다. 그래서 한동안 계획을 접어 두었다.
그러다 구글 AI Pro 요금제를 쓰면 구글 크레딧이 매달 10달러씩 쌓인다는 걸 알게 됐다.
이 크레딧을 사용하면 된다. (크레딧은 직접 GCP에서 사용해야 한다. https://developers.google.com/program/my-benefits?hl=ko)
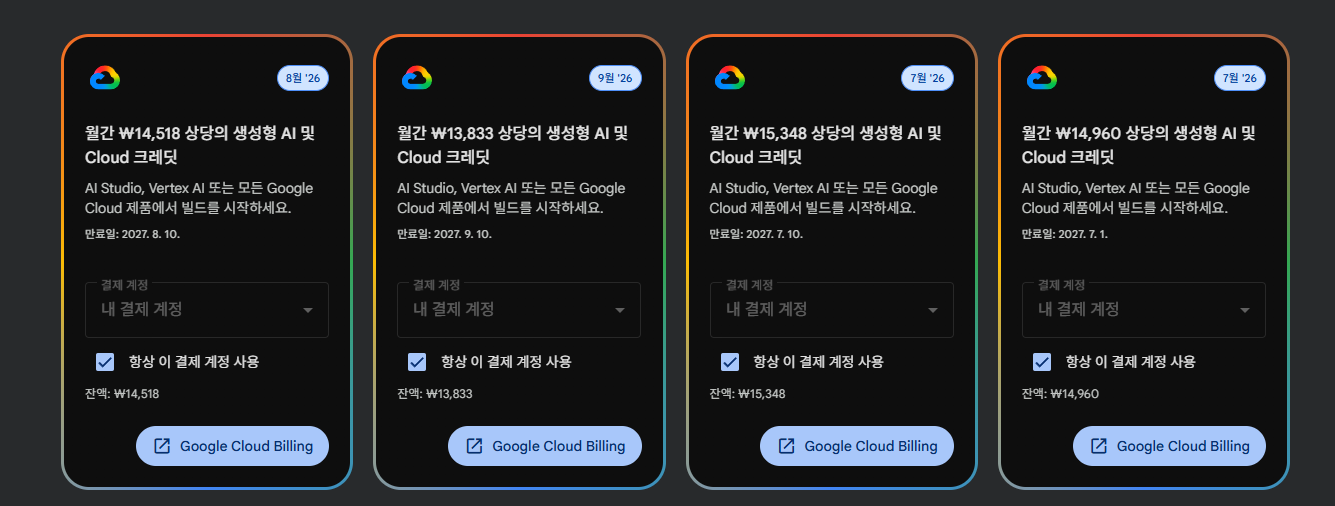
바로 서버에 Hermes Agent 를 설치하고, API 는 가장 저렴한 Gemini 3.1 Flash-Lite 를 사용했다. 그리고 디스코드 봇과 연결하여 개인비서로 쓰기 시작했다.
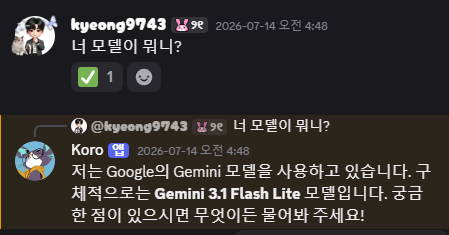
문제는 비용이었다. API 는 쓰는 만큼 돈이 나간다. 10달러를 넘기면 그때부터는 돈이 나간다. 학생 입장에서 매달 나가는 돈을 만들고 싶지 않았고, 결국 비서를 부르는 횟수를 확 줄였다. 비서를 만들어 놓고 눈치를 보면서 쓰는 이상한 상황이 됐다.
LFM2.5 를 보고 바로 든 생각은 단순했다. 서버에 로컬 모델을 올리고 Hermes Agent 에 연결하면, 전기세 말고는 비용이 들지 않는다.
LFM2.5-2.6B 는 어떤 모델인가
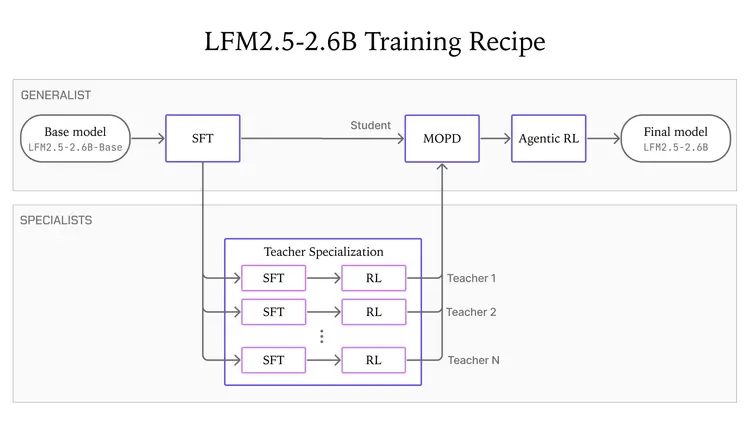
출처: Liquid AI 공식 블로그
LFM2.5-2.6B 는 Liquid AI 가 2026년 8월 4일에 공개한 2.69B 파라미터 모델이다. 공식 소개의 방향은 분명하다. 휴대폰이나 노트북 안에서 에이전트를 돌리는 것. 공식 자료 기준으로 Q4_K_M 양자화 모델이 메모리를 2.5GB 도 쓰지 않고, 갤럭시 스마트폰에서 초당 30 토큰, Apple M5 Max 에서 초당 220 토큰이 나온다.
트랜스포머만 쌓지 않았다
30개 층 중 22개는 계산이 가벼운 합성곱(short convolution) 블록이고, 먼 거리의 문맥을 봐야 하는 8개 층에만 어텐션(GQA)을 넣었다. 비싼 어텐션을 꼭 필요한 곳에만 써서 전체 계산량을 줄인 하이브리드 구조다.
이전 모델들보다 컨텍스트는 32K 에서 128K 로, 어휘는 65K 에서 128K 로 늘었다. 어휘를 늘린 건 비라틴 문자 언어를 더 잘 지원하기 위해서다. 한국어를 포함해 16개 언어를 지원한다.
에이전트로 쓰라고 만든 모델
학습 과정에서 가장 눈에 띈 건 마지막 단계다. 사후학습은 네 단계로 진행됐다.
- 지도 미세조정(SFT) 2회
- 지시 따르기, 수학, 코드, 도구 사용 같은 분야별 교사 모델 학습
- 학생 모델이 스스로 만든 답을 분야별 교사에게 배우는 증류(MOPD)
- 실제 에이전트 하네스 안에서 여러 턴에 걸친 강화학습
4번에 쓰인 하네스 이름에 Hermes Agent 가 있었다. 내가 서버에 깔아 둔 바로 그 에이전트다. 처음부터 그 안에서 굴려 가며 학습한 모델이라는 뜻이라, 찾던 조건에 딱 맞았다.
숫자로 보면
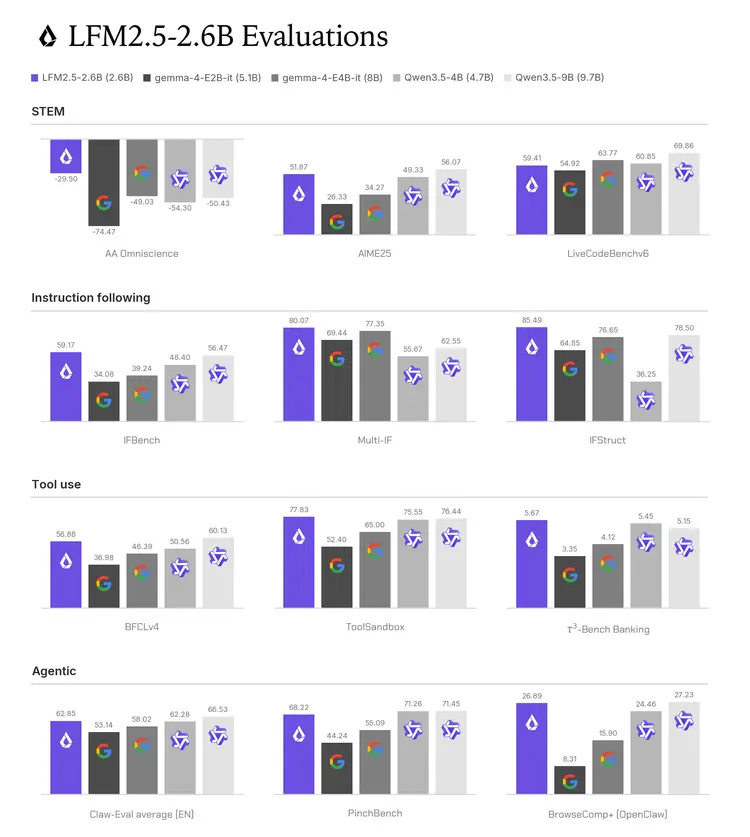
출처: Liquid AI 공식 블로그
공식 벤치마크에서 지시 따르기(IFBench 59.17, Multi-IF 80.07)와 도구 사용(ToolSandbox 77.83)은 3배 넘게 큰 Qwen3.5-9B 보다 높다. 반대로 코딩(LiveCodeBenchv6 59.41)은 비슷한 크기의 모델보다 낮다. 공식 문서도 에이전트 작업, 도구 호출, 데이터 추출, RAG 에는 권장하고, 코딩과 지식을 많이 요구하는 작업은 권장하지 않는다.
내가 하려는 일은 딱 권장 쪽이었다. 비서가 도구를 부르고, 문서를 찾아 답하는 일이다.
그런데 라즈베리파이는?
라즈베리파이 이야기는 VentureBeat 기사에 나온다. Liquid AI 의 Maxime Labonne 는 가장 좋은 예로 라즈베리파이를 들면서, 라즈베리파이에서 꽤 빠르게 동작하는 데모가 많다고 말했다.
다만 얼마나 빠른지는 어디에도 없었다. 공식 블로그와 모델 카드에 공개된 수치는 M5 Max, Ryzen AI Max+, 스마트폰까지다. 라즈베리파이에서 초당 몇 토큰이 나오는지, 메모리를 얼마나 쓰는지는 내가 직접 측정해야 했다.
만들기로 한 것
내가 사용하는 장비들은 모두 제각각이다. 노트북, 데스크톱, 라즈베리파이 5, 우분투 서버, 윈도우 서버, 그리고 Oracle Cloud A1 서버. 장비마다 모델을 따로 설치하면 설정이 제각각이 되고, 나중에는 어디서 뭘 바꿨는지 모르게 된다.
그래서 구조를 이렇게 정했다.
docker-compose.yml은 하나로 고정한다- 장비별 차이(스레드 수, 코어 제한, 메모리, 외부 공개 여부)는
.env에만 둔다 - 엔진은 llama.cpp 공식 서버 이미지를 그대로 쓴다. OpenAI 호환 API 와 Web UI 가 같이 따라온다
Hermes Agent든 백엔드든 OpenAI 호환 API 만 있으면 주소를 바꿔 연결할 수 있다. 그게 llama.cpp 서버를 고른 이유다.
테스트하면서 만난 것들
첫 테스트는 노트북(Core Ultra 7 258V)에서 했다.
이미지가 없다
처음에 ghcr.io/ggerganov/llama.cpp 이미지를 받으려 하니 manifest unknown 이 떴다. llama.cpp 저장소가 ggml-org 조직으로 옮겨 가면서 이미지 주소도 바뀌어 있었다. ghcr.io/ggml-org/llama.cpp 로 바꾸니 해결됐다.
모델을 못 알아본다
LFM2.5 GGUF 는 llama.cpp b10262 빌드로 양자화됐다. 그보다 오래된 빌드에서는 unknown model architecture 로 서버가 뜨지 않는다. 최신 태그를 막 쓰면 언젠가 또 깨질 수 있어서, 확인된 빌드 b10423 으로 고정했다.
생각을 끌 수 없는 모델
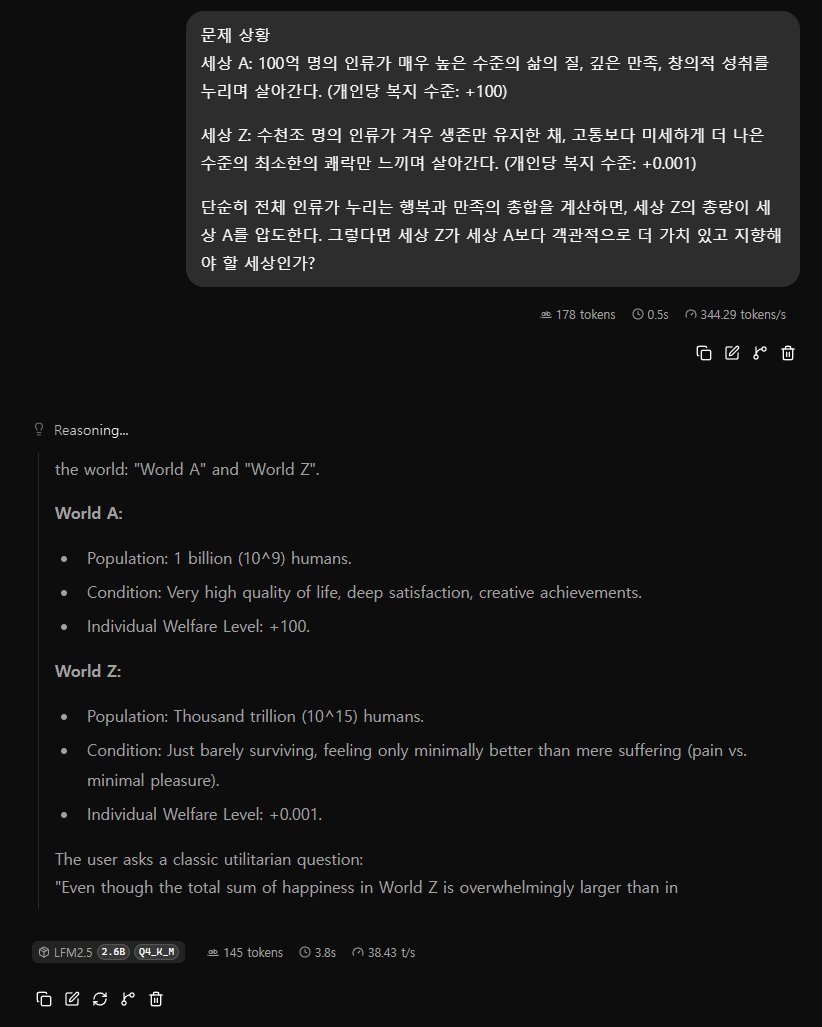
LFM2.5-2.6B 는 답하기 전에 항상 <think> 블록부터 만든다. 끄는 옵션이 없다. 그대로 두면 응답의 content 에 " The user is asking..." 으로 시작하는 사고 과정이 통째로 들어온다. 기존 OpenAI 클라이언트를 연결하면 사용자에게 모델의 혼잣말까지 보여 주게 된다.
.env 의 REASONING_FORMAT=deepseek 설정(컨테이너 안에서는 LLAMA_ARG_THINK)으로 사고 과정을 reasoning_content 로 분리했다. 적용하니 content 에는 32자짜리 답변만, reasoning_content 에는 1,032자짜리 사고 과정이 담겼다. 이름 때문에 헷갈렸는데, deepseek 은 DeepSeek 모델과 관계없는 출력 포맷 이름이다.
답변이 빈 문자열로 온다
이 모델을 쓸 때 가장 주의해야 할 부분이다. 분명 finish_reason 이 돌아오는데 content 가 비어 있었다.
원인은 max_tokens 였다. 이 값에는 사고 토큰까지 포함된다. 한도가 작으면 모델이 생각만 하다가 토큰을 다 쓰고, 답은 한 글자도 못 쓴 채 끝난다. 한국어 질문으로 측정해 보니 400 에서는 사고 1,083자, 답변 0자였다. 1,024 로 올리니 답변 182자가 나왔다.
그런데 1,024 도 안전하지 않았다. "라즈베리파이5 주의점 2가지만 짧게" 라는 짧은 질문에서 사고가 1,005 토큰을 넘었고, 답변은 또 0자였다. 같은 질문을 2,048 로 보내니 정상적으로 끝났다. 질문이 짧다고 생각이 짧은 게 아니었다.
클라이언트가 max_tokens 를 어떻게 보낼지는 내가 통제할 수 없다. 그래서 서버 쪽에서 사고 길이를 자르는 THINK_BUDGET 을 찾았다. 384 로 두니 답변이 35자에서 잘렸고, 256 으로 두니 max_tokens=400 요청에서도 216자짜리 답변이 정상적으로 나왔다. 저사양 장비에는 256 을 기본으로 두기로 했다.
restart 로는 설정이 바뀌지 않는다
스레드 수를 바꿔 가며 테스트하는데 결과가 그대로였다. .env 에서 THREADS=2 로 바꾸고 docker compose restart 를 해도 컨테이너 안의 값은 6 그대로였다. .env 는 컨테이너를 만들 때 적용되기 때문에, 재시작이 아니라 docker compose up -d --force-recreate 로 새로 만들어야 한다.
스레드는 많을수록 빠르지 않았다
노트북은 3, 4, 6, 8 스레드에서 각각 21.4, 23.9, 25.1, 18.8 tok/s 가 나왔다. 8 스레드가 가장 느렸다. Lunar Lake 는 P코어 4개와 LP-E코어 4개로 되어 있는데, 스레드를 전부 채우면 느린 LP-E 코어가 전체 속도를 붙잡는다.
모델을 불러오는 방식도 비교했다. mmap 방식은 메모리를 1.28GiB 만 쓰지만, 띄운 직후 첫 요청이 3 tok/s 까지 떨어졌다. 엔진이나 볼륨 마운트 문제처럼 보였지만, 원인은 mmap 의 페이지 폴트였다. 전체를 RAM 에 올리는 none 방식은 1.70GiB 를 쓰는 대신 첫 요청부터 제 속도가 나서 기본값으로 정했다.
그리고 멈췄다
여기까지 하고 다른 일이 들어와서 프로젝트를 멈췄다. 노트북에서 동작하는 것까지는 확인했지만, 원래 목적이었던 라즈베리파이와 서버에서는 아직 제대로 돌려 보지 못한 상태였다.
다음 편
9월에 다시 시작하면서 장비별로 속도를 측정했다. 데스크톱 CPU 에서 스레드를 32개 줬더니 3 tok/s 가 나온 일, RTX 5070 에서 259 tok/s, 라즈베리파이 5 에서 7 tok/s 가 나오기까지의 과정을 2편에 정리한다.
- GitHub : lfm2.5-universal-stack
- Gitbook : LFM2.5 Universal Stack
- 2편 : LFM2.5 개발기 2편
- 참고 : Hugging Face 모델 카드, Liquid AI 공식 블로그, 파이토치 한국 사용자 모임 소개글, venturebeat 기사 원문