- GitHub : lfm2.5-universal-stack
- Gitbook : LFM2.5 Universal Stack
1편에서는 LFM2.5-2.6B 를 알게 된 계기와 모델 소개, 노트북에서 테스트하며 만난 문제들을 정리했다. 이번 편은 9월에 프로젝트를 다시 꺼내서, 원래 목적이었던 여러 장비에서 실제로 돌려 본 이야기다.
프로젝트를 다시 시작하려고 하니... 컨테이너가 계속 재시작했다
저장소를 새 폴더로 옮기고 docker compose up -d 를 했더니 컨테이너가 재시작을 반복했다. 로그를 보니 failed to open GGUF file. 모델 파일은 .gitignore 로 빼 두었기 때문에 저장소만 옮기면 models/ 가 비어 있다. 다운로드 스크립트를 먼저 돌려야 했다. 당연한 순서인데 오랜만에 꺼내니 잊고 있었다.
채팅 API 로는 속도를 비교할 수 없었다
장비끼리 속도를 비교하려고 보니 문제가 있었다. 이 모델은 질문마다 생각하는 양이 다르다. 같은 질문도 매번 사고 토큰 수가 달라서, 채팅 API 로 측정하면 결과가 들쭉날쭉하다.
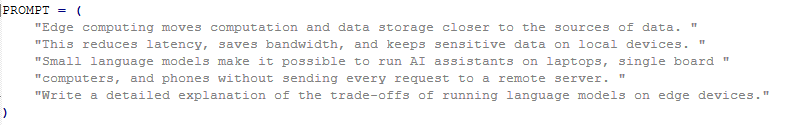
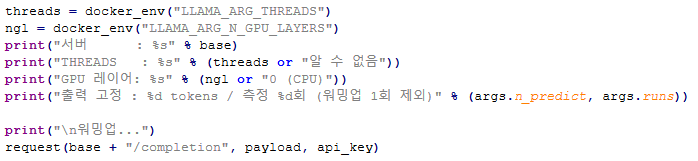
그래서 측정용 스크립트 bench.py 를 따로 만들었다.
- 채팅 템플릿을 거치지 않는
/completion엔드포인트에 같은 프롬프트를 보낸다 ignore_eos로 출력을 256 토큰에 고정한다- 워밍업 1회 뒤 3회 측정해서 평균을 낸다
- 파이썬 표준 라이브러리만 써서, 라즈베리파이에서도 따로 설치할 게 없다
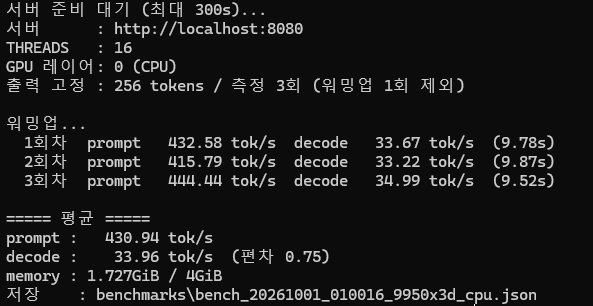
측정값은 두 가지를 본다. 입력을 처리하는 속도(prompt)와 답변을 만들어 내는 속도(decode). 대화할 때 체감되는 건 decode 쪽이다.
32 스레드를 줬더니 3 tok/s
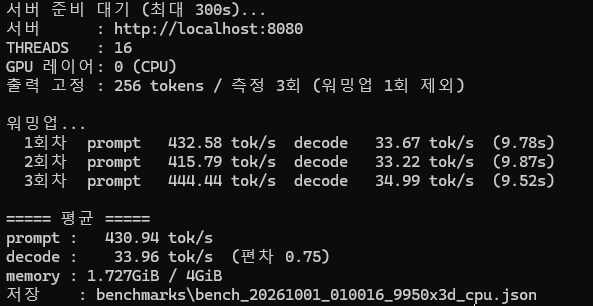
첫 측정 대상은 데스크톱이다. Ryzen 9 9950X3D 는 16코어 32스레드라서, 스레드를 늘려 가며 측정했다.
| THREADS | 6 | 8 | 12 | 16 | 24 | 32 |
|---|---|---|---|---|---|---|
| decode tok/s | 35.0 | 35.9 | 38.9 | 39.4 | 29.6 | 3.1 |
16 까지는 조금씩 빨라졌다. 24 에서는 오히려 느려지고 측정할 때마다 값이 크게 흔들렸다. 32 에서는 3.1 tok/s, 한 번 측정하는 데 1분이 넘게 걸렸다.
CPU 가 32스레드인데 왜 32 에서 급격히 느려지는지 원인을 찾아보니, 컨테이너가 쓸 수 있는 CPU 개수가 달랐다. Windows 의 Docker Desktop 은 WSL2 가상 머신 안에서 컨테이너를 돌린다. docker info --format '{{.NCPU}}' 로 확인해 보니 그 VM 에 할당된 CPU 는 24개였다. 예전에 다른 작업을 하면서 .wslconfig 에 WSL2 의 CPU 를 24개로 제한해 둔 것이 그대로 남아 있었다. 24개밖에 없는 CPU 에 스레드 32개를 올리니, 스레드끼리 CPU 를 서로 뺏으면서 속도가 느려진 것이다.
노트북에서 8 스레드가 느렸던 것과 원인은 다르지만 결론은 같다. 스레드 수는 코어 수만 보고 정하면 안 된다. Docker Desktop 이라면 VM 이 가진 CPU 개수가 기준이다. 데스크톱 프로파일은 16 으로 정했다.
같은 16 스레드라도 다른 날 다시 측정했을 때는 34.0 tok/s 가 나왔다. 측정 시점에 따라 이 정도 차이는 난다.
GPU 는 옵션으로 붙였다
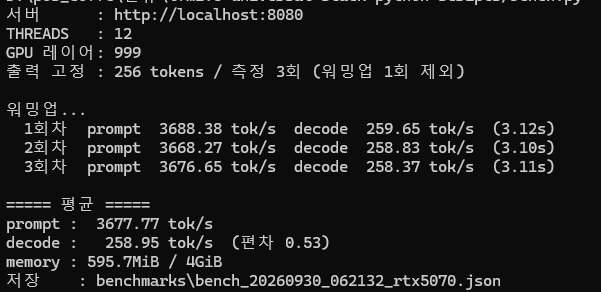
데스크톱에는 RTX 5070 이 있다. 원래는 CPU 로만 동작하게 되어있었지만, GPU 가 있으면 사용할 수 있게 옵션을 추가했다.
기본 docker-compose.yml 은 건드리지 않고, 덮어쓰는 파일 docker-compose.gpu.yml 을 따로 만들었다. 이 파일은 이미지를 CUDA 빌드(server-cuda-b10423)로 바꾸고, GPU 를 붙이고, 모델 레이어를 전부 GPU 에 올리는 일만 한다. 실행할 때 -f docker-compose.yml -f docker-compose.gpu.yml 을 붙이면 GPU 로, 빼면 CPU 로 돈다.
RTX 5070 은 최신 아키텍처(Blackwell)라 CUDA 빌드 호환부터 확인해야 했는데, 공식 CUDA 12 빌드 이미지에서 문제없이 동작했다.
결과는 decode 259.0 tok/s, prompt 3,677.8 tok/s. 같은 PC 의 CPU 보다 decode 가 약 7.6배 빠르다. 모델 전체를 GPU 에 올려도 VRAM 은 2GB 정도만 썼다. 모델이 작다는 게 이런 데서 체감된다.
라즈베리파이
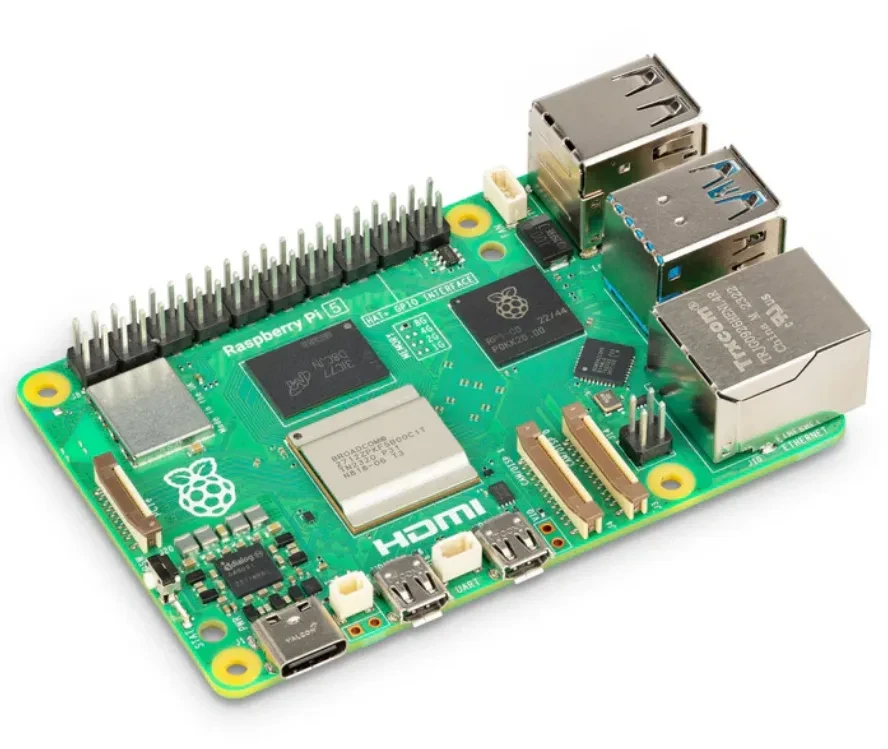
라즈베리파이 5 8GB, OS 는 Raspberry Pi OS (Debian 13 trixie, 64비트)다. 확실히 느리긴 하지만 동작은 한다.
sh 로 실행했더니 Bad substitution
download_model 스크립트를 sh로 실행하자 Bad substitution 오류가 났다.
라즈베리파이 OS 의 sh 는 bash 가 아니라 dash 다. 스크립트는 ${BASH_SOURCE[0]} 같은 bash 문법으로 스크립트 위치를 찾는데, dash 는 이걸 읽지 못해서 경로가 비어 버렸다. bash download_model.sh 로 실행하니 정상적으로 동작하였다.
3 코어로 측정했다
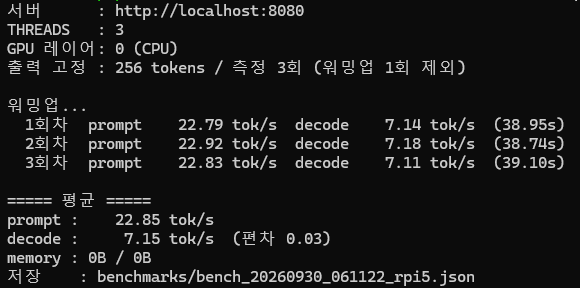
라즈베리파이 5 는 4코어다. (코어 1개가 스레드 1개다) 현재 다른 서비스가 가동 중이라 코어 3개를 모델에 적용하고, 나머지 코어 1개는 다른 서비스용으로 남겨두었다. 측정 결과는 decode 7.1 tok/s, prompt 22.8 tok/s 다.
저장소의 라즈베리파이 프로파일 예시에는 4 코어를 적어 두었다. 다른 서비스 없이 이 모델만 가동할 때를 기준으로 한 값이다.
메모리가 0B 로 나온다
docker stats 로 메모리를 보려는데 0B / 0B 가 나왔다. docker info 를 보니 No memory limit support 경고가 있었다. 라즈베리파이 OS 는 기본 설정에서 Docker 의 메모리 제한 기능(memory cgroup)이 꺼져 있다. 이 상태면 .env 에 적은 MEM_LIMIT 도 적용되지 않는다.
메모리는 프로세스에서 직접 확인했다. llama-server 가 약 1.92GiB 를 쓰고 있었다. 8GB 라즈베리파이에서는 여유가 충분하다.
7 tok/s 면 쓸 만한가
초당 7 토큰은 사람이 글을 읽는 속도와 비슷하다. 답변이 나오기 시작하면 대화하는 데 답답하지 않다.
문제는 답변이 나오기 전이다. 이 모델은 항상 생각부터 한다. 사고를 256 토큰으로 잘라도, 7 tok/s 로는 첫 글자가 나오기까지 30초가 넘게 걸린다. 1편에서 정한 THINK_BUDGET=256 은 라즈베리파이에서는 선택이 아니라 필수에 가깝다. 실시간 대화보다는 디스코드 봇처럼 조금 기다려도 되는 용도가 맞다.
모델 파일이 바뀌어 있었다
측정을 정리하다가 모델 파일 크기가 저장소에 적어 둔 값보다 192바이트 크다는 걸 발견했다. sha256 도 달랐다.
Hugging Face 를 확인해 보니 Liquid AI 가 9월 22일에 GGUF 파일을 새로 올려 두었다. 받은 파일의 sha256 은 새 파일 값과 정확히 같았다. 파일이 깨진 게 아니라 원본이 갱신된 것이다.
다운로드 스크립트는 Hugging Face API 에서 기대값을 받아 검증한다. 다만 API 조회에 실패하면 스크립트에 적어 둔 예비값을 쓰는데, 이 예비값이 8월 파일 기준이라 새 파일을 검증 실패로 판단하게 된다. 예비값을 새 파일 기준으로 바꿨다. 공개 모델은 올린 쪽에서 언제든 바뀔 수 있다는 걸 체감했다.
쓰면서 본 모델의 특징
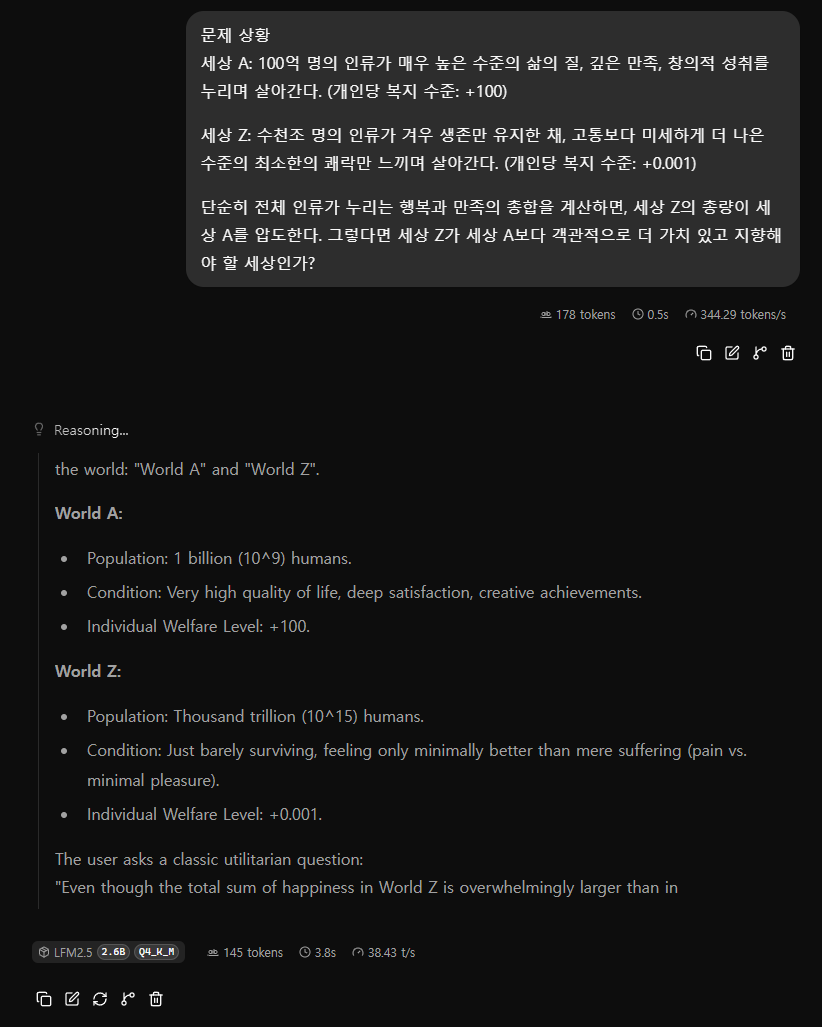
- 생각은 영어로 한다. 한국어로 물어봐도 사고 과정은 대부분 영어로 나오고, 답변만 한국어로 나온다.
- 숫자 단위를 틀린다. 숫자가 많은 한국어 질문에서 "100억 명" 을 사고 과정에서 "1 billion" 으로 옮겼다. 10억이다. 한국어의 만 단위를 영어로 바꾸는 과정에서 생긴 실수로 보인다.
결과
| 장비 | 실행 방식 | prompt (tok/s) | decode (tok/s) | 메모리 |
|---|---|---|---|---|
| RTX 5070 (+ 9950X3D) | GPU | 3,677.8 | 259.0 | RAM 0.6 GiB + VRAM 약 2GB |
| Ryzen 9 9950X3D | CPU 16 스레드 | 430.9 | 34.0 | 1.73 GiB |
| Core Ultra 7 258V | CPU 6 스레드 | - | 25.1 | 1.70 GiB |
| 라즈베리파이 5 8GB | CPU 3 스레드 | 22.8 | 7.1 | 1.92 GiB |
공식 수치(M5 Max 220 tok/s, Ryzen AI Max+ 395 113 tok/s)와 비교하면 내 CPU 결과는 낮다. 장비도 측정 도구도 다르고, 나는 Docker Desktop 위에서 측정했으니 바로 비교할 수는 없다. 대신 같은 스택, 같은 스크립트로 공정하게 비교했다.
배운 것
- 스레드는 코어 수를 넘기지 않는다. Docker Desktop 이라면 VM 의 CPU 개수가 기준이다. 넘기면 조금 느려지는 게 아니라 급격히 느려진다.
- 추론 모델은 max_tokens 부터 의심한다. 답이 비어 있으면 모델이 아니라 토큰 한도 문제일 가능성이 크다.
- 측정은 조건부터 고정한다. 사고 길이가 매번 다른 모델을 채팅 API 로 측정하면 비교가 안 된다.
- 작은 모델은 GPU 가 크지 않아도 된다. VRAM 2GB 면 전부 올라간다.
다음
- 개인비서 : Hermes Agent 의 API 를 Gemini 에서 이 로컬 모델로 바꾼다. 지금 가동 중인 LLM Wiki MCP 와, 만들고 있는 서버 통합관리 MCP 까지 연결하면 비용 걱정 없이 쓰는 비서가 된다.
마치며
스레드에서 본 "라즈베리파이에서 가동이 된다" 는 말은 사실이었다. 초당 7 토큰, 메모리 2GB 가 안 되는 수준으로 돌아간다. 다만 가동이 된다는 것과 쓸 만하다는 건 다른 이야기였다. 첫 답변까지 기다려야 하고, 그 기다림을 어떤 용도에 맞출지는 결국 내가 정해야 한다.
API 비용이 걱정돼서 비서를 아껴 쓰던 입장에서, 전기세만 내면 되는 선택지가 생긴 건 분명한 소득이다. 이제 이 모델에 실제로 일을 시켜 볼 차례다.
- GitHub : lfm2.5-universal-stack
- Gitbook : LFM2.5 Universal Stack
- 1편 : LFM2.5 개발기 1편