LLM Wiki 라는 말을 보았다
LLM Wiki 라는 말을 처음 봤을 때, 또 새로 나온 도구 이름인 줄 알았다. 찾아보니 도구가 아니라 방식이었다.
그리고 LLM 에게 문서를 넘겨줄 때 걸리던 두 가지를 정확히 짚고 있었다.
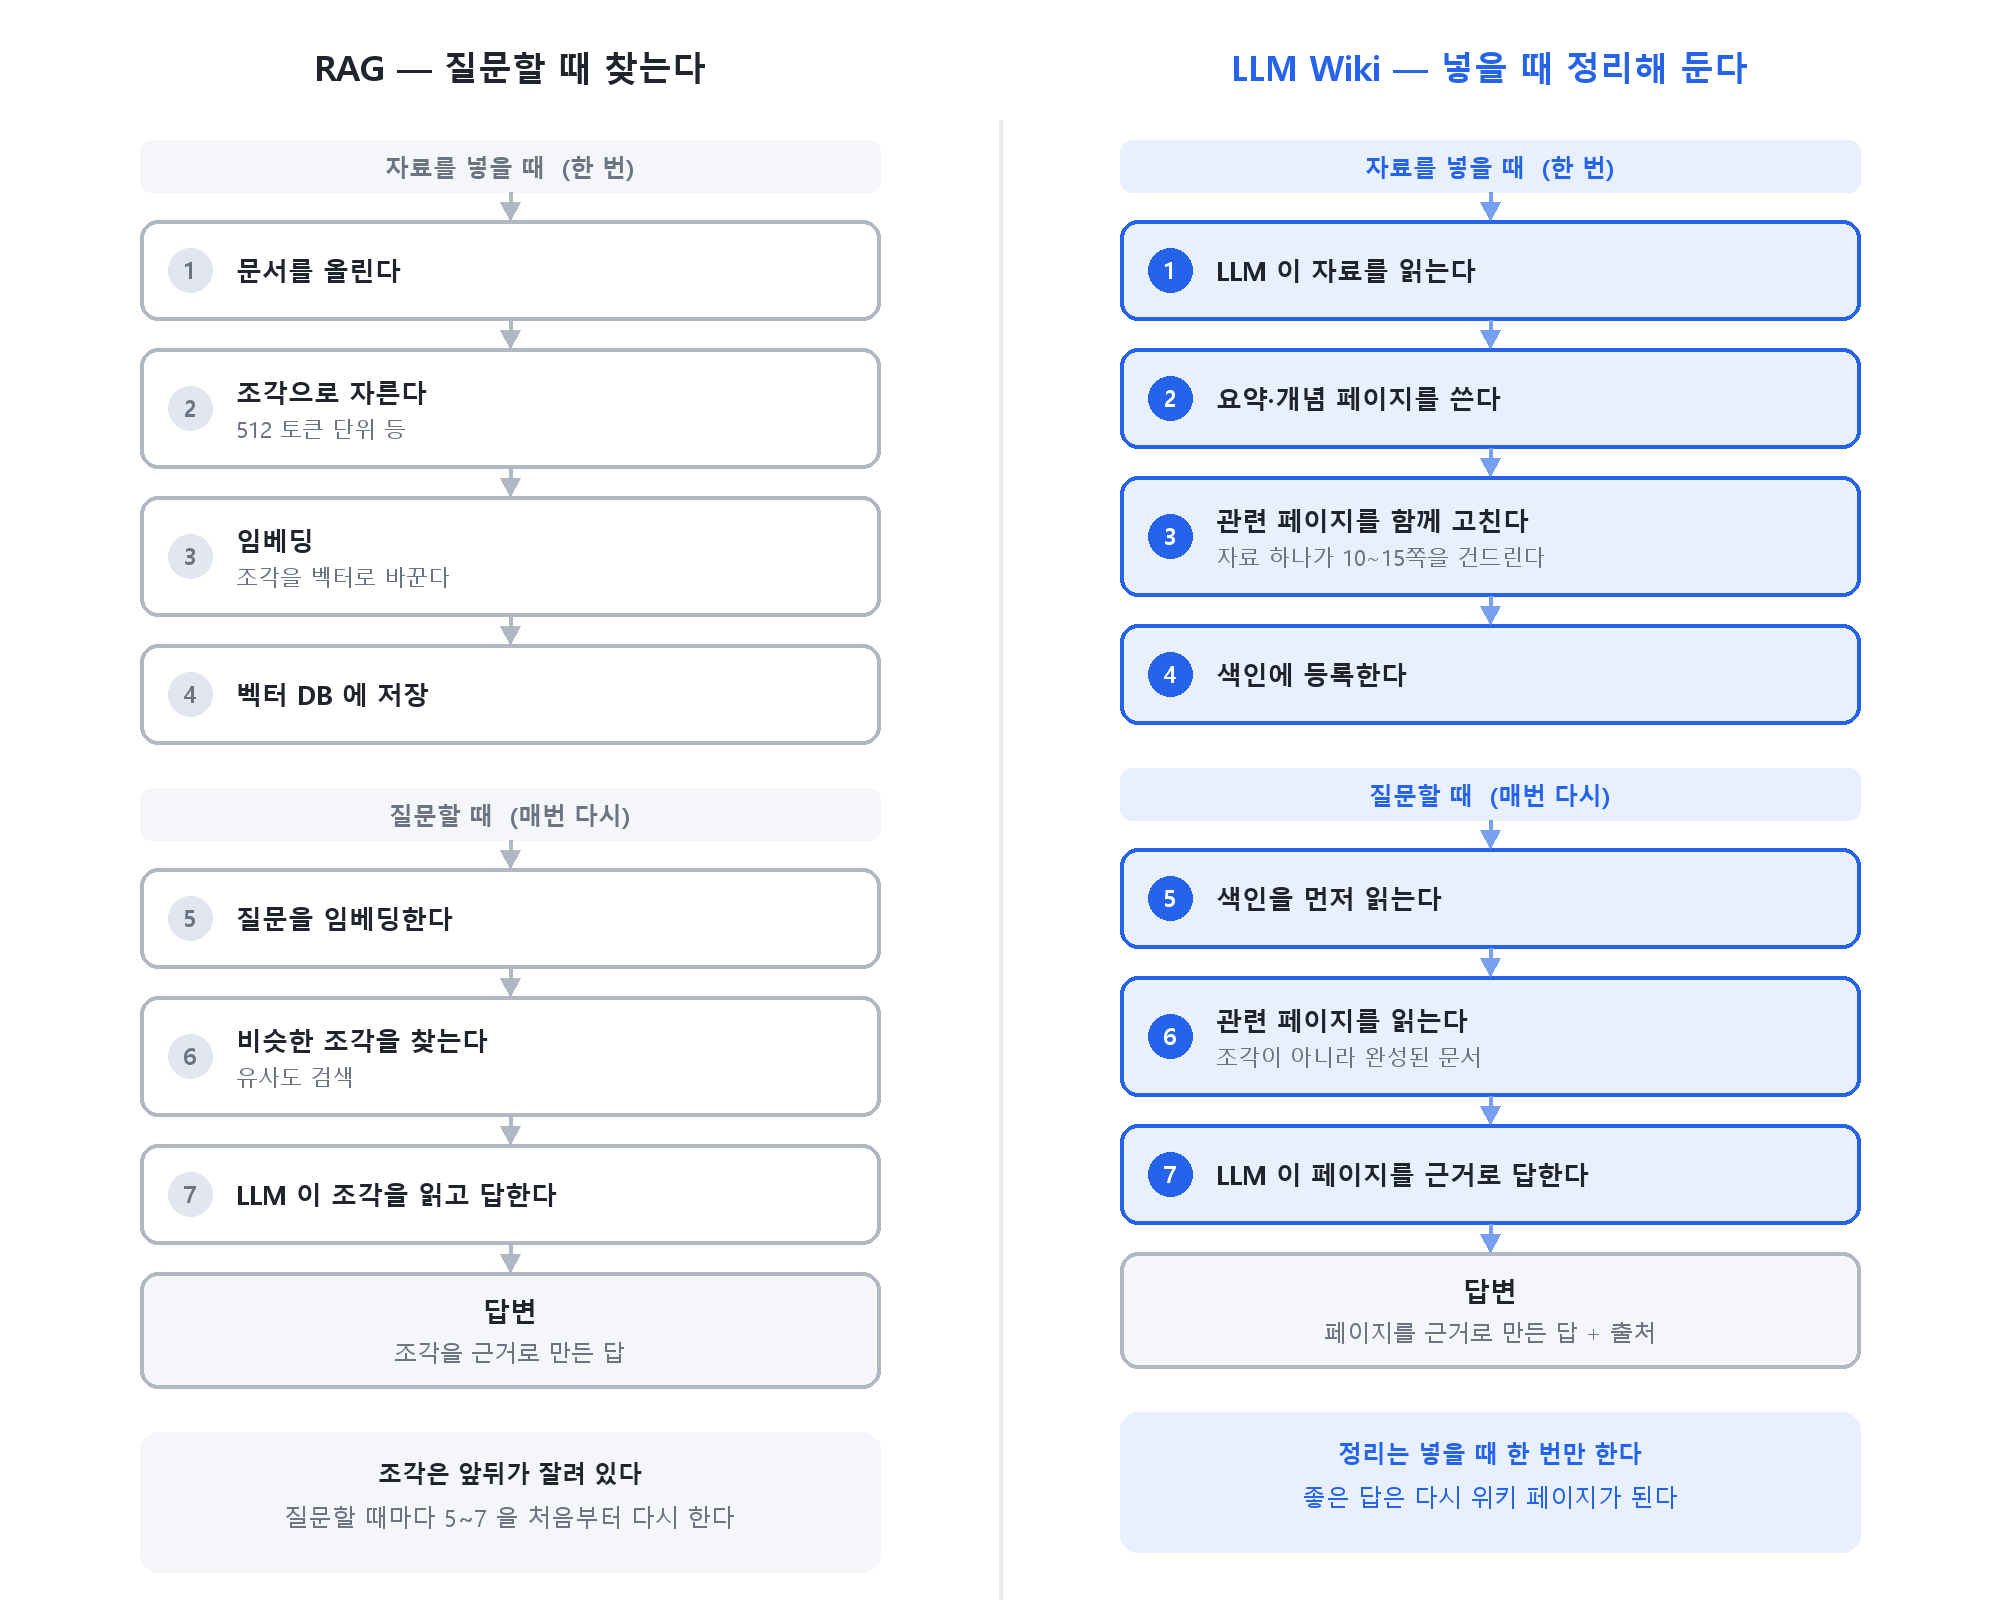
문서를 다루는 흔한 방식은 이렇다. 파일을 올려 두고, 질문하면 시스템이 관련 조각을 찾아 와서, LLM 이 그걸 읽고 답한다. RAG 다. 동작은 한다. 그런데 사용하다 보면 거슬리는 지점이 생긴다.
매번 처음부터다. 어제 답을 찾느라 다섯 문서를 읽었어도, 오늘 같은 질문을 하면 또 처음부터 찾는다. 쌓아 두지 않으면 남는 게 없다. 그래서 같은 질문에 답이 조금씩 달라지기도 한다.
문서를 자르면 맥락이 끊어진다. 긴 문서를 조각으로 자르면, 용어를 정의한 문단과 그 용어를 쓰는 문단이 서로 다른 조각이 된다. 회의록이라면 결정 내용과 그 결정의 이유가 갈라진다. 검색은 관련 있다고 하는데, LLM 은 머리도 꼬리도 없는 문장을 읽는다.
물론 이건 자르는 방식에 달렸다. 문단 단위로 자르거나, 조각을 찾은 뒤 원래 문서를 다시 불러오거나, 메타데이터로 범위를 좁히면 많이 나아진다. 다만 그만큼 설계와 손이 더 든다.
LLM Wiki 는 문서를 정리하는 시점이 다르다. 질문할 때 정리하지 않고, 자료를 위키에 넣을 때 정리한다.
이번 글은 그 방식이 무엇인지, 어떻게 동작하는지, 어디까지 되고 어디서 막히는지 정리한다. 내가 직접 만들어 쓰고 있는 사례는 LLM Wiki 구축기에서 다룬다.
LLM Wiki 란 무엇인가
한 줄로 줄이면 이렇다.
질문을 할 때마다 원본 문서를 다시 검색하는 대신, LLM 이 Markdown 지식베이스를 직접 작성하고 계속 유지하게 하는 방식.
핵심은 정리하는 시점이다. 지식을 질문 시점에 모으느냐, 자료를 받는 시점에 정리해 두느냐.
어디서 나온 말인가
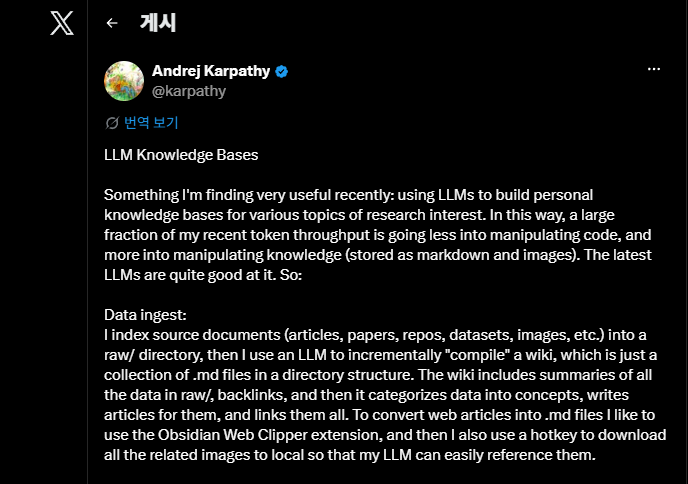
2026년 4월 3일, Andrej Karpathy 가 X 에 자기 작업 방식을 공유했다. 코드를 다루는 데 쓰던 토큰을 지식을 다루는 데 쓰고 있다는 이야기였다.
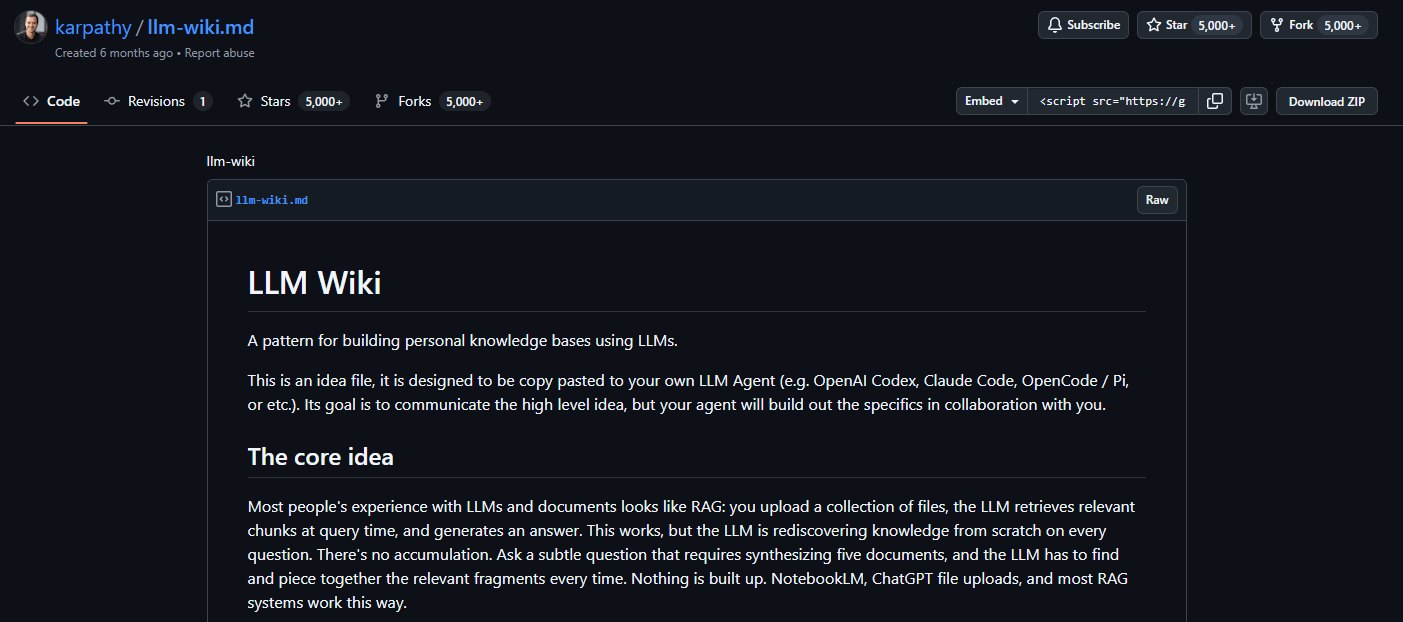
다음 날 그는 GitHub Gist 하나를 올렸다. 제목은 llm-wiki. 실행 코드는 한 줄도 없고 Markdown 문서 한 장이 전부다. 그런데 48시간 만에 별 5,000개가 넘게 붙었다.
Gist 첫머리에 이 문서가 무엇인지 적혀 있다.
"This is an idea file, it is designed to be copy pasted to your own LLM Agent."
(이건 아이디어 파일이고, 당신의 LLM 에이전트에 그대로 복사해 넣으라고 만든 것이다.)
구현체가 아니라 패턴이다. 문서를 에이전트에게 주면 에이전트가 사용자와 상의해 가며 각자의 버전을 만든다. 코드 한 줄 없는 Gist 에 사람들이 몰린 이유가 여기 있다.
그런데 이 말이 여러 뜻으로 쓰인다
용어부터 정리한다. "LLM Wiki" 는 최소 세 가지를 가리킨다.
| 쓰임 | 무엇인가 |
|---|---|
| 설계 패턴 | Karpathy 가 말한 그 방식. 이 글이 다루는 것 |
| CLI, 에이전트 도구 | 코딩 에이전트에 연결해 위키 문서를 자동 생성하는 플러그인 |
| 데스크톱 앱 | 지식 트리와 그래프 뷰를 제공하는 별도 애플리케이션 |
검색하면 셋이 섞여 나온다. 이 글에서 LLM Wiki 는 첫 번째, 설계 패턴만 가리킨다.
구조: 폴더 둘, 파일 하나
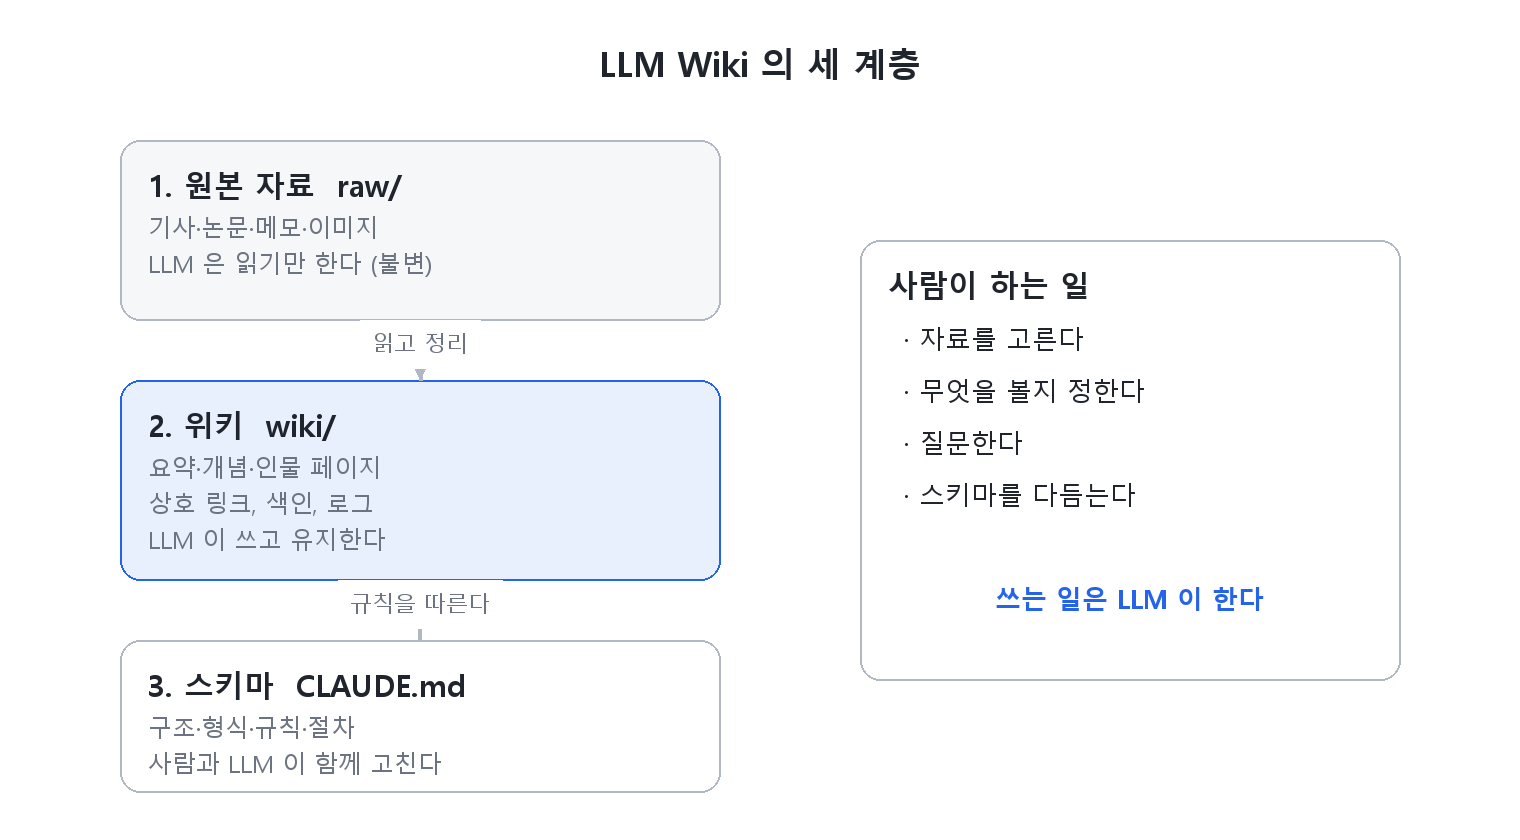
Gist 가 말하는 구조는 단순하다. 폴더 두 개와 파일 한 개라고 봐도 된다.
raw/        원본 자료   — LLM 이 읽기만 한다. 고치지 않는다
wiki/       위키        — LLM 이 쓰고 유지한다. 사람은 읽기만 한다
CLAUDE.md   스키마      — 위키를 어떻게 만들고 유지할지 적은 규칙
(또는 AGENTS.md)
raw/ (원본 자료). 기사, 논문, 이미지, 데이터 파일.
LLM 은 읽기만 하고 고치지 않는다. 위키 내용이 의심될 때 돌아와서 대조하는 위치다.
wiki/ (위키). LLM 이 만든 Markdown 묶음이다. 자료별 요약, 개념, 인물 페이지, 비교, 전체 개요.
상호 링크와 색인까지 LLM 이 관리한다. 자료 하나가 들어오면 페이지 10~15개가 같이 바뀐다.
CLAUDE.md (스키마). Claude Code 면 CLAUDE.md, Codex 면 AGENTS.md 다.
폴더 구조, 페이지 형식, 이름 규칙, 자료를 넣을 때의 절차를 적는다.
Gist 는 이 파일을 핵심 설정 파일이라고 부른다. 이게 있어야 에이전트가 그냥 챗봇이 아니라 규칙이 있는 위키 관리자가 된다.
원문에 나오는 비유가 가장 명확하다.
"Obsidian is the IDE; the LLM is the programmer; the wiki is the codebase."
(옵시디언이 IDE 고, LLM 이 프로그래머고, 위키가 코드베이스다.)
사람은 코드를 읽듯 위키를 읽고, 쓰는 건 LLM 이 한다.
동작 방식: 수집, 질의, 점검
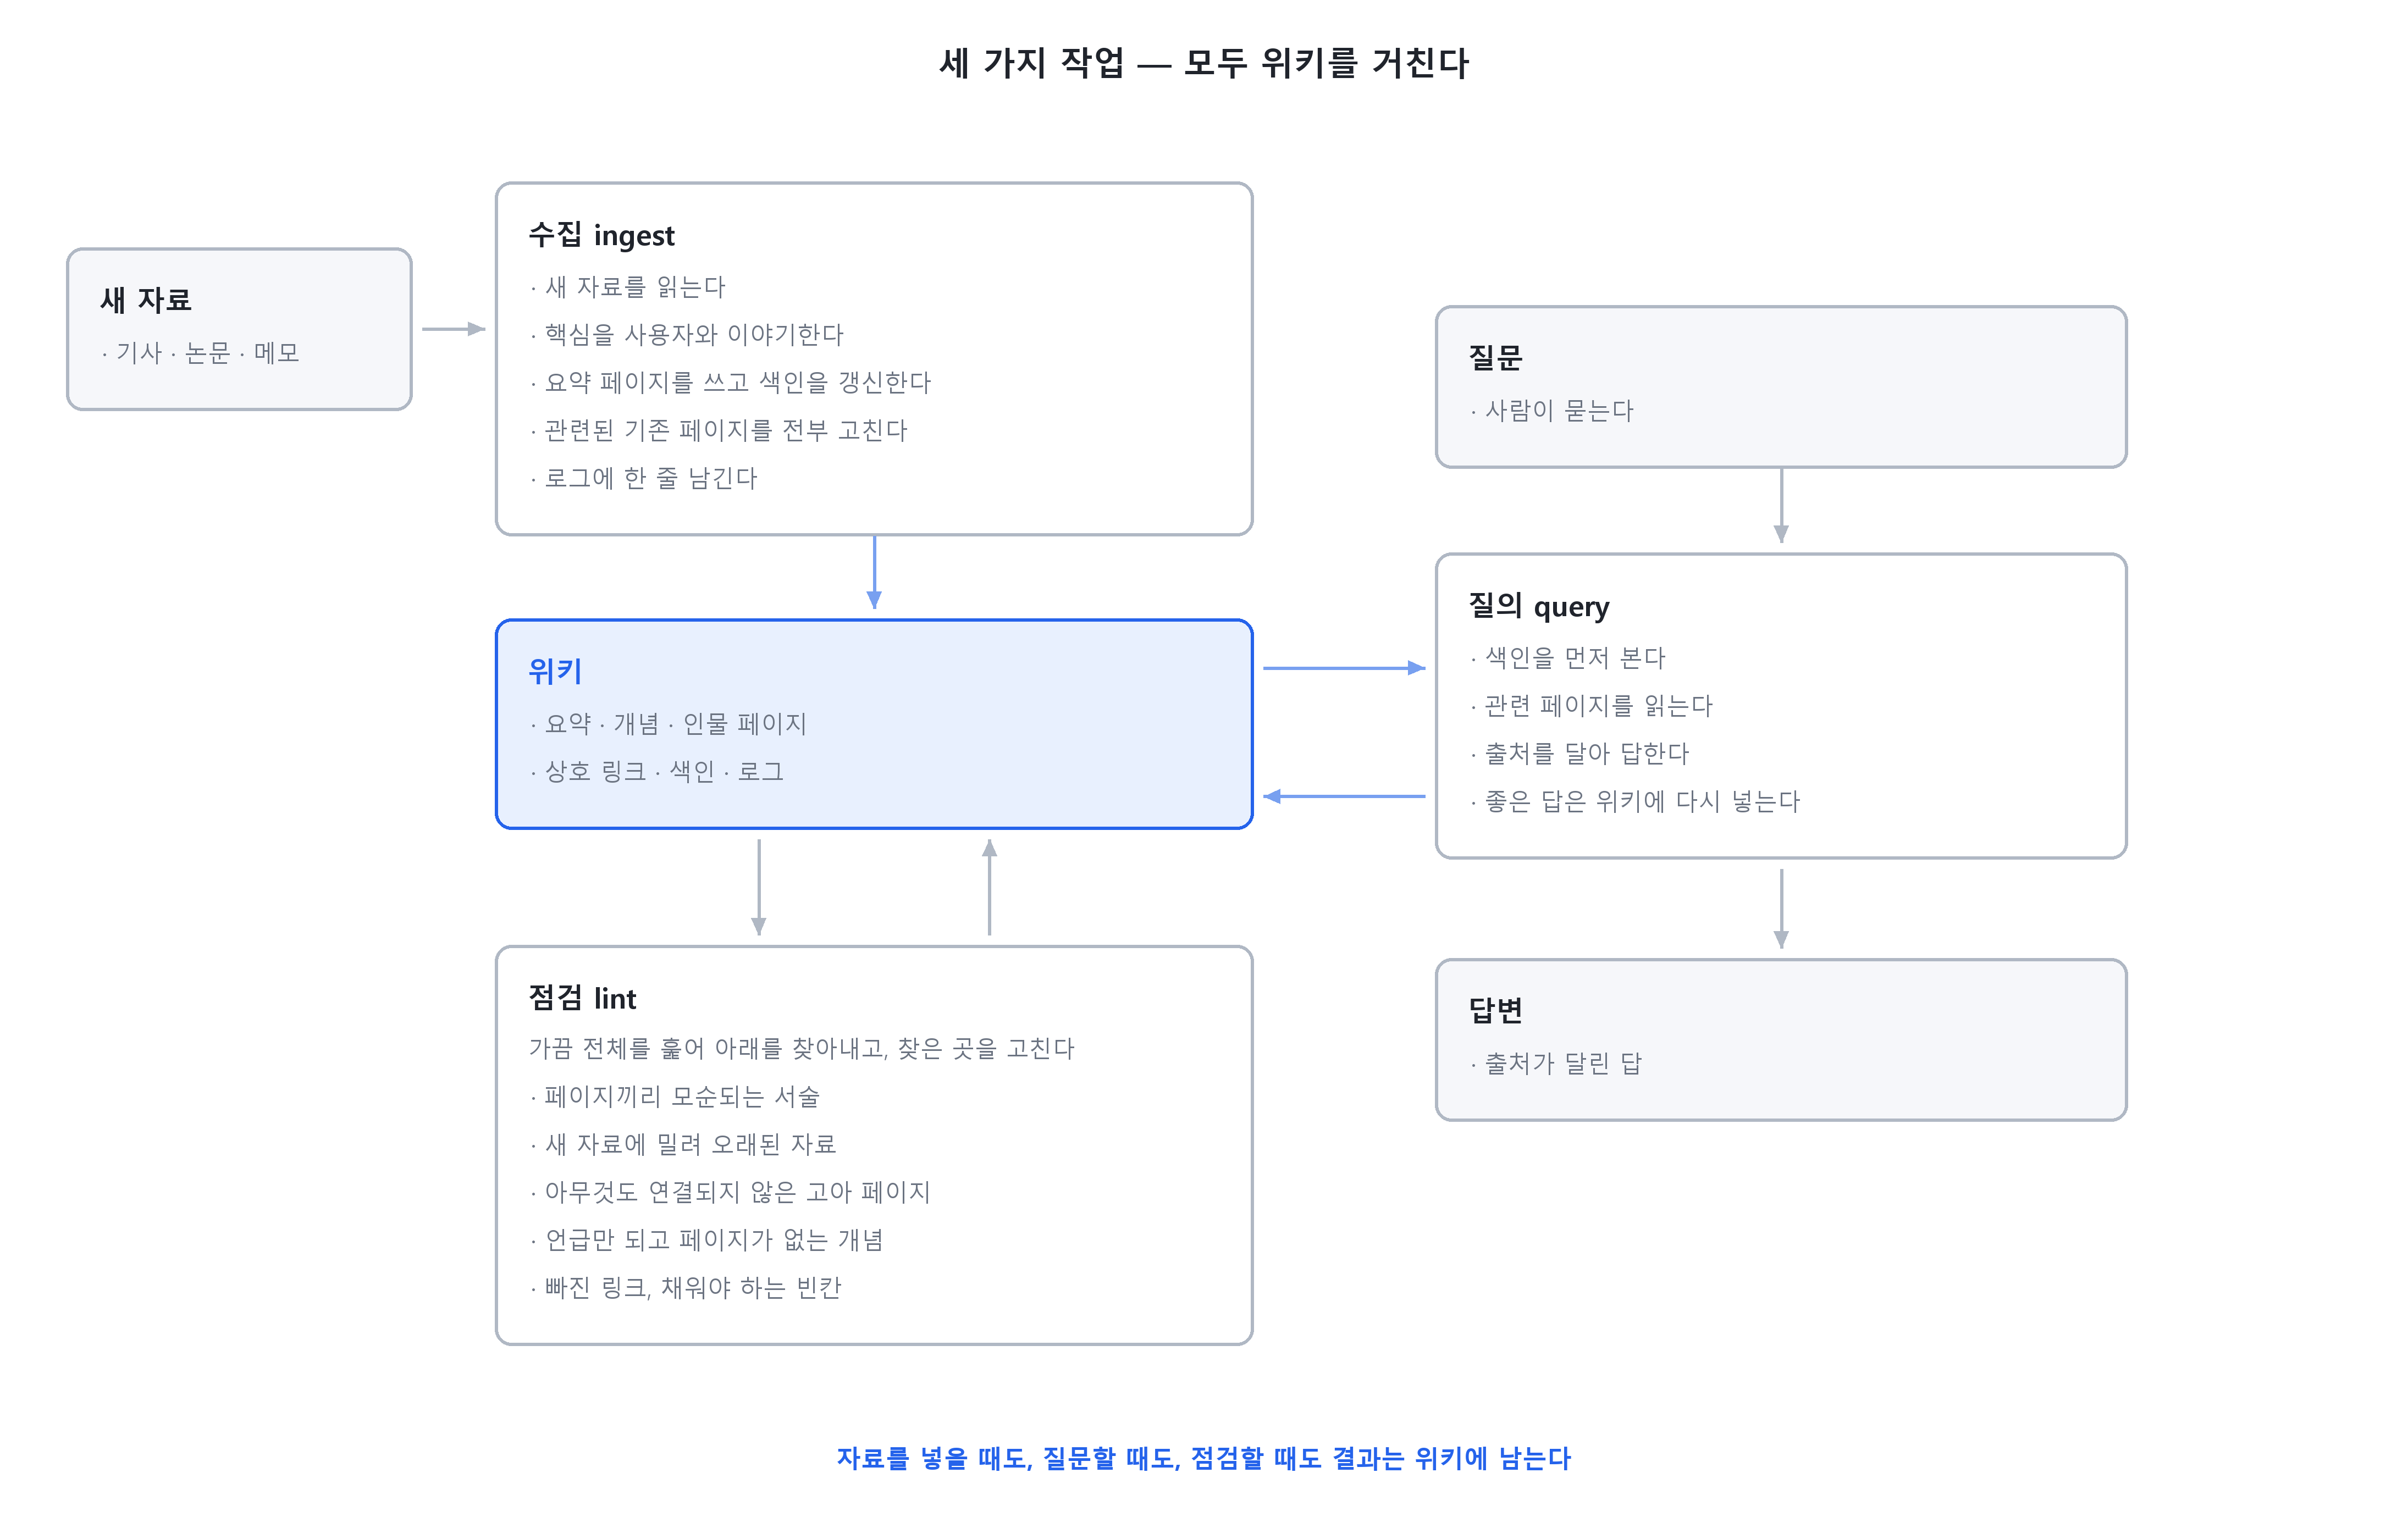
작업은 세 가지뿐이다.
수집 (ingest)
새 자료를 raw/ 에 넣고 LLM 에게 처리를 시킨다. LLM 은 자료를 읽고, 핵심을 사용자와 이야기하고, 요약 페이지를 쓰고, 색인을 갱신하고, 관련된 기존 페이지를 전부 고친다. 그리고 로그에 한 줄 남긴다.
자료 하나를 넣으면 위키 여러 곳이 같이 바뀐다.
질의 (query)
위키에 묻는다. LLM 은 색인을 먼저 보고, 관련 페이지를 읽고, 출처를 달아 완성된 문서를 근거로 답한다.
그리고 한 가지가 더 있다. 좋은 답은 위키에 다시 넣는다.
비교표, 분석, 새로 발견한 연결점 같은 것들을 위키에 남겨 보강한다. 그렇게 위키가 두꺼워진다.
점검 (lint)
가끔 위키 전체를 훑게 한다. 찾는 것은 이렇다.
- 페이지끼리 모순되는 서술
- 새 자료에 밀려 오래된 자료
- 아무것도 연결되지 않은 고아 페이지
- 언급만 되고 페이지가 없는 개념
- 빠진 링크, 채워야 하는 빈칸
위키를 한 번씩 훑어서 어긋난 곳을 찾아내는 작업이다.
색인과 로그
Gist 원문은 특별한 파일 두 개를 둔다.
| 파일 | 성격 | 쓰임 |
|---|---|---|
index.md | 내용 중심 | 전 페이지 목록 + 한 줄 요약. 질의할 때 LLM 이 먼저 읽는 파일 |
log.md | 시간 중심 | 수집, 질의, 점검 기록을 덧붙이기만 함. 위키의 연표 |
색인 파일 하나로 자료 100개, 페이지 수백 개 규모까지는 버틴다는 게 원문의 주장이다. 그 말은 곧 이 규모에서는 벡터 DB 가 필요 없다는 뜻이다.
RAG와 무엇이 다른가
| RAG | LLM Wiki | |
|---|---|---|
| 정리하는 시점 | 질문할 때 | 자료를 넣을 때 |
| LLM 이 읽는 것 | 잘린 조각(chunk) | 완성된 페이지 |
| 지식 누적 | 없음. 매 질문이 처음 | 쌓임. 질문한 것도 남는다 |
| 모순 처리 | 그때그때 | 넣을 때 표시해 둠 |
| 사람이 읽기 | 어려움(벡터) | Markdown 문서 |
| 필요한 것 | 임베딩, 벡터 DB | 폴더와 Markdown 문서 |
| 규모 | 수십만~수백만 문서 | 추린 문서 100~1만 개 |
LLM Wiki 는 원본 조각이 아니라 정리된 페이지를 검색한다.
어느 쪽이 낫다는 이야기가 아니다. 문서가 수십만 건이면 위키 방식은 애초에 불가능하고, 몇백 건을 정확하게 다뤄야 하면 위키 쪽이 편하다. 규모와 용도의 문제다.
그렇다고 RAG 를 안 쓰게 되는 건 아니다. 위키가 커지면 결국 위키 안에서도 검색이 필요해지고, 그때 쓰는 게 하이브리드 검색이다. Gist 도 색인만으로 부족해지면 Markdown 을 검색하는 도구를 연결하라고 한다. 단어로 찾고, 뜻으로 찾고, 그렇게 모은 후보를 LLM 이 다시 정렬하는 방식이다.
달라지는 건 무엇을 찾느냐다. 잘린 조각이 아니라, 정리해 둔 페이지를 찾는다.
한계와 주의점
항상 좋은 점만 있는 건 아니다. 실제로 지적되는 약점은 이렇다.
LLM 품질에 달려 있다. 자료 A 와 B 가 어긋날 때 무엇을 남길지 판단하는 건 LLM 이다. 잘못 판단해도 결과는 멀쩡한 문장으로 남는다. 틀린 걸 알아보기가 더 어렵다.
유지 비용은 0이 아니다. 사람이 손으로 쓰지 않을 뿐, 자료를 넣을 때마다 토큰을 사용한다. 자료 하나가 페이지 10~15개를 건드리면 그만큼 읽고 쓴다.
규모가 커지면 탐색이 문제가 된다. 원문이 말하는 기준은 자료 약 100개, 40만 단어 정도다. 10만, 100만 문서로 가면 색인 파일 한 장으로는 안 된다.
여러 에이전트가 동시에 쓰면 깨진다. 파일 기반이라 권한 분리도, 트랜잭션도, 잠금도 없다. 두 에이전트가 같은 페이지를 고치면 그대로 충돌한다. 개인용 도구로 보는 게 맞다.
캐시를 다시 발명한 것 아니냐는 비판도 있다. 일리가 있다. 미리 정리해 둔 것은 결국 캐시이고, 캐시에는 무효화 문제가 따라온다. 낡은 페이지를 언제 어떻게 갱신할지는 "점검(lint)"에 맡겨져 있다. 이 부분은 자동이 아니라 운영의 몫이다.
자주 하는 오해: LLM Wiki는 MCP인가
MCP가 아니다. 둘은 아예 다른 이야기다.
LLM Wiki 는 지식을 어떻게 정리할지에 대한 방식이다. 남는 것은 Markdown 문서 묶음이고, 폴더만 있으면 만들 수 있다.
MCP 는 AI가 외부 데이터와 도구를 사용할 수 있게 해 주는 연결 통로이다.
그런데도 둘을 같이 말하게 되는 이유가 있다. 위키를 PC 밖에 두는 순간 연결 통로가 필요해지기 때문이다.
휴대폰에서도, 다른 PC 에서도 같은 위키를 쓰려면 그 길을 뚫어야 한다. 그 길로 MCP 를 쓰면 "LLM Wiki + MCP" 가 된다.
Karpathy 의 원문은 MCP 를 전제하지 않는다. 에이전트가 폴더를 직접 읽고 쓰는 구조다. MCP 가 등장하는 건 선택 사항으로 언급되는 검색 도구 정도다.
마치며
이 방식이 눈에 띄는 이유는 새 기술에 있지 않다. Markdown 도 에이전트도 있던 것이다. 바뀐 건 문서 관리를 누가 하느냐다.
1945년 Vannevar Bush 가 상상한 Memex 는 개인이 모은 자료들을 연결하는 장치였다. 그가 못 푼 문제는 그 연결을 누가 계속 갱신하느냐였다. 사람은 지겨워서 위키를 버린다. LLM 은 지겨워하지 않는다.
2편에서는 내가 이 방식을 홈랩에 올린 이야기를 쓴다. 왜 만들게 됐는지, git 저장소를 원본으로 두고 라즈베리파이를 MCP 서버로 격리한 이유, 저장할 때마다 13종 검사를 통과해야만 반영되게 만든 과정이다.
LLM Wiki 구축기 : https://velog.io/@kyeong9743/LLM-Wiki-2
참고 : Karpathy의 llm-wiki Gist 원문 , VentureBeat 소개 기사 , Towards AI 분석 글 , AFFiNE: 용어 정리