Agentic QA 설계: Claude 기반 모바일·웹 Runtime 검증
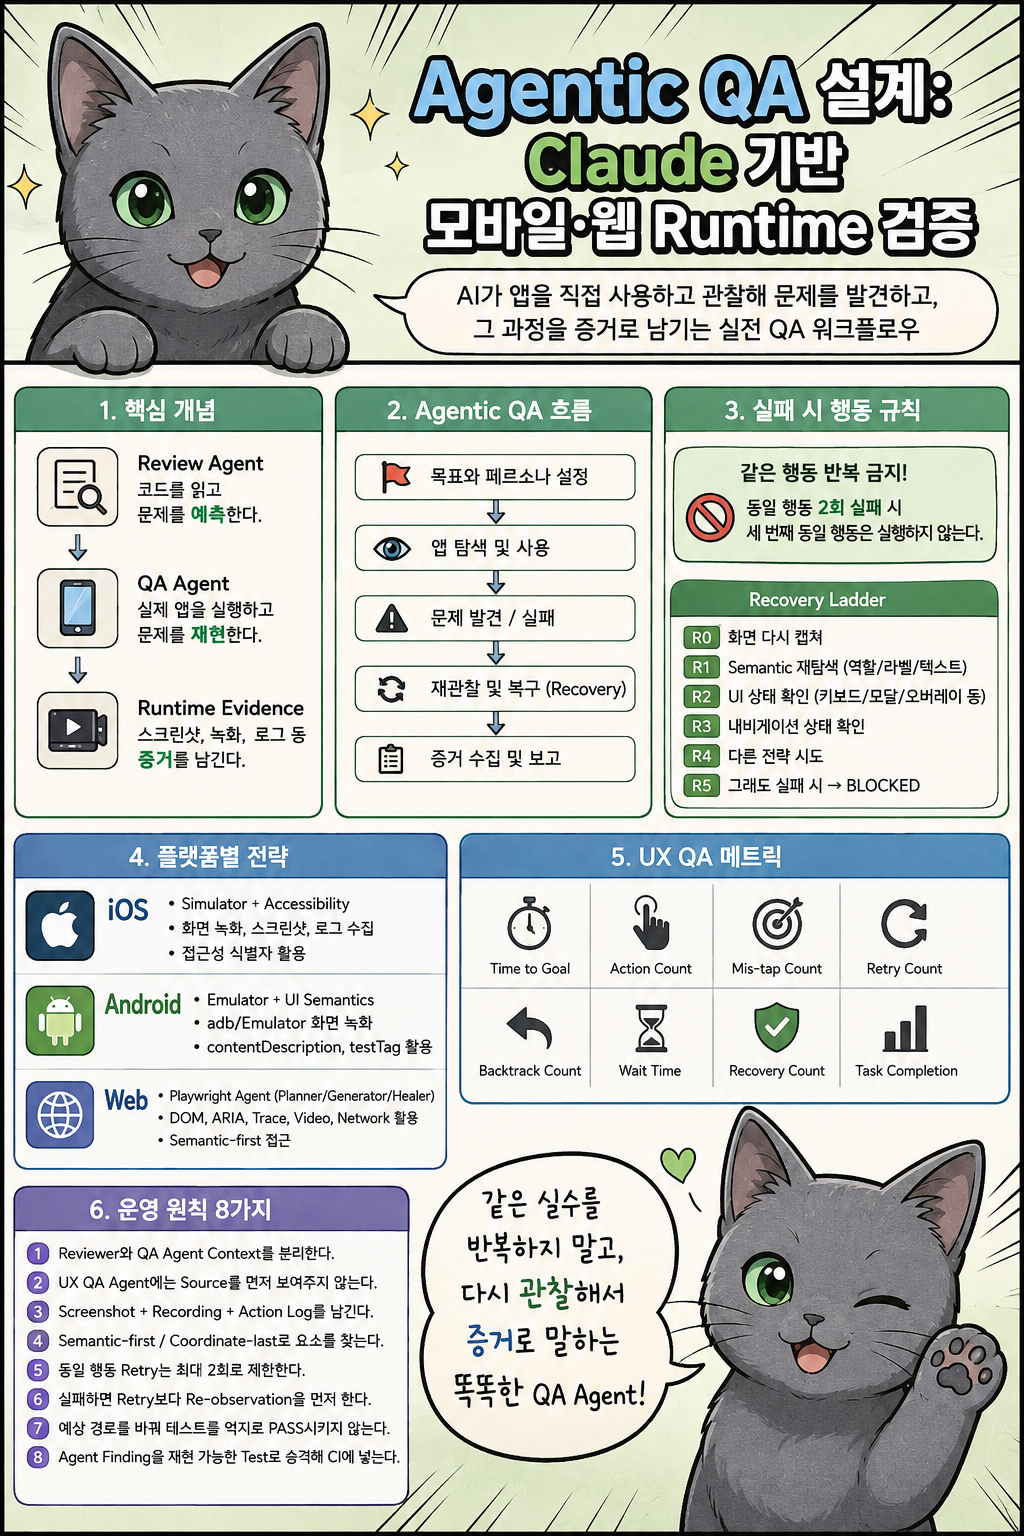
Agentic QA 설계: Claude 기반 모바일·웹 Runtime 검증
AI Coding Agent가 실제 개발에 깊게 들어오기 시작하면서 QA의 역할도 바뀌고 있다.
초기 AI Testing은 대부분 이런 수준이었다.
요구사항
  ↓
LLM
  ↓
Unit Test 생성
  ↓
실행
조금 발전하면 E2E Test까지 만들어줬다.
하지만 2026년 Agentic QA의 흐름은 여기서 한 단계 더 간다.
변경된 코드
   ↓
Review Agent
   ↓
실행 환경
   ↓
QA Agent
   ↓
실제 사용자 행동
   ↓
Runtime Evidence
   ↓
문제 재현
   ↓
Recovery / Re-observation
   ↓
Human Review
최근 Agentic Software Quality Assurance 연구에서도 Agent의 활용 범위는 단순 Test Generation을 넘어 Test Design·Execution·Defect Management·Diagnostic Workflow까지 확장되고 있다. 다만 대부분 완전 자율 시스템보다 Moderate Autonomy와 Hybrid/Multi-Agent 구조에 머물러 있으며, Validation·Transparency·Scalability가 여전히 주요 과제로 지적된다.
따라서 지금 실무에서 현실적인 방향은:
AI가 QA를 완전히 대신하게 만드는 것이 아니라, Claude에게 실행·탐색·관찰을 맡기고 사람이 검증할 수 있는 Evidence를 남기게 만드는 것이다.
이 글에서는 Claude를 기준으로 iOS·Android·Web Frontend에서 이를 어떻게 구성할지 살펴본다.
1. Review Agent와 QA Agent는 같은 역할이 아니다
먼저 가장 중요한 구분부터 해야 한다.
Claude에게:
이번 변경 리뷰하고
문제 있으면 테스트까지 해줘.
라고 한 Session에서 전부 처리하게 만들 수도 있다.
하지만 실제로는 역할을 분리하는 편이 좋다.
Claude Review Agent
        │
        ├─ Source
        ├─ Diff
        ├─ Architecture
        ├─ State
        ├─ Concurrency
        └─ Test Coverage
그리고 별도로:
Claude QA Agent
        │
        ├─ Running App
        ├─ User Goal
        ├─ UI
        ├─ Interaction
        ├─ Runtime
        ├─ Recording
        └─ Logs
를 둔다.
둘의 차이는 간단하다.
Review
= 문제를 코드에서 예측한다.

QA
= 문제를 실제 실행 환경에서 발견한다.
예를 들어 Review Agent가:
로그인 버튼이 활성화되는 시점과
Request 상태 사이에 Race 가능성이 있습니다.
라고 지적할 수 있다.
QA Agent는 실제로:
느린 Network 설정
        ↓
로그인 버튼 Tap
        ↓
반응 없음
        ↓
두 번째 Tap
        ↓
Request 2개 발생
을 재현한다.
후자의 가치가 훨씬 크다.
2. 구현 Agent와 Reviewer도 가능하면 Context를 분리한다
Agent가 직접 구현한 코드를 같은 Context에서 다시 Review하도록 하면 문제가 하나 생긴다.
이미 자신의 판단 근거를 알고 있다.
Implementation Context

"이 구조가 적절하다고 판단해 이렇게 구현함"
그 상태에서:
이제 리뷰해.라고 하면 구현 당시의 가정을 그대로 유지할 가능성이 있다.
그래서:
Session A
Implementation
↓
Session B
Review
↓
Session C
Runtime QA
처럼 나누는 편이 좋다.
같은 Claude를 사용해도 된다.
중요한 것은 역할과 Context를 분리하는 것이다.
3. QA Agent는 Source Code를 처음부터 보여주지 않아도 된다
이건 UX QA에서 특히 중요하다.
예를 들어 프로필 수정 기능을 테스트한다.
Claude가 이미 Source를 읽어서:
ProfileEditButton은
Navigation Bar 오른쪽에 있음
을 알고 있다.
그 상태에서:
프로필 수정 기능을 찾아봐.라고 하면 실제 사용성 테스트가 아니다.
답을 알고 시험을 보는 셈이다.
그래서 UX QA Agent에는 먼저:
Goal

Persona

Starting State

Acceptance Criteria
정도만 준다.
예:
Persona:
처음 앱을 사용하는 사용자.

Starting State:
로그인된 Home 화면.

Goal:
프로필 사진을 변경한다.

규칙:
화면 내부 구현이나
Navigation 구조를 알고 있다고 가정하지 마.
실제 사용자처럼 UI에서 기능을 찾아가.
이런 방식을 Context Isolation으로 볼 수 있다.
Review Agent는 Repository를 모두 본다.
QA Agent는 제품을 먼저 본다.
4. Screenshot만으로 UX QA를 하면 절반밖에 보지 못한다
AI UI 검증이라고 하면 가장 먼저 떠올리는 것이 Screenshot이다.
Before Screenshot

vs

After Screenshot
Screenshot은 매우 유용하다.
레이아웃이 깨졌는지,
텍스트가 잘렸는지,
버튼이 화면 밖으로 밀렸는지,
Dark Mode가 이상한지 볼 수 있다.
하지만 Screenshot에는 결정적인 정보가 없다.
시간이다.
실제 UX 문제는 이런 과정에서 생긴다.
00:00 화면 진입

00:01 버튼 Tap

00:02 반응 없음

00:03 다시 Tap

00:04 Loading 표시

00:06 화면 전환

00:07 이전 Tap 때문에
      두 번째 요청 결과 도착
마지막 화면 Screenshot만 보면 정상일 수도 있다.
하지만 사용 경험은 정상적이지 않다.
따라서 Runtime UX QA에서는:
Screenshot

+

Screen Recording

+

Action Timeline
조합이 훨씬 강하다.
5. Screen Recording은 결과물이 아니라 QA Evidence다
화면 녹화를 “영상으로 앱을 보여주는 기능” 정도로 생각하면 아깝다.
QA에서는 실행 과정의 Evidence가 된다.
예를 들어:
사용자가 버튼을 찾는 데 얼마나 걸렸는가?

Tap 후 Feedback이 얼마나 늦었는가?

같은 버튼을 다시 눌렀는가?

잘못된 화면으로 들어갔다 돌아왔는가?

Keyboard 때문에 UI가 가려졌는가?

Loading이 끝난 것을 알아차리기 쉬웠는가?
를 볼 수 있다.
즉:
Screenshot
= UI State Evidence

Recording
= UX Temporal Evidence
라고 구분하면 된다.
6. iOS에서는 지금도 Simulator 화면을 녹화할 수 있다
Xcode 27의 미래 기능을 기다릴 필요는 없다.
Apple Simulator에는 이미 화면 Recording 기능이 있다.
CLI에서는:
xcrun simctl io booted recordVideo qa-profile.mov를 사용할 수 있다.
종료는 Control-C다. Apple 공식 Simulator 문서에서도 simctl io ... recordVideo를 지원한다.
최근 Xcode의 Device Hub에서도 Simulator 또는 Device 화면을 직접 녹화할 수 있다.
QA Artifact를 예를 들어:
qa/
└── profile-edit/
    ├── recording.mov
    ├── actions.jsonl
    ├── screenshots/
    ├── console.log
    └── report.md
처럼 남길 수 있다.
7. Android도 Emulator Recording을 바로 사용할 수 있다
Android Emulator 역시 영상 Recording을 제공한다.
GUI의 Record and Playback 기능을 사용할 수도 있고 명령줄에서도 Recording이 가능하다.
실기기나 Emulator에서는:
adb shell screenrecord /sdcard/qa-login.mp4로 기록한 뒤:
adb pull /sdcard/qa-login.mp4로 가져올 수도 있다.
Android Emulator의 최근 Console 기능에는 화면 Record뿐 아니라 Automation Macro Record/Playback도 포함돼 있어 반복 가능한 상태 전환을 구성하는 데 활용할 수 있다.
8. Web은 현재 가장 Agentic QA에 적합한 환경이다
Web은 모바일보다 Agent가 볼 수 있는 구조화된 정보가 많다.
DOM

ARIA

Role

Label

Text

Network

Console

Trace

Screenshot

Video
가 존재한다.
그래서 현재 Agentic QA의 가장 완성도 높은 사례 중 하나가 Playwright다.
Playwright는 현재 공식적으로 세 가지 Test Agent를 제공한다.
Planner

Generator

Healer
Planner는 앱을 직접 탐색하고 Test Plan을 만든다.
Generator는 Plan을 실제 Playwright Test로 만든다.
Healer는 실패한 Test를 재생한 뒤 현재 UI를 다시 조사하고 equivalent element 또는 flow를 찾아 Test를 수정한 뒤 재실행한다.
Claude Code용 정의도 만들 수 있다.
npx playwright init-agents --loop=claude현재 Agentic QA가 향하고 있는 방향을 꽤 잘 보여주는 사례다.
9. 중요한 것은 “Test를 다시 실행한다”가 아니다
Playwright Healer가 흥미로운 이유는 단순 Retry를 하지 않는다는 점이다.
실패하면:
Test 실패
   ↓
Failing Step Replay
   ↓
현재 UI 다시 조사
   ↓
대체 Element / Flow 탐색
   ↓
Patch
   ↓
Re-run
한다.
이 원칙을 iOS와 Android QA Agent에도 그대로 가져올 수 있다.
10. 같은 버튼을 세 번 누르는 Agent는 좋은 QA Agent가 아니다
실제로 Agent에게 앱을 맡기면 자주 발생하는 문제가 있다.
"저장" 버튼 찾음

↓

Tap

↓

아무 반응 없음

↓

다시 Tap

↓

실패

↓

또 Tap
세 번째도 실패한다.
이때 Agent가:
버튼이 동작하지 않습니다.라고 끝내버릴 수도 있다.
하지만 아직 아무것도 확정되지 않았다.
원인은:
Agent가 버튼 위치를 잘못 찾았을 수도 있고

Tap Automation이 실패했을 수도 있고

Keyboard가 버튼을 가렸을 수도 있고

Loading Overlay가 Input을 막고 있을 수도 있고

버튼이 disabled일 수도 있고

실제 Product Bug일 수도 있다.
11. 그래서 Same-action Retry Budget을 둔다
Agent QA 정책에 명시한다.
같은 목표에서
동일하거나 실질적으로 동일한 행동이
2회 실패하면

세 번째 동일 행동을 실행하지 않는다.
대신:
RECOVERY MODE로 전환한다.
이 규칙 하나만 넣어도 QA Agent의 무한 Loop를 크게 줄일 수 있다.
12. Retry가 아니라 Re-observation이 핵심이다
나쁜 Workflow:
Tap
↓
실패
↓
Tap
↓
실패
↓
Tap
좋은 Workflow:
Tap
↓
실패
↓
Re-observe
↓
Target 다시 찾기
↓
State 재확인
↓
다른 Action 전략
즉 실패했을 때 행동을 반복하지 않고 관찰을 갱신한다.
Agentic QA에서 굉장히 중요한 원칙이다.
13. Recovery Ladder를 만들어두면 좋다
같은 Element를 두 번 못 찾으면 다음 순서로 이동하게 한다.
R0 — 화면 다시 캡처
Current Screenshot현재 화면 자체가 예상 상태인지 확인한다.
R1 — Semantic Target 재탐색
Role

Accessibility Label

Text

Identifier

Content Description
등을 확인한다.
R2 — UI State 확인
Keyboard

Modal

Alert

Bottom Sheet

Loading Overlay

Disabled State

Scroll Position
등을 본다.
R3 — Navigation State 확인
Agent가 엉뚱한 화면으로 이동했는지 확인한다.
R4 — 다른 Locator 전략
예:
Accessibility

→ Text

→ Structural Context

→ Visual
순으로 다시 찾는다.
R5 — Blocked
그래도 해결하지 못하면:
BLOCKED로 바꾸고 사람에게 Evidence를 전달한다.
같은 행동을 끝없이 수행하지 않는다.
14. Element 탐색은 Semantic-first가 좋다
Web에서는 특히 명확하다.
예를 들어 Playwright라면:
page.getByRole("button", { name: "로그인" })같은 방식이다.
Playwright Codegen 역시 Locator 생성에서 Role·Text·Test ID 등의 resilient locator를 우선하고 복수 Element가 매칭될 경우 더 구체화한다.
세 플랫폼에 같은 원칙을 적용할 수 있다.
1. Semantic Role

2. Accessibility Label

3. Visible Text

4. Stable Test Identifier

5. Structural Context

6. Visual Location

7. Raw Coordinate
Coordinate는 마지막으로 둔다.
15. Raw Coordinate 기반 QA가 쉽게 깨지는 이유
예를 들어:
Tap (342, 671)라고 저장했다.
다음 실행에서는:
Dynamic Type 변경

Keyboard 표시

Device 크기 변경

Banner 표시

Safe Area 변경
때문에 버튼이 움직였다.
같은 좌표를 누르면 엉뚱한 곳을 누른다.
그래서 Agent에게:
버튼 위치를 외우게 하는 것이 아니라:
"저장"이라는 의미를 가진 Button을 찾게 해야 한다.
16. iOS에서는 Accessibility가 Agent QA Infrastructure가 된다
iOS 화면에서:
Accessibility Label

Accessibility Identifier

Traits
가 잘 설정돼 있으면 QA 자동화가 훨씬 안정적이다.
예:
Button("프로필 수정") {
    ...
}
.accessibilityIdentifier("profile.edit")
UI Test뿐 아니라 향후 Semantic QA Agent에도 활용하기 쉬워진다.
중요한 것은:
AI QA를 위해 접근성을 넣는다가 아니다.
원래 좋은 Accessibility가 사용자·테스트·Agent 모두에게 좋은 Semantic Interface가 된다는 것이다.
17. Android에서는 Semantics를 활용한다
Compose라면:
contentDescription

Semantics

testTag
같은 정보를 사용한다.
예:
Modifier.testTag("profile.edit")하지만 무조건 Test Tag만 늘리는 것이 답은 아니다.
가능하면 사용자가 실제로 인식하는 의미와 Automation Identifier가 연결돼 있어야 한다.
18. Test Identifier도 이름을 제대로 정한다
나쁜 예:
button1

button2

button3
좋은 예:
login.submit

profile.edit

checkout.confirm
이렇게 해두면 Agent Report도 이해하기 쉬워진다.
Failed to activate checkout.confirm이라는 결과가 훨씬 의미 있다.
19. Agent가 못 찾았다고 바로 UX Bug라고 판단하면 안 된다
이것도 중요한 함정이다.
Claude가 버튼을 못 찾았다.
그러면:
버튼 Discoverability가 나쁩니다.라고 바로 결론을 내릴 수 있다.
하지만 Agent Vision 문제일 수도 있다.
그래서 실패 원인을 최소 네 가지로 분류한다.
PERCEPTION

LOCALIZATION

AUTOMATION

PRODUCT
PERCEPTION
화면 자체를 잘못 이해했다.
LOCALIZATION
Element를 이해했지만 위치를 잘못 찾았다.
AUTOMATION
Tap/Click 전달 자체가 실패했다.
PRODUCT
실제 UI가 찾기 어렵거나 동작하지 않는다.
20. PRODUCT 판정에는 한 단계 더 Evidence가 필요하다
예를 들어:
Visual에서는 버튼이 존재

Accessibility Tree에서도 존재

enabled = true

Tap 명령도 target에 전달

그래도 반응 없음
이라면 Product Bug 가능성이 높아진다.
반대로:
Accessibility Tree에서는 버튼 발견

Claude Vision에서만 못 찾음
이라면 Agent Perception 문제에 가깝다.
Agent QA 결과도 이런 식으로 원인 신뢰도를 표현해야 한다.
21. UX QA는 PASS/FAIL만으로 부족하다
기존 자동 Test:
Login

PASS
Agent UX QA에서는 조금 더 많은 정보를 기록할 수 있다.
예:
Goal:
프로필 사진 변경

Completion:
PASS

Expected Actions:
4

Actual Actions:
7

Mis-taps:
1

Retries:
1

Backtracks:
1

Recovery:
1

Time to Goal:
14.2 sec
기능은 정상이다.
하지만 UX에는 마찰이 있다는 신호다.
22. Agentic QA에서 볼 수 있는 UX Metric
대략 다음 정도만 있어도 충분하다.
Task Completion

Time to Goal

Action Count

Mis-tap Count

Retry Count

Backtrack Count

Wait Time

Recovery Count
이 데이터를 반복 Release에서 비교한다.
예:
Profile Edit

v1
Actions 8
Time 18s

v2
Actions 5
Time 11s
정량적인 UX Regression Signal로 사용할 수 있다.
사람 대상 Usability Test를 대체한다는 의미는 아니다.
Release 전 자동화 가능한 Synthetic UX Signal이 하나 더 생기는 것이다.
23. QA Agent에 Persona를 줄 수도 있다
예:
Persona:
앱을 처음 사용하는 사용자.
또는:
Persona:
큰 글씨를 사용하는 사용자.
Persona:
네트워크가 느린 환경의 사용자.Persona:
한 손으로 앱을 사용하는 사용자.그리고 같은 Goal을 실행한다.
이렇게 하면 테스트 Scenario가 훨씬 다양해진다.
24. 하지만 Persona를 인간 사용자 시뮬레이션이라고 과장하면 안 된다
Claude가:
처음 사용하는 사용자처럼 행동한다고 해서 실제 사람과 동일한 행동 패턴을 보장하지는 않는다.
따라서:
Human Usability Study대체재가 아니다.
보다 정확한 표현은:
Synthetic User Scenario다.
실제 사람을 대상으로 한 UX Research 전에 반복 가능한 마찰 요소를 찾는 도구로 사용하면 적절하다.
25. Screen Recording과 Action Timeline을 같이 남겨야 한다
영상만 남기면 이런 문제가 생긴다.
저 Tap은 Agent가 의도한 건가?

실수인가?

어떤 Element를 누르려고 했나?
알 수 없다.
그래서 행동도 기록한다.
예:
{"t": 0.0, "event": "scenario_start"}
{"t": 2.1, "action": "tap", "target": "login.submit"}
{"t": 2.3, "state": "loading"}
{"t": 5.4, "action": "tap", "target": "login.submit"}
{"t": 5.5, "finding": "possible delayed feedback"}
이제 Recording과 연결할 수 있다.
26. Video 전체를 Claude에게 계속 넣는 구조도 피한다
여기서 중요한 현실적인 제한이 있다.
현재 Claude Code 자체를 raw video stream을 실시간으로 계속 해석하는 QA 엔진처럼 가정하는 것은 정확하지 않다.
Claude Code에는 Shell·MCP·파일·외부 Tool 권한을 세밀하게 설정할 수 있지만, Video QA는 보통 Recording·Frame·Trace·Screenshot 등을 Artifact화해 별도의 Tool Pipeline과 연결하는 방식으로 구성하는 편이 안전하다. Claude Code는 --allowedTools, MCP별 권한, Command별 Bash 권한 등을 지원한다.
따라서 실전에서는:
Recording
    ↓
Action Timeline
    ↓
이상 Event 탐지
    ↓
관련 구간 선택
    ↓
Screenshot / Key Frames / Trace
    ↓
Claude Analysis
처럼 가져가는 편이 효율적이다.
27. Claude에게 필요한 권한도 최소 범위로 준다
QA라고 해서:
Bash 전체 허용

Filesystem 전체 허용

Deploy 허용
할 필요는 없다.
Claude Code는 Tool 단위와 Command Pattern 단위 권한을 지원한다.
예를 들어 개념적으로:
ALLOW

Read
git diff
test command
simulator/emulator command
QA artifact directory
browser MCP
DENY
git push
production deployment
credential directory
production database처럼 분리한다.
Claude Code의 --allowedTools, --disallowedTools, /permissions, MCP Tool permission을 사용할 수 있다.
28. 권한을 많이 주는 게 Agentic QA의 핵심은 아니다
좋은 QA Agent는:
모든 것을 할 수 있는 Agent가 아니다.
QA에 필요한 행동만
독립적으로 실행할 수 있는 Agent
에 가깝다.
예:
앱 실행

Test 실행

Simulator 조작

Browser 조작

Screenshot

Recording

Log 읽기
까지는 허용.
하지만:
Release

Production DB 수정

Secret 변경

App Store 배포
는 QA 역할 밖이다.
29. Review → Functional QA → UX QA 세 단계가 가장 깔끔하다
전체 Pipeline을 이렇게 나누면 좋다.
CHANGE
   │
   ▼
STATIC REVIEW
   │
   ├─ correctness
   ├─ state
   ├─ concurrency
   ├─ architecture
   └─ accessibility
   │
   ▼
FUNCTIONAL QA
   │
   ├─ happy path
   ├─ failure path
   ├─ edge cases
   └─ recovery
   │
   ▼
UX QA
   │
   ├─ discoverability
   ├─ navigation
   ├─ feedback
   ├─ wait
   ├─ retry
   └─ friction
QA라는 하나의 Prompt 안에 다 섞지 않는다.
30. iOS Review Agent가 볼 것
iOS라면 대표적으로:
Swift Concurrency

Actor Isolation

MainActor

Task Cancellation

Memory / Retain Cycle

Observation

SwiftUI State

Navigation

Error Handling

Accessibility

Localization
등이다.
Architecture를 쓰는 팀이라면:
Feature 간 직접 의존

Presentation → Data 직접 접근

Domain → UIKit/SwiftUI 의존

Dependency Injection
같은 규칙도 Review Contract에 넣는다.
31. Android Review Agent가 볼 것
Android에서는:
Coroutine Scope

Structured Concurrency

Flow / StateFlow

Lifecycle

Compose State

Recomposition

LaunchedEffect

ViewModel

Navigation

Room

Retrofit

DI
등을 집중적으로 본다.
특히 Compose에서는:
State Hoisting

Effect Key

Lifecycle-aware collection

불필요한 Recomposition
같은 부분이 Review 대상이 된다.
32. Web Frontend Review Agent가 볼 것
React/Next.js 계열이라면:
State

Effect

Async Race

Server / Client Boundary

Hydration

Error State

Loading State

Empty State

Accessibility

Responsive

Performance
를 본다.
그 다음 실제 Browser QA로 넘어간다.
33. Web Agentic QA는 지금 당장 꽤 높은 수준으로 만들 수 있다
현재 Playwright Test Agents는:
Planner

↓

Generator

↓

Healer
구조를 공식 제공한다.
예를 들어 Claude에게:
guest checkout flow를 탐색해서
Test Plan을 만들고,

Happy Path뿐 아니라
payment failure,
back navigation,
slow response를 포함해.
라고 Planner를 이용할 수 있다.
Generator가 Test를 생성한다.
Test가 깨지면 Healer가:
Replay

↓

Inspect Current UI

↓

Repair

↓

Re-run
한다.
이게 Agentic QA의 좋은 기준점이다.
34. 다만 Healer가 Test를 고쳤다고 제품이 정상이라는 뜻은 아니다
여기에도 함정이 있다.
UI가 변경돼 Locator만 바뀌었다.
Old Locator
↓
Fail

Healer
↓
New Locator

PASS
좋다.
그런데 실제 기능이 깨졌는데 Healer가 새로운 경로를 찾아 Test를 PASS시킬 수도 있다.
따라서 중요한 규칙이 필요하다.
Expected User Path

vs

Actual User Path
를 비교한다.
35. 예상 경로와 실제 경로를 별도로 기록한다
예:
Expected:

Home
→ Profile
→ Edit
그런데 Agent는:
Home
→ Settings
→ Account
→ Profile
→ Edit
으로 성공했다.
기능적으로는 PASS.
하지만 원래 Navigation의 UX Regression은 존재할 수 있다.
그래서:
Functional Completion

PASS
와:
Expected Path

FAIL
을 따로 표시한다.
36. Agent가 우회했다고 QA 성공으로 처리하지 않는다
QA Prompt에 명시한다.
원래 Scenario의 예상 Interaction Path를
임의로 변경해서 성공시키지 마.

우회 경로를 발견한 경우:

Functional Alternative Path

로 별도 기록하고

원래 경로는 실패로 유지해.
이렇게 해야 Self-healing이 실제 Bug를 숨기는 것을 막을 수 있다.
37. Agentic QA에는 Guardrail이 반드시 필요하다
최근 연구에서도 Agentic AI가 SQA 효율과 Adaptability를 높일 가능성이 있지만 Transparency·Validation이 핵심 연구 과제로 남아 있다.
실전 Guardrail은 복잡할 필요 없다.
Same Action Retry <= 2

Scenario Recovery <= 3

No Production Mutation

No Test Expectation Rewrite Without Approval

No Expected Path Rewrite

Unverified != PASS
정도만 있어도 상당히 강하다.
38. 테스트 자체를 Agent 마음대로 바꾸게 하지 않는다
예:
Expected:
HTTP 401
→ 로그인 화면 표시
Test가 실패했다.
Agent가:
현재는 403이 나오니까
expect를 403으로 바꾸겠습니다.
하면 Test는 통과한다.
하지만 제품 요구사항을 깨뜨렸다.
따라서:
Locator Repair

AUTO
일 수 있어도:
Business Assertion Change

HUMAN APPROVAL
로 둔다.
Agentic QA의 자동 복구 범위와 Product Specification 변경을 반드시 분리해야 한다.
39. Claude QA Agent Prompt는 이렇게 만들 수 있다
예:
현재 빌드를 QA해.

목표:
신규 사용자가 프로필 사진을 변경한다.

먼저 구현 코드를 읽지 말고
실제 사용자처럼 앱을 사용해.

검증:

1. 목표 기능 발견 가능성
2. 정상 경로 완료
3. Loading/Failure/Recovery
4. Keyboard 및 Overlay 방해
5. 불필요한 Backtrack
6. 느린 Feedback
7. Accessibility 기반 요소 탐색

규칙:

- 동일 행동을 2회 실패하면 반복하지 않는다.
- Recovery Mode로 전환해 현재 UI를 다시 관찰한다.
- Semantic selector를 좌표보다 우선한다.
- 예상 경로를 임의로 바꿔 PASS시키지 않는다.
- 확인하지 못한 항목은 Not Verified로 남긴다.

수집:

- Screenshot
- Screen recording
- Action timeline
- Runtime logs

완료 후:

Functional QA
UX Findings
Recovery Events
Not Verified

를 분리해서 보고해.
이 정도면 단순 “테스트해줘”와는 완전히 다른 결과가 나온다.
40. QA Report도 Agent 자연어 감상문으로 받지 않는다
추천 Format:
## Scenario

Profile photo edit

## Functional

PASS

## Expected Path

PASS

## Time to Goal

11.4s

## Actions

Expected: 4
Actual: 6

## Retry

1

## Backtrack

1

## Recovery

R1 Semantic Re-localization

## UX Findings

MAJOR
Edit CTA discoverability low

MINOR
Loading feedback begins ~1.2s after tap

## Runtime

No crash
No console error

## Evidence

recording.mov
actions.jsonl
screenshots/004.png

## Not Verified

physical device
VoiceOver
slow cellular
결과를 다시 재현할 수 있다.
41. Runtime Evidence가 가장 중요하다
Claude:
문제가 없어 보입니다.보다:
Build PASS

E2E PASS

Runtime Error 0

Retry 1

Recording 00:07~00:12에서
Button feedback delay 확인
이 훨씬 좋은 QA 결과다.
즉 Agent의 의견이 아니라:
Execution Evidence를 중심에 둔다.
42. Agentic QA를 CI Gate로 바로 쓰면 안 되는 영역도 있다
Agent의 탐색 결과가 매번 조금씩 달라질 수 있다.
따라서 모든 Runtime Agent 판단을:
Merge Block으로 사용하는 것은 위험할 수 있다.
초기에는:
Agentic QA

→ Discovery / Review Signal
로 사용하는 편이 좋다.
반면 안정된 Test로 변환된 것은:
Playwright

XCTest

Espresso / Compose UI Test

Unit Test
처럼 Deterministic Runner로 CI에 넣는다.
43. Author-time AI와 Runtime Gate를 분리하면 안정적이다
좋은 구조:
Agent

탐색
계획
Test 생성
Failure 분석
      │
      ▼
Committed Tests
      │
      ▼
Deterministic Runner
      │
      ▼
CI Gate
Agent는 Test를 발견하고 개선한다.
최종 Merge Gate는 가능한 한 반복 가능한 도구가 담당한다.
이 방향은 최신 Agentic QA 논의에서도 중요한 구분이다. Playwright도 Agent가 Plan·Test·Healing을 수행하면서 실제 실행은 Playwright Test Runner를 기반으로 한다.
44. QA Agent를 잘 쓰면 Regression Test가 계속 좋아진다
예를 들어 Agent가 탐색 중 발견했다.
Double Tap
+
Slow Network
=
Duplicate Payment Request
그것을 QA Report에만 남기지 않는다.
다음 단계:
Agent Finding

↓

Reproduction

↓

Regression Scenario

↓

Deterministic Test

↓

CI
로 승격한다.
다음 Release부터는 Claude가 다시 이 문제를 “발견”할 필요가 없다.
Test가 막는다.
45. Agentic QA의 목적은 기존 Test Automation을 없애는 게 아니다
오히려 역할이 다르다.
Traditional Automation

알고 있는 문제를
계속 검증
Agentic QA:
아직 Test로 정의되지 않은
새로운 실패 가능성을 탐색
이다.
둘을 조합하는 편이 훨씬 강하다.
46. 가장 좋은 QA Loop
Agent explores

↓

새로운 Edge Case 발견

↓

Human 확인

↓

Regression Test 생성

↓

CI 편입

↓

Agent는 다음 새로운 문제 탐색
QA Coverage가 계속 확장된다.
47. Claude Code 권한도 QA 전용 Profile로 만들 수 있다
Claude Code는 읽기·Bash·MCP 등에 세분화된 권한 규칙을 지원하며 프로젝트 설정으로 공유할 수도 있다.
그래서 개발 Session과 QA Session 권한을 다르게 둘 수 있다.
예:
Development Agent

Edit
Build
Test
QA:
QA Agent

Read
Build
Test
Simulator
Browser
Recording
Logs

Source Edit X
특히 UX QA Phase에서는 처음부터 Source 수정 권한을 빼는 것도 좋다.
문제를 발견하자마자 고쳐버리지 않고 Evidence부터 남기게 하기 위해서다.
48. Review와 Fix도 분리하면 Evidence가 깨끗해진다
나쁜 방식:
QA
↓
문제 발견
↓
즉시 수정
↓
계속 QA
하다 보면 어떤 변경 때문에 결과가 달라졌는지 추적하기 어려워진다.
추천:
QA RUN 01

↓

Findings freeze

↓

Fix

↓

QA RUN 02
Recording과 Report도 Run 단위로 나눈다.
qa/
├── run-001/
└── run-002/
이러면 Before/After 비교도 가능하다.
49. iOS·Android·Web 공통 구조
최종적으로는 세 플랫폼이 이렇게 정리된다.
                    Claude
                       │
          ┌────────────┼────────────┐
          ▼            ▼            ▼
         iOS        Android         Web
          │            │            │
     Simulator      Emulator      Browser
          │            │            │
       Semantic     Semantic      DOM/ARIA
          │            │            │
       Recording    Recording     Video/Trace
          │            │            │
       Runtime       Logcat      Console/Network
          └────────────┼────────────┘
                       ▼
                 QA Evidence
                       │
                       ▼
                  Recovery
                       │
                       ▼
                 Regression
                       │
                       ▼
                      CI
Web이 현재 가장 구조화된 Agent QA 환경이고 모바일은 그 방향으로 따라가는 모습에 가깝다.
50. Xcode 27 MCP는 지금의 전제로 넣지 않는다
iOS 부분에서는 특히 이 선을 명확하게 하는 편이 좋다.
현재 실전 Workflow는:
Simulator

simctl

XCTest

Accessibility

Screen Recording

별도 Automation Tool
등 현재 사용할 수 있는 도구를 기준으로 구성한다.
Xcode 27 MCP는 정식 환경에서 검증된 현재 전제처럼 쓰지 않는다.
다만 앞으로 Apple이 외부 Agent에게:
Simulator Interaction

Runtime State

Preview

Debugger

Semantic UI
같은 Tool Access를 더 자연스럽게 제공하게 된다면, iOS Agentic QA 역시 Web의 Browser Agent와 비슷하게 훨씬 단순한 구조가 될 여지는 크다.
그 정도 전망으로만 두는 편이 적절하다.
51. 최근 Agentic QA 연구가 보여주는 현실적인 결론
2026년 8월 28일 공개된 SQA Systematic Mapping Study는 37개 Primary Study를 분석했다.
연구는 Agentic AI 활용이 특히 Product Assurance의 Test Generation·Defect Management에 집중돼 있다고 설명한다.
동시에 대부분의 시스템은:
완전 자율보다는:
Moderate Autonomy

Hybrid

Multi-Agent
구조에 가깝다.
효율·정확도·Maintainability 개선 가능성이 있지만 Scalability·Generalizability·Transparency와 Validation은 여전히 중요한 제한이다.
또 8월 24일 공개된 Multi-Agent SQA 연구에서도 Agent가 Defect Detection·Localization·Test Generation을 협업하도록 하는 방향이 제시되고 있다.
즉 지금 Agentic QA에서 가장 현실적인 설계는:
AI가 모든 QA를 대신한다.가 아니다.
AI가 탐색과 실행을 확대하고

Deterministic Tool이 검증하고

Evidence를 사람이 확인한다.
이다.
52. 가장 중요한 운영 규칙 8개
실제로 적용한다면 이 정도만 먼저 정하면 된다.
1. Reviewer와 QA Agent Context를 분리한다.

2. UX QA Agent에는 Source를 먼저 보여주지 않는다.

3. Screenshot + Recording + Action Log를 남긴다.

4. Semantic-first / Coordinate-last로 Element를 찾는다.

5. 동일 행동 Retry는 최대 2회로 제한한다.

6. 실패하면 Retry보다 Re-observation을 먼저 한다.

7. Expected Path를 바꿔 테스트를 억지로 PASS시키지 않는다.

8. Agent Finding을 재현 가능한 Test로 승격한 뒤 CI에 넣는다.
53. 마무리
AI QA의 초기 모습은 단순했다.
Claude

↓

Test 작성
하지만 Agent가 Browser·Simulator·Emulator·Shell·MCP 같은 Tool을 사용할 수 있게 되면서 QA의 범위가 빠르게 넓어지고 있다.
이제 가능한 Workflow는:
코드를 읽고

↓

실제 앱을 실행하고

↓

사용자처럼 기능을 찾아보고

↓

Tap하고

↓

기다리고

↓

실패하고

↓

현재 상태를 다시 관찰하고

↓

다른 전략으로 다시 시도하고

↓

화면과 Runtime을 기록한다.
여기서 가장 중요한 변화는 자율성 자체가 아니다.
좋은 QA Agent는 무조건 끝까지 해결하는 Agent가 아니다.
같은 버튼을 세 번 누르며 억지로 Scenario를 완료하는 Agent도 아니다.
두 번 실패했다면:
STOP하고,
왜 실패했는가?를 다시 조사할 수 있어야 한다.
Perception 문제인가?

Target Localization 문제인가?

Automation 문제인가?

실제 UX 문제인가?
를 구분한다.
그리고 그 판단의 근거를:
Screenshot

Recording

Action Timeline

Semantic UI

Runtime Log

Network

Console
같은 Evidence로 남긴다.
이 구조가 중요한 이유는 QA의 결과가:
Claude가 문제 없다고 했다.에서:
이 Scenario를 실제 실행했고,
여기서 한 번 실패했고,
이 Evidence 때문에 원인을 이렇게 분류했다.
로 바뀌기 때문이다.
또 하나 중요한 변화는 Screenshot 중심 QA에서 시간축을 가진 QA로 이동하는 것이다.
실제 UX 문제는 대부분 한 장의 화면보다:
Tap

↓

Feedback

↓

Wait

↓

Transition

↓

Recovery
사이에 존재한다.
그래서 Screen Recording과 Action Timeline이 중요해진다.
이 둘을 이용하면 기능이 성공했는지만 보는 것이 아니라:
몇 번 눌렀는지

잘못 누른 곳은 없는지

얼마나 기다렸는지

되돌아갔는지

같은 동작을 반복했는지
까지 볼 수 있다.
그 순간 Claude는 단순한 Test Generator를 넘어 Synthetic User 역할을 수행하는 QA Agent로 확장된다.
다만 사람의 사용성 테스트를 대신한다고 과장해서는 안 된다.
Agent의 Perception 자체가 틀릴 수 있기 때문이다.
그래서 앞으로 Agentic QA에서 가장 중요한 설계 원칙은 자율성이 아니라:
Bounded Autonomy

+

Recovery Policy

+

Runtime Evidence

+

Deterministic Validation
일 가능성이 높다.
한 문장으로 정리하면 이렇다.
Agentic QA는 AI에게 테스트를 맡기는 기술이 아니라, AI가 제품을 직접 사용하고 실패하면 다시 관찰하며 그 과정을 검증 가능한 Evidence로 남기게 만드는 QA 시스템이다.
그리고 iOS·Android·Web에서 이 구조가 제대로 자리 잡으면 QA의 완료 기준도 달라질 수 있다.
기존:
테스트가 통과했다.에서:
실제 사용자 Flow를 수행했고,

기능적으로 성공했고,

불필요한 Retry나 Backtrack이 없었으며,

Runtime 오류가 없고,

그 과정의 Evidence까지 남아 있다.
로 바뀌는 것이다.
이게 현재 Agentic QA에서 가장 흥미로운 변화다.
참고 자료
-
Frontiers in Computer Science — Software quality assurance in the era of Agentic AI: a systematic mapping study, 2026-08-28
Agentic AI의 SQA 활용을 37개 연구를 기반으로 분석한다. Product Assurance, Test Generation, Defect Management에 활용이 집중되고 있으며 Moderate Autonomy·Hybrid·Multi-Agent 구조가 주류라는 점과 Transparency·Validation 등의 한계를 정리한다. -
International Journal of Computational Intelligence Systems — Agentic AI for Early Bug Detection and Software Quality Assurance, 2026-08-24
여러 Agent가 Defect Prediction·Localization·Test Generation을 협력하는 Multi-Agent SQA 구조를 다룬 최신 연구다. -
Microsoft Playwright — Playwright Test Agents
Planner가 앱을 탐색해 Test Plan을 만들고 Generator가 Test를 생성하며 Healer가 실패 Step을 Replay하고 현재 UI를 다시 조사해 Test를 복구하는 공식 Agentic Testing Workflow를 제공한다. Claude Code용 Agent Definition도 지원한다. -
Anthropic — Claude Code permissions / CLI
Claude Code가 Bash·MCP·Filesystem 등에 대해 세분화된 Tool Permission을 지원하며allowedTools,disallowedTools,/permissions등의 정책으로 QA Agent의 실행 범위를 제한할 수 있음을 설명한다. -
Apple Developer — Simulator video recording
xcrun simctl io booted recordVideo를 이용해 Simulator의 Runtime Interaction을 영상 Artifact로 저장할 수 있다. -
Android Developers — Emulator / adb screen recording
Android Emulator 및adb shell screenrecord를 통해 QA Session을 녹화할 수 있고 최신 Emulator에서는 Host 기반 Recording 기능도 제공한다.
핵심 참고 포인트
현재 Agentic QA 연구는 완전히 독립적으로 제품 품질을 승인하는 Autonomous QA보다 Agent가 Test Planning·Execution·Defect Diagnosis를 수행하고 사람이 Validation과 최종 판단을 담당하는 Semi-autonomous 구조에 더 가깝다.
Web에서는 Playwright의 Planner→Generator→Healer가 이미 상당히 구체적인 Agentic Testing 구조를 제공한다. 특히 실패 시 동일 Action을 반복하는 것이 아니라 Failing Step Replay → Current UI Inspection → Recovery → Re-run으로 이동하는 방식은 모바일 QA Agent에도 그대로 적용할 가치가 있다.
모바일에서는 현재 Screen Recording·Accessibility/Semantics·Simulator/Emulator Automation을 조합하는 방식이 현실적이다. Xcode 27 MCP 같은 향후 Apple Agent Tooling이 안정적으로 제공되면 iOS에서도 Browser Agent에 가까운 Runtime QA 환경이 만들어질 가능성이 있지만, 현재 Workflow의 필수 전제로 두지는 않는 편이 정확하다.
가장 중요한 것은 Claude가 Scenario를 끝까지 성공시키는 것이 아니다. 같은 실패를 반복할 때 멈출 수 있고, 다시 관찰해 Perception·Localization·Automation·Product 문제를 구분하며, 그 판단을 Recording·Action Timeline·Runtime Evidence로 남길 수 있어야 한다. 이것이 단순 AI Test Generation과 Agentic QA를 구분하는 핵심이다.