Claude Fable 5.1이 바꾼 Coding Agent 판도: GPT-5.6 Sol을 앞선 건 무엇인가
Claude Fable 5.1이 바꾼 Coding Agent 판도: GPT-5.6 Sol을 앞선 건 무엇인가
불과 두 달 전만 해도 Coding Agent 경쟁에서는 GPT-5.6 Sol의 존재감이 상당히 강했다.
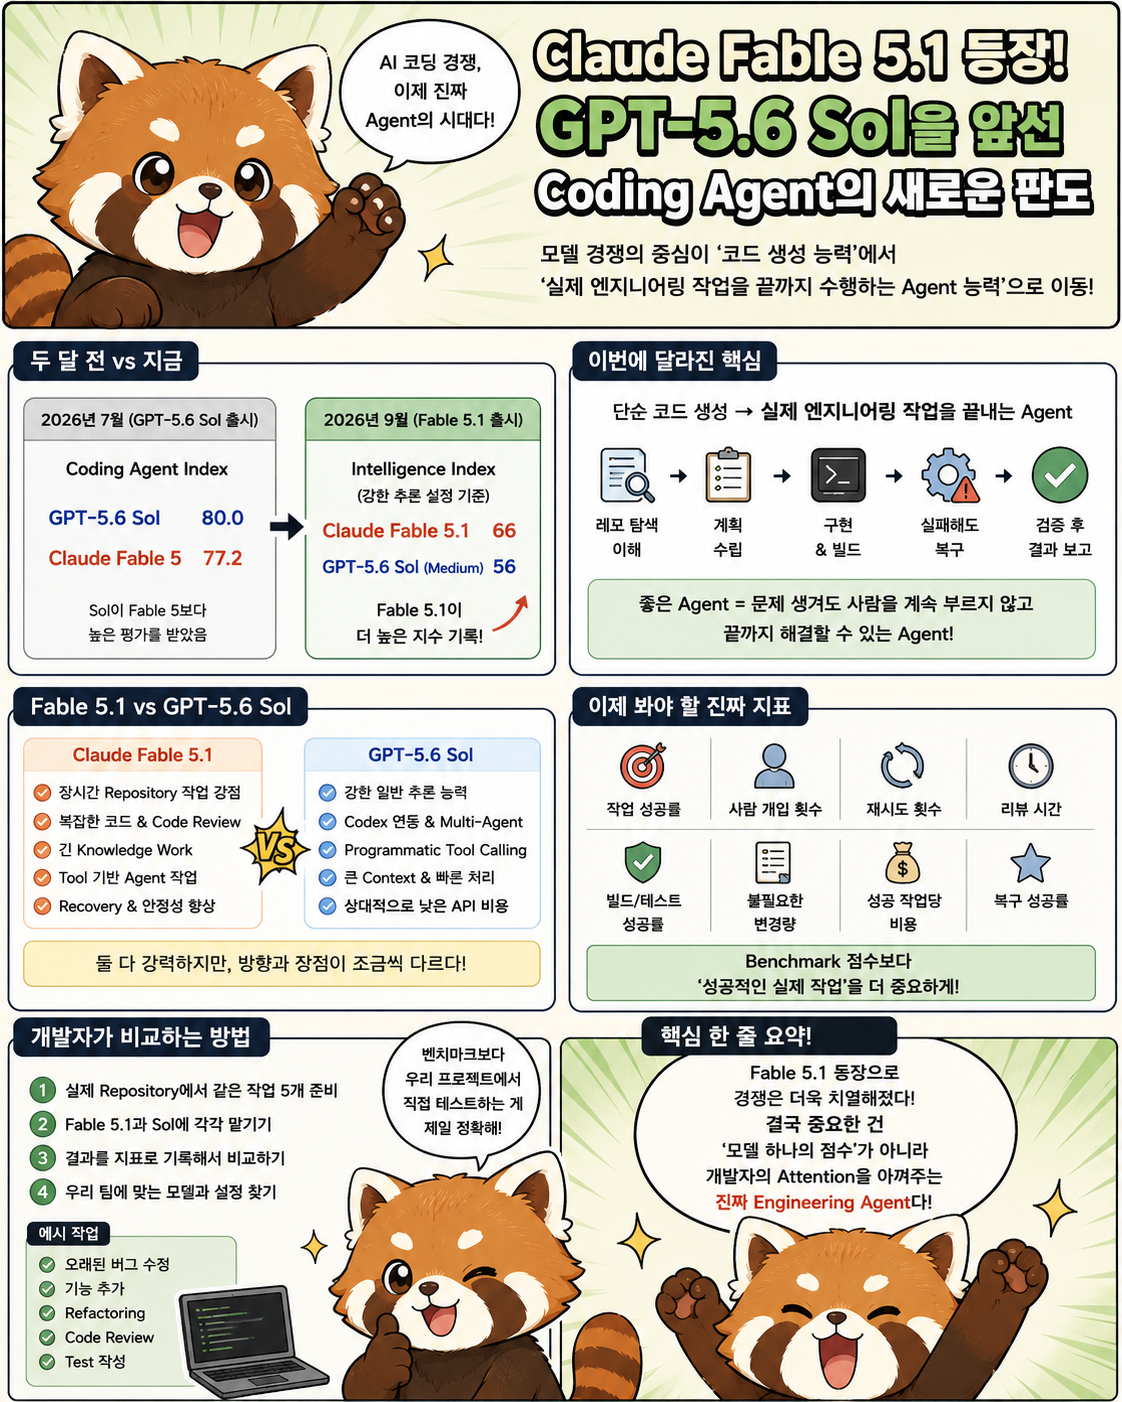
OpenAI가 2026년 7월 GPT-5.6을 정식 공개했을 당시 Sol은 Artificial Analysis Coding Agent Index에서 80점을 기록했다. 당시 Claude Fable 5는 77.2점이었다. OpenAI는 Terminal-Bench 2.1과 DeepSWE에서도 Sol의 장기 Coding Agent 성능을 강조했다.
그런데 2026년 9월 1일 Anthropic이 Claude Fable 5.1을 공개하면서 분위기가 다시 달라졌다. Anthropic은 Fable 5.1을 현재 자사의 가장 강력한 Coding·Knowledge Work 모델로 소개하고 있다.
이번 변화에서 중요한 건 단순히 새로운 모델이 벤치마크 몇 개에서 GPT를 앞섰다는 사실이 아니다.
더 중요한 변화는 Coding Model 경쟁의 중심이 코드 생성 능력에서 실제 Engineering Task를 끝까지 수행하는 Agent 능력으로 이동하고 있다는 점이다.
1. 몇 달 만에 순위가 다시 뒤집혔다
GPT-5.6 Sol이 공개됐을 당시 OpenAI가 강조했던 지표 중 하나가 Artificial Analysis Coding Agent Index였다.
GPT-5.6 Sol     80.0
Claude Fable 5  77.2
Sol은 당시 Fable 5보다 2.8점 높았다.
특히 OpenAI가 강조한 것은 단순한 점수뿐만 아니었다.
Sol은 Fable 5와 비교했을 때 더 적은 출력 토큰과 더 짧은 작업 시간, 더 낮은 예상 비용으로 높은 Coding Agent 성능을 냈다는 것이 OpenAI의 설명이었다.
그런데 Fable 5.1이 나오면서 비교 대상 자체가 달라졌다.
Artificial Analysis의 출시 직후 비교에서는 Fable 5.1의 Adaptive Reasoning·Max Effort 구성이 GPT-5.6 Sol medium보다 Intelligence Index에서 상당히 높은 결과를 보이고 있다.
Artificial Analysis Intelligence Index

Claude Fable 5.1 Max    66
GPT-5.6 Sol Medium      56
다만 이 비교는 추론 설정이 동일하지 않다.
Fable은 Max Effort이고 Sol은 Medium이므로 이것만 보고 “10점 차이로 완전히 이겼다”고 말하면 안 된다. 반대로 현재 Fable 5.1이 이전 Fable 5보다 상당히 강해졌다는 신호로 보는 것은 충분히 가능하다.
2. 이번 변화는 일반 Coding보다 Agentic Coding에서 더 크게 보인다
요즘 Coding Agent가 수행하는 일은 예전의 코드 생성과 많이 다르다.
예전에는:
요구사항
  ↓
함수 작성
  ↓
결과
정도였다.
지금은 오히려 이런 형태다.
Repository 탐색
        ↓
관련 Architecture 파악
        ↓
문제 재현
        ↓
수정 계획
        ↓
여러 파일 수정
        ↓
Build
        ↓
Test
        ↓
실패
        ↓
원인 재분석
        ↓
수정
        ↓
재검증
        ↓
Review-ready 결과
이 흐름에서는 모델의 순수 Coding 능력만으로는 부족하다.
필요한 능력이 달라진다.
Repository Understanding

Planning

Tool Use

Long-horizon Reasoning

Failure Recovery

Verification

Context 유지
이번 Fable 5.1이 특히 노리는 부분이 이 영역이다.
Anthropic은 Fable 5.1을 대규모 코드베이스 작업, Code Review, 장시간 진행되는 Agent 작업, Tool 사용과 복잡한 Knowledge Work를 위한 모델로 소개하고 있다.
3. 좋은 Coding Agent는 코드를 잘 만드는 Agent가 아니다
실제 개발에서 더 중요한 질문은 이것이다.
한 번에 정답 코드를 만들었는가?보다:
문제가 생겨도
사람을 계속 부르지 않고
끝까지 해결할 수 있는가?
다.
예를 들어 Agent에게 Build Error 하나를 맡긴다.
좋지 않은 Agent:
Build 실패
   ↓
A 수정
   ↓
Build 실패
   ↓
A' 수정
   ↓
Build 실패
   ↓
A'' 수정
겉으로 보면 계속 일하고 있다.
하지만 실제로는 같은 가설 안에서 빙빙 돌고 있다.
좋은 Agent는 두 번째 실패쯤에서 이렇게 움직여야 한다.
Build 실패
   ↓
기존 가설 폐기
   ↓
관련 코드 다시 조사
   ↓
새 가설 수립
   ↓
다른 증거 확인
   ↓
수정
이게 Recovery 능력이다.
장시간 Coding Agent에서는 이 차이가 굉장히 크다.
4. GPT-5.6 Sol 역시 바로 이 영역을 겨냥한 모델이다
그래서 Fable 5.1이 좋아졌다고 해서 Sol이 갑자기 구형 Coding Model이 된 것은 아니다.
OpenAI가 GPT-5.6 Sol을 출시하면서 가장 강하게 강조했던 것도 long-horizon agentic work였다.
Sol은 Terminal-Bench 2.1에서 88.8퍼센트, DeepSWE v1.1에서 72.7퍼센트를 기록했고, max 추론과 여러 하위 Agent를 병렬로 사용하는 ultra 구성까지 도입했다.
즉 두 회사 모두 같은 곳을 보고 있다.
Claude Fable 5.1
          ↘

        Long-running
        Engineering Agent

          ↗
GPT-5.6 Sol
경쟁은 더 이상 “누가 Python 함수를 더 잘 만드는가”가 아니다.
5. 벤치마크 숫자를 직접 비교할 때는 주의해야 한다
여기서 자주 발생하는 오류가 있다.
예를 들어 GPT-5.6 Sol 발표 자료에는:
Terminal-Bench 2.1
88.8%
이 나온다.
반면 최신 Claude 자료나 새로운 비교에서는 다른 버전의 Terminal-Bench나 다른 Harness를 사용하는 경우가 있다.
그래서:
88.8 vs 55.x처럼 숫자만 직접 놓고:
Sol이 훨씬 강하다.라고 결론 내리면 안 된다.
Benchmark 버전이 다르면 문제 집합도 다르고, Agent Harness나 Tool 환경도 달라질 수 있다.
Coding Agent에서는 특히:
Model
+
Harness
+
Tool
+
Reasoning 설정
+
Context
전체가 결과에 영향을 준다.
6. 이제 모델 이름보다 Harness가 더 중요해진다
같은 Fable 5.1이라도:
Claude App에서 사용하는 것과:
Claude Code로 Repository를 직접 수정하게 하는 것은 완전히 다른 경험이다.
Sol도 마찬가지다.
ChatGPT와:
Codex에서 동일한 모델을 사용해도 Agent의 행동 방식은 달라진다.
이제 실제 Coding Agent 성능은 대략 이런 식으로 보는 것이 맞다.
Agent 성능
=
Model
+
Harness
+
Repository Context
+
Tool Access
+
Project Rules
+
Validation
모델 하나의 IQ 점수만으로 설명하기 어렵다.
7. Fable 5.1에서 눈여겨볼 부분은 Code Review다
Coding Agent가 좋아지면서 새로운 병목이 하나 생겼다.
Review다.
Agent가 몇 분 만에 20개 파일을 수정할 수 있어도 사람은 그 20개 파일을 다시 읽어야 한다.
그래서 앞으로 강한 Coding Agent에게 필요한 능력은:
Code Generation뿐만 아니다.
Code Review

Impact Analysis

Missing Test 발견

Architecture 위반 탐지

Risk 분류
가 점점 중요해진다.
Fable 5.1도 Anthropic이 Coding과 Knowledge Work를 핵심 용도로 내세우면서 이런 장시간 Repository 작업을 중심에 두고 있다.
8. 좋은 Reviewer는 Diff만 보면 안 된다
예를 들어 이런 변경이 있다고 하자.
func loadUser() async {
    user = try? await repository.load()
}
단순히 문법만 보면 이상하지 않을 수 있다.
하지만 실제 Review에서는:
이 메서드는 MainActor인가?

View가 사라졌을 때 Task는 취소되는가?

실패를 왜 무시하는가?

Repository 구현은 Actor-safe한가?

기존 Error State는 어떻게 되는가?

테스트는 있는가?
까지 봐야 한다.
즉:
Diff
↓
Call Graph
↓
State
↓
Architecture
↓
Runtime
↓
Test
를 연결해야 한다.
이런 작업은 작은 코드 생성 문제보다 훨씬 긴 Context와 추론을 필요로 한다.
9. 그래서 이번 경쟁은 ‘누가 더 똑똑하냐’보다 ‘누가 덜 귀찮게 하느냐’에 가깝다
Agent를 실제 사용하는 개발자 입장에서는 꽤 단순하다.
A Agent:
질문
질문
질문
승인
질문
실패
재시도
B Agent:
Task 시작

↓

조사

↓

구현

↓

Build

↓

실패

↓

스스로 복구

↓

Test

↓

결과 보고
두 모델의 Benchmark가 비슷하다면 실제로는 B가 훨씬 생산적이다.
그래서 앞으로 Coding Agent 지표에는 이런 것도 들어가야 한다.
Successful Task Rate

Human Intervention Count

Retry Count

Recovery Success Rate

Review Time

Unnecessary Diff
10. Sol과 Fable 5.1의 차이는 이제 성능만으로 보기 어렵다
현재 분위기를 단순화하면 대략 이런 식이다.
GPT-5.6 Sol
강점은 여전히 뚜렷하다.
강한 일반 추론

Agentic Coding

Codex 통합

Programmatic Tool Calling

큰 Context

빠른 처리

상대적으로 낮은 API 비용
OpenAI는 GPT-5.6이 Tool을 연결하고 중간 결과를 처리하며 다음 Action까지 결정하는 Programmatic Tool Calling을 지원하도록 설계했다고 설명한다.
Claude Fable 5.1
이번 세대에서 눈에 띄는 방향은:
장시간 Repository 작업

복잡한 Coding

Code Review

긴 Knowledge Work

Tool 기반 Agent 작업
이다.
특히 최신 독립 평가 초기 결과에서도 Fable 5.1의 추론 성능 상승이 확인되기 시작했다.
11. 가격은 Sol이 여전히 중요한 강점을 가진다
Coding Agent에서는 성능이 전부가 아니다.
Agent는 많은 Token을 소비한다.
Repository가 크다면:
Architecture 문서

Source

Tests

Build Log

Git Diff

Error Log
를 계속 읽는다.
그래서 가격 차이가 장시간 작업에서 크게 누적된다.
Artificial Analysis의 현재 비교에서도 Fable 5.1 Max 구성이 GPT-5.6 Sol medium보다 지능 점수는 높지만 Token 비용은 더 높은 것으로 나타난다.
즉:
가장 강한 모델과:
가장 경제적인 Agent는 반드시 같은 모델이 아니다.
12. 진짜 비교해야 할 것은 Cost per Successful Task다
예를 들어:
Fable 5.1

Task 성공
1회 실행
비용 6달러
와:
Sol

첫 번째 실패
두 번째 Retry
세 번째 성공
총 비용 4달러
라면 Sol이 더 저렴하다.
반대로:
Fable
1회 성공
Sol
4회 실패 후 Human Intervention이라면 Fable이 비싸더라도 전체 비용은 더 낮을 수 있다.
실제 비용은:
Model Cost

+

Retry Cost

+

CI Cost

+

Human Review Time

+

Rework
이다.
그래서 결국 중요한 지표는:
Cost per Successful Task가 된다.
13. 개발자가 직접 비교하려면 벤치마크보다 자기 Repository가 낫다
새 모델이 나왔을 때 LeetCode 같은 문제를 하나 던지는 것보다 실제 Repository에서 같은 일을 맡겨 보는 게 훨씬 낫다.
예를 들어 다섯 가지 정도면 충분하다.
오래된 버그
재현
↓
원인
↓
수정
↓
Regression Test
Repository 전체 Refactoring
영향 범위 조사
↓
계획
↓
수정
↓
Build
↓
Test
Code Review
PR Diff
↓
Critical/Major 문제
↓
Missing Test
↓
실제 영향
실패 Recovery
일부러 깨진 Test를 준다.
그리고:
같은 시도를 반복하는지

가설을 바꾸는지

다른 Evidence를 찾는지
본다.
장시간 작업
30분 이상 걸릴 일을 맡긴다.
그리고 결과를 이렇게 기록한다.
Task Success

Human Intervention

Retry

Runtime

Review Time

Unnecessary Changes
이게 실제 개발자에게는 훨씬 정확한 Benchmark다.
14. 모델을 하나로 고정할 이유도 점점 줄어들고 있다
불과 몇 달 사이에도 순위가 뒤집힌다.
GPT-5.6 Sol이 공개됐을 때는 Fable 5보다 강한 Coding Agent 성능을 강조했다.
그리고 두 달 뒤 Fable 5.1이 나왔다.
이 속도라면 특정 모델 하나를:
우리 팀의 영구 표준으로 만드는 것은 점점 어려워진다.
오히려 Agent Workflow를 모델과 분리하는 게 낫다.
Task
  ↓
Agent
  ↓
Repository
  ↓
Build
  ↓
Test
  ↓
Review
그리고 Agent 자리에:
Fable 5.1

GPT-5.6 Sol

다음 세대 모델
을 교체할 수 있도록 한다.
15. 중요한 규칙은 모델 내부가 아니라 Repository에 남긴다
모델이 바뀌어도 유지돼야 할 것이 있다.
Architecture

Coding Rule

Build Command

Test Policy

Security Rule

Review Rule
이런 것들이다.
따라서:
AGENTS.md

CLAUDE.md

Skills

Architecture Docs

Tests

CI
같은 Repository 자산이 중요해진다.
좋은 Agent Workflow는 특정 모델의 기억에 의존하지 않는다.
16. 모델 Routing도 더 현실적인 선택이 된다
모든 작업에 Fable 5.1이나 Sol Max를 사용할 필요도 없다.
예:
단순 코드 조사
→ 빠른 모델

Boilerplate
→ 저렴한 모델

일반 Feature
→ 중간급 모델

복잡한 Debugging
→ Fable 5.1 / Sol

Architecture 변경
→ 최고 reasoning 구성
이렇게 Task별로 나누는 편이 전체 비용은 훨씬 낮아진다.
17. 특히 XHigh·Max를 항상 켜놓는 시대도 끝나갈 수 있다
강한 모델을 쓰는 것과 모든 Task에서 최대 추론을 사용하는 것은 다르다.
예를 들어:
파일 이름 변경

Import 수정

테스트 Fixture 생성
에 최고 Reasoning이 필요하지는 않다.
반대로:
Deadlock

Memory Corruption

Architecture Migration

희귀 Production Crash
같은 문제에는 강한 추론이 필요하다.
그래서:
Medium
↓
High
↓
XHigh / Max
처럼 필요한 경우에만 올리는 것이 효율적이다.
모델의 평균 성능이 올라갈수록 오히려 이런 Reasoning Routing이 더 중요해진다.
18. Coding Agent의 새로운 병목은 사람의 Review다
Agent 성능이 높아질수록 이상한 현상이 생긴다.
Agent Throughput
↑↑↑

Human Review Throughput
→
Agent 세 개를 동시에 돌리면 세 개의 PR이 나온다.
하지만 Developer 한 명은 세 개를 동시에 Review할 수 없다.
그래서 이제 중요한 Agent 능력은:
많이 수정가 아니다.
Review하기 좋은 변경이다.
예를 들어:
작은 Diff

명확한 변경 이유

실제 실행한 Test

검증하지 못한 부분

Risk 높은 파일
을 짧게 제공하는 Agent가 실무에서는 더 유용하다.
19. 결국 Fable 5.1에서 봐야 하는 건 ‘Attention Efficiency’다
앞으로 Coding Agent 경쟁에서 꽤 중요한 개념이 될 수 있다.
Token Efficiency만이 아니다.
Human Attention Efficiency다.
예를 들어:
Agent A

10달러
사람 개입 1회
Review 10분
Agent B
3달러
사람 개입 12회
Review 45분어느 쪽이 실제로 더 싼지는 명확하지 않다.
Senior Developer의 35분이 API 비용 7달러보다 훨씬 비쌀 수도 있다.
20. 그래서 Fable 5.1의 진짜 경쟁 상대는 Sol의 Benchmark 점수가 아니다
더 근본적인 질문은 이것이다.
누가 더 높은 점수를 받았나?보다는:
어떤 Agent에게 일을 맡겼을 때

개발자가 가장 적게 개입하고

가장 작은 Review 비용으로

신뢰할 수 있는 변경을 받는가?
이다.
이게 앞으로 실무 Agent 경쟁의 핵심에 더 가깝다.
21. GPT-5.6 Sol이 당장 밀려났다고 보기도 어렵다
이번 발표만 보고 Sol을 내려놓을 필요도 없다.
OpenAI의 Sol은 여전히:
Terminal 작업

Programmatic Tool Calling

긴 Context

Codex

Multi-Agent Ultra
라는 상당히 강한 Agent 환경을 가지고 있다.
특히 Sol은 모델 하나만이 아니라 Codex Harness와 함께 평가해야 한다.
Fable 5.1도 Claude Code와 함께 봐야 한다.
따라서 앞으로 비교는 사실:
Fable 5.1
vs
Sol
보다:
Claude Code + Fable 5.1

vs

Codex + GPT-5.6 Sol
쪽이 실제 개발자 경험에 더 가깝다.
22. 이번 발표가 보여준 가장 중요한 변화
Fable 5.1의 점수가 Sol보다 몇 점 높은지는 몇 달 뒤 다시 바뀔 수도 있다.
그보다 중요한 건 Frontier Model 경쟁의 속도다.
7월:
GPT-5.6 Sol 등장

→ Fable 5보다 높은 Coding Agent 지표
9월:
Fable 5.1 등장

→ 다시 Claude 쪽 성능 크게 상승
앞으로도 이런 식일 가능성이 높다.
즉 이제 모델 경쟁은 연 단위가 아니다.
몇 주, 몇 달 단위다.
23. 그래서 개발팀이 준비해야 할 것은 ‘최고 모델 선택’이 아니다
지금 최고인 모델을 찾아 영구적으로 고정하는 것보다:
모델을 쉽게 교체할 수 있는 Agent Workflow가 더 중요하다.
예:
Task Specification
       ↓
Coding Agent
       ↓
Build
       ↓
Tests
       ↓
Static Checks
       ↓
Runtime Verification
       ↓
Human Review
여기서 Coding Agent만 교체하면 된다.
그러면 Fable이 좋아지면 Fable을 쓰고,
Sol이 다음 업데이트에서 다시 올라오면 Sol을 쓸 수 있다.
24. 앞으로 좋은 Coding Agent를 판단할 때 볼 숫자
개발팀이라면 다음 정도면 충분하다.
작업 성공률

평균 Retry 횟수

사람 개입 횟수

Build/Test 성공률

Review 시간

재작업 비율

불필요한 변경량

성공 작업당 비용
특히:
Benchmark Score보다:
Successful Task Rate를 보는 편이 좋다.
25. 개인 개발자도 아주 간단하게 비교할 수 있다
실제 사용하는 Repository 하나를 정한다.
같은 Task 다섯 개를 준비한다.
버그 수정

기능 추가

Refactoring

Code Review

Test 작성
Fable 5.1과 Sol에 각각 똑같이 맡긴다.
그리고 결과를 이렇게 적는다.
| 항목 | Fable 5.1 | GPT-5.6 Sol |
|---|---|---|
| 완료 여부 | ||
| 사람 개입 | ||
| Retry | ||
| Build | ||
| Test | ||
| Review 시간 | ||
| 불필요한 수정 | ||
| 비용 |
5개만 해도 자신의 실제 개발 환경에서는 어느 쪽이 맞는지 꽤 잘 보인다.
인터넷 Benchmark보다 훨씬 유용하다.
마무리
Claude Fable 5.1의 등장은 Coding Agent 경쟁이 얼마나 빠르게 움직이고 있는지를 다시 보여준다.
불과 두 달 전 GPT-5.6 Sol은 Artificial Analysis Coding Agent Index에서 80점을 기록하며 Fable 5를 앞섰고, Terminal-Bench 2.1과 DeepSWE 같은 장시간 Engineering Benchmark에서도 강한 결과를 보여줬다.
그리고 이제 Fable 5.1이 등장했다.
출시 직후 Artificial Analysis 평가에서도 Fable 5.1의 강한 추론 구성은 Sol의 일반적인 reasoning 구성보다 높은 Intelligence Index를 기록하기 시작했다. 다만 서로 reasoning 설정이 다르므로 이 수치를 그대로 모델 전체의 절대 순위로 해석해서는 안 된다.
이번 변화의 핵심은:
Claude가 GPT를 이겼다.가 아니다.
더 중요한 변화는 이것이다.
Coding Model 경쟁
        ↓
Coding Agent 경쟁
        ↓
Engineering Agent 경쟁
코드를 생성하는 능력에서 Repository를 이해하고,
Tool을 사용하고,
실패하면 다시 조사하고,
Build와 Test를 거쳐,
사람이 Review할 수 있는 변경을 만들어내는 능력으로 경쟁의 중심이 이동하고 있다.
그래서 앞으로 모델을 평가할 때도 질문을 바꿔야 한다.
누가 코드를 더 잘 쓰는가?보다:
누가 개발자의 Attention을 가장 적게 사용하면서 신뢰할 수 있는 Software Change를 끝까지 만들어주는가?
Fable 5.1과 GPT-5.6 Sol의 진짜 승부도 결국 여기서 갈릴 가능성이 크다.
그리고 이 속도라면 지금의 1등 모델이 몇 달 뒤에도 1등일 거라는 보장은 없다.
그래서 개발자에게 가장 중요한 자산은 특정 모델이 아니다.
AGENTS.md

Skills

Architecture

Tests

Build

CI

Review Policy
처럼 어떤 Frontier Model이 들어와도 그대로 사용할 수 있는 Engineering System이다.
모델은 계속 바뀐다.
좋은 개발 Workflow는 남는다.
참고 자료
-
Anthropic — Claude Fable
Anthropic은 2026년 9월 1일 Claude Fable 5.1을 발표하고 Coding과 Knowledge Work를 위한 자사의 가장 강력한 모델로 소개했다. -
OpenAI — GPT-5.6
GPT-5.6 Sol은 Artificial Analysis Coding Agent Index 80점, Terminal-Bench 2.1 88.8퍼센트, DeepSWE v1.1 72.7퍼센트를 기록했으며 OpenAI는 긴 Coding·Tool Workflow를 핵심 역량으로 설명한다. -
OpenAI — GPT-5.6 Engineering
OpenAI는 GPT-5.6에서 Context 관리, Prompt Caching, Agent Harness, Programmatic Tool Calling 등을 통해 긴 Agent 작업의 효율을 높이는 방향을 설명하고 있다. -
Artificial Analysis — Claude Fable 5.1 vs GPT-5.6 Sol
출시 직후 비교에서 Fable 5.1의 강한 reasoning 설정이 Sol medium보다 높은 Intelligence Index를 기록하고 있지만 가격과 응답 지연에서는 Sol이 유리한 결과도 나타난다. 서로 reasoning 설정이 다르다는 점을 함께 봐야 한다.
핵심 참고 포인트
Fable 5.1이 나오면서 GPT-5.6 Sol이 모든 Coding 영역에서 명확히 패배했다고 단정할 단계는 아니다. 벤치마크 버전, Reasoning Effort, Harness가 서로 다르기 때문이다.
다만 Fable 5.1 출시 직후의 평가와 Anthropic의 제품 방향을 보면 Claude의 Coding·Long-running Agent 성능이 다시 크게 올라온 것은 분명하다.
따라서 이번 발표를 가장 정확하게 해석하면 “Coding Model의 새로운 절대 1등이 결정됐다”보다는 “Fable 5.1이 Agentic Coding 경쟁을 다시 매우 팽팽하게 만들었고, 이제 모델 비교는 단발 Benchmark보다 실제 Engineering Task 성공률과 사람의 개입 비용을 기준으로 해야 한다”에 가깝다.