Codex 멀티에이전트 구현 + Claude Review·QA 개발 환경
Codex 멀티에이전트 구현 + Claude Review·QA 개발 환경
AI Coding Agent를 처음 사용할 때는 대부분 한 명의 개발자를 하나의 Agent로 대체하는 형태에서 시작한다.
Developer
   ↓
Coding Agent
   ↓
Code
하지만 최근 Coding Agent가 긴 작업을 처리하고, 여러 Repository를 동시에 다루며, Build와 Test까지 수행하기 시작하면서 구조가 조금씩 달라지고 있다.
이제 개인 개발자도 이런 환경을 만들 수 있다.
                     나
                     │
                     ▼
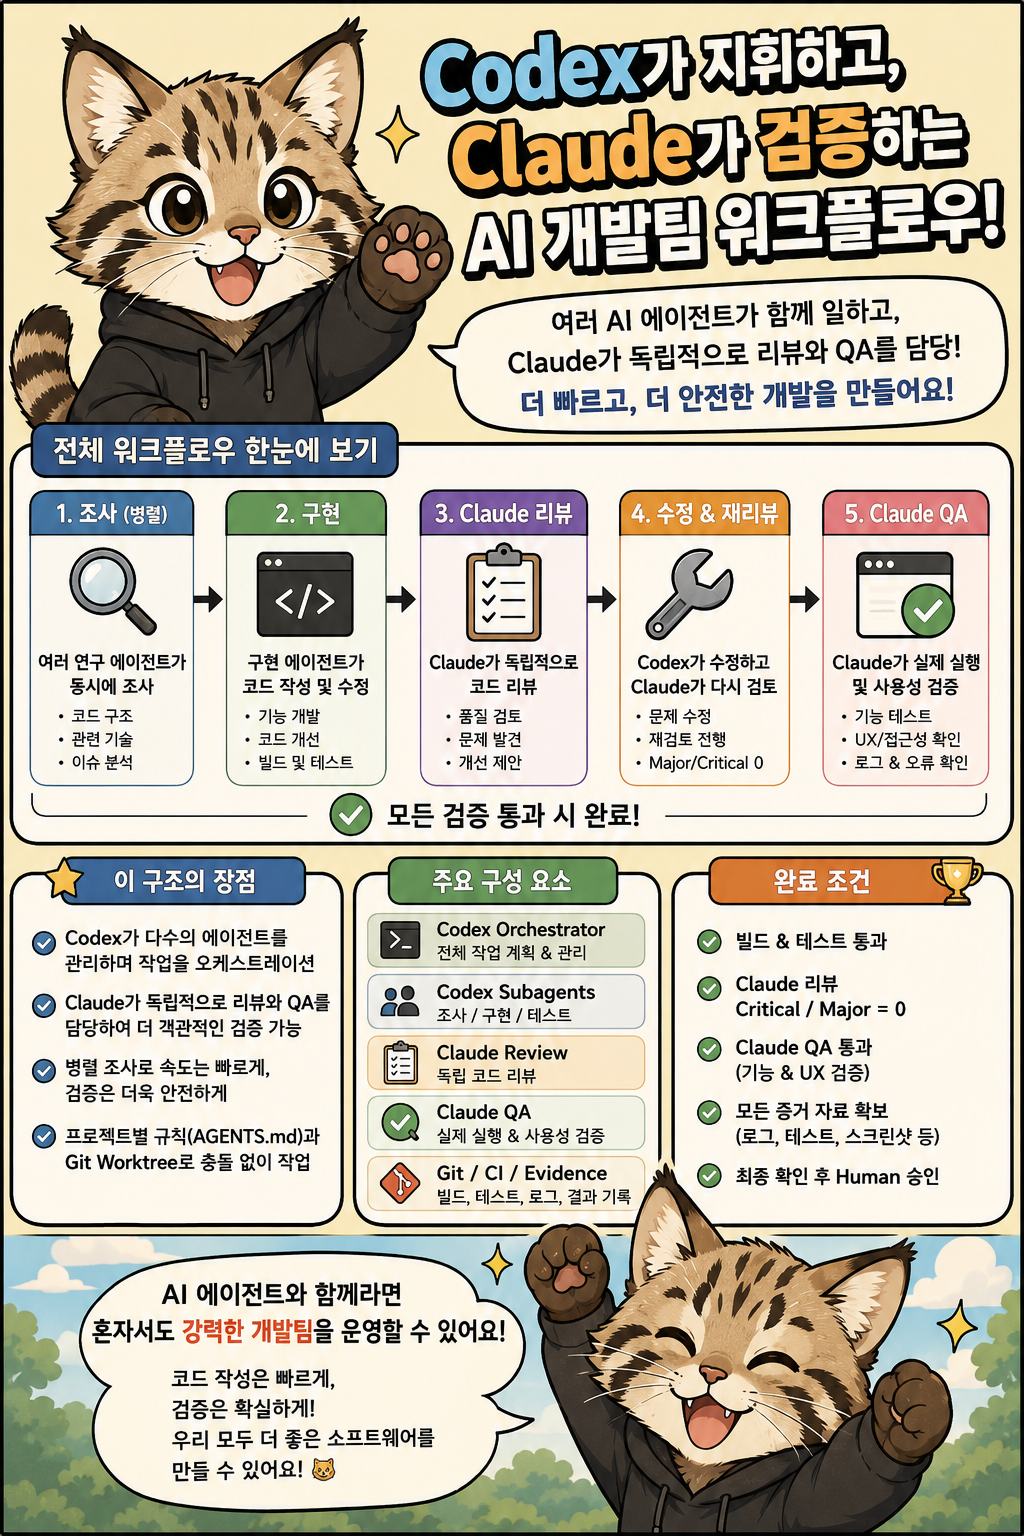
              Codex Orchestrator
                     │
          ┌──────────┼──────────┐
          ▼          ▼          ▼
      조사 Agent   구현 Agent   테스트 Agent
          │          │          │
          └──────────┼──────────┘
                     ▼
                  변경 코드
                     │
                     ▼
               Claude Review
                     │
                     ▼
                 Codex 수정
                     │
                     ▼
                 Claude QA
                     │
                     ▼
              Runtime Evidence
                     │
                     ▼
                  Human Gate
여기서 핵심은 단순히 Agent를 여러 개 실행하는 것이 아니다.
Codex가 구현 조직을 관리하고 Claude를 독립적인 검증 계층으로 분리하는 것이다.
OpenAI는 현재 Codex를 여러 Agent를 동시에 관리하는 command center로 설명하고 있으며, 프로젝트별 Thread와 Git worktree를 이용해 여러 Agent가 같은 Repository에서도 서로 충돌하지 않고 병렬 작업할 수 있도록 지원한다. Skills를 이용해 팀이나 개인의 반복적인 작업 방식도 Codex에 정의할 수 있다.
이 기능들을 잘 조합하면 별도의 복잡한 Agent 플랫폼 없이도 꽤 강력한 개인용 AI 개발 조직을 만들 수 있다.
1. 개인 Workspace 자체를 하나의 작은 개발 조직으로 본다
예를 들어 개인 Workspace가 이렇게 되어 있다고 하자.
~/workspace/

├── ios-camera/
├── ios-pantry/
├── android-app/
├── web-dashboard/
├── backend/
├── automation/
└── novel-tools/
각 폴더는 독립된 Git Repository다.
기존에는 개발자가 직접 프로젝트를 옮겨 다녔다.
ios-camera
→ 작업

web-dashboard
→ 작업

backend
→ 작업
Agent 환경에서는 조금 다르게 생각할 수 있다.
                    Workspace
                        │
                        ▼
                     Codex
                        │
        ┌───────────────┼───────────────┐
        ▼               ▼               ▼
    ios-camera      web-dashboard     backend
        │               │               │
      Agent A          Agent B          Agent C
각 Agent는 자신의 Repository에서 독립적으로 작업한다.
그리고 각 프로젝트 안에는 해당 프로젝트만의 규칙을 둔다.
2. 프로젝트마다 AGENTS.md를 따로 둔다
예를 들어 iOS 프로젝트라면:
ios-camera/
├── .git/
├── AGENTS.md
├── Package.swift
├── Sources/
└── Tests/AGENTS.md:
# 프로젝트 규칙

- Swift 6 기준
- iOS 18 이상
- Swift Concurrency 우선
- UI 상태 변경은 MainActor에서 수행
- 새 외부 라이브러리는 사용자 확인 없이 추가하지 않는다
- 기존 Public API 변경은 확인 후 진행한다
- 구현 후 반드시 Build한다
- 관련 Unit Test가 있으면 실행한다
- 테스트하지 않은 항목은 완료했다고 말하지 않는다
Android라면 전혀 다른 규칙을 둘 수 있다.
# 프로젝트 규칙

- Kotlin
- Jetpack Compose
- Coroutine Structured Concurrency 준수
- StateFlow 사용
- Gradle build 확인
- lint 실행
- 기존 Convention Plugin 규칙 유지
Web:
# 프로젝트 규칙

- Next.js
- TypeScript strict 유지
- 접근성 확인
- Playwright E2E 사용
- Console Error 확인
- Responsive Layout 검증
상위 Codex는 이 모든 세부 규칙을 기억할 필요가 없다.
Workspace Codex
= 어디에서 누가 일할지 결정

각 Repository
= 어떻게 일할지 결정
역할을 분리한다.
3. Codex 멀티에이전트는 ‘모두 코딩’하게 하지 않는다
멀티에이전트를 처음 쓰면 쉽게 이런 구조를 만들게 된다.
Agent A → 구현
Agent B → 구현
Agent C → 구현
Agent D → 구현
하지만 같은 Feature를 여러 Agent가 동시에 수정하면 오히려 관리가 어려워진다.
더 안정적인 구조는 역할을 나누는 것이다.
Research Agent
READ ONLY

Architecture Agent
READ ONLY

Implementation Agent
WRITE

Test Agent
READ + EXECUTE
즉:
병렬 조사
   ↓
결과 취합
   ↓
한 Agent가 구현
방식이다.
독립적인 작업만 병렬화한다.
4. 예를 들어 iOS Camera 버그 하나를 맡긴다면
Goal:
동영상 촬영 중 간헐적으로
AVAssetWriter append가 실패하는 원인을 찾아 수정한다.
상위 Codex가 바로 코드부터 수정하지 않는다.
먼저 작업을 나눈다.
Research Agent A
→ CaptureSession / Frame Pipeline 조사

Research Agent B
→ AVAssetWriter 사용 구조 조사

Research Agent C
→ 관련 Test / Log / Error Path 조사
세 Agent는 동시에 조사할 수 있다.
                 Codex
                   │
       ┌───────────┼───────────┐
       ▼           ▼           ▼
 Frame 조사    Writer 조사    Log 조사
       │           │           │
       └───────────┼───────────┘
                   ▼
              조사 결과 취합
그다음 Implementation Agent 하나가 실제 수정한다.
5. 같은 Repository에서는 Worktree를 이용한다
여러 Agent가 동일 Repository에서 작업할 때 가장 중요한 것이 Git 격리다.
Codex 앱은 Worktree를 기본 지원한다.
각 Agent가:
main repository

├── worktree-research-a
├── worktree-research-b
├── worktree-implementation
└── worktree-test
처럼 독립된 코드 복사본에서 작업할 수 있다.
OpenAI도 Codex 앱에서 여러 Agent가 동일 Repository를 동시에 작업할 때 각 Agent가 별도의 Worktree를 이용하기 때문에 로컬 Git 상태를 건드리지 않고 다양한 접근을 병렬로 시도할 수 있다고 설명한다.
이게 멀티에이전트에서 굉장히 중요하다.
6. Codex를 ‘코더’가 아니라 Tech Lead로 사용한다
상위 Codex 역할은 직접 모든 코드를 작성하는 것이 아니다.
다음에 더 가깝다.
Goal 분석

↓

작업 분해

↓

Agent 배치

↓

결과 수집

↓

구현 방향 선택

↓

Build / Test

↓

검증 Agent에게 전달
즉:
Codex Orchestrator
=
PM
+
Tech Lead
처럼 사용한다.
실제 수정은 하위 Agent가 담당한다.
7. Skills로 오케스트레이션 규칙을 고정한다
매번 Codex에게:
먼저 조사하고
병렬 Agent를 띄우고
한 Agent만 수정하고
테스트하고
Claude Review하고...
라고 설명할 필요는 없다.
Skill로 만든다.
예를 들어:
engineering-orchestratorSkill의 핵심 Goal:
# 목표

독립적인 조사 작업은 Codex subagent로 병렬 수행한다.

실제 Repository 수정은 명확한 소유권을 가진
하나의 Implementation Agent가 담당한다.

구현 완료 후 자동 검증을 수행한다.

그 후 Claude를 독립 Reviewer로 사용한다.

Critical 또는 Major 문제가 발견되면
Codex가 수정하고 다시 Review한다.

Review를 통과한 뒤 Claude QA를 실행한다.

QA에서 문제가 발견되면 다시 Codex로 반환한다.

Critical / Major가 모두 해결되고
필수 Runtime 검증이 끝났을 때만 완료한다.
실행 순서:
1. Goal 확인
2. Repository 규칙 확인
3. 작업 분해
4. 조사 Agent 병렬 실행
5. 결과 취합
6. 구현
7. Build/Test
8. Claude Review
9. 수정
10. Re-review
11. Claude QA
12. 수정
13. Re-QA
14. 결과 보고
OpenAI는 Skills를 반복 가능한 작업 방법, 팀의 표준, 도구 사용 방법 등을 Codex에 제공하는 방식으로 설명하고 있다.
8. Codex만으로 구현과 테스트까지 처리한다
첫 번째 검증 계층은 AI Reviewer가 아니다.
Compiler
Test
Lint
Runtime
다.
예를 들어 iOS라면:
Implementation
      ↓
xcodebuild
      ↓
Unit Test
      ↓
필요한 Simulator 검증
Android:
Implementation
      ↓
Gradle
      ↓
Unit Test
      ↓
Lint
      ↓
Emulator
Web:
Implementation
      ↓
Type Check
      ↓
Unit Test
      ↓
Build
      ↓
Playwright
Agent가:
수정했습니다.
문제 없습니다.
라고 말하는 건 검증이 아니다.
9. 그다음에 Claude를 독립 Reviewer로 붙인다
여기서 Claude가 들어간다.
Codex가 구현했다면 Claude는 코드를 수정하지 않는다.
Codex
= 작성자

Claude
= Reviewer
로 분리한다.
Claude에게 전달할 것은:
Task 목표

Acceptance Criteria

Git Diff

관련 Architecture

관련 Test

프로젝트 규칙
정도다.
그리고 Reviewer Prompt를 고정한다.
이 변경을 독립 Reviewer 관점에서 검토해.

구현을 수정하지 마.

다음 항목에 대해서만
실제 근거가 있는 문제를 보고해.

- Correctness
- Concurrency
- State
- Architecture
- Error handling
- Regression 가능성
- Missing Test
- Security
- Accessibility

결과는:

Critical
Major
Minor
Missing Tests
Not Verified

로 분류해.
10. Claude에게 전체 작업 History를 주지 않는 것도 중요하다
Codex가 구현 과정에서:
왜 이 구조를 선택했는지
어떤 시행착오가 있었는지
를 모두 Claude에게 알려주면 Reviewer도 영향을 받을 수 있다.
독립 Review라면 오히려:
Task

Diff

현재 코드

검증 결과
중심으로 주는 것이 좋다.
그러면:
Codex
→ 구현 당시의 가정

Claude
→ 결과물 자체 평가
가 분리된다.
11. Review 결과는 다시 Codex로 반환한다
예:
Claude Review

CRITICAL
없음

MAJOR

1.
Task cancellation 이후에도
state mutation이 발생할 가능성이 있음.

2.
Error path에서 기존 retry state가 초기화되지 않음.

MINOR

Naming 1건.
상위 Codex는 이걸 받는다.
Claude Findings
       ↓
Codex 판단
       ↓
Implementation Agent 수정
       ↓
Build
       ↓
Tests
그리고 다시 Claude에게 보낸다.
12. Re-review를 반드시 한다
Workflow:
Claude Review
     ↓
문제 발견
     ↓
Codex Fix
     ↓
Claude Re-review
완료 조건:
Critical = 0
Major = 0
로 정할 수 있다.
Minor는 필요에 따라 처리한다.
이렇게 하면 Review Agent가 단순히 참고 의견만 주고 사라지는 구조가 아니다.
13. Review와 QA는 같은 Claude Session으로 하지 않는다
여기서 역할을 한 번 더 분리한다.
Claude Review Agent

Source
Diff
Architecture
Tests
를 본다.
반면:
Claude QA Agent

실행된 앱
User Goal
UI
Runtime
Recording
Logs
를 본다.
즉:
Review
= 코드에서 문제를 예측

QA
= 실제 실행해서 문제를 발견
이다.
14. iOS QA라면
현재 사용 가능한 도구를 기준으로 구성한다.
Claude QA
    │
    ▼
iOS Simulator
    │
    ├── UI Interaction
    ├── Accessibility
    ├── Screenshot
    ├── Screen Recording
    └── Runtime Log
예를 들어:
처음 사용하는 사용자가

1. 카메라 화면 진입
2. 필터 선택
3. 동영상 촬영
4. 촬영 종료
5. 저장

까지 수행한다.
단순히 기능이 되는지만 보는 것이 아니다.
Tap 실패

버튼 발견 시간

Retry

Backtrack

반응 지연

Keyboard/Overlay

잘못된 Navigation
도 확인한다.
15. Android QA도 같은 원칙이다
Claude QA
    │
    ▼
Android Emulator
    │
    ├── Semantics
    ├── UIAutomator
    ├── Screenshot
    ├── Recording
    └── Logcat
Element를 찾을 때도:
Semantic
↓
Accessibility
↓
Text
↓
Identifier
↓
Visual
↓
Coordinate
순서로 접근한다.
좌표 Tap부터 시작하지 않는다.
16. Web에서는 Playwright를 붙이기가 가장 좋다
현재 Web이 Agentic QA를 만들기 가장 좋은 환경이다.
Claude QA
   │
   ▼
Playwright
   │
   ├── DOM
   ├── ARIA
   ├── Browser Interaction
   ├── Video
   ├── Trace
   ├── Console
   └── Network
Playwright는 현재 공식적으로 Planner, Generator, Healer 형태의 Test Agent Workflow도 제공하고 있어 Agent가 앱을 탐색하고 테스트 계획을 만들거나 실패한 테스트를 다시 조사하는 구조를 만들 수 있다.
Claude QA와 결합하면:
User Scenario
     ↓
Browser 사용
     ↓
Problem
     ↓
Screenshot / Video / Trace
     ↓
Finding
형태가 된다.
17. QA에서 동일 실패를 반복하게 두지 않는다
Agent QA를 실제 돌리면 자주 발생하는 문제가 있다.
버튼 Tap
   ↓
실패
   ↓
같은 버튼 Tap
   ↓
실패
   ↓
다시 Tap
이건 좋은 QA가 아니다.
QA Skill에 규칙을 넣는다.
동일한 목표에서
동일하거나 실질적으로 동일한 행동이
2회 실패하면

세 번째 동일 행동을 실행하지 않는다.
대신:
STOP

↓

현재 화면 다시 관찰

↓

Semantic Tree 재확인

↓

Keyboard / Modal / Overlay 확인

↓

Navigation State 확인

↓

다른 탐색 전략
으로 간다.
18. Agent 실패와 Product 실패도 분리한다
Claude가 버튼을 못 찾았다고:
UX가 나쁘다.고 바로 결론내리면 안 된다.
원인은 적어도 네 종류다.
PERCEPTION
화면을 잘못 이해

LOCALIZATION
Element 위치를 잘못 찾음

AUTOMATION
Tap 자체 실패

PRODUCT
실제 앱 문제
QA 결과에는 이 분류를 같이 남기게 한다.
19. QA Evidence를 남긴다
QA Agent의 결과가:
테스트했습니다.
정상입니다.
이면 부족하다.
예:
Scenario
영상 촬영 후 저장

Functional
PASS

Expected Actions
5

Actual Actions
6

Retry
1

Backtrack
0

Runtime
Crash 0

UX Finding
저장 처리 시작까지 약간의 피드백 지연 존재

Evidence
recording.mov
actions.jsonl
screenshots/005.png

Not Verified
Physical Device
정도가 되어야 한다.
20. QA Finding도 다시 Codex로 돌아간다
예를 들어 Claude QA가:
MAJOR

저장 버튼 Tap 후
약 2초간 Feedback이 없어
사용자가 다시 Tap할 가능성이 있음.
을 찾았다.
그럼:
Claude QA Finding
       ↓
Codex
       ↓
관련 State 조사
       ↓
Loading 표시 수정
       ↓
Build/Test
       ↓
Claude QA 2
를 돌린다.
21. 결국 전체 개발 Loop는 이렇게 된다
                         HUMAN
                           │
                           ▼
                   Codex Orchestrator
                           │
          ┌────────────────┼────────────────┐
          ▼                ▼                ▼
      Research         Architecture      Test Analysis
       Codex              Codex              Codex
          │                │                 │
          └────────────────┼─────────────────┘
                           ▼
                    Implementation
                         Codex
                           │
                           ▼
                   Build / Test / Lint
                           │
                           ▼
                    Claude Review
                           │
                    문제 발견?
                    │           │
                   YES         NO
                    │           │
                    ▼           ▼
                Codex Fix    Claude QA
                    │           │
                    ▼           ▼
               Build/Test   Runtime Test
                    │           │
                    └─────┐     │
                          ▼     ▼
                       Re-review
                           │
                           ▼
                        Re-QA
                           │
                           ▼
                    Final Evidence
                           │
                           ▼
                         HUMAN
개인 개발 환경에서도 충분히 현실적인 구조다.
22. 여러 프로젝트를 동시에 돌리면 더 재미있어진다
Workspace가:
workspace/

├── ios-camera/
├── ios-pantry/
├── android/
├── web/
└── backend/
라고 하자.
Codex에서는 서로 다른 Project Thread를 동시에 실행할 수 있다. OpenAI는 현재 Codex를 여러 Agent가 프로젝트를 넘나들며 병렬 작업하는 command center로 설명한다.
예:
                   Codex Workspace
                          │
        ┌─────────────────┼─────────────────┐
        ▼                 ▼                 ▼
    ios-camera           web             backend
        │                 │                 │
  Codex Agent Team   Codex Agent Team  Codex Agent
        │                 │                 │
   Claude Review      Claude Review     Tests
        │                 │
    Claude QA          Claude QA
한 프로젝트가 Build되는 동안 다른 프로젝트 Agent는 Repository 조사를 할 수 있다.
23. 상위 Workspace에는 얇은 규칙만 둔다
예:
# Workspace 운영 규칙

- 각 Agent는 지정된 Repository 안에서만 작업한다.
- Repository의 AGENTS.md를 최우선한다.
- 독립적인 조사 작업은 병렬화한다.
- 동일 파일을 수정하는 Agent를 동시에 실행하지 않는다.
- 구현 Agent와 Review Agent 역할을 분리한다.
- Build/Test 없이 완료 처리하지 않는다.
- Claude Review의 Critical/Major가 0일 때만 QA로 진행한다.
- QA의 주요 문제를 해결하지 않은 상태로 DONE 처리하지 않는다.
프로젝트 세부 규칙은 각 Repository에 둔다.
24. Workspace에는 Task Board 하나를 두면 편하다
예:
TASKS.md내용:
RUNNING

IOS-114
동영상 저장 실패 조사

WEB-081
결제 Flow 개선


REVIEW

ANDROID-044
로그인 상태 처리


QA

IOS-110
필터 촬영 Flow


DONE

WEB-080
프로필 UI
상위 Codex는 이걸 보고 다음 작업을 선택한다.
개인 개발자에게도 상당히 유용하다.
25. Codex가 모든 결정을 하게 하지는 않는다
자동으로 처리해도 되는 것:
Formatting

작은 Refactor

Test 작성

Build 오류 수정

명확한 Bug Fix
확인이 필요한 것:
Public API 변경

Architecture 변경

새 Dependency

Database Schema

Auth 구조
사람에게 남길 것:
Production Deploy

Security Policy

중요 Product 결정

대규모 데이터 Migration
즉:
AUTO

CONFIRM

HUMAN ONLY
세 단계로 나눈다.
26. 최종 완료 조건도 명확하게 만든다
Agent가:
작업 완료했습니다.라고 말한다고 완료가 아니다.
예를 들어:
Implementation 완료

Build PASS

Tests PASS

Claude Review
Critical 0
Major 0

Claude QA
Functional PASS

확인하지 못한 항목 명시

Git Diff 확인 가능
정도가 완료 조건이다.
27. 가장 중요한 목표는 Agent 숫자를 늘리는 게 아니다
멀티에이전트를 구축하다 보면 쉽게:
Agent 10개

Agent 20개
가 목표가 된다.
하지만 실제 병목은 사람이다.
Agent Throughput
↑↑↑

Human Review
→
Agent가 하루에 PR을 20개 만들어도 사람이 검토하지 못하면 아무 의미가 없다.
그래서 오케스트레이션의 목표는:
더 많은 Agent가 아니라:
더 적은 Human Attention으로
더 신뢰할 수 있는 Change
를 만드는 것이다.
28. Codex + Claude 구조의 장점
이 구조에서 역할이 매우 명확하다.
Codex
= 생산

Claude
= 독립 검증

Build/Test/Runtime
= 증거

Human
= 최종 판단
특정 모델 하나의 자기 검증에 의존하지 않는다.
그리고 모델이 바뀌어도 Workflow 자체는 유지할 수 있다.
나중에:
Codex → 다른 구현 Agent

Claude → 다른 Review Agent
로 교체해도:
Goal
→ 구현
→ 검증
→ QA
→ Human
구조는 그대로 남는다.
29. 결국 개인 개발자도 작은 AI 개발팀을 운영하게 된다
예전 개인 개발:
나

기획
설계
개발
테스트
QA
Review
Agent 환경:
                  나
                  │
                  ▼
             Goal / 판단
                  │
                  ▼
               Codex
       ┌──────────┼──────────┐
       ▼          ▼          ▼
     조사        구현       테스트
                  │
                  ▼
                Claude
             Review / QA
                  │
                  ▼
              Evidence
                  │
                  ▼
                  나
개발자가 직접 모든 작업을 수행하는 것에서 AI 팀의 작업 경계를 설계하고 최종 결과를 판단하는 역할로 조금씩 이동한다.
30. 그렇다면 Orca는 필요 없을까?
꼭 그렇지는 않다.
Codex 안에서만 이런 환경을 구성하면 가장 단순하다는 장점이 있다.
Codex 자체가 이미:
- Multi-agent
- 프로젝트별 Thread
- Git Worktree
- Skills
- Background Work
를 지원하기 때문이다.
하지만 Agent 종류를 더 자유롭게 섞거나, Agent 실행 상태 자체를 별도 시스템에서 관리하고 싶다면 외부 오케스트레이션 계층이 의미가 있다.
대표적인 예가 Orca 계열이다.
31. Orca를 넣으면 구조는 이렇게 바뀐다
                    Human
                      │
                      ▼
                Orchestrator
                      │
                      ▼
                    Orca
        ┌─────────────┼─────────────┐
        ▼             ▼             ▼
      Codex       Claude Code     Cursor
        │             │             │
        └─────────────┼─────────────┘
                      ▼
              Isolated Worktrees
Orca 프로젝트들은 일반적으로 Agent마다 독립 Git worktree를 만들고 여러 Worker를 병렬 실행한 뒤 상태와 결과를 오케스트레이터에 전달하는 방식을 사용한다.
예를 들어 araa47/orca는 각 Worker를 독립 Git worktree와 tmux 환경에 실행하고 background daemon이 Worker 완료·막힘 상태 등을 감시해 상위 오케스트레이터에게 전달한다. Codex·Claude Code·Cursor를 Worker로 사용할 수 있다. 다만 해당 프로젝트 자체가 개인/Hobby 프로젝트라는 점은 감안해야 한다.
다른 orca-cli/orca 구현은 SQLite에 Run 상태를 저장하고, 각 Agent를 Worktree로 격리하며, MCP를 통해 Codex·Claude Code·Cursor·OpenCode 등의 Agent가 Orca를 제어할 수 있도록 설계돼 있다. 작업 의존성을 DAG로 구성하는 Pod 구조도 제공한다.
32. Orca가 Codex Native 방식보다 좋은 경우
다음 같은 상황이다.
Codex만 사용이 아니라:
Codex

Claude Code

Cursor

OpenCode

다른 Agent
를 동시에 Worker로 사용하고 싶다.
또는:
Agent 상태

Run History

작업 DAG

완료 이벤트

Retry

Worker 교체
를 모델과 분리된 시스템에서 관리하고 싶을 수도 있다.
이런 경우 Orca 같은 별도 Orchestration Layer가 더 자연스럽다.
33. 반대로 개인 개발자라면 Codex Native부터 시작하는 게 좋다
처음부터:
Codex
+
Claude
+
Orca
+
MCP
+
tmux
+
Task DB
를 모두 구성할 필요는 없다.
관리해야 하는 시스템만 늘어난다.
현재 Codex가 제공하는 기능으로 먼저:
Codex Multi-Agent

+

Worktree

+

Skills

+

Claude Review/QA
를 구성해보는 편이 좋다.
필요한 순간이 오면 Orca를 추가한다.
34. 비슷한 효과를 내는 다른 방식도 있다
Orca만 유일한 방법은 아니다.
예를 들어 Orka Agents 계열 프로젝트는 Codex CLI·Claude Code CLI·GitHub Copilot CLI·OpenCode 같은 Repository 기반 Coding Agent Runtime을 하나의 Coordinator 아래에서 실행하고, 장시간 Goal Loop와 Multi-Agent Coordination을 제공하는 방향으로 개발되고 있다.
또 다른 Orca 계열 데스크톱 환경들은 여러 Codex·Claude Code·OpenCode Agent를 각각 Worktree에서 병렬 실행하고 결과를 한 화면에서 비교하는 구조를 제공한다.
그리고 꼭 별도 오케스트레이터를 사용할 필요도 없다.
Claude Code의 Subagent, Codex Multi-Agent, CI Workflow, Git Worktree와 간단한 Task Ledger를 조합해서 직접 작은 오케스트레이션 환경을 만들 수도 있다.
마무리
현재 개인 개발자에게 꽤 현실적인 시작점은 이 구조라고 생각한다.
                    HUMAN
                      │
                      ▼
              Codex Orchestrator
                      │
          ┌───────────┼───────────┐
          ▼           ▼           ▼
       Research    Architecture   Test
        Codex        Codex        Codex
          │           │           │
          └───────────┼───────────┘
                      ▼
               Codex Implementation
                      │
                      ▼
                Build / Test
                      │
                      ▼
                Claude Review
                      │
                 Codex Fix
                      │
                 Re-review
                      │
                      ▼
                  Claude QA
                      │
                Runtime Evidence
                      │
                      ▼
                    HUMAN
이 구조에서 Codex는 단순한 Coding Agent가 아니다.
여러 작업과 Agent를 관리하는 Engineering Orchestrator가 된다.
Claude도 두 번째 Coding Agent로 사용하지 않는다.
Claude Review
Claude Runtime QA
라는 독립 검증 계층으로 사용한다.
그리고 가장 중요한 판단은 AI가 아니라:
Compiler
Tests
Runtime
Git Diff
Human
에 남긴다.
OpenAI가 Codex를 여러 Agent를 병렬로 관리하는 command center로 확장하고 Worktree와 Skills를 기본 기능으로 넣은 것도 결국 개발 Workflow가 이런 방향으로 이동하고 있기 때문이다.
중요한 것은 Agent를 몇 명 띄웠느냐가 아니다.
개발자의 개입을 얼마나 줄이면서도 검증 가능한 Software Change를 만들어낼 수 있느냐다.
그래서 개인 Workspace가 이미 여러 Git Repository로 잘 나뉘어 있다면 굳이 거대한 Agent Platform부터 구축할 필요가 없다.
먼저:
Workspace
+
Codex Multi-Agent
+
프로젝트별 AGENTS.md
+
Skills
+
Git Worktree
+
Claude Review
+
Claude QA
로 시작해도 상당히 강력한 개인 AI 개발팀을 만들 수 있다.
그리고 프로젝트 수가 늘어나거나 서로 다른 Coding Agent를 동시에 운영하고 싶어질 때는 그 위에 Orca 같은 Agent Orchestrator, Orka Agents 계열, 또는 다른 Multi-Agent Runtime을 얹어 비슷한 구조를 더 명시적인 실행·상태 관리 시스템으로 확장할 수 있다.
즉 선택은 두 가지다.
가볍게 시작

Codex Native
+ Claude Review/QA
또는:
Agent 종류와 규모 확대

Orchestration Layer
+ Codex
+ Claude Code
+ 기타 Agent
어느 쪽이든 핵심 Architecture는 같다.
구현하는 Agent와 검증하는 Agent를 분리하고, Agent보다 Evidence를 신뢰하며, 사람은 가장 비싼 판단에만 개입하는 것.
앞으로 개인 개발 환경도 점점 IDE 하나를 사용하는 방식에서 작은 AI 개발 조직을 운영하는 방식으로 바뀔 가능성이 크다.
참고 자료
OpenAI는 Codex를 여러 Agent를 동시에 관리하고 프로젝트별로 병렬 작업을 수행하는 command center로 제공하고 있으며, 같은 Repository에서도 Git worktree를 통해 Agent 작업을 격리할 수 있다고 설명한다. Skills를 통해 반복적인 개발 Workflow와 팀 규칙을 Codex에 제공할 수도 있다.
Orca 계열 오픈소스 프로젝트들은 Codex·Claude Code·Cursor 같은 Coding Agent를 독립 Git worktree에 실행하고, Worker의 상태·완료·Retry·작업 의존성을 오케스트레이션 계층에서 관리하는 접근을 보여준다. 구현마다 기능과 성숙도는 다르므로 실제 도입 전 프로젝트 상태와 유지보수 수준을 확인할 필요가 있다.
핵심 참고 포인트
처음부터 외부 Orchestrator를 추가해야 하는 것은 아니다. 현재 Codex 자체가 Multi-Agent + Worktree + Skills + 프로젝트 단위 작업을 제공하기 때문에 개인 개발 환경에서는 먼저 Codex를 상위 오케스트레이터로 두고 Claude를 Review·QA 계층으로 분리하는 방식이 비교적 단순하다.
프로젝트와 Agent 수가 늘어나거나 Codex·Claude Code·Cursor 등 여러 Agent Runtime을 한 시스템에서 운영하고 싶어진다면 Orca나 Orka 같은 별도의 오케스트레이션 도구를 추가할 수 있다. 중요한 것은 특정 도구가 아니라 Goal → 병렬 조사 → 구현 → 자동 검증 → 독립 Review → Runtime QA → Human Gate라는 Workflow 자체다.