Jev가 뭐냐
Jev가 뭐냐 v1.01
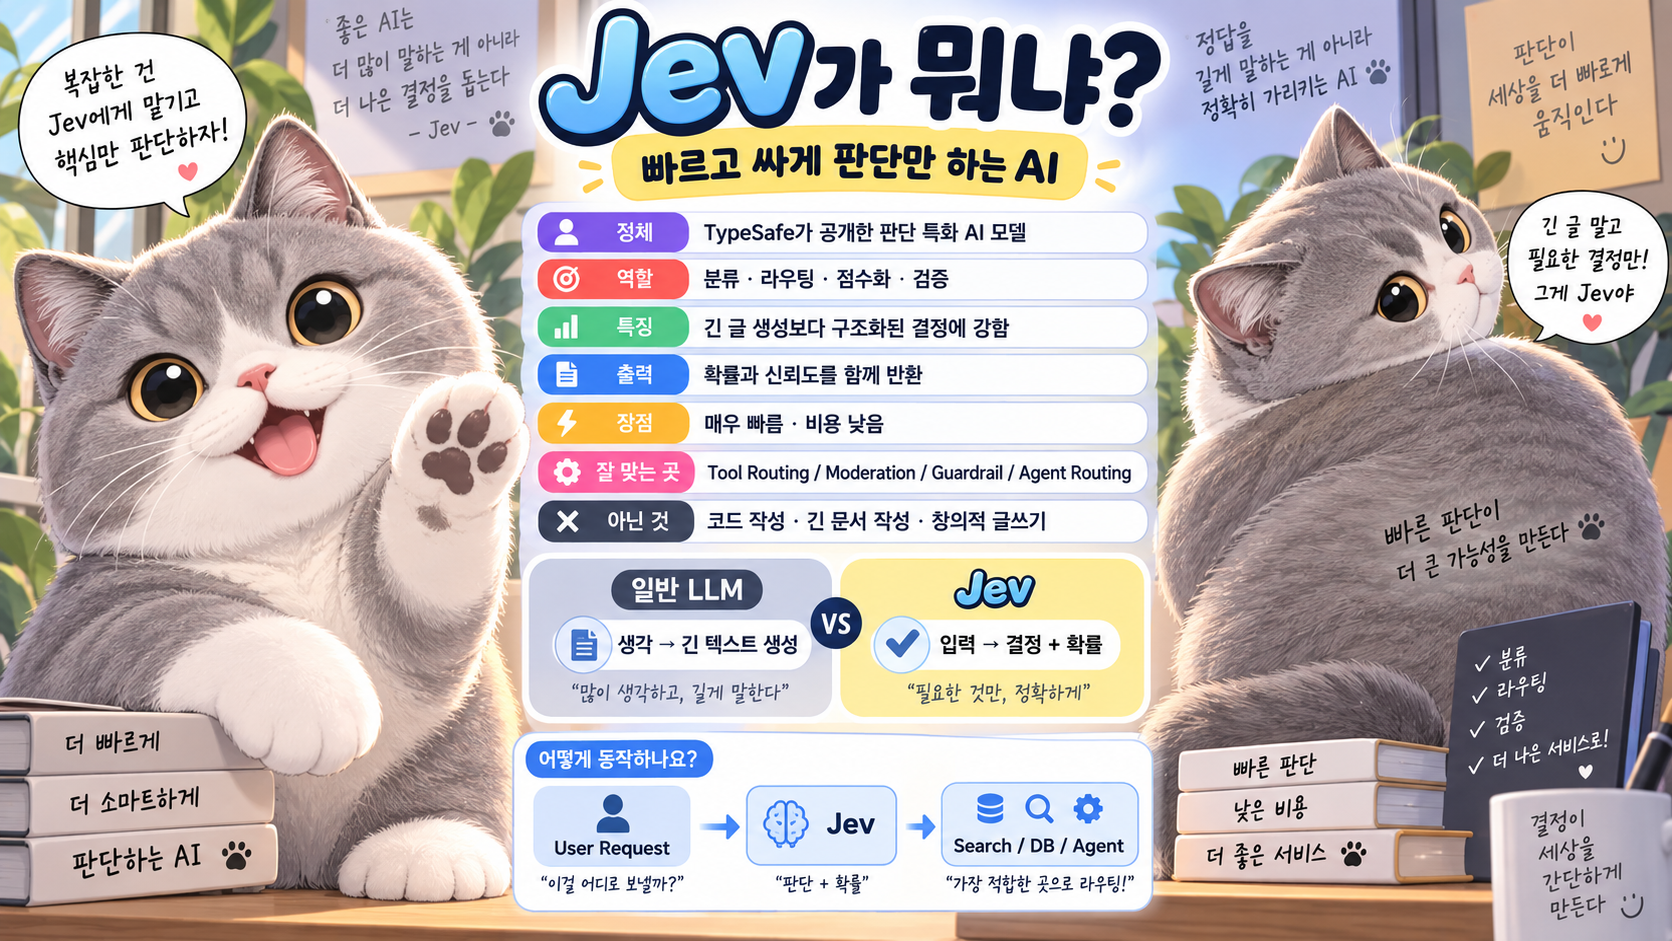
LLM 대신 ‘판단’만 빠르게 하는 AI가 나온 이유
요즘 AI 모델은 코드를 작성하고, 검색하고, Tool을 호출하고, 여러 단계를 거쳐 문제를 해결합니다.
그런데 실제 서비스를 만들다 보면 모든 요청에 GPT, Claude, Gemini 같은 큰 모델이 필요한 것은 아닙니다.
예를 들어 이런 판단입니다.
이 문의는 결제 문제인가?

검색으로 보낼까,
DB 조회로 보낼까?

이 메시지는 위험한가?

자동 승인해도 되는가?

어느 Agent에게 보내야 하는가?
이런 문제는 단순한 if문으로 처리하기에는 애매하지만, 매번 큰 LLM을 호출하기에는 과합니다.
TypeSafe AI가 2026년 9월 공개한 Jev는 바로 이 중간 영역을 노립니다.
Jev는 긴 글을 생성하는 모델이 아닙니다.
미리 정해진 선택지 중에서 빠르게 판단하고, 그 판단의 확률까지 반환하는 모델에 가깝습니다.
1. Jev는 일반 LLM과 무엇이 다른가
일반 LLM은 기본적으로 문자열을 생성합니다.
Input
 ↓
LLM
 ↓
Token
 ↓
Token
 ↓
Token
 ↓
Text
JSON이나 Structured Output을 사용해 결과 형식을 제한할 수는 있지만 본질적으로는 생성형 모델입니다.
예를 들어:
{
  "category": "billing",
  "confidence": 0.96
}
같은 결과를 만들 때도 Token을 순차적으로 생성합니다.
Jev는 출발점부터 다릅니다.
Unstructured State
        ↓
       Jev
        ↓
Typed Probabilistic Decision
사용자가:
"카드 결제가 두 번 됐어요."라고 입력했다면,
billing      0.96
technical    0.02
account      0.01
other        0.01
처럼 판단 결과를 바로 반환하는 방식입니다.
여기서 한 가지 구분할 부분이 있습니다.
위 예제처럼:
billing
technical
account
other
중 반드시 하나를 선택해야 하는 문제라면 Jev의 Choice가 잘 맞습니다.
하지만 실제 고객 문의는 하나의 Label로 끝나지 않을 수도 있습니다.
예를 들어:
"결제가 두 번 됐고,
환불 요청했는데 아직 돈도 안 들어왔어요."
라면:
결제 문제
+
중복 결제
+
환불 미수신
이 동시에 성립할 수 있습니다.
이런 문제를 하나의 Choice로 만들면 중요한 정보 하나가 사라질 수 있습니다.
이럴 때 Jev에서는 각각을 독립적인 Yes/No 판단으로 분리하는 Noul을 사용할 수 있습니다.
duplicate_charge?

YES    0.97
NO     0.03
refund_missing?
YES 0.88
NO 0.12account_problem?
YES 0.07
NO 0.93needs_human_review?
YES 0.74
NO 0.26이렇게 하면 여러 조건을 동시에 유지할 수 있습니다.
즉 Jev에서 중요한 것은 모든 문제를 하나의 거대한 분류기로 만드는 것이 아닙니다.
문제를 작은 판단으로 나눈 뒤 그 결과를 Code에서 다시 조합하는 것에 가깝습니다.
핵심은 설명문을 잘 만드는 것보다 소프트웨어가 바로 사용할 수 있는 결정을 반환하는 것입니다.
TypeSafe는 이런 형태를 System One Model이라고 부릅니다.
2. 챗봇보다 ‘똑똑한 if문’에 가깝다
Jev를 이해하기 가장 쉬운 방법은 확률적으로 판단하는 if문이라고 생각하는 것입니다.
기존 코드라면:
if message.contains("결제") {
    route = .billing
} else if message.contains("비밀번호") {
    route = .account
}
처럼 만들 수 있습니다.
하지만 실제 사용자의 문장은 훨씬 다양합니다.
"결제가 안 된 것 같은데 돈은 빠져나갔어요."

"환불했다고 했는데 아직 입금이 안 됐어요."

"카드는 정상인데 주문이 두 번 잡혔습니다."
Rule을 계속 추가하면 유지하기 어려워집니다.
반대로 이 정도 문제를 매번 Frontier LLM에 보내는 것도 과합니다.
Jev가 들어갈 자리는 대략 이 사이입니다.
Hard-coded Rule
      ↓
     Jev
      ↓
Full LLM / Agent
즉,
규칙만으로 처리하기에는 애매하지만 깊은 추론까지는 필요 없는 판단
에 적합합니다.
Choice / Noul / Score는 언제 쓰나
Jev의 판단을 조금 더 정확하게 나누면 세 가지 Primitive로 볼 수 있습니다.
반드시 하나만 골라야 한다
→ Choice
예를 들면:
billing
technical
account
other
중 하나를 선택하거나,
Architect
Developer
QA
Reviewer
중 하나의 Agent로 Routing하는 경우입니다.
반대로 여러 조건이 동시에 참일 수 있다면:
각 조건을 독립적으로 판단
→ Noul
을 사용할 수 있습니다.
결제 문제인가?
→ YES / NO

환불 문제인가?
→ YES / NO

사기 가능성이 있는가?
→ YES / NO

사람의 검토가 필요한가?
→ YES / NO
처럼 각각 독립적으로 판단합니다.
강도나 정도를 판단해야 한다면:
연속적인 평가
→ Score
를 사용할 수 있습니다.
예를 들어:
위험도

품질

관련성

우선순위
같은 문제입니다.
간단하게 정리하면:
Choice
→ 하나를 선택

Noul
→ 독립적인 Yes / No

Score
→ 정도를 평가
입니다.
이 Primitive들을 Code에서 조합하면 하나의 복잡한 Workflow를 만들 수 있습니다.
3. 가장 중요한 특징은 Confidence다
자동화에서 어려운 것은 AI가 틀린다는 사실 자체가 아닙니다.
더 큰 문제는 틀린 결과를 얼마나 확신하고 있는지 알기 어렵다는 것입니다.
예를 들어 실제 정확도가 95%인 모델이라도 모든 결과에:
confidence = 0.99를 반환한다면 그대로 자동화하기 어렵습니다.
반대로 Confidence가 실제 정확도와 잘 맞는다면 시스템을 이렇게 만들 수 있습니다.
Confidence > 0.95
        ↓
자동 처리

0.70 ~ 0.95
        ↓
큰 LLM으로 재검토

< 0.70
        ↓
Human Review
TypeSafe가 Jev에서 특히 강조하는 것이 바로 Calibrated Probability입니다.
단순히:
billing이라고 답하는 것이 아니라,
billing = 0.96처럼 이 판단을 얼마나 믿을 수 있는지까지 같이 제공합니다.
이 구조가 실무에서 꽤 중요합니다.
AI를 무조건 믿고 실행하는 것이 아니라 Confidence에 따라 자동화 수준을 조절할 수 있기 때문입니다.
그리고 Confidence Gate를 반드시 최종 Label 하나에만 적용할 필요도 없습니다.
여러 개의 Noul을 사용한다면 각각의 판단에 Threshold를 적용할 수 있습니다.
예를 들어:
duplicate_charge

YES 0.97
→ 자동 Tag
refund_missing
YES 0.82
→ LLM Reviewfraud_suspected
YES 0.31
→ 적용하지 않음그리고 Code에서 결과를 다시 조합합니다.
여러 Label이 동시에 높은 확률
→ Multi-intent 처리

애매한 판단 존재
→ LLM Review

전체적으로 불확실
→ Human Review
처럼 구성할 수 있습니다.
여기서 사용한:
0.95
0.70
은 Jev가 정해주는 공식 Threshold가 아닙니다.
서비스 특성과 오판 비용에 따라 개발자가 정하는 운영 기준의 예시입니다.
예를 들어 금융 승인처럼 잘못된 자동처리의 비용이 큰 서비스와 단순 문의 Tagging 서비스가 같은 Threshold를 사용할 이유는 없습니다.
4. Agent 시스템에서는 Router로 쓰기 좋다
최근 Agent Architecture에서 자주 반복되는 작업 중 하나가 Routing입니다.
예를 들어:
User Request
      ↓
Router
      ↓
 ┌────┼─────────┐
Search DB   Coding Agent
이 Router도 LLM으로 만들 수 있습니다.
하지만 모든 요청마다 큰 Reasoning Model을 한 번씩 호출하면 Routing 자체가 비용과 Latency가 됩니다.
Jev를 앞단에 넣으면 구조가 달라집니다.
User Request
      ↓
     Jev
      ↓
 ┌────┼──────────────┐
Tool  Skill        Agent
예를 들어:
Search Tool       0.87
Database Tool     0.08
Coding Agent      0.03
Human Review      0.02
가 나온다면 Search Tool로 바로 보냅니다.
반대로:
Research Agent    0.42
Database Tool     0.38
Human Review      0.20
처럼 애매하다면 바로 실행하지 않고 큰 모델이나 사람에게 판단을 넘길 수 있습니다.
Jev가 Agent를 대체하는 것은 아닙니다.
큰 Agent가 필요한지를 먼저 판단하는 앞단의 Decision Layer에 가깝습니다.
다만 여기에서도 Choice와 Noul을 구분하면 좋습니다.
예를 들어:
이 요청을 담당할 Agent 하나만 선택한다.라면:
Architect      0.07
Developer      0.81
QA             0.09
Reviewer       0.03
같은 Choice가 자연스럽습니다.
반대로 요청 하나에 여러 작업이 포함될 수도 있습니다.
"이 PR의 보안 문제를 확인하고
Simulator Regression도 돌려줘."
같은 요청입니다.
이 경우:
Security Agent?

YES 0.94
Simulator QA?
YES 0.91Coding Agent?
NO 0.82처럼 여러 Noul로 분리할 수 있습니다.
그러면 Orchestrator는:
Security Agent
+
Simulator QA Agent
를 둘 다 실행할 수 있습니다.
즉:
하나의 목적지만 선택
→ Choice

여러 Tool / Agent가 동시에 필요
→ 여러 Noul
처럼 구분할 수 있습니다.
5. Multi-Agent 비용을 줄이는 앞단 판단기로도 쓸 수 있다
Agent가 많아지면 Routing 자체도 중요한 문제가 됩니다.
Main System
 ├─ Coding Agent
 ├─ Security Agent
 ├─ Research Agent
 ├─ Data Agent
 └─ Release Agent
모든 요청에 Main LLM이 먼저:
어느 Agent가 처리해야 하지?
라고 판단한다면 Agent를 호출하기도 전에 Model Call 하나가 필요합니다.
Routing이 충분히 정형화돼 있다면 Jev 같은 Decision Model을 앞에 둘 수 있습니다.
Request
   ↓
  Jev
   ↓
선택된 Agent만 호출
Agent 요청량이 많아질수록 이런 작은 차이가 비용과 응답 시간에 영향을 줄 수 있습니다.
6. Skill + MCP 구조와도 잘 맞는다
최근 Agent Architecture에서는 모든 기능을 Agent로 만들기보다:
Skill
+
MCP Tool
을 활용하는 방식도 늘고 있습니다.
예를 들어 개발 Agent가 다음 Capability를 가지고 있다고 해보겠습니다.
Swift Migration Skill

Release Skill

GitHub MCP

Research Agent
요청이 들어오면 어디로 보낼지 결정해야 합니다.
Request
   ↓
  Jev
   ↓
 ┌──────┬───────┬────────────┐
Skill   MCP    Research Agent
Jev는 Orchestrator 전체를 대체한다기보다,
Orchestrator가 계속 반복하는 작은 판단을 앞단에서 처리하는 역할에 가깝습니다.
7. Moderation과 Guardrail에도 잘 맞는다
Jev 같은 Decision Model이 잘 맞는 또 다른 영역은 Moderation입니다.
예를 들어:
Safe          0.96
Harmful       0.03
Uncertain     0.01
또는:
Prompt Injection

Yes   0.91
No    0.09
처럼 사용할 수 있습니다.
Agent 시스템에서는 흔히:
User Input
    ↓
Guardrail
    ↓
Agent
    ↓
Tool Call
구조를 사용합니다.
모든 입력을 큰 LLM에게 먼저 보내지 않고, 빠른 Decision Layer가 위험도를 평가한 뒤 필요한 요청만 Agent로 넘기는 방식입니다.
8. Agent 결과를 다시 검증하는 데도 사용할 수 있다
Jev를 Input Router로만 볼 필요는 없습니다.
Agent가 만든 결과 뒤에도 붙일 수 있습니다.
Coding Agent
      ↓
Code Change
      ↓
Jev Verification
예를 들어:
요청을 충족했는가?

YES 0.94
NO  0.06
또는:
Security Risk

Low       0.82
Medium    0.15
High      0.03
같은 판단을 할 수 있습니다.
다만 Build나 Unit Test처럼 명확하게 확인할 수 있는 것은 AI에게 물어볼 이유가 없습니다.
Compiler
Test
Static Analysis
로 검증하면 됩니다.
좋은 기준은 이렇습니다.
확실한 검증
→ Code

애매한 판단
→ Jev
9. 일반 LLM의 Structured Output과는 뭐가 다른가
GPT나 Claude도 JSON Schema를 사용해서:
{
  "route": "research",
  "confidence": 0.91
}
같은 결과를 반환할 수 있습니다.
그러면 이런 질문이 생깁니다.
그냥 GPT Structured Output 쓰면 되는 것 아닌가?
가능합니다.
차이는 Output Format이 아니라 Model이 무엇을 위해 설계됐느냐입니다.
일반 LLM은:
Generative Model
      ↓
Schema Constraint
      ↓
Structured Output
입니다.
Jev는:
Decision Model
      ↓
Typed Decision
자체가 목적입니다.
TypeSafe 설명에 따르면 Jev는 긴 문자열을 순차 생성하지 않고 여러 판단을 병렬로 계산하는 구조를 사용합니다.
Text Generation이 필요 없는 작업에서는 그 차이가 Latency와 Cost로 나타날 수 있다는 설명입니다.
10. “Zero Hallucination”이라는 표현은 구분해서 봐야 한다
TypeSafe는 Jev를 설명하면서 Zero Hallucinations라는 강한 표현도 사용합니다.
그대로 받아들이기보다는 의미를 나눠 보는 것이 좋습니다.
Jev는 자유로운 문자열을 생성하지 않기 때문에:
존재하지 않는 API 생성

없는 Tool 이름 생성

Schema 밖의 Field 생성
같은 Generative Hallucination Surface는 크게 줄어듭니다.
하지만 판단 자체는 틀릴 수 있습니다.
실제: billing

Jev: technical
같은 오류입니다.
즉:
Wrong Type
→ 구조적으로 방지 가능

Wrong Decision
→ 여전히 가능
입니다.
그래서 Confidence Calibration이 중요합니다.
11. 속도와 비용은 상당히 공격적인 숫자다
TypeSafe 공식 발표에 따르면 Jev의 End-to-end Response Time은 현재 대략:
70ms ~ 500ms범위라고 설명합니다.
공개 가격은:
$0.042 / 1M input tokens입니다.
Output Token은 별도로 과금하지 않는다고 밝히고 있습니다.
자체 Workflow Evaluation에서는 최대:
193.6x faster

444.6x cheaper
라는 결과도 공개했습니다.
다만 이 수치는 그대로 일반화하면 안 됩니다.
TypeSafe 역시 해당 Workflow가 System One 형태에 잘 맞는 작업이고, 내부 Evaluation 설계에 Bias가 존재할 가능성을 인정하고 있습니다.
따라서:
Jev가 GPT보다 193배 빠르다.
라고 보기보다는,
Decision 중심 Workflow에서는 큰 Generative Model보다 상당한 속도와 비용 이점이 나올 가능성이 있다.
정도로 보는 것이 적절합니다.
12. Jev가 잘 맞는 곳과 안 맞는 곳
잘 맞는 작업은 꽤 명확합니다.
Classification

Routing

Scoring

Verification

Moderation

Guardrail

Fraud Detection

Search Ranking
반대로 다음 작업에는 적합하지 않습니다.
코드 작성

문서 작성

Research

긴 대화

Architecture 설계

복잡한 Reasoning
이런 작업은 여전히 GPT, Claude, Gemini 같은 Generative Model이나 Agent 영역입니다.
13. Code / Jev / LLM / Agent의 역할은 다르다
AI를 전부 하나의 Model로 해결할 필요는 없습니다.
문제의 성격에 따라 역할을 나눌 수 있습니다.
Code
→ 확실한 규칙

Jev
→ 빠르고 애매한 판단

LLM
→ 깊은 추론과 생성

Agent
→ 장기적인 작업 수행
예를 들어:
Code
HTTP Status 확인
정확한 계산
Schema Validation
Unit Test
처럼 결과가 명확한 작업입니다.
Jev
분류
라우팅
점수화
Moderation
Approval 판단
처럼 정답이 애매하지만 긴 추론이 필요하지 않은 작업입니다.
LLM
코드 생성
문서 작성
복잡한 설명
Research 결과 정리
같은 생성과 추론을 담당합니다.
Agent
여러 Tool 사용
계획 수립
반복적인 작업
장시간 자동화
를 담당합니다.
각각의 장점을 조합하는 것이 모든 요청에 가장 큰 Model을 사용하는 것보다 훨씬 현실적인 Architecture가 될 수 있습니다.
14. 실제 서비스에서는 Confidence Gate가 핵심이다
Jev를 Production에 넣는다면 결과를 그대로 믿고 실행하는 구조보다는 Threshold를 두는 편이 현실적입니다.
Jev Decision
     ↓
Confidence
그리고:
> 0.95
→ 자동 처리

0.70 ~ 0.95
→ Frontier LLM 재검토

< 0.70
→ Human Review
처럼 구성할 수 있습니다.
이 패턴은:
Agent Routing

Moderation

Fraud

Approval

Quality Gate
같은 영역에 그대로 적용할 수 있습니다.
결국 중요한 것은 Jev의 판단 자체보다 얼마나 확실할 때 자동화를 허용할 것인가입니다.
여기서도 0.95 / 0.70은 Jev가 정해주는 고정 기준이 아니라 서비스 정책을 설명하기 위한 예시입니다.
실제 Production에서는 업무의 위험도와 오판 비용을 기준으로 Threshold를 따로 검증해야 합니다.
또 여러 Noul을 사용하는 Workflow라면 하나의 최종 Confidence만 보는 대신 각 판단마다 서로 다른 Threshold를 적용하고 Code에서 결과를 조합할 수도 있습니다.
15. 아직은 Early Access다
현재 Jev는 Early Access 단계입니다.
따라서 Production 적용에서는 아직 확인해야 할 것이 많습니다.
실제 Traffic에서의 Latency

Domain별 Accuracy

Confidence Calibration

Long-term Reliability

Pricing

API Stability
특히 현재 공개된 주요 성능 수치는 TypeSafe 자체 Evaluation입니다.
공개된 숫자만 보고 바로 기존 시스템을 교체하기보다는 실제 서비스의 Workflow로 비교하는 것이 좋습니다.
16. 실제 도입을 검토한다면 이 질문부터 하면 된다
현재 시스템에서 큰 LLM이 다음 일을 하고 있는지 먼저 확인하면 됩니다.
분류

점수화

라우팅

검증

Filter

Guardrail
그리고 질문합니다.
이 작업에서 실제로 긴 Text Generation이 필요한가?
필요하지 않다면 Jev 같은 Decision Model을 검토할 가치가 있습니다.
반대로:
복잡한 추론

코드 생성

Research

문서 생성
이 필요하다면 기존 LLM이 더 적합합니다.
그리고 한 가지 질문을 더 해볼 수 있습니다.
이 판단은 반드시 하나만 선택해야 하는가?
그렇다면:
Choice가 맞을 수 있습니다.
반대로:
여러 조건이 동시에 성립할 수 있는가?
라면:
Noul
+
Noul
+
Noul
로 판단을 분리하는 편이 더 자연스럽습니다.
정도를 평가하는 문제라면:
Score를 검토할 수 있습니다.
즉 실제 Jev Workflow는:
State
 ↓
여러 개의 작은 Typed Decision
 ↓
Probability / Confidence
 ↓
Code
 ↓
최종 Action
처럼 구성하는 것이 핵심입니다.
마치며
Jev가 흥미로운 이유는 GPT나 Claude보다 더 큰 모델이 나왔기 때문이 아닙니다.
목표가 아예 다릅니다.
기존 LLM은:
생각하고
말하고
생성한다.
Jev는:
판단한다.에 집중합니다.
그래서 Jev를 가장 단순하게 표현하면:
빠르고 저렴한 AI 판단 함수
에 가깝습니다.
모든 문제에 가장 큰 LLM을 호출하는 대신:
확실한 규칙
→ Code

애매하지만 빠른 판단
→ Jev

복잡한 추론
→ LLM

장기 작업
→ Agent
처럼 역할을 나눌 수 있습니다.
그리고 Jev 내부에서도:
하나를 고른다
→ Choice

각 조건을 독립적으로 판단한다
→ Noul

정도를 평가한다
→ Score
로 문제를 더 작게 나눌 수 있습니다.
이 작은 판단들을 Code에서 조합하는 것이 단순히 하나의 Label을 얻는 것보다 Jev의 성격을 더 잘 보여줍니다.
Jev가 Production 환경에서도 현재 공개된 속도와 Calibration을 유지할 수 있을지는 더 지켜봐야 합니다.
하지만 방향 자체는 꽤 흥미롭습니다.
AI를 더 크게 만드는 경쟁과 별개로,
AI를 더 작은 Software Primitive로 만드는 경쟁도 시작되고 있습니다.
참고자료
-
TypeSafe AI — Introducing System One Models and Jev
Jev의 Architecture, RLCD, Parallel Sampling, Typed Decision, Confidence, 가격과 Workflow Evaluation을 설명한 공식 발표입니다.
Jev 공식 발표 보기 -
TypeSafe AI — Workflow Evals
실제 Workflow를 작은 Decision으로 분해하는 방식과Noul,Choice,Score의 차이를 확인할 수 있습니다. Customer Service, Security Incident, Invoice Processing 등의 예제에서 여러 독립 판단을 Code로 다시 조합하는 방식도 볼 수 있습니다.
Workflow Evals 보기 -
TypeSafe AI — API Documentation
실제 API Schema에서NoulQuestion,ChoiceQuestion,ScoreQuestion과 각각의 Answer 구조를 확인할 수 있습니다.
TypeSafe API 문서 보기 -
TypeSafe AI — 공식 사이트
Jev의 현재 가격, System One Model의 특징과 Early Access 상태를 확인할 수 있습니다.
TypeSafe AI 공식 사이트 -
TypeSafe AI — Lies, Damned Lies, and Benchmarks
TypeSafe가 일반 Benchmark Table보다 실제 Workflow Evaluation을 강조하는 이유와 내부 평가의 한계를 설명합니다.
Benchmark 관련 공식 글 보기
TypeSafe 공식 자료 기준으로 보면, Jev는 2026년 9월 14일 Early Access로 공개된 첫 System One Model입니다. 일반 LLM처럼 문자열을 생성하지 않고 미리 정의된 타입의 판단과 확률을 반환하도록 설계됐으며, 회사는 이를 위해 RLCD와 Parallel Sampler라는 별도 Training·Inference 방식을 사용한다고 설명합니다.
현재 공개 가격은 입력 100만 Token당 $0.042이며 Output Token은 별도 과금하지 않습니다. TypeSafe는 현재 서비스 Latency를 약 70~500ms라고 밝히고 있으며, 자체 Workflow Evaluation에서는 최대 193.6배 빠르고 444.6배 저렴한 결과를 공개했습니다. 다만 회사 역시 이 수치가 실제 효과 중 높은 편일 가능성이 있고 Evaluation 설계에 내부 Bias가 존재할 수 있다는 점을 명시하고 있습니다.
또 하나 주의할 부분은 TypeSafe가 사용하는 Zero Hallucinations 표현입니다. Jev의 Output Schema가 미리 정해져 있기 때문에 Schema 밖의 값이나 Type Error를 생성하지 않는다는 의미에서는 강한 구조적 보장이 가능합니다. 하지만 Model이 잘못된 선택지를 높은 확률로 고르는 Decision Error 자체가 불가능하다는 의미로 받아들이면 안 됩니다. 실제 Production 적용에서는 Calibration과 Confidence Threshold를 반드시 함께 평가하는 것이 중요합니다.

제가 볼 때 이게 진정한 CS에서 핵심 키가 될 것 같습니다.