Claude Sonnet 5.5가 나왔다 — 달라진 성능과 역할
Claude Sonnet 5.5가 나왔다 — 달라진 성능과 역할
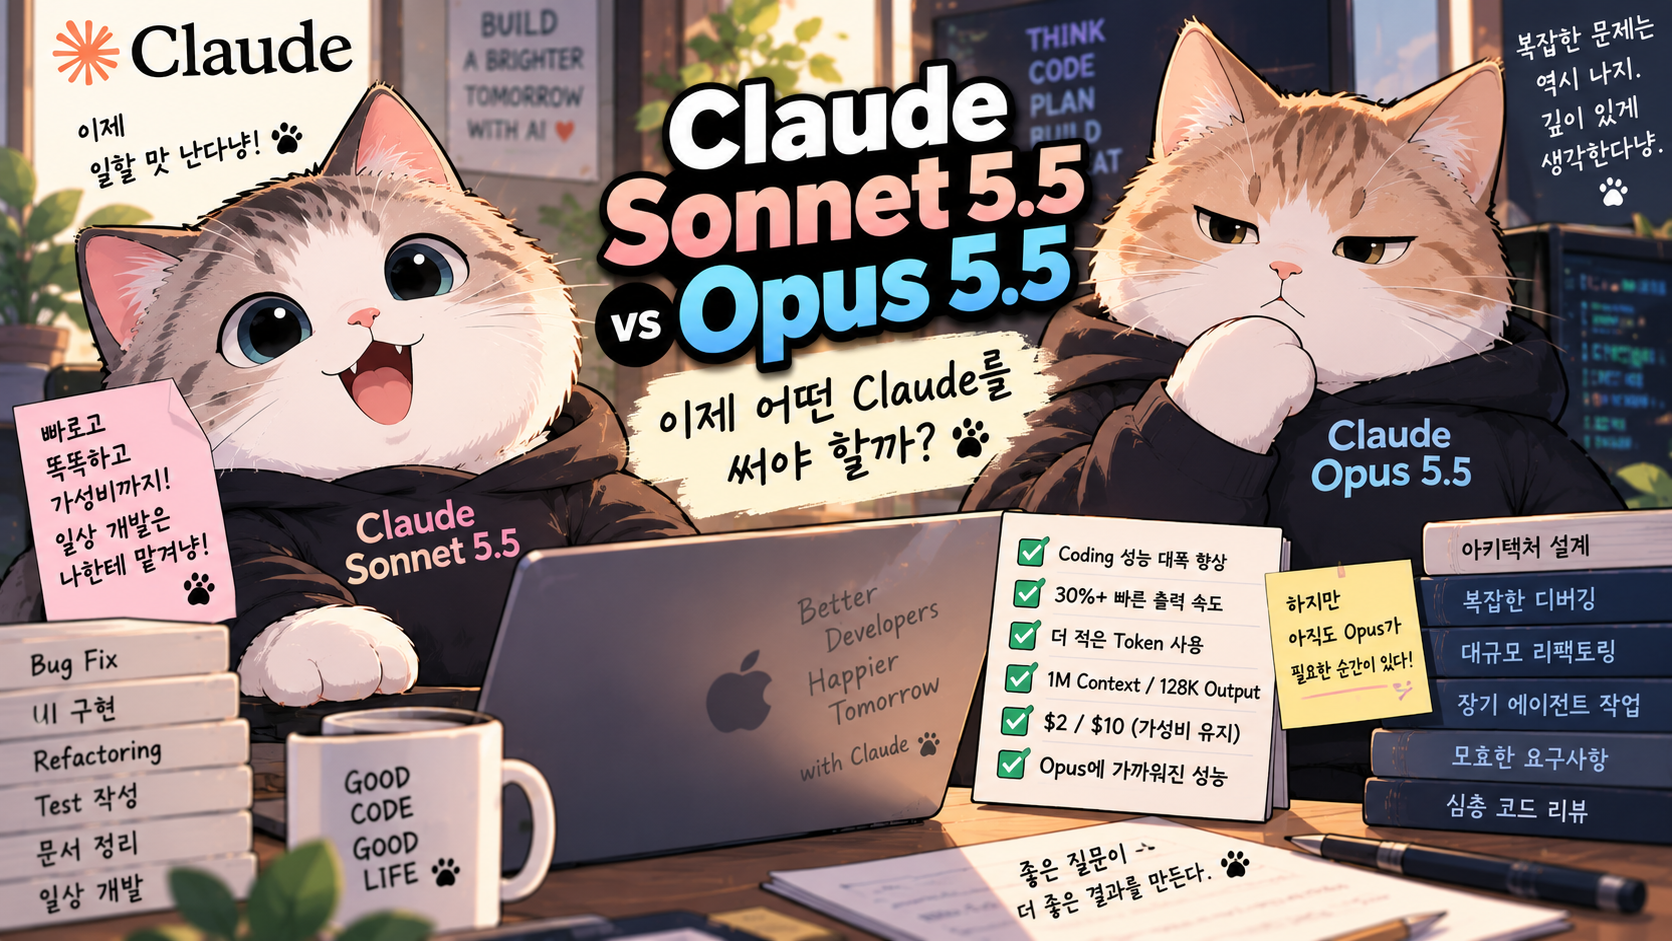
속도·비용·Coding·Effort까지, 모델의 역할이 더 선명해졌다
2026년 9월 28일 Anthropic이 Claude Sonnet 5.5를 공개했습니다.
Opus 5.5가 나온 지 불과 며칠 뒤입니다.
처음 스펙만 보면 이런 생각이 들 수 있습니다.
Opus 5.5
→ 더 좋은 Claude

Sonnet 5.5
→ 조금 빠르고 저렴한 Claude
그런데 이번에는 그렇게 단순하게 나누기 어렵습니다.
Sonnet 5.5의 Coding과 Agent 성능이 크게 올라왔고, 일부 평가에서는 Opus 5.5에 거의 붙었습니다.
그러면서 역할이 오히려 더 명확해졌습니다.
Sonnet 5.5
→ 매일 많이 쓰는 모델

Opus 5.5
→ 어려운 문제를 오래 맡기는 모델
Claude Code를 하루 종일 사용하는 개발자라면 이번 변화가 꽤 중요합니다.
1. Sonnet 5.5는 단순한 마이너 업데이트가 아니다
Anthropic은 Sonnet 5.5를 Claude 5.5 제품군의 두 번째 모델로 소개했습니다.
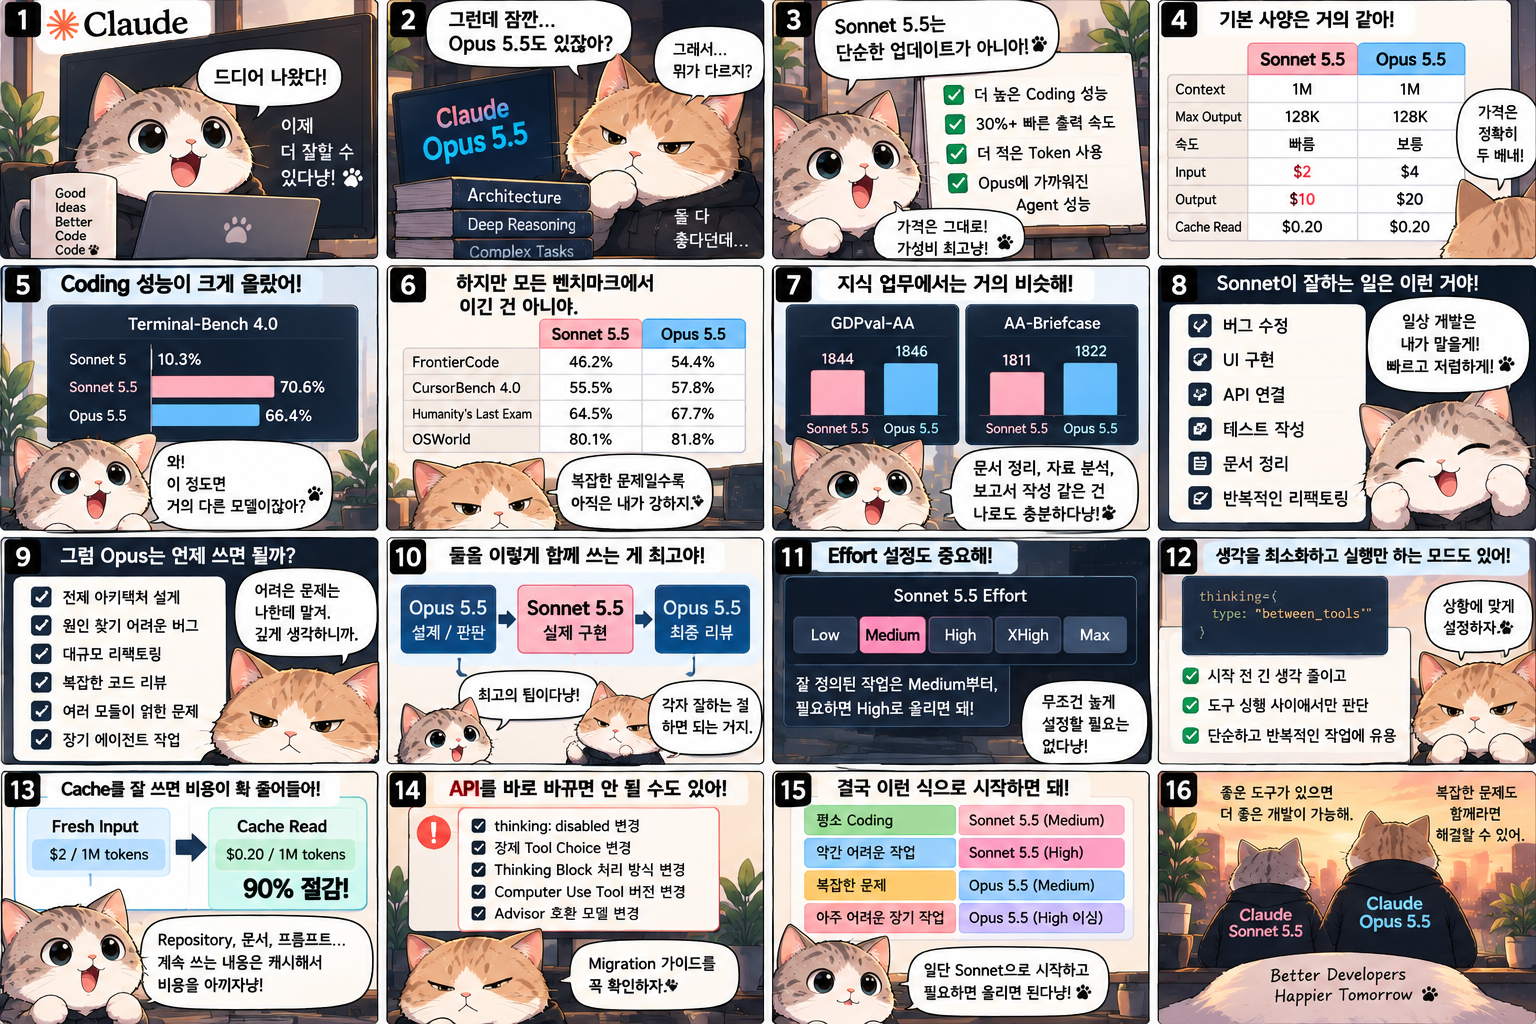
Sonnet 5와 비교하면 핵심 변화는 크게 네 가지입니다.
더 높은 Coding 성능

30% 이상 빠른 출력

더 적은 Token 사용

Opus에 가까워진 Agent 성능
가격 자체는 Sonnet 5와 같습니다.
Input
$2 / 1M tokens

Output
$10 / 1M tokens

Cache Read
$0.20 / 1M tokens
그런데 Anthropic 내부 테스트에서는 같은 작업을 처리하는 데 필요한 Token과 단계가 줄면서 작업 하나당 실제 비용은 최대 30% 낮아졌다고 설명합니다.
즉:
Token 단가가 싸졌다가 아니라,
같은 일을
더 적은 Token과 Tool Call로 끝낸다
에 가깝습니다.
2. 일단 Sonnet 5.5와 Opus 5.5를 비교해보자
기본 사양은 생각보다 많이 같습니다.
| Sonnet 5.5 | Opus 5.5 | |
|---|---|---|
| Context | 1M | 1M |
| Max Output | 128K | 128K |
| Batch Max Output | 300K Beta | 300K Beta |
| Input | $2 | $4 |
| Output | $10 | $20 |
| Cache Read | $0.20 | $0.20 |
| 5분 Cache Write | $2.50 | $5 |
| 1시간 Cache Write | $4 | $8 |
| 속도 | Fast | Moderate |
| Adaptive Thinking | 지원 | 항상 활성화 |
| API 기본 Effort | High | Medium |
Context와 최대 출력 크기는 같습니다.
가장 큰 차이는 결국:
속도

가격

판단의 깊이
입니다.
3. 가격은 정확히 두 배 차이다
Fresh Token 기준으로는 정말 깔끔합니다.
Sonnet 5.5
Input   $2
Output $10
Opus 5.5
Input   $4
Output $20
정확히 두 배입니다.
예를 들어 같은 작업에서:
Input  500K
Output 100K
를 사용했다면 단순 Token 비용은:
Sonnet

$1 + $1
= 약 $2
Opus
$2 + $2
= 약 $4정도가 됩니다.
장시간 Coding Agent를 여러 개 병렬로 돌리기 시작하면 이 차이가 상당히 커집니다.
4. 그런데 Cache Read 가격은 둘이 같다
여기가 재미있습니다.
Sonnet 5.5
Cache Read $0.20

Opus 5.5
Cache Read $0.20
입니다.
Fresh Input은:
Sonnet $2
Opus   $4
인데 Cache Hit이 나면 둘 다:
$0.20입니다.
그래서 긴 Agent Session에서는 단순히:
Opus는 항상 Sonnet보다 두 배 비싸다.
라고 계산하면 안 됩니다.
예를 들어 반복해서 읽는:
System Prompt

CLAUDE.md

Tool Schema

Repository Context

Architecture 문서
가 Cache Hit을 계속 낸다면 두 모델의 Input 비용 차이는 상당히 줄어듭니다.
물론 Output과 새로운 Input, Cache Write는 여전히 Opus가 비쌉니다.
5. 이번 Sonnet에서 가장 크게 달라진 건 Coding이다
대표적인 결과가 Terminal-Bench 4.0입니다.
Sonnet 5       10.3%

Sonnet 5.5     70.6%

Opus 5.5       66.4%
숫자만 보면 굉장히 큰 변화입니다.
Terminal-Bench는 단순 Coding 문제보다:
Terminal 사용

여러 단계 명령 실행

파일 수정

환경 확인

문제 해결
같은 Agent 작업을 평가합니다.
즉 Sonnet 5.5가 단순히 코드 자동완성을 잘하게 된 게 아닙니다.
Agent로 움직이는 능력이 크게 올라온 것입니다.
6. 그렇다고 Sonnet이 Opus를 이겼다고 보면 안 된다
Benchmark 하나만 보면 Sonnet 5.5가 Opus 5.5보다 높은 결과도 있습니다.
하지만 다른 평가를 보면 다시 달라집니다.
FrontierCode
Sonnet 5.5    46.2%
Opus 5.5      54.4%
CursorBench 4.0
Sonnet 5.5    55.5%
Opus 5.5      57.8%
Humanity's Last Exam
Sonnet 5.5    64.5%
Opus 5.5      67.7%
OSWorld
Sonnet 5.5    80.1%
Opus 5.5      81.8%
즉 실제 결과는:
어떤 작업에서는 Sonnet 우세

어떤 작업에서는 Opus 우세

복잡도가 높아질수록 Opus의 장점이 커짐
에 가깝습니다.
Anthropic도 복잡하고 열린 문제가 길게 이어지면서 지속적인 판단이 필요한 작업에서는 Opus 5.5가 여전히 더 강하다고 명확하게 구분합니다.
7. 지식 업무에서는 거의 붙어버린 영역도 있다
GDPval-AA 결과를 보면 재미있습니다.
Sonnet 5.5    1844

Opus 5.5      1846
거의 같습니다.
AA-Briefcase에서도:
Sonnet 5.5    1811

Opus 5.5      1822
차이가 크지 않습니다.
그래서:
문서 정리

자료 분석

보고서 작성

스프레드시트

일반적인 Research

업무용 Presentation
같은 잘 정의된 작업이라면 Sonnet 5.5를 먼저 사용하는 게 상당히 자연스러워졌습니다.
8. Sonnet 5.5가 특히 잘 맞는 건 ‘범위가 명확한 일’이다
Anthropic도 Sonnet 5.5의 강점을 이렇게 잡고 있습니다.
Well-scoped everyday tasks

Bug Fixing

Document

Slides

Spreadsheet

Design
즉:
이 프로젝트를 처음부터 어떻게 설계할까?
보다:
이 ViewModel의 Race Condition을 찾아서 고쳐줘.
같은 작업입니다.
예를 들면 개발에서는:
특정 Bug 수정

API 하나 추가

View 구현

Unit Test 작성

Compiler Error 수정

Swift 6 Warning 정리

반복적인 Refactoring

PR Review

문서 작성
같은 업무입니다.
9. UI 작업도 이번 Sonnet에서 꽤 강조됐다
Anthropic은 Sonnet 5.5에서 Design 감각도 별도로 강조하고 있습니다.
단순히 화면이 동작하게 만드는 것보다:
Spacing

Layout

Typography

Visual hierarchy

기존 Design Style 유지
같은 부분을 더 잘 처리하도록 개선됐다는 설명입니다.
실제 Claude Code를 쓰다 보면 이 차이는 꽤 중요합니다.
예전 Coding Agent는:
기능은 맞는데
화면이 묘하게 못생김
인 경우가 많았습니다.
Sonnet 5.5는 일반적인 Front-end나 UI 구현에서 이런 후처리 비용을 줄이는 쪽도 목표로 하고 있습니다.
10. iOS 개발에서도 Sonnet 5.5가 잘 맞는 일이 많다
예를 들어 이런 작업입니다.
SwiftUI 화면 구현

UIKit → SwiftUI 부분 전환

ViewModel 생성

API 연결

DTO → Domain 변환

Unit Test 작성

Swift 6 Concurrency Warning 수정

Localization 추가

Accessibility 보완
이런 업무는 보통 목표와 범위가 명확합니다.
Sonnet 5.5가 잘 맞는 영역입니다.
반대로:
Navigation 전체 Architecture 변경

Camera Pipeline 재설계

Concurrency 구조 재설계

대규모 Module Dependency 정리

수십 개 Feature가 얽힌 Regression 분석
같은 문제라면 Opus 5.5를 먼저 생각해볼 만합니다.
11. Sonnet 5.5가 빨라진 것도 꽤 중요하다
Anthropic 발표 기준으로 Sonnet 5.5는 Sonnet 5보다 Output 생성 속도가 30% 이상 빨라졌습니다.
Agent에서 이 차이는 단순히 답변이 빨리 나오는 것보다 더 큽니다.
Coding Agent는:
생각

Tool Call

결과

생각

Tool Call

결과
를 여러 번 반복합니다.
각 단계가 조금씩 빨라지면 전체 작업 시간은 크게 줄어듭니다.
실제 외부 테스트에서도:
Tool Call 감소

Shell 실행 감소

불필요한 검색 감소

작업 단계 감소
가 보고됐습니다.
12. ‘더 빠르다’는 게 생각을 덜 한다는 뜻은 아니다
여기서 Effort가 중요합니다.
Sonnet 5.5는:
Low

Medium

High

XHigh

Max
다섯 단계의 Effort를 지원합니다.
Effort를 올리면 일반적으로:
더 오래 생각

더 많은 Token 사용

더 많은 확인

비용 증가

Latency 증가
가 발생합니다.
무조건 높다고 좋은 게 아닙니다.
13. API의 기본값은 High다
Claude API에서 Sonnet 5.5의 기본 Effort는:
High입니다.
반면 Claude 앱과 Claude Code에서는 Anthropic 발표 기준 기본값을:
Medium으로 사용합니다.
이 차이를 알고 있어야 합니다.
같은 Sonnet 5.5라도:
API

Claude Code

Claude 앱
에서 체감 속도와 사용량이 다르게 느껴질 수 있기 때문입니다.
14. 개발에서는 Medium부터 시작해도 되는 작업이 많다
Anthropic의 권장 방식도 꽤 현실적입니다.
잘 정의된 Agent Coding
Medium부터 시작어렵거나 긴 작업
High일반 Chat이나 Latency가 중요한 작업
Low / Medium정도입니다.
그래서 개발자 입장에서는:
Sonnet 5.5 Medium을 기본값처럼 사용하고,
문제가 잘 안 풀리거나 범위가 커졌을 때:
High
→ XHigh
→ Max
로 올리는 방식이 합리적입니다.
15. Max가 항상 더 좋은 것도 아니다
재미있는 사례가 있습니다.
FrontierCode에서 Sonnet 5.5는 Max Effort가 XHigh보다 오히려 낮은 결과를 기록했습니다.
이유가 있습니다.
Max에서는 모델이 더 적극적으로 Review를 하고 여러 Subagent까지 사용하면서 요청 범위를 넘어서는 수정을 하거나 Timeout이 발생한 사례가 있었습니다.
즉:
더 오래 생각
=
항상 더 좋은 결과
가 아닙니다.
특히 범위가 명확한 Coding 작업에서는 필요 이상으로 생각하면 오히려 일을 키울 수도 있습니다.
16. 그래서 Sonnet의 장점은 낮은 Effort에서도 잘 나온다는 것이다
이번 발표에서 중요한 부분입니다.
여러 Benchmark에서 Sonnet 5.5는:
Low
또는
Medium
만 사용해도 이전 Sonnet 5의 최고 결과를 넘어섰습니다.
일부 작업에서는 작업당 비용이 Sonnet 5의 10분의 1 수준까지 내려갔습니다.
왜냐하면 단순 Token 가격뿐 아니라:
적은 Tool Call

적은 Retry

짧은 Thinking

적은 Output Token

빠른 실행
이 같이 작동하기 때문입니다.
17. Adaptive Thinking은 이제 기본이다
Sonnet 5.5는 기본적으로 Adaptive Thinking을 사용합니다.
예전처럼:
thinking budget = 10000처럼 고정 Token 수를 정하는 방식보다,
output_config.effort로 얼마나 깊게 생각할지 지정하는 방식입니다.
예를 들면:
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[
        {
            "role": "user",
            "content": "Review this architecture"
        }
    ],
    output_config={
        "effort": "medium"
    }
)
처럼 사용할 수 있습니다.
18. 아예 앞에서 생각하지 않게 할 수도 있다
Sonnet 5.5에는 between_tools가 있습니다.
thinking={
    "type": "between_tools"
}
를 사용하면 작업 시작 전에 길게 생각하는 부분을 줄이고 Tool Call 사이에서 필요한 판단만 수행하게 할 수 있습니다.
예를 들어:
파일 읽기

간단한 문자열 변경

Test 실행

결과 확인
처럼 생각보다 실행이 중요한 작업에서는 유용할 수 있습니다.
다만 between_tools에서는 일부 Effort 사용 방식에 제한이 있으므로 기존 Sonnet 5의:
thinking: disabled와 완전히 같은 설정이라고 생각하면 안 됩니다.
19. Sonnet 5에서 바로 모델 이름만 바꾸면 안 될 수도 있다
API 사용자는 이 부분을 꼭 확인해야 합니다.
Sonnet 5.5에는 몇 가지 Breaking Change가 있습니다.
대표적으로:
thinking: disabled 변경

강제 Tool Choice 변경

Thinking Block 처리 방식 변경

Computer Use Tool 버전 변경

Advisor 호환 모델 변경
이 있습니다.
Sonnet 5에서:
thinking={"type": "disabled"}를 사용했다면 Sonnet 5.5에서는 그대로 보내면 오류가 날 수 있습니다.
대신 조건에 맞게:
thinking={"type": "between_tools"}를 사용해야 합니다.
20. Agent UI를 만들었다면 Thinking Block도 확인해야 한다
Sonnet 5.5에서는 Tool Call 사이에 모델이 작성하는 설명이 thinking block으로 들어가는 경우가 있습니다.
기본 설정에서는 해당 내용이 보이지 않을 수 있습니다.
그래서 기존 UI가:
Claude가 지금 어떤 작업을 하고 있는지
실시간 표시
하는 구조라면 업데이트 후 갑자기:
Tool 실행

...

Tool 실행
처럼 중간 과정이 비어 보일 수 있습니다.
이 경우 thinking.display 설정을 다시 확인해야 합니다.
API를 직접 사용하는 서비스라면 꽤 중요한 Migration 포인트입니다.
21. Prompt Cache 최소 크기도 줄었다
Sonnet 5.5에서는 Cache 가능한 최소 Prompt 크기가:
1024 tokens

↓

512 tokens
으로 줄었습니다.
큰 Repository를 다루는 Agent뿐 아니라 비교적 작은 System Prompt나 업무 Context도 Cache 적용 대상으로 만들기 쉬워졌습니다.
가격은:
Cache Read
$0.20 / MTok
입니다.
Fresh Input이:
$2이므로 Cache Hit이면 Input 비용이 90% 줄어듭니다.
22. Opus 5.5도 Cache Read는 똑같이 $0.20이다
다시 이 부분이 재미있습니다.
Sonnet Fresh Input
$2

Opus Fresh Input
$4
인데,
둘 다 Cache Read는:
$0.20입니다.
그래서 Agent가 오래 실행될수록:
어떤 모델인가못지않게:
Context를 얼마나 재사용하는가가 중요합니다.
짧은 작업에서는 Sonnet의 가격 차이가 크게 보이지만, 긴 Agent Session에서는 Cache 설계에 따라 차이가 달라질 수 있습니다.
23. 그러면 일상 Coding은 Sonnet으로 충분할까
상당히 많은 작업에서는 그렇다고 볼 수 있습니다.
예를 들어:
버그 하나 고치기

View 하나 추가

API 붙이기

Test 추가

작은 Refactoring

PR Review

문서 정리

UI 수정
이라면 Sonnet 5.5부터 시작하는 게 자연스럽습니다.
특히 속도가 빠르기 때문에:
수정
↓
확인
↓
다시 수정
↓
확인
하는 짧은 반복 작업에 잘 맞습니다.
24. Opus 5.5는 언제 쓰는 게 좋을까
Opus의 역할도 오히려 더 명확해졌습니다.
예를 들어:
Architecture 전체 설계

원인을 찾기 어려운 Bug

여러 Module이 얽힌 문제

대규모 Refactoring

긴 Research

복잡한 Code Review

모호한 요구사항

오랜 시간 판단이 필요한 Agent 작업
입니다.
이런 작업의 특징은:
정답이 명확하게 주어져 있지 않다는 것입니다.
Sonnet은 범위가 명확한 문제를 빠르게 처리하는 데 강하고,
Opus는:
무엇이 문제인지부터 알아내야 하는 작업에 더 잘 맞습니다.
25. 실전에서는 둘을 같이 쓰는 게 오히려 자연스럽다
예를 들어 큰 Feature를 만든다고 해보겠습니다.
처음 Architecture를 정하는 건 Opus에게 맡깁니다.
Opus 5.5

요구사항 분석
↓
Architecture
↓
Module 구성
↓
Interface 결정
그리고 구현을 Sonnet으로 넘깁니다.
Sonnet 5.5

View 구현
↓
Repository 구현
↓
Test 작성
↓
Build 오류 수정
마지막에 다시 Opus로 Review할 수 있습니다.
Opus 5.5

전체 Diff 확인
↓
Architecture 위반 확인
↓
누락된 Case 확인
전체 구조는:
            Opus 5.5
           설계 / 판단
                ↓
          Sonnet 5.5
           실제 구현
                ↓
          Sonnet 5.5
        반복 수정 / Test
                ↓
            Opus 5.5
           최종 Review
입니다.
26. 이 방식은 비용 차이도 꽤 크다
모든 작업을 Opus에 맡기면 당연히 편합니다.
하지만 실제 프로젝트에서는 상당수 시간이:
파일 읽기

단순 수정

Test 실행

Compiler Error 처리

반복 작업
에 들어갑니다.
굳이 이런 작업까지 Opus가 계속 처리할 필요는 없습니다.
그래서:
판단이 중요한 부분
→ Opus

실행량이 많은 부분
→ Sonnet
으로 나누면 비용과 속도를 같이 잡을 수 있습니다.
27. Claude Code에서는 이런 식으로 생각하면 쉽다
Sonnet 5.5
오늘 일할 개발자Opus 5.5
어려운 문제 생겼을 때 부르는 시니어정도로 생각하면 이해하기 쉽습니다.
평소에는 Sonnet으로:
구현

수정

Test

Review
를 빠르게 반복합니다.
그리고:
이거 왜 계속 깨지지?
싶은 순간 Opus로 올리는 겁니다.
28. Sonnet 5.5가 Opus를 없애는 모델은 아니다
이번 발표를 보고:
이 정도면 Opus 필요 없는 것 아닌가?
라는 생각이 들 수 있습니다.
실제로 일부 Benchmark에서는 꽤 가까워졌습니다.
하지만 Anthropic도 두 모델을 명확하게 다르게 설명합니다.
Sonnet 5.5
→ 빠르고 저렴한 일상 업무

Opus 5.5
→ 복잡하고 오래 지속되는 판단
입니다.
그래서 이번 Sonnet의 의미는:
Opus를 없앴다가 아니라,
Opus를 써야 했던 작업의 범위를 줄였다에 더 가깝습니다.
29. 이전에는 애매하면 Opus였다
복잡도가 조금만 높아져도:
Sonnet으로 될까?

↓

그냥 Opus 쓰자.
가 되기 쉬웠습니다.
하지만 Sonnet 5.5에서는:
일단 Sonnet Medium
        ↓
안 되면 High
        ↓
그래도 어려우면 Opus
라는 선택지가 현실적으로 생겼습니다.
비용을 신경 쓰는 팀이라면 꽤 큰 차이입니다.
30. 개발자라면 이렇게 시작해볼 만하다
평소 Coding
Sonnet 5.5
Medium
약간 어려운 Coding
Sonnet 5.5
High
빠르게 반복해야 하는 UI / Bug Fix
Sonnet 5.5
Low 또는 Medium
Architecture / 어려운 Debug
Opus 5.5
Medium
정말 복잡한 장기 작업
Opus 5.5
High 이상
그리고 무조건 높은 Effort를 쓰기보다 실제 작업 결과를 보고 올리는 편이 낫습니다.
마치며
Sonnet 5.5에서 가장 눈에 띄는 변화는 처음에는 70.6% 같은 Coding Benchmark일 수 있습니다.
하지만 실제 개발자에게 더 중요한 변화는 다른 데 있습니다.
30%+ 빠른 출력

더 적은 Tool Call

더 적은 Token

1M Context

128K Output

$2 / $10 가격

$0.20 Cache Read

Opus에 가까워진 Coding / Agent 성능
이게 한꺼번에 들어왔습니다.
그래서 Claude 제품군의 역할도 더 명확해졌습니다.
Fable 5.1
→ 가장 어려운 Frontier 작업

Opus 5.5
→ 복잡한 Coding과 장시간 Agent

Sonnet 5.5
→ 매일 사용하는 Coding과 업무

Haiku
→ 빠르고 대량인 작업
특히 개발자에게 중요한 변화는 Sonnet으로 처리할 수 있는 작업의 범위가 크게 넓어졌다는 것입니다.
예전에는 조금 복잡해지면 Opus를 먼저 생각했다면 이제는:
Sonnet으로 시작한다.

필요하면 Effort를 올린다.

그래도 어렵다면 Opus로 간다.
가 훨씬 자연스러운 사용법이 됐습니다.
Opus 5.5가 여전히 더 복잡한 문제에서 강합니다.
하지만 Sonnet 5.5는 그 아래에서 단순한 보급형 모델이 아닙니다.
하루 종일 Claude Code를 돌리는 개발자가 가장 많이 쓰게 될 모델에 가까워졌습니다.
그리고 이번 5.5 제품군에서 가장 재미있는 변화도 결국 이것입니다.
가장 좋은 모델 하나를 계속 사용하는 것보다,
작업의 난이도에 따라 Sonnet과 Opus를 바꿔 쓰는 편이 더 중요해지고 있습니다.
참고자료
Anthropic — Introducing Claude Sonnet 5.5
Sonnet 5.5의 공식 발표입니다. Sonnet 5 대비 성능·속도·비용 변화와 Opus 5.5와의 비교, Coding 및 Knowledge Work 평가 결과를 확인할 수 있습니다.
https://www.anthropic.com/claude-sonnet-5-5
Anthropic — Claude Sonnet 5.5 Model Overview
1M Context, 128K Output, 가격, Cache 비용, Adaptive Thinking과 기본 Effort 등 Sonnet 5.5의 공식 사양을 확인할 수 있습니다.
https://platform.claude.com/docs/en/models/sonnet-5-5/overview
Anthropic — What's new in Claude Sonnet 5.5
Sonnet 5.5의 Thinking, Tool Use, 응답 구조, 새로운 API 동작과 Sonnet 5에서 달라진 부분을 정리한 공식 문서입니다.
https://platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
Anthropic — Migrating to Claude Sonnet 5.5
thinking: disabled 변경, between_tools, Effort 재설정, Prompt Cache 최소 길이와 기존 Sonnet 애플리케이션을 5.5로 옮길 때 확인해야 할 Breaking Change를 설명합니다.
https://platform.claude.com/docs/en/models/sonnet-5-5/migration-guide
Anthropic — Claude Opus 5.5 Model Overview
Sonnet 5.5와 비교할 때 필요한 Opus 5.5의 가격, Context, Output, Cache, Adaptive Thinking과 기본 Effort를 확인할 수 있습니다.
https://platform.claude.com/docs/en/models/opus-5-5/overview