GPT-6.1 Sol이 일주일 만에 나왔다 — 6.0은 왜 이렇게 빨리 교체됐을까
GPT-6.1 Sol이 일주일 만에 나왔다 — 6.0은 왜 이렇게 빨리 교체됐을까
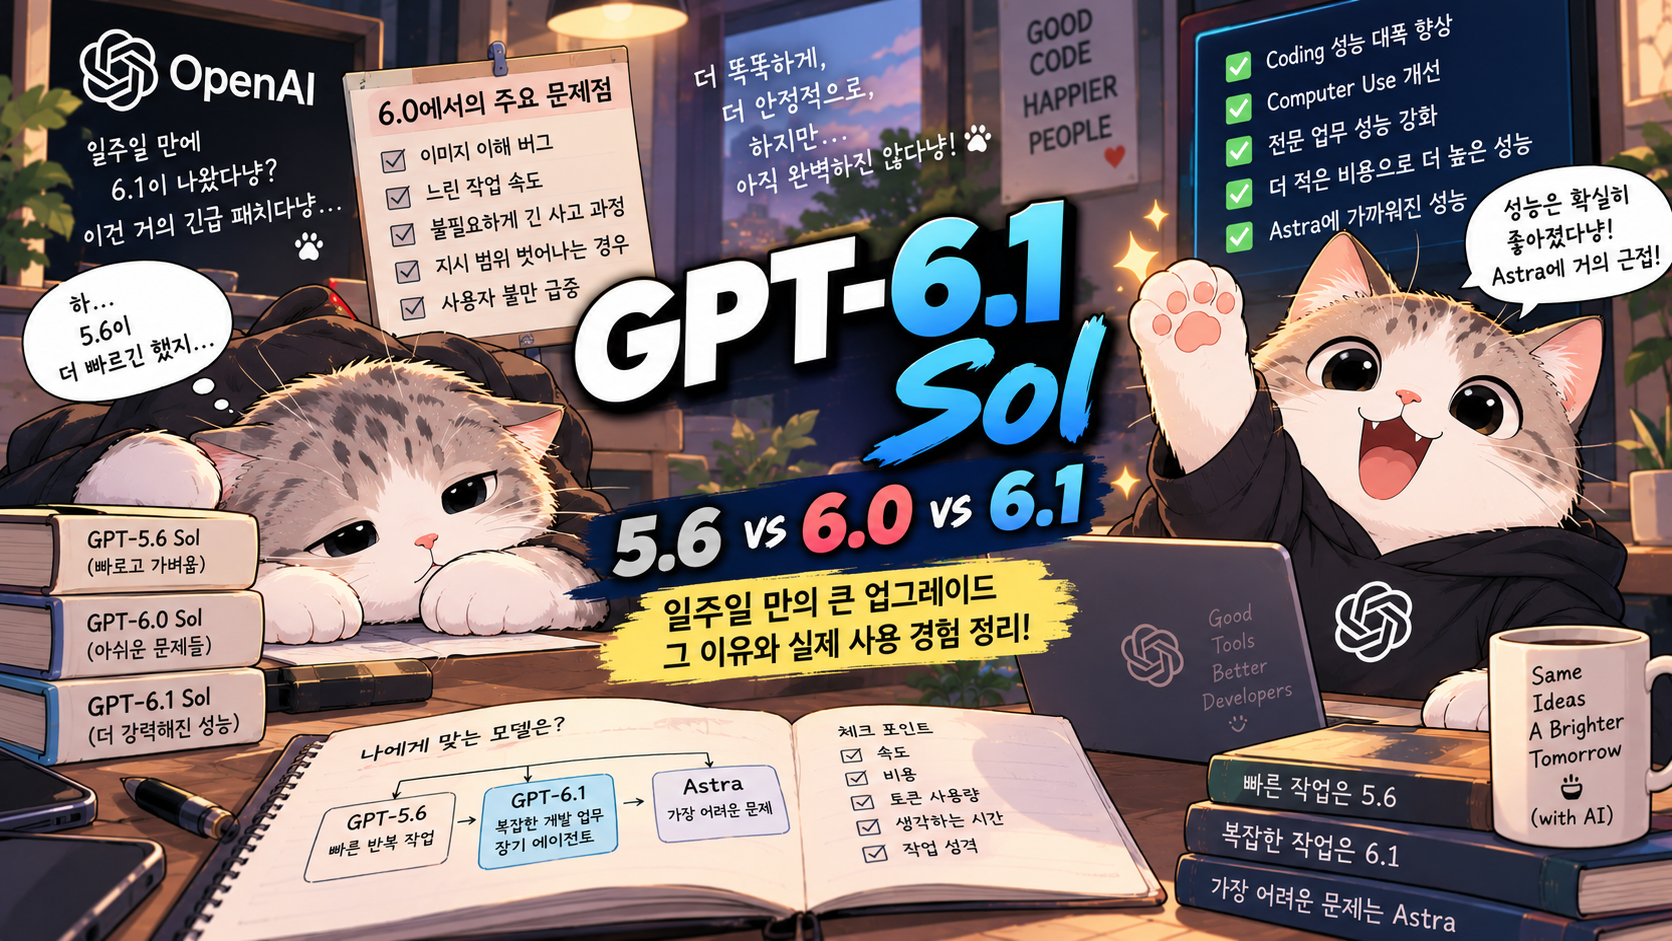
성능은 Astra에 가까워졌지만, 5.6보다 느리다는 말이 나오는 이유
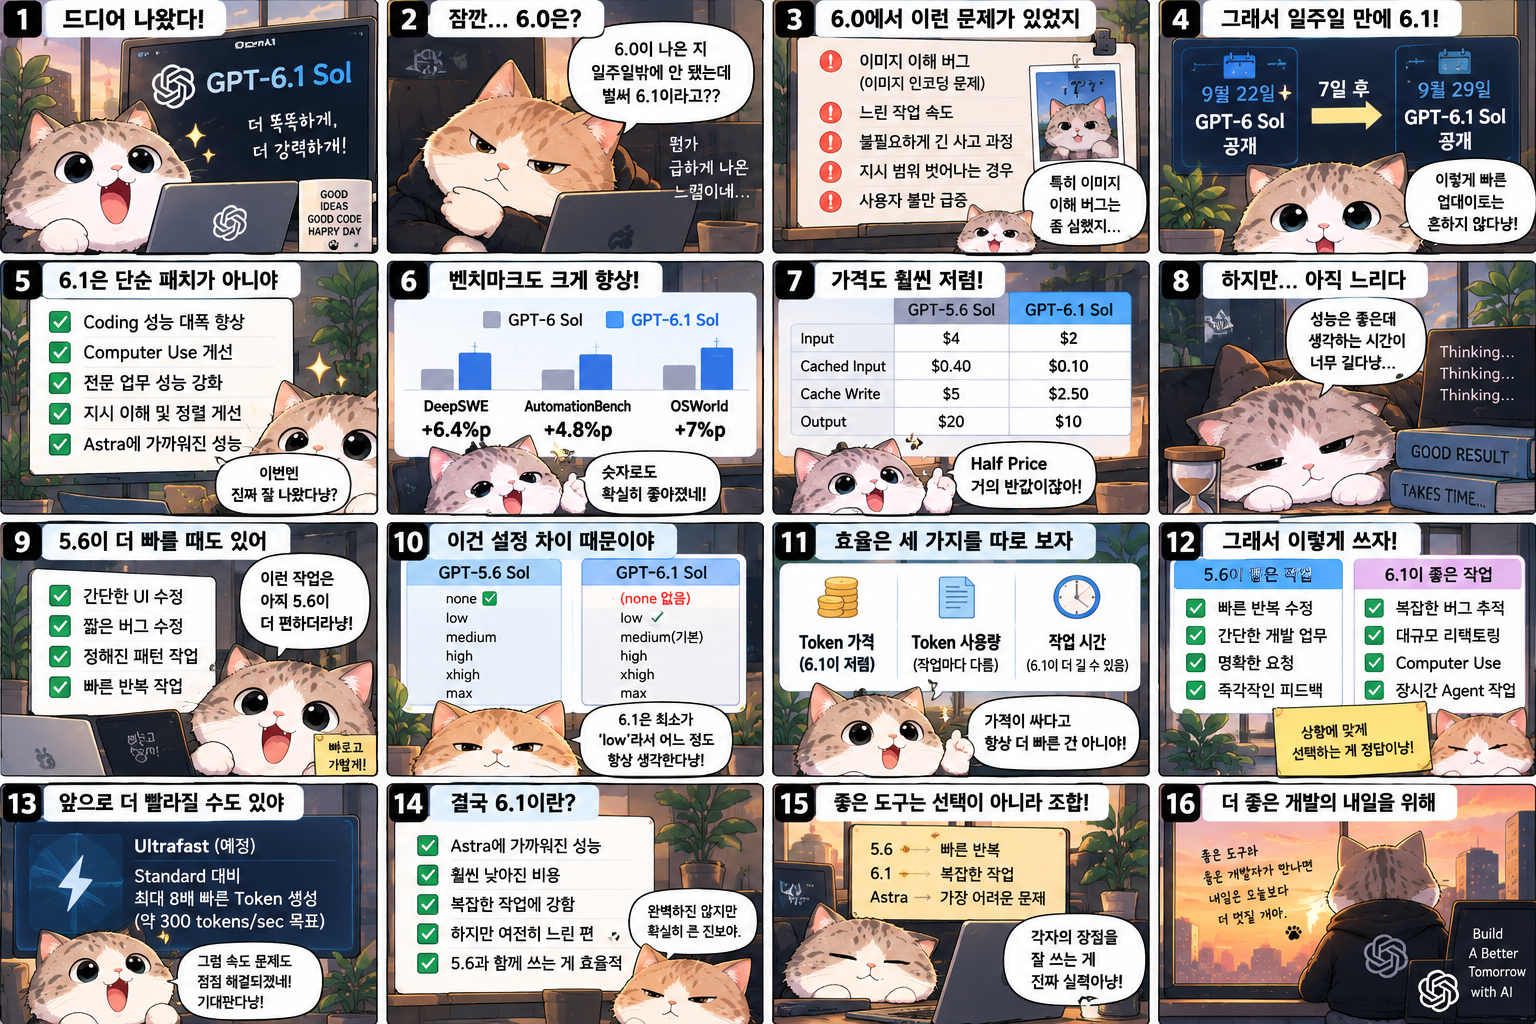
2026년 9월 22일 OpenAI가 GPT-6 Sol을 공개했습니다.
그리고 불과 7일 뒤인 9월 29일 GPT-6.1 Sol이 나왔습니다.
보통 모델 세대에서 6.0 → 6.1이 일주일 만에 넘어가는 경우는 흔하지 않습니다.
더구나 OpenAI도 6.1을 단순한 작은 수정이 아니라 GPT-6 Sol의 큰 업그레이드라고 표현했습니다. Coding, Computer Use, 전문 업무 전반에서 성능이 크게 올라갔고, 여러 평가에서는 Astra에 상당히 가까워졌습니다.
그런데 실제 Codex 사용자 반응을 보면 조금 복잡합니다.
성능은 확실히 좋아졌다.

6.0보다 훨씬 낫다.

그런데...

느리다.

생각하는 시간이 길다.

5.6 Sol이 오히려 편한 작업도 있다.
라는 평가가 동시에 나오고 있습니다.
그래서 이번 6.1은 단순히:
GPT-6 Sol보다 좋은 모델이 나왔다.
로 끝낼 모델은 아닙니다.
성능, Token 비용, 실제 Token 사용량, 그리고 작업 시간은 서로 따로 봐야 합니다.
1. GPT-6 Sol은 나온 지 일주일 만에 6.1이 됐다
날짜를 놓고 보면 상당히 빠릅니다.
2026.09.22

GPT-6 Sol
GPT-6 Luna
        ↓
       7일
        ↓
2026.09.29

GPT-6.1 Sol
GPT-6 Sol 자체도 작은 모델은 아니었습니다.
OpenAI는 당시 GPT-6 Astra에서 사용한 Training과 Alignment 개선을 보다 빠르고 저렴한 모델로 가져온 것이 Sol이라고 설명했습니다.
가격도 GPT-5.6 Sol 대비 절반 수준으로 낮췄습니다.
그런데 일주일 만에 다시:
GPT-6 Sol

↓

GPT-6.1 Sol
이 등장했습니다.
2. 6.1이 빨리 나온 정확한 이유를 OpenAI가 밝힌 것은 아니다
여기서는 구분할 필요가 있습니다.
OpenAI가:
GPT-6 Sol에 문제가 많아서 일주일 만에 6.1을 만들었다.
라고 발표한 적은 없습니다.
따라서 이걸 사실처럼 말하면 안 됩니다.
공식적으로 확인되는 건:
6.1은 GPT-6 Sol의 큰 업그레이드

Coding 크게 개선

Computer Use 개선

전문 업무 개선

Instruction / Alignment 개선

비용 효율 개선
정도입니다.
하지만 출시 직후 상황을 보면 6.0에 손볼 곳이 적지 않았다는 사실도 보입니다.
GPT-6 Sol에서는 실제 문제가 있었다
3. 출시 사흘 뒤 Image Understanding 버그가 수정됐다
GPT-6 Sol 출시일은 9월 22일입니다.
그런데 9월 25일 OpenAI Release Note에 이런 수정이 올라왔습니다.
GPT-6 Sol과 Luna의 Image Encoding 문제 때문에 이미지 이해 성능이 떨어지는 버그가 있었고 이를 수정했다는 내용입니다.
Codex와 Computer Use의 Visual Task에도 영향을 줬습니다.
즉 적어도 이 부분은 사용자 추측이 아니라 공식 확인된 문제입니다.
GPT-6 Sol 출시
     ↓
Image Encoding 문제
     ↓
Visual Understanding 저하
     ↓
3일 뒤 수정
Computer Use를 중요하게 내세운 GPT-6 모델에서 꽤 민감한 문제였습니다.
4. Coding 쪽에서는 다른 불만도 빠르게 나오기 시작했다
이쪽은 공식적으로 확인된 버그와는 다릅니다.
OpenAI Developer Community와 Codex 사용자 커뮤니티에서는 출시 직후 다음과 같은 경험담이 올라왔습니다.
간단한 작업이 너무 오래 걸린다.

계획만 세우다 시간이 많이 지나간다.

지시 범위를 벗어난다.

명확한 요청을 놓치는 경우가 있다.

5.6 Sol보다 작업이 답답하다.
OpenAI Developer Community에는 평소 몇 분 걸리던 작업이 수십 분에서 한 시간 이상 걸렸다는 사례도 올라왔습니다. 한 사용자는 GPT-6 Sol 작업이 평소보다 10~20배 길어졌다고 보고했습니다.
Reddit에서도 동일한 작업을 GPT-6 Sol과 5.6 Sol에 각각 맡겼을 때 5.6이 훨씬 빨리 진행됐다는 경험담들이 나왔습니다. 다만 이런 자료는 통제된 Benchmark가 아니라 사용자 경험이라는 점은 반드시 감안해야 합니다.
5. 그런데 공식 Benchmark에서 GPT-6 Sol은 5.6보다 좋았다
재미있는 부분입니다.
OpenAI가 발표한 평가에서는 GPT-6 Sol이 GPT-5.6 Sol보다 분명히 좋아졌습니다.
특히 실제 Repository에서:
코드 수정

Test 품질

수정 범위

Coding Style

Repository 규칙 준수
까지 평가하는 FrontierCode에서 개선됐습니다.
게다가 API 가격은:
GPT-5.6 Sol

Input   $4
Output $20

        ↓

GPT-6 Sol

Input   $2
Output $10
으로 절반이 됐습니다.
즉 공식적으로 보면:
성능 ↑

가격 ↓
였습니다.
그런데 실사용에서는:
작업 시간 ↑ ?

생각하는 시간 ↑ ?

체감 집중력 ↓ ?
이라는 불만이 일부 나온 겁니다.
이게 이번 모델을 이해할 때 중요한 부분입니다.
6. 그리고 6.1에서 성능이 다시 크게 뛰었다
GPT-6.1 Sol은 단순히 6.0의 작은 Patch가 아닙니다.
OpenAI의 공식 평가를 보면 차이가 상당합니다.
DeepSWE v1.1에서는 GPT-6 Sol의 최고 점수를 6.4%포인트 넘으면서도 더 낮은 Reasoning Effort와 비용을 사용했습니다.
AutomationBench에서도 같은 Reasoning 설정의 GPT-6 Sol보다:
+4.8%p높았습니다.
Computer Use를 평가하는 OSWorld 2.0에서는 최대 Reasoning 설정 기준:
GPT-6 Sol 대비

+7%p
올라갔습니다.
Terminal-Bench Science에서는 6.0의 점수를 2배 이상으로 끌어올리면서 작업당 비용은 절반 이하였습니다.
일주일 차이 모델치고 변화 폭이 꽤 큽니다.
7. 그래서 이름도 단순 GPT-6 Sol Refresh가 아니라 6.1이다
결과적으로:
GPT-6 Sol
→ 저렴한 GPT-6

GPT-6.1 Sol
→ Astra에 가까운 실전 고성능 모델
로 성격이 조금 달라졌습니다.
OpenAI도 6.1을:
Near-Astra performance
라고 표현합니다.
1.05M Context와 128K 최대 Output은 그대로지만 모델의 실제 문제 해결 능력이 Astra 쪽으로 이동했습니다.
8. 특히 Coding에서 Astra와 상당히 가까워졌다
OpenAI가 6.1에서 가장 강조하는 영역도 Agentic Coding입니다.
DeepSWE에서는 GPT-6.1 Sol이 약 5분의 1 비용으로 Astra와 비슷한 수준까지 올라왔습니다.
구조적으로 보면:
GPT-6 Astra

가장 높은 성능
가장 어려운 문제
        ↓
GPT-6.1 Sol

Astra에 가까운 성능
훨씬 낮은 비용
        ↓
GPT-6 Luna

대량 작업
낮은 비용
이 훨씬 명확해졌습니다.
9. Computer Use도 6.1의 큰 변화다
Coding만 좋아진 것도 아닙니다.
OSWorld에서 6.1은 6.0보다 크게 향상됐고, 최대 Reasoning에서는 Astra와의 차이가 2.1%포인트까지 줄었습니다.
그런데 작업당 비용은 Astra의 약 7분의 1 수준이었습니다.
그래서 6.1의 용도는:
코드 작성

Browser 사용

GUI 조작

문서 처리

Business Workflow

Agent 작업
을 묶어서 오래 수행하는 쪽에 가깝습니다.
10. Multi-Agent도 6.1부터 붙었다
GPT-6.1 Sol에는 또 하나 중요한 변화가 있습니다.
Responses API에서 Multi-agent Beta를 지원합니다.
Root Agent가 작업을 나눠 Subagent에게 넘길 수 있습니다.
예를 들어:
             GPT-6.1 Sol
                  │
          ┌───────┼───────┐
          ↓       ↓       ↓
        Agent   Agent    Agent

        탐색     구현     Test
같은 구조가 가능합니다.
단순 모델 성능 향상보다 Agent Runtime에서 쓰기 위한 변화가 더 많아지고 있습니다.
그런데 여기서 문제가 하나 있다
11. 6.1도 여전히 느리다는 이야기가 많다
GPT-6.1이 나온 뒤 첫 반응 중 가장 많이 보이는 말 중 하나가:
좋긴 좋은데 정말 느리다.
입니다.
현재 Codex 커뮤니티에서는:
6.0보다는 훨씬 좋다.

결과물도 괜찮다.

사용 한도도 적게 줄어드는 것 같다.

그런데 작업 시간이 너무 길다.
는 경험담이 반복적으로 나오고 있습니다.
일부 사용자는 5.6 Sol보다 Token 생성 속도가 체감상 2~3배 느리다고 측정했고, 긴 Coding 작업에서 몇 분간 눈에 띄는 진행이 없는 경우도 보고하고 있습니다. 이는 서버 부하나 계정·처리 Tier에 따라 달라질 수 있는 커뮤니티 측정값이지 공식 성능 수치는 아닙니다.
12. 이건 ‘Token이 싸다’와 전혀 다른 문제다
AI 비용 이야기를 할 때 세 가지를 구분해야 합니다.
Token 가격

Token 사용량

Wall-clock Time
입니다.
셋은 같은 개념이 아닙니다.
예를 들어:
모델 A

10,000 tokens
30초
$1


모델 B

8,000 tokens
3분
$0.50
이라면 모델 B는:
Token 효율 ↑
가격 효율 ↑
일 수 있지만,
시간 효율 ↓입니다.
현재 GPT-6.1 Sol에서 보이는 현상도 이 구분으로 보는 게 좋습니다.
13. API 가격만 보면 6.1은 5.6보다 훨씬 싸다
현재 표준 짧은 Context 기준 가격을 보면:
| GPT-5.6 Sol | GPT-6.1 Sol | |
|---|---|---|
| Input | $4 | $2 |
| Cached Input | $0.40 | $0.10 |
| Cache Write | $5 | $2.50 |
| Output | $20 | $10 |
100만 Token 기준입니다. GPT-5.6 Sol의 현재 가격은 프로모션 가격이고, OpenAI는 최소 2026년 11월 21일까지 이를 유지한다고 안내하고 있습니다.
단가만 보면:
Input
50% 감소

Output
50% 감소

Cache Read
75% 감소
입니다.
특히 Cache는 차이가 큽니다.
14. Repository를 계속 읽는 Agent라면 Cache 차이가 상당하다
Coding Agent는 매 요청마다 완전히 새로운 Context만 처리하지 않습니다.
계속 반복되는 내용이 많습니다.
System Prompt

AGENTS.md

Tool Schema

Repository Context

Architecture 문서

이전 작업 내용
이런 부분이 Cache에 들어가면:
GPT-5.6 Sol
$0.40

↓

GPT-6.1 Sol
$0.10
입니다.
Agent가 오래 실행될수록 이 차이는 꽤 커집니다.
6.1이 비용 기준으로 효율이 좋다고 OpenAI가 강조하는 이유 중 하나입니다.
15. 그런데 Token을 실제로 덜 쓰는지는 별개의 문제다
여기서는 주의해야 합니다.
OpenAI는:
GPT-6.1 Sol은 항상 GPT-5.6 Sol보다 몇 퍼센트 적은 Token을 사용한다.
같은 일반적인 수치를 공개하지 않았습니다.
작업마다 완전히 다릅니다.
오히려 복잡한 Agent 작업에서는:
더 긴 Reasoning

더 많은 탐색

더 많은 Tool Call

더 긴 작업 지속시간
이 생길 수도 있습니다.
따라서:
6.1이 싸다

=

무조건 Token을 적게 쓴다
는 아닙니다.
16. 특히 Reasoning 설정에서 5.6과 중요한 차이가 있다
GPT-5.6 Sol은:
none
low
medium
high
xhigh
max
를 지원합니다.
반면 GPT-6.1 Sol은:
low
medium
high
xhigh
max
이고,
none과 minimal을 지원하지 않습니다.
이건 작은 차이처럼 보이지만 일상 Coding에서는 꽤 중요할 수 있습니다.
17. 5.6은 아예 ‘생각하지 말고 빨리 실행’이 가능하다
예를 들어 작업이:
버튼 이름 변경

문자열 수정

간단한 View 추가

정해진 Pattern대로 파일 생성
처럼 명확하다면 긴 Reasoning이 필요하지 않습니다.
GPT-5.6 Sol은:
reasoning.effort = none으로 이런 작업을 처리할 수 있습니다.
하지만 6.1은 최소가:
low입니다.
따라서 구조적으로도 6.1은 어느 정도 Reasoning을 항상 수행하는 모델에 가깝습니다.
단순한 작업에서 5.6이 더 빠르고 가볍게 느껴질 수 있는 이유 중 하나로 볼 수 있습니다.
이건 OpenAI가 공식적으로 “5.6이 더 빠른 이유”라고 설명한 것은 아니지만, 두 모델의 설정 차이에서 자연스럽게 예상할 수 있는 부분입니다.
18. Medium이 기본이라는 것도 중요하다
GPT-6.1 Sol의 기본 Reasoning Effort는:
medium입니다.
Coding 작업에서 아무 설정 없이 실행하면 어느 정도의 Reasoning이 기본적으로 들어갑니다.
그리고:
high

xhigh

max
로 올릴수록 일반적으로 더 오래 생각하고 더 많은 Reasoning Token을 사용할 가능성이 높아집니다.
그래서 단순한 Coding 작업까지 무조건:
6.1 Sol Max로 돌리는 건 좋은 사용법이라고 보기 어렵습니다.
19. 6.1은 ‘빠르게 대답하는 모델’보다 ‘끝까지 해결하는 모델’에 가깝다
GPT-5.6 Sol을 사용할 때 만족도가 높았던 작업 중에는 이런 것이 많습니다.
정확하게 요청한 것만 수정

빠르게 코드 작성

짧은 반복 작업

즉각적인 피드백
반면 6.1이 목표로 하는 영역은 조금 다릅니다.
복잡한 Repository

긴 Coding 작업

Computer Use

여러 Tool 사용

전문 업무

Multi-Agent

Long-horizon Workflow
입니다.
따라서 사용 경험 자체도 달라질 수밖에 없습니다.
20. 문제는 개발자는 Benchmark보다 기다리는 시간을 먼저 느낀다는 것
공식 Benchmark에서:
+6.4%p

+7%p

2배 이상
같은 개선이 있어도,
개발자가 실제로 보는 화면이:
Thinking...

Thinking...

Tool...

Thinking...
이라면 체감은 좋지 않을 수 있습니다.
특히 Coding은 대화형 작업입니다.
수정
↓
확인
↓
추가 요청
↓
수정
↓
Build
을 반복합니다.
한 번의 결과가 조금 더 정확해도 매번 기다리는 시간이 길어진다면 생산성이 반드시 좋아지는 건 아닙니다.
21. 그래서 ‘효율’을 하나의 숫자로 보면 안 된다
GPT-6.1 Sol과 GPT-5.6 Sol을 비교하면 이렇게 보는 게 훨씬 정확합니다.
| 기준 | GPT-5.6 Sol | GPT-6.1 Sol |
|---|---|---|
| API Token 단가 | 높음 | 낮음 |
| Cache 비용 | 높음 | 매우 낮음 |
| 복잡한 Agent 성능 | 좋음 | 더 강함 |
| Astra 근접 성능 | 낮음 | 높음 |
reasoning:none | 가능 | 불가 |
| 짧은 수정 체감 | 유리할 수 있음 | Reasoning Overhead 가능 |
| 긴 복잡한 작업 | 좋음 | 유리 |
| 현재 체감 속도 | 빠르다는 사용자 많음 | 느리다는 보고 많음 |
마지막 줄은 공식 Benchmark가 아니라 현재 사용자 경험을 정리한 것입니다.
22. 재미있는 건 ‘느린데 사용량은 잘 안 줄어든다’는 반응도 많다는 것
6.1 사용자 반응은 조금 이상하게 갈립니다.
한쪽에서는:
너무 느리다.

한 작업에 너무 오래 걸린다.
라고 하고,
다른 쪽에서는:
몇 시간 사용했는데
Weekly Usage가 거의 안 줄었다.
라고 합니다.
이 두 이야기는 동시에 사실일 수 있습니다.
왜냐하면:
사용 한도 소모

≠

실제 작업 시간
이기 때문입니다.
구독 서비스의 Usage Meter 역시 단순 Raw Token 숫자만 보여주는 지표라고 볼 수 없습니다.
23. 그래서 ‘6.1은 Token을 적게 쓴다’고 단정하는 것도 아직 이르다
지금 커뮤니티를 보면:
사용량이 거의 안 줄었다는 사람도 있고,
긴 작업 하나에 사용량이 크게 줄었다는 사람도 있습니다.
Processing Tier, Effort, Context 크기, Tool 사용량, 작업 종류에 따라 결과가 크게 달라집니다.
따라서 지금 시점에서 가장 안전한 표현은:
6.1은 API 단가와 공식 작업당 비용은 매우 낮아졌지만, 실제 Token 소비량과 구독 사용량은 작업마다 크게 달라진다.
입니다.
24. 반대로 OpenAI의 공식 ‘작업당 비용’ 결과는 상당히 좋다
단순 Token 가격 말고 실제 Benchmark 작업 하나를 끝내는 비용을 보면 6.1이 상당히 강합니다.
Terminal-Bench Science 최대 Effort에서 OpenAI가 발표한 평균 작업 비용은:
GPT-6.1 Sol

$5.47
였습니다.
비교 대상으로 제시된:
Claude Opus 5.5
$23.21

GPT-6 Astra
$23.80
보다 75% 이상 낮았습니다.
즉 복잡한 작업에서는 오래 생각하더라도 문제를 실제로 해결하는 데 들어가는 금액은 낮을 수 있습니다.
25. 그래서 Token Efficiency와 Time Efficiency를 나눠서 봐야 한다
정리하면 이렇습니다.
비용 효율
6.1 Sol
★★★★★
API 가격과 Cache는 확실히 좋아졌습니다.
복잡한 문제 해결 효율
6.1 Sol
★★★★★
공식 Benchmark에서는 6.0과 5.6보다 확실히 강합니다.
짧은 작업의 반응 속도
5.6 Sol이 더 편한 경우가 있음특히 빠르게 수정하고 결과를 보는 작업입니다.
긴 Agent 작업
6.1 Sol이 더 적합한 번 맡긴 뒤 오래 실행시키는 작업입니다.
26. 5.6이 아직도 좋은 이유도 여기에 있다
새 모델이 나왔다고 5.6 Sol의 장점이 갑자기 없어지는 건 아닙니다.
5.6은 꽤 오랫동안 실제 개발자 Workflow에서 다듬어졌습니다.
그리고 사용 방식도 단순합니다.
요청

↓

빠르게 이해

↓

수정

↓

결과
특히 사용자가 원하는 범위가 명확할 때 좋은 경험을 주는 경우가 많습니다.
현재 커뮤니티에서도:
6.1의 결과는 좋지만 빠른 반복 작업은 5.6이 더 편하다.
는 반응을 쉽게 볼 수 있습니다.
27. 그렇다고 5.6이 더 좋은 모델이라고 볼 수도 없다
반대도 마찬가지입니다.
공식 평가에서는 6.1이:
Agentic Coding

Computer Use

전문 문서

Business Workflow

과학 작업

Alignment
대부분에서 6.0을 크게 앞서고 Astra에 접근합니다.
보안 평가에서도 일부 항목은 5.6보다 크게 향상됐고, Chain-of-Thought 제어 능력 역시 5.6보다 높아졌습니다.
따라서:
5.6
→ 빠른 반복에 좋은 모델

6.1
→ 더 큰 일을 해결하는 모델
정도로 보는 게 지금은 가장 자연스럽습니다.
28. 실제 Codex에서는 작업에 따라 나눠 쓰는 게 좋다
예를 들어 이런 작업이라면 5.6이 여전히 편할 수 있습니다.
간단한 UI 수정

이름 변경

작은 Bug Fix

정해진 Pattern 반복

짧은 Refactoring

빠른 질문 / 확인
반면 6.1은 이런 작업에서 매력적입니다.
Architecture를 이해해야 하는 수정

복잡한 Bug 추적

대규모 Refactoring

Repository 전체 탐색

Computer Use

여러 Tool을 사용하는 작업

오래 걸리는 Coding Agent 작업
29. 6.1에서는 Medium부터 쓰는 게 더 중요해졌다
6.1이 강하다고 처음부터:
High

XHigh

Max
만 쓰면 기다리는 시간이 상당히 길어질 수 있습니다.
따라서 일반 Coding에서는:
Medium부터 시작하는 게 좋습니다.
문제가 잘 해결되지 않을 때:
Medium
   ↓
High
   ↓
XHigh
순서로 올리는 편이 낫습니다.
Max는 정말 복잡한 작업을 장시간 맡길 때 쓰는 쪽이 자연스럽습니다.
30. 그리고 긴 작업은 오히려 밤새 맡기는 방식이 잘 맞는다
6.1에 대한 현재 사용자 반응 중 재미있는 표현이 있습니다.
Overnight task에 좋다.
즉:
개발자와 계속 대화하는 모델보다
큰 작업을 맡겨놓고
나중에 결과를 보는 모델
에 더 잘 맞는다는 의미입니다.
Codex가 점점 Background Agent 쪽으로 가고 있다는 걸 생각하면 이상한 방향도 아닙니다.
31. 속도가 중요하다면 결국 Fast와 Ultrafast가 있다
OpenAI 역시 속도를 별도의 제품 축으로 만들고 있습니다.
GPT-6.1 Sol에는 향후 Ultrafast가 제공될 예정이며, OpenAI는 Standard 대비 최대 8배 빠른 Token 생성을 예고하고 있습니다.
DevDay 기준으로 Codex에서는 최대 약 300 tokens/sec 수준을 목표로 하고 있습니다.
즉 앞으로는 모델 선택이:
어떤 모델?
하나로 끝나지 않고,
어떤 모델?

어떤 Effort?

어떤 Speed Tier?
까지 들어가게 됩니다.
32. 하지만 빠른 Tier는 결국 돈과 Compute의 교환이다
이 구조가 의미하는 것도 명확합니다.
더 강한 Reasoning
→ 시간 증가

더 빠른 Inference
→ 비용 증가

낮은 비용
→ 기다리는 시간 증가 가능
입니다.
결국 AI Coding도:
성능

속도

가격
세 개를 동시에 최대로 만들 수는 없습니다.
GPT-6.1 Sol은 현재 성능과 가격에 상당히 많은 비중을 둔 모델처럼 보입니다.
그리고 Standard 속도에서는 그 대가를 어느 정도 기다리는 시간으로 내는 셈입니다.
33. 6.1을 ‘느린 Astra’라고 보는 사용자도 있는 이유
커뮤니티에서는 재미있는 추측도 있습니다.
일부 사용자는 6.1과 Astra의 답변 방식이나 실수가 상당히 비슷하다면서:
Astra급 모델을 더 적은 Compute로 돌리는 것 아니냐.
는 추측을 하고 있습니다.
하지만 이건 확인된 사실이 아닙니다.
OpenAI가 공개한 것은 GPT-6.1 Sol이 Astra와 같은 종류의 Training Data와 Training 방식을 사용한다는 정도입니다.
따라서:
6.1 = Astra를 느리게 돌린 것이라고 단정하면 안 됩니다.
다만 Astra와 성능 격차를 크게 줄이면서 비용을 5분의 1 수준으로 낮춘 만큼, Serving과 Compute 배분 방식이 사용자 경험에 영향을 줄 가능성은 충분히 생각해볼 수 있습니다.
34. 그래서 6.1의 진짜 장점은 ‘한 번의 답변’보다 Agent 경제성이다
GPT-6.1 Sol을 Chatbot처럼 보면:
왜 이렇게 오래 생각하지?라는 느낌이 들 수 있습니다.
하지만 Agent 관점에서는 계산이 달라집니다.
예를 들어:
5.6

작업 시도
↓
실패
↓
다시 Prompt
↓
재시도
↓
사람 수정
보다,
6.1

오래 생각
↓
탐색
↓
수정
↓
Test
↓
완료
가 실제 비용과 사람의 개입을 줄인다면 후자가 더 효율적입니다.
OpenAI의 Benchmark도 이런 작업당 비용을 상당히 강조합니다.
35. 하지만 개발자가 옆에서 기다리고 있다면 이야기가 달라진다
반대로 내가 화면 앞에서:
한 줄 수정

확인

한 줄 수정

확인
을 반복하고 있다면 6.1의 깊은 Reasoning은 오히려 방해가 될 수 있습니다.
이럴 때는:
5.6 Sol

또는

Luna

또는

6.1 Low
같은 선택이 더 생산적일 수 있습니다.
결국 중요한 건 가장 높은 Benchmark 모델을 선택하는 게 아닙니다.
작업 형태에 맞는 모델을 선택하는 겁니다.
36. 지금 기준으로 정리하면 이렇게 쓸 것 같다
빠른 Coding 반복
GPT-5.6 Sol아직 꽤 좋습니다.
일반적인 복잡한 Coding
GPT-6.1 Sol Medium부터 시작합니다.
어려운 Debug / Architecture / 장시간 Agent
GPT-6.1 Sol High이상으로 올립니다.
가장 어려운 작업
GPT-6 Astra를 생각할 수 있습니다.
속도가 정말 중요하다면
Fast / Ultrafast같은 Processing Tier를 검토합니다.
37. 결국 6.1이 일주일 만에 나온 이유를 어떻게 봐야 할까
공식적으로는 정확한 이유가 공개되지 않았습니다.
따라서:
6.0이 망해서 긴급하게 6.1을 냈다.
고 말할 근거는 없습니다.
하지만 일주일 사이 실제로 벌어진 일을 모아보면:
GPT-6 Sol 출시

↓

Visual Encoding 문제 수정

↓

Coding / Latency 관련 사용자 불만

↓

7일 만에 6.1

↓

Coding 성능 대폭 개선

↓

Computer Use 개선

↓

Instruction / Alignment 개선

↓

Astra에 근접
입니다.
그리고 OpenAI 스스로 6.1을 “major upgrade”라고 표현하고 있습니다.
따라서 이번 6.1은 계획된 단순 Patch라기보다 GPT-6 Sol의 실전 모델 위치를 빠르게 다시 잡은 업데이트로 보는 편이 더 자연스럽습니다.
다만 그 이유가 사용자 불만 때문인지, 원래 예정된 모델 일정이었는지는 현재 공개된 정보만으로는 알 수 없습니다.
마치며
GPT-6.1 Sol의 첫인상은 조금 모순적입니다.
더 똑똑하다.

더 싸다.

Cache도 훨씬 싸다.

Astra에 가까워졌다.

그런데...

느리다.
입니다.
하지만 이건 이상한 일이 아닐 수도 있습니다.
AI Agent에서 효율은 더 이상 하나의 숫자가 아닙니다.
Token 단가

Token 사용량

Cache Hit

Reasoning 양

작업 성공률

재시도 횟수

Wall-clock Time

사람의 개입 시간
을 전부 봐야 합니다.
API 가격과 공식 Benchmark 기준으로는 GPT-6.1 Sol이 GPT-5.6 Sol보다 훨씬 경제적인 모델입니다.
반면 빠르게 대화하면서 코드를 수정하는 개발 경험에서는 5.6 Sol이 아직 더 경쾌하게 느껴질 수 있습니다.
그리고 6.1의 현재 가장 큰 약점은 바로 그 부분입니다.
성능은 Astra 쪽으로 올라갔지만,
속도까지 Astra처럼 느껴지는 것은 아닙니다.
그래서 GPT-6.1 Sol은 지금 당장 5.6을 완전히 지워버리는 모델이라기보다:
5.6
→ 빠른 개발 반복

6.1
→ 복잡하고 긴 Agent 작업

Astra
→ 가장 어려운 문제
로 역할이 나뉘기 시작한 모델에 더 가깝습니다.
앞으로 Ultrafast가 넓게 제공되고 Serving 속도가 안정되면 이 구분이 다시 바뀔 수도 있습니다.
하지만 지금 시점에서 GPT-6.1 Sol을 평가할 때 가장 중요한 건 단순히:
6.0보다 몇 점 좋아졌나?
가 아닙니다.
이 모델이 내 개발 시간을 실제로 줄여주느냐.
그리고:
더 오래 생각한 만큼 다시 시킬 일이 줄어드느냐.
이 두 가지를 직접 확인해보는 게 더 중요합니다.
참고자료
OpenAI — Introducing GPT-6.1 Sol
GPT-6.1 Sol의 Coding, Computer Use, 전문 업무 성능과 GPT-6 Sol·Astra 비교, 작업당 비용, 가격을 확인할 수 있는 공식 발표입니다.
https://openai.com/index/introducing-gpt-6-1-sol/
OpenAI — Introducing GPT-6 Sol and Luna
GPT-6 Sol의 초기 목표와 GPT-5.6 Sol 대비 가격·Coding·Caching 개선을 설명한 공식 발표입니다.
https://openai.com/index/introducing-gpt-6-sol-and-luna/
OpenAI Developers — GPT-6.1 Sol
1.05M Context, 128K Output, Reasoning Effort 범위와 API 지원 기능을 확인할 수 있습니다.
https://developers.openai.com/api/docs/models/gpt-6.1-sol
OpenAI Developers — API Pricing
GPT-6.1 Sol과 GPT-5.6 Sol의 Input·Cached Input·Cache Write·Output 가격을 비교할 수 있는 공식 가격표입니다.
https://developers.openai.com/api/docs/pricing
OpenAI — Release Notes
GPT-6 Sol과 Luna에서 발생했던 Image Encoding 문제와 Visual Understanding 수정 내용을 확인할 수 있습니다.
https://openai.com/products/release-notes/
OpenAI — DevDay 2026 Recap
GPT-6.1 Sol을 GPT-6 Sol의 주요 업그레이드로 소개하고 Multi-Agent, Ultrafast 등 최근 Agent 관련 발표를 정리합니다.
https://openai.com/index/devday-2026-recap/
OpenAI Developer Community — Codex tasks suddenly taking 10–20x longer
GPT-6 Sol 출시 직후 Codex의 긴 작업 시간과 사용량 증가를 보고한 실제 사용자 사례입니다. 공식 Benchmark가 아닌 커뮤니티 경험이라는 점을 감안해서 볼 필요가 있습니다.
Reddit — GPT-6.1 Sol 사용자 반응
GPT-6.1 Sol의 결과 품질, 낮은 사용량 체감과 함께 느린 Token 생성 및 긴 작업 시간을 경험한 사용자들의 초기 반응을 확인할 수 있습니다.