Moru를 써보고 얻은 것들 — Codex와 Claude가 완료까지 함께 일하는 개발 환경 만들기
Moru를 써보고 얻은 것들 — Codex와 Claude가 완료까지 함께 일하는 개발 환경 만들기
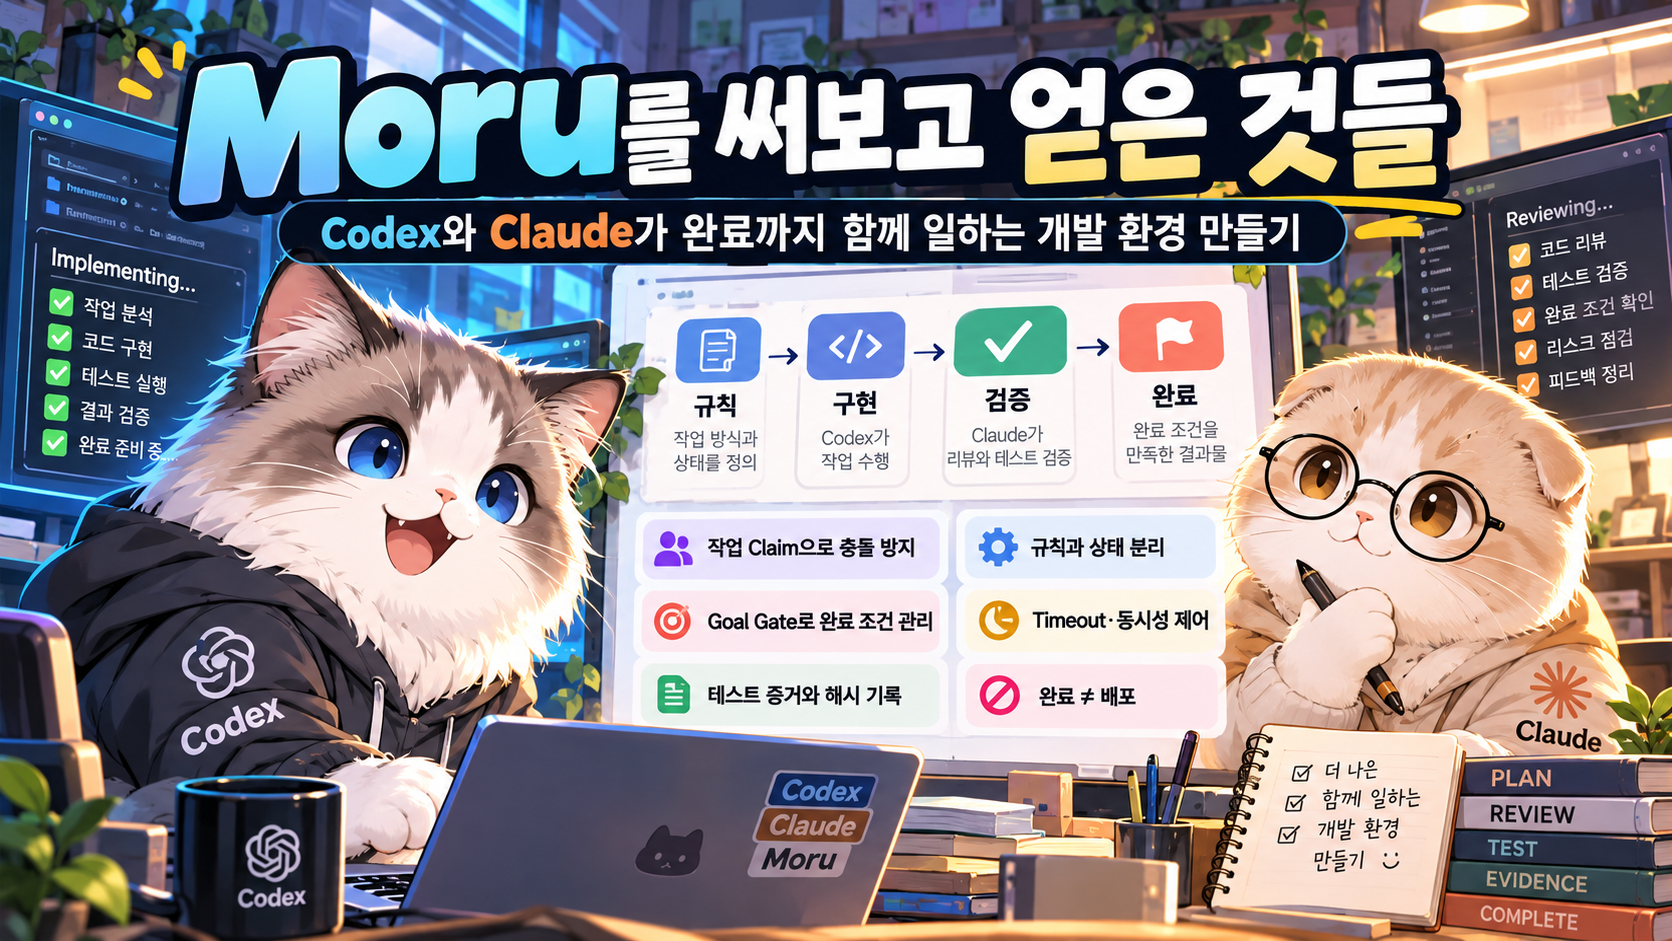
작업 충돌부터 컨텍스트 낭비, 테스트 증거 관리, 완료 조건까지 — AI 코딩 에이전트를 안정적으로 운영하기 위해 바꾼 것들
AI 코딩 에이전트를 오래 사용하다 보면 모델 성능보다 먼저 작업 환경의 한계를 만나게 된다.
처음에는 Codex나 Claude Code에 "이 버그를 고쳐줘", "테스트까지 실행해줘"라고 요청하는 것만으로도 충분해 보인다.
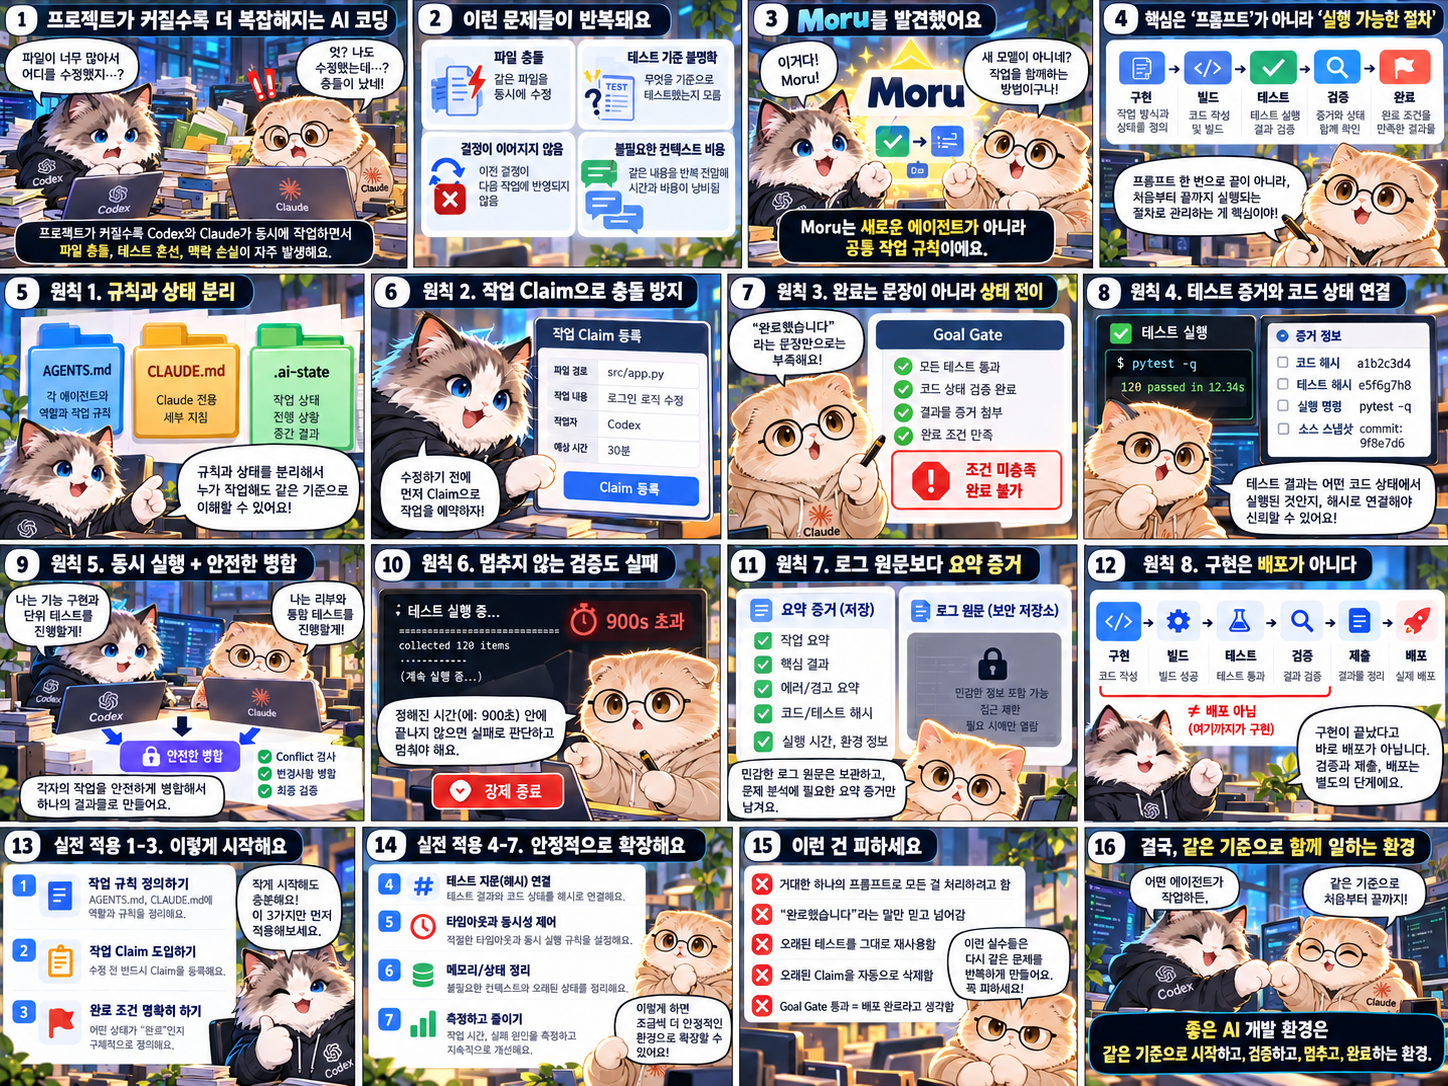
하지만 프로젝트가 커지고 여러 에이전트를 함께 사용하기 시작하면 문제가 달라진다.
한 에이전트가 수정하고 있는 파일을 다른 에이전트가 건드린다.
테스트를 통과했다고 보고했지만, 정확히 어떤 코드 상태에서 실행한 테스트인지 알 수 없다.
이전 세션에서 확정한 설계가 다음 세션에 전달되지 않아 같은 문제를 다시 분석한다.
심지어 테스트가 실패했는데도 에이전트가 작업을 완료했다고 보고하는 경우도 있다.
문제를 막으려고 AGENTS.md와 CLAUDE.md에 규칙을 계속 추가하면 또 다른 문제가 생긴다.
단순한 질문을 할 때도 수많은 규칙을 읽고, 작업에 필요하지 않은 정보까지 컨텍스트에 포함하게 된다.
AI가 코드를 작성하는 능력은 좋아졌지만, 여러 AI가 같은 프로젝트에서 안정적으로 일하도록 만드는 것은 여전히 별개의 문제다.
이런 문제를 해결하는 과정에서 살펴본 프로젝트가 Moru Core다.
Moru Core는 Codex나 Claude Code를 대체하는 새로운 AI 모델이 아니다.
기존 코딩 에이전트를 그대로 사용하면서 공통 작업 규칙, 선택적인 문서 로딩, 안전 검사, 완료 검증 등을 연결하는 오픈소스 프로젝트다.
Moru를 사용하며 인상적이었던 원칙들을 바탕으로 로컬 개발 환경도 다시 정리했다.
그 과정에서 작업 소유권, 상태 관리, 검증 증거, 완료 조건, 동시 실행 제어를 별도의 구조로 분리했다.
이번 글에서는 Moru Core가 제시한 접근과, 이를 참고해 로컬 환경에 직접 적용한 설계를 구분해 살펴본다.
핵심은 단순하다.
에이전트가 "완료했습니다"라고 말하는 것과 실제 작업이 완료된 것은 다르다.
1. Moru Core의 핵심은 새로운 에이전트가 아니라 공통 작업 규칙이다
Moru Core는 이미 사용하고 있는 AI 코딩 도구에 공통적인 작업 규칙을 적용하는 프로젝트다.
Codex, Claude Code, Antigravity 등의 도구에 연결해 사용할 수 있도록 구성돼 있다.
중요한 점은 기존 개발 환경을 전부 교체하지 않아도 된다는 것이다.
예를 들어 Codex는 계속 코드를 수정하고, Claude Code는 기존 방식대로 프로젝트를 분석할 수 있다.
Moru Core는 그 과정에서 다음과 같은 기준을 제공한다.
- 작업에 필요한 규칙만 선택적으로 읽기
- 프로젝트 고유 규칙을 프로젝트 내부에 유지하기
- 코드 변경 후 필요한 테스트와 안전 검사 실행하기
- 변경되지 않은 코드에 대해 유효한 검증 결과 재사용하기
- 여러 에이전트가 공통된 작업 기준 사용하기
- 확인된 오류 원인과 해결 방법을 이후 작업에서 참고하기
Moru Core의 공식 자료는 이런 구조를 통해 반복적인 문서 로딩과 작업 단계를 줄이는 방향을 설명한다.
특히 모든 규칙을 하나의 거대한 프롬프트에 넣는 방식 대신, 작업 종류에 따라 필요한 문서만 선택하도록 설계했다.
Moru Core는 이를 위해 Wikimap 기반의 문서 인덱싱과 로컬 검증 실행기를 활용한다.
또 작업 시작과 완료 단계에 안전 검사를 적용하는 VibeGuard도 함께 사용한다.
이렇게 보면 Moru의 목적은 AI에게 더 많은 지시를 전달하는 것이 아니다.
필요한 지시만 읽게 하고, 작업 결과는 실제 실행으로 확인하도록 만드는 것이다.
2. Moru는 실제로 컨텍스트 사용량을 얼마나 줄였을까?
Moru Core의 공개 자료에는 약 5개월 동안 자체 개발 환경에서 측정한 결과가 포함돼 있다.
2026년 5월부터 10월까지 26개 저장소에서 수집한 작업 기록을 바탕으로 규칙 로딩과 토큰 사용량, 작업 단계의 변화를 비교했다.
대표적인 수치는 다음과 같다.
| 측정 항목 | 기존 | 개선 후 | 변화 |
|---|---|---|---|
| 작업당 읽는 규칙 파일 | 20.45개 | 4.15개 | -79.7% |
| 커밋당 에이전트 작업 단계 | 150.7 | 59.2 | -60.7% |
| 변경 파일당 가중 토큰 사용량 | 432.5K | 94.6K | -78.1% |
| Codex 세션 중앙값 토큰 사용량 | 20.28M | 1.25M | -93.8% |
상당히 큰 차이다.
하지만 이 수치를 그대로 모든 개발 환경의 성능 개선 결과로 받아들여서는 안 된다.
해당 자료는 Moru 프로젝트가 자체 저장소와 개발 환경에서 수집한 기록이다.
같은 모델을 사용하더라도 작업의 난이도나 프로젝트 상태, 개발 환경의 차이가 결과에 영향을 줄 수 있다.
따라서 Moru를 설치하면 누구나 토큰 사용량이 79% 줄어든다고 설명하는 것은 적절하지 않다.
이 자료에서 더 중요하게 볼 부분은 어떤 구조를 바꿨을 때 반복적인 작업 비용이 줄어들었는가다.
특히 두 가지가 눈에 띈다.
첫 번째는 작업과 관계없는 규칙을 읽지 않는 것이다.
두 번째는 이전에 확인한 결과를 무조건 다시 검증하지 않고, 현재 코드 상태에서도 유효한지 판단하는 것이다.
이 두 가지는 Moru를 사용하지 않더라도 일반적인 AI 코딩 환경에 적용할 가치가 있다.
3. 첫 번째 원칙 — 규칙과 현재 작업 상태를 분리한다
AI 코딩 환경을 만들 때 흔히 하는 실수 중 하나는 모든 규칙을 AGENTS.md나 CLAUDE.md에 넣는 것이다.
처음에는 문제가 없어 보인다.
하지만 프로젝트가 커질수록 파일이 길어진다.
AGENTS.md

- 프로젝트 구조
- 코딩 규칙
- 아키텍처
- 보안 정책
- 빌드 방법
- 테스트 방법
- 현재 작업
- 이전 작업 기록
- 오류 해결 이력
- 임시 결정
이렇게 되면 몇 가지 문제가 생긴다.
단순한 질문을 할 때도 모든 규칙을 읽는다.
이미 끝난 작업의 임시 결정이 현재 작업에 영향을 줄 수 있다.
어떤 규칙이 아직 유효한지 판단하기 어려워진다.
무엇보다 규칙과 상태, 과거 기록이 뒤섞인다.
그래서 로컬 개발 환경에서는 이를 분리했다.
AGENTS.md
CLAUDE.md

.ai-state/
├── README.md
├── active/
│   └── <owner>.md
├── goals/
│   └── <goal-id>/
│       ├── goal.json
│       └── evidence.json
├── constraints.md
├── decisions.md
├── open-questions.md
├── current-task.md
└── logs/
    ├── raw/
    └── summaries/
이 구조는 Moru Core의 기본 디렉터리 구조를 그대로 복사한 것이 아니라, Moru의 설계 원칙을 참고해 로컬 환경에 별도로 만든 구성이다.
각 파일의 역할은 명확하다.
| 파일 | 역할 |
|---|---|
AGENTS.md | 공통 작업 규칙 |
CLAUDE.md | Claude 전용 지침 |
active/ | 현재 작업 중인 에이전트와 수정 범위 |
constraints.md | 반드시 지켜야 하는 제약 조건 |
decisions.md | 확정된 기술적 결정과 이유 |
open-questions.md | 개발자 판단이 필요한 문제 |
current-task.md | 현재 진행 상태와 다음 행동 |
goals/ | 작업 목표와 검증 결과 |
logs/ | 실행 로그와 요약된 검증 정보 |
특히 중요한 것은 상태 파일을 긴 대화 기록처럼 사용하지 않는 것이다.
다음 에이전트가 읽었을 때 무엇이 결정됐고, 무엇이 남았으며, 다음에 어떤 작업을 수행해야 하는지 알 수 있어야 한다.
과거 대화를 많이 저장하는 것보다, 현재 작업을 이어갈 수 있는 정보를 정확하게 남기는 것이 중요하다.
4. 두 번째 원칙 — 파일을 수정하기 전에 작업 소유권을 선언한다
Codex와 Claude Code를 동시에 사용하면 가장 먼저 부딪히는 문제가 파일 충돌이다.
예를 들어 Codex가 네트워크 코드를 수정하는 중이라고 생각해보자.
그 사이 Claude Code가 같은 파일에서 동시성 문제를 발견하고 수정한다.
두 에이전트 모두 정상적으로 작업했다고 보고할 수 있다.
하지만 실제로는 한쪽 변경이 다른 쪽 변경을 덮어썼을 수도 있다.
Git을 사용하면 변경 내용을 확인하고 복구할 수 있다.
그러나 Git만으로 같은 로컬 작업공간에서 실행 중인 두 에이전트의 작업 충돌을 예방할 수 있는 것은 아니다.
그래서 로컬 환경에서는 작업 소유권(Claim) 개념을 도입했다.
각 에이전트는 편집을 시작하기 전에 자신이 수정할 범위를 선언한다.
예를 들면 다음과 같다.
# Claim: codex-interactive

- Status: in_progress
- Updated: 2026-10-29T21:00:00+09:00
- Lease hours: 4
- Allowed edits: `scripts/**`; `docs/goal-system.md`
- Next action: Run focused verification.
다른 에이전트는 작업을 시작하기 전에 활성 Claim을 확인한다.
자신이 수정하려는 파일 범위와 겹친다면 곧바로 편집하지 않는다.
먼저 충돌 상태를 기록하고 작업 범위를 조정한다.
실제로 적용한 규칙
- 하나의 에이전트는 하나의 활성 Claim만 가진다.
- Claim은 소유한 에이전트만 수정하거나 해제한다.
- 수정 범위를 가능한 한 작게 선언한다.
- 오래된 Claim도 다른 에이전트가 임의로 삭제하지 않는다.
- 작업이 완료되면 Claim을 해제하고 현재 상태를 갱신한다.
여기서 Claim은 단순한 작업 메모가 아니다.
에이전트가 작업 시작 전에 확인해야 하는 충돌 방지 규칙이다.
다만 Markdown 파일에 Claim을 적었다는 사실만으로 파일 수정이 운영체제 수준에서 차단되는 것은 아니다.
실제 효과를 얻으려면 작업 시작과 편집 과정에서 Claim 충돌을 검사하는 로직이 필요하다.
또 Claim에 적힌 임대 시간이 지났다는 이유만으로 다른 작업을 자동으로 강제 종료하지 않는다.
작업 상태를 확인하고 소유권을 정리하는 절차가 필요하다.
멀티 에이전트 환경에서는 코드를 잘 수정하는 능력만큼 누가 수정할 수 있는지 관리하는 능력도 중요하다.
5. 세 번째 원칙 — "완료했습니다"를 AI의 판단에 맡기지 않는다
Moru를 참고하면서 가장 크게 바뀐 부분은 작업의 완료 조건이다.
일반적인 AI 코딩 도구에서는 다음과 같은 응답을 자주 볼 수 있다.
구현을 완료했습니다.

관련 테스트도 확인했습니다.

문제없이 동작합니다.
문제는 이 문장만으로 실제 작업 상태를 알 수 없다는 것이다.
테스트를 실행한 것인지, 코드를 읽고 정상일 것이라고 판단한 것인지 구분하기 어렵다.
또 테스트를 실행했더라도 어떤 코드 버전을 기준으로 확인했는지 알 수 없을 수 있다.
그래서 완료를 자연어 답변이 아니라 검증 가능한 상태 전이로 관리하도록 바꿨다.
OpenAI의 Codex Goals 가이드도 비슷한 접근을 설명한다.
목표를 단순한 장기 프롬프트가 아니라 결과물, 검증 방법, 제약 조건, 작업 경계, 반복 정책, 중단 조건을 포함한 계약으로 정의하는 것이다.
이 원칙을 바탕으로 로컬 환경에 별도의 Goal Gate를 만들었다.
Goal 생성
python scripts/goal_gate.py init checkout-fix \
  --objective "결제 오류를 수정하고 회귀 테스트를 통과한다" \
  --root commerce_app \
  --owner codex-interactive \
  --allow 'Sources/**' \
  --allow 'Tests/**' \
  --require 'unit:command' \
  --require 'preview:artifact' \
  --blocked-condition "테스트 환경이나 제품 결정이 없으면 중단한다"
위 명령은 직접 구성한 로컬 goal_gate.py 도구의 사용 예제다.
Moru Core가 기본 제공하는 CLI 명령과는 다르다.
목표를 생성할 때 수정 가능한 경로와 완료에 필요한 증거를 함께 정의한다.
이후 구현 작업을 수행한다.
작업이 끝났다고 판단되면 다음 검증을 실행한다.
python scripts/goal_gate.py run checkout-fix unit -- swift test

python scripts/goal_gate.py artifact \
  checkout-fix preview build/preview.png

python scripts/goal_gate.py status checkout-fix

python scripts/goal_gate.py finish checkout-fix
여기서 finish는 단순히 완료 상태를 기록하는 명령이 아니다.
필수 검증 증거가 존재하고 유효한지 확인하는 마지막 단계다.
테스트가 실패했거나 필요한 산출물이 없다면 완료 처리를 거부한다.
이 방식의 장점은 명확하다.
Codex가 작업했든 Claude가 작업했든 완료 조건은 동일하다.
AI가 스스로 충분히 확인했다고 판단해도 계약을 충족하지 못했다면 완료되지 않은 작업으로 남는다.
완료는 에이전트의 자신감이 아니라, 사전에 정의한 증거로 판단해야 한다.
6. 네 번째 원칙 — 테스트 결과에도 유효한 코드 상태가 있다
테스트는 한 번 통과했다고 영원히 유효한 것이 아니다.
예를 들어 월요일에 모든 테스트가 통과했다고 생각해보자.
화요일에 다른 에이전트가 네트워크 코드를 수정했다.
그렇다면 월요일의 테스트 결과로 화요일의 코드를 검증했다고 말할 수 있을까?
당연히 어렵다.
그런데 AI 에이전트는 이전 테스트 결과가 남아 있으면 그것을 현재 작업에도 사용할 수 있다고 판단할 가능성이 있다.
그래서 테스트 결과를 코드 상태와 연결해야 한다.
로컬 Goal Gate에는 검증 시점의 지문을 함께 기록하도록 구성했다.
대표적인 항목은 다음과 같다.
- 실행 명령의 SHA-256
- 허용된 파일 범위의 SHA-256
- 의존성 잠금 파일의 지문
- 실행 환경 관련 파일의 지문
- 실행 파일 정보와 수정 시각
- stdout·stderr의 SHA-256과 바이트 수
- 종료 코드
- 실행 시간
- 타임아웃 발생 여부
이런 정보를 저장하는 이유는 단순하다.
이전에 통과한 테스트가 지금도 유효한지 판단하기 위해서다.
예를 들어 다음과 같은 상황이다.
월요일

Source A: SHA-256 abc123
테스트: PASS
화요일에도 검증 대상 코드와 실행 명령, 의존성, 관련 환경이 같다면 기존 결과를 재사용할 수 있는지 검토할 수 있다.
반대로 코드가 변경됐다면 다시 검증해야 한다.
명시적인 결과 재사용
로컬 환경에서는 이전 검증 결과를 재사용할 때 --reuse 옵션을 명시하도록 했다.
자동으로 어제의 테스트 결과를 현재 코드에 적용하지 않기 위해서다.
물론 파일 해시가 같다는 사실만으로 모든 종류의 테스트 결과가 언제나 유효하다고 보장되지는 않는다.
외부 API 상태나 데이터베이스, 운영체제, 시간, 네트워크 환경에 의존하는 테스트라면 추가 조건이 필요하다.
따라서 재사용 정책은 테스트 성격에 따라 달라져야 한다.
예를 들어 순수한 계산 함수의 단위 테스트는 재사용 조건을 비교적 명확하게 정의할 수 있다.
반면 실제 서버와 통신하는 통합 테스트는 외부 상태가 달라질 수 있어 더 신중해야 한다.
핵심은 재사용 자체가 아니라 재사용해도 되는 이유를 증명할 수 있어야 한다는 것이다.
7. 다섯 번째 원칙 — 멀티 에이전트는 동시에 실행된다는 전제로 설계한다
Codex와 Claude가 서로 다른 검증 작업을 동시에 실행할 수 있다.
이때 단순히 작업이 병렬로 실행되는 것만 생각하면 문제가 발생한다.
예를 들어 두 에이전트가 같은 evidence.json 파일을 사용하는 상황이다.
Codex                    Claude
  │                        │
  ▼                        ▼
evidence.json 읽기     evidence.json 읽기
  │                        │
테스트 A 실행           테스트 B 실행
  │                        │
결과 A 저장             결과 B 저장
두 에이전트가 동일한 이전 상태를 읽었다면 문제가 발생할 수 있다.
Codex가 결과 A를 저장한 뒤 Claude가 자신의 이전 상태에 결과 B만 추가해 파일을 다시 저장하면 결과 A가 사라질 수 있기 때문이다.
여기서 자주 오해하는 부분이 있다.
파일을 원자적으로 저장하는 것과 동시에 발생한 상태 변경을 안전하게 병합하는 것은 다르다.
임시 파일을 만든 뒤 원자적 파일 교체를 사용하면 파일이 중간에 깨지는 문제를 줄일 수 있다.
하지만 두 에이전트가 서로 다른 오래된 상태를 기반으로 저장하는 문제까지 해결하지는 못한다.
그래서 로컬 환경에서는 다음 절차를 적용했다.
- 검증 명령 자체는 병렬로 실행한다.
- 결과를 저장할 때 Goal별 파일 잠금을 획득한다.
- 잠금을 획득한 뒤 최신
evidence.json을 다시 읽는다. - 자신의 검증 결과만 병합한다.
- 병합 결과를 안전하게 저장한다.
- 완료 판정도 동일한 잠금 안에서 수행한다.
개념적으로 다음과 같다.
Codex 검증 A ───────┐
                    │
                    ▼
               Goal Lock
                    │
               최신 상태 읽기
                    │
               결과 A 병합
                    │
               저장 후 해제
                    │
Claude 검증 B ──────┤
                    ▼
               Goal Lock
                    │
               최신 상태 읽기
                    │
               결과 B 병합
                    │
               저장 후 해제
이렇게 하면 검증 작업을 병렬로 수행하면서도 결과 저장 시점에는 충돌을 제어할 수 있다.
실제 로컬 동시 실행 테스트에서도 서로 다른 두 검증 결과가 모두 보존되는 것을 확인했다.
다만 이러한 파일 잠금 방식은 사용하는 운영체제와 파일 시스템에 따라 구현 세부사항이 달라질 수 있다.
여러 컴퓨터가 같은 상태를 공유한다면 로컬 파일 잠금만으로 충분하지 않을 수도 있다.
그 경우에는 데이터베이스 트랜잭션이나 별도의 분산 잠금 정책이 필요할 수 있다.
8. 여섯 번째 원칙 — 끝나지 않는 테스트는 성공도, 진행 중도 아니다
AI 코딩 환경에서 생각보다 자주 발생하는 문제가 있다.
빌드나 테스트 명령이 종료되지 않는 것이다.
예를 들어 다음과 같은 명령이다.
swift test정상적인 경우라면 테스트를 실행한 뒤 종료 코드를 반환한다.
그런데 특정 테스트에서 데드락이 발생하거나 하위 프로세스가 종료되지 않으면 명령이 끝나지 않을 수 있다.
이때 에이전트가 아무 제한 없이 기다리도록 두면 작업 전체가 멈춘다.
그래서 로컬 검증 명령에는 기본 타임아웃을 적용했다.
기본 제한은 900초다.
시간이 초과되면 명령을 실패로 기록한다.
{
  "exit_code": 124,
  "timed_out": true,
  "status": "failed"
}
여기서 중요한 부분은 단순히 부모 프로세스를 종료하는 것만으로 충분하지 않을 수 있다는 점이다.
빌드 도구는 내부적으로 여러 하위 프로세스를 실행할 수 있다.
xcodebuild
    │
    ├── swift-frontend
    ├── clang
    ├── test runner
    └── other processes
부모 프로세스만 종료하면 하위 작업이 계속 남을 가능성이 있다.
그래서 로컬 실행기에서는 새 프로세스 그룹으로 명령을 시작하고, 타임아웃 시 해당 그룹의 프로세스를 함께 종료하도록 구성했다.
물론 타임아웃 값은 작업 종류에 따라 조정해야 한다.
빠른 단위 테스트와 대규모 iOS 빌드, UI 테스트를 모두 같은 제한으로 처리하는 것이 항상 적절하지는 않기 때문이다.
중요한 것은 시간이 초과된 작업을 성공으로 간주하지 않는 것이다.
검증이 끝나지 않았다면 아직 검증되지 않은 상태다.
9. 일곱 번째 원칙 — 증거는 남기되 모든 로그를 저장하지 않는다
검증 결과를 관리하기 시작하면 로그가 빠르게 쌓인다.
빌드 로그와 테스트 로그, 에이전트 실행 기록, 오류 메시지가 계속 생성된다.
처음에는 모든 원본 로그를 저장하는 것이 안전해 보일 수 있다.
하지만 시간이 지나면 다른 문제가 생긴다.
로그에 API 키나 인증 정보가 포함될 수 있다.
사용자의 개인정보나 내부 서버 주소가 기록될 수도 있다.
또 로그 파일이 커지면서 이후 AI 세션에서 관련 내용을 읽는 비용이 늘어난다.
그래서 공통 증거 저장소에는 원본 로그를 무조건 저장하지 않도록 했다.
대신 다음 정보를 기록한다.
{
  "command": "swift test",
  "exit_code": 0,
  "timed_out": false,
  "duration_ms": 12540,
  "stdout_sha256": "abc123...",
  "stdout_bytes": 18432,
  "stderr_sha256": "def456...",
  "stderr_bytes": 0
}
위 해시값은 형식 설명을 위한 예시다.
실제 결과에서는 전체 SHA-256 값을 기록한다.
이렇게 하면 로그 본문을 항상 읽지 않더라도 실행 결과의 식별 정보와 상태를 관리할 수 있다.
원본 로그가 필요한 경우에는 별도 디렉터리에 제한적으로 저장한다.
logs/
├── raw/
└── summaries/
원본 로그에는 접근 권한과 보존 기간을 적용하는 것이 좋다.
또 해시를 남겼다고 해서 로그 내용이 안전하다는 의미는 아니다.
SHA-256은 내용을 식별하고 무결성을 확인하는 데 도움을 줄 수 있지만 민감한 정보가 포함됐는지 검사하는 기능은 아니다.
필요한 경우 비밀정보 탐지나 마스킹 절차도 별도로 구성해야 한다.
핵심은 다음과 같다.
에이전트가 다음 작업을 수행하는 데 필요한 것은 대개 수천 줄의 로그 원문이 아니라, 어떤 검증이 어떤 결과로 끝났는지에 대한 정보다.
10. 여덟 번째 원칙 — 구현과 검증, 배포를 같은 완료 상태로 취급하지 않는다
AI 코딩 에이전트가 자주 혼동하는 표현이 있다.
"구현했습니다."
"테스트했습니다."
"완료했습니다."
"배포했습니다."
이 표현들은 서로 다른 상태를 가리킨다.
예를 들어 Codex가 Swift 코드를 수정했다고 해보자.
코드 작성은 끝났다.
하지만 아직 빌드하지 않았다면 실제 프로젝트에서 컴파일되는지 알 수 없다.
빌드가 성공했더라도 테스트를 통과했는지는 별개다.
테스트가 통과했더라도 TestFlight에 업로드된 것은 아니다.
TestFlight 업로드에 성공했더라도 App Store에 출시된 것은 아니다.
이 상태들을 분리해야 한다.
IMPLEMENTED
     ↓
BUILD_PASSED
     ↓
TEST_PASSED
     ↓
VERIFIED
     ↓
REVIEW_APPROVED
     ↓
SUBMITTED
     ↓
RELEASED
로컬 Goal Gate가 통과했다면 해당 목표의 검증 계약을 충족했다는 의미다.
이것이 자동으로 배포 승인을 뜻하지는 않는다.
특히 다음과 같은 외부 작업은 별도 승인을 요구하도록 구성했다.
- 원격 Git 저장소 Push
- 공개 저장소 생성
- App Store 제출
- 실제 서버 배포
- 비용이 발생하는 외부 API 호출
- 외부 메시지와 이메일 전송
이런 작업은 코드 수정과 다르게 외부 시스템에 영향을 준다.
따라서 Goal의 완료 여부만으로 실행하도록 두는 것은 위험할 수 있다.
AI가 기술적으로 작업을 완료하는 것과 실제 사용자에게 결과를 공개하는 것은 서로 다른 책임이다.
11. 로컬 환경에서 가장 중요한 것은 실패했을 때 다시 시작할 수 있는 구조다
AI 코딩 작업은 항상 정상적으로 끝나지 않는다.
세션이 종료될 수도 있고, 네트워크 요청이 실패할 수도 있다.
사용량 제한에 도달하거나 테스트가 멈추는 경우도 있다.
그때마다 처음부터 다시 작업하면 컨텍스트와 시간이 낭비된다.
따라서 현재 작업 상태를 복구할 수 있어야 한다.
예를 들어 다음 정보를 남긴다.
Goal ID

현재 담당 에이전트

마지막 성공 단계

변경된 파일

현재 Git Commit

검증 결과

실패 원인

다음 실행할 명령
이렇게 해두면 다음 세션에서는 긴 이전 대화를 읽지 않아도 된다.
현재 상태와 다음 행동만 확인하면 된다.
Moru Core 역시 중단된 작업을 이어갈 수 있는 실행 기록과 Work Card 개념을 제공한다.
로컬 환경에서는 이 원칙을 활용하되 프로젝트에 맞는 별도의 상태 파일로 관리했다.
특히 작업이 중단됐다는 이유만으로 완료된 검증을 무조건 처음부터 다시 실행할 필요는 없다.
반대로 이전 검증이 현재 코드에서도 유효한지 확인하지 않고 그대로 재사용해서도 안 된다.
중단된 작업을 안전하게 이어가려면 현재 상태뿐 아니라 이전 검증의 유효성까지 확인해야 한다.
12. 실패했던 해결 방법을 그대로 다음 작업에 전달하면 안 된다
여러 에이전트를 사용하면 이전 작업의 기록을 공유하는 것이 유용하다.
하지만 모든 기록을 다음 작업에 전달하는 것은 좋지 않다.
특히 실패한 해결 방법이나 확인되지 않은 가설이 장기 메모리에 남으면 문제가 된다.
예를 들어 AI가 네트워크 오류의 원인을 잘못 추측했다고 생각해보자.
가설:
URLSession 설정이 잘못됐다.
이 가설을 검증하지 않은 채 프로젝트의 공통 메모리에 저장하면 이후 다른 에이전트도 같은 전제를 바탕으로 작업할 수 있다.
그래서 메모리에는 정보의 상태가 필요하다.
확인된 사실

검증된 해결 방법

설계 결정

미해결 질문

폐기된 가설
이들을 구분해야 한다.
예를 들어 다음과 같이 기록할 수 있다.
## Confirmed

- 취소된 요청의 응답이 화면 상태를 변경했다.
- Request ID 검증을 추가한 뒤 재현 테스트 통과.

## Rejected Hypothesis

- URLSession 설정이 원인이라는 가설은
  재현 테스트에서 확인되지 않았다.

## Open Question

- 앱 백그라운드 복귀 시에도
  같은 문제가 발생하는지 추가 확인 필요.
이런 방식이면 다음 에이전트가 확인된 사실과 추측을 혼동하지 않는다.
또 임시 메모리에는 재검토 시점이나 만료 기준을 두는 것이 좋다.
프로젝트 구조가 달라졌는데 오래된 해결 방법이 계속 적용되는 문제를 줄이기 위해서다.
13. 처음부터 모든 기능을 만들 필요는 없다
이런 개발 환경을 설명하면 상당히 복잡하게 느껴질 수 있다.
작업 소유권, Goal Gate, 파일 해시, 동시성 제어, 타임아웃, 로그 관리까지 한 번에 구축해야 할 것처럼 보이기 때문이다.
하지만 실제로는 작은 규칙부터 적용하는 것이 좋다.
1단계 — 프로젝트 규칙 정리
먼저 AGENTS.md에 핵심 규칙만 작성한다.
빌드 방법, 수정하면 안 되는 파일, 코딩 규칙, 보안 정책과 배포 승인 조건부터 시작한다.
2단계 — 작업 Claim 도입
Codex와 Claude가 동시에 같은 파일을 수정하지 않도록 작업 소유권을 관리한다.
처음에는 간단한 Claim 파일만으로도 현재 누가 어떤 작업을 수행하는지 확인하는 데 도움이 된다.
3단계 — 완료 조건 정의
테스트와 산출물의 완료 기준을 명확히 한다.
무엇이 완료돼야 하는가?

어떤 테스트가 통과해야 하는가?

어떤 파일을 변경할 수 있는가?

무엇이 없으면 중단해야 하는가?
4단계 — 검증 증거 기록
테스트 결과를 실행 당시의 코드 상태와 연결한다.
커밋과 파일 지문, 실행 명령, 결과 코드를 함께 기록한다.
5단계 — 동시성 및 타임아웃 처리
여러 에이전트가 동시에 검증을 수행하기 시작했다면 결과 저장에 잠금을 적용한다.
빌드와 테스트가 끝나지 않는 상황도 처리한다.
6단계 — 프로젝트 메모리 정리
모든 대화 기록을 저장하지 않는다.
확정된 결정과 제약, 검증된 해결 방법, 미해결 질문만 구분해서 보관한다.
7단계 — 실제 사용량을 측정하고 줄이기
어떤 규칙이 자주 사용되는지 확인한다.
불필요한 문서와 중복 검증을 제거한다.
단순 질문에는 복잡한 Goal 절차를 적용하지 않는다.
좋은 AI 개발 환경은 모든 작업을 무겁게 만드는 환경이 아니라, 필요한 작업에만 필요한 절차를 적용하는 환경이다.
14. 실제로 피해야 할 설계
Moru의 원칙을 참고해 로컬 환경을 구성하면서 특히 주의할 부분도 있었다.
| 피해야 할 방식 | 문제가 되는 이유 |
|---|---|
| 모든 규칙을 하나의 긴 프롬프트에 저장 | 불필요한 컨텍스트 소비 |
| AI의 완료 보고만 신뢰 | 실제 검증 여부 확인 불가 |
| 코드 상태 없이 테스트 결과만 저장 | 오래된 테스트를 재사용할 위험 |
| 오래된 Claim 자동 삭제 | 진행 중인 작업과 충돌 가능 |
| 원자적 저장만으로 동시성 해결 | 상태 갱신 손실 가능 |
| 검증되지 않은 해결책을 공통 메모리로 등록 | 잘못된 가정 반복 |
| 모든 로그 원문을 장기 보관 | 보안과 컨텍스트 비용 증가 |
| Goal 통과를 배포 승인으로 처리 | 외부 시스템에 의도하지 않은 변경 |
| 모든 질문에 전체 검증 절차 실행 | 간단한 작업까지 느려짐 |
이 표에서 특히 중요한 항목은 두 가지다.
첫 번째는 상태 관리와 검증을 분리하는 것이다.
현재 작업이 어디까지 진행됐는지 아는 것과 실제로 올바르게 동작하는지 확인하는 것은 다르다.
두 번째는 실패 조건을 먼저 정하는 것이다.
AI가 실패한 작업을 무한히 재시도하지 않도록 해야 한다.
어떤 상황에서 멈추고 개발자에게 판단을 요청할지 명확해야 한다.
15. 아직 개선해야 할 부분도 남아 있다
현재 로컬 환경이 모든 문제를 해결한 것은 아니다.
오히려 실제로 여러 에이전트를 함께 사용하면서 추가로 필요한 기능이 보이기 시작했다.
대표적인 과제는 다음과 같다.
첫 번째는 메모리의 유효기간이다.
검증된 해결 방법도 프로젝트가 변경되면 더 이상 적용되지 않을 수 있다.
따라서 저장된 결정과 해결 방법을 언제 다시 검토해야 하는지 관리할 필요가 있다.
두 번째는 문서 검색 비용이다.
규칙 파일을 선택적으로 읽더라도 어떤 문서가 필요한지 찾는 작업 자체에 비용이 발생할 수 있다.
Moru Core가 Wikimap 같은 경량 인덱싱 도구를 활용하는 이유도 여기에 있다.
세 번째는 Goal의 수명주기다.
완료와 실패 외에도 중단, 폐기, 다른 작업으로 대체된 상태를 관리할 필요가 있다.
created

in_progress

blocked

verified

completed

abandoned

superseded
네 번째는 독립적인 검수 증거다.
특히 보안과 배포 관련 작업에서는 구현한 에이전트의 보고만으로 충분하지 않을 수 있다.
별도의 리뷰와 CI 결과를 완료 조건에 포함하는 것이 좋다.
다섯 번째는 실제 효율 측정이다.
규칙을 추가할수록 반드시 생산성이 좋아지는 것은 아니다.
작업 단계와 토큰 사용량, 재작업 횟수, 테스트 실행 시간을 측정해야 한다.
효과가 없는 규칙이라면 제거할 필요도 있다.
이런 과정은 한 번에 완성되는 작업이 아니다.
실제 실패가 발생한 부분부터 개선하고, 추가한 규칙도 테스트하면서 점진적으로 발전시켜야 한다.
마치며 — 더 좋은 프롬프트보다 중요한 것은 작업의 기준이다
Moru Core를 사용하며 얻은 가장 큰 교훈은 더 복잡한 프롬프트를 작성하는 방법이 아니었다.
AI 코딩 에이전트가 안정적으로 일하려면 세 가지가 필요하다는 점이다.
첫 번째는 작업 소유권이다.
누가 어떤 파일을 수정하고 있는지 알아야 한다.
여러 에이전트가 서로의 작업을 덮어쓰지 않도록 해야 한다.
두 번째는 완료 계약이다.
무엇을 완료로 인정할지 미리 정해야 한다.
테스트와 산출물, 제약 조건이 명확해야 한다.
세 번째는 실행 가능한 검증 증거다.
AI가 완료했다고 말하는 것만으로 충분하지 않다.
실제 실행한 테스트와 당시 코드 상태, 결과가 남아 있어야 한다.
Codex와 Claude Code는 서로 다른 도구다.
하지만 같은 프로젝트에서 작업한다면 같은 기준을 따라야 한다.
모델이 바뀌더라도 작업 소유권과 설계 결정, 제약 조건, 검증 증거, 사람의 승인 권한은 유지돼야 한다.
AI 코딩 도구의 성능이 좋아질수록 더 많은 파일을 더 빠르게 수정할 수 있다.
그럴수록 중요한 것은 코드를 작성하는 속도보다 변경된 코드가 정말 올바른지 확인하고, 다음 작업에서도 그 상태를 유지하는 능력이다.
결국 좋은 AI 개발 환경은 에이전트가 많은 환경이 아니다.
누가 작업하더라도 같은 기준으로 시작하고, 검증하고, 멈추고, 완료하는 환경이다.
참고자료
Moru Core — 공식 웹사이트
Moru Core의 목적과 기존 AI 코딩 도구에 공통 작업 규칙을 연결하는 접근을 설명한다.
Moru Core — How It Works
필요한 규칙만 읽는 방식, 검증 절차, 실행 기록, 에이전트 간 공통 작업 규칙을 설명하는 공식 페이지.
Moru Core — GitHub
Moru Core의 실제 구현, 설치 절차, Moru Hook, VibeGuard, Wikimap, 작업 규칙과 검증 절차를 확인할 수 있다.
Moru Core — 5개월 실사용 분석
26개 저장소에서 수집한 에이전트 작업 단계, 규칙 파일 읽기, 토큰 사용량 등의 변화를 정리한 자체 측정 자료.
OpenAI — Using Goals in Codex
Codex에서 장기 작업의 목표와 완료 조건, 검증 증거, 반복 정책, 중단 조건을 관리하는 방법을 설명한다.
OpenAI — AGENTS.md
Codex가 프로젝트별 작업 규칙을 읽고 적용하는 방법을 설명하는 공식 문서.
Anthropic — Claude Code Memory
Claude Code에서 CLAUDE.md와 프로젝트별 지침을 구성하고 관리하는 공식 문서.
Git — Git Worktree
여러 작업 디렉터리를 사용해 독립적인 브랜치 작업을 관리하는 공식 문서. 멀티 에이전트 환경에서 작업 공간을 분리하는 참고자료로 활용할 수 있다.
JSON Schema — 공식 문서
작업 계약과 검증 결과 JSON의 필수 필드, 타입, 허용 상태 등을 검사하기 위한 표준 문서.
Python — hashlib
SHA-256 등 해시 함수를 사용해 파일과 검증 결과의 지문을 계산하는 방법을 설명한다.
Python — subprocess
외부 명령 실행과 종료 코드, 타임아웃, 프로세스 관리 방법을 설명한다.