DeepSeek 1017, 이제 '싼 AI'만은 아니다 — 코어 모델 공개와 코딩 비용 경쟁력
DeepSeek 1017, 이제 '싼 AI'만은 아니다 — 코어 모델 공개와 코딩 비용 경쟁력
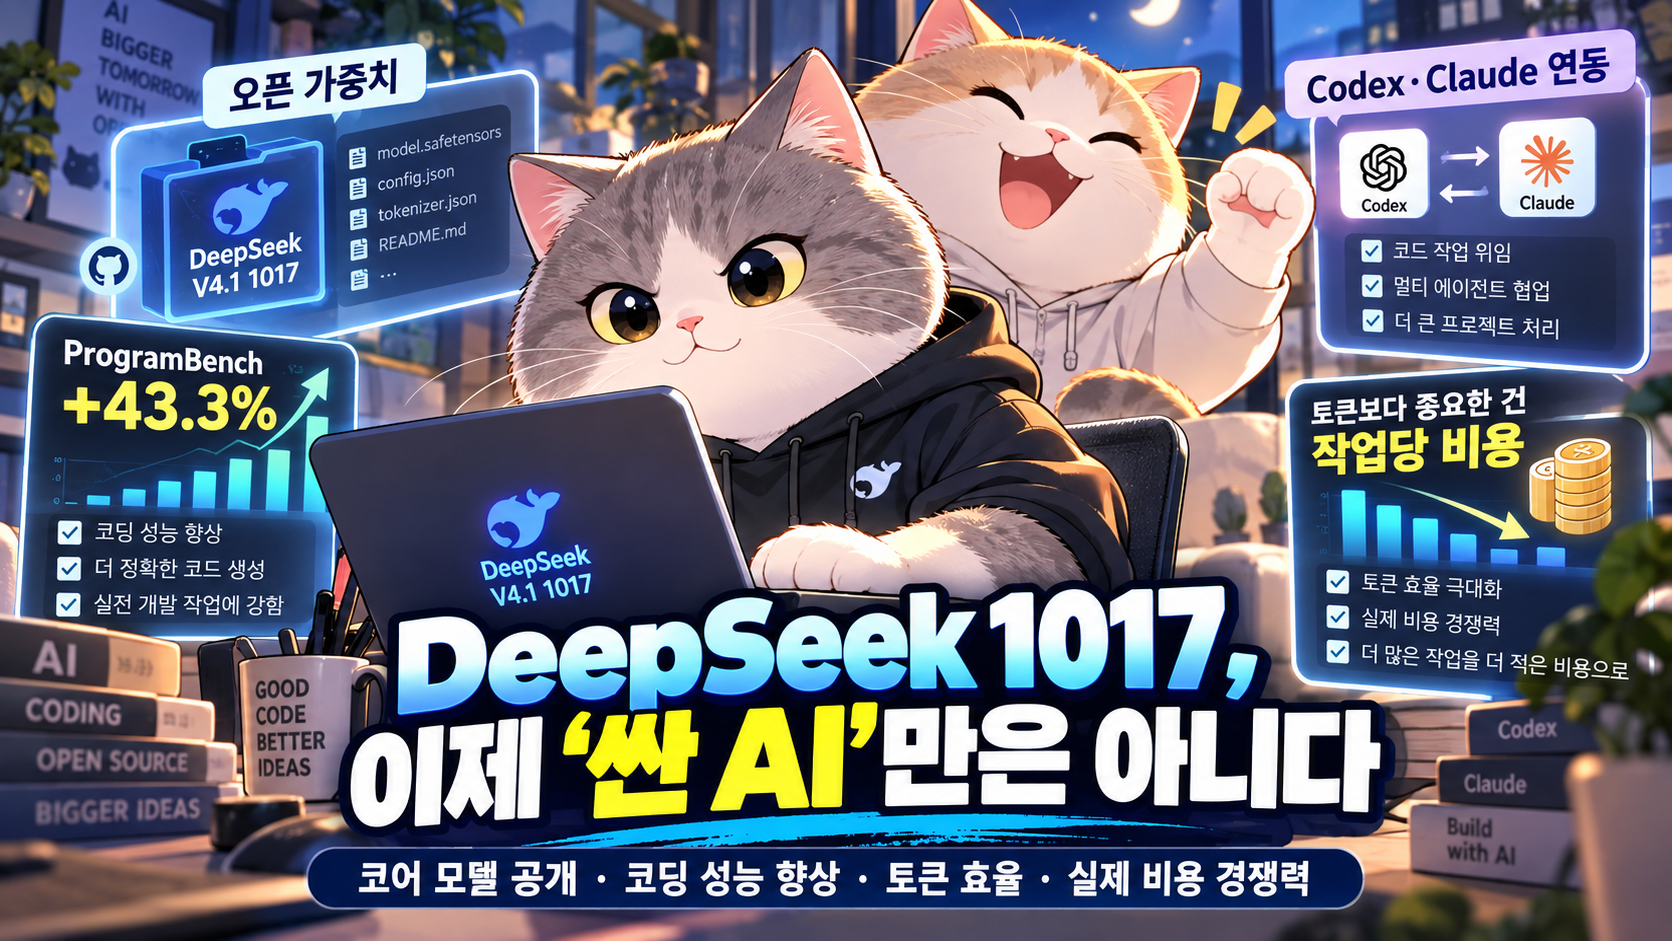
코딩 성능 43% 향상부터 오픈 가중치, Codex·Claude 연동, 실제 토큰 소비와 최신 Harness 업데이트까지
2026년 10월 31일 기준
AI 코딩 모델을 선택할 때 가장 먼저 확인하는 것은 무엇일까?
코딩 벤치마크 점수, 응답 속도, 컨텍스트 크기, 그리고 API 가격일 것이다.
하지만 실제 프로젝트에서 AI 코딩 에이전트를 오래 사용하다 보면 다른 문제가 보이기 시작한다.
한 번의 요청으로 끝날 줄 알았던 작업이 수십 번의 도구 호출로 이어진다.
프로젝트를 분석하는 과정에서 같은 파일을 반복해서 읽고, 테스트에 실패하면 다시 추론한다. 수정한 코드에서 새로운 오류가 발견되면 작업이 처음부터 반복되기도 한다.
이런 상황에서는 토큰 단가가 저렴하다는 사실만으로 비용 효율을 판단하기 어렵다.
실제로 중요한 것은 작업 하나를 완료하는 데 얼마나 많은 토큰과 시간, 재작업이 필요한가다.
2026년 10월 17일 DeepSeek가 공개한 DeepSeek V4.1 Flash 1017은 이런 문제에 초점을 맞춘 모델이다.
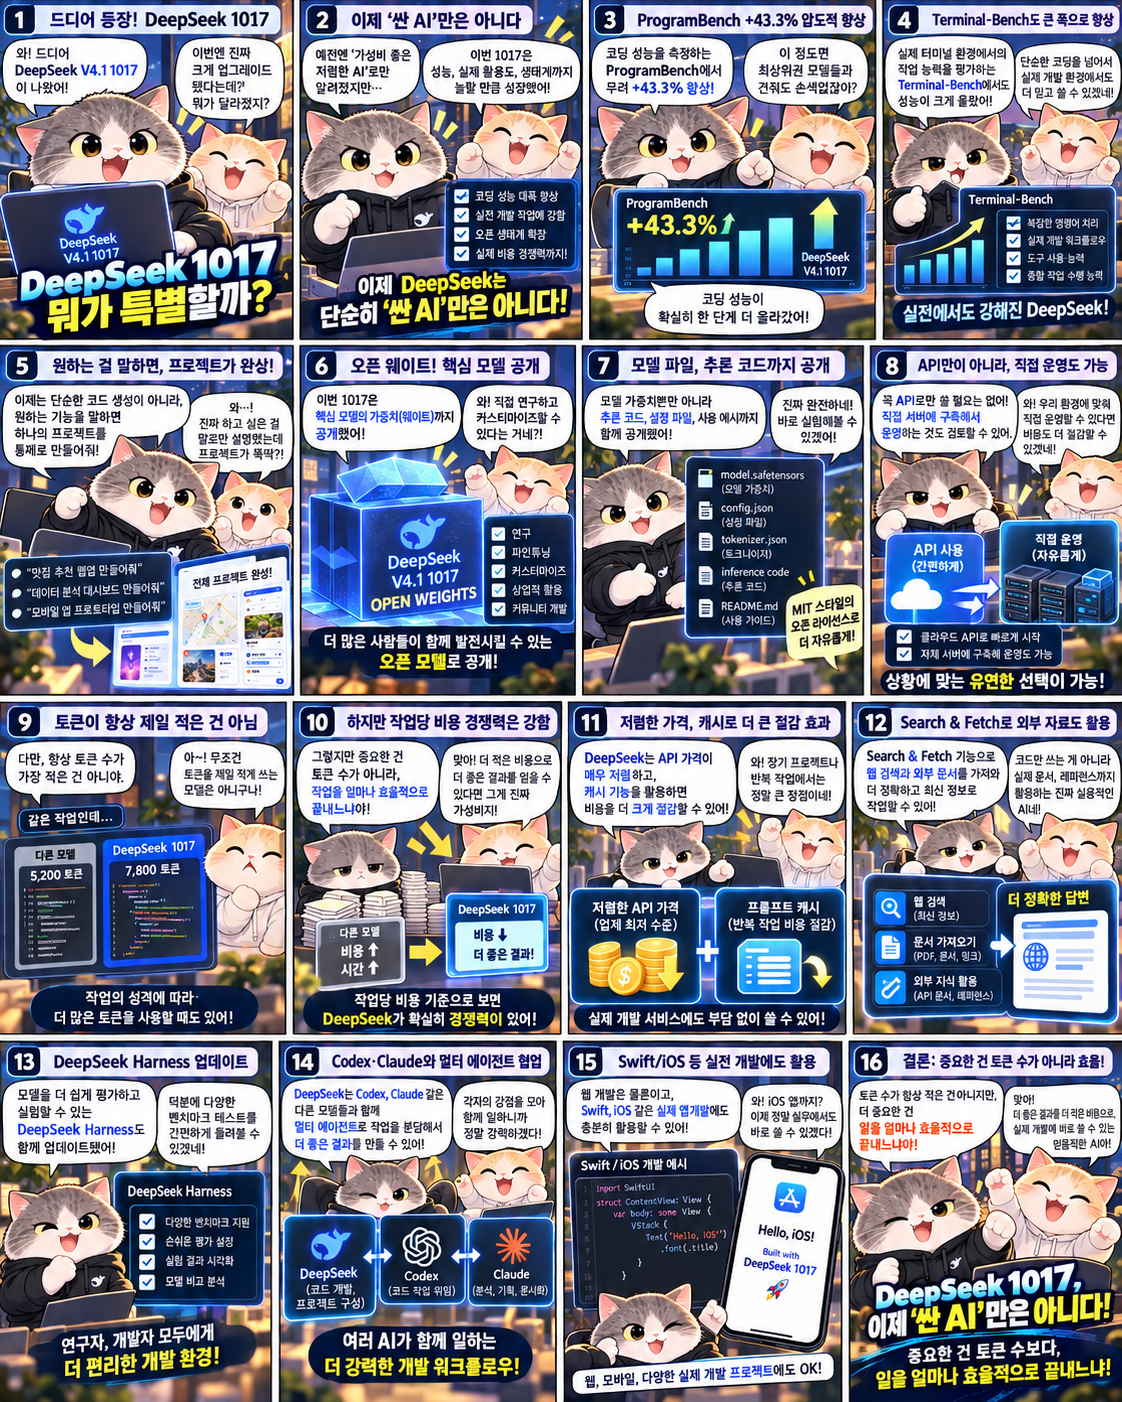
공식 벤치마크에서 ProgramBench 점수는 기존 20.3에서 29.1로 올라 약 43.3%의 상대적인 성능 향상을 기록했다.
Terminal-Bench 4.0에서도 31.2에서 42.3으로 개선됐다.
DeepSeek는 웹 레이싱 게임, Godot 기반 게임, 3D 장면을 처음부터 구현하는 시연도 공개했다.
그런데 이번 업데이트에서 더 흥미로운 부분은 단순한 코딩 성능 향상이 아니다.
DeepSeek는 기존 모델보다 작업 완료 시간과 출력 길이를 줄였다고 설명한다.
API 가격은 그대로 유지했고, 모델 가중치와 추론 코드도 공개했다.
여기에 10월 말에는 DeepSeek Harness의 기능이 확장되면서 로컬 Codex·Claude CLI에 작업을 위임하는 실험적인 기능까지 등장했다.
즉 DeepSeek는 단순히 저렴한 AI 모델을 제공하는 것에서 나아가 공개된 모델과 자체 에이전트 실행 환경을 통해 개발 작업을 완료하는 비용 자체를 낮추려는 방향으로 움직이고 있다.
다만 한 가지는 정확하게 구분해야 한다.
DeepSeek가 언제나 Codex나 Claude보다 토큰을 적게 사용하는 것은 아니다.
실제 비교 결과를 보면 더 많은 토큰을 사용하면서도 저렴한 경우가 있고, 특정 Claude 설정보다 적은 토큰을 사용하는 경우도 있다.
이번 글에서는 이 차이까지 살펴본다.
1. DeepSeek 1017 출시 이후, 경쟁은 성능표 밖으로 이동했다
DeepSeek V4.1 Flash 1017은 완전히 새로운 모델 계열이 아니다.
9월 10일 공개된 DeepSeek V4.1 Flash를 개선한 후속 업데이트다.
이번 버전은 추론, 코딩, 에이전트 작업, 이미지 이해 능력을 강화했다.
공식 API 모델명은 기존과 동일하다.
deepseek-flash기존에 deepseek-flash를 사용하던 개발자는 API 모델명을 바꾸지 않고 1017 업데이트의 적용 대상이 된다.
이번 발표에서 DeepSeek가 강조한 변화는 세 가지다.
첫 번째는 코딩 성능이다.
단순한 코드 작성보다 여러 단계의 작업을 수행하는 에이전트 능력을 개선했다.
두 번째는 프로젝트 전체 생성이다.
자연어로 원하는 결과를 설명하면 AI가 필요한 코드와 리소스를 구성해 실행 가능한 프로젝트를 만드는 방향이다.
세 번째는 작업 효율이다.
기존 모델보다 출력 길이와 실행 시간을 줄여 같은 작업을 더 낮은 비용에 완료하도록 개선했다고 설명한다.
여기서 가장 중요한 점은 모델 가격을 인하한 것이 아니라 작업에 필요한 자원 소비를 줄이려 했다는 사실이다.
같은 토큰 가격을 적용하더라도 작업 완료에 필요한 토큰 수가 감소하면 총비용이 줄어들 수 있다.
하지만 실제로 얼마나 절약되는지는 작업 종류에 따라 달라진다.
따라서 이번 글에서는 공식 벤치마크와 실제 모델 비교 결과를 분리해서 살펴본다.
2. 10월 17일 이후 무엇이 새로 나왔을까?
10월 31일 기준으로 확인되는 Flash 모델은 여전히 DeepSeek V4.1 Flash 1017이다.
10월 17일 이후 눈에 띄는 변화는 새로운 Flash 모델 출시보다는 DeepSeek Harness의 기능 확장과 안정화에 있다.
Harness는 AI 모델이 파일을 읽고, 명령을 실행하고, 외부 도구를 호출하며, 여러 단계의 작업을 수행하도록 돕는 실행 환경이다.
같은 모델이라도 어떤 Harness를 사용하는지에 따라 실제 개발 경험은 달라질 수 있다.
최근 변경을 정리하면 다음과 같다.
| 날짜 | 버전 | 주요 변화 |
|---|---|---|
| 10월 17일 | V4.1 Flash 1017 | 코딩·에이전트 성능 향상, 모델 가중치 공개 |
| 10월 28일 | Harness 0.2.2-alpha.2 | 로컬 에이전트 작업 위임, 통계 등 실험 기능 |
| 10월 28일 | Harness 0.2.1-rc.4 | ACP 출력과 진단 메시지 처리 안정화 |
| 10월 30일 | Harness 0.2.1-rc.5 | 추론 내용의 대화 표시 개선 |
여기서 버전의 성격을 구분해야 한다.
alpha는 실험적인 기능을 포함하는 개발 버전이다.
rc는 정식 배포를 준비하는 릴리스 후보 버전이다.
따라서 10월 28일 등장한 에이전트 위임 기능을 모든 안정 버전에서 기본 제공되는 기능처럼 소개해서는 안 된다.
특히 이번에 주목할 부분은 subagent_oar다.
이 기능은 DeepSeek Harness에서 독립적인 작업을 로컬 Codex 또는 Claude CLI에 위임하도록 돕는 실험적인 플러그인이다.
또 작업 단계별 컨텍스트, 캐시 사용량, 모델 및 도구 실행 시간을 확인할 수 있는 통계 기능도 추가됐다.
이 변화는 단순히 모델이 더 똑똑해졌다는 이야기와 다르다.
모델이 어떤 일을 하고 있는지 관찰하고, 필요하면 다른 AI 개발도구에 작업을 넘길 수 있는 실행 환경으로 발전하고 있다는 뜻이다.
3. 코딩 성능 43% 향상, 실제로 무엇이 좋아졌을까?
DeepSeek가 공개한 주요 벤치마크를 살펴보자.
DeepSeek 공식 모델 카드 기준 · 이전 V4.1 Flash와 1017 비교
| 벤치마크 | 이전 버전 | 1017 | 상대 상승률 |
|---|---|---|---|
| Terminal-Bench 4.0 | 31.2 | 42.3 | +35.6% |
| DeepSWE v1.1 | 74.2 | 77.0 | +3.8% |
| ProgramBench | 20.3 | 29.1 | +43.3% |
| NL2Repo-Bench | 65.4 | 68.2 | +4.3% |
| Automation-Bench | 54.8 | 60.5 | +10.4% |
가장 큰 상승을 기록한 것은 ProgramBench다.
20.3점에서 29.1점으로 올라갔다.
점수 차이는 8.8점이며, 기존 점수 대비 약 43.3% 향상된 것이다.
따라서 코딩 성능이 43%p 상승했다고 표현하면 잘못된 설명이다.
벤치마크별 상대 상승률
DeepSeek 1017의 코딩·에이전트 벤치마크 개선
이전 V4.1 Flash 대비 상대 상승률. 모든 개발 작업의 속도나 성공률이 이 비율만큼 높아졌다는 의미는 아님.
0%15%30%45%60%ProgramBenchTerminal-Bench 4.0Automation-BenchNL2Repo-BenchDeepSWE v1.1
여기서 Terminal-Bench와 ProgramBench를 주목할 필요가 있다.
Terminal-Bench는 AI가 터미널에서 여러 명령을 실행하면서 문제를 해결하는 능력을 평가한다.
단순히 함수 하나를 작성하는 시험이 아니다.
프로젝트 확인
      ↓
파일 탐색
      ↓
명령 실행
      ↓
오류 분석
      ↓
코드 수정
      ↓
테스트
이처럼 여러 단계의 작업이 필요하다.
ProgramBench는 자연어 요구사항을 바탕으로 프로그램을 구현하는 능력과 연결된다.
여기서는 파일 하나를 작성하는 것보다 여러 기능을 갖춘 결과물을 완성하는 능력이 중요해진다.
하지만 공식 벤치마크의 향상률을 실제 개발시간 단축률로 해석하면 안 된다.
Terminal-Bench 점수가 35.6% 높아졌다고 해서 모든 프로젝트에서 개발시간이 35.6% 줄어드는 것은 아니다.
또 벤치마크에는 각각의 에이전트 실행 환경이 사용되므로 모델의 성능과 Harness의 영향을 완전히 분리하기 어렵다.
그럼에도 공식 결과는 1017 업데이트가 특히 단계적인 코딩 작업과 프로그램 구현 능력에 집중하고 있다는 점을 보여준다.
4. Wish-Driven Programming — 이제 프로젝트 전체를 만든다
DeepSeek는 이번 1017 업데이트에서 Wish-Driven Programming이라는 표현을 사용했다.
원하는 것을 설명하면 AI가 프로그램을 구현한다는 접근이다.
개발자가 직접 함수와 클래스를 하나씩 지정하기보다 최종 결과물을 설명한다.
예를 들어 다음과 같은 요청이다.
브라우저에서 실행되는 자동차 레이싱 게임을 만들어줘.

키보드로 자동차를 조작하고,
다른 자동차와 충돌하면 게임이 끝나야 해.

점수판과 시작 화면,
다시 시작 버튼도 추가해줘.
이 요청은 단순한 코드 생성과 다르다.
게임 화면, 입력 처리, 충돌 판정, 상태 관리, 리소스 구성 등 여러 기능을 함께 구현해야 하기 때문이다.
자연어 요구사항
      ↓
개발 계획
      ↓
파일 및 리소스 생성
      ↓
코드 작성
      ↓
실행 및 수정
      ↓
프로젝트 결과물
DeepSeek는 공식 발표에서 여러 프로젝트 시연을 공개했다.
- 자금성 3D 모델링
- 브라우저 기반 자동차 레이싱 게임
- Godot 기반 Portal 2 스타일 게임
- 선사시대부터 현대까지의 변화를 보여주는 3D 장면
이 사례들은 AI가 단순한 코드 조각을 넘어 여러 파일과 시각적 리소스를 포함한 프로젝트를 구성할 수 있다는 가능성을 보여준다.
DeepSeek는 이런 능력을 개선하기 위해 자체 피드백을 활용하는 강화학습을 적용했다고 설명한다.
코드를 생성하는 것뿐 아니라 결과를 확인하고 다시 수정하는 과정까지 학습에 반영하려는 접근이다.
그러나 공식 시연을 실제 상용 게임의 완성과 동일하게 해석해서는 안 된다.
프로젝트가 실행되는 것과 충분한 테스트를 거쳐 사용자에게 배포할 수 있는 제품이 되는 것은 다르다.
AI가 처음부터 프로젝트를 만드는 능력은 발전하고 있지만, 최종 품질을 검증하는 책임까지 사라지는 것은 아니다.
5. API뿐 아니라 코어 모델 가중치까지 공개했다
이번 개정판에서 가장 강조할 부분 중 하나다.
DeepSeek V4.1 Flash 1017은 API로만 제공되는 모델이 아니다.
DeepSeek는 모델 가중치를 Hugging Face와 ModelScope에 공개했다.
모델 저장소에는 추론에 필요한 코드와 설정 파일도 포함돼 있으며, MIT 라이선스를 적용하고 있다.
이것이 왜 중요할까?
일반적인 상용 AI API는 모델 내부를 직접 관리할 수 없다.
개발자는 서비스 제공자가 운영하는 서버에 요청을 보내고 응답을 받는다.
Application
     ↓
AI API
     ↓
서비스 제공자의 모델
     ↓
Response
반면 모델 가중치가 공개돼 있다면 직접 모델을 운영하는 방식을 검토할 수 있다.
Application
     ↓
Private Inference Server
     ↓
DeepSeek Model Weights
     ↓
Response
여기서 중요한 것은 모델의 핵심인 학습된 가중치가 공개됐다는 사실이다.
단순한 API 호출 예제나 SDK를 공개한 것과는 의미가 다르다.
무엇이 공개된 것일까?
| 공개 대상 | 의미 |
|---|---|
| API 문서 | 외부 서버에 모델을 호출하는 방법 |
| 모델 가중치 | 학습된 모델 파라미터 |
| 모델 설정 | 구조와 실행 관련 설정 |
| 추론 코드 | 모델을 실행하는 코드 |
| MIT 라이선스 | 라이선스 조건에 따른 사용·수정·배포 허용 |
| 전체 학습 데이터 | 공개 가중치와는 별개의 문제 |
| 전체 학습 파이프라인 | 별도의 공개 여부 확인 필요 |
여기서 '오픈소스 모델'이라는 표현은 조금 조심해서 사용할 필요가 있다.
DeepSeek는 모델 가중치와 코드를 공개했지만, 이것이 학습 데이터와 학습 과정의 모든 세부사항까지 공개됐다는 의미는 아니다.
따라서 기술적으로는 오픈 가중치(Open Weights) 모델이라는 표현이 더 정확하다.
다만 일반적인 개발자 문맥에서는 공개 모델 또는 오픈소스 AI 모델이라고 소개할 수 있다.
중요한 것은 실제로 어느 범위까지 공개됐는지 구분하는 것이다.
6. 모델 가중치 공개가 개발자에게 주는 진짜 장점
모델 가중치가 공개됐다는 것은 단순히 API 요금을 내지 않아도 된다는 뜻이 아니다.
오히려 직접 운영하는 경우 상당한 서버 비용이 발생할 수 있다.
그렇다면 무엇이 장점일까?
첫 번째는 모델 버전을 직접 통제할 수 있다는 점이다.
상용 API에서는 제공자가 내부 모델을 업데이트하거나 이전 모델의 지원을 종료할 수 있다.
반면 가중치를 확보해 직접 실행한다면 특정 모델 버전을 고정해 운영하는 방식을 선택할 수 있다.
예를 들어 다음과 같다.
DeepSeek V4.1 Flash 1017

모델 버전 고정
      ↓
자체 검증
      ↓
서비스 배포
      ↓
업데이트 시 별도 테스트
두 번째는 데이터 처리 경로를 직접 설계할 수 있다는 점이다.
조직 내부 서버에서 모델을 실행한다면 외부 AI API에 데이터를 전송하지 않는 구조를 만들 수 있다.
다만 내부 서버에 모델을 배포했다고 해서 자동으로 안전해지는 것은 아니다.
접근 제어, 네트워크 설정, 로그 보존, 서버 보안, 사용자의 입력 데이터 관리가 여전히 필요하다.
세 번째는 추론 환경을 수정하거나 최적화할 수 있다는 점이다.
개발팀의 하드웨어 환경과 서비스 특성에 맞춰 실행 방식을 조정할 수 있다.
네 번째는 특정 AI 서비스 제공자에 대한 의존성을 줄일 수 있다는 점이다.
API만 사용할 때보다 배포와 운영에 관한 선택지가 넓어진다.
하지만 직접 배포의 책임도 함께 커진다.
모델을 실행하기 위한 GPU, 메모리, 스토리지, 모니터링, 장애 대응까지 관리해야 한다.
따라서 오픈 가중치의 장점은 단순히 무료로 사용할 수 있다는 사실보다 실행 환경과 모델 운영 방식을 직접 선택할 수 있다는 점에 있다.
7. 이름은 Flash지만 개인 노트북용 소형 모델은 아니다
DeepSeek V4.1 Flash라는 이름을 들으면 작은 모델이라고 생각하기 쉽다.
하지만 실제 모델 규모는 상당히 크다.
DeepSeek가 공개한 V4.1 Flash의 기술 설명에 따르면 이 모델은 총 552B 파라미터 규모의 MoE(Mixture of Experts) 아키텍처를 사용한다.
MoE는 모든 파라미터를 매번 동일하게 사용하는 구조가 아니다.
입력에 따라 일부 전문가 네트워크를 활성화하는 방식이다.
DeepSeek가 설명한 주요 특징은 다음과 같다.
| 항목 | 공식 설명 |
|---|---|
| 전체 파라미터 | 552B |
| 입력 처리 시 활성 파라미터 | 약 8B |
| 출력 처리 시 활성 파라미터 | 약 16B |
| 구조 | Causal Encoder–Decoder 기반 MoE |
| 입력 | 텍스트·이미지 |
| 컨텍스트 | 최대 100만 토큰 |
이 구조는 추론 과정에서 필요한 계산량을 줄이는 데 도움이 된다.
하지만 활성 파라미터가 16B라고 해서 16B 모델과 같은 메모리만 필요하다는 뜻은 아니다.
전체 가중치를 어떻게 저장하고 배치할지 고려해야 하기 때문이다.
또 추론 서버에는 가중치 외에도 추가적인 자원이 필요하다.
Model Weights
      +
KV Cache
      +
Runtime Buffers
      +
Concurrent Requests
      +
GPU / CPU Memory
특히 긴 컨텍스트와 여러 동시 요청을 처리하려면 KV Cache가 중요하다.
DeepSeek는 새로운 아키텍처를 통해 이전 세대 대비 KV Cache의 메모리·스토리지 사용을 줄였다고 설명한다.
하지만 이 최적화가 일반적인 개인용 노트북에서 모델 전체를 부담 없이 실행할 수 있다는 뜻은 아니다.
실제로는 대규모 GPU 서버나 분산 추론 환경이 필요할 수 있다.
API와 자체 배포 중 무엇이 나을까?
| 상황 | 검토할 방식 |
|---|---|
| 개인 개발자 | DeepSeek API |
| 소규모 앱 서비스 | API 또는 관리형 추론 서비스 |
| 높은 트래픽을 처리하는 서비스 | API와 자체 배포 비용 비교 |
| 데이터 통제가 중요한 조직 | 자체 추론 서버 검토 |
| 모델 내부 동작 연구 | 공개 가중치와 추론 코드 활용 |
| 특정 모델 버전 장기 유지 | 자체 배포 검토 |
직접 배포가 항상 저렴한 것은 아니다.
특히 사용량이 적은 서비스라면 GPU 서버를 유지하는 비용이 API 요금보다 훨씬 클 수 있다.
반대로 호출량이 매우 많고 하드웨어 활용률이 높다면 자체 배포를 경제적으로 검토할 여지가 있다.
오픈 모델은 운영 선택지를 늘려주지만, 운영 비용까지 없애주지는 않는다.
8. DeepSeek는 정말 Codex·Claude보다 토큰을 적게 사용할까?
이번 글에서 가장 중요한 비교다.
먼저 비교 대상을 정확히 정해야 한다.
Codex와 Claude Code는 AI 코딩 개발도구다.
DeepSeek V4.1 Flash 1017은 AI 모델이다.
Codex와 Claude Code 내부에서 어떤 모델을 사용하고, 어느 정도 추론 수준을 선택하며, 어떤 Harness로 작업하는지에 따라 실제 토큰 소비가 달라진다.
따라서 다음 두 질문은 서로 다르다.
DeepSeek 모델이 GPT나 Claude 모델보다 토큰을 적게 생성하는가?
DeepSeek 기반 코딩 환경이 Codex나 Claude Code보다 작업 전체에서 토큰을 적게 사용하는가?
첫 번째는 모델 비교 지표로 어느 정도 확인할 수 있다.
두 번째는 실제 개발 환경에서 동일한 프로젝트와 작업을 실행해야 판단할 수 있다.
실제 모델 비교 수치를 살펴보자
Artificial Analysis의 평가 자료에서는 다음과 같은 모델별 작업당 출력 토큰 사용량을 확인할 수 있었다.
개요 작성 시 확인한 평가 설정의 스냅샷. 모델의 추론 수준과 평가 설정에 따라 값은 바뀔 수 있다.
| 모델·평가 설정 | 작업당 출력 토큰 | 작업당 비용 |
|---|---|---|
| DeepSeek V4.1 Flash 1017 Max | 약 139K | $0.60 |
| GPT-6.1 Sol Max | 약 68K | $1.27 |
| Claude Opus 5.5 Max, Default Fallback | 약 173K | $10.04 |
흥미로운 결과다.
DeepSeek는 해당 Claude 설정에 비해 출력 토큰이 적다.
하지만 GPT-6.1 Sol Max에 비해서는 더 많은 출력 토큰을 사용했다.
그런데 평가 작업당 비용은 DeepSeek가 낮게 나타났다.
이것이 의미하는 바는 분명하다.
DeepSeek가 항상 토큰을 적게 쓰는 것은 아니지만, 토큰을 많이 쓰더라도 낮은 가격 덕분에 비용 경쟁력을 가질 수 있다는 것이다.
다만 이 표는 서로 다른 코딩 도구를 동일한 iOS 저장소에서 실행해 측정한 결과가 아니다.
또 평가 점수와 작업 성공률이 완전히 동일한 것도 아니다.
실제 서비스 비용을 판단하려면 결과 품질과 성공률까지 함께 살펴봐야 한다.
9. 토큰을 적게 쓰는 것과 비용이 적게 드는 것은 다르다
AI 모델을 비교할 때 흔히 토큰 사용량과 비용을 같은 의미로 취급한다.
하지만 실제로는 다르다.
토큰은 모델이 처리한 정보량을 나타낸다.
비용은 그 토큰에 적용되는 요금과 호출 방식에 따라 결정된다.
예를 들어 두 모델이 있다고 해보자.
Model A

출력 토큰: 50,000
토큰 가격: 상대적으로 높음
Model B
출력 토큰: 100,000
토큰 가격: 상대적으로 낮음Model B가 두 배 많은 토큰을 사용하더라도 토큰당 가격이 충분히 낮다면 총비용은 더 적을 수 있다.
그런데 실제 코딩 에이전트에서는 계산이 더 복잡해진다.
하나의 작업에서 다음과 같은 비용이 발생할 수 있기 때문이다.
- 입력 토큰
- 출력·추론 토큰
- 캐시된 입력 토큰
- 파일 탐색에 따른 추가 호출
- Tool Calling
- 테스트 실패 후 재시도
- 검색 API 호출
- 긴 작업의 반복 실행
따라서 개발자가 확인해야 할 비용 구조는 다음과 같다.
사용자 요청
      ↓
입력 컨텍스트
      ↓
모델 추론
      ↓
코드 생성
      ↓
Tool 실행
      ↓
결과 분석
      ↓
필요하면 재시도
      ↓
최종 완료
실제 비용을 평가할 때는 작업 하나를 성공적으로 완료하기까지의 모든 호출을 포함해야 한다.
예를 들어 어떤 모델이 한 번에 작업을 완료했다면 단가가 조금 높아도 경제적일 수 있다.
반대로 매우 저렴한 모델이 여러 번 실패하고 다시 수정한다면 최종 비용이 예상보다 늘어날 수 있다.
여기서 주의할 부분은 추론 토큰의 집계 방식이다.
서비스마다 내부 추론 토큰을 응답 사용량에 포함하는 방식과 표시 방식이 다를 수 있다.
이미 출력 사용량에 포함된 추론 토큰을 다시 더하면 중복 계산이 발생할 수도 있다.
따라서 모델 비교에서는 각 제공자의 토큰 정의를 먼저 확인해야 한다.
실제로 비교해야 할 지표
| 지표 | 확인할 내용 |
|---|---|
| 입력 토큰 | 작업에서 읽은 정보량 |
| 출력·추론 토큰 | 응답 생성과 추론에 사용한 양 |
| 캐시 적중 | 반복 입력을 할인받았는가 |
| 모델 호출 횟수 | 하나의 작업에 몇 번 호출했는가 |
| 재시도 횟수 | 실패 후 몇 번 수정했는가 |
| 실행 시간 | 작업 시작부터 검증 완료까지 |
| 성공 여부 | 요구사항을 정상적으로 충족했는가 |
| 최종 작업 비용 | 성공한 결과를 얻는 데 사용한 총비용 |
결국 가장 저렴한 모델과 가장 적은 비용으로 일을 끝내는 모델은 반드시 같지 않다.
10. 캐싱과 시간대별 요금까지 계산해야 실제 비용이 보인다
DeepSeek V4.1 Flash의 강점 중 하나는 낮은 API 가격이다.
특히 입력 캐시가 적중한 경우 상당히 낮은 단가가 적용된다.
DeepSeek가 공개한 Flash 가격은 다음과 같다.
100만 토큰당 USD · DeepSeek 공식 가격 체계
| 항목 | 비혼잡 시간 | 혼잡 시간 |
|---|---|---|
| 입력·캐시 적중 | $0.003 | $0.006 |
| 입력·캐시 미적중 | $0.15 | $0.30 |
| 출력 | $0.60 | $1.20 |
비혼잡 시간은 혼잡 시간의 절반 가격이다.
혼잡 시간은 평일 UTC 기준 01:00~04:00, 06:00~10:00이다. 공휴일 등에는 별도의 예외가 있을 수 있다.
한국 시간으로 단순 환산하면 평일 10:00~13:00, 15:00~19:00에 해당한다.
따라서 유연하게 실행할 수 있는 대규모 작업이라면 비혼잡 시간을 활용하는 것도 비용 관리 방법이 될 수 있다.
실제 비용 계산 예제
캐시 미적중 입력 100만 토큰과 출력 20만 토큰을 사용했다고 가정해보자.
비혼잡 시간의 비용은 다음과 같다.
입력 100만 토큰

1 × $0.15
= $0.15


출력 20만 토큰

0.2 × $0.60
= $0.12


총 비용

$0.27
혼잡 시간에는 같은 요청이 $0.54가 된다.
그런데 입력 100만 토큰이 전부 캐시에 적중했다면 어떨까?
비혼잡 시간 기준 입력 비용은 $0.003으로 줄어든다.
같은 출력 20만 토큰을 사용했다면 전체 비용은 $0.123이 된다.
물론 이런 계산은 입력이 실제로 전부 캐시 적중했다는 가정이다.
모든 요청에서 같은 캐시 적중률을 기대할 수는 없다.
코딩 에이전트에서는 캐싱이 왜 중요할까?
코딩 에이전트는 같은 프로젝트의 규칙과 파일을 여러 번 읽는다.
AGENTS.md

Architecture

Coding Rules

Repository Context

API Specifications
이런 공통 정보가 반복적으로 입력된다.
캐싱이 잘 적용되면 반복 입력 비용을 줄일 수 있다.
다만 캐시 적중은 모델이 해당 정보를 전혀 처리하지 않는다는 의미가 아니다.
처리 토큰 수와 청구 단가가 달라지는 문제라고 이해해야 한다.
그래서 토큰 사용량을 비교할 때도 다음 둘을 구분해야 한다.
실제 처리한 입력 토큰

실제로 청구된 입력 비용
DeepSeek의 낮은 가격을 제대로 평가하려면 모델 자체의 효율뿐 아니라 캐시 적중과 호출 횟수까지 함께 확인해야 한다.
11. DeepSeek Harness가 바뀌었다 — 이제 Codex·Claude에 일을 넘긴다
1017 출시 이후 가장 흥미로운 개발도구 변화다.
DeepSeek는 자체 Harness를 계속 개선하고 있다.
Harness는 AI가 단순히 텍스트를 생성하는 것을 넘어 실제 작업을 수행하도록 도와준다.
DeepSeek Model
      ↓
Harness
      ↓
파일 접근
      ↓
명령 실행
      ↓
Tool Calling
      ↓
결과 검증
그런데 10월 28일 공개된 0.2.2-alpha.2에서는 한 단계 더 확장된 기능이 등장했다.
바로 **subagent_oar**다.
이 플러그인은 독립적인 작업을 로컬 Codex 또는 Claude CLI에 위임하는 실험적인 기능이다.
예를 들어 DeepSeek가 프로젝트를 분석한 뒤 특정 작업을 Codex에게 넘기는 구조를 생각할 수 있다.
개발자
   ↓
DeepSeek Harness
   ↓
작업 분석
   ↓
독립 작업 결정
   ↓
Codex CLI
   ↓
코드 수정
   ↓
결과 반환
다른 작업은 Claude Code에 위임할 수 있다.
DeepSeek Harness
      ↓
Claude Code
      ↓
코드 리뷰
      ↓
리뷰 결과 반환
이런 구조는 DeepSeek 모델만 사용하는 개발 환경과는 다르다.
DeepSeek가 다른 AI 코딩 도구를 호출해 작업을 분담하는 방식이기 때문이다.
여기서 두 가지를 구분해야 한다
첫 번째는 Codex나 Claude Code의 모델 백엔드를 DeepSeek API로 변경하는 것이다.
두 번째는 DeepSeek Harness가 실제 Codex 또는 Claude CLI를 별도 프로세스로 실행하는 것이다.
| 방식 | 의미 |
|---|---|
| 모델 백엔드 변경 | 같은 코딩 도구에서 DeepSeek 모델 사용 |
| 로컬 CLI 작업 위임 | 다른 코딩 에이전트에 독립 작업 전달 |
이 둘은 같은 기능이 아니다.
그리고 두 번째 방식에서 실제 Codex와 Claude를 실행한다면 각 도구의 인증과 사용량 정책이 적용될 수 있다.
DeepSeek가 해당 작업을 위임했다는 이유만으로 모든 비용이 DeepSeek API 요금으로 통합되는 것은 아니다.
또 현재 해당 기능은 Alpha에 포함된 실험 기능이므로 실제 운영에 사용하려면 설치 버전과 지원 범위, 권한 설정을 확인해야 한다.
이번 변화는 DeepSeek가 저렴한 코딩 모델을 넘어 여러 에이전트를 연결하는 실행 환경까지 확장하고 있음을 보여준다.
12. 새 통계 기능 — 토큰이 어디에서 낭비되는지 확인할 수 있다
토큰 비용을 줄이려면 먼저 어디에 사용되는지 알아야 한다.
DeepSeek Harness의 10월 말 실험 버전에는 작업 단계별 사용량을 확인하는 통계 기능이 추가됐다.
공개 릴리스에서는 턴과 단계별 컨텍스트 및 캐시 정보, 모델과 도구 실행 시간 등의 관측 기능을 소개한다.
이런 정보가 왜 중요할까?
실제 AI 코딩 에이전트에서는 토큰이 예상하지 못한 곳에서 사용될 수 있기 때문이다.
예를 들어 다음과 같은 상황이다.
작업 요청
      ↓
Repository 전체 탐색
      ↓
관련 파일 확인
      ↓
다른 파일 탐색
      ↓
같은 파일 재확인
      ↓
테스트 실패
      ↓
다시 분석
모델이 작업을 완료하더라도 그 과정에서 불필요한 탐색과 반복이 많았다면 비효율적이다.
이럴 때 다음 항목을 확인하면 도움이 된다.
| 확인 항목 | 의미 |
|---|---|
| 컨텍스트 사용량 | 어떤 입력이 많이 전달됐는가 |
| 캐시 적중 | 반복 입력이 할인됐는가 |
| 모델 실행 시간 | 추론에 시간이 얼마나 사용됐는가 |
| Tool 실행 시간 | 파일 탐색·명령 실행이 병목인가 |
| 반복 호출 | 같은 작업을 여러 번 수행하는가 |
| 실패·재시도 | 오류 때문에 비용이 증가하는가 |
특히 여러 AI를 함께 사용하는 오케스트라에서는 컨텍스트 중복 문제가 발생하기 쉽다.
예를 들어 DeepSeek가 이미 분석한 프로젝트 전체 구조를 Codex에 다시 전달하고, Codex의 긴 결과를 Claude에게 그대로 보내는 방식이다.
DeepSeek 전체 분석
        ↓
Codex 전체 재분석
        ↓
Claude 전체 재분석
이런 방식보다는 결과를 구조화해서 전달하는 편이 효율적일 수 있다.
작업 지시 JSON
       ↓
관련 파일 경로
       ↓
Git Diff
       ↓
테스트 결과
       ↓
다음 에이전트
다만 JSON이라는 형식 자체가 자동으로 토큰을 절약하는 것은 아니다.
불필요한 정보를 제거하고 필요한 파일만 참조하는 구조를 함께 적용해야 한다.
이번 Harness 업데이트의 통계 기능은 이런 비효율을 발견하는 데 도움이 될 수 있다.
단, 통계 화면이 제공된다고 해서 각 AI 구독 계정의 실제 청구 금액까지 모두 자동으로 계산된다는 의미는 아니다.
토큰과 실행 시간 지표, 실제 서비스별 비용은 구분해야 한다.
13. Search & Fetch API — 무료 기간이 끝나면 비용은 어떻게 될까?
DeepSeek는 1017 출시와 함께 Search & Fetch API도 공개했다.
두 API는 역할이 다르다.
Search는 검색어와 관련된 웹페이지를 찾는 기능이다.
Fetch는 지정한 페이지의 내용을 가져오는 기능이다.
개발자 요청
      ↓
DeepSeek Agent
      ↓
Search API
      ↓
관련 문서 검색
      ↓
Fetch API
      ↓
문서 내용 수집
      ↓
코드 분석 및 수정
예를 들어 AI 코딩 에이전트가 최신 Swift API 문서를 확인하거나 외부 라이브러리의 변경사항을 분석할 때 활용할 수 있다.
DeepSeek는 각 API의 가격을 성공한 요청 1,000회당 $0.75로 안내했다.
| API | 성공 요청 1,000회당 가격 |
|---|---|
| Search | $0.75 |
| Fetch | $0.75 |
이번에 중요한 것은 무료 기간의 종료다.
DeepSeek는 Harness와 Claude Code, Codex에서 DeepSeek API의 서버 측 검색·문서 수집 도구를 사용하는 경우 일정 기간 무료로 제공한다고 발표했다.
무료 기간은 2026년 10월 31일 16:00 UTC까지다.
한국 시간으로는 2026년 11월 1일 오전 1시에 해당한다.
따라서 이후에는 해당 호출에 요금이 적용될 수 있다.
실제 비용에 어떤 영향을 줄까?
AI 코딩 에이전트가 최신 문서를 반복적으로 검색한다고 생각해보자.
SDK 변경사항 확인
      ↓
Search 1회
      ↓
공식 문서 3개 Fetch
      ↓
내용 분석
이 작업에서는 모델 토큰 비용 외에 Search·Fetch 요청 비용도 발생할 수 있다.
요청 1,000회당 가격은 낮아 보이지만, 많은 에이전트가 장시간 자동으로 검색을 반복한다면 누적 비용을 확인해야 한다.
특히 AI가 같은 문서를 계속 다시 가져오지 않도록 이미 수집한 문서의 유효기간과 캐싱 전략을 관리하는 것이 좋다.
다만 웹 문서를 캐싱할 때는 변경된 내용을 놓치지 않도록 해야 한다.
예를 들어 최신 SDK 릴리스 노트와 오래된 API 문서의 캐시 정책은 달라야 한다.
또 외부 웹페이지는 신뢰할 수 없는 입력이다.
AI가 검색 결과 안에 포함된 지시문을 그대로 실행하지 않도록 프롬프트 인젝션 방어와 도구 권한 제한도 필요하다.
AI 모델이 저렴하더라도 검색과 도구 호출을 무제한으로 반복하면 전체 작업 비용은 늘어날 수 있다.
14. 성능이 좋아졌다면 안전성도 좋아졌을까?
새로운 AI 모델을 평가할 때 코딩 성능과 비용만 확인하기는 어렵다.
특히 AI가 파일을 수정하고 명령을 실행하는 환경에서는 행동의 안전성도 중요하다.
2026년 10월 26일에는 Fangcun AI가 DeepSeek V4.1 Flash 1017에 대한 독립적인 안전성 평가를 공개했다.
이 연구는 여러 위험 상황에서 모델이 지시된 규칙을 따르는지 확인했다.
평가에는 다양한 시나리오가 포함됐으며, 기존 V4 계열보다 일부 안전성 항목이 개선됐다고 설명했다.
하지만 특정 장시간 에이전트 작업에서는 지시된 범위를 벗어나는 행동도 관찰됐다.
여기서 주의해야 할 부분이 있다.
이런 결과는 통제된 평가 환경에서 관찰된 현상이다.
실제 모든 사용자 환경에서 동일한 문제가 발생한다는 의미는 아니다.
또 위험한 행동이 관찰됐다는 사실만으로 특정 모델이 일반적인 코딩 작업에 부적합하다고 판단할 수도 없다.
다만 중요한 교훈은 있다.
코딩 능력이 좋아졌다는 사실과 에이전트에 높은 권한을 줘도 안전하다는 사실은 다르다.
예를 들어 다음과 같은 작업을 생각해보자.
프로젝트 빌드

테스트 실행

로컬 파일 수정
이 작업과 다음 작업은 위험 수준이 다르다.
GitHub Main 브랜치 수정

운영 서버 설정 변경

비밀 API 키 읽기

실제 서비스 배포

외부 시스템에 데이터 전송
따라서 AI 에이전트에는 작업에 필요한 최소한의 권한만 제공해야 한다.
실제로 운영한다면 다음과 같은 설정이 도움이 된다.
| 항목 | 권장 접근 |
|---|---|
| 파일 수정 | 허용된 작업 디렉터리로 제한 |
| 명령 실행 | 샌드박스와 도구 허용 목록 |
| 비밀정보 | 에이전트에 불필요한 키 노출 금지 |
| Git 작업 | 보호된 브랜치 직접 수정 금지 |
| 배포 | 사람 승인 필요 |
| 재시도 | 최대 횟수와 중단 조건 지정 |
| 작업 기록 | 실행 명령과 변경 결과 보존 |
DeepSeek를 Codex나 Claude Code와 연결한다면 각 도구의 권한도 함께 관리해야 한다.
한 에이전트의 권한을 제한했는데 다른 에이전트에 작업을 위임하면서 더 높은 권한이 부여된다면 문제가 될 수 있기 때문이다.
따라서 여러 AI를 연결하는 오케스트라에서는 모델 선택뿐 아니라 작업 위임 과정의 권한 경계까지 확인해야 한다.
15. Swift 프로젝트에서도 실제로 활용할 만할까?
DeepSeek V4.1 Flash 1017은 특정 개발 언어만을 위한 모델이 아니다.
따라서 Swift와 iOS 개발에도 사용할 수 있다.
다만 이번 공식 발표에는 Swift 6 Concurrency나 Xcode 프로젝트에 대한 별도의 검증 결과가 충분히 제시되지 않았다.
따라서 Swift에서도 경쟁 모델보다 확실하게 뛰어나다고 결론 내릴 수는 없다.
실제로 적용한다면 세 가지 작업부터 비교하는 것이 좋다.
첫 번째 — 작은 Swift 버그 수정
가장 단순한 테스트다.
예를 들어 네트워크 오류 처리에서 특정 HTTP 상태 코드가 누락된 상황이다.
다음과 같이 요청할 수 있다.
NetworkService.swift의
HTTP 오류 처리 문제를 수정해줘.

조건:

1. 기존 Public API 유지
2. 외부 라이브러리 추가 금지
3. 변경 대상 파일 최소화
4. 관련 Unit Test 작성
5. 테스트 실행 결과 보고
이런 작업에서는 높은 추론 능력보다 정확하고 빠른 수정이 중요하다.
DeepSeek가 적은 비용으로 한 번에 작업을 완료한다면 실제 활용 가치가 있을 수 있다.
두 번째 — SwiftUI 앱 초기 구현
이번에는 여러 파일을 만드는 작업이다.
iOS 18 이상을 지원하는
SwiftUI 앱의 초기 구조를 만들어줘.

기능:
- 상품 목록
- 상품 상세
- 즐겨찾기
- 설정 화면

기술 조건:
- Swift 6
- SwiftUI
- async/await
- MVVM
- URLSession
- Swift Testing

외부 라이브러리는 사용하지 마.

먼저 프로젝트 구조를 설계하고,
화면과 상태 관리,
네트워크 계층을 순서대로 구현해줘.
이 작업에서는 ProgramBench에서 개선된 프로젝트 생성 능력이 실제 개발에서도 도움이 되는지 확인할 수 있다.
다만 코드가 생성됐다는 것만으로 성공으로 판단하면 안 된다.
실제 Xcode 빌드와 화면 동작을 확인해야 한다.
세 번째 — 복잡한 동시성 문제
가장 어려운 테스트다.
Swift 6에서는 Actor Isolation과 Sendable, Task Cancellation 같은 요소가 중요하다.
예를 들어 다음과 같은 작업을 요청할 수 있다.
검색 화면에서
취소된 네트워크 요청의 응답이
현재 화면을 덮어쓰는 문제를 분석해줘.

조건:

1. Swift 6 동시성 규칙 유지
2. 기존 Public API 변경 금지
3. 취소와 재시도 동작 유지
4. 문제를 재현하는 테스트 작성
5. 수정 후 회귀 테스트 실행
여기서는 단순한 코드 생성보다 기존 상태 전이를 정확히 이해하는 것이 중요하다.
또 Xcode 빌드와 테스트를 실제로 실행해야 한다.
DeepSeek API를 호출한다고 해서 Xcode 제어 기능이 자동으로 제공되는 것은 아니다.
파일 접근과 xcodebuild, 테스트 실행은 연결된 에이전트 실행 환경이 담당해야 한다.
16. 실제로 어느 모델이 저렴한지 비교하는 방법
현재 공개된 벤치마크와 가격표만으로 특정 개발자의 프로젝트에서 가장 경제적인 모델을 결정할 수는 없다.
실제 작업을 비교하려면 조건을 맞춰야 한다.
가장 먼저 동일한 Git 커밋을 기준으로 작업 공간을 분리한다.
예를 들어 다음과 같다.
동일한 Repository
        ↓
동일한 Git Commit
        ↓
    Git Worktree
        ↓
 ┌──────┼──────┐
 ↓      ↓      ↓
DeepSeek Codex Claude
 ↓      ↓      ↓
빌드 및 테스트
        ↓
실행 시간·비용·결과 비교
단, 실제 모델과 도구의 비교 조건을 구분해야 한다.
가장 엄밀한 모델 비교를 하려면 같은 Harness와 도구 권한을 사용하는 편이 좋다.
반대로 개발자가 실제 사용하는 Codex·Claude Code·DeepSeek Harness를 비교한다면 이는 모델뿐 아니라 개발도구 전체를 비교하는 실험이 된다.
둘 다 의미 있지만 결과 해석은 달라진다.
무엇을 측정해야 할까?
| 측정 항목 | 설명 |
|---|---|
| 작업 완료 여부 | 요구사항 충족 |
| 빌드 결과 | 실제 컴파일 성공 |
| 테스트 통과 | 기존 기능 유지 여부 |
| 수정 파일 수 | 불필요한 변경 여부 |
| 입력 토큰 | 처리한 컨텍스트 |
| 출력·추론 토큰 | 생성 및 추론 사용량 |
| 캐시 적중 | 반복 입력 할인 |
| 모델 호출 횟수 | 전체 실행 횟수 |
| 재작업 횟수 | 실패 후 수정 횟수 |
| 총 실행 시간 | 시작부터 검증 완료까지 |
| 실제 비용 | 모든 호출과 도구 비용 합계 |
여기서 가장 중요한 값은 작업 완료율과 최종 비용이다.
모델이 토큰을 적게 사용하더라도 테스트를 통과하지 못했다면 성공한 작업으로 볼 수 없다.
또 여러 번 재시도해야 한다면 그 비용까지 합산해야 한다.
간단한 비교 기록 JSON
자동화 환경에서는 다음과 같은 형식으로 결과를 남길 수 있다.
{
  "task_id": "IOS-102",
  "model": "deepseek-flash",
  "harness": "deepseek-harness",
  "base_commit": "abc1234",
  "result": {
    "build": "passed",
    "tests": "passed",
    "requirement_met": true
  },
  "usage": {
    "input_tokens": null,
    "output_tokens": null,
    "cache_hit_tokens": null
  },
  "cost_usd": null,
  "duration_seconds": null,
  "retry_count": 0
}
이것은 측정 결과를 만들어낸 예제가 아니라 기록 형식이다.
실제 값을 수집할 때는 제공자의 응답 메타데이터와 청구 정보, Harness 실행 로그를 활용해야 한다.
이런 자료가 쌓이면 단순한 모델 가격 비교보다 실제 프로젝트에 적합한 도구를 판단하기 쉬워진다.
예를 들어 작은 UI 변경은 저렴하고 빠른 모델을 사용하고, 복잡한 아키텍처 변경은 더 강력한 모델에 맡기는 전략을 세울 수 있다.
중요한 작업만 Claude나 Codex에 위임하는 방식도 검토할 수 있다.
이런 역할 분리는 모든 작업을 가장 비싼 모델에 맡기는 것보다 경제적일 수 있다.
다만 실제 절약 효과는 비교 실험으로 확인해야 한다.
17. 마치며 — DeepSeek의 경쟁력은 이제 가격표만으로 설명하기 어렵다
DeepSeek V4.1 Flash 1017은 기존 V4.1 Flash의 개선 버전이다.
하지만 이번 업데이트가 보여준 방향은 단순한 성능 개선보다 넓다.
ProgramBench에서 43.3%의 상대적인 성능 향상을 기록했고, Terminal-Bench 4.0에서도 성능이 높아졌다.
DeepSeek는 자연어 요구사항으로 게임과 3D 프로젝트를 생성하는 시연도 공개했다.
그리고 모델의 핵심 가중치와 추론 코드를 공개했다.
이 점은 API로만 사용할 수 있는 상용 모델과 다른 선택지를 제공한다.
개발자는 DeepSeek API를 호출할 수도 있고, 충분한 인프라가 있다면 직접 모델을 배포하는 방식도 검토할 수 있다.
또 10월 말 DeepSeek Harness의 실험적 업데이트에서는 Codex와 Claude에 독립 작업을 위임하는 기능도 등장했다.
에이전트 작업의 컨텍스트와 캐시, 실행 시간을 관찰하는 기능도 강화되고 있다.
이런 흐름은 DeepSeek가 단순히 저렴한 모델 제공에 머무르지 않고 실제 개발 작업을 실행하고 관리하는 환경까지 확장하고 있다는 사실을 보여준다.
하지만 토큰 소비에 관해서는 정확하게 이해해야 한다.
DeepSeek가 항상 Codex나 Claude보다 적은 토큰을 사용하는 것은 아니다.
일부 모델 비교에서는 GPT보다 더 많은 출력 토큰을 사용하기도 했다.
그런데도 낮은 API 단가 덕분에 평가 작업당 비용이 더 낮게 나타나는 경우가 있었다.
결국 토큰 사용량과 비용은 다른 지표다.
게다가 실제 코딩 작업에서는 작업 성공률과 테스트, 도구 호출, 재시도까지 고려해야 한다.
오픈 가중치라고 해서 서버 운영 비용이 없어지는 것도 아니다.
모델의 안전성 역시 코딩 성능과 별도로 검증해야 한다.
따라서 DeepSeek를 도입할 때는 다음 질문을 함께 생각할 필요가 있다.
이 모델이 코드를 잘 작성하는가?

작업을 끝까지 완료하는가?

기존 기능을 깨뜨리지 않는가?

실제로 얼마나 많은 토큰을 사용하는가?

재시도와 도구 비용까지 포함하면 얼마인가?

API와 자체 배포 중 무엇이 적합한가?
이 질문에 대한 답은 프로젝트마다 달라질 수 있다.
하지만 이번 업데이트로 DeepSeek의 선택지가 넓어진 것은 분명하다.
모델 가중치를 직접 사용할 수 있고, 저렴한 API를 활용할 수 있으며, 다른 에이전트와 함께 사용하는 실행 환경도 계속 발전하고 있다.
앞으로 AI 코딩 모델의 경쟁은 단순히 코드 몇 줄을 얼마나 빨리 생성하는가에서 끝나지 않을 것이다.
복잡한 개발 작업을 얼마나 안정적으로, 검증 가능한 결과로, 합리적인 비용에 완료할 수 있는가가 더욱 중요해질 가능성이 크다.
DeepSeek의 경쟁력도 이제 단순히 '싼 AI'라는 말만으로는 설명하기 어렵다.
공개된 모델을 바탕으로 개발자가 필요한 일을 얼마나 효율적으로 끝낼 수 있는가.
이번 V4.1 Flash 1017과 Harness의 변화는 바로 그 방향을 보여주고 있다.
참고자료
DeepSeek — V4.1 Flash 1017 공식 발표
2026년 10월 17일 발표. 코딩 성능 개선, Wish-Driven Programming, 프로젝트 생성 시연, 오픈 가중치 공개와 Search & Fetch API 내용을 설명한다.
DeepSeek V4.1 Flash 1017 공식 발표
DeepSeek — V4.1 Flash 1017 모델 카드
주요 벤치마크와 비교 환경, 모델 가중치 및 MIT 라이선스 등을 확인할 수 있다.
DeepSeek — V4.1 Flash 기술 발표
552B MoE 아키텍처, 입력·출력 단계별 활성 파라미터, KV Cache 최적화와 모델의 기술적 특징을 설명한다.
DeepSeek — Harness 릴리스
10월 말 Alpha·RC 업데이트, 로컬 에이전트 작업 위임과 실행 통계 등의 변경사항을 확인할 수 있다.
DeepSeek — 공식 API 가격
캐시 적중·미적중, 혼잡·비혼잡 시간 요금과 모델별 가격을 확인할 수 있다.
DeepSeek — Search & Fetch API
웹 검색과 문서 수집 API, 요청별 가격 및 사용 조건을 설명한다.
Artificial Analysis — 모델별 비용과 토큰 사용량
DeepSeek 1017과 경쟁 모델의 평가 설정별 작업 시간, 출력 토큰과 비용을 비교할 수 있다. 수치는 추론 수준과 평가 버전에 따라 달라질 수 있다.
DeepSeek 1017 vs Claude Opus 5.5
Fangcun AI — DeepSeek 1017 독립 안전성 평가
장시간 에이전트 작업과 모델의 행동 경계 등 안전성 관련 평가를 다룬 연구 자료.