
이번 포스팅은 2023년도 2학기 수업 <데이터애널리틱스> 과목에서 진행했던 프로젝트의 일부를 담고 있습니다.
프로젝트 개요
지금까지 코로나19 팬데믹은 사회에 대대적인 영향을 미쳤습니다. 팬데믹은 다양한 분야에 영향을 미쳤으나, 그중 중환자 치료 환경은 참담한 실정이었습니다.
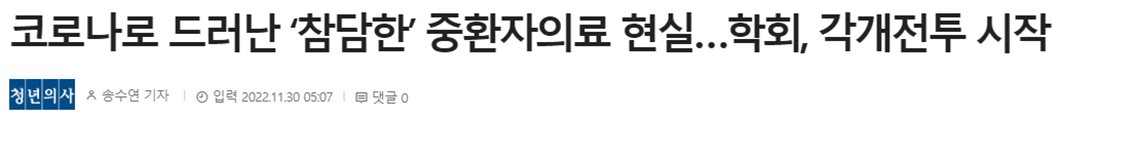
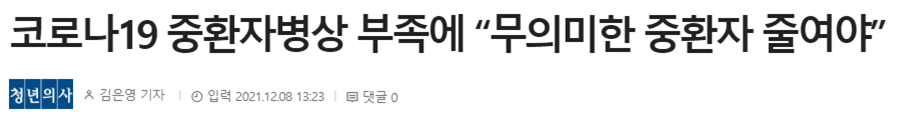
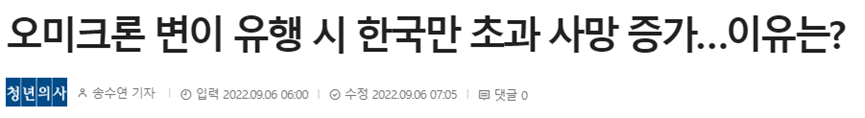
다음은 기사의 일부입니다.
“코로나19 팬데믹이 ‘후진국 수준’인 우리나라 중환자 의료체계를 수면 위로 끌어올렸다. 하지만 그뿐이었다. 위중증 환자 급증으로 중환자 병상 부족 문제가 반복될 때마다 중환자 의료체계를 개선해야 한다는 목소리도 커졌지만 행정명령으로 병상만 확보하면 그만이었다.”
“임 회장은 ‘정부는 중환자 병상을 늘리기 위해 노력하고 있지만 이와 함께 무의미한 중환자실 입실도 줄일 필요가 있다’며 ‘중환자실을 일반 병상 만들 듯 만들어낼 수는 없다. 또 만들어진다 한들 의료인력을 쉽게 늘릴 수 있는 것도 아니다’라고 말했다. 임 회장은 ‘지난 2014년 상급종합병원 연구에 따르면 내과계 중환자실 환자의 10%가 입실 당일 이미 무의미한 입원인 것으로 조사됐다’면서 “무의미한 중환자실 입원을 줄이면 상당수 중환자 병실을 만들어내는 효과가 있을 것”이라고 했다.”
“김영삼 교수 연구결과, 올해 3월 초과사망 1만8000명 발생 폐렴 등 입원 환자 줄어 ‘비코로나 환자 의료접근성 떨어졌다’ ‘필요 인원의 58% 인력으로 중환자실 운영, 사망률 높아’”
팬데믹 기간 중 중환자 병상 부족, 무의미한 중환자실 입실 및 입원, 필요 인력의 부족 등 중환자 치료 관련하여 다양한 문제가 발생하였습니다. 코로나19와 같은 전염병이 다시 재발한다면, 현재의 의료 체계로 그것을 감당할 수 있을까요?
또한, 우리나라의 경우 인구 고령화가 지속되어 고령 인구가 증가함에 따라 중환자실 이용이 더더욱 증가할 예정입니다. 이를 대비하여 중환자 의료체계 관련 지원이 필요한 상황입니다.
이런 문제 상황을 기반으로, 이번 프로젝트를 기획하였습니다.
본 프로젝트의 목표는 다음과 같습니다.
- 병실, 인력 등 제한된 자원을 적절히 분배할 수 있도록 머신러닝을 사용하여 환자의 중증도를 정확히 추정하는 것
- 의사, 간호사 등 AI 관련 비전공자 또한 머신러닝 모델을 사용할 수 있도록 구현하는 것
첫 번째 목표인 환자의 중증도 추정을 위해, 저희는 중환자실에 입원한 환자가 3일 내 사망할 확률을 예측하기로 하였습니다. 사망 예측은 환자가 입원한 지 6시간 이내에 발생한 이벤트를 기반으로 예측하며, 3일 내 사망할 확률이 높은 경우 해당 환자의 중증도가 높다고 생각합니다.
환자 입원 후 6시간 이내의 데이터만을 사용한 것은 중환자실의 고질적인 문제 중 하나인 병상 부족을 고려해 보았을 때, 가능한 한 빨리 환자의 중증도를 추정하고 위중 정도를 판단하는 것이 중요하다고 판단하였기 때문입니다.
또한, SHAP 기반 local 특성 중요도를 계산함으로써 해당 환자의 중증도(사망 확률) 추정에 크게 영향을 주었던 특성을 식별하고자 하였습니다.
다음으로 두 번째 목표를 위해, 모델을 훈련한 후 이를 사용할 수 있는 간단한 웹페이지를 구현하였습니다. 파이썬의 streamlit 라이브러리를 사용하였으며, csv 파일만 업로드하면 각 환자의 중증도와 중요 특성을 확인할 수 있도록 구현하였습니다.
데이터셋 소개

본 프로젝트에서 사용한 데이터셋은 MIMIC-IV 데이터셋입니다. MIMIC(Medical Information Mart for Intensive Care)은 중환자실(ICU)에서 수집된 대규모 의료 데이터셋으로, 실제 환자들의 의료 기록을 포함하고 있습니다.
이 데이터셋은 Beth Israel Deaconess Medical Center에서 수집되었으며, 다양한 연구 및 의료 정보 기술 개발을 위해 사용됩니다.
데이터셋에 관한 자세한 설명은 공식 문서 및 다른 블로그를 참고해 주세요.
MIMIC-IV 데이터셋은 하나의 csv 파일이 아닌 ICU stays, Admissions, Labevents 등 여러 개의 테이블로 이루어져 있습니다. 각각의 테이블은 고유의 정보(입원 관련, 치료 관련 등)를 담고 있으며 환자의 id를 뜻하는 subject_id, hadm_id 등을 키로 가집니다(아닌 테이블도 있습니다).
데이터 통합 및 전처리
이번 섹션에서는 흩어져 있는 데이터를 통합하고 전처리하는 과정을 소개합니다.
중환자실에 입원한 환자의 정보는 ICU stays 테이블에 저장되어 있어, 이 테이블에 저장된 환자 데이터를 기반으로 모델을 훈련합니다.
환자가 입원한 지 6시간 이내에 발생한 이벤트로 3일 내 사망 여부를 예측하는데, 환자의 이벤트(심장박동 수, 수혈 여부, 혈압 등등)는 Chartevents, Inputevents, Outputevents, Labevents 등 다양한 테이블에 저장되어 있습니다.
이를 고려하여, 아래와 같이 테이블을 통합하였습니다.
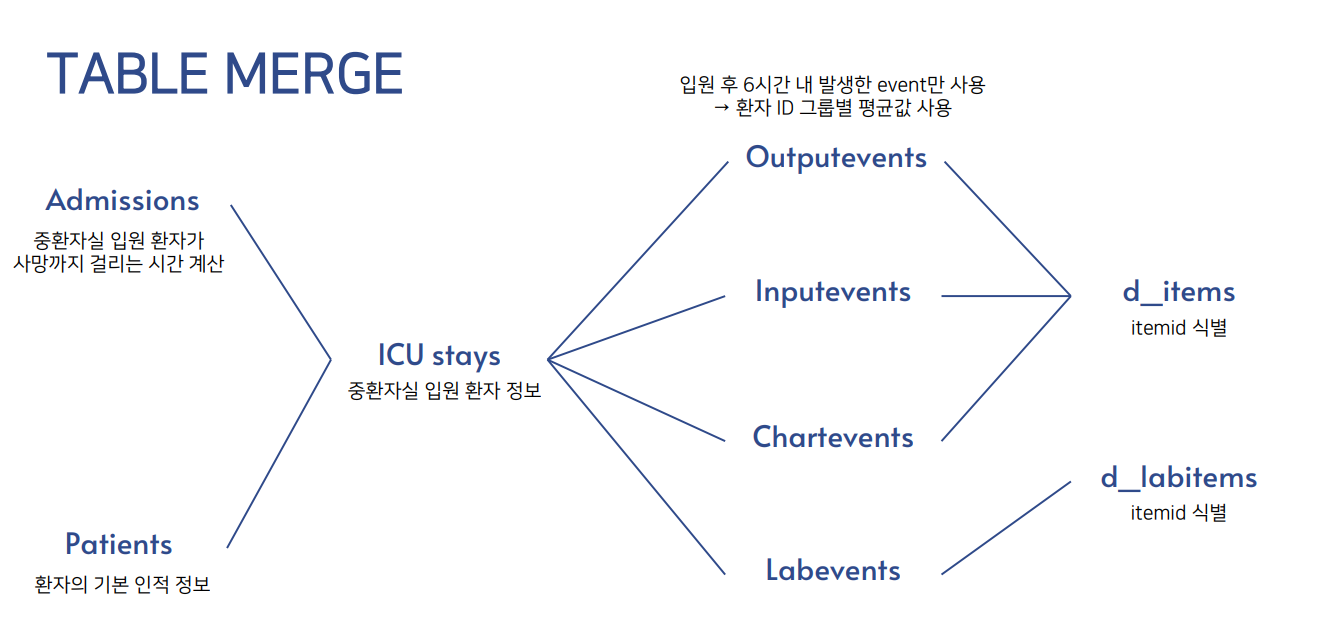
ICU stays, Patients로 환자의 기본적인 정보(성별, 나이 등)를 얻고, Admissions 테이블을 통해 환자가 입원 후 사망까지 걸린 시간을 확인합니다(사망하지 않은 경우도 물론 있습니다). 사망까지 걸린 시간이 3일 이내라면 이후 데이터의 레이블이 1(양성)이 됩니다.
입원 중 환자에게 발생한 이벤트는 4개의 테이블 Chartevents, Inputevents, Outputevents, Labevents의 데이터를 사용하며, 해당 환자의 입원 시간에서 6시간 이내에 발생한 데이터만 사용하였습니다. 6시간 동안 여러 번 발생한 이벤트의 경우(6시간 동안 혈압을 여러 번 재는 등), 해당 이벤트의 평균 값을 사용합니다.
또한 각 이벤트의 코드를 식별할 수 있도록 d_items, d_labitems 테이블을 사용하였습니다.
기본 인적 정보
먼저, 다음과 같이 환자의 기본 인적 정보를 추출하였습니다. 각 csv 파일의 용량이 크므로 del, gc.collect()를 수시로 호출합니다.
코드 중에서, pd.read_csv() 함수를 csv.gz 파일에 바로 적용할 수 있음을 나중에 알았습니다. 따라서 gzip.open()은 차후 생략해도 될 것 같습니다.
icu_stay_csv = gzip.open('./MIMIC-IV/icu/icustays.csv.gz')
icu_stay = pd.read_csv(icu_stay_csv)

del icu_stay_csv
gc.collect()

# 동일 hadm_id 중복 제거
icu_stay = icu_stay.drop_duplicates(subset=['hadm_id'], keep='first')
icu_stay[['subject_id', 'hadm_id', 'intime']].to_csv('icu_stay.csv')
icu_stay = pd.read_csv('icu_stay.csv', index_col=0)

admission = pd.read_csv('./MIMIC-IV/core/admissions.csv')
admission = admission[['hadm_id', 'deathtime']]

patients = pd.read_csv('./MIMIC-IV/core/patients.csv')
patients = patients[['subject_id', 'gender', 'anchor_age']]

icu_stay = pd.merge(icu_stay, patients, on='subject_id', how='left')
icu_stay = pd.merge(icu_stay, admission, on='hadm_id', how='left')

icu_stay['intime'] = pd.to_datetime(icu_stay['intime'])
icu_stay['deathtime'] = pd.to_datetime(icu_stay['deathtime'])

icu_stay['mortality'] = icu_stay['deathtime'] - icu_stay['intime']
icu_stay['mortality_in_second'] = icu_stay.mortality.dt.total_seconds()

# 입원 후 6시간 이내에 데이터를 기반으로 3일 내 죽을 확률 계산
# mortality_in_second가 양수 혹은 null(사망하지 않음)인 데이터만 사용
icu_stay = icu_stay[(icu_stay.mortality_in_second > 0) | (icu_stay.mortality_in_second.isnull())]
icu_stay['mortality_in_3days'] = icu_stay['mortality_in_second'] < 86400 * 3
icu_stay = icu_stay[['hadm_id', 'intime', 'gender', 'anchor_age', 'mortality_in_second', 'mortality_in_3days']]

icu_stay.to_csv('icu_stay_with_3days.csv')
del icu_stay, admission, patients
gc.collect()
pd.to_datetime()을 사용하여 입원 시간(intime) 및 사망 시간(deathtime)을 처리합니다. 사망 시간에서 입원 시간을 빼 입원 후 사망까지 걸린 시간(mortality_in_second)을 계산하고, 3일 내 사망한 환자를 식별(mortality_in_3days)합니다.
위 코드를 통해 입원한 환자의 id(hadm_id), 성별, 나이, 사망까지 걸린 시간 및 3일 내 사망 여부를 얻을 수 있습니다.
발생 이벤트
Labevents, Inputevents, Outputevents, Chartevents는 데이터의 형식이 비슷하므로, 거의 같은 방법으로 처리하였습니다.
각 데이터들은 다음의 형태로 저장되어 있습니다(간소화한 도식입니다).
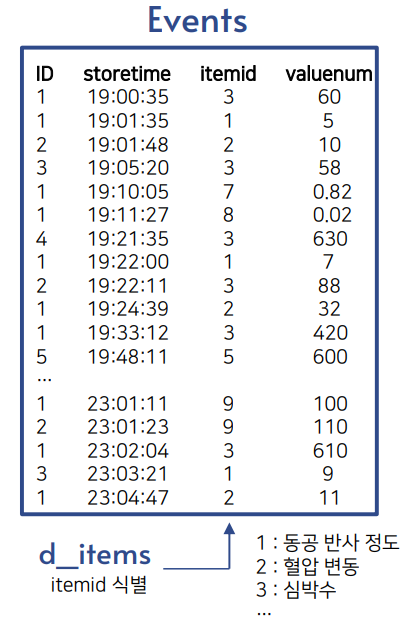
각 환자의 id, 이벤트가 저장된 시간, 발생한 이벤트의 id 및 해당 이벤트의 값이 있습니다. 이 외에도 해당 이벤트를 저장한 직원 등 추가적인 정보가 있으나, 모델링에 무의미할 것으로 판단하여 위의 정보만을 사용합니다.
위의 데이터를 다음과 같이 변경합니다.
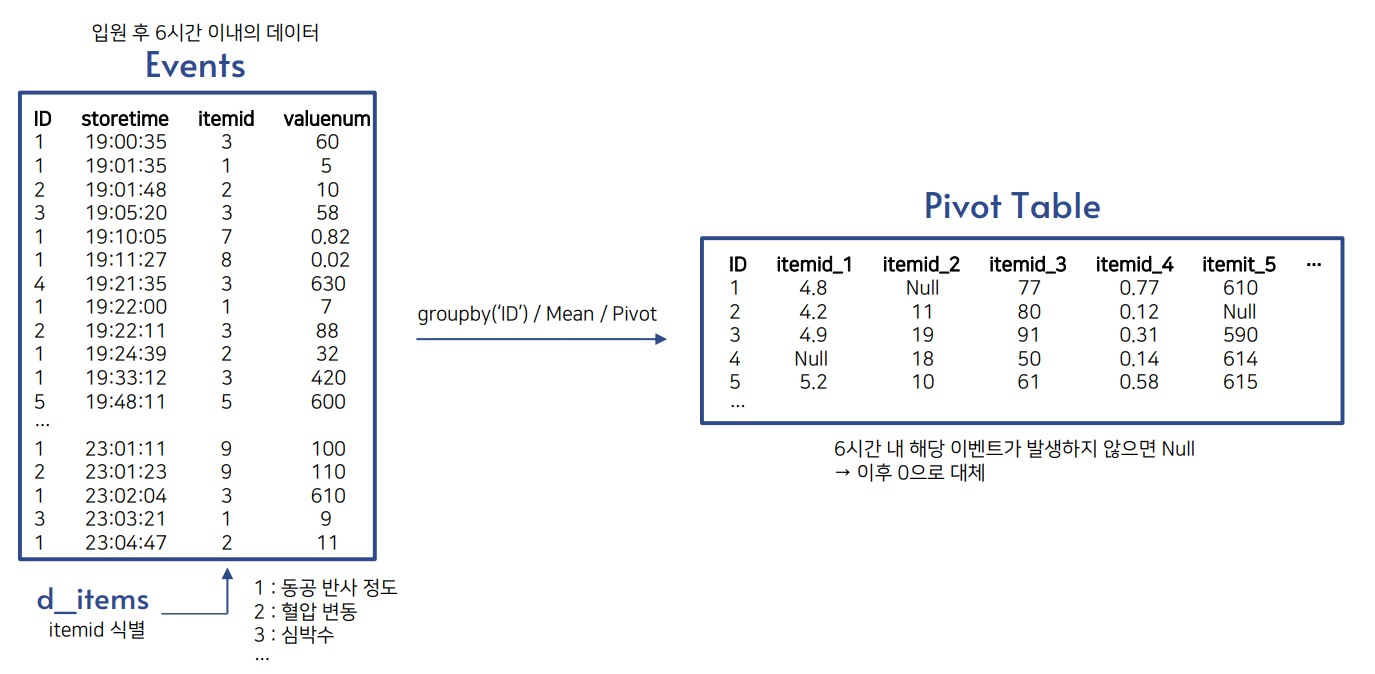
우선, 입원 시간과 이벤트가 저장된 시간(storetime)을 비교하여 입원 후 6시간 이내의 데이터만을 필터링합니다. 이후, 환자의 id(hadm_id)를 기반으로 그룹을 만든 후 그룹별 평균 계산 및 pivot을 적용하여 오른쪽의 Pivot Table과 같은 결과를 얻습니다.
이렇게 하면 하나의 row로 한 명의 환자를 표현할 수 있습니다. Null 값의 경우, 6시간 이내에 해당 이벤트가 발생하지 않은 것이므로 그 값을 0으로 채웁니다.
위의 과정을 코드로 나타내 보면 다음과 같습니다.
data = pd.read_csv('./icu_stay_with_3days.csv', index_col=0)

outputevents_csv = gzip.open('./MIMIC-IV/icu/outputevents.csv.gz')
outputevents = pd.read_csv(outputevents_csv)

del outputevents_csv
gc.collect()

outputevents = pd.merge(outputevents, data[['hadm_id', 'intime']], on='hadm_id', how='left')

outputevents['intime'] = pd.to_datetime(outputevents['intime'])
outputevents['storetime'] = pd.to_datetime(outputevents['storetime'])

outputevents['time_to_store'] = outputevents['storetime'] - outputevents['intime']
outputevents['time_to_store'] = outputevents['time_to_store'].dt.total_seconds()

# 6시간 이내의 데이터
outputevents['time_to_store_in_day'] = (outputevents['time_to_store'] < 86400 / 4) & (outputevents['time_to_store'] > 0)

outputevents_in_6hour = outputevents[outputevents.time_to_store_in_day]
outputevents_in_6hour = pd.merge(outputevents_in_6hour, d_items[['itemid', 'label']], on=['itemid'], how='left')

# 6시간 내 value의 평균을 사용
tmp = outputevents_in_6hour.groupby(['hadm_id', 'label'])['value'].mean()
tmp = pd.DataFrame(tmp).reset_index()

outputevents_in_6hour_pivot = tmp.pivot(index='hadm_id', columns='label', values='value')
outputevents_in_6hour_pivot = outputevents_in_6hour_pivot.reset_index()
outputevents_in_6hour_pivot.to_csv('outputevents_in_row_mean.csv')
데이터프레임 outputevents의 time_to_store_in_day가 1이면 입원 후 6시간 이내에 발생한 데이터입니다(변수 이름을 잘못 지었습니다...).
각 테이블마다 특성의 이름이 조금씩 다르지만(value가 아니라 amount 특성이 있다는 등), 전체적인 과정은 동일합니다. 다만, Chartevents와 Labevents의 경우 csv 파일의 용량이 너무 커 그 파일을 한 번에 읽지 못할 수 있습니다. 그때에는 다음과 같이 읽습니다.
chartevent_csv = gzip.open('./MIMIC-IV/icu/chartevents.csv.gz')

result = pd.DataFrame()

cols = ['hadm_id', 'storetime', 'itemid', 'valuenum']

for cnt, df in enumerate(pd.read_csv(chartevent_csv, chunksize=1e6, usecols=cols)):
    df = pd.merge(df, data[['hadm_id', 'intime']], on='hadm_id', how='left')
    df['intime'] = pd.to_datetime(df['intime'])
    df['storetime'] = pd.to_datetime(df['storetime'])

    df['time_to_store'] = df['storetime'] - df['intime']
    df['time_to_store'] = df['time_to_store'].dt.total_seconds()

    # 6시간 이내의 데이터
    df['time_to_store_in_day'] = (df['time_to_store'] < 86400 / 4) & (df['time_to_store'] > 0)
    df = df[df.time_to_store_in_day]
    df = pd.merge(df, d_items[['itemid', 'label']], on=['itemid'], how='left')
    result = pd.concat([result, df])

del chartevent_csv
gc.collect()

result = result.groupby(['hadm_id', 'label'])['valuenum'].mean()
result = pd.DataFrame(result).reset_index()
result = result.pivot(index='hadm_id', columns='label', values='valuenum').reset_index()
result.to_csv('chartevents_in_row_mean.csv')

del result
gc.collect()
chunksize 및 usecol을 사용하여 필요한 특성만 부분적으로 읽어 result에 추가합니다. 만약 6시간이 아닌 12시간, 24시간 등 더 많은 데이터를 사용한다면, 더 많은 데이터가 result에 추가되어 result 객체를 RAM에 올리지 못할 수 있으니 이를 주의합니다.
이 과정을 마치면 다음과 같은 데이터셋을 얻을 수 있습니다.
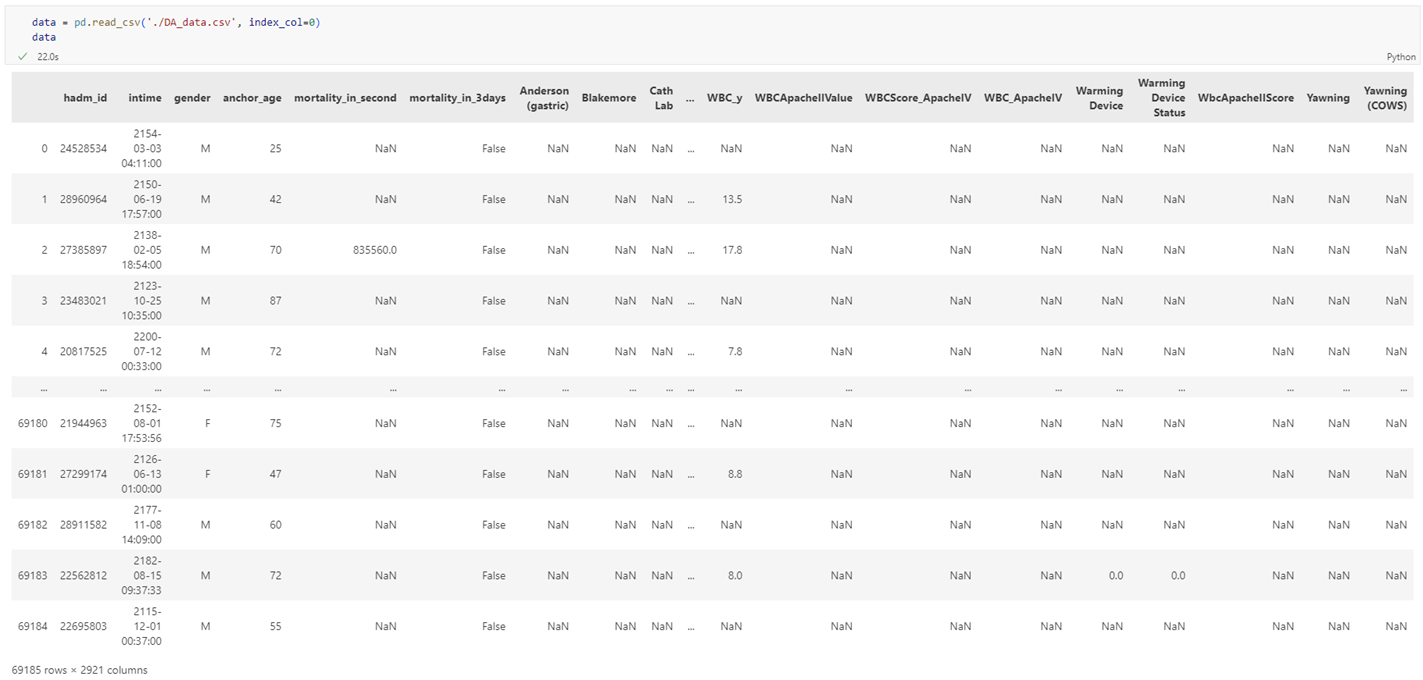
69,185개의 샘플(69,185명의 중환자실 입원 환자)과 2,921개의 특성을 가진 데이터셋을 얻었습니다. NaN은 이후 0으로 채웁니다. 이 데이터를 기반으로 모델을 훈련합니다.
모델링
프로젝트의 주요 문제는 해당 환자가 3일 내 사망할 확률을 구하는 것입니다. 3일 내 사망 여부를 예측하는 이진 분류 문제로 접근하여, 이후 predict_proba() 등을 사용하여 3일 내 사망 확률을 추정합니다.
이진 분류 문제 해결을 위해, 먼저 다음 6개의 모델을 훈련하였습니다.
- TabNet
- ResNet (for tabular data)
- XGBoost
- LightGBM
- RandomForest
- LogisticRegression
이후, 최종 예측에서는 TabNet을 제거하였습니다. 총 5개의 모델 예측 결과로 soft voting을 수행하여 최종 예측 결과를 얻었습니다.
추가적인 전처리
먼저, 데이터를 읽어온 후 결측치 대체 및 불필요한 특성을 제거합니다.
data.gender = data.gender.replace({'M':1, 'F':0})
y = data.mortality_in_3days.replace({True:1, False:0})

X = data.drop(['hadm_id', 'intime', 'mortality_in_second', 'mortality_in_3days'], axis=1)
X.fillna(0, inplace=True)

del data
gc.collect()
사전 실험 결과, 데이터셋의 특성이 약 3천 개로 수가 너무 많아 모델 훈련, 특히 딥러닝 모델 훈련에 시간이 너무나도 오래 걸렸기에 특성 선택을 수행하였습니다.
전체 특성에서 단일 모델 기준 성능이 가장 좋았던 XGBoost 모델의 결과를 사용하여 SHAP 기반 global 특성 중요도를 계산하였고, 특성 중요도 값이 0보다 큰 특성만을 사용하였습니다.
# SHAP(XGBoost) based feature importance
shap_fi = pd.read_csv('./shap_fi_mean.csv', index_col=0)

shap_fi[shap_fi.shap_importance > 0].shape
출력
(514, 2)
전체 특성 중 514개 특성만을 사용하여 최종 모델링을 진행하였습니다.
또한, 다음과 같이 데이터셋에 클래스 불균형 문제가 있음을 확인하였습니다.
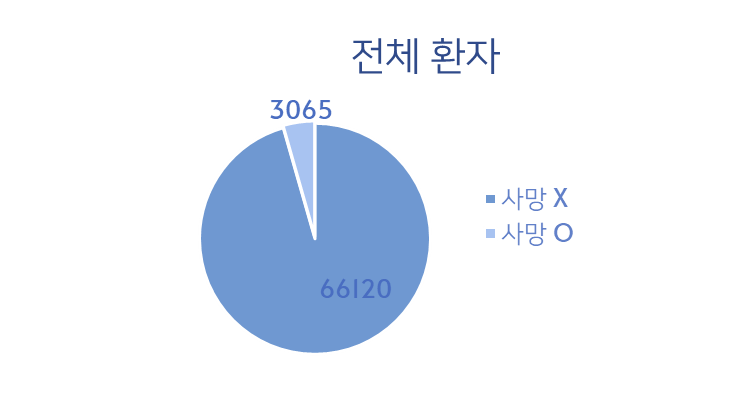
이를 고려하여, 소수 클래스를 추가하는 오버샘플링 과정을 수행하였습니다.
단순히 소수 클래스 샘플을 복제하는 사이킷런의 resample, 새로운 데이터를 합성하는 SMOTE, ADASYN을 실험한 결과 사이킷런의 resample의 효과가 가장 좋아 resample을 사용하여 소수 클래스 샘플을 추가하였습니다.
아래 코드는 각 데이터셋(훈련, 검증, 테스트)에 표준화를 적용한 뒤, 오버샘플링을 적용하는 코드입니다.
ss = StandardScaler()
X_train.iloc[:, :] = ss.fit_transform(X_train)
X_val.iloc[:, :] = ss.transform(X_val)
X_test.iloc[:, :] = ss.transform(X_test)

ss = StandardScaler()
X_train_all.iloc[:, :] = ss.fit_transform(X_train_all)

# upsample -> abnormal(dies in 3 days) case
X_train_normal = X_train[y_train==0]
X_train_abnormal = X_train[y_train==1]

y_train_normal = y_train[y_train==0]
y_train_abnormal = y_train[y_train==1]

X_abnormal_res, y_abnormal_res = resample(X_train_abnormal, y_train_abnormal, replace=True, n_samples=X_train_normal.shape[0], random_state=21)
X_train = pd.concat([X_train_normal, X_abnormal_res])
y_train = pd.concat([y_train_normal, y_abnormal_res])

# shuffle
X_res, y_res = shuffle(X_train, y_train, random_state=21)
X_res.shape
출력
(108000, 514)
# upsample -> abnormal(dies in 3 days) case
X_train_normal = X_train_all[y_train_all==0]
X_train_abnormal = X_train_all[y_train_all==1]

y_train_normal = y_train_all[y_train_all==0]
y_train_abnormal = y_train_all[y_train_all==1]

X_abnormal_res, y_abnormal_res = resample(X_train_abnormal, y_train_abnormal, replace=True, n_samples=X_train_normal.shape[0], random_state=21)
X_train_all = pd.concat([X_train_normal, X_abnormal_res])
y_train_all = pd.concat([y_train_normal, y_abnormal_res])

# shuffle
X_res_all, y_res_all = shuffle(X_train_all, y_train_all, random_state=21)

# X_res_all : no validation subset
X_res_all.shape
출력
(120000, 514)
준비된 데이터를 사용하여 모델을 훈련합니다.
TabNet
TabNet은 pytorch_tabnet의 TabNetClassifier를 사용하였습니다. pretrain 기능을 사용해 보았습니다.
sparse_X_train = scipy.sparse.csr_matrix(X_res)
sparse_X_valid = scipy.sparse.csr_matrix(X_val)

# TabNetPretrainer
unsupervised_model = TabNetPretrainer(optimizer_fn=torch.optim.Adam,
                                      verbose=5,)

unsupervised_model.fit(X_train=X_res.values,
                       eval_set=[X_val.values],
                       max_epochs=50,
                       patience=10,
                       batch_size=1024,
                       virtual_batch_size=256,
                       num_workers=0,
                       drop_last=False,
                       pretraining_ratio=0.5,)

tabnet_params = {"optimizer_fn": torch.optim.Adam,
                 "optimizer_params": dict(lr=1e-3, weight_decay=1e-2),
                 "scheduler_fn": torch.optim.lr_scheduler.StepLR,
                 "scheduler_params":{"step_size":10, "gamma":0.99},
                 "mask_type": 'sparsemax',
                 "device_name": 'cpu',
                 "n_d": 8,
                 "n_a": 8,
                 "n_steps": 3,
                 "gamma": 1.3,
                 "seed": 21}

tabnet = TabNetClassifier(**tabnet_params)

max_epochs = 150

# Fitting the model
tabnet.fit(X_train=sparse_X_train, y_train=y_res,
           eval_set=[(sparse_X_train, y_res), (sparse_X_valid, y_val)],
           eval_name=['train', 'val'],
           eval_metric=['accuracy', 'logloss'],
           max_epochs=max_epochs,
           patience=50,
           batch_size=1024,
           virtual_batch_size=256,
           from_unsupervised=unsupervised_model)
학습 결과를 확인해 보면 다음과 같았습니다.
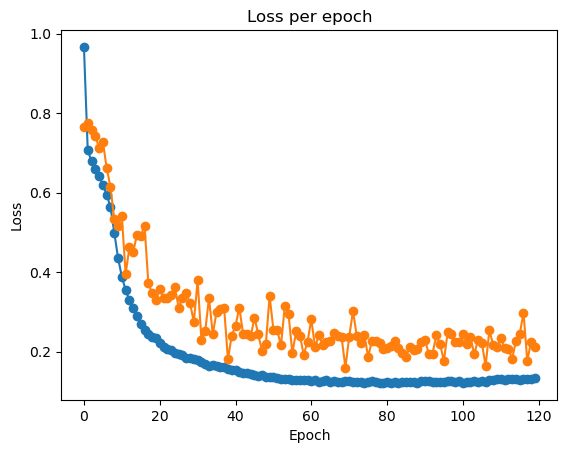
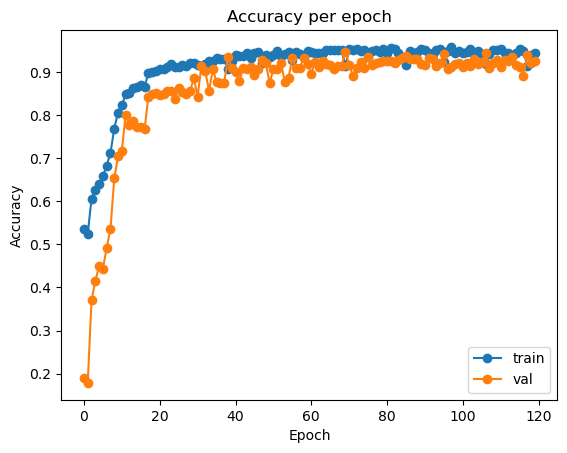
높은 정확도를 보여주지만, 검증 세트의 경우 클래스 불균형 상황에서 오버샘플링을 수행하지 않았으므로 정확도는 그다지 유용한 지표가 아닙니다.
테스트 세트에 대한 confusion matrix를 그려봅니다.
preds = tabnet.predict(X_test.values)

conf_matrix(y_test, preds)
출력
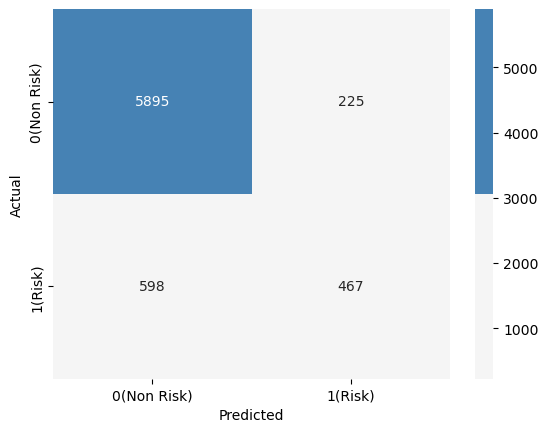
Accuracy: 0.885455810716771
Recall: 0.4384976525821596
Precision: 0.6748554913294798
F1: 0.5315879339783722
검증 세트와 마찬가지로 테스트 세트 또한 오버샘플링을 수행하지 않았으므로 정확도는 높지만, 나머지 지표가 낮습니다.
본래 엄격하게는 테스트 세트를 분리한 다음, 마지막의 마지막에서만 성능(일반화 성능) 확인을 위해 사용하는 것이 맞습니다.
위와 같은 경우에는 검증 세트에 대한 혼동 행렬을 확인하여 모델의 성능을 평가하는 것이 더 옳은 방법입니다(이때는 차마 생각하지 못했습니다...).
모델을 저장합니다
# save model
saved_filepath = tabnet.save_model('TabNet')
XGBoost
XGBoost, LightGBM, RandomForest, LogisticRegression 모두 비슷한 방법으로 훈련합니다.
위 네 모델의 경우, 검증 세트까지 훈련 데이터에 포함한 X_res_all로 모델을 훈련한 후 테스트 세트로 모델의 성능을 확인하였습니다. 다시 언급하지만, 이럴 때는 검증 세트를 떼어낸 후 검증 세트에서 성능을 확인해야 합니다.
xgb = XGBClassifier(seed=21)
xgb.fit(X_res_all.values, y_res_all)

preds = xgb.predict(X_test.values)
conf_matrix(y_test, preds)
출력
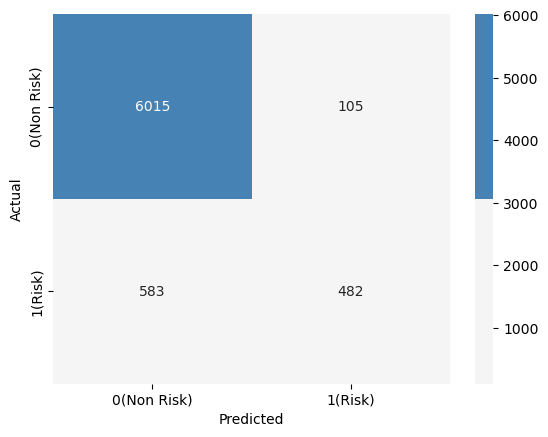
Accuracy: 0.9042449547668754
Recall: 0.45258215962441317
Precision: 0.8211243611584327
F1: 0.5835351089588378
# save model
joblib.dump(xgb, 'XGBoost.pkl')
LightGBM
lgbm = LGBMClassifier(seed=21)
lgbm.fit(X_res_all.values, y_res_all)

preds = lgbm.predict(X_test.values)
conf_matrix(y_test, preds)
출력
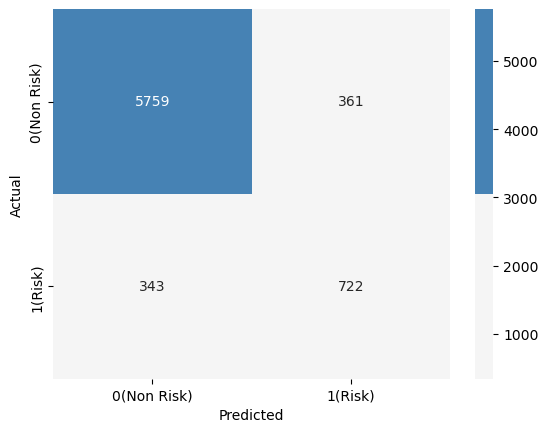
Accuracy: 0.9020180932498261
Recall: 0.6779342723004694
Precision: 0.6666666666666666
F1: 0.6722532588454375
# save model
joblib.dump(lgbm, 'LightGBM.pkl')
RandomForest
rf = RandomForestClassifier(n_estimators=300, random_state=21)
rf.fit(X_res_all.values, y_res_all)

preds = rf.predict(X_test.values)
conf_matrix(y_test, preds)
출력
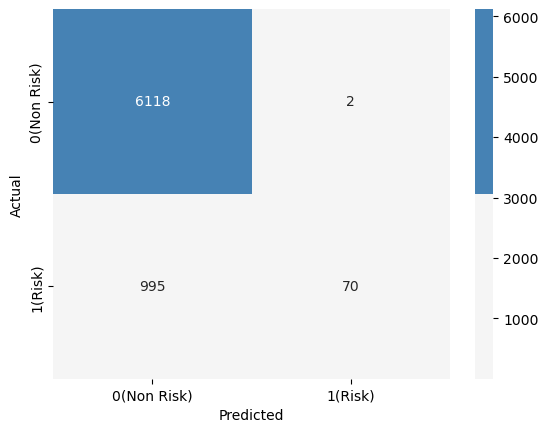
Accuracy: 0.8612386917188587
Recall: 0.06572769953051644
Precision: 0.9722222222222222
F1: 0.12313104661389623
# save model
joblib.dump(rf, 'RandomForest.pkl')
LogisticRegression
lr = LogisticRegression(C=0.01, random_state=21)
lr.fit(X_res_all.values, y_res_all)

preds = lr.predict(X_test.values)
conf_matrix(y_test, preds)
출력
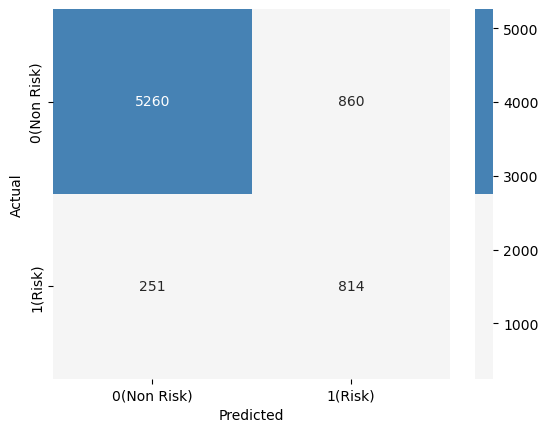
Accuracy: 0.8453723034098817
Recall: 0.7643192488262911
Precision: 0.4862604540023895
F1: 0.5943775100401606
# save model
joblib.dump(lr, 'LogisticRegression.pkl')
ResNet
ResNet의 경우, rtdl 라이브러리에 구현된 아키텍처를 사용하였습니다. pytorch 기반입니다.
적절한 관련 함수를 정의한 후, 모델을 훈련합니다.
resnet = rtdl.ResNet.make_baseline(d_in=X_res.shape[1],
                                   d_main=256,
                                   d_hidden=128,
                                   dropout_first=0.3,
                                   dropout_second=0.3,
                                   n_blocks=2,
                                   d_out=1)

criterion = nn.BCELoss()
optimizer = optim.Adam(resnet.parameters(), lr = 1e-3, weight_decay=1e-2)
scheduler = optim.lr_scheduler.StepLR(optimizer, step_size=10, gamma=0.99)

history = {'train_loss' : [],
           'val_loss': [],
           'train_accuracy': [],
           'val_accuracy': []}

device = 'cpu'
EPOCHS = 150
max_loss = np.inf

for epoch in range(EPOCHS):
    train_loss, train_acc, history = model_train(resnet, train_loader, criterion, optimizer, device, history, scheduler)
    val_loss, val_acc, history = model_evaluate(resnet, val_loader, criterion, device, history)

    if val_loss < max_loss:
        print(f'[INFO] val_loss has been improved from {max_loss:.5f} to {val_loss:.5f}. Save model.')
        max_loss = val_loss
        torch.save(resnet.state_dict(), 'ResNet_Best.pth')

    print(f'epoch {epoch+1:02d}, loss: {train_loss:.5f}, accuracy: {train_acc:.5f}, val_loss: {val_loss:.5f}, val_accuracy: {val_acc:.5f} \n')
훈련 결과를 확인하면 다음과 같습니다.
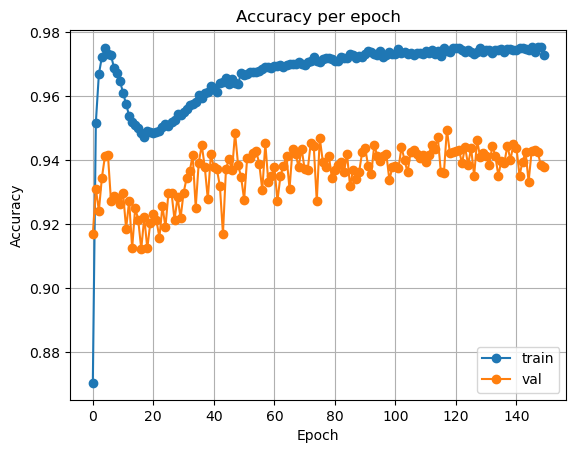
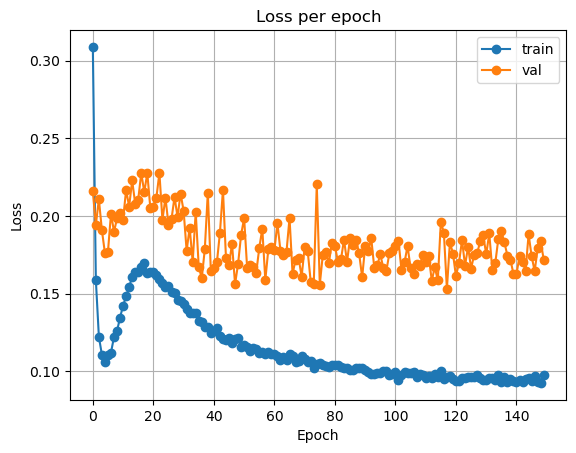
resnet.load_state_dict(torch.load('ResNet_Best.pth'))

# threshold = 0.5
preds = torch.sigmoid(resnet(torch.tensor(X_test.values, dtype=torch.float))) >= torch.FloatTensor([0.5])
preds = np.where(preds.numpy(), 1, 0)

conf_matrix(y_test, preds)
출력
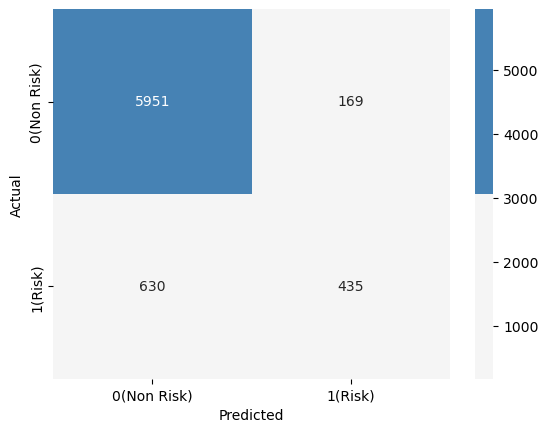
Accuracy: 0.8887961029923451
Recall: 0.4084507042253521
Precision: 0.7201986754966887
F1: 0.5212702216896345
# model save
torch.save(resnet, 'ResNet')
6개의 모델 훈련 결과, 위음성이 특별히 많거나 위양성이 특별히 많은 등 각 모델이 생성하는 오차의 종류가 달랐습니다. 따라서 모델 간 예측 결과를 모두 고려하면(앙상블) 보다 높은 성능을 얻을 수 있을 것이라 예상하였습니다.
하이퍼파라미터 튜닝
Optuna를 사용하여 하이퍼파라미터 튜닝 또한 진행하였습니다.
딥러닝 모델의 경우 고려해야 하는 하이퍼파라미터의 수가 너무 많아 XGBoost, LightGBM, RandomForest, LogisticRegression 모델만 튜닝하였습니다.
다음은 XGBoost의 경우입니다. 함수 내부에서 전체 훈련 데이터셋을 5개의 fold로 나누어 교차 검증을 수행합니다. f1 score가 높아지는 방향으로 하이퍼파라미터를 찾습니다.
def xgb_objective(trial, X, y):
    params = {
        'max_depth': trial.suggest_int('max_depth', 1, 9),
        'learning_rate': trial.suggest_loguniform('learning_rate', 0.01, 1.0),
        'n_estimators': trial.suggest_int('n_estimators', 50, 500),
        'min_child_weight': trial.suggest_int('min_child_weight', 1, 10),
        'gamma': trial.suggest_loguniform('gamma', 1e-8, 1.0),
        'subsample': trial.suggest_loguniform('subsample', 0.01, 1.0),
        'colsample_bytree': trial.suggest_loguniform('colsample_bytree', 0.01, 1.0),
        'reg_alpha': trial.suggest_loguniform('reg_alpha', 1e-8, 1.0),
        'reg_lambda': trial.suggest_loguniform('reg_lambda', 1e-8, 1.0),
        'eval_metric': 'mlogloss',
        'use_label_encoder': False
    }

    cv = StratifiedKFold(n_splits=5, shuffle=True)
    cv_scores = []

    for idx, (train_idx, val_idx) in enumerate(cv.split(X, y)):
        X_train, X_val = X.iloc[train_idx], X.iloc[val_idx]
        y_train, y_val = y.iloc[train_idx], y.iloc[val_idx]

        # using statistic of X_train
        ss = StandardScaler()
        X_train.iloc[:, :] = ss.fit_transform(X_train)
        X_val.iloc[:, :] = ss.transform(X_val)

        model = XGBClassifier(seed=21, **params)
        model.fit(X_train, y_train)
        y_pred = model.predict(X_val)
        cv_scores.append(f1_score(y_val, y_pred))

    f1 = np.mean(cv_scores)

    return f1

xgb_study = optuna.create_study(study_name='XGBoost', direction='maximize', sampler=TPESampler(seed=21))
# non-scaled X_train_all
xgb_study.optimize(lambda trial: xgb_objective(trial, X_train_all, y_train_all), n_trials=30)
다른 모델 또한 위와 유사하게 하이퍼파라미터 탐색을 수행하였습니다.
다만, 실험 결과 하이퍼파라미터를 튜닝하지 않은 경우의 성능이 더 좋아 튜닝된 모델을 사용하지는 않았습니다.
모델 성능 확인
Soft Voting 구현
TabNet을 제외한 5개 모델의 예측 결과를 soft voting 합니다. TabNet을 제외한 이유는 이후 SHAP value 계산에 어려움이 있었기 때문입니다.
저장한 모델을 불러옵니다.
xgb = joblib.load('XGBoost.pkl')

resnet = rtdl.ResNet.make_baseline(d_in=X_test.shape[1],
                                   d_main=256,
                                   d_hidden=128,
                                   dropout_first=0.3,
                                   dropout_second=0.3,
                                   n_blocks=2,
                                   d_out=1)

resnet = torch.load('ResNet')
resnet.eval()

lgbm = joblib.load('LightGBM.pkl')

rf = joblib.load('RandomForest.pkl')

lr = joblib.load('LogisticRegression.pkl')
모델이 출력한 예측 확률을 모두 더한 후, 5로 나누어 최댓값이 1이 되도록 정규화합니다.
xgb_preds_proba = xgb.predict_proba(X_test.values)[:, 1]
lgbm_preds_proba = lgbm.predict_proba(X_test.values)[:, 1]
rf_preds_proba = rf.predict_proba(X_test.values)[:, 1]
lr_preds_proba = lr.predict_proba(X_test.values)[:, 1]
resnet_preds_proba = torch.sigmoid(resnet(torch.tensor(X_test.values, dtype=torch.float))).detach().numpy().reshape(-1, )

preds_proba = xgb_preds_proba + lgbm_preds_proba + rf_preds_proba + resnet_preds_proba + lr_preds_proba
preds_proba = pd.Series(preds_proba)

# normalize into [0, 1]
preds_proba_normalize = preds_proba / 5
preds_proba_normalize.describe()
출력
count    7185.000000
mean        0.152253
std         0.206912
min         0.000722
25%         0.017825
50%         0.061375
75%         0.193323
max         0.939831
dtype: float64
AUROC 점수를 확인해 보면 다음과 같습니다.
# Maximum AUROC in single model : 0.9215344134523918 (LightGBM)

print('Soft Voting AUROC (probability):', roc_auc_score(y_test, preds_proba_normalize))
출력
Soft Voting AUROC (probability): 0.9230151278038603
클래스(3일 내 사망하면 1, 아니면 0) 별 평균 예측 확률은 다음과 같습니다. 여기서 예측 확률은 5개 모델의 예측 확률을 모두 더한 후 5로 나눈 값을 의미합니다.
# probability groupby class label
preds_df = pd.concat([preds_proba_normalize, y_test.reset_index(drop=True)], axis=1)
preds_df.columns = ['Preds', 'Label']

preds_df.groupby('Label')['Preds'].describe()
출력
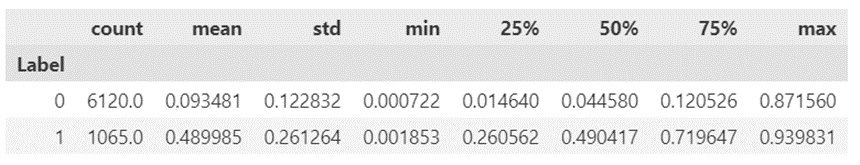
3일 내 사망한 경우 평균 예측 확률값이 0.489, 사망하지 않은 경우 0.093으로 확실한 차이를 보입니다.
Threshold 조절
지금까지는 추정된 확률이 0.5보다 클 때 레이블 1로 예측하였습니다. 허용할 수 있는 위양성 및 위음성 수를 고려하여, 다음과 같이 임계값을 조절할 수 있습니다.
test_pred_proba = np.where(preds_proba_normalize >= 0.1, 1, 0)

conf_matrix(y_test, test_pred_proba)
출력
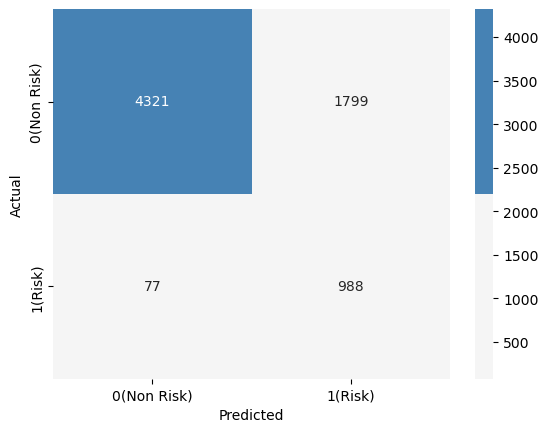
Accuracy: 0.7389004871259569
Recall: 0.927699530516432
Precision: 0.35450304987441694
F1: 0.5129802699896158
test_pred_proba = np.where(preds_proba_normalize >= 0.25, 1, 0)

conf_matrix(y_test, test_pred_proba)
출력
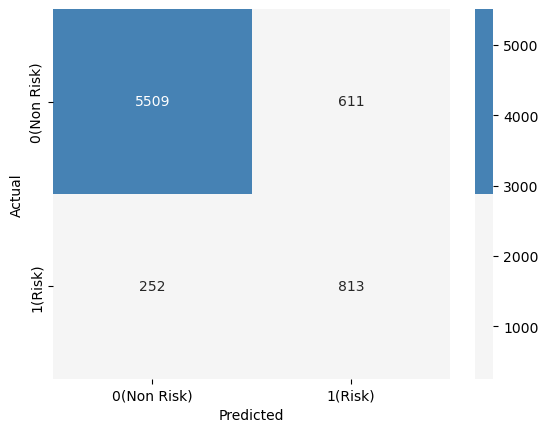
Accuracy: 0.8798886569241475
Recall: 0.7633802816901408
Precision: 0.5709269662921348
F1: 0.6532744073925272
test_pred_proba = np.where(preds_proba_normalize >= 0.5, 1, 0)

conf_matrix(y_test, test_pred_proba)
출력
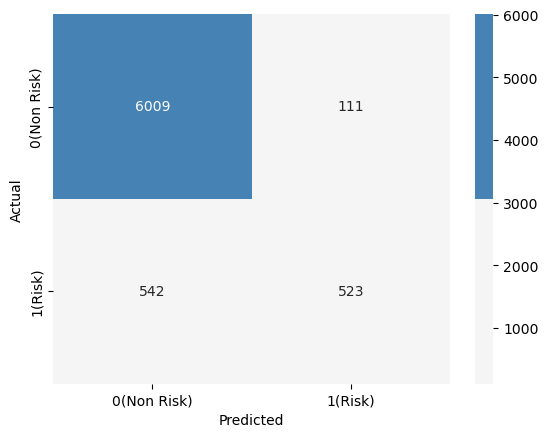
Accuracy: 0.909116214335421
Recall: 0.49107981220657276
Precision: 0.8249211356466877
F1: 0.6156562683931724
test_pred_proba = np.where(preds_proba_normalize >= 0.75, 1, 0)

conf_matrix(y_test, test_pred_proba)
출력
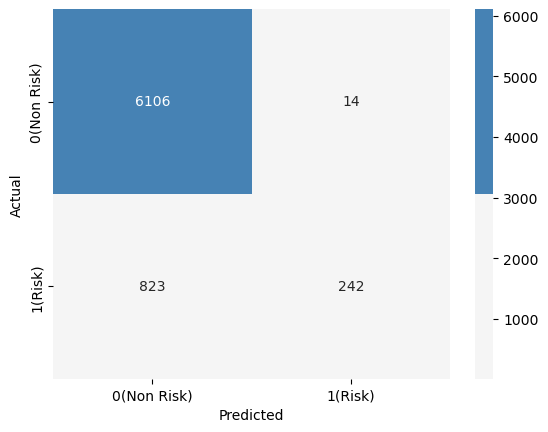
Accuracy: 0.8835073068893529
Recall: 0.2272300469483568
Precision: 0.9453125
F1: 0.3663890991672975
임계값이 변함에 따라 위음성 / 위양성의 수가 달라져 성능 지표들이 달라집니다. 정밀도와 재현율 간의 트레이드오프를 고려하여 적절한 임계값을 찾아야 하며, 이를 위해 오차 한계를 설정할 수 있는 도메인 전문가의 도움이 필요합니다.
특성 중요도 확인
5개 모델의 예측 결과를 사용하여 SHAP value를 계산합니다. 모델에 맞게 TreeExplainer / Explainer / DeepExplainer를 사용하였습니다. 다음은 XGBoost에 대한 예시입니다.
explainer = shap.TreeExplainer(xgb)
shap_values = explainer.shap_values(X_test)

pd.DataFrame(shap_values).to_csv('XGB_shap.csv')
5개 모델에 대한 계산을 끝낸 후, 아래와 같이 절댓값 합을 구하여 global 특성 중요도를 계산하였습니다.
xgb_shap = pd.read_csv('./XGB_shap.csv', names=X_test.columns, index_col=0, skiprows=1).reset_index(drop=True)
lgbm_shap = pd.read_csv('./LGBM_shap.csv', names=X_test.columns, index_col=0, skiprows=1).reset_index(drop=True)
rf_shap = pd.read_csv('./RF_shap.csv', names=X_test.columns, index_col=0, skiprows=1).reset_index(drop=True)
lr_shap = pd.read_csv('./LR_shap.csv', names=X_test.columns, index_col=0, skiprows=1).reset_index(drop=True)
resnet_shap = pd.read_csv('./ResNet_shap.csv', names=X_test.columns, index_col=0, skiprows=1).reset_index(drop=True)

assert xgb_shap.shape == lgbm_shap.shape == rf_shap.shape == lr_shap.shape == resnet_shap.shape == X_test.shape

global_shap = np.abs(xgb_shap) + np.abs(lgbm_shap) + np.abs(rf_shap) + np.abs(lr_shap) + np.abs(resnet_shap)
이 값이 클수록 예측에 있어 영향 있는 특성입니다. 상위 20개 특성을 확인해 보면 다음과 같습니다.
global_shap.sum().sort_values(ascending=False).head(20).plot.bar(figsize=(10, 5))
plt.show()
출력
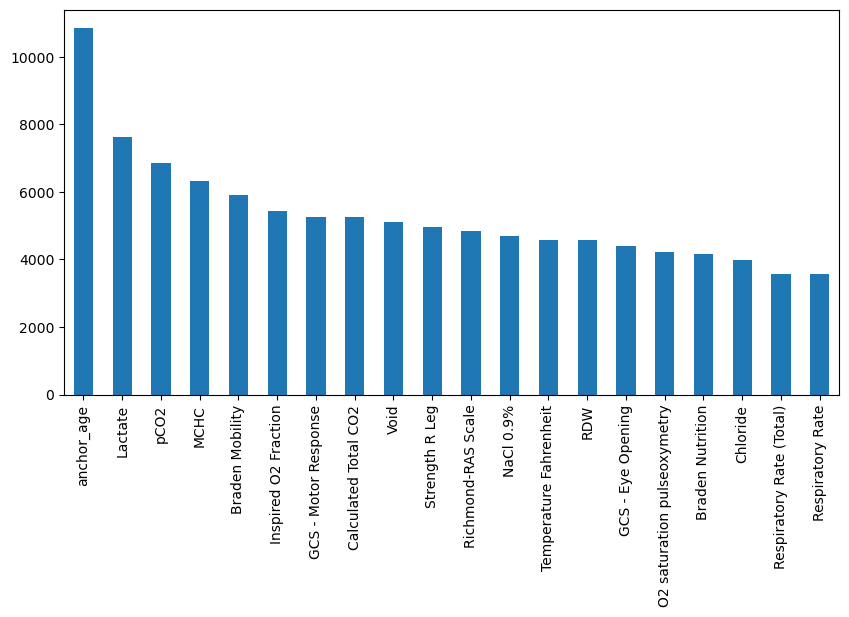
anchor_age는 나이, Lactate는 젖산, pCO2는 혈중 이산화탄소, MCHC는 평균 혈구 내 헤모글로빈 농도를 의미합니다. 위와 같은 특성이 환자 중증도 추정에 큰 영향을 미쳤습니다.
여기서 계산한 특성 중요도는 전체 환자에 대한 특성 중요도, 즉 global 한 경우입니다. 차후 각 환자별 특성 중요도 또한 계산해 봅니다.
웹페이지 구현
streamlit 라이브러리를 사용하여 간단한 웹페이지를 구현합니다.
앞서 저장했던 모델을 불러온 후, 입력된 환자의 데이터를 예측한 뒤 그 결과를 출력합니다. 예를 들면 아래와 같습니다.

위 이미지는 환자 5명의 데이터를 입력한 경우입니다. 2,809, 32,992 등은 환자의 id이며, mortality_in_3days는 3일 내 사망한 여부입니다. 실제 서비스에서는 필요가 없으나, 예측값과 비교하기 위하여 추가하였습니다.
Model Predict와 오른쪽의 그래프는 해당 환자에 대한 모델의 예측값입니다. 이 값이 1에 가까울수록 3일 내 사망할 확률이 높은 것이며, 해당 환자의 중증도가 심각한 것을 의미합니다.
또한 다음과 같이 환자 한 명의 데이터를 입력한 다음, 예측 확률과 함께 그 예측에 가장 많은 영향을 준 특성을 확인할 수도 있습니다.
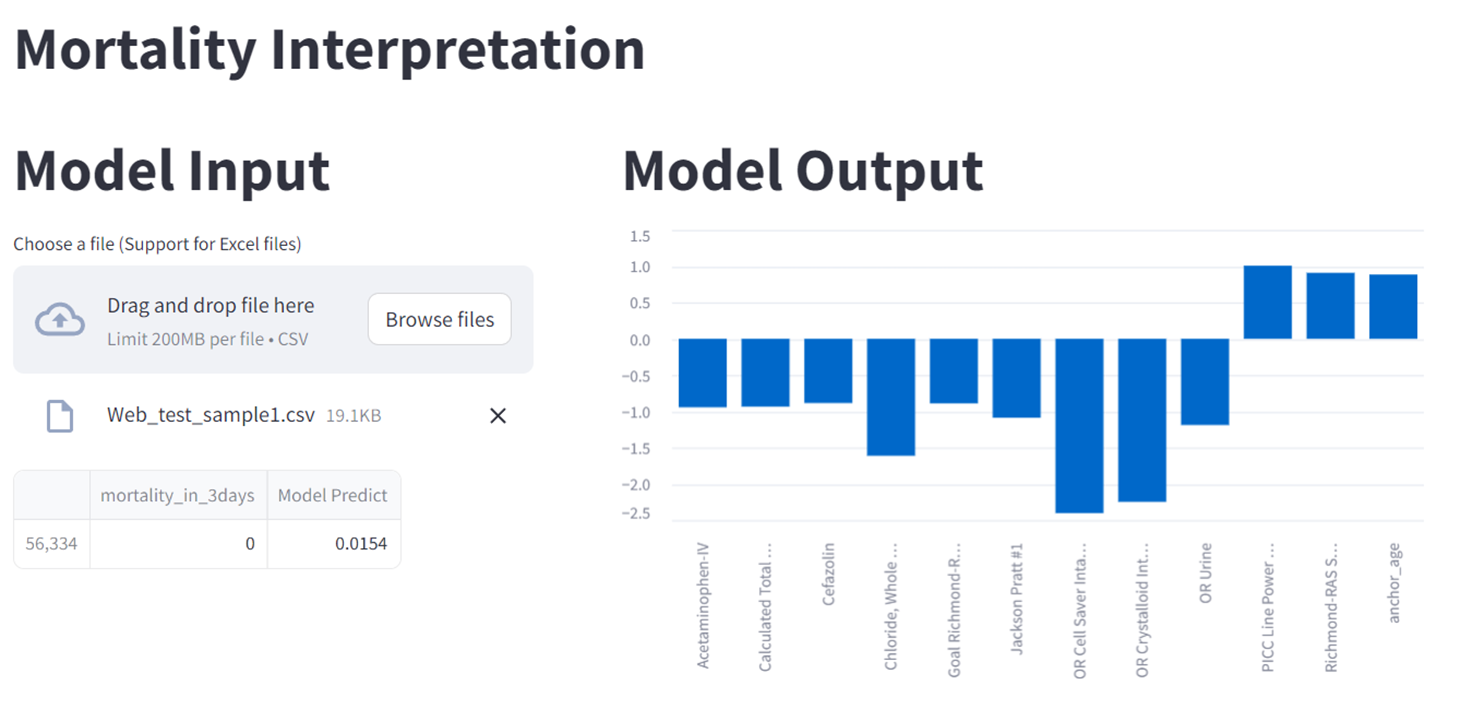
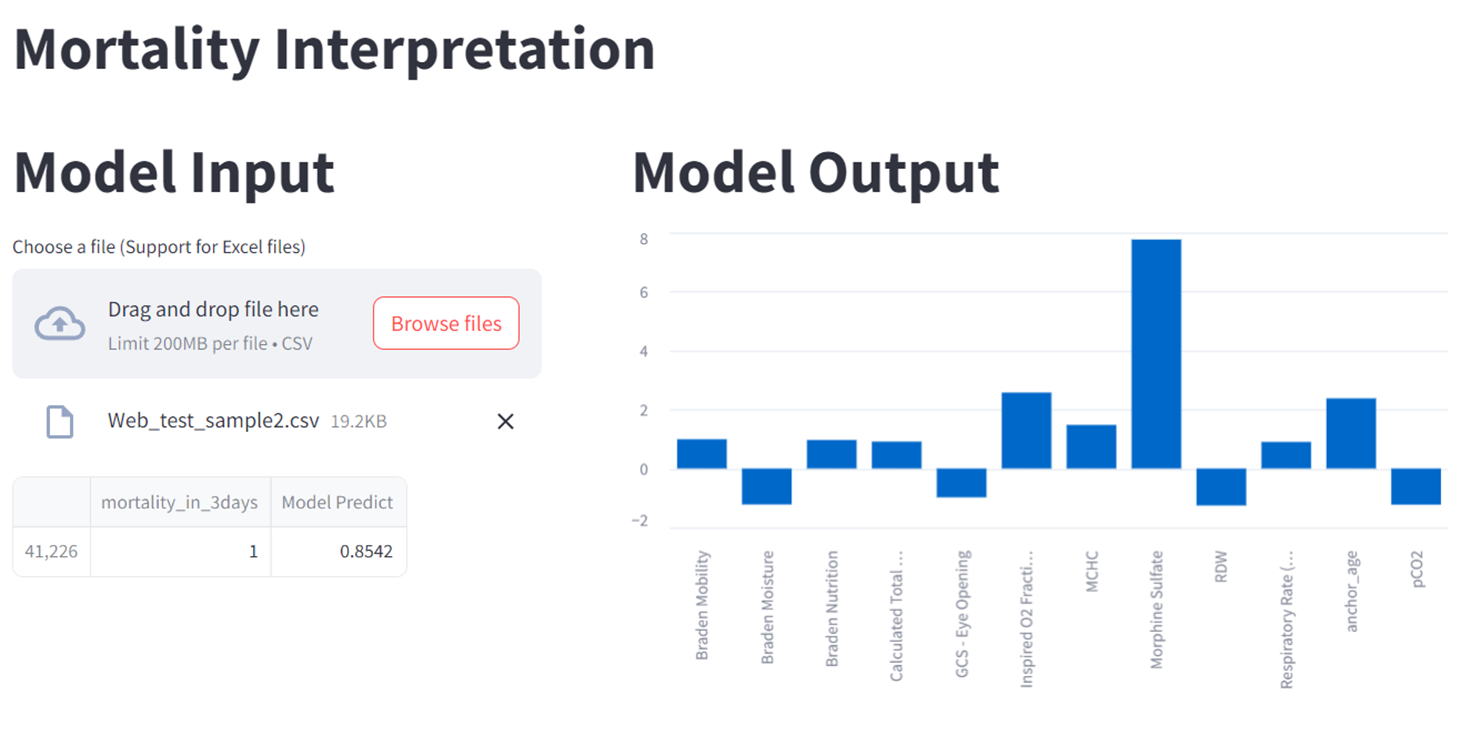
위의 이미지는 예측 확률이 0.0154, 아래 이미지는 예측 확률이 0.8542인 환자의 경우입니다.
오른쪽의 그래프는 각 환자의 사망 예측에 가장 많은 영향을 주었던 12개의 특성입니다. 각 환자의 예측 확률이 왜 그렇게 계산되었는지를 설명합니다. 이 또한 SHAP을 사용하여 계산하였습니다.
이렇게 각 환자에 대한 정보를 확인함으로, 사망에 영향을 주는 요인을 식별하고 추가적인 처치를 수행할 수 있을 것입니다.
마무리
본 프로젝트에서는 머신러닝 기법을 활용하여 중환자실에 입원하는 환자의 중증도를 보다 정확하게 추정하고자 하였습니다.
정밀한 중증도 추정으로 실제 위중한 환자를 식별하고, 해당 환자에게 자원을 집중할 수 있다면 의료서비스의 품질이 향상될 수 있을 것입니다.
또한, 특정 기간 및 특정 지역에 대한 평균적인 중환자 중증도를 계산하여 적절한 간호 인력 수요를 산정할 수 있습니다. 중증 환자가 많을수록 필요한 인력이 많을 것이므로, 해당 중환자실에 추가 인력을 파견하는 등 효율적인 자원 배분을 수행할 수 있을 것입니다.
다음은 프로젝트 한계점 및 추가 고려 사항입니다.
-
하드웨어 성능의 한계가 있어 데이터의 전체 특성을 사용하지 못하거나 하이퍼파라미터 튜닝에 어려움이 있는 등 모델 적합 수준의 한계가 존재하였음.
-
정밀도, 재현율 간의 트레이드오프를 고려하여 적절한 임계값을 찾는 방법이 필요함.
-
웹페이지에 입력하는 환자 데이터의 경우, 모델의 훈련 데이터와 동일한 형태를 가져야 함. 실제 raw 데이터에서 이를 자동으로 전처리할 수 있는 과정을 추가해야 함.
-
보다 엄격한 일반화 성능 확인을 위해, 테스트 세트를 분리한 후 마지막에서만 모델 성능을 확인해야 함.
이상으로 머신러닝 기반 중환자 중증도 추정 프로젝트에 대한 포스팅을 마치겠습니다.
더 자세한 코드 등은 제 github에서 확인하실 수 있습니다.
감사합니다.
