t-sne
t-SNE는 PCA 더불어 대중적(?)으로 사용되는 차원 축소 기법이다. 현업에서 사용되는 데이터는 수 ~ 수백 차원으로 이루어진 경우가 많은데, 이런 경우 데이터의 분포 확인이나 시각화 진행에 어려움이 있다. 이런 경우 보통 2~3차원으로 데이터를 축소하는데 이를 차원 축소라 말한다.
해당 실험은 resnet과 sam 이미지 인코더를 사용하여 이미지의 특징을 추출한 다음 이미지 벡터를 (x, y) 좌표로 차원을 축소시키고 시각화한다.
실험 데이터
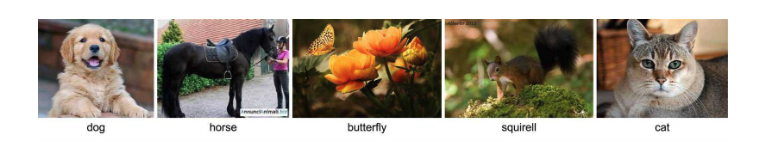
animal 10 이라는 데이터셋 중 일부와 cifar10을 사용하였다.
resnet
먼저 resnet 모델을 로드해준다
model = ResNet101(pretrained=True, model_path=model_path)
transform = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.ToTensor(),
])
model.eval()
그 다음 일반적인 데이터로더를 제작해주었으며, 원하는 샘플의 수 정도만 테스트 할 수 있게 self.sample_image 값을 받을수 있게 해주었다
def _load_images(self):
        images = []
        for cls in self.classes:
            class_path = os.path.join(self.root_dir, cls)
            class_idx = self.class_to_idx[cls]
            pic_count = 0
            for filename in os.listdir(class_path):
                img_path = os.path.join(class_path, filename)
                images.append((img_path, class_idx))
                pic_count += 1

                if self.sample_image is not None and pic_count == self.sample_image:
                    break
dataset = CustomDataset(root_dir=train_data_path, transform=transform,
sample_image=sample_image)
dataloader = DataLoader(dataset, batch_size=batch_size, shuffle=True)resnet을 사용하여 이미지의 특징을 추출한다
# Iterate over the data loader
for batch in tqdm(dataloader, desc='Running the model inference'):
    images = batch['image'].to(device)
    labels += batch['label']
    image_paths += batch['image_path']
    with torch.no_grad():
        output = model.forward(images)

    current_outputs = output.cpu().numpy()
    features.append(current_outputs)
특징들을 tsne로 차원축소를 해주고 플롯으로 시각화해준다
# Concatenate the features along the batch dimension
features = np.concatenate(features, axis=0)
tsne = TSNE(n_components=2).fit_transform(features) # n_components = 차원 수

tx = tsne[:, 0]
ty = tsne[:, 1]

tx = scale_to_01_range(tx)
ty = scale_to_01_range(ty)

# fig = plt.figure()
fig = plt.figure(figsize=(10, 10))
ax = fig.add_subplot(111)

num_classes = len(os.listdir(train_data_path))
classes = sorted(os.listdir(train_data_path))

num_to_class_name = {i: folder for i, folder in enumerate(classes)}
colors_per_class = {i: tuple(
    np.random.randint(0, 256, 3)) for i in range(num_classes)}

for label in colors_per_class:
    indices = [i for i, l in enumerate(labels) if l == label]
    current_tx = np.take(tx, indices)
    current_ty = np.take(ty, indices)

    color = np.array(colors_per_class[label], dtype=float) / 255

    label_directory = num_to_class_name[label]
    ax.scatter(current_tx, current_ty, c=color, label=label_directory)

ax.legend(loc='best')
plt.show()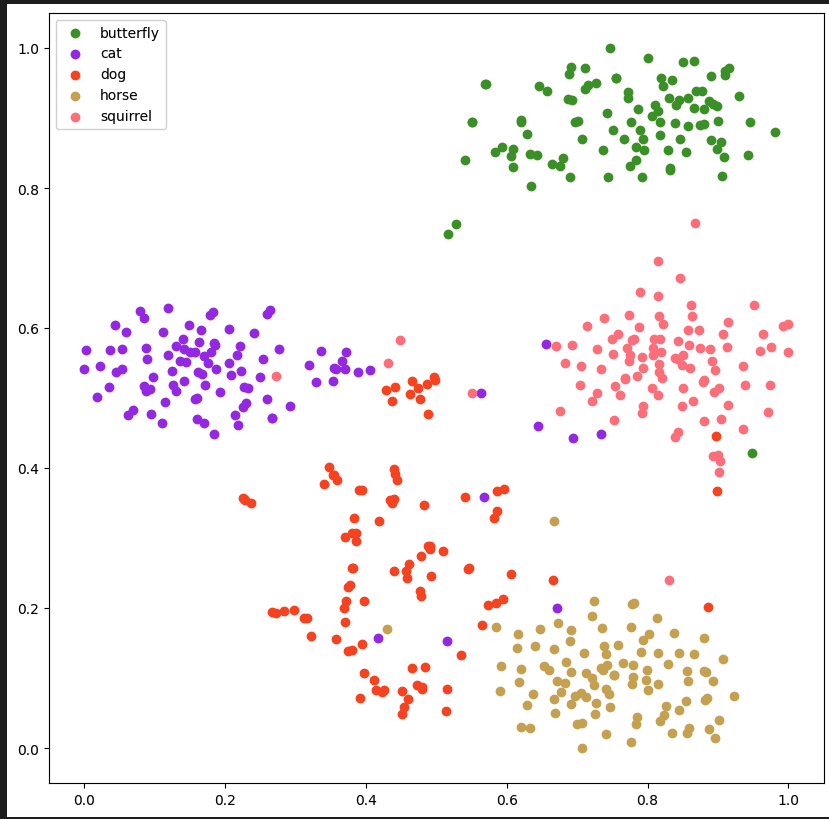 | 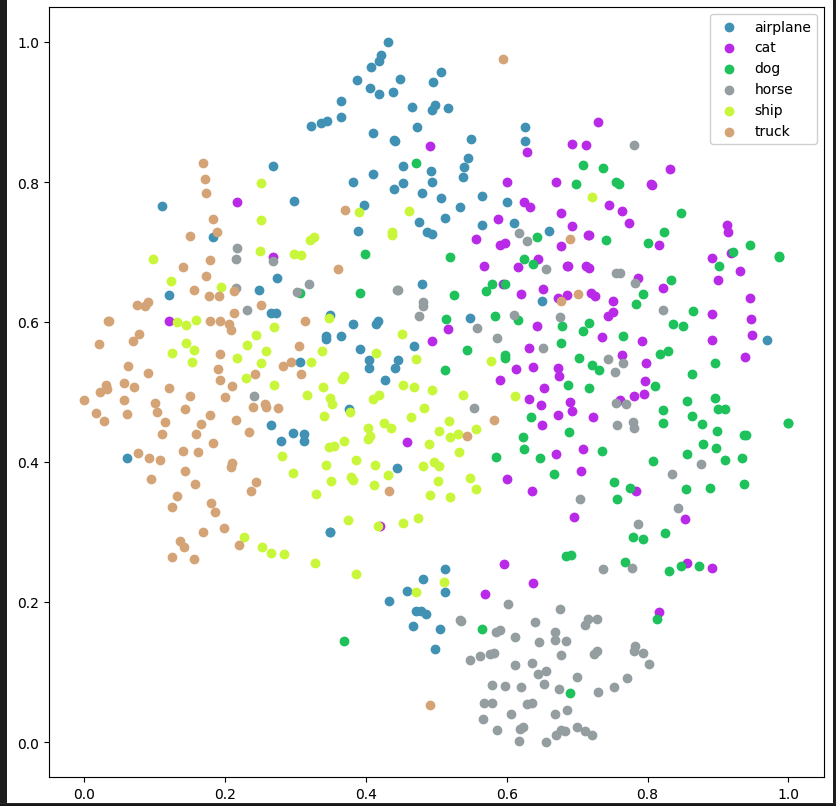 |
|---|
좌: animal 10
우: cifar 10
이 정도면 나쁘지않게 군집이 이루어져있는데?
segment anything image encoder
이 실험을 진행했을 당시 굉장히 놀라웠던 모델이었기에, 이 모델로 이미지 특징을 뽑으면 어떨까 궁금했다.
위와 같은 방식에 resnet 대신 Segment-Anything image-encoder를 사용하여 구현해보았다
def get_sam_predictor() -> SamPredictor:
    path = Path(settings.WEIGHTS_PATH)
    checkpoint_fp = path / settings.WEIGHTS_FILE
    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')

    sam_model = sam_model_registry["vit_h"](
        checkpoint=checkpoint_fp
    ).to(device)
    return SamPredictor(sam_model)

class EncodeModel(metaclass=Singleton):
    def __init__(self) -> None:
        self.predictor = get_sam_predictor()

    def get_image_embedding(self, image: str):
        buf = io.BytesIO(base64.b64decode(image))
        image = Image.open(buf)
        image = image.convert("RGB")

        self.predictor.set_image(np.array(image))
        features = self.predictor.get_image_embedding()

        return features
기존 sam의 인코더 모델만 따로 정의를 해서 이미지의 벡터를 추출하였다
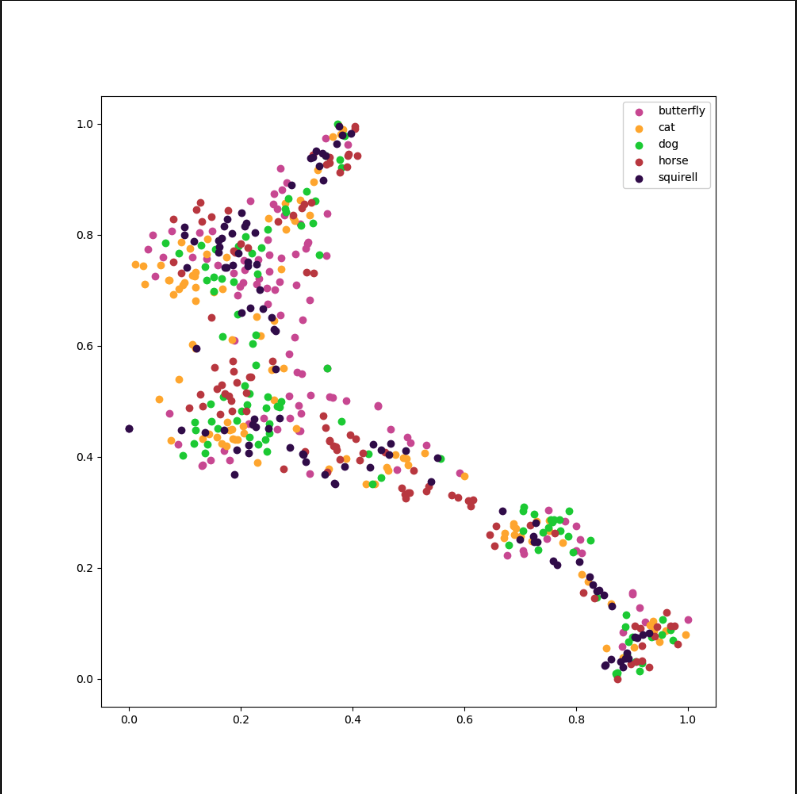 animal 데이터셋 결과인데 분류를 위해서 만들어진 모델이 아니라서 이런 결과가 나오는건가 싶었다...
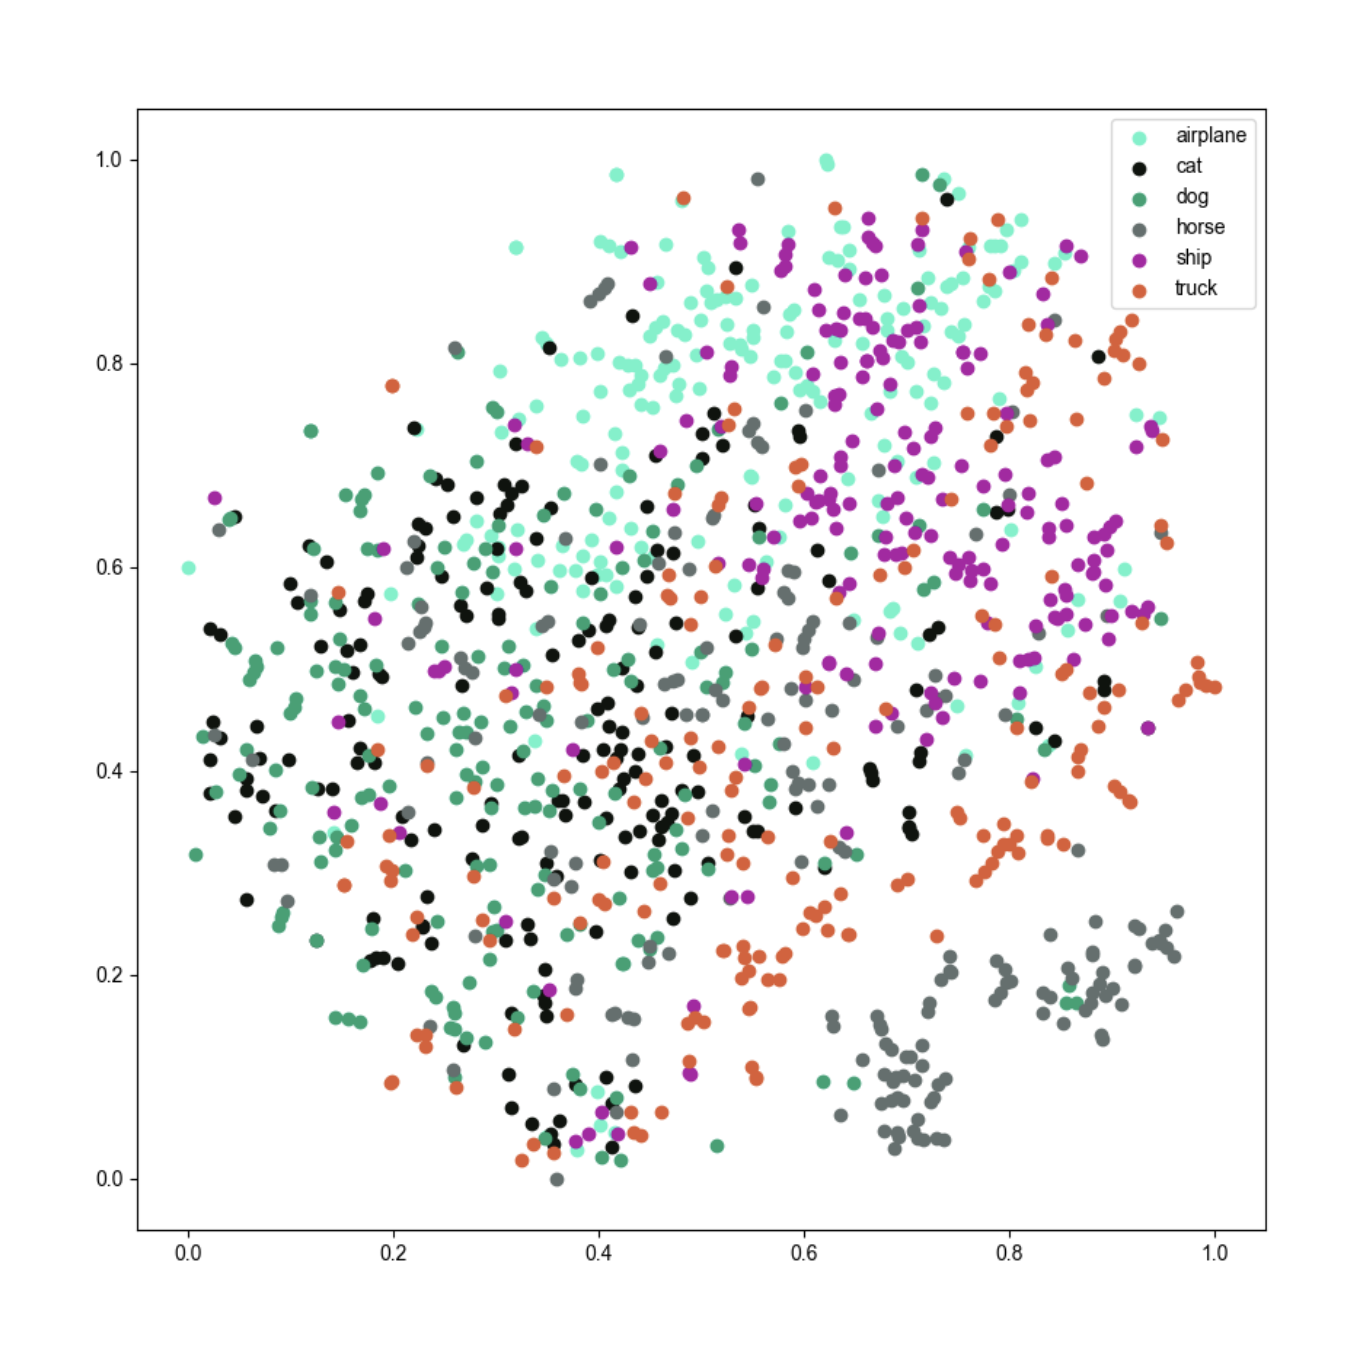 cifar 에서도 뭐 비슷한 성능인것 같네...
onnx resnet umap
이 이후로 umap이 좀 더 빠르고 정보의 손실 없이 차원 축소를 할 수 있다는 정보를 발견하여, umap 으로 변경하여서 실험하였다. 코드는 똑같고 차원 축소부분만 umap으로 변경하고, resnet에 onnx도 적용해보았다
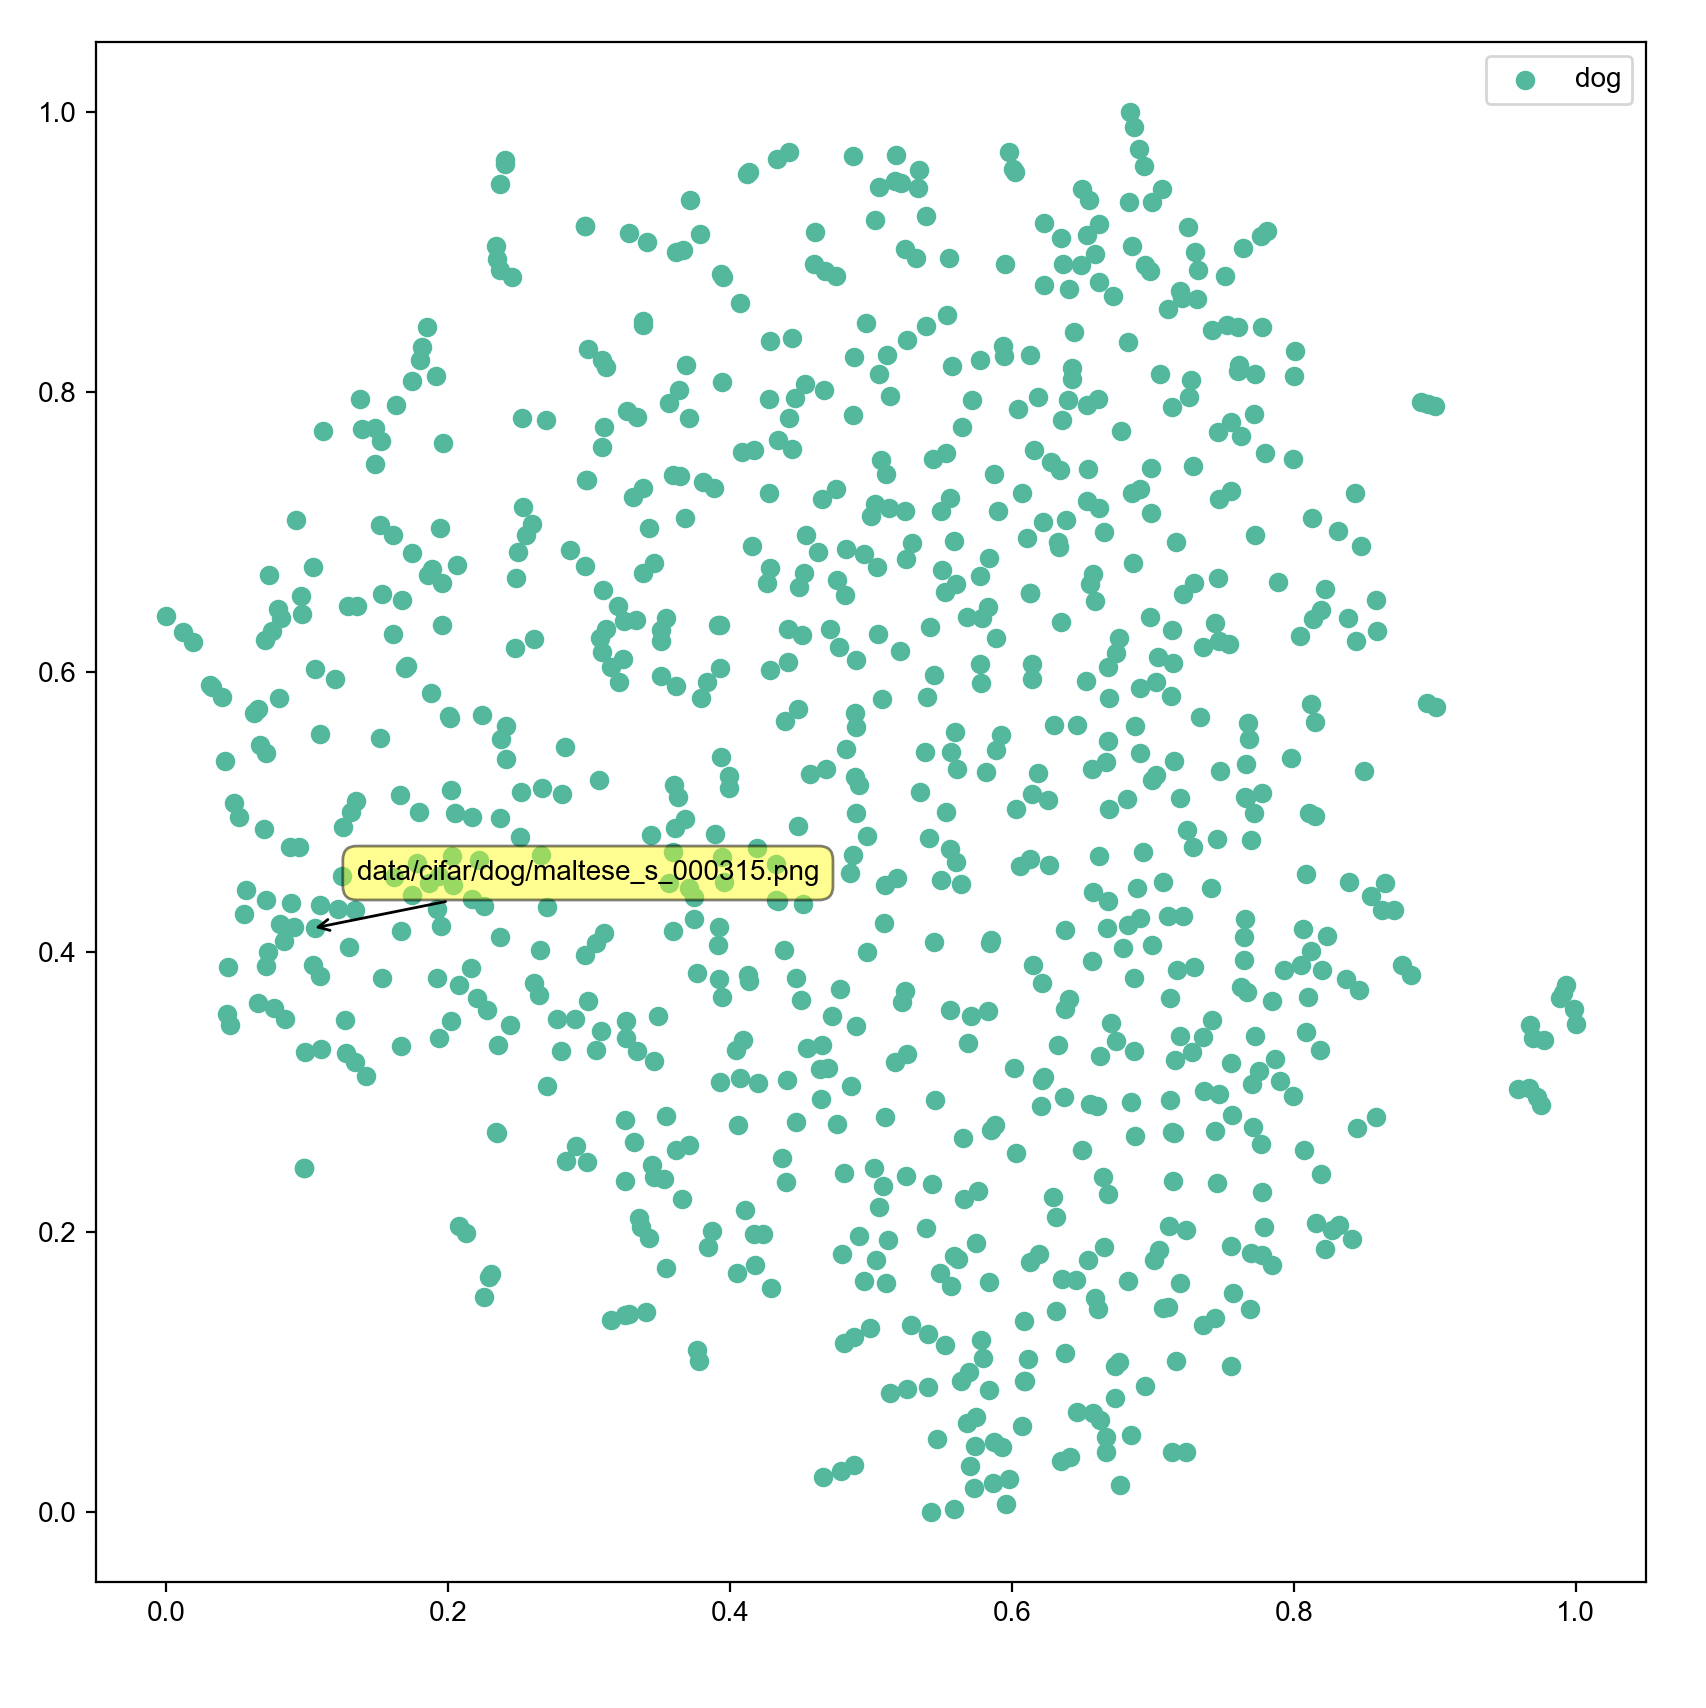
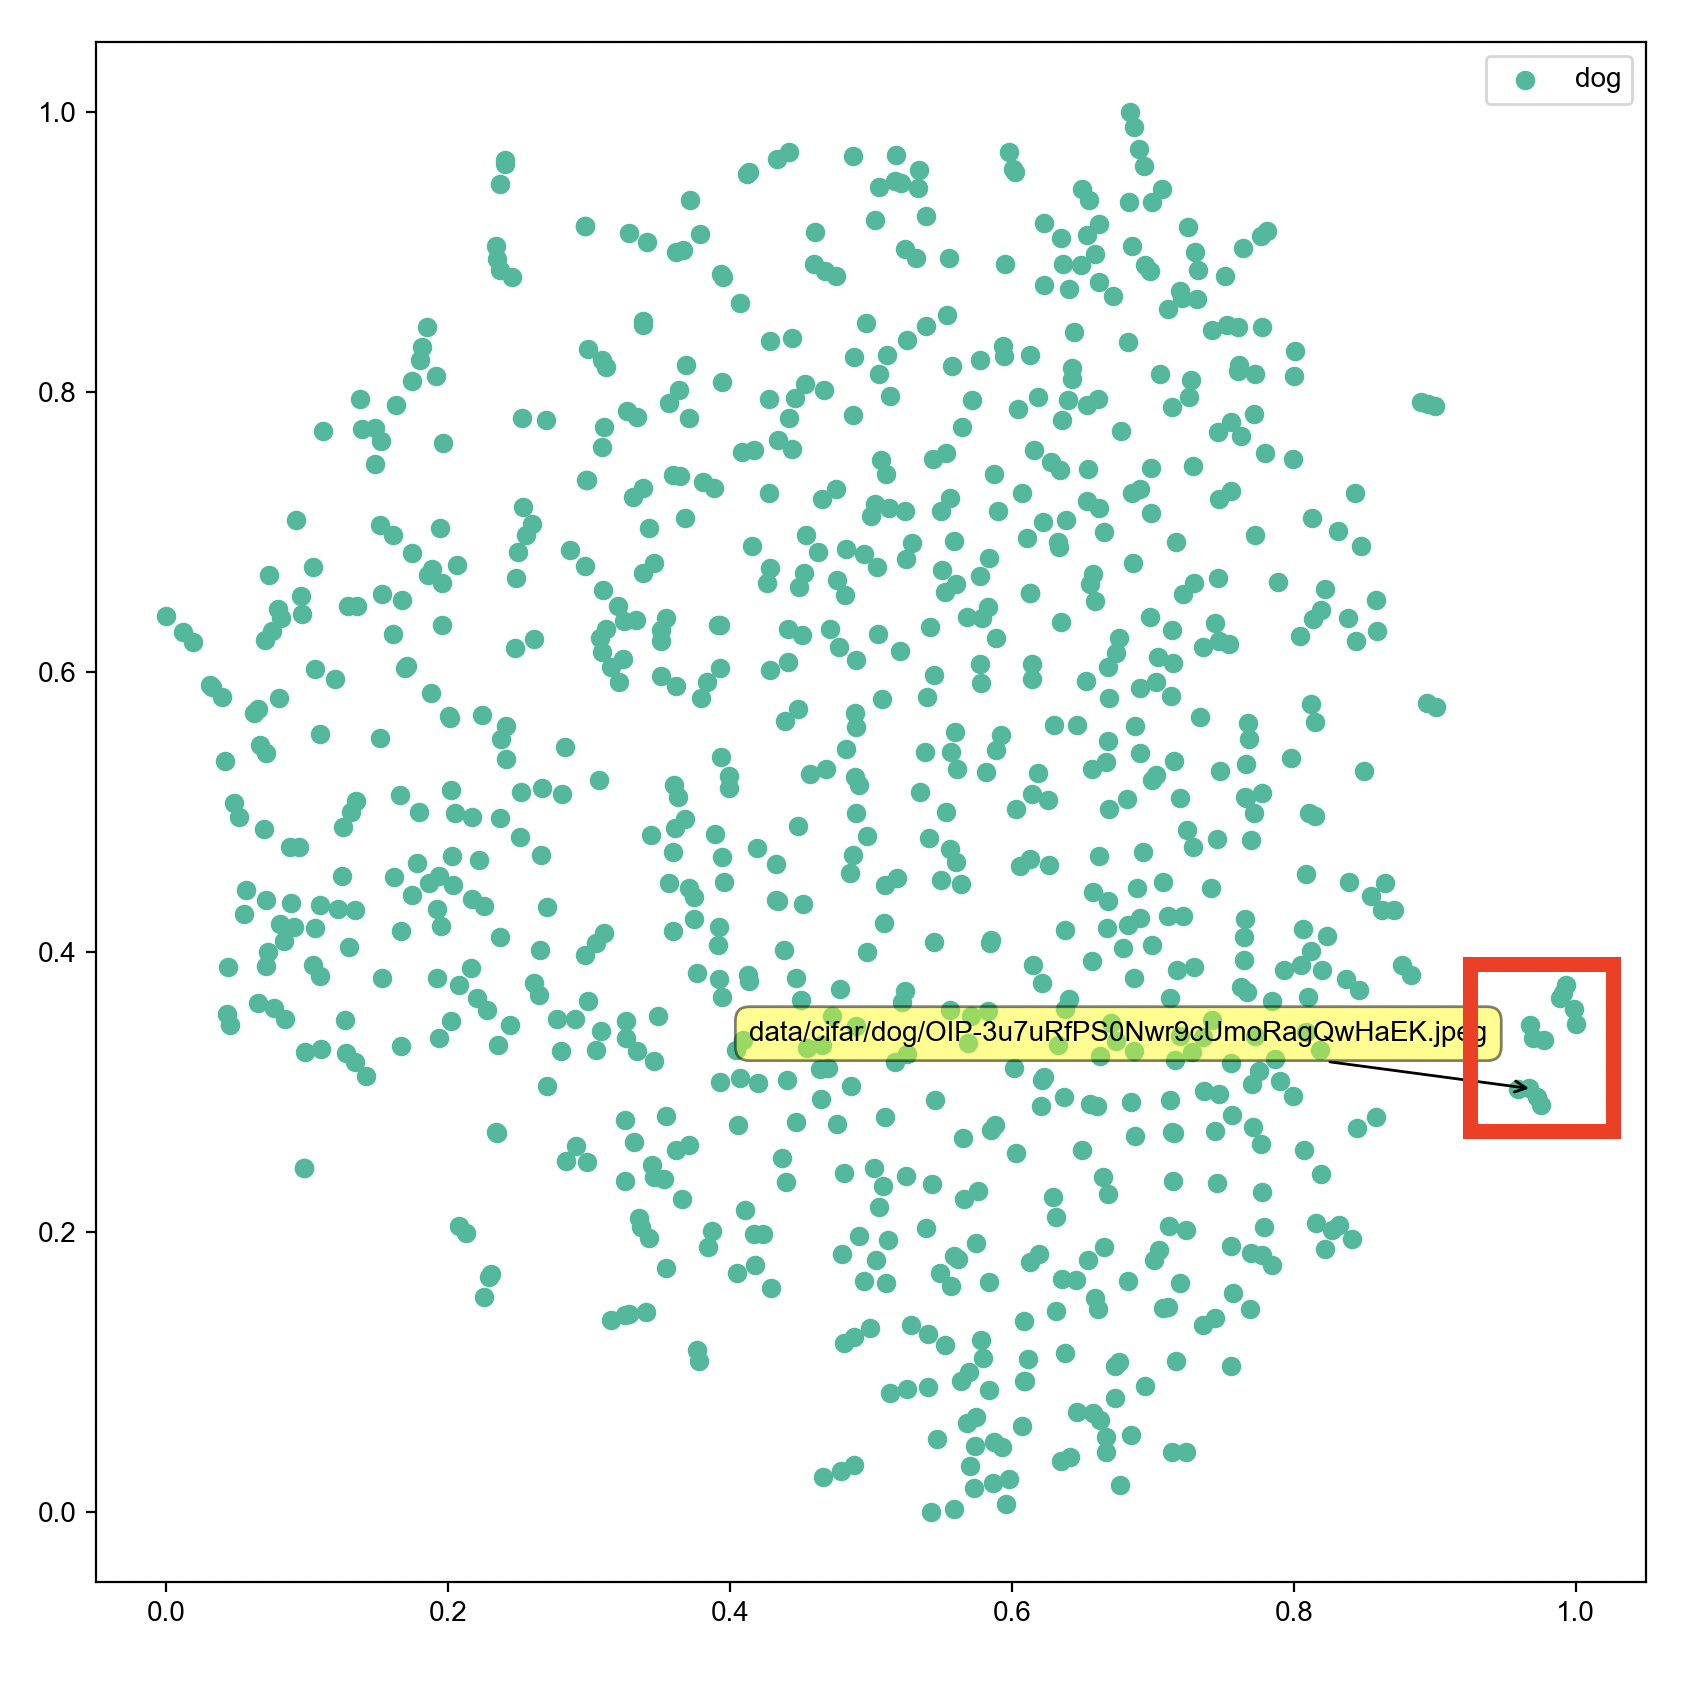
cifar 데이터 “dog” 디렉터리 안에 “butterfly” 데이터 일부 삽입하여 테스트 해보았다
resnet onnxruntime umap
 |  |
|---|
오... 확실히 빠르고 성능도 오른쪽에 따로 빠져있는 부분 나비 사진 군집을 확인 하였다
처리시간 (10,000장 기준) resnet (torch cpu) resnet (torch gpu) resnet (onnx cpu) sam (cpu) 인코딩 20 minute 20 second 10 minute 7 hour t-sne 3 minute 3 minute 3 minute 4 minute umap 1 minute 1 minute 1 minute 1 minute
이 기술을 사용하면 특이 케이스인 데이터를 발견하기 쉬울것 같고, 데이터의 오차를 줄이기 편할것같다
참고자료
시각화: t-SNE (t-Stochastic Neighbor Embedding)
t-SNE for Feature Visualization
t-Stochastic Neighbor Embedding (t-SNE) 와 perplexity
