[논문 리뷰] DeepLabV1 : Semantic Image Segmentation with Deep Convolutional Nets and Fully Connected CRFs
Abstract>
Deep Convolutional Neural Networks(DCNNs)를 pixel-level classification 문제를 해결하기 위해 사용합니다. DCNNs의 마지막 레이어에서의 특징은 정확한 object segmentation을 포착하기에 부족합니다. 이것은 DCNNs의 invariance 특징 때문입니다. 부정확한 localization문제를 DCNNs의 마지막 레이어에서의 responses와 fully connected Conditional Random Field(CRF)를 결합하여 해결합니다.
Introduction>
DCNNs는 classification에 대해서는 성공적으로 해내지만 오히려 low-level task인 semantic segmentation,pose-estimation과 같은 작업에 있어서는 "invariance"한 특징이 방해가 되는데
DCNNs를 image labeling task에 적용하기 위해서 두 가지 장애물이 있습니다. (1) down-sampling과 (2) invariance 입니다. 첫 번째 문제는 max-pooling과 stride=2인 down-sampling에 의해 발생합니다. 이 문제를 해결하기 위해 'astous'(with holes) 알고리즘을 적용합니다 두 번째 문제를 해결하기 위해서 Conditional Random Field(CRF)를 사용합니다.
(1) signal down sampling (기존 DCNN의 각 계층(max-pooling, downsampling/stride)을 지나면서 feature resolution의 감소한다.
(CNN의 네트워크는 네트워크가 깊어질수록 feature들의 크기가 작아진다.))-> by employ the 'atrous(hole) algorithm'
(2) spatial insensitivity(invariance)(localization을 요구하는 semantic segmentation에서는 spatiacl accuracy를 제한)
-> by employ a fully-connected conditional random field(CRF)
The three advantafes of our "DeepLab" system are 1)speed,2)accuracy,3)simplicity
Related Work>
pixel representation(->2-stage approaches)
and The main difference between our model and other state-of-the-art models is the combination of pixel-level CRFs and DCNN-based 'unary'term
: 이 모델과 다른 모델의 큰 차이점은 pixe-level CRFs와 DCNn-based unary term의 조합이다는 점이다.
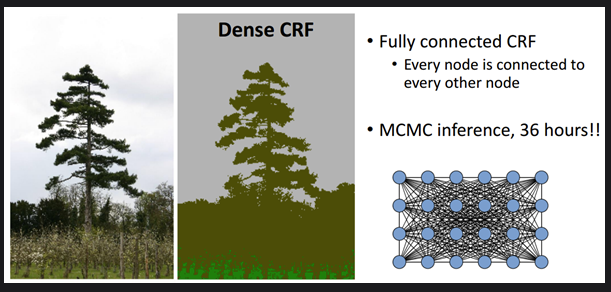
모든 pixel을 CRF 노드로 취급하고, long range dependency를 활용하고, CRF inference를 사용하여 DCNN 기반 비용 함수를 직접 최적화한다.
Convolutional Neural Networks for Dense Image Labeling>
이 파트에서는 VGG-16을 semantic segmentation을 위해 어떻게 수정하고 fine-tunning하는지 소개합니다.
semantic segmentation에서 dense spatial score evalution은 중요합니다. 이것을 구현하기 위해 첫 번째로, VGG-16의 fully connected layer를 convolutional로 변경했습니다. 하지만 이것은 stride of 32 pixel인 sparsely를 생성하기 때문에 무언가가 더 필요합니다. 신경망에서 마지막 두 개의 max-pooling layer을 제거합니다. 그리고 conv filter를 다음과 같이 수정합니다.

3.2 Controlling the receptive field size and acceleration dense computation with convolutional net
dense score computation을 위해서 신경망의 receptive field size를 조절합니다. 신경망의 fully connected layer를 fully convolutional로 변경할 때, 첫 번째 fully connected layer는 7x7 수용영역에서 4,096개의 필터를 갖습니다. 그리고 이것은 computational bottleneck이 됩니다. 이 문제를 해결하기 위해서 첫 번째 fc layer의 수용영역을 4x4로 변경합니다. 이것으로 2~3배의 속도 향상이 있습니다. fc layer를 통과하기 전에 마지막 피쳐맵의 크기를 4x4 사용합니다.
Detailed boundary recovery: fully-connected conditional random fields and multi-scale prediction>
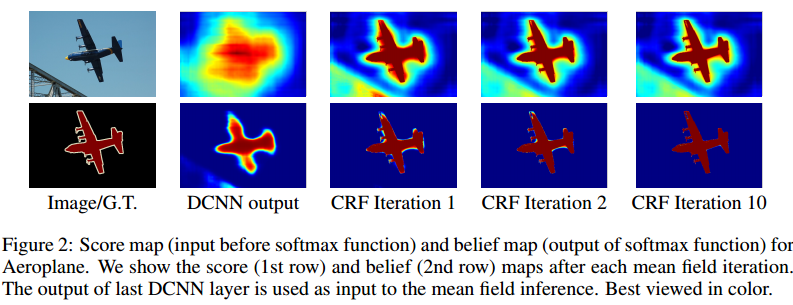
위 그림을 보면 DCNN의 score map은 객체의 대략적인 위치와 존재만을 예측합니다. 하지만 경계는 잘 못잡아내는 모습을 보여주고 있습니다. 다수의 max-pooling layer를 지닌 깊은 모델은 classification에서 성공적 이지만, invariance와 큰 receptive field는 위치를 포착하는데에 문제가 됩니다. 이 문제를 해결하기 위해 두 가지 접근법이 있습니다. 첫 번째는 객체 경계를 좀 더 잘 예측하기 위해 다수의 레이어에서의 정보를 묶는 것입니다. 두 번째 접근법은 super-pixel representation을 적용하는 것입니다.
-> 경계를 잘 예측하지 못한다는 단점을 보완하기 위해 다수의 레이어에서 정보를 묶는 방법과 super-pixel representation을 적용하는 방법을 취합니다.
한줄정리>
DCNNs를 image labeling task에 적용하기 위해서 두 가지 장애물이 있습니다. (1) down-sampling과 (2) invariance 입니다. 첫 번째 문제는 max-pooling과 stride=2인 down-sampling에 의해 발생합니다. 이 문제를 해결하기 위해 'astous'(with holes) 알고리즘을 적용합니다 두 번째 문제를 해결하기 위해서 Conditional Random Field(CRF)를 사용합니다.
각각을 간단하게 설명하면 VGG-16의 FC 계층을 convoluiton 계층으로 바꾸고, 마지막 max-pooling layer 2개를 제거한다. 그리고 "hole algorithm"을 적용해서 넓은 receptive field를 볼 수 있게 했는데
(a) 기본적인 convolution (kernel=3)
(b) 확장계수(rate)이 2인 atrous convolution
학습할 파라미터마다 rate만큼 공간을 띄우고, 그 공간에 0을 채워서 receptive field의 크기를 조절하는 방법이다.
atrous convolution을 사용하면 같은 kernel 크기로 연산량은 유지하고 receptive field의 크기는 커지게 된다.

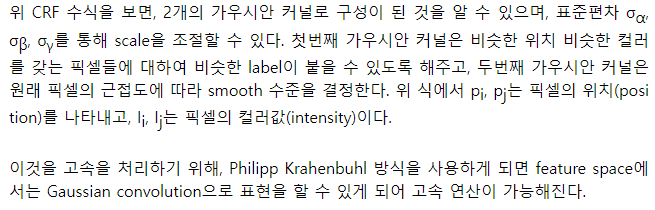
위 CRF의 수식은 2개의 가우시안 커널로 구성된다. 알파, 베타, 감마를 통해서 scale을 조정한다.
1) 첫 번째 커널은 비슷한 위치 비슷한 색상을 갖는 픽셀들에 대하여 비슷한 label이 붙게 한다. (pixel position&color intensity 사용)
2) 두 번째 커널은 픽셀의 근접도에 따라 smooth 수준을 결정한다. (pixel position만 사용)
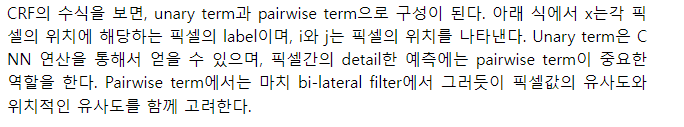
추가적으로 DeepLab은 boundary localization 정확도를 높이기 위해 multi-scale prediction도 시도하여 성능을 높인것 또한 알 수 있습니다.
추가 개념)
Atrous convolution에는 convolution layer에 dilation rate라는 개념이 추가됩니다. dilation rate란 아래와 같이 각 kernel pixel 사이의 간격(사실 비어있는 kernel pixel의 값은 0)을 의미합니다.
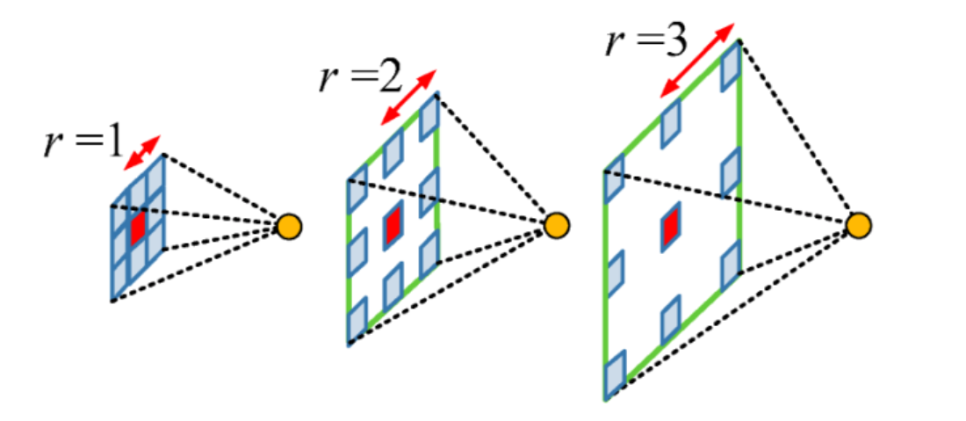
위 그림처럼 3x3 kernel을 dilation rate=2와 함께 사용하게 되면 오직 9개의 파라미터를 사용하여 5x5 kernal이 연산하는 영역과 동일한 범위를 연산할 수 있습니다.
이를 통해서 동일한 computational cost를 통해서 더 넓은 영역을 살펴볼 수 있습니다.
DeepLab V1 Design 정리)
DCNN의 출력 coarse score map을 bi-linear interpolation으로 upsampling 해서 기존 이미지의 크기로 확대한다. 이후 full-connected CRF로 결과를 정제해서 정확도를 높인다.
1. intermediate layer에 multi scale feature 사용
-
fully-connected CRF로 segmentatin result를 정제(refinement)
-
large FOV(field of view, input stride를 증가시킴) 계산 속도 증가
reference>
https://deep-learning-study.tistory.com/564
https://m.blog.naver.com/PostView.nhn?blogId=laonple&logNo=221017461464&proxyReferer=https:%2F%2Fwww.google.com%2F
https://doubleyoo.tistory.com/3
[출처] ASPP(Atrous Spatial Pyramid Pooling)|작성자 muke0822
https://blog.naver.com/h22hyeon/222247290992
