[논문리뷰] DeepLabv2 : Semantic Image Segmentation with Deep Convolutional Nets,Atrous Convolution,and Fully Connected CRFs
Abstract>
DeepLabV2는 VGG16, ResNet101에 일반적인 convolution을 ASPP(Atrous spatial pyramid pooling)으로 대체해 연산량은 적지만 큰 범위의 receptive field를 커버하도록 하여서 커다란 object를 다 cover할 수 있도록 하였습니다. 또한 max pool, stride 2를 가진 conv를 atrous conv로 대체하여 비교적 큰 feature map을 가질 수 있도록 하였습니다. 그리고 CRF(Conditional Random Field)를 이용해 predicted sementic information을 더 자세하고 조밀하게 recovering 하였다. PASCAL VOC-2012에서 79.7%의 IOU 결과로 1등을 해 높은 성능을 증명했다.
Introduction>
1. reduced feature resolution
reduce feature resolution기존 DCNN 모델에서는 receptive field가 더 많은 영역을 cover하도록 pooling과 stride를 사용해 down sampling을 진행했다. 하지만, feature map의 사이즈를 계속 줄이면서 feature resolution이 저하되는 문제점이 발생했다.또한, upsampling이 필요한 구간에서는 deconvolution보다 연산이 간단한 bilinear interpolation을 사용하였다.
그래서 본 논문에서 atrous convolution을 제안해 적은 연산량으로도 넓은 field를 cover할 수 있도록 하였다. atrous convolution을 통해 이미지 사이즈를 보존할 수 있게 되었고, 결과적으로 원래의 DCNN 보다 feature map의 사이즈가 더 크다.
2. existence of objects at multiple scale
이미지에는 다양한 크기의 물체들이 존재한다. 좁은 공간부터 넓은 공간을 적은 연산량을 가지고 cover하기 위해 다양한 rate의 atrous convolution을 사용하여 다양한 공간의 feature를 추출했다.
성능이 향상 되지만, 기존 atrous convolution보다 계산량이 증가한다는 단점이 있다.
3. reduced localization accuracy due to DCNN invariance
DCNN은 깊은 layer일 수록, 공간적 정보를 소실하고 물체의 추상적인 정보를 가지게 된다. model의 output에 공간적 정보를 더하기 위해 윗단의 convolution layer의 feature maps의 정보를 합해주는 skip layer를 사용할 수 있고, CRF(fully connected conditional random field)를 사용해 매우 자세하게 segmentated 정보를 얻을 수 있다. 본 논문에서는 CRF 방식을 사용해 소실된 위치 정보를 회복했다.DeepLab V2은 ResNet101을 기반으로 DCNN+CRF 구조를 생성했으며, VGG16을 사용한 DeepLab V1보다 더 높은 성능을 가졌다.
FCN를 CNN로 변경하여 spatial한 정보를 보존하였고, atrous conv를 사용해 feature resolution의 저하를 막았다(기존 8 pixels feature map → 32 pixels feature map). CRF로 결과를 refine하여 더 정확하고 detail한 semantic 결과를 얻을 수 있었다.
Method>

입력 이미지가 들어왔을 때 DCNN으로 만든 score map을 Bi-linear Interpolation을 통해 키우고 CRF로 디테일을 살린다는 면에서 Deeplabv1과 동일하다.
여기서 resolution이 줄어들어 생기는 문제를 해결하기 위해 DCNN 내 몇 pooling layer를 없애고, atrous convolution이 사용되었다.
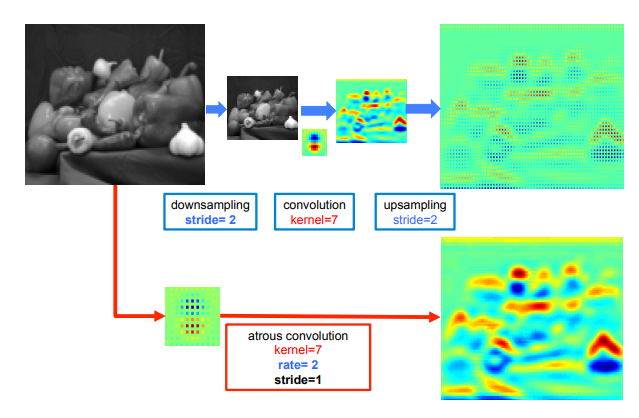
위 그림에서도 알 수 있듯, stride=2로 둬서 downsampling이 이루어진 경우 upsampling을 했을 때 coarse한 score map이 생기는 반면, atrous convolution을 거쳤을 때엔 resolution이 줄어들지 않아 upsampling이 필요없으며 dense한 score map이 생김을 알 수 있다.
v1과 v2가 atrous convolution이 사용된 DCNN이 사용되는 점에서 동일하나, 차이점이 있다면 뒤에 ASPP 모듈이 붙는다는 것이다.

ASPP (Atrous Spatial Pyramid Pooling) 모듈은 위와 같이 생겼다. 주황색 픽셀을 분류하기 위해 다양한 dilation rate를 이용해서 나온 다양한 스케일의 피쳐를 사용한다.
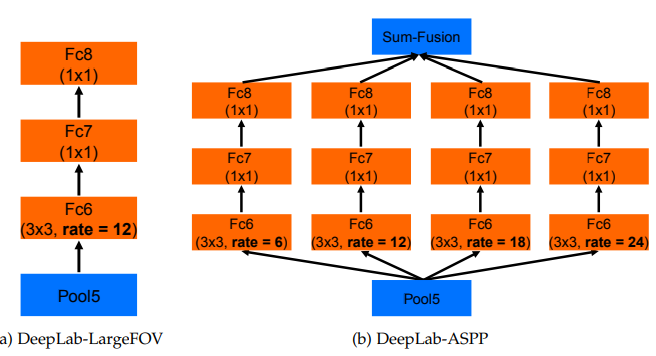
전체적인 구조를 보면, Deeplab v1(왼쪽)에서 VGG16의 pool5 뒤로 rate=12를 가진 하나의 3x3 convolution layer를 거친 뒤 1x1 convolution으로 classify를 했다면, Deeplab v2(오른쪽, DeepLab-ASPP)에서는 네 개 rate(6, 12 ,18, 24)로 convolution layer를 병렬로 돌린 것을 sum하여 최종적인 결과를 얻어낸다.
Experimental Results>
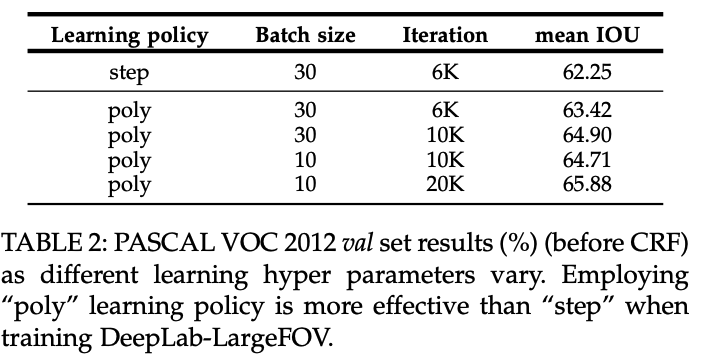
learning late를 조절할 때, step 방식보다 poly 방식이 더 좋은 성능을 보여줬다고 한다. step 방식은 고정된 step size로 learning rate를 줄이는 방식이고, poly는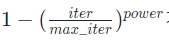 가 계속 곱해지는 형태로 정의된다.
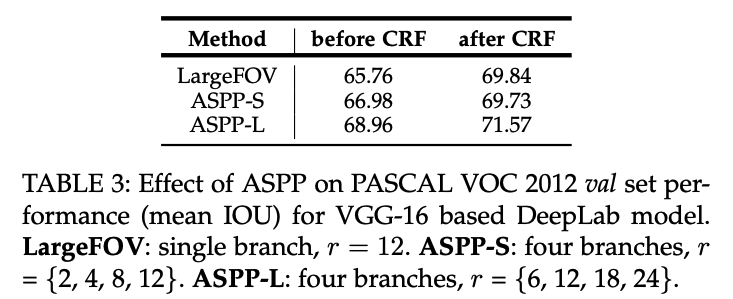
ASPP에서 각각의 r(rate)의 크기에 따른 성능 변화도 확인할 수 있다.
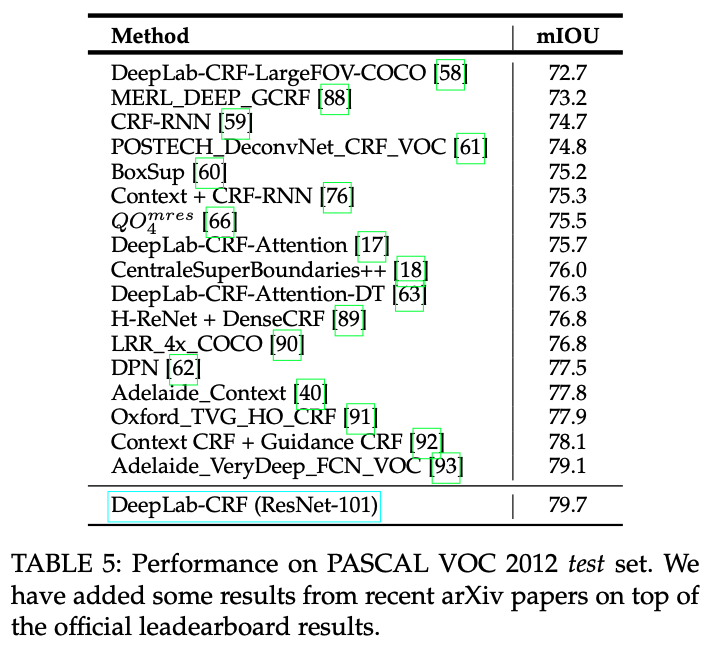
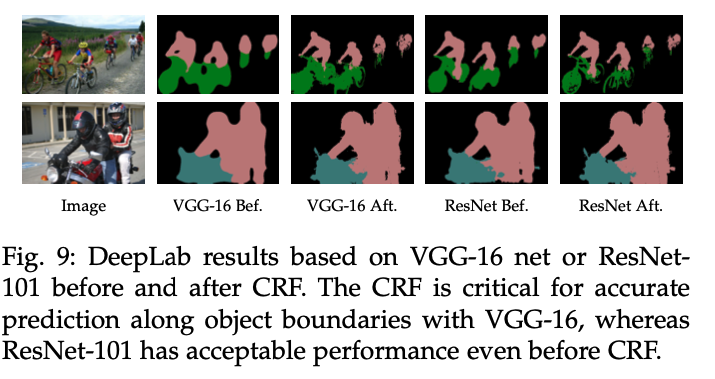
V1과 달리 backbone을 VGG-16이 아니라 ResNet-101을 사용했고, 그것이 성능이 더 좋았다고 한다.
한줄정리>
Deeplabv1이 DCNN 부분에서 atrous convolution을 사용하고, CRF를 사용한 것에 집중했다면, Deeplabv2는 atrous convolution을 사용한 DCNN 부분에 다양한 dilation rate를 사용한 atrous convolution을 하는 ASPP 모듈을 사용하여 multi-scale object를 segment할 수 있음을 강조했다. 또한 backbone을 VGG가 아니라 ResNet을 사용한 점이 있다.
references>
https://jlog1016.tistory.com/86
https://noteforstudy.tistory.com/entry/Deeplab-v2-%EB%85%BC%EB%AC%B8-%EB%A6%AC%EB%B7%B0
https://velog.io/@ckd248/%EB%85%BC%EB%AC%B8-%EB%A6%AC%EB%B7%B0-DeepLab-Semantic-Image-Segmentation-withDeep-Convolutional-Nets-Atrous-Convolutionand-Fully-Connected-CRFs-DeepLab-v2
