[논문리뷰]DeconvNet:Learning Deconvolution Network for Semantic Segmentation
Abstract>
DeconvNet은 2015년도 CVPR에 소개된 논문으로 FCN의 한계를 극복한 논문입니다.
FCN의 단점들을 보자면 첫 번째는 fixed-size receptive field 때문에, 신경망이 오직 하나의 scale 이미지만 다를 수 있습니다. 그러므로 receptive field보다 작거나 큰 객체는 mislabeled 되거나, fragmented된다는 단점이 있습니다.
따라서 그림과 같이 큰 객체가 작은 객체 여러개로 분해되거나 작은 객체가 거의 검출이 안되는 것을 볼 수 있었습니다.이 문제를 해결하기 위해 FCN은 skip architecture를 제안했지만, 근본적인 해결책이 되지는 않았습니다.
두 번째는 deconvolution 과정이 간단합니다. FCN에서는 Skip Connection을 적용해서 FCN16s, 8s을 사용해서 Maxpooling에 의해서 정보가 손실되기전의 특징맵을 활용하는 모습을 보였습니다. 하지만, 이는 성능적으로 아직 불충분한 모습이 있습니다.
이러한 upsampling은 좋은 성능를 얻기가 어렵다는 특징이 있었습니다.
따라서 이러한 문제점을 보완해서 저자들이 주장하는 것이 DeconvNet입니다.
Architecture>
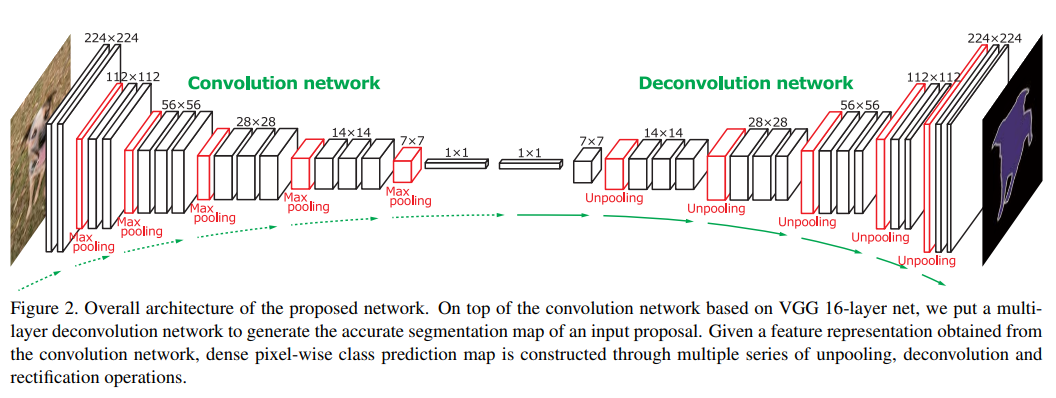
DeconvNet의 구조는 크게 Convolution Network(Encoder)와 Deconvolution Network(Decoder) 부분으로 구성되어 있으며, 대칭적인 특징을 가지고 있습니다. Encoder는 VGG16에서 마지막 Classification Layer를 제거한 형태를 가집니다.

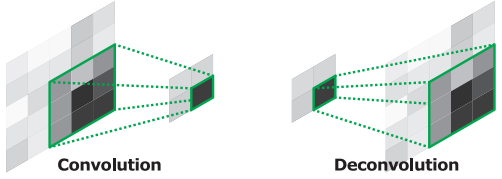
convolution은 입력 이미지에서 특징을 추출하기 위해 사용하고, deconvolution은 convolution이 추출한 특징에서 segmentation을 수행합니다.
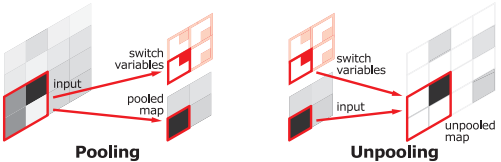
max pooling 연산을 할 때, max value의 index를 저장합니다. 그리고, unpooling을 할때, 저장한 index에 max value를 복원합니다.이를 통해 위치정보를 저장 및 복원할 수 있습니다.
unpooling 과정을 거치면 피쳐맵의 크기가 확대되고, sparse한 값(대부분이 0)을 갖습니다. deconvolution 연산을 통해 dense 피쳐맵을 만듭니다.

layer가 낮은 (b)에서 layer가 높은(j)까지 진행되는 과정을 보면 overall한 이미지에서 complex 즉, finer한 mask를 생성하는 것을 볼 수 있습니다.
논문의 내용을 정리하자면 Unpooling( (c) (e) (g) (i))은 example-specific를 captures함으로써 reconstructs the detailed structure of an object in finer resolutions하는 즉, 자세한 구조를 잡아내는 역할을 하고,
deconvolutional layers( (b) (d) (f) (h) (j))는 class-specific shapes를 capture하는 경향이 있어서 noisy activations에는 amplify되고, 나머지 지역에 대해서는 suppressed되도록 하는 즉,빈 공간을 채운 자세한 모양을 잡아내는 역할을 하는 것을 알 수 있습니다.
Training>
Batch Normalization
DNN은 Internal-covariate-shift 때문에 최적화하기 어렵고, 이를 해결하기 위해서 batch normalization을 적용합니다.
Two-stage Training
일반적인 이미지 분류는 테스크가 쉽지만, Segmentation은 픽셀단위의 분류를 하기에 Optimal을 찾는 과정이 더 어렵고 local optimal을 탈출하기가 어렵습니다.
그렇기에, 1stage에서는 하나의 객체만 포함하도록 해서 쉬운 테스크를 진행하고 2stage에서는 좀 더 어려운 이미지로 학습을 진행합니다.
Inference>
DeconvNet은 individual instance에 대해서 semantic segmentation을 수행합니다.
그리고 이때 individual instance를 생성하기 위해 input image를 window sliding을 통해서 충분한 수의 candidate proposals를 만듭니다. 이후, 이에 대해 semantic segmentation을 수행하고 proposals에 대해서 나온 모든 결과를 aggregate해서 전체 이미지에 대한 결과를 생성합니다.
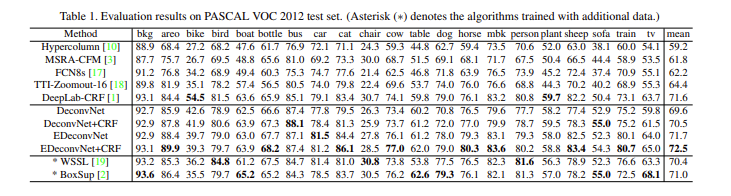
추가적으로, FCN과 앙상블시에 성능이 향상됩니다.
DeconvNet은 fine-details를 잘 잡는 반면에, FCN은 overall shape를 추출하는데 강점을 가지고 있습니다
둘을 독립적으로 시행후에 Ensemble 하고, CRF를 적용하면 가장 좋은 결과가 나옵니다.
Experiments>

한줄정리)
FCN의 단점들인 fixed-size receptive field로 인해 과 복원과정의 단순함인 Skip Connection을 보완하여서 Unpooling과 DeConvolution을 통해 큰 객체가 작은 객체 여러개로 분해되거나 작은 객체가 거의 검출이 안되는 FCN의 단점들을 극복하였습니다. DeconvNet의 구조는 크게 Convolution Network(Encoder)와 Deconvolution Network(Decoder) 부분으로 구성되어 있으며, 대칭적인 특징을 가지고 있습니다. Encoder는 VGG16에서 마지막 Classification Layer를 제거한 형태를 가집니다. Unpooling과 DeconvNet 각각은 자세한 구조를 잡아내는 역할과 noisy activations에는 amplify하여 자세한 모양을 잡아내는 역할을 수행하였으며 추가로 DeconvNet만 사용하였을 때는 FCN에 비해 noisy한 결과가 도출되기도 하였는데 FCN과의 앙상블 후 CRF를 적용하는 것을 통해 가장 좋은 성능을 낼 수 있도록 고안하였습니다. 추가적으로 둘을 독립적으로 시행후에 Ensemble 하고, CRF를 적용하면 가장 좋은 결과가 나옵니다.
추가)
CRF는 Computer Vision task에서 CRF는, 이미지의 각 픽셀이 특정 클래스에 속할 확률을 계산하여 최종 Segmentaion 결과를 도출하는 것을 말합니다.
- CRF는 은 아래와 같은 특징을 가지고 있습니다.
a) 그래프 기반의 모델(GNN)로써, Node와 Edge로 구성됩니다. Node는 관측된 변수(예: 이미지 픽셀 등)을 나타내며, 엣지는 노드 간의 상호작용을 나타냅니다.
b) 확률적 모델로써, 랜덤 변수들 간의 조건부 확률 분포를 정의합니다.
c) 조건부 모델링을 수행하는데, 관측된 변수의 조건하에서 다른 변수들의 확률 분포를 학습하거나 추론합니다. 즉, 이미지 Segmentation에서는 각 픽셀의 레이블을 예측하는 것은 주어진 이미지에 대한 레이블 분포를 학습하는 조건부 모델링 작업이 되는 것입니다.
-
CRF 모델의 구성
Unary potential : 각 픽셀이 특정 클래스에 속할 확률
Pairwise potential : 픽셀 간의 관계를 나타내며, 픽셀 간의 공간적 관계 및 색상적 유사성 등을 고려
Higher-order potential : 3개 이상의 픽셀 간의 관계를 의미
-CRF 학습 방법
Maximum likelihood 추정 : 학습 데이터의 log likelihood를 최대화하는 모델을 학습
구조적 SVM : CRF 모델을 SVM으로 학습
Gibbs sampling : MCMC 방법을 사용하여 CRF 모델 학습 -
CRF와 같은 작업은 픽셀 단위의 세밀한 예측이 필요하다는 측면에서, object-centric한 classifcation task를 할 때 큰 Receptive field와 다수의 Max pooling layer를 통해 global한 특징 추출에 초점을 맞추고 있다는 점이 Segmentation task에서는 한계가 된다는 부분에 착안하여 CV task에 사용되었습니다.
- Fully Connected CRF란?
-
이와 같이 CRF는 픽셀 단위 분류를 하는 Segmentation에서 예측 과정간 발생하는 noise들을 없애기 위해 사용되었습니다. 하지만, 보통 중간 단계에서 후처리를 하는 Short range CRF가 대부분이었습니다.
-
일반적인 DCNN에서는 여러 단계의 conv + pooling을 거쳐 feature map의 크기가 작아지고 그것을 upsampling 하는 과정에서 원래 크기의 이미지로 복원하기 때문에, Upsampling 과정에서 smoothing 현상이 이미 발생합니다. 이 과정에서 CRF를 적용한다면, 즉 smoothing 된 서로 차이가 크지 않은 픽셀들에 CRF를 적용한다면 결과가 더 나빠질 수 있습니다.
-
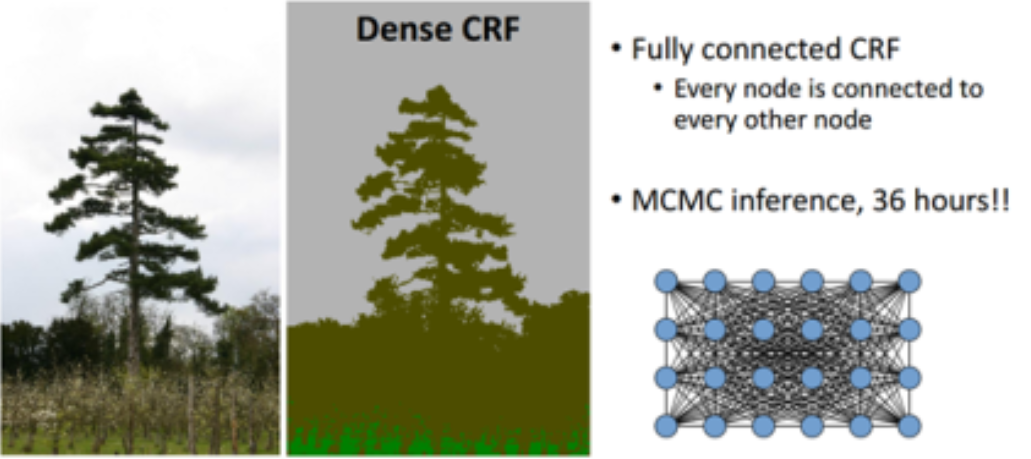
이것에 대한 해결책으로 나온 것이 Fully Connected CRF입니다.
* 기존의 Short range의 CRF를 적용시 아래 그림 처럼 local connection 정보만을 사용하게 되어 detail한 정보를 얻을 수는 없게 됩니다.

- 반면, fully Connected CRF를 사용하게 되면 아래 그림 처럼 detail한 결과를 얻을 수 있습니다.
출처: https://jaylala.tistory.com/entry/개념정리Fully-Connected-CRFs란 [Innov_AI_te:티스토리]
reference)
https://arxiv.org/pdf/1505.04366
출처: https://eda-ai-lab.tistory.com/519 [TEAM EDA:티스토리]
https://geunuk.tistory.com/467
https://deep-learning-study.tistory.com/565
출처: https://jaylala.tistory.com/entry/개념정리Fully-Connected-CRFs란 [Innov_AI_te:티스토리]
