FCN은 Semantic Segmentation 모델을 위해 기존에 image classification에서 우수한 성능을 보인 CNN 기반 모델(AlexNet, VGG16, GoogLeNet)을 목적에 맞춰 변형시킨 것이다.
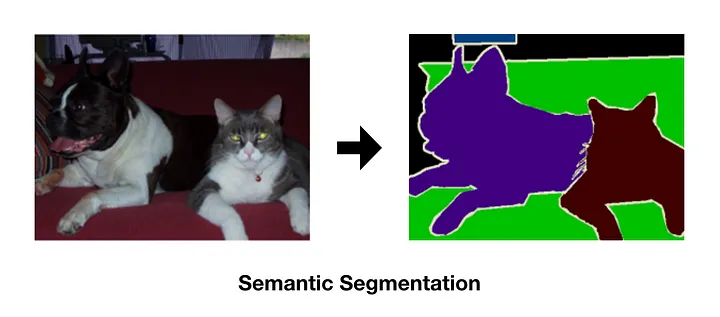
각 핵심 keywords를 이해함으로써 논문을 이해해 보도록 하겠습니다.
1. Convolutionalization
2. Deconvolution (Upsampling)
3. Skip architecture
Convolutionalization>
기존의 classification 모델이 갖는 내부구조는 주로 출력층 부분이 FC 즉, fully connected layer로 되어있는데 이때 fc-layer가 갖는 한계가 이미지의 위치정보가 사라진다는 특징이 있습니다. 그런데 이 점이 segmentation에서의 목적인 원본 이미지의 각 픽셀에 대해 클래스를 구분하고 인스턴스 및 배경을 분할하는 것으로 위치 정보가 매우 중요하다는 점에서 큰 약점이 되고, 따라서 fc-layer를 Conv-layer로 대체하였습니다. 그렇게 함으로써 원본 이미지의 위치 정보를 내포할 수 있게 되었으나 semantic segmentation의 최종 목적인 픽셀 단위 예측과 비교했을 때, FCN의 출력 Feature map은 너무 coarse(거친, 알맹이가 큰)하여서 원본이미지 크기에 가까운 Dense map으로 변환할 필요가 있었습니다.
Deconvolution (Upsampling)>
이렇게 Coarse map에서 Dense map으로 변환하는 방법에는 Interpolation
Deconvolution
Unpooling
Shift and stitch
와 같은 것들이 있는데 각각을 보면
1)Interpolation
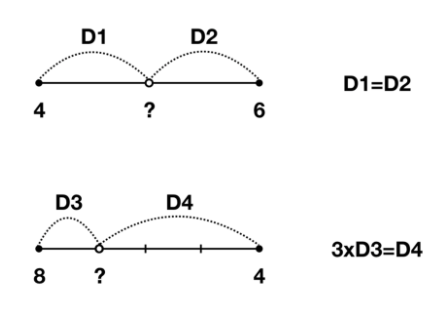
1D의 경우부터 살펴보면 위의 값은 5, 아래의 값은 7이라는 것을 쉽게 알 수 있는데 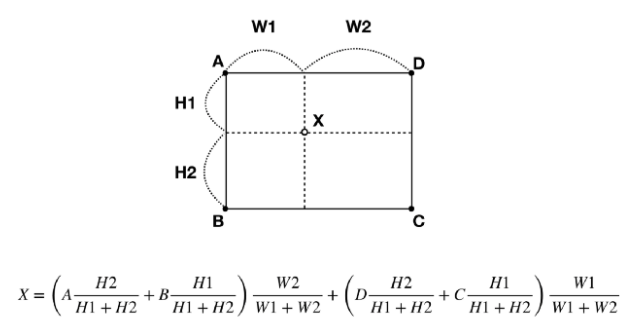
이를 2D로 확장하면 x,y 좌표를 각각 계산하면 된다. 이와 같은 방법으로 저해상도의 이미지를 고해상도의 이미지로 확장할 때 비어있는 중간값들을 유추하여 채워줄 수 있다.
2)Deconvolution
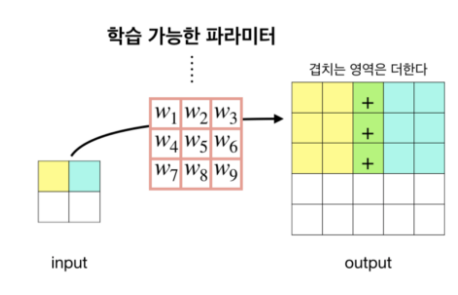
Deconvolution은 Convolution의 역연산이다.겹치는 영역은 더해서 구해주면 Upsampling된 output을 얻을 수 있다.
하지만 2가지 방식 전부 이미 크게 줄어든 상태의 feature map으로부터 추정을 하는 형태기 때문에 여전히 정보손실은 클 수 밖에 없다.
3.Unpooling
Pooling을 적용하지 않는 방법이다. 이 경우 필터가 더 세밀한 부분을 볼 수는 있지만 Receptive Field가 줄어들어 이미지의 컨텍스트를 놓치게 된다.또한, Pooling의 중요한 역할 중 하나는 특징맵의 크기를 줄임으로써 학습 파라미터의 수를 감소시키는 것인데, 이러한 과정이 사라지면 파라미터의 수가 급격히 증가하고 이로인해 더 많은 학습시간을 요구하게 된다.
4.Shift and stitch
max pooling을 하고 위치 정보를 저장하여 원래의 이미지 크기로 upscaling하는 방식, but 계산 비용이 크고 이보다 skip connection을 사용한 upsampling이 더 효과적으로 판단되어서 이 방법은 사용되지 않습니다.
Skip architecture>
본 논문에서는 Segmentation을 얻기 위해
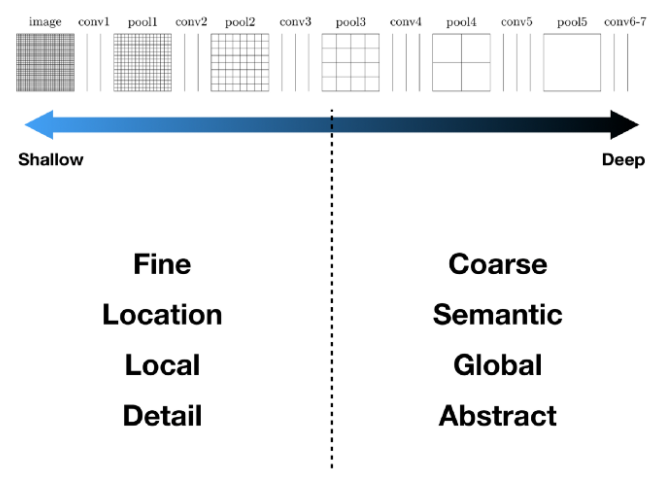
Deep & Coarse(추상적인) 레이어의 의미적(Semantic) 정보와 Shallow & fine 층의 외관적(appearance) 정보를 결합한 Skip architecture를 정의합니다.
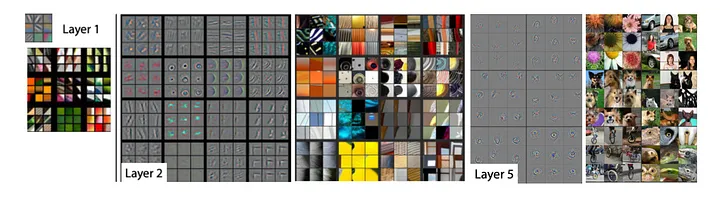
시각화 모델을 통해 입력 이미지에 대해 얕은 층에서는 주로 직선 및 곡선, 색상 등의 낮은 수준의 특징에 활성화되고, 깊은 층에서는 보다 복잡하고 포괄적인 개체 정보에 활성화된다는 것을 확인할 수 있다.또한 얕은 층에선 local feature를 깊은 층에선 global feature를 감지한다고 볼 수 있습니다.
이러한 직관을 기반으로 앞에서 구한 Dense map에 얕은 층의 정보를 결합하는 방식으로 Segmentation의 품질을 개선하였습니다.
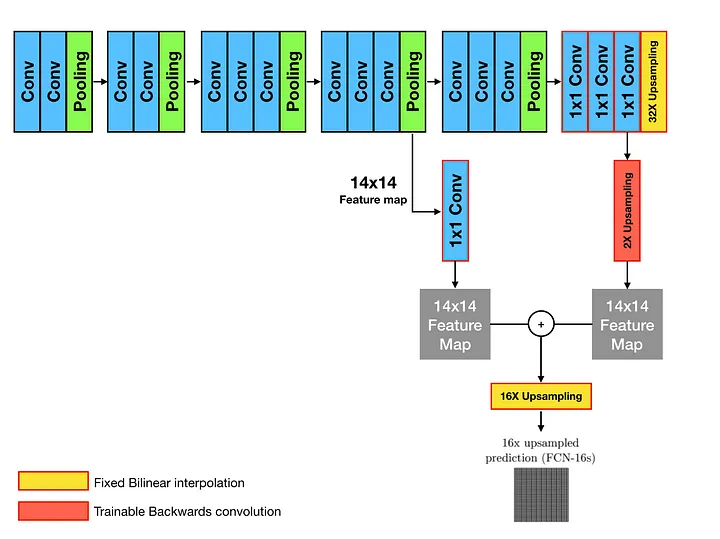
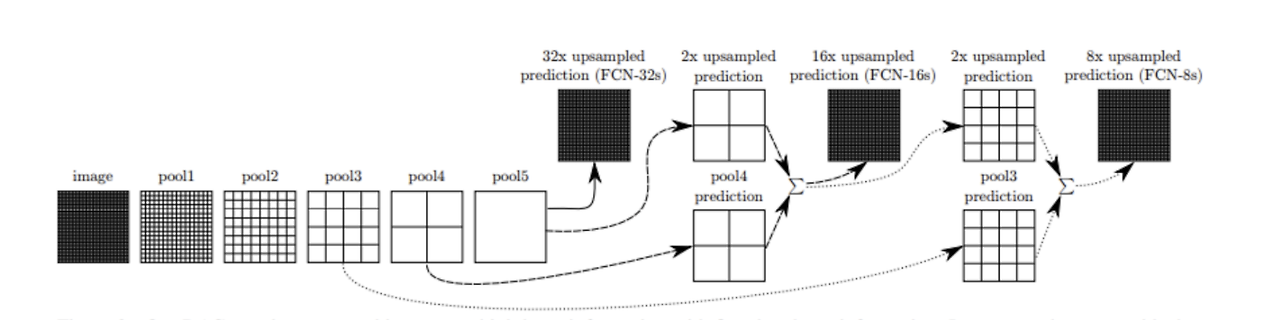
이미지의 좌측 하단 그림을 통해 FCN-16s를 설명하면 다음과 같다.
pooling을 덜 거친 중간 단계의 feature map들을 활용하였습니다.
1. Pool5를 통해 생성된 1x1 feature map을 2배로 upsampling한다.
2. Pool4에서 생성된 2x2x512 feature map에서 1x1x512 필터를 적용한다.
3. 위의 두 과정에서 연산된 결과를 element-wise로 더해준 후, 16배로 upsampling하여 32x32로 만들어준다.
FCNs은 End-to-End 방식의 Fully-Convolution Model을 통한 Dense Prediction 혹은 Semantic Segmentation의 초석을 닦은 연구로써 이후 많은 관련 연구들에 영향을 주었다.
참고)
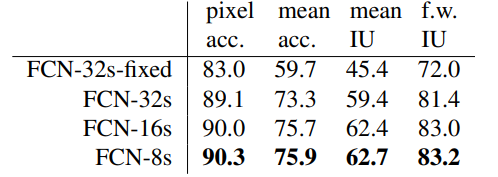
FCN-8s가 가장높은 IU를 기록한 것을 알 수 있습니다.

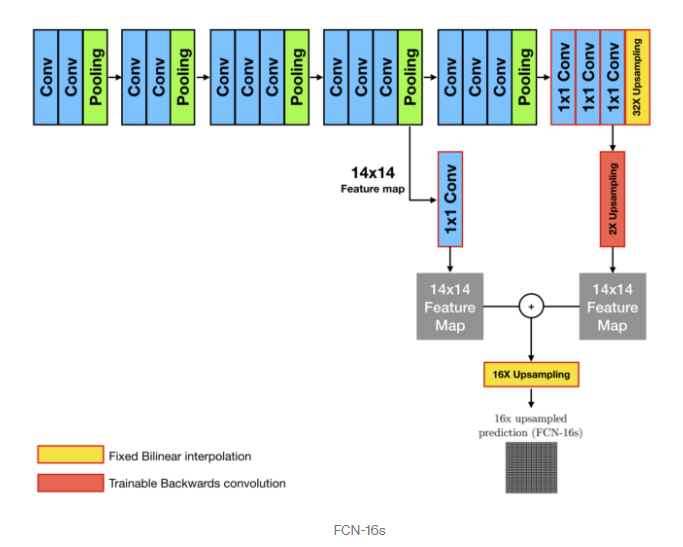
FCN-8s와 FCN-16s의 구조적 차이
FCN-32s:
가장 기본적인 버전으로, 입력 이미지를 몇 개의 풀링 레이어를 통해 다운샘플링합니다.
다운샘플링된 마지막 출력 (32배 축소)을 업샘플링하여 원래 크기로 복원합니다.
이는 해상도 손실이 크고, 세부 정보를 복원하기 어려운 단점이 있습니다.
FCN-16s:
FCN-32s의 단점을 보완하기 위해 고안되었습니다.
다운샘플링된 마지막 출력 (32배 축소)과 그 이전 레이어의 출력 (16배 축소)을 합쳐서 업샘플링합니다.
이로 인해, 더 많은 세부 정보를 유지할 수 있습니다.
구조: 32배 다운샘플된 출력과 16배 다운샘플된 출력을 결합하여 2배 업샘플링한 후 최종적으로 16배 업샘플링합니다.
FCN-8s:
FCN-16s보다 더 나은 세부 정보를 유지합니다.
다운샘플링된 마지막 출력 (32배 축소), 그 이전 레이어의 출력 (16배 축소), 그리고 그 이전 레이어의 출력 (8배 축소)을 합쳐서 업샘플링합니다.
이로 인해 가장 많은 세부 정보를 유지할 수 있습니다.
구조: 32배 다운샘플된 출력, 16배 다운샘플된 출력, 8배 다운샘플된 출력을 결합하여 최종적으로 8배 업샘플링합니다.
FCN-8s가 더 성능이 좋은 이유
더 많은 세부 정보 유지:
FCN-8s는 8배, 16배, 32배 다운샘플된 출력들을 결합하여 최종 출력을 생성합니다.
더 높은 해상도의 특징 맵을 사용하여 결과적으로 더 많은 세부 정보를 포함하는 출력을 생성할 수 있습니다.
정확한 경계 복원:
더 작은 스케일(8배)에서의 정보는 객체의 경계를 더 정확하게 복원하는 데 도움을 줍니다.
이는 특히 경계가 중요한 이미지 분할 작업에서 성능 향상을 가져옵니다.
더 나은 학습:
다양한 스케일의 특징을 결합함으로써 모델이 다양한 크기와 형태의 객체를 더 잘 학습할 수 있습니다.
이는 객체의 크기나 위치에 덜 민감하게 만들어줍니다.
결론적으로, FCN-8s는 FCN-16s 및 FCN-32s에 비해 더 많은 세부 정보를 포함하고, 경계를 더 정확하게 복원하며, 다양한 크기와 형태의 객체를 더 잘 학습할 수 있어 성능이 더 우수합니다.
몇줄 정리)
Semantic Segmentation 모델을 위해 CNN 기반 모델(AlexNet, VGG16, GoogLeNet)을 목적에 맞춰 변형시킨 것으로 fc-layer를 Conv-layer로 대체하였으나 그 과정에서 픽셀 단위 예측을 위해 Coarse map에서 Dense map으로 변환할 필요가 있었고 이를 위해 사용한 방식이 Skip architecture으로 Dense map에 얕은 층의 정보를 결합하는 방식으로 부족한 fine information을 pooling을 덜 거친 중간 단계의 feature map들을 활용하여서 보완한 Network라고 볼 수 있습니다.
